สรุปภาพรวม: Gemini 3.8 Live เทียบกับ GPT-Live-1
สิ่งที่ตารางด้านล่างไม่สามารถบอกได้คือ ในทั้งสองกรณี แอปของคุณยังคงเป็นผู้ทำงานจริง เช่น เรียกใช้ฟังก์ชันของคุณ และติดตามสิ่งที่ผู้ใช้ร้องขอ
|
จุดเปรียบเทียบ |
Gemini 3.8 Live |
GPT-Live-1 |
|
บทบาท |
โมเดลเดียวที่ฟัง มองเห็น ให้เหตุผล และขอให้แอปของคุณลงมือทำ |
โมเดลเสียงที่สนทนาและส่งงานยากให้แบ็กเอนด์ |
|
รหัสโมเดล |
|
|
|
อินพุตที่รองรับโดยตรง |
ข้อความ เสียง รูปภาพ เฟรมวิดีโอ |
ข้อความและเสียงเท่านั้น |
|
ตำแหน่งที่รันการให้เหตุผลเชิงลึก |
ภายในโมเดล โดย Extended Thinking จะเพิ่มปริมาณ |
ในแบ็กเอนด์ที่คุณเลือก |
|
ใครรันฟังก์ชันของคุณ |
แอปพลิเคชันของคุณ (Search grounding รันที่ฝั่ง Google) |
แอปพลิเคชันของคุณ; เครื่องมือที่โฮสต์ เช่น การค้นเว็บ รันกับแบ็กเอนด์ |
|
หน่วยการคิดเงิน |
โทเคน รวมถึงโทเคนสำหรับการคิด |
นาทีของเซสชันที่เชื่อมต่อ บวกการใช้งานแบ็กเอนด์ |
|
ชั้นใช้ฟรี |
มี |
ไม่มี |
Gemini 3.8 Live และ GPT-Live-1 คืออะไร?
ทั้งคู่เป็นโมเดลสุนทรพจน์-ต่อ-สุนทรพจน์ จึงรับเข้าเป็นเสียงและส่งออกเป็นเสียง โดยไม่ต้องถอดเสียงแยกต่างหาก
Gemini 3.8 Live คืออะไร?
Gemini 3.8 Live คือโมเดลสนทนาแบบไลฟ์ความหน่วงต่ำของ Google รับข้อความ รูปภาพ เสียง และวิดีโอ ให้เหตุผลระหว่างเทิร์น และเรียกฟังก์ชันแบบอะซิงโครนัส ทั้งสองรุ่นของ Gemini ระบุขีดจำกัดอินพุตไว้ที่ 131,072 โทเคนบนหน้ารายการโมเดล
Gemini 3.8 Live Extended Thinking เป็นโมเดลแยก ไม่ใช่การตั้งค่า เพิ่มการให้เหตุผลเบื้องหลัง ในระดับต่ำ กลาง หรือสูง พร้อมบรรยายความคืบหน้าไปด้วย
ตามบันทึกเวอร์ชันของ Google โมเดลทั้งสองมีสถานะพร้อมใช้งานทั่วไป ขณะที่คู่มือความสามารถของ Live API ยังระบุว่า API อยู่ในสถานะพรีวิว
GPT-Live-1 คืออะไร?
GPT-Live-1 คือโมเดลเสียงแบบฟูลดูเพล็กซ์ของ OpenAI ฟูลดูเพล็กซ์คือคำทางเทคนิคสำหรับพฤติกรรมฟังไปพูดไปตามที่เกริ่นไว้
OpenAI เรียกการส่งต่องานให้แบ็กเอนด์ว่า delegation และเสียงสามารถพูดต่อไปในระหว่างที่งานนั้นรันอยู่
GPT-Live-1 ก็ไม่ใช่ผลิตภัณฑ์เดียวกับสาย GPT-Realtime-2 ของ OpenAI หรือโมเดลแบ็กเอนด์ที่มันส่งต่อให้ GPT-Realtime-2.1 เก็บการให้เหตุผลและเครื่องมือไว้ในโมเดลเรียลไทม์ตัวเดียว ดังนั้นทุกอย่างที่กล่าวถึง delegation ใช้กับ GPT-Live-1 เท่านั้น
ความแตกต่างหลักระหว่าง Gemini 3.8 Live และ GPT-Live-1 คืออะไร?
สรุปสั้นอยู่ใน TL;DR แล้ว ส่วนนี้คือฉบับเต็ม Gemini 3.8 Live เลือกเรียกฟังก์ชันภายในเซสชันไลฟ์ ขณะที่ GPT-Live-1 ส่งการให้เหตุผลไปที่แบ็กเอนด์แยก ในทั้งสองแนวทาง แอปของคุณเป็นผู้รันฟังก์ชันของคุณเอง
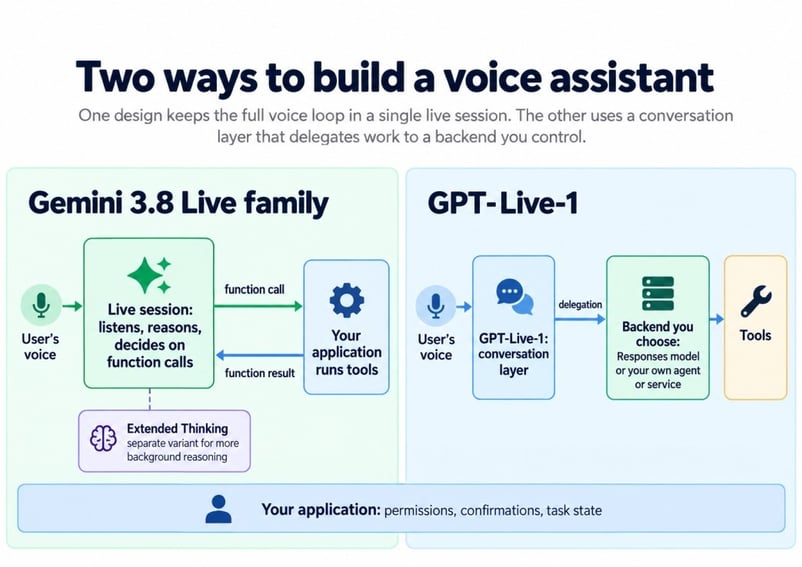
ตำแหน่งที่แต่ละโมเดลวางส่วน “คิด” ภาพโดยผู้เขียน
สิ่งที่จะกล่าวต่อไปส่วนใหญ่ย้อนกลับไปที่จุดแยกนี้ จึงขอแยกอธิบายแต่ละฝั่งก่อน
วิธีที่ Gemini 3.8 Live วางแผนภายในเซสชันเดียว
กับ Gemini ไม่มีโมเดลตัวที่สองให้ตั้งค่า โมเดลไลฟ์จะปล่อยคำสั่งเรียกฟังก์ชันเมื่อมันต้องการข้อมูล และไคลเอนต์ของคุณจะส่งผลลัพธ์กลับ ตามที่คู่มือการคิดของ Googleอธิบายไว้
การย้ายไป Extended Thinking ใช้ปลายทาง WebSocket เดิมและไม่ต้องมีโมเดลแบ็กเอนด์ แม้โค้ดฝั่งไคลเอนต์จะต้องเปลี่ยน
การทำงานของการมอบหมายงานใน GPT-Live-1
GPT-Live-1 จัดการเสียงและตัดสินใจว่าจะขอความช่วยเหลือเมื่อใด ส่วนแบ็กเอนด์จัดการการให้เหตุผล เครื่องมือ และกฎธุรกิจ คู่มือการพรมต์ของ OpenAI วางขั้นตอนงานทั้งหมดไว้ในคำสั่งของแบ็กเอนด์
กับ Responses delegation OpenAI จะรันโมเดลที่คุณตั้งค่าไว้ ส่วน client delegation จะส่งงานไปยังโมเดลหรือบริการใดๆ ที่แอปของคุณรัน ไม่ว่าแบบใด คู่มือ delegation ระบุว่าแอปพลิเคชันของคุณเป็นเจ้าของสิทธิ์ บันทึก และสถานะงาน
เหตุใดความต่างด้านสถาปัตยกรรมจึงสำคัญ
ราคาของการแยกส่วนคือชิ้นส่วนที่มากขึ้น: เซสชันเสียง แบ็กเอนด์ และสถานะที่แชร์กัน แลกกับความสามารถในการเปลี่ยนโมเดลให้เหตุผลโดยไม่ต้องแตะส่วนเสียง
ดีลนี้ดูแย่หากคุณยังไม่มีแบ็กเอนด์ แต่ดูดีกว่าหากต้องอัปเกรดเอเยนต์เดิมโดยไม่เปลี่ยนเสียง
ทั้งสองโมเดลรับมือการขัดจังหวะอย่างไร?
ทั้งคู่รับมือการขัดจังหวะได้ แต่ GPT-Live-1 ถูกออกแบบโดยยึดสิ่งนี้ไว้เป็นแกน รวมถึงการหยุดเว้นวรรคและ backchannel (เสียง “อือฮึ” ของผู้ฟัง) Gemini 3.8 Live รองรับ barge-in และเสียงเชิงรุกเปิดใช้ตลอด แต่เอกสารของ Google ไม่เรียกมันว่าแบบฟูลดูเพล็กซ์
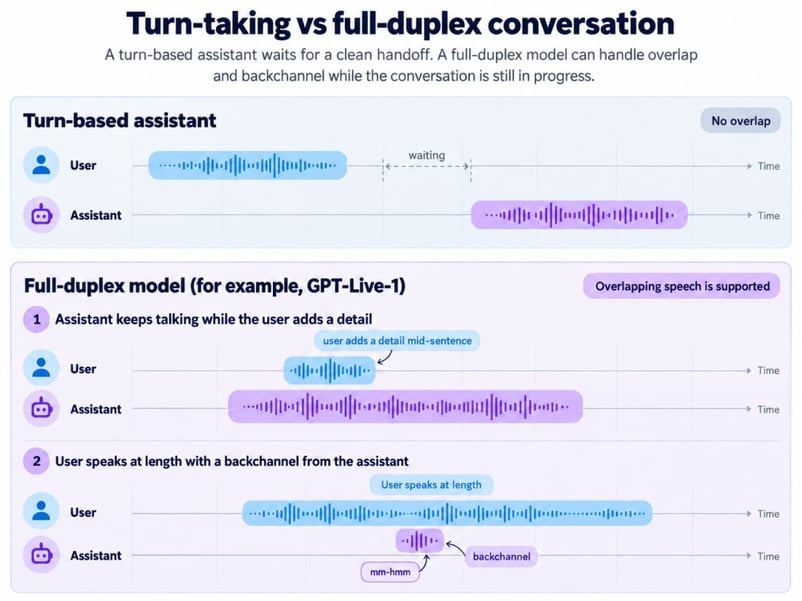
ผลัดกันพูดเทียบกับการพูดพร้อมกัน ภาพโดยผู้เขียน
โพสต์เปิดตัวของ OpenAI อ้างคำกล่าวจากแอปสอนภาษา Speak ว่า GPT-Live-1 ลดการขัดจังหวะได้เกือบ 80% เมื่อเทียบกับระบบแบบผลัดกันพูด ซึ่งเป็นคำอ้างจากลูกค้าไม่ใช่การทดสอบอิสระ
ในฝั่ง Gemini เสียงเชิงรุกทำให้โมเดลข้ามคำพูดที่ไม่ได้พูดกับมันได้ บทเรียน Gemini ของเราพบว่าเสียงจากลำโพงแล็ปท็อปที่ไหลเข้ามายในไมค์ถูกนับเป็นการแทรกของผู้ใช้ จึงควรทดสอบทั้งแบบใส่และไม่ใส่หูฟัง
การให้เหตุผลและการเรียกใช้เครื่องมือ: ทั้งสองต่างกันอย่างไร?
Gemini ขยายความสามารถการให้เหตุผลโดยสลับจากรุ่น Live พื้นฐานไป Extended Thinking ส่วน GPT-Live-1 ขยายโดยเปลี่ยนแบ็กเอนด์ จึงควรเปรียบเทียบ Extended Thinking กับ GPT-Live-1 ที่ตั้งค่าครบ ไม่ใช่เฉพาะโมเดลเสียง
Gemini 3.8 Live เทียบกับ Gemini 3.8 Live Extended Thinking
Gemini 3.8 Live พื้นฐานไม่มีการตั้งค่า thinking_level และรับฟังก์ชัน BLOCKING เพื่อรองรับโค้ดเก่า Extended Thinking เปลี่ยนพฤติกรรมฝั่งไคลเอนต์ 4 อย่าง:
-
เครื่องมือ: ใช้ได้เฉพาะฟังก์ชัน
NON_BLOCKINGและแบบบล็อกจะคืนค่าผิดพลาดแบบแข็ง -
ระดับการคิด: ไม่มีตัวเลือกต่ำสุด มีเพียงสามระดับดังกล่าว
-
จบหนึ่งเทิร์น:
turnComplete: trueไม่ได้แปลว่าโมเดลเสร็จแล้ว ไคลเอนต์ของคุณต้องดูค่าinteraction_statusจนเป็นIDLE -
การจัดตาราง: ไม่รองรับการจัดตารางฟังก์ชัน
Google แนะนำ Extended Thinking สำหรับงานหลายขั้นตอนและเครื่องมือที่ช้า โดยต้องแลกกับความหน่วงและโทเคนเอาต์พุตที่มากขึ้น
มีอย่างหนึ่งที่น่าหงุดหงิดในเอกสารของ Google โพสต์เปิดตัวบอกว่า Gemini 3.8 Live สามารถ “คุยต่อในขณะที่งานเสร็จเบื้องหลัง” แต่คู่มือการคิดบอกว่ารุ่นพื้นฐาน “รอการทำงานของเครื่องมือก่อนจึงจะพูด” บทเรียน Gemini ของเราเห็นพฤติกรรมหลังระหว่างการค้นหาสภาพอากาศ จึงควรวางแผนตามคู่มือจนกว่า Google จะชี้แจง
มีโมเดลแบ็กเอนด์ใดใช้กับ GPT-Live-1 ได้บ้าง?
GPT-Live-1 สามารถอยู่หน้าทุกแบ็กเอนด์ที่คุณตั้งค่า เอกสารของ OpenAI ชี้ไปที่แบ็กเอนด์ GPT-6 สามตัว:
-
GPT-6 Luna (
gpt-6-luna) ตัวเริ่มต้นที่คู่มือ delegation แนะนำ -
GPT-6 Sol (
gpt-6-sol) ข้อเสนอแนะของคู่มือสำหรับงานที่ยากขึ้น -
GPT-6 Astra ซึ่งโพสต์เปิดตัวแนะนำสำหรับปัญหาลูกค้าที่ซับซ้อน
แถวใน Artificial Analysis อย่าง "GPT-Live-1 (Astra, medium)" และ "GPT-Live-1 (Sol, low)" คือการกำหนดค่าระบบ ไม่ใช่เวอร์ชันของโมเดลเสียง Artificial Analysis ไม่ระบุเจเนอเรชันของ Sol และ OpenAI ก็ออกGPT-6.1 Sol หลังจากการทดสอบเหล่านั้นเสร็จสิ้น
เมื่อผู้โทรเปลี่ยนคำขอระหว่างงาน
สมมติผู้โทรขอเลื่อนการจองเป็นวันศุกร์ แล้วพูดว่า “จริงๆ เอาวันพฤหัส” ระหว่างที่การค้นหากำลังรัน จะนับคำขอหลังเท่านั้น
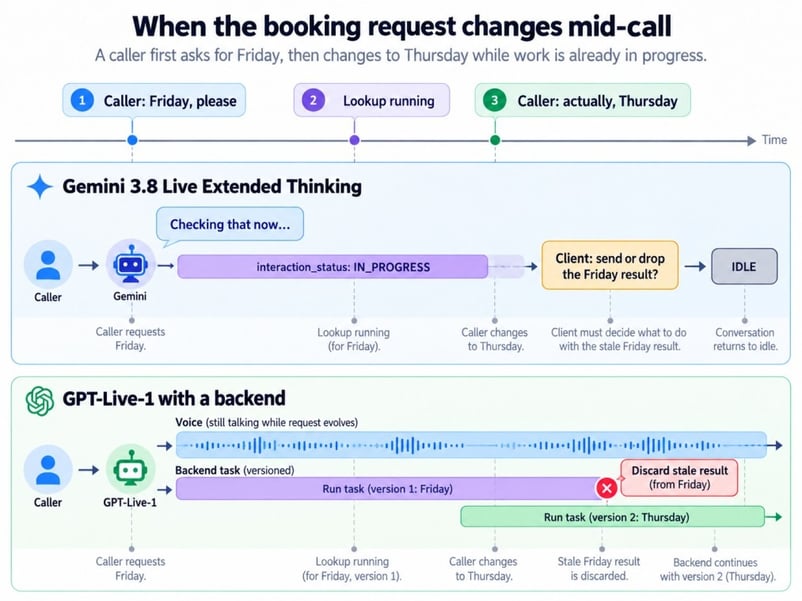
คำขอเปลี่ยนระหว่างงานที่ช้า ภาพโดยผู้เขียน
ใน GPT-Live-1 การขัดจังหวะเสียงไม่ยกเลิกงานในแบ็กเอนด์ Responses delegation ยังอาจส่งผลเก่ากลับไปที่เสียงได้ ขณะที่ client delegation ให้โค้ดของคุณทิ้งผลนั้นก่อนได้
ใน Gemini ไคลเอนต์ของคุณสามารถทิ้งผลเครื่องมือที่ค้างได้ ไม่ว่ากรณีใด แอปของคุณเป็นผู้ตัดสินใจว่างานปัจจุบันคืออะไร
รองรับรูปภาพและวิดีโอหรือไม่?
Gemini 3.8 Live รองรับรูปภาพและวิดีโอโดยกำเนิด ส่วน GPT-Live-1 ระบุว่าไม่รองรับทั้งสอง แอป GPT-Live-1 ยังสามารถส่งรูปไปยังแบ็กเอนด์วิชันแยกได้ แต่ไม่สามารถดูภาพจากกล้องแบบไลฟ์ได้เอง
สำหรับ Gemini เฟรมวิดีโอเข้ามาในเซสชันเดียวกับเสียง ทำให้โมเดลตอบได้ว่า “สายนี้ใช่ไหม” ขณะผู้ใช้ยกให้ดู แต่มาพร้อมต้นทุนสองอย่าง เฟรมวิดีโอถูกส่งโดยค่าเริ่มต้น และคู่มือการจัดการเซสชันของ Google จำกัดเซสชันที่มีเสียงและวิดีโอไว้ที่ 2 นาที เทียบกับ 15 นาทีสำหรับเสียงล้วน เว้นแต่จะเปิดใช้การบีบอัดหน้าต่างบริบท
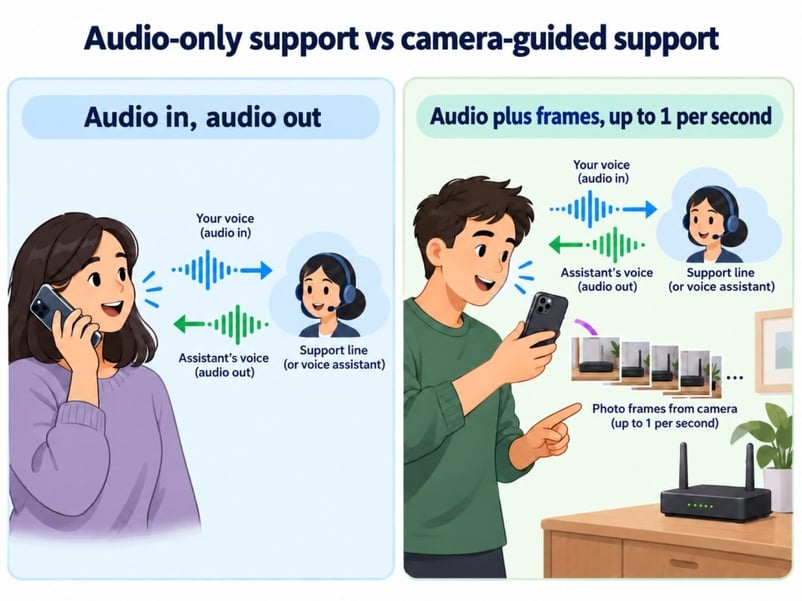
การโทรเทียบกับการซ่อมผ่านกล้อง ภาพโดยผู้เขียน
สายจองจะไม่มีเฟรมวิดีโอให้เห็น และกระดานผู้นำด้านเสียงด้านล่างไม่ได้วัดวิชัน
เกณฑ์ชี้วัด: Gemini 3.8 Live เทียบกับ GPT-Live-1
ไม่มีการชี้วัดใดชี้ขาดการเปรียบเทียบนี้ได้เพียงตัวเดียว ในสี่การกำหนดค่าของสองโมเดล Astra นำดัชนีหลัก Sol นำด้านพลวัตการสนทนา และ Gemini พื้นฐานมี Arena Elo สูงสุดในสี่ค่ากำหนดนั้น
ก่อนอื่น อธิบายวิธีทำงานของดัชนีหลัก เพราะสิ่งนี้อธิบายช่องว่างส่วนใหญ่
วิธีทำงานของ Artificial Analysis Speech to Speech Index
ดัชนีให้น้ำหนักเท่ากันกับสี่ทักษะต่างกัน:
- Big Bench Audio: คำถามให้เหตุผลที่ถามเป็นเสียง
- τ-Voice: งานบริการลูกค้าหลายขั้นตอน เช่น เปลี่ยนเที่ยวบิน
- คะแนน Arena: คะแนนจากการโหวตปิดตาของมนุษย์ว่าอยากคุยกับเอเยนต์ใด
- อัตราสำเร็จของงาน: ความถี่ที่บทสนทนาจบด้วยการเรียกเครื่องมือสุดท้ายที่ถูกต้อง
พลวัตการสนทนารายงานแยกตามระเบียบวิธี v2.0
นี่คอการกำหนดค่าทั้งสี่ที่สำคัญที่นี่
|
การกำหนดค่า |
ดัชนี |
Big Bench Audio |
τ-Voice |
พลวัตการสนทนา |
Arena Elo |
ความสำเร็จของงาน |
TTFA |
|
GPT-Live-1 (Astra, medium) |
83.2 |
90.1% |
74.5% |
94.9% |
1027 |
87.4% |
1.34 s |
|
Gemini 3.8 Live Extended Thinking (High) |
82.6 |
97.7% |
68.6% |
91.9% |
966 |
89.1% |
1.35 s |
|
GPT-Live-1 (Sol, low) |
80.1 |
89.0% |
59.3% |
97.3% |
1037 |
90.9% |
1.24 s |
|
Gemini 3.8 Live |
74.5 |
91.7% |
30.1% |
96.1% |
1074 |
93.2% |
1.18 s |
ทั้งสองคะแนน τ-Voice ของ GPT-Live-1 มาจากการทดสอบครั้งเดียว จึงควรใช้ด้วยความระมัดระวัง
งานของเอเยนต์เทียบกับคะแนนความพึงพอใจของมนุษย์
บน τ-Voice Astra ได้ 74.5% Extended Thinking 68.6% และ Gemini พื้นฐาน 30.1% การให้เหตุผลเพิ่มมีความหมายเมื่อเชื่อมเครื่องมือหลายตัว
ด้านบทสนทนาบอกอีกเรื่อง: Sol ได้คะแนนสูงสุด และช่วงความเชื่อมั่น Arena ของ Gemini พื้นฐานกับ Sol ทับซ้อนกัน
ช่องว่างดัชนี 0.6 จุดระหว่าง Astra กับ Extended Thinking ไม่มีช่วงความเชื่อมั่นที่เผยแพร่ ทั้งคู่นั้นสลับตำแหน่งกันมาแล้วครั้งหนึ่ง จึงยังนับว่าใกล้เคียงกัน
โมเดลใดตอบกลับเร็วกว่า?
Gemini 3.8 Live พื้นฐานมีเวลาเริ่มเสียงแรก (TTFA) เร็วสุดในตาราง แต่ช่วงของทั้งสี่ต่างกันไม่ถึง 0.2 วินาที TTFA คือเวลาที่โมเดลใช้สร้างโทเคนเสียงแรก
TTFA ไม่สะท้อนการตอบสนองต่อการขัดจังหวะหรือเวลาที่ต้องใช้เพื่อจบการจองหรือการค้นหา อย่างหลังขึ้นอยู่กับแบ็กเอนด์และเครื่องมือของคุณมากกว่า
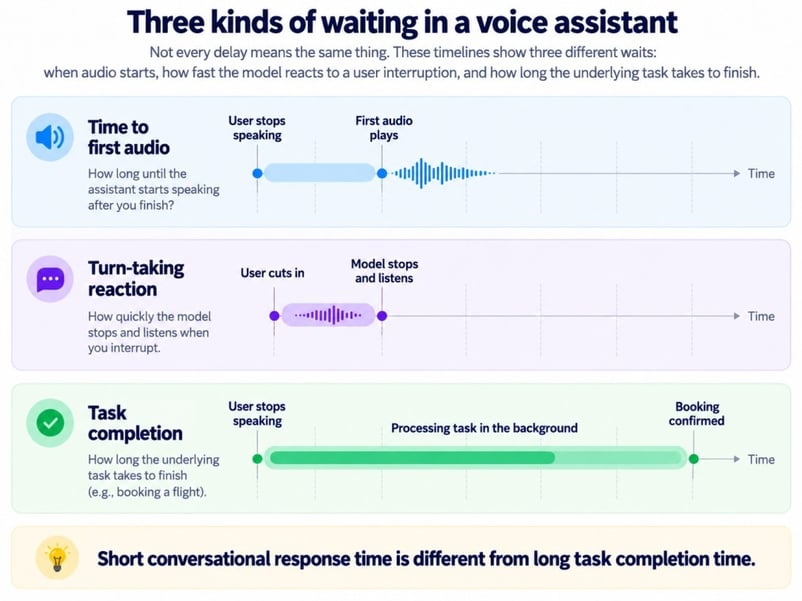
การรอสามแบบในระบบเสียง ภาพโดยผู้เขียน
ทั้ง Extended Thinking และ GPT-Live-1 สามารถพูดคุยต่อระหว่างที่การค้นหาช้าทำงานอยู่ แต่ผู้โทรยังคงต้องรอการจอง
สิ่งที่เกณฑ์เสียงไม่ได้วัด
สำหรับสายสนับสนุน กระดานผู้นำบอกคุณไม่ได้ว่า:
- ผู้ให้บริการโทรศัพท์และโคเดกของคุณส่งสัญญาณได้สะอาดหรือไม่
- เอเยนต์ยังคงทำตามสคริปต์ของคุณหลังผ่านไปสิบหรือไม่
- โมเดลได้ยินผู้โทรที่มีสำเนียงจัดในที่มีเสียงดังอย่างไร
- ต้นทุนสายสนทนาจริงเท่าใดเมื่อรวมค่าแบ็กเอนด์และเครื่องมือ
การทดสอบนำร่องด้วยบันทึกเสียงของคุณเองตอบคำถามเหล่านี้ได้ดีกว่า
ราคา: อันไหนถูกกว่า?
Gemini พื้นฐานถูกที่สุดในบททดสอบของ Artificial Analysis แต่อัตราคิดเงินต่างกัน สิ่งสำคัญคือ “ต้นทุนต่อภารกิจที่สำเร็จ” มากกว่าป้ายราคา
อัตราด้านล่างคือราคาตามหน้าราคา Googleและหน้ารายการโมเดล GPT-Live-1 ณ เวลาที่เขียนนี้ และตัวเลขต่อนาทีของ Gemini เป็นการแปลงจากราคาโทเคนของ Google เอง
|
รายการค่าใช้จ่าย |
Gemini 3.8 Live และ Extended Thinking (ชั้นเสียเงิน) |
GPT-Live-1 |
|
อินพุตเสียง |
$3.00 ต่อ 1M โทเคน (ราว $0.005/นาที) |
รวมใน $0.05 ต่อนาที คิดเป็นวินาที |
|
เอาต์พุตเสียง |
$12.00 ต่อ 1M โทเคน (ราว $0.018/นาที) |
รวมในค่าธรรมเนียมเซสชันเดียวกัน |
|
อินพุตรูปภาพหรือวิดีโอ |
$1.00 ต่อ 1M โทเคน (ราว $0.002/นาที) |
ไม่รองรับ |
|
การให้เหตุผล |
โทเคนสำหรับการคิดคิดเงินในอัตราเอาต์พุต |
โทเคนของโมเดลแบ็กเอนด์ตามราคาโมเดลนั้น |
|
การค้นหาและเครื่องมือ |
ฟรี 5,000 คำขอ Search ต่อเดือน จากนั้น $14 ต่อ 1,000 |
คิดเงินตามโมเดลแบ็กเอนด์และเครื่องมือที่ใช้ |
โทเคนสำหรับการคิดทำให้ Extended Thinking มีต้นทุนสูงกว่า Gemini พื้นฐาน Artificial Analysis ประมาณ $0.84 ต่อชั่วโมงอินพุตเสียงสำหรับ Gemini พื้นฐาน $3.50 สำหรับ Extended Thinking $4.47 สำหรับ Sol และ $5.83 สำหรับ Astra ไม่นับเครื่องมือและส่วนลดแคช Gemini Live ไม่รองรับการแคช แต่แบ็กเอนด์ของ GPT-Live-1 ทำได้
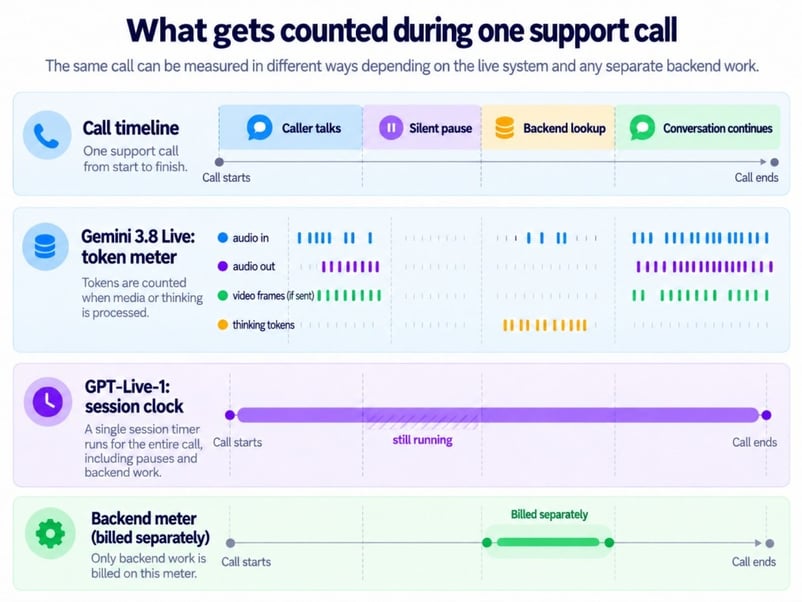
มิเตอร์แต่ละตัวนับอะไรระหว่างสาย ภาพโดยผู้เขียน
นาฬิกาของ GPT-Live-1 เดินแม้ในช่วงเงียบ และการ mute ไม่หยุดมัน รวมค่าธรรมเนียมในตารางและค่าโทรศัพท์ แล้วหารด้วยจำนวนงานที่เสร็จสิ้น
การรองรับบนเบราว์เซอร์ เซิร์ฟเวอร์ และโทรศัพท์
ทั้งแอปบนเบราว์เซอร์และเซิร์ฟเวอร์เชื่อมต่อกับทั้งสองโมเดลได้ แต่การดีพลอยบนโทรศัพท์ทำให้ต่างกัน แผนภาพแสดงเส้นทางการเชื่อมต่อ ความต่างด้านปฏิบัติการคืออายุการเชื่อมต่อและใครอยู่ในเส้นทางของสาย
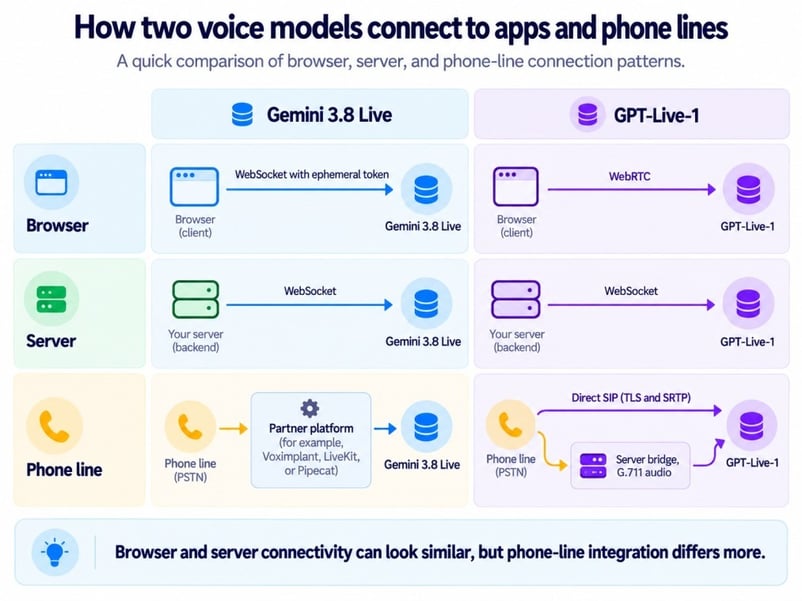
เส้นทางเชื่อมต่อของเบราว์เซอร์ เซิร์ฟเวอร์ และโทรศัพท์ ภาพโดยผู้เขียน
การเชื่อมต่อของ Gemini รีเซ็ตหลังราว 10 นาที จึงต้องมีการ resume สำหรับสายที่ยาวกว่า ส่วน GPT-Live-1 ควรล็อกการเชื่อมต่อเสียงและงานที่มอบหมายให้แบ็กเอนด์แยกกัน
การโทรและการรองรับ SIP
SIP ตรงทำให้มีผู้ให้บริการน้อยลงหนึ่งรายในเส้นทางสายของ GPT-Live-1 เส้นทางผ่านพาร์ทเนอร์ของ Gemini เพิ่มบริการอีกตัวให้ต้องตั้งค่า ตรวจสอบ และดีบัก
นักพัฒนาบางรายบนฟอรั่มของ OpenAI รายงานว่า GPT-Live-1 ให้สัญญาว่าจะทำแอคชันโดยไม่สร้าง delegation ฝ่ายสนับสนุนของ OpenAI ไม่ได้เรียกว่านี่คือบั๊ก แต่ชี้ไปที่คู่มือการพรมต์ซึ่งระบุว่าการยืนยันด้วยคำพูดไม่ได้ยืนยันว่าเริ่มงานแบ็กเอนด์แล้ว จึงควรล็อกเหตุการณ์ delegation แยกจากเสียง
ตั้งแต่ 2 พฤศจิกายน OpenAI ยังรองรับการโทรออกผ่าน SIP สำหรับทุกองค์กรมาด้วย ทำให้ GPT-Live-1 โทรออกได้เช่นเดียวกับการรับสาย
ควรใช้ตัวไหน?
ตัวเลือกขึ้นกับสองคำถาม: ผู้ช่วยต้อง “มองเห็น” หรือไม่ และมีแบ็กเอนด์อยู่แล้วหรือยัง หากตอบว่าใช้อย่างแรก ชี้ไปที่ Gemini หากตอบว่าใช้อย่างที่สอง ชี้ไปที่ GPT-Live-1
ข้ามไปยังสถานการณ์ที่ตรงกับผลิตภัณฑ์ของคุณด้านล่าง
สายสนับสนุนและการจอง
สายโทรศัพท์ต้องการการรับมือการขัดจังหวะและการยืนยันก่อนทำสิ่งที่ย้อนกลับไม่ได้ GPT-Live-1 ลงตัวดี ด้วยการรองรับ SIP ตามที่กล่าว และตรรกะการจองคงไว้ในแบ็กเอนด์
การแก้ปัญหาผ่านกล้องและหน้าจอ
เมื่อผู้ใช้ชี้โทรศัพท์ไปที่เราเตอร์ โมเดลต้องให้เหตุผลกับสิ่งที่เห็นในตอนนั้น Gemini 3.8 Live ทำได้ในเซสชันเดียว โดยไม่ต้องมีคอมโพเนนต์วิชันแยก ตราบใดที่วางแผนรองรับเพดานวิดีโอ 2 นาทีจากส่วนภาพ
งานหลายขั้นตอนเบื้องหลัง
สำหรับงานที่เชื่อมเครื่องมือหลายตัว ให้เทียบ Extended Thinking กับ GPT-Live-1 บวก Astra Astra นำ τ-Voice ในการทดสอบครั้งเดียว ดังนั้นตัวเลือกยังคงกลับไปที่ว่าจะวางการให้เหตุผลไว้ที่ใด
เพิ่มเสียงให้เอเยนต์ที่คุณมีอยู่แล้ว
Client delegation สามารถเพิ่ม GPT-Live-1 ให้เอเยนต์เดิมโดยไม่ต้องเขียนลูปให้เหตุผลใหม่ ส่วน Gemini โมเดลไลฟ์จะกลายเป็นตัววางแผน
ปริมาณสายสูง งบจำกัด
สายสั้น เรียบง่าย ชี้ไปที่ Gemini พื้นฐาน ซึ่งถูกที่สุดในบททดสอบของ Artificial Analysis เครื่องมือหลายขั้นตอนจะเปลี่ยนสมการนี้
ข้อคิดส่งท้าย
กรอบที่ชัดที่สุดในการเทียบครั้งนี้คือ Gemini 3.8 Live รวมการมองเห็น การให้เหตุผล และการพูดไว้ในโมเดลเดียว ขณะที่ GPT-Live-1 แยกเสียงออกจากความฉลาดเบื้องหลัง ทั้งสองไม่ได้ครองกัน และทั้งคู่ใกล้เคียงกันมากในด้านความเป็นธรรมชาติและความเร็วในการตอบจนสถาปัตยกรรมจะเป็นตัวตัดสินในการใช้งานจริงส่วนใหญ่
สิ่งที่น่าสนใจคือความเป็นผู้นำด้านงานเอเยนต์ขยับไปทาง GPT-Live-1 ร่วมกับ Astra อย่างรวดเร็ว คะแนนนั้นเป็นของทั้งระบบ ไม่ใช่แค่โมเดลเสียง จึงเป็นข้อโต้แย้งของการมอบหมายงานให้เห็นภาพ แม้ผลทดสอบครั้งเดียวจะเป็นเพียงสัญญาณ ไม่ใช่คำตัดสิน
อีกอย่างที่น่าจับตาคือไลน์อัปแบ็กเอนด์ของ OpenAI เพราะ GPT-6.1 Sol ออกช่วงปลายกันยายน 2026 แบ็กเอนด์ใหม่แต่ละตัวสามารถขยับคะแนนของ GPT-Live-1 ได้โดยไม่แตะเสียง ขณะที่ฝั่ง Google การเปลี่ยนที่เทียบเคียงกันคือต้องสลับโมเดลไลฟ์
ณ ตอนนี้ Gemini 3.8 Live เป็นตัวเลือกที่ง่ายกว่าสำหรับงานที่มีกล้อง และ GPT-Live-1 เป็นตัวเลือกที่ง่ายกว่าสำหรับผลิตภัณฑ์บนโทรศัพท์ที่มีแบ็กเอนด์อยู่แล้ว ไม่ว่าทางใด โค้ดของคุณยังต้องรับมือปัญหาจองวันศุกร์เปลี่ยนเป็นพฤหัสอยู่ดี
สำหรับแนวคิดเอเยนต์เบื้องหลังทั้งสองเส้นทาง คอร์ส Introduction to AI Agents ของเราครอบคลุมเครื่องมือ หน่วยความจำ และการวางแผน
FAQs
GPT-Live-1 ใช้โมเดล Gemini เป็นแบ็กเอนด์ได้ไหม?
ได้ Client delegation สามารถส่งงานไปยังโมเดลข้อความของ Gemini ที่อยู่หลังแบ็กเอนด์ของคุณเอง คุณจะจ่ายให้ OpenAI ตามนาทีเสียง และจ่ายให้ Google ตามโทเคนของแบ็กเอนด์
การสนทนา GPT-Live-1 อยู่ในบริบทได้นานแค่ไหน?
GPT-Live-1 มีหน้าต่างบริบท 128,000 โทเคน ซึ่งนับโทเคนเสียง ไม่ใช่แค่ถอดเสียง เมื่อการใช้งานเกิน 90% จะเริ่มเครื่องเสียงทดแทนที่พกพาประวัติล่าสุดได้สูงสุด 8,192 โทเคนและสรุปย่อ ดังนั้นให้เก็บแอคชันที่ยืนยันแล้วและสถานะงานไว้ในแอปของคุณเอง
มีการจำกัดอัตราใดบ้างสำหรับ Gemini 3.8 Live และ GPT-Live-1?
GPT-Live-1 อนุญาต 50 เซสชันพร้อมกันบนแพ็กเกจ Build, 300 บน Launch และ 500 บน Grow โดยไม่มีชั้นใช้ฟรี Google ไม่ได้เผยขีดจำกัดเฉพาะสำหรับ Live และให้ดู Google AI Studio เพื่อดูขีดจำกัดปัจจุบันของโปรเจกต์
โค้ดแอปเสียงเดิมนำกลับมาใช้ได้ไหม?
ส่วนใหญ่ฝั่ง Gemini และน้อยกว่าฝั่ง OpenAI โค้ดที่เขียนสำหรับ Gemini 3.1 Flash Live ส่วนใหญ่ต้องแค่เปลี่ยนสตริงโมเดล โดยตัดการตั้งค่า thinking_level ออก ซึ่ง gemini-3.8-live ไม่รองรับ นอกจากนี้ให้ลบ enable_affective_dialog และ proactive_audio: false หากโค้ดของคุณยังพกพามาจากรุ่นเก่า GPT-Live-1 ใช้ปลายทาง v1/live/sessions ของตนเองแทน v1/realtime ดังนั้นแอป Realtime API ต้องปรับ และ OpenAI ก็มีคู่มือย้ายให้
เสียงของ Gemini 3.8 Live มีวอเตอร์มาร์กไหม?
ได้ Google ระบุว่าเสียงทั้งหมดที่สร้างโดยผลิตภัณฑ์ AI ของตน รวมถึง Gemini 3.8 Live ทั้งสองรุ่น มีวอเตอร์มาร์ก SynthID ที่ผู้ฟังไม่ได้ยิน ช่วยได้หากต้องแสดงหลักฐานว่าผู้โทรได้ยินเสียงสังเคราะห์
ผู้ช่วยเสียงรุ่นเก่ามักโต้ตอบแบบผลัดกันพูด: ผู้ใช้พูด รอ แล้วค่อยได้คำตอบ Gemini 3.8 Live ของ Google และ GPT-Live-1 ของ OpenAI เป็นเอเยนต์เสียงแบบเรียลไทม์ที่รองรับการขัดจังหวะและการเปลี่ยนใจกลางประโยค ทั้งสองไม่ได้เหนือกว่าอีกฝ่ายไปเสียทุกด้าน
ความต่างอยู่ที่จุดที่การคิดเกิดขึ้น Gemini 3.8 Live รับฟังคุณ มองผ่านกล้องได้ ให้เหตุผล และตัดสินใจว่าเมื่อใดจะขอให้แอปของคุณลงมือทำ GPT-Live-1 เน้นที่บทสนทนาและฟังไปพูดไปได้ เมื่อ GPT-Live-1 ต้องคิดยากขึ้นหรือทำแอคชัน จะส่งงานต่อให้โมเดลหรือบริการตัวที่สองที่เรียกว่าแบ็กเอนด์
OpenAI นำ GPT-Live-1 มาไว้ใน API เมื่อกันยายนที่ผ่านมา และ Google ก็เปิดตัว Gemini 3.8 Live ในอีกไม่ถึงสัปดาห์ บทความภาพรวม Gemini 3.8 Live ของเรา ครอบคลุมรายละเอียดการเปิดตัวของ Google หากต้องการลงมือสร้างด้วยตัวใดตัวหนึ่ง ลองดูบทเรียน Gemini 3.8 Live และบทเรียน API ของ GPT-Live-1 สำหรับการตั้งค่า
สรุปสั้นๆ
ไม่มีเวลาอ่านยาว? นี่คือการเปรียบเทียบ 6 ข้อ:
ข้อกำหนดเรื่องกล้องหรือแบ็กเอนด์ที่มีอยู่แล้ว อาจชี้ขาดได้ก่อนคะแนนบนตาราง รายละเอียดอยู่ในตารางด้านล่าง