Gemini 3.8 Live と GPT-Live-1 の概要比較
以下の表では伝わりにくい点があります。どちらの場合も、実際の作業(関数の実行やユーザーの要望の管理など)は最終的に自分のアプリが担います。
|
比較項目 |
Gemini 3.8 Live |
GPT-Live-1 |
|
役割 |
聞く・見る・推論する・アプリに実行を依頼するまでを1つのモデルで担当 |
会話する音声モデル。難しい処理はバックエンドに委譲 |
|
モデル ID |
|
|
|
ネイティブ入力 |
テキスト、音声、画像、動画フレーム |
テキストと音声のみ |
|
高度な推論の実行場所 |
モデル内部(Extended Thinking で推論量が増加) |
選択したバックエンド内 |
|
関数実行者 |
アプリケーション側(検索の根拠付けは Google 側で実行) |
アプリケーション側。Web 検索などのホストツールはバックエンドと連携 |
|
課金単位 |
トークン(思考トークンを含む) |
接続セッションの分課金+バックエンド使用量 |
|
無料枠 |
あり |
なし |
Gemini 3.8 Live と GPT-Live-1 とは?
いずれも音声入出力のモデルで、音声を入力し、文字起こしを挟まずに音声で出力します。
Gemini 3.8 Live とは?
Gemini 3.8 Live は Google の低レイテンシなライブ対話モデルです。テキスト、画像、音声、動画を受け付け、ターン間で推論し、非同期に関数を呼び出します。両方の Gemini バリアントは、それぞれのモデルページに入力上限 131,072 トークンを掲示しています。
Gemini 3.8 Live Extended Thinking は設定ではなく別モデルです。進捗を口頭で説明しながら、バックグラウンド推論を低・中・高のレベルで追加します.
Google のリリースノートでは両モデル ID が GA とされていますが、Live API の機能ガイドでは API がプレビュー表記のままです。
GPT-Live-1 とは?
GPT-Live-1 は OpenAI の全二重音声モデルです。全二重とは、イントロで述べた「話しながら聞く」挙動の技術用語です。
OpenAI はバックエンドへの引き継ぎを delegation(委譲)と呼びます。音声は、処理が走っている間も話し続けられます。
GPT-Live-1 は、OpenAI の GPT-Realtime-2 系列や委譲先のバックエンドモデルとは別製品です。GPT-Realtime-2.1 は推論とツールを1つのリアルタイムモデルに内包しているため、ここで述べる委譲の話は GPT-Live-1 のみが対象です。
Gemini 3.8 Live と GPT-Live-1 の最大の違いは?
TL;DR が要点でしたが、ここで詳しく説明します。Gemini 3.8 Live はライブセッション内で関数呼び出しを選択します。一方で GPT-Live-1 は推論を別のバックエンドに手渡します。どちらの設計でも、自分の関数は自分のアプリケーションが実行します。
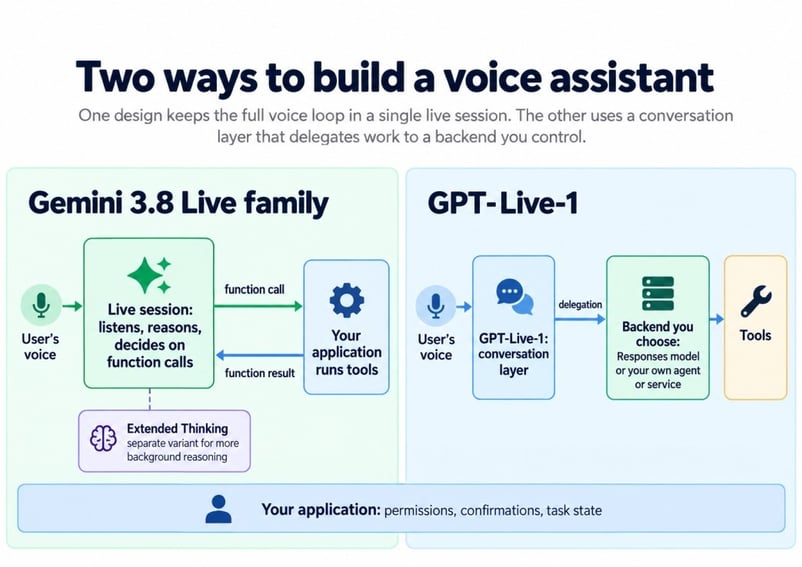
各モデルが「考える場所」。画像:筆者作成。
この分岐に、以降の多くの違いが紐づきます。まずはそれぞれの仕組みから。
Gemini 3.8 Live が1セッション内で計画する方法
Gemini では第2のモデルを設定する必要はありません。ライブモデルはデータが必要になると関数呼び出しを出力し、クライアントは結果を返します。詳しくは Google の Thinking ガイドを参照してください。
Extended Thinking に切り替えても同じ WebSocket エンドポイントを使い、バックエンドモデルは不要ですが、クライアントコードには変更が必要です。
GPT-Live-1 の委譲の仕組み
GPT-Live-1 は音声処理を担当し、いつ支援を求めるかを判断します。バックエンドは推論、ツール、ビジネスルールを担当します。OpenAI のプロンプトガイドでは、タスク手順の全体をバックエンド側の指示に記述します。
Responses 委譲では、OpenAI が設定したモデルを実行します。Client 委譲では、アプリケーション側で動かす任意のモデルやサービスに処理を渡します。いずれの場合も、委譲ガイドによれば、アプリケーションが権限、記録、タスク状態を保持します。
このアーキテクチャ差が重要な理由
分割の代償は、音声セッション、バックエンド、両者で共有する状態というコンポーネントの増加です。その代わり、音声部分に手を入れずに推論モデルを差し替えられます。
バックエンドがまだない場合は負担に見えますが、既存のエージェントを声を変えずにアップグレードしたい場合には有利です。
割り込みへの対応は?
どちらも割り込みに対応しますが、GPT-Live-1 はそれを中心に、ポーズや相づち(聞き手の「うんうん」)まで含めて設計されています。Gemini 3.8 Live はbarge-in をサポートし、プロアクティブ音声は常時オンですが、Google のドキュメントでは「全二重」とは明言していません。
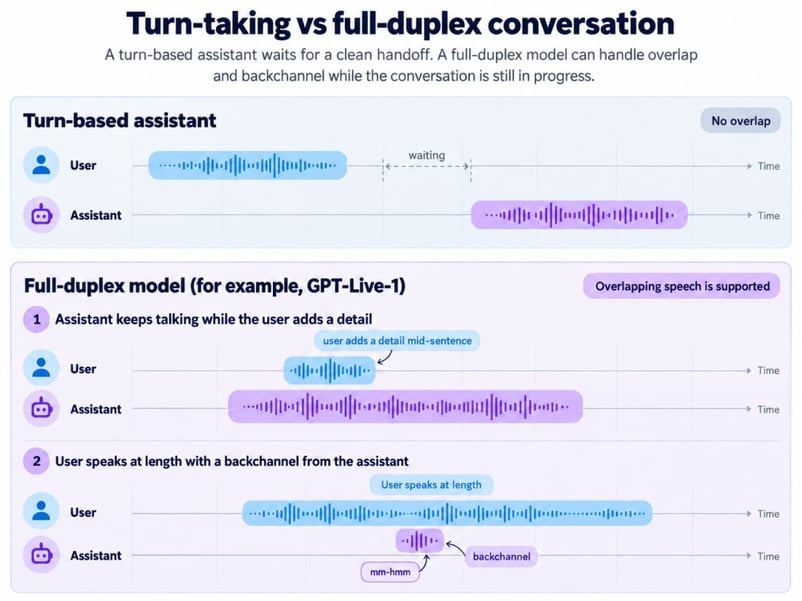
交互会話 vs 同時会話。画像:筆者作成。
OpenAI の発表記事では、語学アプリ Speak が「GPT-Live-1 により、ターン制システムに比べて割り込みが約80%減少した」と述べています。これは顧客の主張であり、独立した検証ではありません。
Gemini では、プロアクティブ音声により、モデルは自分宛てでない発話をスキップできます。Gemini のチュートリアルでは、ノート PC のスピーカー音がマイクに回り込むと、ユーザーの割り込みとして扱われることが分かりました。ヘッドフォンあり/なしでの動作をテストしてください。
推論とツール呼び出しの扱いは?
Gemini はベースの Live から Extended Thinking に切り替えて推論をスケールします。GPT-Live-1 はバックエンドを変えてスケールするため、比較するなら Extended Thinking と、音声モデル単体ではなくバックエンド込みの GPT-Live-1 構成にしてください。
Gemini 3.8 Live と Extended Thinking の違い
ベースの Gemini 3.8 Live には thinking_level 設定がなく、レガシーコード向けに BLOCKING 関数を受け付けます。Extended Thinking ではクライアント側の挙動が4点変わります。
-
ツール:
NON_BLOCKINGのみ有効。ブロッキング関数はハードエラーに。 -
思考レベル:最小レベルはなく、前述の3段階のみ。
-
ターンの終わり:
turnComplete: trueは完了を意味しなくなるため、クライアントはinteraction_statusがIDLEになるまで監視。 -
スケジューリング:関数のスケジューリングは非対応。
Google は、複数ステップのタスクや遅いツールには Extended Thinking を推奨しています。その分、レイテンシと出力トークンが増えます。
1点、ドキュメントで気になったことがあります。発表記事では「Gemini 3.8 Live はバックグラウンドでタスクを進めながら会話を続けられる」とありますが、Thinking ガイドではベースモデルは「ツール実行を待ってから話す」と書かれています。天気の照会でも後者の挙動を確認したため、Google の明確化があるまではガイドの記述に合わせて計画することを勧めます。
GPT-Live-1 と組み合わせるバックエンドモデルは?
GPT-Live-1 は、設定した任意のバックエンドの前段に置けます。OpenAI のドキュメントは 3 つの GPT-6 バックエンドを指しています。
-
GPT-6 Luna(
gpt-6-luna):委譲ガイドの推奨スタートポイント -
GPT-6 Sol(
gpt-6-sol):より難しいタスク向けの提案 -
GPT-6 Astra:複雑な顧客対応に推奨(発表記事)
Artificial Analysis の「GPT-Live-1 (Astra, medium)」「GPT-Live-1 (Sol, low)」は音声モデルのバージョンではなくシステム構成を指します。Artificial Analysis は Sol の世代を明記しておらず、OpenAI はその後にGPT-6.1 Sol をリリースしました。
通話中に依頼内容が途中で変わったら
たとえば予約の変更を金曜にと依頼した後、検索中に「やっぱり木曜で」と言い直した場合、有効なのは後者だけです。
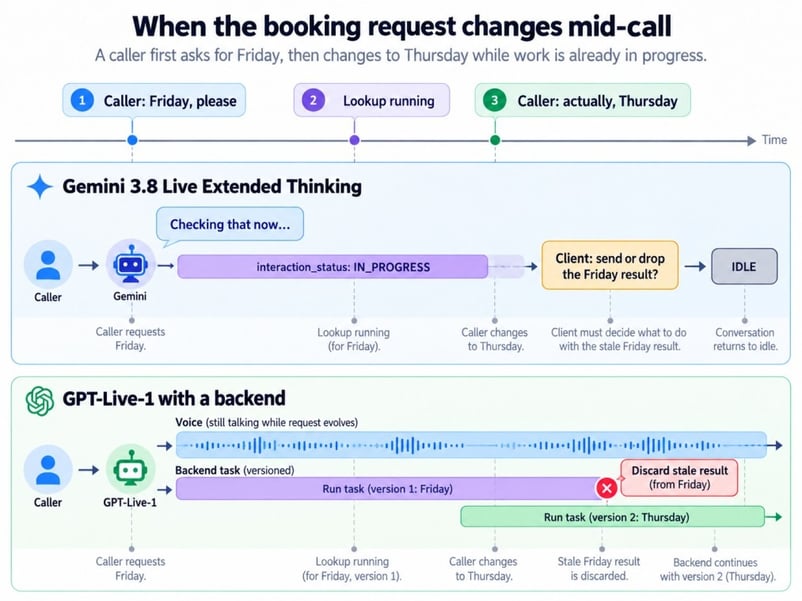
遅い処理中の依頼変更。画像:筆者作成。
GPT-Live-1 では、音声を割り込んでもバックエンド処理はキャンセルされません。Responses 委譲では古い結果が音声に戻る可能性があり、Client 委譲ならコード側で事前に捨てられます。
Gemini では、クライアントが古いツールの結果を破棄できます。いずれにせよ、現在のタスクを決めるのはアプリケーションです。
画像と動画のサポートは?
Gemini 3.8 Live は画像と動画をネイティブに受け付け、GPT-Live-1 はどちらも非対応です。GPT-Live-1 のアプリでも別のビジョンバックエンドに写真を送ることは可能ですが、ライブカメラを自ら視聴することはできません。
Gemini の場合、フレームは音声と同じセッションに入るため、ユーザーが機器をかざしながら「このケーブルで合っていますか?」と尋ねると、その場で答えられます。その代償が2つあります。動画フレームはデフォルトで送信され、Google のセッションガイドでは、音声+動画のセッションは最長2分、音声のみは15分に制限(コンテキストウィンドウの圧縮を有効化しない限り)としています。
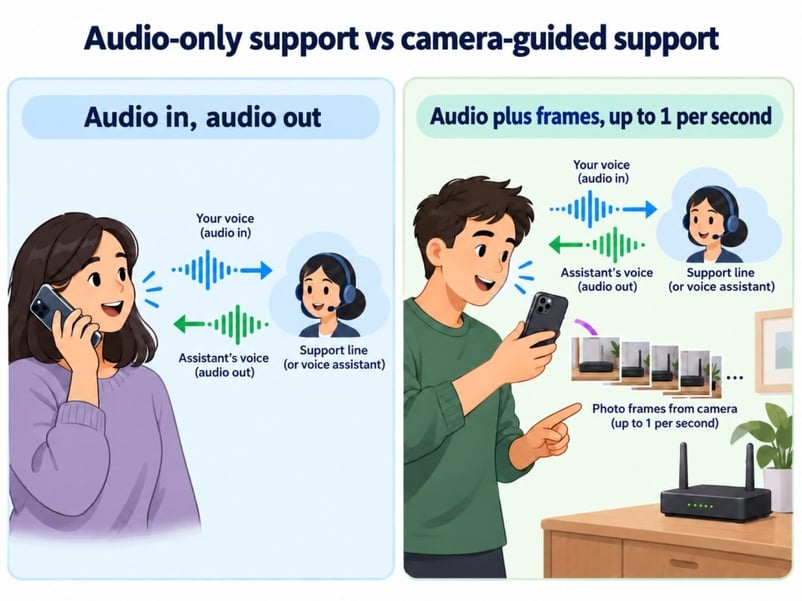
電話対応 vs カメラを使う修理対応。画像:筆者作成。
予約窓口ではフレームを見ることはありませんし、以下の音声ベンチマークはビジョンを測定していません。
Gemini 3.8 Live と GPT-Live-1 のベンチマーク
単一のベンチマークで結論は出ません。2モデルの4構成のうち、メイン指標では Astra が首位、会話ダイナミクスでは Sol が首位、Arena Elo はベースの Gemini が4構成中で最高です。
まず、指数の仕組みから。多くの差はこれで説明がつきます。
Artificial Analysis Speech to Speech Index の仕組み
この指数は4つの異なるスキルを同等に重みづけします。
- Big Bench Audio:音声で出題される推論問題
- τ-Voice:フライト変更などの複数ステップのカスタマーサービス作業
- Arena スコア:どのエージェントを好むかのブラインドな人手投票
- タスク成功率:会話が正しい最終ツール呼び出しで終わった割合
会話ダイナミクスは、v2.0 の方法論に基づき別途報告されます。
ここで重要なのは次の4構成です。
|
構成 |
Index |
Big Bench Audio |
τ-Voice |
会話ダイナミクス |
Arena Elo |
タスク成功 |
TTFA |
|
GPT-Live-1 (Astra, medium) |
83.2 |
90.1% |
74.5% |
94.9% |
1027 |
87.4% |
1.34 s |
|
Gemini 3.8 Live Extended Thinking (High) |
82.6 |
97.7% |
68.6% |
91.9% |
966 |
89.1% |
1.35 s |
|
GPT-Live-1 (Sol, low) |
80.1 |
89.0% |
59.3% |
97.3% |
1037 |
90.9% |
1.24 s |
|
Gemini 3.8 Live |
74.5 |
91.7% |
30.1% |
96.1% |
1074 |
93.2% |
1.18 s |
両方の GPT-Live-1 の τ-Voice スコアは1回の試行に基づくため、慎重に扱ってください。
エージェントタスク vs 人の好みスコア
τ-Voice では、Astra が 74.5%、Extended Thinking が 68.6%、ベースの Gemini が 30.1%。ツールを連携させると、追加の推論が効いてきます。
会話では様相が異なり、Sol が最高。Arena の信頼区間はベースの Gemini と Sol で重なっています。
指数で Astra と Extended Thinking の差は 0.6 ポイントで、信頼区間は公表されていません。すでに両者が順位を入れ替えたこともあるため、現時点では引き分けと見なします。
どちらが速く応答する?
TTFA(最初の音声トークンが出るまでの時間)は、ベースの Gemini 3.8 Live が表中で最速ですが、4構成全体の差は 0.2 秒未満です。
TTFA は、割り込みへの反応や、予約・検索の完了までの時間は捉えません。後者は主にバックエンドとツールに依存します。
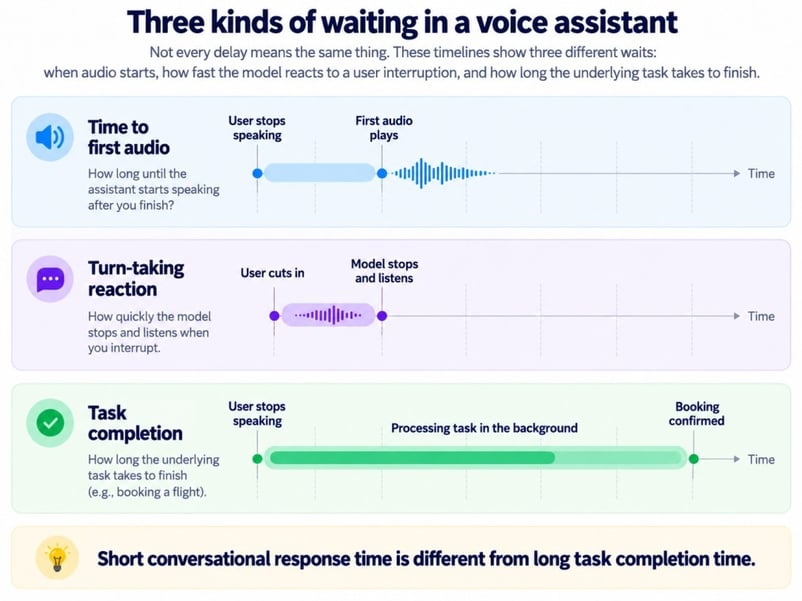
音声で発生する3種類の待ち時間。画像:筆者作成。
Extended Thinking と GPT-Live-1 のどちらも、遅い検索中に話し続けられます。とはいえ、発信者は予約の完了を待つことに変わりありません。
音声ベンチマークが測らないもの
サポート窓口にとって、ランキングでは分からない点があります。
- 電話事業者とコーデックが音声を劣化なく運べるか
- 10分後もスクリプトに従えているか
- 雑音の多い路上で強い訛りの発話をどう聞き取るか
- バックエンドとツールのコストを含めた実際の通話単価
自社の録音を使ったパイロットが、これらには最適な答えを出します。
料金比較:どちらが安い?
Artificial Analysis のテストではベースの Gemini が最安でしたが、課金対象が異なります。表示単価よりも、タスク完了あたりのコストが重要です。
以下のレートは、執筆時点のGoogle の料金ページと GPT-Live-1 のモデルページの定価で、Gemini の分単価はトークン価格から Google 自身が換算した値です。
|
費目 |
Gemini 3.8 Live/Extended Thinking(有料ティア) |
GPT-Live-1 |
|
音声入力 |
$3.00/100万トークン(約 $0.005/分) |
$0.05/分に含まれる(秒課金) |
|
音声出力 |
$12.00/100万トークン(約 $0.018/分) |
同じセッション料金に含まれる |
|
画像・動画入力 |
$1.00/100万トークン(約 $0.002/分) |
非対応 |
|
推論 |
思考トークンは出力レートで課金 |
バックエンドモデルのトークンをそのモデルの価格で課金 |
|
検索・ツール |
月 5,000 件まで無料、その後 $14/1,000 件 |
使用するバックエンドモデル・ツール側で課金 |
思考トークンにより、Extended Thinking はベースの Gemini より高くつきます。Artificial Analysis の推定では、入力音声1時間あたりの費用は、ベース Gemini が $0.84、Extended Thinking が $3.50、Sol が $4.47、Astra が $5.83(ツールとキャッシュ割引を除く)。Gemini Live はキャッシング非対応ですが、GPT-Live-1 のバックエンドは対応可能です。
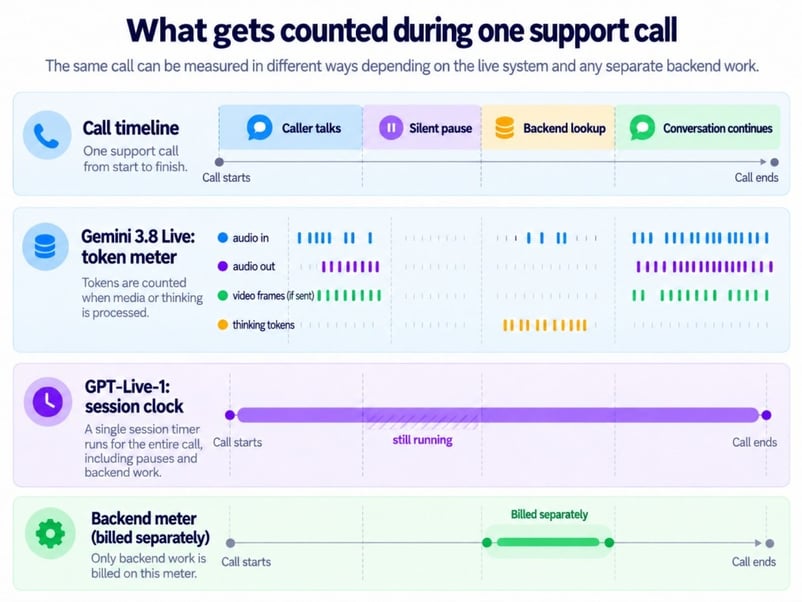
通話中に各メーターが数えるもの。画像:筆者作成。
GPT-Live-1 のクロックは無音でも回り、ミュートしても止まりません。表の費用と電話回線の費用を合算し、完了タスク数で割って評価してください。
ブラウザ・サーバー・電話でのサポート
ブラウザとサーバーのアプリはいずれのモデルにも接続できますが、電話展開で差が出ます。図は接続オプションを示し、運用面の違いは接続の寿命と、通話経路上に誰が入るかです。
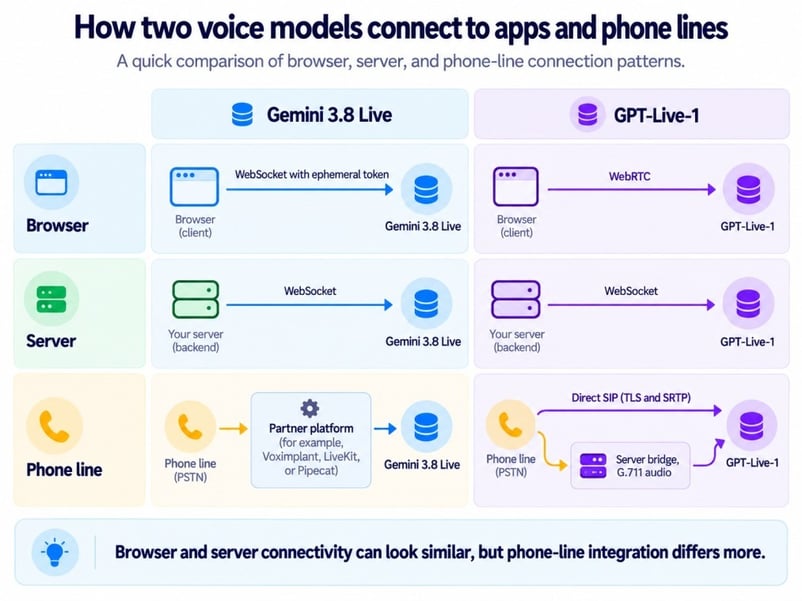
ブラウザ/サーバー/電話の接続経路。画像:筆者作成。
Gemini の接続は約10分でリセットされるため、長い通話ではセッション再開が必要です。GPT-Live-1 では、音声接続と委譲したバックエンド処理を別々にログ取りしてください。
電話と SIP サポート
直接 SIP 接続できる GPT-Live-1 は、通話経路のベンダーが1つ少なくて済みます。Gemini のパートナー経由は、設定・監視・デバッグすべきサービスが1つ増えます。
OpenAI フォーラムでは、いくつかの開発者が、GPT-Live-1 がアクションを約束しつつ、委譲を作成しないケースを報告しています。OpenAI サポートはバグ認定はせず、プロンプトガイドを参照するよう案内しました。同ガイドでは、「口頭での了承」はバックエンド処理開始の確約ではないと注意しています。音声とは別に、委譲イベントをログすることを推奨します。
11月2日以降、OpenAI は全組織向けに発信側の SIP 通話もサポートし、GPT-Live-1 は受電だけでなく発信も可能になりました。
どちらを使うべきか?
選択の軸は2つです。「アシスタントは見る必要があるか」「既にバックエンドがあるか」。前者が Yes なら Gemini、後者が Yes なら GPT-Live-1 が有力です。
自分のプロダクトに当てはまるシナリオに飛んでください。
電話サポートと予約
電話窓口では、割り込み対応と不可逆な処理の前の確認が必須です。SIP 対応(前述)と、予約ロジックをバックエンド側に保てる点から、GPT-Live-1 は相性が良いでしょう。
カメラや画面のトラブルシューティング
ユーザーがスマホをルーターに向けるような場面では、その場で見ている内容について推論する必要があります。Gemini 3.8 Live は、別コンポーネントを用意せず1セッションで対応できます。画像の節にあった「動画2分上限」を考慮して設計してください。
バックグラウンドでの複数ステップ作業
ツール連携が連鎖するタスクでは、Extended Thinking と、Astra を組み合わせた GPT-Live-1 を比較してください。τ-Voice では Astra が1回の試行で首位ですが、要は推論をどこに置くかの選択です。
既存エージェントへの音声追加
Client 委譲なら、既存エージェントの推論ループを書き換えずに GPT-Live-1 を追加できます。Gemini では、ライブモデルがプランナーの役割になります。
高い通話量と厳しい予算
短く単純な通話であれば、Artificial Analysis のテストで最安だったベースの Gemini が有力です。複数ステップのツール連携があると計算は変わります。
まとめ
最も分かりやすい整理は、Gemini 3.8 Live は「見る・考える・話す」を1モデルに統合し、GPT-Live-1 は声とその背後の知能を分離する、ということです。どちらかが圧勝というわけではなく、人間らしさや応答速度は拮抗しているため、実際の選択はアーキテクチャで決まるでしょう。
興味深いのは、エージェントタスクでの優位が Astra を組み合わせた GPT-Live-1 に素早く傾いたことです。あのスコアは音声モデル単体ではなくシステム全体のものです。つまり委譲のメリットが表れたと言えます。ただし、1回の試行はシグナルであって結論ではありません。
もう1点注目すべきは OpenAI のバックエンドのラインアップです。GPT-6.1 Sol は 2026 年 9 月下旬に登場しました。各バックエンドの更新で、声に触れずとも GPT-Live-1 のスコアは動きます。一方、Google の同等の変更はライブモデルの切り替えを意味します。
現時点では、カメラを使う用途には Gemini 3.8 Live が、既存バックエンドを持つ電話プロダクトには GPT-Live-1 が選びやすいでしょう。いずれの場合も、金曜から木曜への予約変更のような問題は、最終的にコードで扱う必要があります。
いずれの道にも共通するエージェントの基本概念(ツール、メモリ、計画)については、Introduction to AI Agents コースをご覧ください。
FAQs
GPT-Live-1 はバックエンドに Gemini モデルを使えますか?
はい。Client 委譲を使えば、自前のバックエンドの背後で Gemini のテキストモデルに処理を送れます。音声分は OpenAI に、バックエンドのトークン分は Google に支払うことになります。
GPT-Live-1 の会話はどれくらいの長さまで文脈に残りますか?
GPT-Live-1 のコンテキストウィンドウは 128,000 トークンで、文字起こしだけでなく音声トークンも数えます。使用率が 90% を超えると、直近最大 8,192 トークンの履歴と要約を引き継ぐ代替音声エンジンが起動します。確定したアクションやタスク状態は、必ず自分のアプリケーション側で保持してください。
Gemini 3.8 Live と GPT-Live-1 にはどんなレート制限がありますか?
GPT-Live-1 は Build で同時セッション 50、Launch で 300、Grow で 500 を許可し、無料枠はありません。Google は Live 単体の上限を公開しておらず、現在の上限は Google AI Studio を参照するよう案内しています。
既存の音声アプリのコードは再利用できますか?
主に Gemini で互換性があり、OpenAI はやや少なめです。Gemini 3.1 Flash Live 向けに書いたコードは、基本的にモデル文字列を更新するだけで動きますが、thinking_level 設定は gemini-3.8-live が受け付けないため削除してください。また、古いモデルから引き継いでいる場合は enable_affective_dialog と proactive_audio: false も外してください。GPT-Live-1 は v1/live/sessions エンドポイントを使い、 v1/realtime ではないため、Realtime API アプリは移行が必要です。OpenAI は移行ガイドを公開しています。
Gemini 3.8 Live の音声は透かし入りですか?
はい。Google は、Gemini 3.8 Live の両モデルを含む AI 生成音声のすべてに、リスナーには聞こえない SynthID 透かしが入ると述べています。通話者が合成音声を聞いた事実を示す必要が生じた場合に役立ちます。
従来の音声アシスタントは主に交互会話でした。話して、待って、返答を聞くという流れです。Google の Gemini 3.8 Live と OpenAI の GPT-Live-1 は、割り込みや話の途中での変更にも対応できるリアルタイム音声エージェントです。どちらが一方的に優れているというものではありません。
違いは「どこで考えるか」です。Gemini 3.8 Live はユーザーの声を聞き、カメラ入力も観察し、推論したうえで、いつアプリにアクションを依頼するかを判断します。GPT-Live-1 は会話に特化し、話しながら聞くことができます。より難しい推論やアクションが必要なときは、バックエンドと呼ばれる第2のモデルやサービスに処理を引き継ぎます。
OpenAI はこの9月に GPT-Live-1 を API に導入し、Google はその1週間足らず後に Gemini 3.8 Live をリリースしました。Gemini 3.8 Live の概要では Google の発表を取り上げています。どちらかで開発したい場合は、Gemini 3.8 Live のチュートリアルと GPT-Live-1 API チュートリアルでセットアップを解説しています。
TL;DR
時間がない方向けに、6つのポイントで比較します。
カメラ要件や既存バックエンドの有無で、ベンチマークを見る前に選択が決まることがあります。以下の表がその理由を示します。