
Gemini 3.8 Live 与 GPT-Live-1 一览
下表之外要补充的一点是,两种方案都仍需您的应用实际完成工作,例如运行您的函数并跟踪用户的请求。
|
对比点 |
Gemini 3.8 Live |
GPT-Live-1 |
|
角色 |
单一模型:聆听、观察、推理,并请求您的应用执行 |
语音模型:负责对话,将更难的工作交给后端 |
|
模型 ID |
|
|
|
原生输入 |
文本、音频、图像、视频帧 |
仅文本与音频 |
|
更深层推理所在 |
模型内部;启用 Extended Thinking 时更强 |
您选择的后端 |
|
由谁运行您的函数 |
您的应用(Search grounding 在 Google 侧运行) |
您的应用;托管工具(如网页搜索)随后端运行 |
|
计费单位 |
Token(含思考 Token) |
连接会话分钟数,外加后端用量 |
|
免费层 |
有 |
无 |
什么是 Gemini 3.8 Live 和 GPT-Live-1?
两者都是语音到语音模型:音频输入、音频输出,无需独立转写步骤。
什么是 Gemini 3.8 Live?
Gemini 3.8 Live 是 Google 的低时延实时对话模型。它可接收文本、图像、音频和视频,在轮次之间推理,并异步调用函数。两款 Gemini 变体的模型页面均列出 131,072 个 token 的输入上限,见其模型页面。
Gemini 3.8 Live Extended Thinking 是独立模型,而非开关。它在讲述进度的同时,按低/中/高级别加入后台推理。
Google 的版本说明显示两款模型 ID 均已普遍可用,但Live API 能力指南仍将该 API 标注为预览。
什么是 GPT-Live-1?
GPT-Live-1 是 OpenAI 的全双工语音模型。全双工是我在引言中描述的“边说边听”行为的技术称谓。
OpenAI 将交给后端处理称为“委派”。语音可在这项工作进行时继续说话。
GPT-Live-1 也不同于 OpenAI 的 GPT-Realtime-2 系列或其委派用的后端模型。GPT-Realtime-2.1 将推理与工具保留在一个实时模型中,因此本文关于委派的讨论仅适用于 GPT-Live-1。
Gemini 3.8 Live 与 GPT-Live-1 的主要区别是什么?
要点速览给了简版,这里是完整版。Gemini 3.8 Live 在实时会话内决定函数调用;GPT-Live-1 则将推理交给独立后端。在两种方案中,您的应用都负责运行自己的函数。
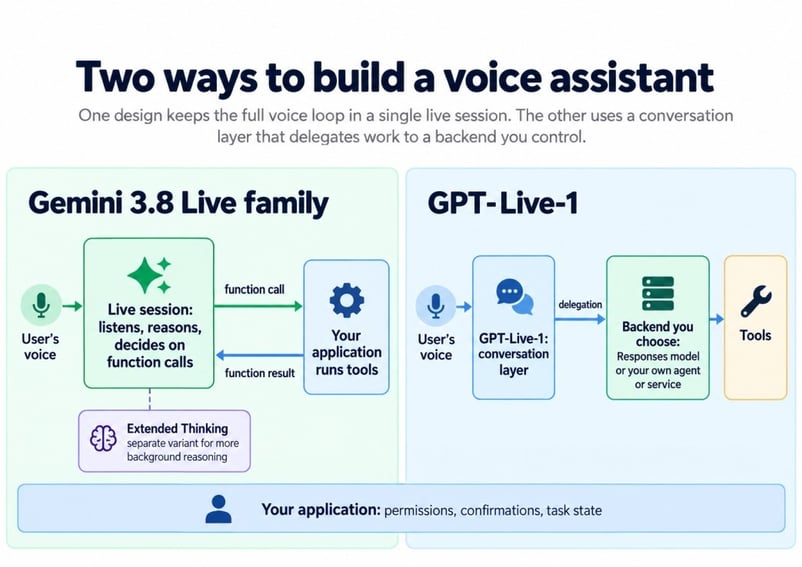
两者对“思考”的安置。作者制图。
后文大多由这一分工延展而来,先分述两侧。
Gemini 3.8 Live 如何在单一会话内规划
使用 Gemini 时,无需配置第二个模型。实时模型在需要数据时发出函数调用,您的客户端返回结果,详见 Google 的思考指南。
切换到 Extended Thinking 仍使用同一 WebSocket 端点,也不需要后端模型,但客户端代码会有变更。
GPT-Live-1 的委派如何工作
GPT-Live-1 处理语音并决定何时寻求帮助;后端负责推理、工具与业务规则。OpenAI 的提示指南将完整任务流程写入后端的指令中。
使用 Responses 委派时,由 OpenAI 运行您配置的模型;使用客户端委派时,工作交给您应用运行的任意模型或服务。无论哪种方式,委派指南都指出您应当拥有权限、记录与任务状态。
架构差异为何重要
分层的代价是更多部件:一条语音会话、一个后端,以及两者共享的状态。回报是,您可以在不动语音层的情况下更换推理模型。
如果您尚无后端,这样的取舍看上去更麻烦;但若要在不改动语音的前提下升级既有代理,则更有优势。
Gemini 3.8 Live 和 GPT-Live-1 如何处理打断?
两者都能处理打断,但 GPT-Live-1 围绕打断、停顿与回声反馈(听者发出的“嗯哼”)而设计。Gemini 3.8 Live 支持barge-in(插话打断),而且其前馈音频始终开启,但 Google 文档并未称其为全双工。
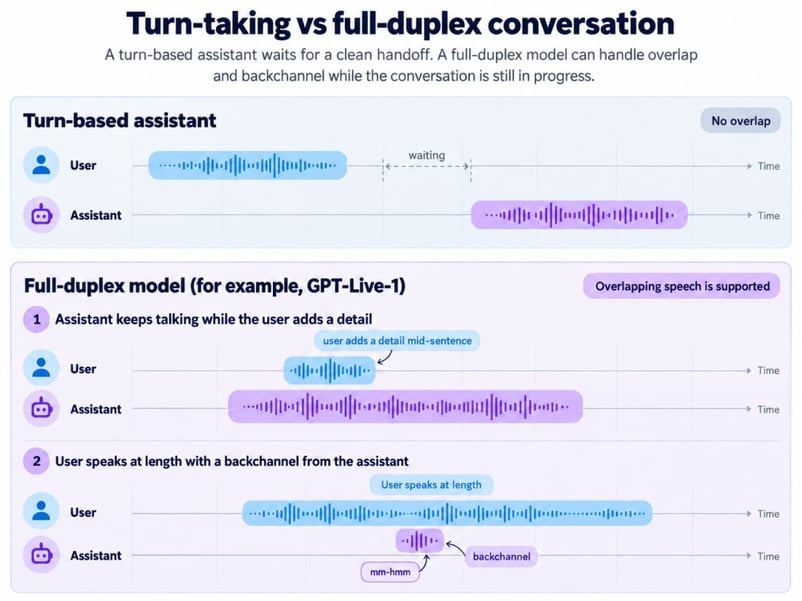
轮流说话 vs 同时说话。作者制图。
OpenAI 的发布帖引用语言学习应用 Speak 的说法称,GPT-Live-1 将打断比回合制系统减少了近 80%,这属客户陈述而非独立测试。
在 Gemini 上,前馈音频可让模型忽略并非对它说的话。我们的 Gemini 教程发现,笔记本扬声器外放漏进麦克风也会被视为用户插话,建议分别用/不用耳机进行测试。
Gemini 3.8 Live 和 GPT-Live-1 如何处理推理与工具调用?
Gemini 通过从基础版 Live 切换到 Extended Thinking 来扩展推理;GPT-Live-1 则通过更换后端来扩展。因此请将 Extended Thinking 与完整的 GPT-Live-1 方案对比,而非只看语音模型。
Gemini 3.8 Live vs. Gemini 3.8 Live Extended Thinking
基础版 Gemini 3.8 Live 没有 thinking_level 设置,并接受 BLOCKING 函数以兼容旧代码。Extended Thinking 改变了四处客户端行为:
-
工具:仅支持
NON_BLOCKING函数;阻塞函数会直接报错。 -
思考级别:没有最低选项,只有上述三档。
-
回合结束:
turnComplete: true不再表示模型已完成,客户端需监测interaction_status直至其为IDLE。 -
调度:不支持函数调度。
Google 建议在多步任务与慢工具场景使用 Extended Thinking,但其代价是更高的时延与输出 Token。
Google 文档里有一点让我困惑。发布帖称 Gemini 3.8 Live 可“在后台任务完成时继续对话”,但思考指南却说基础模型会“在说话前等待工具执行完成”。我们的 Gemini 教程在天气查询中观察到后者表现,因此在 Google 澄清前,我会按指南来规划。
GPT-Live-1 可搭配哪些后端模型?
GPT-Live-1 可置于任意您配置的后端之前。OpenAI 文档指向三款 GPT-6 后端:
-
GPT-6 Luna(
gpt-6-luna),委派指南建议的起点 -
GPT-6 Sol(
gpt-6-sol),指南建议用于更难的任务 -
GPT-6 Astra,发布帖推荐用于复杂客户问题
Artificial Analysis 中的“GPT-Live-1(Astra,medium)”与“GPT-Live-1(Sol,low)”表示系统配置,而非语音模型版本。Artificial Analysis 未标明 Sol 的代际,且 OpenAI 在那些测试之后发布了GPT-6.1 Sol。
呼叫者在任务中途改口会发生什么
假设呼叫者请求将预订改到周五,查询尚在进行时又说“其实改到周四”。只有第二个请求应作数。
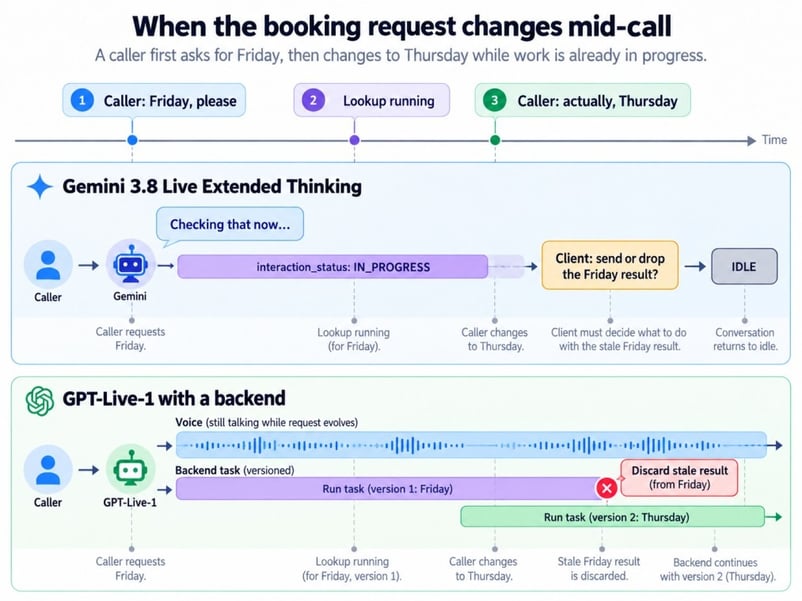
慢任务中的需求变更。作者制图。
在 GPT-Live-1 上,打断语音不会取消后端工作。使用 Responses 委派时,仍可能将旧结果返回给语音;使用客户端委派时,您的代码可先行丢弃旧结果。
在 Gemini 上,您的客户端也可丢弃过期的工具结果。无论哪种方式,当前任务由您的应用来界定。
是否支持图像与视频?
Gemini 3.8 Live 原生支持图像与视频;GPT-Live-1 标注两者均不支持。GPT-Live-1 应用仍可把照片发至独立的视觉后端,但自身无法观看实时摄像头。
对 Gemini 而言,视频帧与音频进入同一会话,因此用户举起线缆时,模型能回答“这是对的那根吗?”但需付出两点代价:默认会发送视频帧,且 Google 的会话指南规定同时含音频与视频的会话上限为 2 分钟,仅音频为 15 分钟,除非开启上下文窗口压缩。
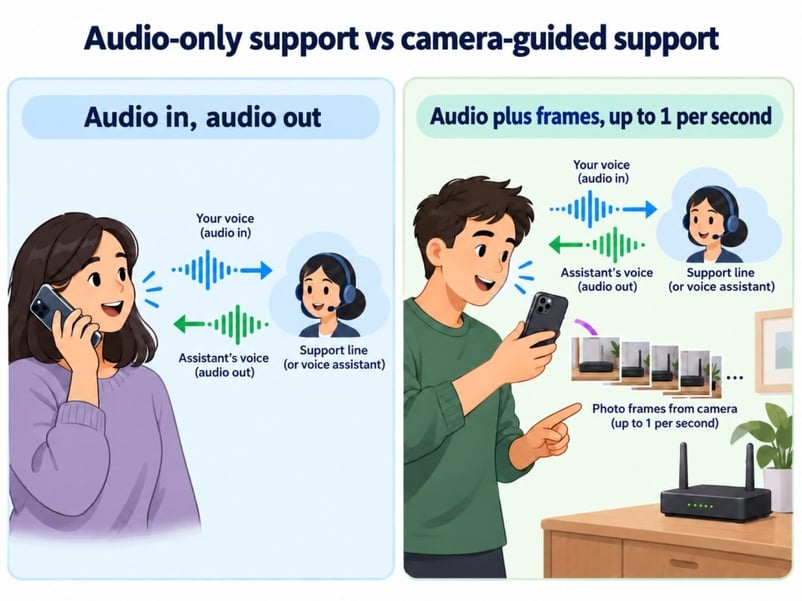
电话来电 vs 相机协助维修。作者制图。
订座热线从不涉及视频帧,而下文的语音榜单也不衡量视觉能力。
Gemini 3.8 Live vs. GPT-Live-1 基准测试
没有任何单一基准能定论这场对比。在两者的四种配置中,Astra 领跑主索引,Sol 领跑会话动态,基础版 Gemini 的 Arena Elo 则在四者中最高。
先看主索引如何计算,因为这能解释大部分差异。
Artificial Analysis 语音到语音索引的工作方式
该索引对四种不同能力等权计分:
- Big Bench Audio:口述的推理问题
- τ-Voice:多步客服任务,例如改签航班
- Arena 评分:盲测的人类偏好投票
- 任务成功率:对话以正确的最终工具调用收尾的频率
会话动态依据v2.0 方法单列报告。
这里是本文相关的四种配置。
|
配置 |
索引 |
Big Bench Audio |
τ-Voice |
会话动态 |
Arena Elo |
任务成功 |
TTFA |
|
GPT-Live-1(Astra,medium) |
83.2 |
90.1% |
74.5% |
94.9% |
1027 |
87.4% |
1.34 s |
|
Gemini 3.8 Live Extended Thinking(高) |
82.6 |
97.7% |
68.6% |
91.9% |
966 |
89.1% |
1.35 s |
|
GPT-Live-1(Sol,low) |
80.1 |
89.0% |
59.3% |
97.3% |
1037 |
90.9% |
1.24 s |
|
Gemini 3.8 Live |
74.5 |
91.7% |
30.1% |
96.1% |
1074 |
93.2% |
1.18 s |
两个 GPT-Live-1 的 τ-Voice 分数都来自一次试验,需谨慎看待。
代理任务 vs 人类偏好分
在 τ-Voice 上,Astra 为 74.5%,Extended Thinking 为 68.6%,基础版 Gemini 为 30.1%。一旦工具形成链路,额外的推理很重要。
会话方面则是另一番情形:Sol 最高,且基础版 Gemini 与 Sol 的 Arena 置信区间有重叠。
Astra 与 Extended Thinking 的主索引仅相差 0.6 分,未公布置信区间。二者已互换过名次,我仍将其视为不分伯仲。
哪款响应更快?
基础版 Gemini 3.8 Live 的首次音频时间(TTFA)最快,但四者的差距不足 0.2 秒。TTFA 指模型产出首个音频 Token 的用时。
TTFA 未体现对打断的响应,也未计及完成一次订座或查询的用时;后者更多取决于您的后端与工具。
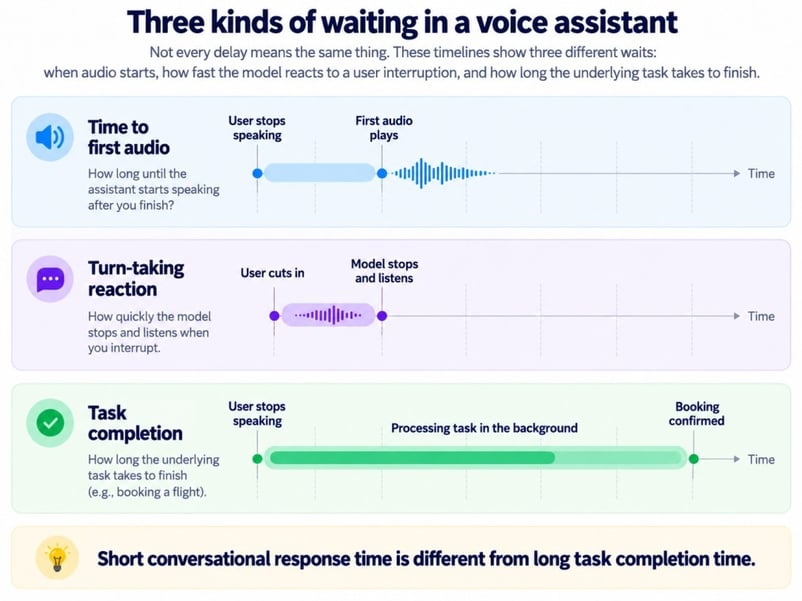
语音交互中的三种等待。作者制图。
Extended Thinking 与 GPT-Live-1 都能在慢查询时继续说话,但呼叫者仍在等待预订完成。
语音基准未衡量的内容
对于客服热线,榜单无法告诉您:
- 您的电话供应商与编解码器传输是否清晰
- 代理在 10 分钟后是否仍遵循脚本
- 嘈杂环境下、重口音来电者的听感如何
- 计入后端与工具后,通话成本是多少
使用您自己的录音做试点更能回答这些问题。
定价对比:哪款更便宜?
在 Artificial Analysis 的测试中,基础版 Gemini 成本最低,但两者的计费维度不同。每个成功任务的成本比标价更关键。
下述费率为撰文时 Google 定价页与 GPT-Live-1 模型页的标价,Gemini 的每分钟数据为 Google 按 Token 价换算。
|
费用项 |
Gemini 3.8 Live 与 Extended Thinking(付费层) |
GPT-Live-1 |
|
音频输入 |
每 100 万 Token $3.00(约 $0.005/分) |
包含于 $0.05/分的会话费,按秒计费 |
|
音频输出 |
每 100 万 Token $12.00(约 $0.018/分) |
同一会话费用覆盖 |
|
图像或视频输入 |
每 100 万 Token $1.00(约 $0.002/分) |
不支持 |
|
推理 |
思考 Token 按输出费率计费 |
后端模型 Token 按其价格计费 |
|
搜索与工具 |
每月 5,000 次免费 Search 请求,超出后每 1,000 次 $14 |
由您使用的后端模型与工具计费 |
思考 Token 使 Extended Thinking 比基础版 Gemini 更贵。Artificial Analysis 估算基础版 Gemini 的输入音频每小时 $0.84,Extended Thinking $3.50,Sol $4.47,Astra $5.83,均不含工具与缓存折扣。Gemini Live 不支持缓存;GPT-Live-1 的后端可以。
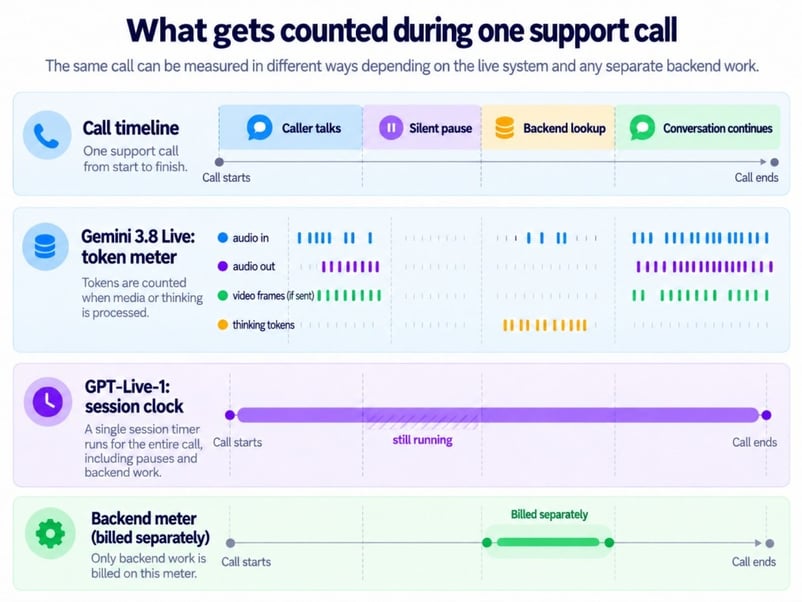
通话中各自计量的内容。作者制图。
GPT-Live-1 的时钟在静默中也继续计时,静音不会停止。将表中各项费用与电话成本相加,再除以完成的任务数。
浏览器、服务器与电话的支持情况
浏览器与服务器应用均可连接两种模型,但电话部署将二者区分开来。下图展示了连接方式;运维差异在于连接时长与谁位于通话路径中。
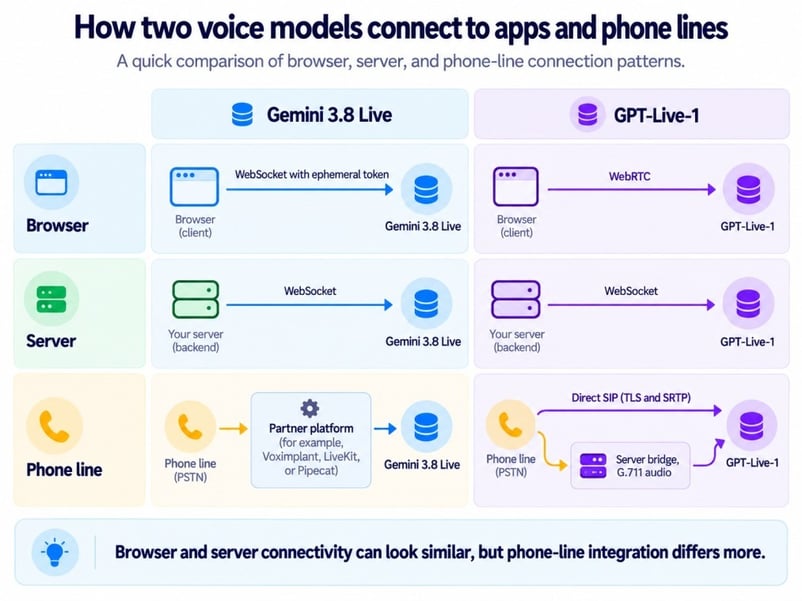
浏览器、服务器与电话的连接路径。作者制图。
Gemini 连接约 10 分钟后会重置,较长通话需要会话恢复。使用 GPT-Live-1 时,请分别记录语音连接与委派到后端的工作。
电话与 SIP 支持
直接 SIP 使 GPT-Live-1 的通话路径少一个厂商。Gemini 的合作方路径会多一项需要配置、监控与调试的服务。
有开发者在OpenAI 论坛反馈 GPT-Live-1 口头承诺执行动作却未创建委派。OpenAI 支持并未将其定性为缺陷,而是指向提示指南,说明口头确认并不代表后端工作已启动。建议将委派事件与语音输出分别记录。
自 11 月 2 日起,OpenAI 也支持所有组织进行外呼 SIP 通话,因此 GPT-Live-1 既可接听也可外拨。
Gemini 3.8 Live vs. GPT-Live-1:该用哪一个?
抉择归结为两问:助手是否需要“看”?您是否已有后端?前者为“是”更偏向 Gemini;后者为“是”更偏向 GPT-Live-1。
直接跳到与您产品相符的场景:
电话客服与预约
电话线需要处理打断,并在不可逆操作前进行确认。GPT-Live-1 很契合,具备上述 SIP 支持,且将订座逻辑保留在后端。
相机与屏幕排障
当用户将手机对准路由器时,模型必须对当下画面进行推理。Gemini 3.8 Live 可在一个会话内完成,无需额外视觉组件,但需考虑图像部分提到的 2 分钟视频上限。
后台的多步工作
对于串联多工具的任务,请将 Extended Thinking 与 GPT-Live-1 搭配 Astra 的方案对比。Astra 在一次试验中领跑 τ-Voice,因此选择仍取决于推理应驻留何处。
为现有代理添加语音
客户端委派可在不重写推理循环的情况下为既有代理加入 GPT-Live-1。使用 Gemini 时,实时模型将成为规划者。
高通话量且预算有限
短而简单的通话更指向基础版 Gemini,它在 Artificial Analysis 的测试中最省钱。多步工具会改变这笔账。
结语
最清晰的表述方式是:Gemini 3.8 Live 将“看、想、说”合于一体;GPT-Live-1 则将语音与其背后的智能分离。两者都不具备全面碾压优势,且在“更像人类、响应更快”上已足够接近,实际决策更多将由架构决定。
更有意思的是,代理任务的领先优势在搭配 Astra 的 GPT-Live-1 上升很快。该分数属于整个系统,而非仅语音模型,这是“委派”优势的直观体现——不过一次试验只是信号而非定论。
另一个值得关注的是 OpenAI 的后端阵容:GPT-6.1 Sol 于 2026 年 9 月下旬发布。每个新后端都能在不触碰语音层的情况下改变 GPT-Live-1 的成绩,而 Google 的相应变更意味着要切换实时模型。
目前,带相机的场景用 Gemini 3.8 Live 更省事;已有后端的电话类产品用 GPT-Live-1 更顺手。不论选哪条路,您的代码都要能处理“周五改到周四”的订座问题。
想要了解两条路径背后的代理概念,我们的AI 代理入门课程涵盖工具、记忆与规划。
FAQs
GPT-Live-1 能否使用 Gemini 模型作为后端?
可以。客户端委派可将工作发送到您后端所接入的 Gemini 文本模型。语音分钟费用支付给 OpenAI,后端 Token 费用支付给 Google。
GPT-Live-1 的对话能在上下文中维持多长?
可以。GPT-Live-1 具有 128,000 Token 的上下文窗口,统计的是音频 Token,而不仅是转写文本。一旦使用量超过 90%,它会启动替换的语音引擎,保留至多 8,192 个 Token 的近史与摘要,因此请将已确认的动作与任务状态保存在您自己的应用中。
Gemini 3.8 Live 与 GPT-Live-1 有哪些速率限制?
GPT-Live-1 的并发会话上限为:Build 套餐 50、Launch 套餐 300、Grow 套餐 500,且无免费层。Google 未单列 Live 的限额,建议在 Google AI Studio 查看您项目的当前限制。
我能复用现有语音应用的代码吗?
主要是 Gemini 侧需要调整,OpenAI 边相对较少。为 Gemini 3.1 Flash Live 编写的代码主要需要替换为新模型字符串,并移除任何 thinking_level 设置,gemini-3.8-live 不接受该项。还需删除从旧模型沿用的 enable_affective_dialog 与 proactive_audio: false。GPT-Live-1 使用独立的 v1/live/sessions 端点而非 v1/realtime,因此 Realtime API 应用需要重构,OpenAI 提供了迁移指南。
Gemini 3.8 Live 的音频是否带水印?
可以。Google 表示,其 AI 产品生成的所有音频(包括两款 Gemini 3.8 Live 模型)都带有听不见的 SynthID 水印,若您需要证明来电者听到了合成语音,这将有所帮助。

我是一名数据工程师兼社区建设者,专注于数据管道、云端与 AI 工具链,同时为 DataCamp 和新兴开发者撰写实用且高影响力的教程。
传统语音助手多为轮流说话:您说完,等待,然后它再回答。Google 的 Gemini 3.8 Live 和 OpenAI 的 GPT-Live-1 是可实时对话的语音代理,能处理打断与半句中的改口。两者并非全局一强。
不同点在于“思考”发生在哪里。Gemini 3.8 Live 负责聆听、可查看摄像头输入、进行推理,并决定何时请求您的应用执行动作。GPT-Live-1 则专注于对话,且能边说边听。当它需要更深的推理或执行动作时,会把工作交给名为后端的第二个模型或服务。
OpenAI 于 9 月将 GPT-Live-1 引入其 API,Google 随后不到一周发布了 Gemini 3.8 Live。我们的Gemini 3.8 Live 概览介绍了 Google 的发布。如需上手构建,可参考我们的 Gemini 3.8 Live 教程与 GPT-Live-1 API 教程完成配置。
要点速览
时间紧?六点对比如下:
是否需要摄像头或是否已有后端,往往会在榜单数据前就决定选型。下表说明了原因。