Previzualizarea următoarei piese arată litera tetromino-ului — O, I, T, S, Z — în loc să deseneze piesa. O poți citi odată ce cunoști notația, dar îți ia o clipă de fiecare dată când arunci o privire, iar asta contează la viteză. Niciun model nu a fost rugat să ofere previzualizare, deci este o alegere pe care Sol a oferit-o voluntar și apoi a executat-o cam minimal. Este singurul loc unde buildul mai finisat este cel mai puțin lizibil.
Ce a produs Claude Opus 5.5
Opus 5.5 a avut nevoie de 3 ture și 2 apeluri de instrumente, un glob și un write, pentru a livra un index.html de 19 KB numit „Flip Tetris”. Comentariul din antet este specificația mai atentă dintre cele două: un randomizator 7-bag pe un seed fix, rotație cu wall kicks, colapsul rândurilor per teanc și o notă că o piesă aflată în cădere își inversează pur și simplu direcția când se schimbă gravitația.
Jocul funcționează exact cum e descris și la fel de stabil ca al lui Sol, cu o „piesă fantomă” și o bară de countdown care devine roșie înainte de fiecare inversare. Previzualizarea următoarei piese desenează forma reală, ceea ce e alegerea corectă și singurul lucru pe care îl face mai bine decât Sol la o privire rapidă.
A adăugat și un contor de nivel pe care nu l-a cerut nimeni, iar eu l-aș considera egal, nu un plus: nivelurile cresc suficient de lent încât nu fac diferență până mult mai târziu într-un joc decât vor fi jucate realist aceste builduri. Unde pierde Opus este la senzație, nu la logică: layoutul este mai simplu decât al lui Sol și soft drop-ul este mai puțin fluid, așa că pierde un punct la calitatea vizuală și unul la completitudine.
Rezultate
| Măsură | GPT-6 Sol | Claude Opus 5.5 |
|---|---|---|
| Ture | 6 | 3 |
| Apeluri de instrumente | 9 | 2 |
| Cost | 0,26 $ | 0,87 $ |
| Total tokeni | 120.226 | 107.958 |
| Tokeni de raționare | 8.123 | 22.551 |
| Rulabilitate | pass | pass |
| Mecanica flipului | 5 | 5 |
| Completitudinea jocului | 5 | 4 |
| Calitate vizuală și senzație | 5 | 4 |
| Scor pe rubrică (media celor trei axe) | 5 | 4,3 |
GPT-6 Sol câștigă acest test, dar la limită și nu pe partea grea. Ambele au rezolvat corect inversarea gravitației, deci diferența a ținut de execuție, iar receptivitatea și finisajul vizual al lui Sol îi dau un mic avantaj față de Opus.
Ce le separă mai clar este costul rulărilor. Opus 5.5 a cheltuit 0,87 $ față de 0,26 $ pentru Sol, de peste trei ori mai mult, și a făcut asta pe mai puțini tokeni în total: 108k față de 120k. Diferența este raționarea: Opus a „gândit” cam de trei ori mai intens per tură, a ajuns la un build corect în jumătate din ture și s-a oprit. Sol a iterat în fișier, ieftin, și a ieșit ușor în față la senzație.
Aceasta este o singură rulare a unei singure sarcini la un singur nivel de efort și sondează logica buclei de joc într-un fișier, nu munca pe depozite pe orizont lung pe care o benchmarkează ambii furnizori. Cifrele de cost sunt câte un punct de date, nu o medie.
Când să alegi GPT-6 Sol vs Claude Opus 5.5
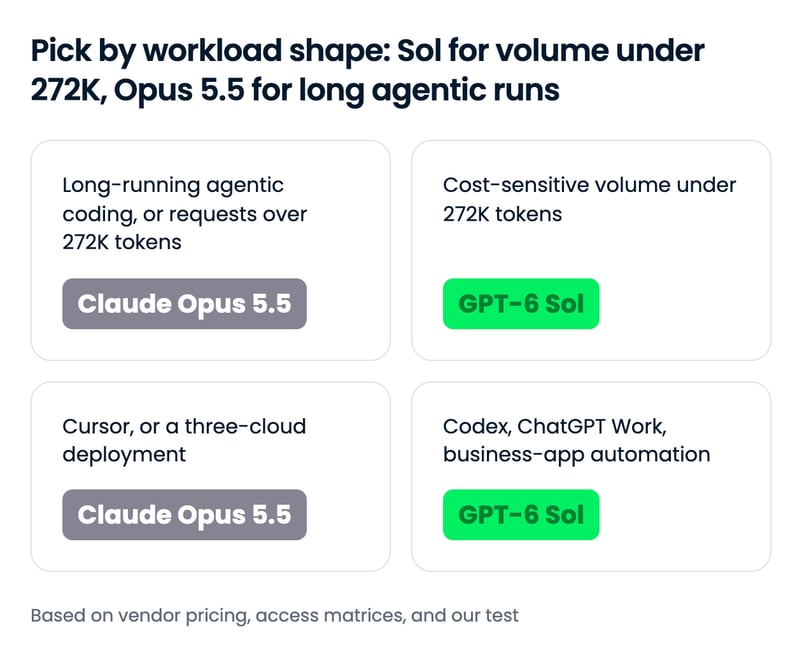
Răscrucea ține de mărimea cererii și forma încărcării, nu de capabilitatea brută: sub 272K tokeni per cerere, discountul lui Sol este real; peste atât sau în bucle cu cache intens, cele două facturi converg, iar avansul publicat al lui Opus 5.5 la munca agentică este ceea ce plătești.
Alege GPT-6 Sol dacă...
- Rulezi agenți cu volum mare unde fiecare cerere rămâne sub pragul de context lung. Jumătate din prețul de listă compune pe milioane de cereri, iar tariful de citire din cache este oricum identic.
- Echipa ta lucrează deja în Codex sau ChatGPT Work. Sol este disponibil acolo pe fiecare plan plătit, iar Codex este hamul pentru care OpenAI l-a reglat.
- Automatizezi fluxuri de lucru de business cu buget limitat. Rularea lui Sol pe AutomationBench a costat 0,27 $ per sarcină, iar afirmațiile OpenAI despre cost-per-sarcină sunt argumentul său cel mai puternic.
- Vrei o scară a efortului care coboară până jos. Setarea
nonea lui Sol și schimbările de efort sigure pentru cache permit unui agent să ruleze follow-up-uri ieftine și să escaladeze doar pașii dificili.
Alege Claude Opus 5.5 dacă...
- Munca ta este codare agentică de lungă durată: migrații, audituri și sarcini multi-repository. Opus 5.5 publică scoruri mai puternice pe fiecare benchmark de codare agentică pe care îl raportează, iar anecdotele testerilor sunt despre joburi care rulează ore întregi.
- Cererile tale depășesc frecvent pragul de context lung al lui Sol. Anthropic facturează întreaga fereastră de 1M la tarife standard, iar suprataxa lui Sol închide cea mai mare parte a diferenței de preț la această dimensiune.
- Ai nevoie de modelul în Cursor sau pe toate cele trei clouduri hyperscaler azi. Opus 5.5 este listat în Cursor și pe Bedrock, Vertex AI și Microsoft Foundry; Sol nu este disponibil în Cursor sau Vertex AI.
- Rulezi agenți fără supraveghere și vrei modelul mai conservator. Evaluarea de containere a Anthropic și protecțiile sale de clasă Fable sunt construite exact pentru asta, cu condiția ca munca ta să nu fie securitate cibernetică.
Cum să începi cu GPT-6 Sol și Claude Opus 5.5
| Suprafață | GPT-6 Sol | Claude Opus 5.5 |
|---|---|---|
| Aplicație pentru consumatori | ChatGPT Work și Codex pe planurile Plus, Pro, Business, Enterprise și Edu; încă nu în Chat-ul consumer al ChatGPT | Aplicațiile Claude; limitele de utilizare crescute pe planurile Pro, Max, Team și Enterprise la lansare |
| API first-party | Da, OpenAI API (Responses API recomandat) | Da, Claude API |
| Platforme cloud | Azure AI Foundry, AWS Bedrock | AWS Bedrock, Google Cloud Vertex AI, Microsoft Foundry |
| Agenți de codare | Codex, GitHub Copilot | Claude Code, Cursor, GitHub Copilot |
| Routere terțe | OpenRouter, Vercel AI Gateway | OpenRouter, Vercel AI Gateway |
| ID model API | gpt-6-sol | claude-opus-5-5 |
Opus 5.5 a fost lansat pe toate cele trei clouduri mari și în Cursor din prima zi, în timp ce Sol este pe două clouduri și lipsește din lista de modele a Cursor. Pe API-uri, șirurile sunt gpt-6-sol și claude-opus-5-5.
Folosirea GPT-6 Sol și Claude Opus 5.5 într-un agent de codare
Fiecare model vine în interiorul propriului agent al furnizorului, Codex pentru Sol și Claude Code pentru Opus 5.5, și ambele pot fi selectate în GitHub Copilot. Dacă vrei un singur ham pentru ambele, un agent bazat pe router precum OpenCode ajunge la ele prin OpenRouter ca openai/gpt-6-sol și anthropic/claude-opus-5.5, ceea ce este modul în care testul nostru le-a rulat sub instrumente identice.
Apelurile directe la API folosesc SDK-uri diferite, deci schimbul înseamnă clientul și șirul modelului, nu o singură linie:
from openai import OpenAI
client = OpenAI()
response = client.responses.create(
model="gpt-6-sol",
reasoning={"effort": "high"},
input="Refactor this module and explain what you changed.",
)
print(response.output_text)from anthropic import Anthropic
client = Anthropic()
response = client.messages.create(
model="claude-opus-5-5",
max_tokens=4096,
messages=[{"role": "user", "content": "Refactor this module and explain what you changed."}],
)
print(response.content[0].text)Pentru setările complete de agenți, tutorialul Codex CLI și tutorialul Claude Code acoperă instalarea și fluxurile, iar comparația Codex vs Claude Code cântărește chiar hamurile.
Gânduri finale
Dacă încărcarea ta este lungă, de codare agentică, sau cererile trec de pragul de context lung, folosește Claude Opus 5.5: publică numere mai puternice la agentic și prețurile sale nu penalizează cererile mari. Dacă rulezi volum sub acel prag, lucrezi în Codex sau ChatGPT Work sau automatizezi aplicații de business cu buget limitat, folosește GPT-6 Sol și păstrează diferența.
Ce mi se pare cel mai interesant este că niciun furnizor nu a putut include noul model al celuilalt în tabelul său, iar în singurul loc unde i-am putut compara noi, un build autoconținut, modelul mai ieftin a ieșit în față la finisaj.
Dacă vrei să construiești cu oricare model, îți recomand cursurile noastre Working with the OpenAI API și Introduction to Claude Models.
Întrebări frecvente
Când ar trebui să folosesc GPT-6 Sol în loc de Claude Opus 5.5?
Folosește GPT-6 Sol atunci când cererile tale rămân sub 272K tokeni de input și volumul contează: este listat la 2 $ per 1M tokeni de input și 10 $ per 1M tokeni de output, jumătate din cei 4 $ și 20 $ ai lui Claude Opus 5.5. Este și alegerea firească dacă echipa ta lucrează în Codex sau ChatGPT Work. Alege Opus 5.5 pentru codare agentică de lungă durată, pentru cereri peste 272K tokeni sau când ai nevoie de modelul în Cursor sau pe toate cele trei clouduri mari.
Cât de mult mai ieftin este GPT-6 Sol decât Claude Opus 5.5?
La prețul de listă, Claude Opus 5.5 costă exact de două ori GPT-6 Sol la input (4 $ vs 2 $ per 1M tokeni), output (20 $ vs 10 $) și scrieri în cache (5 $ vs 2,50 $). Citirile din cache costă 0,20 $ per 1M tokeni pe ambele. Sol taxează 2x input și 1,5x output pentru orice cerere peste 272K tokeni de input, în timp ce Anthropic facturează întreaga fereastră de 1M la tarife standard, astfel că diferența se reduce la aproximativ 8% la retrieval cu context lung și la circa 33% în bucle agentice cu cache intens.
Care sunt ID-urile de model API pentru GPT-6 Sol și Claude Opus 5.5?
Pe OpenAI API, GPT-6 Sol este gpt-6-sol. Pe Claude API, Claude Opus 5.5 este claude-opus-5-5, iar pe Amazon Bedrock este anthropic.claude-opus-5-5. Prin OpenRouter, cele două sunt openai/gpt-6-sol și anthropic/claude-opus-5.5.
Unde pot accesa GPT-6 Sol și Claude Opus 5.5?
GPT-6 Sol este disponibil în ChatGPT Work și Codex pentru utilizatorii Plus, Pro, Business, Enterprise și Edu, prin OpenAI API, pe Azure AI Foundry și AWS Bedrock, în GitHub Copilot și via OpenRouter; nu este încă în chatul consumer al ChatGPT. Claude Opus 5.5 este disponibil în aplicațiile Claude, prin Claude API, pe AWS Bedrock, Google Cloud Vertex AI și Microsoft Foundry și în Claude Code, Cursor și GitHub Copilot.
Care este mai bun pentru codare, GPT-6 Sol sau Claude Opus 5.5?
Pe benchmarkurile publicate, conduce Claude Opus 5.5: Anthropic raportează 66,4% pe Terminal-Bench 4.0 și 54,4% pe FrontierCode, în timp ce OpenAI spune că GPT-6 Sol se potrivește cu Claude Fable 5.1 pe FrontierCode, pe care Anthropic îl notează la 50,3%. În testul nostru practic, un Tetris într-un singur fișier cu inversare a gravitației, ambele modele au rezolvat corect logica, iar GPT-6 Sol a obținut 5,0 față de 4,3 pentru Opus 5.5 la finisaj și senzație.
Atenția pentru noul model Anthropic a durat doar vreo oră în cursa pentru modele de vârf mai eficiente și mai accesibile.
Claude Opus 5.5 este primul model din familia Claude 5.5, prezentat ca având performanță la nivelul Fable 5.1 la un cost de rulare mai mic decât Opus 5.
OpenAI a răspuns foarte repede, publicând GPT-6 Sol ca nivel mediu în familia GPT-6, antrenat cu aceleași metode ca vârful de gamă GPT-6 Astra și lansat la jumătate din prețul API față de predecesorul său, GPT-5.6 Sol.
În acest articol, voi compara GPT-6 Sol și Claude Opus 5.5 pe multe categorii de performanță, limite de siguranță și prețuri, și voi include un test practic de build pe care l-am rulat pe ambele.
Pe scurt (TL;DR)
Ce este GPT-6 Sol?
GPT-6 Sol este modelul de nivel mediu GPT-6 al OpenAI, lansat pe 22 septembrie 2026, alături de GPT-6 Luna și poziționat sub vârful de gamă GPT-6 Astra.
Argumentul său de vânzare este rețeta de antrenare a lui Astra la jumătate din prețul API al GPT-5.6 Sol, cu cache de prompt care supraviețuiește schimbărilor intermediare din conversație ale efortului de raționare sau ale instrumentelor.
Ghidul nostru GPT-6 Sol și Luna acoperă lansarea, iar tutorialul API GPT-6 Astra parcurge instrumentele async ale familiei și controlul fin (steering).
Ce este Claude Opus 5.5?
Claude Opus 5.5 este primul model Claude 5.5 de la Anthropic, lansat pe 22 septembrie 2026, ca noul model principal al companiei pentru codare agentică de lungă durată și muncă de cunoaștere.
Argumentul său de vânzare este rezultate de clasă Fable la prețuri Opus: Anthropic spune că se potrivește cu Claude Fable 5.1 la majoritatea sarcinilor și vine cu protecții de securitate cibernetică și biologie de clasă Fable.
Ghidul nostru Opus 5.5 acoperă lansarea, iar tutorialul API Claude Opus 5 acoperă API-ul generației anterioare.
GPT-6 Sol vs Claude Opus 5.5: comparație directă
Din cauza lansărilor aproape simultane, niciun furnizor nu a inclus noul model al celuilalt în tabelul de lansare, astfel că cele două modele se suprapun pe doar două benchmarkuri, iar Opus 5.5 conduce în ambele. Argumentul lui Sol se bazează pe preț și pe cum s-a descurcat în testul nostru propriu.
nonelamax; mai puține afirmații înșelătoare despre munca sa de codare decât GPT-5.6 SolFluxuri de codare și agentice
Opus 5.5 publică cifre mai puternice la codare agentică, iar postarea lui Sol nu le contestă direct. Anthropic raportează Opus 5.5 pe Terminal-Bench 4.0, FrontierCode și CursorBench; OpenAI raportează Sol pe DeepSWE și descrie rezultatul său pe FrontierCode doar ca potrivindu-se cu Claude Fable 5.1 la efort xhigh. Anthropic plasează Fable 5.1 la 50,3% pe FrontierCode față de 54,4% pentru Opus 5.5, deci, dacă ambele afirmații se susțin, Sol stă cu aproximativ patru puncte în urmă față de Opus 5.5 pe singurul benchmark de codare menționat de ambii furnizori.
Ambii furnizori se bazează pe anecdote cu orizont lung mai degrabă decât pe scoruri comune. Rescrierea internă HAProxy de la C la Rust a Anthropic a avut Opus 5.5 terminând în 9,5 ore față de 12 pentru Fable 5.1 la un cost cu 51% mai mic. Argumentul OpenAI este costul per sarcină: Sol ajunge la circa un punct de scorul Fable 5 pe DeepSWE la un cost cu aproximativ 80% mai mic.
Două motive pentru a privi aceste tabele cu rezerve:
Pe hârtie, Opus 5.5 este modelul de codare mai puternic; testul nostru unic de build de mai jos este locul unde diferența nu a apărut.
Fluxuri de business și utilizarea calculatorului
Opus 5.5 conduce ambele benchmarkuri pe care le împart cele două modele, iar diferența pe AutomationBench este cea mai clară cifră din acest articol: 40,0% pentru Opus 5.5 față de 33,2% pentru Sol pe testul Zapier al agenților ce lucrează în 47 de instrumente de business.
Replica lui Sol este factura: OpenAI poziționează Sol ca depășind Claude Opus 5 la 9% din costul per sarcină al lui Opus 5, deși comparația este cu Opus-ul anterior, nu cu acesta.
Opus 5.5 este agentul mai puternic la scor; Sol este cel pe care ți-l permiți să-l rulezi pe fiecare tichet.
Muncă de cunoaștere și fiabilitate factuală
Opus 5.5 deține singurul număr cross-vendor aici: 1846 Elo pe GDPval-AA v2.1, înaintea scorurilor GPT-6 Astra și GPT-5.6 Sol în tabelul Anthropic; Sol nu este listat. În testul Anthropic de scriere de rapoarte, unde orice cifră inventată eșuează rularea, 16 din 18 rapoarte Opus 5.5 au trecut, iar nici Fable 5.1, nici Opus 5 nu au trecut vreodată.
Dovada lui Sol este împotriva propriului predecesor: pe setul intern de factualitate al OpenAI, Sol face cam jumătate din greșelile lui GPT-5.6 Sol. Testul AA-Omniscience al Artificial Analysis confirmă, cu o nuanță: rata de halucinații a lui Sol a scăzut de la 92% la 60% în timp ce a răspuns doar la 83% dintre întrebări față de 99% la predecesor.
Ambele sunt mai atente decât predecesorii; doar Opus 5.5 a arătat asta împotriva unui rival.
Limite de siguranță și constrângeri API
Sol este API-ul mai puțin constrâns, iar Opus 5.5 este cel mai supravegheat.
Opus 5.5 nu poate rula cu „gândirea” oprită, respinge folosirea forțată a instrumentelor și leagă blocurile de gândire de modelul și conversația care le-au produs, astfel că un context editat eșuează cu o eroare 400 pe conturile create după 31 august 2026. Majoritatea sarcinilor de securitate cibernetică sunt redirecționate către Opus 4.8 în afara Cyber Verification Program, iar munca de biologie necesită Life Sciences Verification Program.
Scara lui Sol merge de la
nonelamax, efortul poate fi schimbat în mijlocul conversației fără a strica cache-ul, iar OpenAI raportează mai puține afirmații înșelătoare despre munca sa de codare decât GPT-5.6 Sol.Compromisul este deliberat: Opus 5.5 a încercat să treacă granițele de containere cu aproximativ 85% mai rar decât Opus 5, ceea ce contează pentru agenți fără supraveghere.
Prețuri: ce plătești de fapt
Opus 5.5 costă exact dublu față de Sol la tarifele „headline”, dar cele două mecanisme pe care le plătesc efectiv agenții rup tiparul: citirile din cache costă la fel, iar Sol adaugă un suprataxă peste 272K tokeni pe care Anthropic nu o are.
Tarife pe token, unul lângă altul
Prima de preț este plată pe input, output și scrieri în cache, deci lovește la fel orice formă de încărcare până când intră în joc cachingul sau contextul lung. Citirile din cache sunt excepția, iar Anthropic spune că acestea alcătuiesc cea mai mare parte a costului pentru munca agentică și de codare. Niciun furnizor nu publică un tarif separat pentru tokenii de raționare, deci bugetează-i la tariful de output.
Cât costă o încărcare reală
Rândul „peste prag” este ideea principală: odată ce fiecare cerere depășește pragul, suprataxa lui Sol îi ridică factura la doar 8% sub Opus 5.5, deci un pipeline de retrieval cu context lung primește aproape deloc discount alegând Sol. Bucla cu cache intens reduce diferența la 33% din alt motiv: cele 1.000 de citiri din cache costă la fel pe ambele modele, și doar tokenii proaspeți poartă prima de 2x.
Modelele folosesc tokenizatoare diferite, iar niciun furnizor nu a publicat numărări de tokeni pentru o încărcare comună, deci tratează aceste totale ca o comparație de tarife, nu ca o factură. Anthropic spune că Opus 5.5 folosește mai puțini tokeni per sarcină decât Opus 5, dar nu și cum se compară cu Sol.
Cum s-au descurcat GPT-6 Sol și Claude Opus 5.5
Benchmarkurile de la doi furnizori care nu au testat modelul celuilalt merg doar până la un punct, așa că am rulat o sarcină de build pe ambele cu același prompt și aceleași instrumente.
Testul
Le-am cerut amândurora să construiască un Tetris într-un singur fișier pe o tablă de 12×24 cu o singură întorsătură: gravitația se inversează la fiecare 20 de secunde. Două lucruri cerute de prompt îl fac dificil: după o inversare, piesele trebuie să cadă spre tavan și să se blocheze într-un al doilea teanc acolo, cu linii pline curățate pe oricare teanc, iar celulele deja blocate nu trebuie să se miște niciodată.
Ambele modele au rulat în OpenCode cu aceeași suprafață de instrumente fixată: doar citire, căutare și editare de fișiere, fără shell și fără rețea. Ambele au rulat la efort de raționare
high, o încercare fiecare, fără retry-uri, iar promptul a fost livrat byte-cu-byte într-o sesiune nouă.O asimetrie de reținut:
higheste cu două trepte sub plafon pe ambele scări, dar scara lui Sol are o treaptănoneîn plus la bază, decihigheste a patra din șase setări pentru el și a treia din cinci pentru Opus 5.5.Acesta a fost promptul:
Am înregistrat costul și le-am notat pe ambele pe următoarele trei rubrici, cu scoruri de la 1 la 5:
Ce a produs GPT-6 Sol
Sol a avut 6 ture și 9 apeluri de instrumente: a listat, a căutat și a citit spațiul de lucru gol înainte de a scrie un
index.htmlde 22 KB, apoi l-a corectat încă o dată. Ce a ieșit are propriul branding, „Fall / Rise, a game of shifting ground”, cu un panou al gravitației care își schimbă culoarea din chihlimbar în teal la inversare, un countdown până la următoarea inversare și un card de reguli în margine.Face ce trebuie și funcționează lin și stabil: teancul de pe podea rămâne la loc la inversare, piesele se ridică și se blochează pe tavan, liniile se curăță pe ambele teancuri, iar soft drop-ul se simte receptiv, ceea ce l-a făcut mai plăcut de jucat dintre cele două.