Предпросмотр следующей фигуры показывает букву тетромино — O, I, T, S, Z — вместо отрисовки самой фигуры. Это читаемо, если знать нотацию, но каждый взгляд отнимает долю секунды, а на скорости это важно. Ни одна модель не получала требования делать предпросмотр, так что это добровольный выбор Sol, но реализованный не до конца. Это единственное место, где более отполированная сборка получилась менее удобочитаемой.
Что сделал Claude Opus 5.5
Opus 5.5 потребовалось 3 хода и 2 вызова инструментов — один glob и одна запись — чтобы выдать 19‑килобайтный index.html под названием «Flip Tetris». Комментарий в заголовке — более аккуратная спецификация из двух: рандомизатор «7‑мешок» на фиксированном сиде, вращение с «ударом о стену», схлопывание рядов на каждой стопке и пометка, что фигура в полёте просто меняет направление при перевороте гравитации.
Игра работает ровно как описано и столь же стабильно, как у Sol, с «призрачной» фигурой и полосой обратного отсчёта, которая краснеет перед каждым переворотом. Предпросмотр следующей фигуры рисует реальную форму — это верное решение и единственное, что он делает лучше Sol на первый взгляд.
Он также добавил счётчик уровней, о котором никто не просил, и это, скорее, в ноль, чем в плюс: уровни растут достаточно медленно, чтобы не влиять на игру до гораздо более глубокой стадии, чем эти сборки реалистично выдержат. Где Opus проигрывает — это ощущение, а не логика: оформление проще, чем у Sol, и «мягкое» опускание менее плавное, поэтому он теряет балл по визуальному качеству и один по полноте.
Результаты
| Метрика | GPT-6 Sol | Claude Opus 5.5 |
|---|---|---|
| Ходы | 6 | 3 |
| Вызовы инструментов | 9 | 2 |
| Стоимость | $0,26 | $0,87 |
| Всего токенов | 120 226 | 107 958 |
| Токены рассуждений | 8 123 | 22 551 |
| Запускаемость | pass | pass |
| Механика переворота | 5 | 5 |
| Полнота игры | 5 | 4 |
| Визуальное качество и ощущения | 5 | 4 |
| Итог по рубрике (среднее по трём осям) | 5 | 4,3 |
GPT-6 Sol выигрывает этот тест, но минимально — и не на сложной части. Обе модели правильно реализовали переворот гравитации, так что преимущество решилось в ремесле, и отзывчивость и визуальная полировка Sol дали ему перевес над Opus.
Более резкое различие — в стоимости прогона. Opus 5.5 потратил $0,87 против $0,26 у Sol — более чем втрое — и сделал это на меньшем числе токенов: 108 тыс. против 120 тыс. Разница — в рассуждениях: Opus думал примерно втрое интенсивнее на ход, достиг корректной сборки за половину ходов и остановился. Sol вместо этого дешёво итеративно правил файл — и немного обогнал по ощущениям.
Это единичный прогон одной задачи на одном уровне усилия, и он проверяет логику игрового цикла в одном файле, а не длительную работу по репозиторию, которую бенчмаркируют вендоры. Стоимости — по одной точке данных, не средние.
Когда выбирать GPT-6 Sol vs Claude Opus 5.5
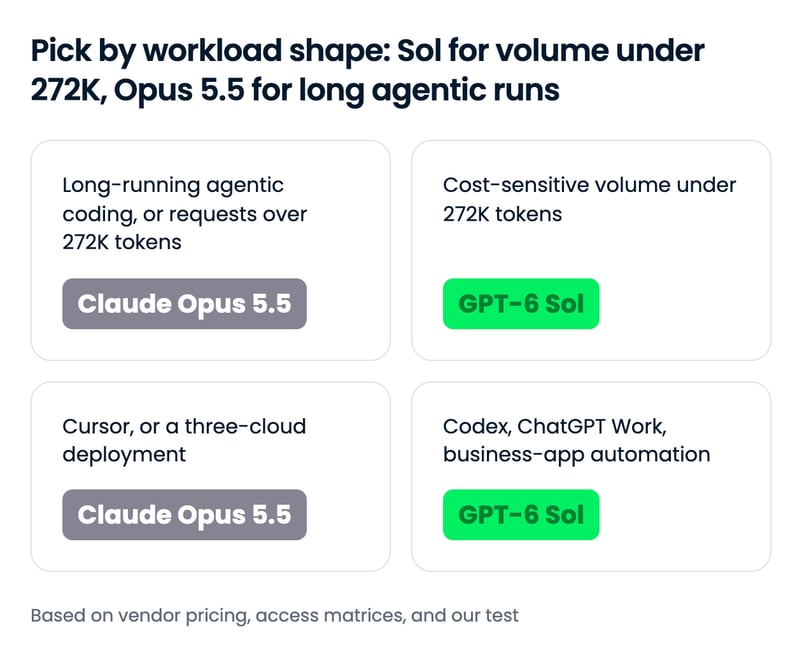
Развилка — в размере запроса и форме нагрузки, а не в «сырой» способности: ниже 272 тыс. токенов на запрос скидка Sol реальна; выше этого или в петлях с активным кэшем счета сходятся, и вы платите за опубликованное преимущество Opus 5.5 в агентной работе.
Выберите GPT-6 Sol, если…
- Вы запускаете высокообъёмных агентов, где каждый запрос остаётся ниже порога длинного контекста. Половинная цена по прайсу масштабируется на миллионы запросов, а ставка чтения из кэша и так одинакова.
- Ваша команда уже работает в Codex или ChatGPT Work. Sol доступен там на каждом платном плане, а Codex — это хомут, под который OpenAI его настраивала.
- Вы автоматизируете бизнес-процессы при ограниченном бюджете. Прогон Sol на AutomationBench стоил $0,27 за задачу, и заявления OpenAI о стоимости за задачу — его сильнейший аргумент.
- Вам нужна лестница усилия «в самый низ». Настройка
noneу Sol и безопасная для кэша смена усилия позволяют агенту дёшево выполнять догоняющие шаги и повышать усилие только на сложных.
Выберите Claude Opus 5.5, если…
- Ваша работа — длительное агентное программирование: миграции, аудиты и многорепозитарные задачи. Opus 5.5 публикует более сильные результаты по всем агентным бенчмаркам, о которых сообщает, а кейсы тестировщиков — о часовых прогонах.
- Ваши запросы регулярно превышают порог длинного контекста у Sol. Anthropic тарифицирует всё окно 1 млн по стандартным ставкам, а надбавка Sol закрывает большую часть ценового разрыва на таком размере.
- Вам нужна модель в Cursor или на всех трёх гиперскейлерных облаках уже сегодня. Opus 5.5 есть в Cursor и на Bedrock, Vertex AI и Microsoft Foundry; Sol недоступен в Cursor и Vertex AI.
- Вы запускаете агентов без присмотра и хотите более консервативную модель. Оценка изоляции Anthropic и защиты уровня Fable созданы именно для этого, если ваша работа не кибербезопасность.
Как начать работу с GPT-6 Sol и Claude Opus 5.5
| Поверхность | GPT-6 Sol | Claude Opus 5.5 |
|---|---|---|
| Пользовательское приложение | ChatGPT Work и Codex на планах Plus, Pro, Business, Enterprise и Edu; пока нет в потребительском чате ChatGPT | Приложения Claude; лимиты использования повышены на планах Pro, Max, Team и Enterprise при запуске |
| Собственный API | Да, OpenAI API (рекомендуется Responses API) | Да, Claude API |
| Облачные платформы | Azure AI Foundry, AWS Bedrock | AWS Bedrock, Google Cloud Vertex AI, Microsoft Foundry |
| Кодовые агенты | Codex, GitHub Copilot | Claude Code, Cursor, GitHub Copilot |
| Сторонние роутеры | OpenRouter, Vercel AI Gateway | OpenRouter, Vercel AI Gateway |
| ID модели в API | gpt-6-sol | claude-opus-5-5 |
Opus 5.5 вышел в первый день сразу на всех трёх крупных облаках и в Cursor, тогда как Sol — на двух облаках и отсутствует в списке моделей Cursor. В API строки — gpt-6-sol и claude-opus-5-5.
Использование GPT-6 Sol и Claude Opus 5.5 в кодовом агенте
Каждая модель поставляется внутри родного агента: Codex для Sol и Claude Code для Opus 5.5, обе доступны в GitHub Copilot. Если нужен единый хомут для обеих, агент на роутере, такой как OpenCode, добирается до них через OpenRouter как openai/gpt-6-sol и anthropic/claude-opus-5.5 — так и шёл наш тест под идентичными инструментами.
Прямые вызовы API используют разные SDK, так что подмена — это клиент и строка модели, а не одна строка кода:
from openai import OpenAI
client = OpenAI()
response = client.responses.create(
model="gpt-6-sol",
reasoning={"effort": "high"},
input="Refactor this module and explain what you changed.",
)
print(response.output_text)from anthropic import Anthropic
client = Anthropic()
response = client.messages.create(
model="claude-opus-5-5",
max_tokens=4096,
messages=[{"role": "user", "content": "Refactor this module and explain what you changed."}],
)
print(response.content[0].text)Для полноценных настроек агентов наши туториал по Codex CLI и туториал по Claude Code описывают установку и процессы, а сравнение Codex и Claude Code оценивает сами хомуты.
Итоги
Если ваша нагрузка — длинное агентное программирование или ваши запросы выходят за порог длинного контекста, используйте Claude Opus 5.5: он публикует более сильные показатели агентной работы, а его цены не наказывают большие запросы. Если вы запускаете объём ниже порога, работаете в Codex или ChatGPT Work, либо автоматизируете бизнес‑приложения при ограниченном бюджете, используйте GPT-6 Sol и экономьте.
Самое интересное — ни один из вендоров не смог включить новую модель конкурента в свою таблицу, а в том единственном месте, где мы смогли сравнить их сами — самодостаточной сборке — более дешёвая модель оказалась впереди по полировке.
Если хотите поработать с любой из моделей, рекомендуем наши курсы Working with the OpenAI API и Introduction to Claude Models.
FAQs
Когда мне стоит использовать GPT-6 Sol вместо Claude Opus 5.5?
Используйте GPT-6 Sol, когда ваши запросы укладываются в 272 тыс. входных токенов и важен объём: его ставки — $2 за 1 млн входных токенов и $10 за 1 млн выходных, то есть половина от $4 и $20 у Claude Opus 5.5. Это также естественный выбор, если ваша команда работает в Codex или ChatGPT Work. Выбирайте Opus 5.5 для длительного агентного программирования, для запросов свыше 272 тыс. токенов или когда модель нужна в Cursor или на всех трёх крупных облаках.
Насколько GPT-6 Sol дешевле, чем Claude Opus 5.5?
По прайс-листу Claude Opus 5.5 стоит ровно вдвое дороже GPT-6 Sol по входу ($4 против $2 за 1 млн токенов), выходу ($20 против $10) и записи в кэш ($5 против $2,50). Чтения из кэша стоят $0,20 за 1 млн токенов у обеих. Sol взимает 2x по входу и 1,5x по выходу за любой запрос свыше 272 тыс. входных токенов, тогда как Anthropic тарифицирует всё окно 1 млн по стандартным ставкам, поэтому разрыв сужается до ~8% на длинноконтекстном извлечении и до ~33% на агентных петлях с активным кэшем.
Какие ID моделей в API у GPT-6 Sol и Claude Opus 5.5?
В OpenAI API GPT-6 Sol — это gpt-6-sol. В Claude API Claude Opus 5.5 — это claude-opus-5-5, а в Amazon Bedrock — anthropic.claude-opus-5-5. Через OpenRouter это openai/gpt-6-sol и anthropic/claude-opus-5.5.
Где я могу получить доступ к GPT-6 Sol и Claude Opus 5.5?
GPT-6 Sol доступен в ChatGPT Work и Codex для пользователей Plus, Pro, Business, Enterprise и Edu, через OpenAI API, на Azure AI Foundry и AWS Bedrock, в GitHub Copilot и через OpenRouter; пока недоступен в потребительском чате ChatGPT. Claude Opus 5.5 доступен в приложениях Claude, через Claude API, на AWS Bedrock, Google Cloud Vertex AI и Microsoft Foundry, а также в Claude Code, Cursor и GitHub Copilot.
Что лучше для программирования: GPT-6 Sol или Claude Opus 5.5?
По опубликованным бенчмаркам лидирует Claude Opus 5.5: Anthropic сообщает 66,4% на Terminal-Bench 4.0 и 54,4% на FrontierCode, тогда как OpenAI заявляет, что GPT-6 Sol соответствует Claude Fable 5.1 на FrontierCode, который Anthropic оценивает в 50,3%. В нашем практическом тесте — одностраничном клоне Tetris с переворотом гравитации — обе модели правильно реализовали логику, а GPT-6 Sol набрал 5,0 против 4,3 у Opus 5.5 по полировке и ощущениям.
Внимание к новой модели Anthropic продержалось примерно час в гонке за более эффективными и доступными моделями на переднем крае.
Их Claude Opus 5.5 — первая модель в семействе Claude 5.5, заявленная как производительность уровня Fable 5.1 при более низкой стоимости, чем у Opus 5.
OpenAI ответила очень быстро, выпустив GPT-6 Sol как средний уровень семейства GPT-6. Его обучали теми же методами, что и флагманский GPT-6 Astra, а цена API — вдвое ниже, чем у предшественника, GPT-5.6 Sol.
В этой статье сравним GPT-6 Sol и Claude Opus 5.5 по ряду категорий производительности, ограничений и цен, а также включим один практический тест сборки, проведённый на обеих моделях.
Коротко
Что такое GPT-6 Sol?
GPT-6 Sol — средний уровень моделей GPT-6 от OpenAI, выпущенный 22 сентября 2026 года вместе с GPT-6 Luna и расположенный ниже флагманского GPT-6 Astra.
Его сильная сторона — рецепт обучения Astra при половинной цене API от GPT-5.6 Sol, с кэшированием подсказок, которое сохраняется даже при изменении усилия рассуждения или набора инструментов в середине диалога.
Наш гид по GPT-6 Sol и Luna освещает запуск, а наш туториал по GPT-6 Astra API показывает работу с асинхронными инструментами и управлением.
Что такое Claude Opus 5.5?
Claude Opus 5.5 — первая модель Claude 5.5 от Anthropic, выпущенная 22 сентября 2026 года, новая лидерская модель компании для длительного агентного программирования и работы с знаниями.
Её сильная сторона — результаты класса Fable по цене Opus: Anthropic утверждает, что она сопоставима с Claude Fable 5.1 на большинстве задач и поставляется с защитами уровня Fable в области кибербезопасности и биологии.
Наш гид по Opus 5.5 освещает запуск, а наш туториал по Claude Opus 5 API описывает API предыдущего поколения.
GPT-6 Sol vs Claude Opus 5.5: сравнение лоб в лоб
Из‑за близких сроков релиза никто из вендоров не включил модель конкурента в свою стартовую таблицу, поэтому у моделей всего два общих бенчмарка — и в обоих лидирует Opus 5.5. Аргументы Sol — цена и то, как он показал себя в нашем собственном тесте.
noneдоmax; меньше вводящих в заблуждение утверждений о своей работе с кодом, чем у GPT-5.6 SolПрограммирование и агентные процессы
Opus 5.5 публикует более сильные показатели по агентному программированию, и пост Sol напрямую их не оспаривает. Anthropic приводит результаты Opus 5.5 на Terminal-Bench 4.0, FrontierCode и CursorBench; OpenAI сообщает результат Sol на DeepSWE и лишь описывает результат на FrontierCode как соответствующий Claude Fable 5.1 при xhigh-усилии. Anthropic оценивает Fable 5.1 в 50,3% на FrontierCode против 54,4% у Opus 5.5, так что если обе оценки верны, Sol отстаёт примерно на четыре пункта на единственном кодовом бенчмарке, который оба вендора упоминают.
Оба вендора опираются скорее на длинные кейсы, чем на общие метрики. Внутренняя миграция HAProxy с C на Rust у Anthropic: Opus 5.5 завершил за 9,5 часа против 12 у Fable 5.1 при на 51% меньшей стоимости. Аргумент OpenAI — стоимость за задачу: Sol близок примерно на один пункт к результату Fable 5 на DeepSWE при примерно на 80% меньшей стоимости.
Две причины относиться к этим таблицам осторожно:
На бумаге Opus 5.5 — более сильная кодовая модель; разрыв не проявился в нашем единственном тесте сборки ниже.
Бизнес-процессы и работа с компьютером
Opus 5.5 лидирует в обоих общих бенчмарках, и разница в AutomationBench — самое чистое число в статье: 40,0% у Opus 5.5 против 33,2% у Sol в тесте Zapier, где агенты работают через 47 бизнес-инструментов.
Ответ Sol — счёт: OpenAI позиционирует Sol как обгоняющий Claude Opus 5 при 9% стоимости за задачу от Opus 5, хотя это сравнение с предыдущим Opus, а не с текущим.
Opus 5.5 — более сильный агент по оценкам; Sol — тот, который вы можете позволить себе запускать на каждом тикете.
Работа с знаниями и фактическая надёжность
Opus 5.5 имеет здесь единственное межвендорное число: 1846 Elo на GDPval-AA v2.1 — выше, чем у GPT-6 Astra и GPT-5.6 Sol в таблице Anthropic; самого Sol там нет. В тесте на написание отчётов у Anthropic, где любая выдуманная цифра проваливает прогон, 16 из 18 отчётов Opus 5.5 прошли, а ни Fable 5.1, ни Opus 5 не прошли ни разу.
У Sol есть данные против собственного предшественника: на внутреннем наборе фактичности OpenAI Sol делает примерно вдвое меньше ошибок, чем GPT-5.6 Sol. Тест AA-Omniscience от Artificial Analysis согласен, но с оговоркой: уровень галлюцинаций у Sol снизился с 92% до 60%, при этом он ответил лишь на 83% вопросов против 99% у предшественника.
Обе модели осторожнее своих предшественников; только Opus 5.5 показал это на фоне конкурента.
Ограничения и условия API
Sol — менее ограниченный API, а Opus 5.5 — более контролируемый.
Opus 5.5 нельзя запускать с отключённым мышлением, он отклоняет принудительное использование инструментов и привязывает блоки мышления к модели и диалогу, которые их породили, поэтому отредактированный контекст выдаёт ошибку 400 на аккаунтах, созданных после 31 августа 2026 года. Большинство задач по кибербезопасности перенаправляются на Opus 4.8 вне программы Cyber Verification, а работы по биологии требуют участия в Life Sciences Verification Program.
Лестница усилия у Sol — от
noneдоmax, усилие можно менять в середине диалога без поломки кэша, и OpenAI сообщает о меньшем количестве вводящих в заблуждение заявлений о своей кодовой работе, чем у GPT-5.6 Sol.Компромисс осознанный: Opus 5.5 пытался пересечь границы изоляции примерно на 85% реже, чем Opus 5, что важно для агентов без присмотра.
Ценообразование: что вы платите на самом деле
По базовым ставкам Opus 5.5 стоит ровно вдвое дороже Sol, но два механизма, за которые агенты платят в реальности, нарушают шаблон: чтение из кэша стоит одинаково, а Sol добавляет надбавку свыше 272 тыс. токенов, которой у Anthropic нет.
Ставки за токены рядом
Премия ровная для входа, выхода и записи в кэш, поэтому она влияет на все типы нагрузок одинаково, пока не вступают в игру кэширование или длинный контекст. Исключение — чтения из кэша, и Anthropic говорит, что именно они составляют большую часть стоимости агентной и кодовой работы. Ни один из вендоров не публикует отдельную ставку для токенов рассуждений, так что закладывайте их по ставке вывода.
Сколько стоит реальная нагрузка
Строка «выше порога» — ключевая: когда каждый запрос пересекает порог, надбавка Sol поднимает счёт до разницы всего в 8% по сравнению с Opus 5.5, так что длинноконтекстный конвейер извлечения почти не получает скидки, выбирая Sol. В петле с активным кэшем разрыв сужается до 33% по другой причине: 1 000 чтений из кэша стоят одинаково в обеих моделях, и только новые токены несут 2x‑премию.
Модели используют разные токенизаторы, и ни один вендор не опубликовал подсчёты токенов для общей нагрузки, поэтому воспринимайте эти суммы как сравнение ставок, а не итогового счёта. Anthropic отмечает, что Opus 5.5 тратит меньше токенов на задачу, чем Opus 5, но не указывает, как это соотносится с Sol.
Как показали себя GPT-6 Sol и Claude Opus 5.5
Бенчмарки от двух вендоров, которые не тестировали модель конкурента, дают ограниченную картину, поэтому я провёл одну задачу сборки на обеих с одинаковым промптом и одинаковыми инструментами.
Тест
Я попросил обе модели собрать одностраничный клон Tetris на поле 12×24 с одним твистом: гравитация переворачивается каждые 20 секунд. Две вещи, требуемые промптом, делают задачу сложной: после переворота фигуры должны падать к потолку и фиксироваться на второй стопке там, при этом полные ряды очищаются на любой из стопок, а клетки, уже зафиксированные, никогда не двигаются.
Обе модели запускались внутри OpenCode с одинаковой закреплённой поверхностью инструментов: чтение файлов, поиск и редактирование, без shell и без сети. Обе работали на
highуровне рассуждений, по одной попытке, без ретраев, и промпт был передан побайтно в новую сессию.Одна асимметрия:
highна две ступени ниже потолка в обеих лестницах, но в лестнице Sol есть дополнительная нижняя ступеньnone, так чтоhigh— это четвёртый из шести уровней у Sol и третий из пяти у Opus 5.5.Промпт был таким:
Я записал стоимость и оценил обе модели по трём шкалам, с оценками от 1 до 5:
Что сделал GPT-6 Sol
Sol потребовалось 6 ходов и 9 вызовов инструментов: он перечислил, нашёл и прочитал пустое рабочее пространство, затем записал 22‑килобайтный
index.htmlи ещё раз его пропатчил. На выходе — собственный брендинг «Fall / Rise, a game of shifting ground», панель гравитации, меняющая цвет с янтарного на бирюзовый при перевороте, обратный отсчёт до инверсии и карточка правил на полях.Он делает то, что должен, и работает плавно и стабильно: напольная стопка остаётся на месте при перевороте, фигуры поднимаются и фиксируются на потолке, ряды очищаются на обеих стопках, а «мягкое» опускание отзывчиво — из‑за этого в игру было приятнее играть.