नेक्स्ट-पीस प्रीव्यू टेट्रोमिनो का अक्षर दिखाता है—O, I, T, S, Z—पीस ड्रॉ करने के बजाय। नोटेशन पता हो तो इसे पढ़ा जा सकता है, लेकिन हर नज़र में एक पल लगता है, और स्पीड पर यह मायने रखता है। किसी भी मॉडल से प्रीव्यू मांगा नहीं गया था, इसलिए यह Sol का अपना चुना हुआ फीचर है जो थोड़ा कमतर बना। यही एक जगह है जहाँ ज्यादा पॉलिश्ड बिल्ड कम पठनीय पड़ा।
Claude Opus 5.5 ने क्या बनाया
Opus 5.5 ने 3 टर्न और 2 टूल कॉल लिए—एक ग्लोब और एक राइट—और "Flip Tetris" नाम से 19 KB का index.html शिप किया। इसका हेडर कमेंट दोनों में ज्यादा सटीक स्पेक है: फिक्स्ड सीड पर 7-बैग रैंडमाइज़र, वॉल किक्स के साथ रोटेशन, प्रति-स्टैक रो कollapse, और यह नोट कि फ्लिप पर मिड-फॉल पीस बस दिशा उलट देता है।
गेम ठीक वैसा ही काम करता है जैसा बताया गया और Sol जितना ही स्थिर है, एक घोस्ट पीस के साथ और एक काउंटडाउन बार जो हर फ्लिप से पहले लाल हो जाता है। इसका नेक्स्ट-पीस प्रीव्यू वास्तविक शेप ड्रॉ करता है, जो सही निर्णय है और नज़र पड़ते ही समझ आने के स्तर पर Sol से बेहतर एक चीज़ है।
इसने एक लेवल काउंटर भी जोड़ दिया जिसे किसी ने नहीं माँगा था, और मैं इसे श्रेय की बजाय बराबरी मानूँगा: लेवल इतने धीमे बढ़ते हैं कि वे तब तक फर्क नहीं डालते जब तक खेल उतनी गहराई तक नहीं खेला जाएगा—जो इन बिल्ड्स के साथ यथार्थवादी नहीं। जहाँ Opus हारता है, वह लॉजिक नहीं बल्कि फील है: लेआउट Sol से सपाट है और सॉफ्ट ड्रॉप कम स्मूद है, इसलिए यह दृश्य गुणवत्ता पर एक अंक और पूर्णता पर एक अंक खोता है।
नतीजे
| माप | GPT-6 Sol | Claude Opus 5.5 |
|---|---|---|
| टर्न | 6 | 3 |
| टूल कॉल | 9 | 2 |
| लागत | $0.26 | $0.87 |
| कुल टोकन | 120,226 | 107,958 |
| रीजनिंग टोकन | 8,123 | 22,551 |
| रन करने योग्य | pass | pass |
| फ्लिप मैकेनिक्स | 5 | 5 |
| गेम पूर्णता | 5 | 4 |
| दृश्य गुणवत्ता और फील | 5 | 4 |
| रुब्रिक स्कोर (तीन अक्षों का औसत) | 5 | 4.3 |
इस टेस्ट में GPT-6 Sol जीतता है, लेकिन मामूली अंतर से, और कठिन हिस्से पर नहीं। दोनों ने ग्रैविटी फ्लिप ठीक किया, तो फ़ैसला कारीगरी पर आया, और Sol की रेस्पॉन्सिवनेस और विज़ुअल पॉलिश ने इसे Opus पर बढ़त दी।
जो उन्हें और स्पष्ट रूप से अलग करता है वह है रन की लागत। Opus 5.5 ने $0.87 खर्च किए, Sol के $0.26 के मुकाबले—तीन गुने से अधिक—और उसने यह कम कुल टोकन पर किया: 108k बनाम 120k। फर्क reasoning का है: Opus ने प्रति टर्न लगभग तीन गुना अधिक सोचा, आधे टर्न में सही बिल्ड तक पहुँचा, और रुक गया। Sol ने फाइल में ही इटरेट किया—सस्ते में—और फील पर थोड़ा आगे रहा।
यह एक टास्क का एकल रन है, एक effort सेटिंग पर, और यह एक फ़ाइल में गेम-लूप लॉजिक को परखता है, न कि वह लंबा-क्षितिज रिपॉज़िटरी कार्य जिसे दोनों वेंडर बेंचमार्क करते हैं। लागत आंकड़े प्रत्येक के लिए एक–एक डेटा पॉइंट हैं, औसत नहीं।
कब चुनें GPT-6 Sol बनाम Claude Opus 5.5
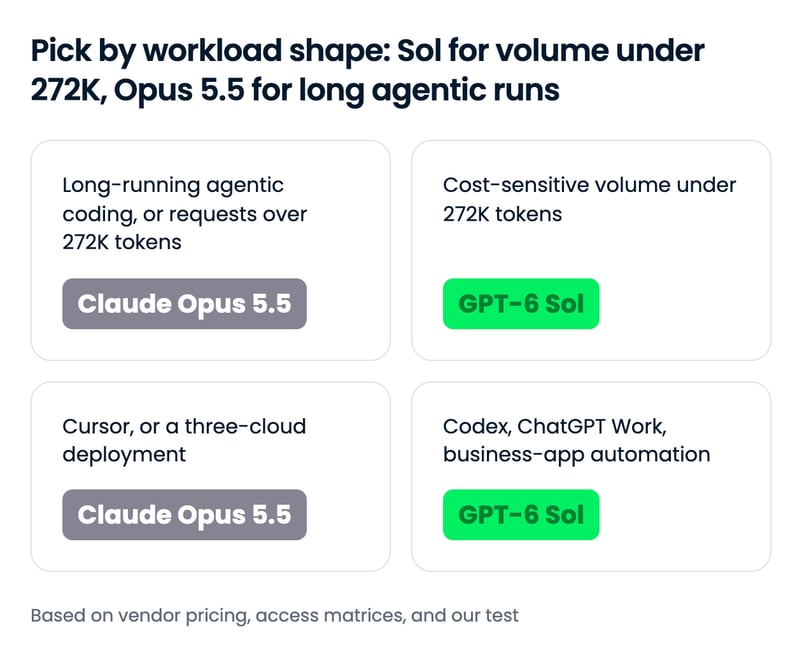
चयन कच्ची क्षमता से अधिक रिक्वेस्ट आकार और वर्कलोड शेप पर निर्भर है: प्रति रिक्वेस्ट 272K टोकन से नीचे, Sol की छूट वास्तविक है; उससे ऊपर, या कैश-भारी लूप्स पर, दोनों के बिल मिलते-जुलते हैं, और एजेंटिक कार्य पर Opus 5.5 की प्रकाशित बढ़त वही है जिसके लिए आप भुगतान कर रहे हैं।
GPT-6 Sol चुनें, अगर...
- आप हाई-वॉल्यूम एजेंट्स चलाते हैं जहाँ हर रिक्वेस्ट लॉन्ग-कॉन्टेक्स्ट थ्रेशहोल्ड के नीचे रहती है। आधा सूची मूल्य लाखों रिक्वेस्ट्स पर कंपाउंड होता है, और कैश-रीड दर तो वैसे भी समान है।
- आपकी टीम पहले से Codex या ChatGPT Work में काम करती है। Sol हर पेड प्लान पर वहाँ उपलब्ध है, और Codex वही हार्नेस है जिसके लिए OpenAI ने इसे ट्यून किया।
- आप बजट में बिजनेस वर्कफ़्लोज़ ऑटोमेट करते हैं। Sol का AutomationBench रन $0.27 प्रति टास्क पड़ा, और प्रति-टास्क लागत पर OpenAI के दावे इसका सबसे मजबूत तर्क हैं।
- आप ऐसी effort सीढ़ी चाहते हैं जो सबसे नीचे तक जाती हो। Sol की
noneसेटिंग और कैश-सुरक्षित effort बदलाव एक एजेंट को सस्ते फॉलो-अप चलाने और सिर्फ कठिन चरणों पर एस्केलेट करने देते हैं।
Claude Opus 5.5 चुनें, अगर...
- आपका काम लंबे समय तक चलने वाला एजेंटिक कोडिंग है: माइग्रेशन, ऑडिट, और मल्टी-रिपॉज़िटरी टास्क्स। Opus 5.5, जिन भी एजेंटिक-कोडिंग बेंचमार्क्स पर रिपोर्ट करता है, उन सभी पर मजबूत स्कोर प्रकाशित करता है, और इसके टेस्टर्स के किस्से घंटों चलने वाले कामों के हैं।
- आपकी रिक्वेस्ट्स अक्सर Sol के लॉन्ग-कॉन्टेक्स्ट थ्रेशहोल्ड से ऊपर जाती हैं। Anthropic पूरी 1M विंडो को मानक दरों पर बिल करता है, और Sol का सरचार्ज उस आकार पर कीमत का अधिकांश अंतर बंद कर देता है।
- आपको मॉडल Cursor में या तीनों हाइपरस्केलर क्लाउड्स पर आज ही चाहिए। Opus 5.5, Cursor और Bedrock, Vertex AI, तथा Microsoft Foundry पर सूचीबद्ध है; Sol, Cursor और Vertex AI में उपलब्ध नहीं है।
- आप एजेंट्स बिना निगरानी के चलाते हैं और अधिक रूढ़िवादी मॉडल चाहते हैं। Anthropic का containment मूल्यांकन और इसके Fable-क्लास सेफगार्ड्स ठीक उसी के लिए बने हैं—बशर्ते आपका काम साइबरसुरक्षा न हो।
GPT-6 Sol और Claude Opus 5.5 के साथ कैसे शुरू करें
| सरफेस | GPT-6 Sol | Claude Opus 5.5 |
|---|---|---|
| कंज्यूमर ऐप | ChatGPT Work और Codex, Plus, Pro, Business, Enterprise, और Edu प्लान्स पर; अभी ChatGPT के Chat में नहीं | Claude ऐप्स; लॉन्च पर Pro, Max, Team, और Enterprise प्लान्स पर यूसेज लिमिट्स बढ़ीं |
| फ़र्स्ट-पार्टी API | हाँ, OpenAI API (Responses API अनुशंसित) | हाँ, Claude API |
| क्लाउड प्लेटफ़ॉर्म | Azure AI Foundry, AWS Bedrock | AWS Bedrock, Google Cloud Vertex AI, Microsoft Foundry |
| कोडिंग एजेंट्स | Codex, GitHub Copilot | Claude Code, Cursor, GitHub Copilot |
| थर्ड-पार्टी राउटर्स | OpenRouter, Vercel AI Gateway | OpenRouter, Vercel AI Gateway |
| API मॉडल ID | gpt-6-sol | claude-opus-5-5 |
Opus 5.5 पहले दिन ही तीनों बड़े क्लाउड्स और Cursor पर लॉन्च हुआ, जबकि Sol दो क्लाउड्स पर है और Cursor की मॉडल सूची में अनुपस्थित है। APIs पर, स्ट्रिंग्स हैं gpt-6-sol और claude-opus-5-5।
कोडिंग एजेंट में GPT-6 Sol और Claude Opus 5.5 का उपयोग
हर मॉडल अपने वेंडर के एजेंट के अंदर शिप होता है—Sol के लिए Codex और Opus 5.5 के लिए Claude Code—और दोनों GitHub Copilot में चुने जा सकते हैं। यदि आप दोनों के लिए एक ही हार्नेस चाहते हैं, तो OpenCode जैसे राउटर-बैक्ड एजेंट, OpenRouter के माध्यम से इन्हें openai/gpt-6-sol और anthropic/claude-opus-5.5 के रूप में पहुँचता है—यही वह सेटअप है जिसमें हमारे टेस्ट ने इन्हें एक समान टूलिंग के तहत चलाया।
डायरेक्ट API कॉल्स अलग SDKs का इस्तेमाल करते हैं, इसलिए स्वैप एक क्लाइंट और मॉडल स्ट्रिंग का है, न कि एक पंक्ति का:
from openai import OpenAI
client = OpenAI()
response = client.responses.create(
model="gpt-6-sol",
reasoning={"effort": "high"},
input="Refactor this module and explain what you changed.",
)
print(response.output_text)from anthropic import Anthropic
client = Anthropic()
response = client.messages.create(
model="claude-opus-5-5",
max_tokens=4096,
messages=[{"role": "user", "content": "Refactor this module and explain what you changed."}],
)
print(response.content[0].text)पूरे एजेंट सेटअप्स के लिए, हमारा Codex CLI ट्यूटोरियल और हमारा Claude Code ट्यूटोरियल इंस्टॉलेशन और वर्कफ़्लोज़ कवर करते हैं, और हमारा Codex बनाम Claude Code तुलना स्वयं हार्नेस का तुलनात्मक आकलन करता है।
अंतिम विचार
यदि आपका वर्कलोड लंबा, एजेंटिक कोडिंग है, या आपकी रिक्वेस्ट्स लॉन्ग-कॉन्टेक्स्ट थ्रेशहोल्ड पार करती हैं, तो Claude Opus 5.5 इस्तेमाल करें: यह एजेंटिक नंबरों में मजबूत नतीजे प्रकाशित करता है, और इसकी प्राइसिंग बड़ी रिक्वेस्ट्स को दंडित नहीं करती। यदि आप उस थ्रेशहोल्ड के नीचे वॉल्यूम चलाते हैं, Codex या ChatGPT Work में रहते हैं, या बजट में बिजनेस ऐप्स ऑटोमेट करते हैं, तो GPT-6 Sol का उपयोग करें और बचत करें।
मुझे सबसे दिलचस्प यह लगता है कि किसी भी वेंडर ने दूसरे के नए मॉडल को अपनी तालिका में नहीं रख पाया, और जहाँ हम उन्हें खुद तुलना कर सके—एक स्व-निहित बिल्ड—वहाँ सस्ता मॉडल पॉलिश पर आगे निकला।
यदि आप किसी भी मॉडल के साथ बनाने को उत्सुक हैं, तो मैं हमारे Working with the OpenAI API और हमारे Introduction to Claude Models कोर्स की सिफारिश करता हूँ।
FAQs
मुझे Claude Opus 5.5 के बजाय GPT-6 Sol कब इस्तेमाल करना चाहिए?
जब आपकी रिक्वेस्ट्स 272K इनपुट टोकन के नीचे रहती हैं और वॉल्यूम मायने रखता है, तब GPT-6 Sol का उपयोग करें: यह 1M इनपुट टोकन पर $2 और 1M आउटपुट टोकन पर $10 पर सूचीबद्ध है—Claude Opus 5.5 के $4 और $20 का आधा। यदि आपकी टीम Codex या ChatGPT Work में काम करती है तो यह स्वाभाविक विकल्प है। 272K टोकन से ऊपर की रिक्वेस्ट्स, लंबे समय तक चलने वाले एजेंटिक कोडिंग, या जब आपको मॉडल Cursor में या तीनों बड़े क्लाउड्स पर चाहिए—तब Opus 5.5 चुनें।
GPT-6 Sol, Claude Opus 5.5 से कितना सस्ता है?
सूची मूल्य पर, Claude Opus 5.5 इनपुट पर GPT-6 Sol से ठीक दोगुना पड़ता है ($4 बनाम $2 प्रति 1M टोकन), आउटपुट पर ($20 बनाम $10), और कैश राइट्स पर ($5 बनाम $2.50)। कैश रीड्स दोनों पर $0.20 प्रति 1M टोकन हैं। Sol किसी भी 272K इनपुट टोकन से ऊपर की रिक्वेस्ट पर इनपुट पर 2x और आउटपुट पर 1.5x चार्ज करता है, जबकि Anthropic पूरी 1M कॉन्टेक्स्ट को मानक दरों पर बिल करता है, इसलिए लॉन्ग-कॉन्टेक्स्ट रीट्रीवल पर अंतर लगभग 8% रह जाता है और कैश-भारी एजेंट लूप्स पर लगभग 33%।
GPT-6 Sol और Claude Opus 5.5 के API मॉडल IDs क्या हैं?
OpenAI API पर, GPT-6 Sol है gpt-6-sol। Claude API पर, Claude Opus 5.5 है claude-opus-5-5, और Amazon Bedrock पर है anthropic.claude-opus-5-5। OpenRouter के माध्यम से, दोनों हैं openai/gpt-6-sol और anthropic/claude-opus-5.5।
मैं GPT-6 Sol और Claude Opus 5.5 कहाँ एक्सेस कर सकता/सकती हूँ?
GPT-6 Sol, ChatGPT Work और Codex में Plus, Pro, Business, Enterprise, और Edu यूज़र्स के लिए, OpenAI API के माध्यम से, Azure AI Foundry और AWS Bedrock पर, GitHub Copilot में, और OpenRouter के जरिए उपलब्ध है; यह अभी ChatGPT के कंज्यूमर चैट में नहीं है। Claude Opus 5.5, Claude ऐप्स में, Claude API के माध्यम से, AWS Bedrock, Google Cloud Vertex AI, और Microsoft Foundry पर, और Claude Code, Cursor, तथा GitHub Copilot में उपलब्ध है।
कोडिंग के लिए कौन बेहतर है, GPT-6 Sol या Claude Opus 5.5?
प्रकाशित बेंचमार्क्स पर, Claude Opus 5.5 आगे है: Anthropic, Terminal-Bench 4.0 पर 66.4% और FrontierCode पर 54.4% रिपोर्ट करता है, जबकि OpenAI कहता है कि GPT-6 Sol, FrontierCode पर Claude Fable 5.1 से मेल खाता है, जिसे Anthropic 50.3% स्कोर करता है। हमारे हैंड्स-ऑन टेस्ट में—एक ग्रैविटी फ्लिप वाले सिंगल-फ़ाइल Tetris क्लोन—दोनों मॉडलों ने लॉजिक सही किया और GPT-6 Sol ने पॉलिश और फील पर 5.0 स्कोर किया, Opus 5.5 के 4.3 के मुकाबले।
Anthropic के नए मॉडल पर ध्यान सिर्फ लगभग एक घंटे टिका रहा—जैसे ही अधिक कुशल और किफायती फ्रंटियर मॉडलों की दौड़ में एक और दावेदार आ गया।
उनका Claude Opus 5.5, Claude 5.5 परिवार का पहला मॉडल है, जिसे Opus 5 से कम रनिंग कॉस्ट पर Fable 5.1-स्तरीय प्रदर्शन के रूप में पेश किया गया है।
OpenAI ने बहुत तेजी से जवाब दिया, GPT-6 परिवार के मिड-टियर के रूप में GPT-6 Sol प्रकाशित किया, जिसे फ्लैगशिप GPT-6 Astra जैसी ही विधियों से प्रशिक्षित किया गया है, और इसे इसके पूर्ववर्ती GPT-5.6 Sol की तुलना में आधे API मूल्य पर लॉन्च किया गया।
इस लेख में, मैं प्रदर्शन के कई वर्गों, गार्डरेल्स, और प्राइसिंग में GPT-6 Sol और Claude Opus 5.5 की तुलना करूंगा, और दोनों पर चलाया गया एक हैंड्स-ऑन बिल्ड टेस्ट भी शामिल करूंगा।
संक्षेप में
GPT-6 Sol क्या है?
GPT-6 Sol, OpenAI का मिड-टियर GPT-6 मॉडल है, जो 22 सितंबर, 2026 को GPT-6 Luna के साथ जारी हुआ और फ्लैगशिप GPT-6 Astra के नीचे स्थित है।
इसका बिक्री-बिंदु है Astra का ट्रेनिंग नुस्खा, GPT-5.6 Sol के API मूल्य के आधे पर, साथ ही ऐसा प्रॉम्प्ट कैशिंग जो बातचीत के बीच में reasoning effort या टूल्स के बदलने पर भी बनी रहती है।
हमारा GPT-6 Sol और Luna गाइड लॉन्च कवर करता है, और हमारा GPT-6 Astra API ट्यूटोरियल इस परिवार के async टूल्स और स्टीयरिंग को समझाता है।
Claude Opus 5.5 क्या है?
Claude Opus 5.5, Anthropic का पहला Claude 5.5 मॉडल है, जो 22 सितंबर, 2026 को जारी हुआ, और लंबे समय तक चलने वाले एजेंटिक कोडिंग और नॉलेज वर्क के लिए कंपनी का नया अग्रणी मॉडल है।
इसका बिक्री-बिंदु है Fable-क्लास नतीजे, Opus कीमतों पर: Anthropic कहता है कि यह अधिकांश कामों पर Claude Fable 5.1 की बराबरी करता है, और इसमें Fable-क्लास साइबरसुरक्षा और बायोलॉजी सेफगार्ड्स शामिल हैं।
हमारा Opus 5.5 गाइड लॉन्च कवर करता है, और हमारा Claude Opus 5 API ट्यूटोरियल पिछली पीढ़ी के API को कवर करता है।
GPT-6 Sol बनाम Claude Opus 5.5: आमने-सामने तुलना
करीब-करीब एक साथ रिलीज़ के कारण, किसी भी वेंडर ने अपने लॉन्च टेबल में दूसरे के नए मॉडल को शामिल नहीं किया, इसलिए दोनों मॉडल केवल दो बेंचमार्क्स पर ओवरलैप करते हैं—और Opus 5.5 दोनों में आगे है। Sol का तर्क कीमत और हमारे अपने टेस्ट में इसके प्रदर्शन पर टिका है।
noneसेmaxतक effort; अपने कोडिंग कार्य के बारे में GPT-5.6 Sol से कम भ्रामक दावेकोडिंग और एजेंटिक वर्कफ़्लोज़
Opus 5.5 के एजेंटिक-कोडिंग नंबर मजबूत हैं, और Sol की पोस्ट उन्हें सीधे चुनौती नहीं देती। Anthropic ने Opus 5.5 को Terminal-Bench 4.0, FrontierCode, और CursorBench पर रिपोर्ट किया; OpenAI ने Sol को DeepSWE पर रिपोर्ट किया और FrontierCode पर इसके नतीजे को केवल इतना कहा कि यह xhigh effort पर Claude Fable 5.1 से मेल खाता है। Anthropic Fable 5.1 को FrontierCode पर 50.3% रखता है जबकि Opus 5.5 54.4% है, तो अगर दोनों दावे सही हैं, तो दोनों वेंडर्स द्वारा उल्लेखित एकमात्र कोडिंग बेंचमार्क पर Sol, Opus 5.5 से लगभग चार अंक पीछे बैठता है।
दोनों वेंडर साझा स्कोर की बजाय लंबे-क्षितिज किस्सों पर निर्भर हैं। Anthropic के आंतरिक HAProxy री-राइट (C से Rust) में Opus 5.5 ने 9.5 घंटे में पूरा किया जबकि Fable 5.1 को 12 घंटे लगे, 51% कम लागत पर। OpenAI का तर्क प्रति-टास्क लागत है: Sol, DeepSWE पर Fable 5 के स्कोर से लगभग एक अंक के भीतर आता है, लगभग 80% कम लागत पर।
इन तालिकाओं को थोड़े संदेह के साथ देखने के दो कारण:
कागज पर, Opus 5.5 मजबूत कोडिंग मॉडल है; नीचे दिया गया हमारा एकल बिल्ड टेस्ट वह जगह है जहां यह अंतर दिखा नहीं।
बिजनेस वर्कफ़्लोज़ और कंप्यूटर उपयोग
Opus 5.5 उन दोनों साझा बेंचमार्क्स में आगे है, और AutomationBench का अंतर इस लेख का सबसे साफ नंबर है: 47 बिजनेस टूल्स पर काम करने वाले एजेंट्स के Zapier टेस्ट में Opus 5.5 के लिए 40.0% बनाम Sol के लिए 33.2%।
Sol की काट है बिल: OpenAI, Sol को Claude Opus 5 के मुकाबले प्रति-टास्क लागत के 9% पर बेहतर बताता है, हालांकि यह तुलना पिछले Opus से है, इससे नहीं।
स्कोर पर Opus 5.5 सशक्त एजेंट है; हर टिकट पर चलाने लायक Sol है।
नॉलेज वर्क और तथ्यात्मक विश्वसनीयता
यहाँ Opus 5.5 के पास एकमात्र क्रॉस-वेंडर नंबर है: GDPval-AA v2.1 पर 1846 Elo, Anthropic की तालिका में GPT-6 Astra और GPT-5.6 Sol के स्कोर से आगे; स्वयं Sol सूचीबद्ध नहीं है। Anthropic के रिपोर्ट-लेखन टेस्ट में, जहाँ कोई भी गढ़ा हुआ आँकड़ा रन फेल कर देता है, Opus 5.5 की 18 में से 16 रिपोर्ट पास हुईं, और न Fable 5.1 और न Opus 5 एक बार भी पास हुए।
Sol का साक्ष्य अपने पूर्ववर्ती के मुकाबले है: OpenAI के आंतरिक factuality सेट पर, Sol, GPT-5.6 Sol की तुलना में लगभग आधी गलतियाँ करता है। Artificial Analysis के AA-Omniscience टेस्ट भी सहमत हैं, एक शर्त के साथ: Sol की hallucination दर 92% से 60% पर आ गई, जबकि इसने सवालों के 83% ही जवाब दिए, अपने पूर्ववर्ती के 99% के मुकाबले।
दोनों अपने पूर्ववर्तियों से अधिक सतर्क हैं; प्रतिद्वंद्वी के मुकाबले इसे दिखाने वाला केवल Opus 5.5 है।
गार्डरेल्स और API सीमाएँ
Sol का API कम बाधित है, और Opus 5.5 अधिक सुपरवाइज़्ड है।
Opus 5.5 में thinking को बंद करके नहीं चलाया जा सकता, फोर्स्ड टूल यूज़ को अस्वीकार करता है, और thinking ब्लॉक्स को उसी मॉडल और बातचीत से बाँधता है जिसने उन्हें उत्पन्न किया, इसलिए संपादित संदर्भ 31 अगस्त, 2026 के बाद बनाए गए खातों पर 400 त्रुटि देता है। अधिकांश साइबरसुरक्षा कार्य उसके Cyber Verification Program के बाहर Opus 4.8 पर रीरूट होते हैं, और बायोलॉजी कार्य के लिए उसका Life Sciences Verification Program चाहिए।
Sol की सीढ़ी
noneसेmaxतक चलती है, बातचीत के बीच में effort बदले जा सकते हैं बिना कैश तोड़े, और OpenAI, GPT-5.6 Sol की तुलना में इसके कोडिंग कार्य के बारे में कम भ्रामक दावों की रिपोर्ट करता है।यह सौदा सोच-समझ कर किया गया है: Opus 5.5 ने containment सीमाएँ पार करने का प्रयास Opus 5 की तुलना में लगभग 85% कम बार किया, जो अनअटेंडेड एजेंट्स के लिए मायने रखता है।
कीमत: आप वास्तव में क्या चुकाते हैं
हेडलाइन रेट्स पर Opus 5.5, Sol से ठीक दोगुना है, लेकिन वे दो तंत्र, जिनके लिए एजेंट वास्तव में भुगतान करते हैं, पैटर्न तोड़ते हैं: कैश रीड्स की कीमत एक समान है, और Sol 272K टोकन से ऊपर पर एक सरचार्ज जोड़ देता है, जो Anthropic नहीं लेता।
टोकन दरें, साथ-साथ
प्रीमियम इनपुट, आउटपुट, और कैश राइट्स में एक समान है, इसलिए यह हर वर्कलोड शेप को बराबर चोट पहुँचाता है—जब तक कैशिंग या लंबा कॉन्टेक्स्ट तस्वीर में नहीं आता। कैश्ड रीड्स अपवाद हैं, और Anthropic कहता है कि वे एजेंटिक और कोडिंग कार्य की लागत का अधिकांश हिस्सा बनाते हैं। कोई भी वेंडर reasoning टोकन के लिए अलग दर प्रकाशित नहीं करता, इसलिए उन्हें आउटपुट दर पर बजट करें।
वास्तविक वर्कलोड की लागत
थ्रेशहोल्ड-से-ऊपर वाली पंक्ति हेडलाइन है: एक बार जब हर रिक्वेस्ट थ्रेशहोल्ड पार करती है, Sol का सरचार्ज इसका बिल Opus 5.5 से केवल 8% के भीतर ले आता है, इसलिए लंबे-कॉन्टेक्स्ट वाली रीट्रीवल पाइपलाइन को Sol चुनने पर लगभग कोई छूट नहीं मिलती। कैश-भारी लूप अलग वजह से अंतर 33% तक लाता है: 1,000 कैश्ड रीड्स की कीमत दोनों मॉडलों पर एक समान है, और केवल ताजे टोकन 2x प्रीमियम ढोते हैं।
दोनों मॉडल अलग टोकनाइज़र इस्तेमाल करते हैं, और किसी वेंडर ने साझा वर्कलोड के लिए टोकन काउंट प्रकाशित नहीं किए, इसलिए इन टोटल्स को बिल की बजाय दर तुलना की तरह देखें। Anthropic यह तो कहता है कि Opus 5.5 प्रति-टास्क Opus 5 से कम टोकन इस्तेमाल करता है, पर Sol के मुकाबले कैसा है—यह नहीं।
GPT-6 Sol और Claude Opus 5.5 ने कैसा प्रदर्शन किया
दो वेंडरों के बेंचमार्क, जिन्होंने एक-दूसरे के मॉडल का परीक्षण नहीं किया, सीमित मायने रखते हैं, इसलिए मैंने दोनों पर एक बिल्ड टास्क, एक जैसे प्रॉम्प्ट और एक जैसे टूलिंग के साथ चलाया।
टेस्ट
मैंने दोनों से 12×24 बोर्ड पर एक सिंगल-फ़ाइल Tetris क्लोन बनाने को कहा, एक ट्विस्ट के साथ: हर 20 सेकंड में ग्रैविटी पलटती है। दो बातें जो प्रॉम्प्ट मांगता है, इसे कठिन बनाती हैं: फ्लिप के बाद, पीसेज़ को छत की ओर गिरना होगा और वहाँ बने दूसरे स्टैक पर लॉक होना होगा, और दोनों स्टैक्स पर फुल रो क्लीयर होनी चाहिए, और जो सेल पहले से लॉक हैं, वे कभी न हिलें।
दोनों मॉडल OpenCode के अंदर एक जैसे पिन किए गए टूल सरफेस पर चले: सिर्फ फ़ाइल रीडिंग, सर्चिंग, और एडिटिंग; कोई शेल नहीं और कोई नेटवर्क नहीं। दोनों
highreasoning effort पर चले, एक–एक प्रयास, कोई रिट्राई नहीं, और प्रॉम्प्ट बाइट-टू-बाइट एक नई सेशन को दिया गया।ध्यान रखने लायक एक विषमता:
highदोनों सीढ़ियों पर छत से दो पायदान नीचे बैठता है, पर Sol की सीढ़ी के नीचे एक अतिरिक्तnoneपायदान है, इसलिएhighउसके छह में चौथा और Opus 5.5 के पाँच में तीसरा है।यह था प्रॉम्प्ट:
मैंने लागत दर्ज की और दोनों को निम्न तीन रुब्रिक्स पर 1 से 5 तक अंक दिए:
GPT-6 Sol ने क्या बनाया
Sol ने 6 टर्न और 9 टूल कॉल लिए: इसने खाली वर्कस्पेस को लिस्ट, सर्च और रीड किया, फिर 22 KB का
index.htmlलिखा, और उसके बाद एक बार और पैच किया। जो निकला, उसका अपना ब्रांडिंग था—"Fall / Rise, a game of shifting ground"—एक ग्रैविटी पैनल के साथ जो फ्लिप पर एम्बर से टील में रंग बदलता है, अगली इन्वर्ज़न तक की काउंटडाउन, और मार्जिन में एक रूल कार्ड।यह वैसा ही करता है जैसा इसे करना चाहिए और स्मूद तथा स्थिरता से काम करता है: फ्लिप पर फ्लोर स्टैक अपनी जगह रहता है, पीसेज़ ऊपर उठते हैं और छत पर लॉक होते हैं, दोनों स्टैक्स पर रो क्लीयर होती हैं, और सॉफ्ट ड्रॉप रेस्पॉन्सिव लगता है, जिससे इसे खेलना दोनों में ज्यादा मज़ेदार रहा।