Die Vorschau für das nächste Teil zeigt den Buchstaben des Tetrominos — O, I, T, S, Z — statt die Form zu zeichnen. Wer die Notation kennt, kann es lesen, aber es kostet jedes Mal einen Moment, und bei Tempo zählt das. Keines der Modelle wurde überhaupt um eine Vorschau gebeten, also war das Sols freiwillige Entscheidung, die dann etwas zu dünn umgesetzt wurde. Das ist die eine Stelle, an der der poliertere Build weniger gut lesbar ist.
Was Claude Opus 5.5 geliefert hat
Opus 5.5 brauchte 3 Züge und 2 Tool-Calls, ein Glob und einen Write, um eine 19 KB große index.html namens „Flip Tetris“ zu shippen. Sein Header-Kommentar ist die sorgfältigere Spez der beiden: ein 7-Bag-Randomizer auf fester Seed, Rotation mit Wall Kicks, zeilenweises Kollabieren je Stapel und der Hinweis, dass ein fallendes Teil schlicht die Richtung umkehrt, wenn die Schwerkraft flippt.
Das Spiel funktioniert exakt wie beschrieben und ebenso stabil wie bei Sol, mit Ghost Piece und einer Countdown-Leiste, die vor jedem Flip rot wird. Seine Vorschau für das nächste Teil zeichnet die tatsächliche Form – das ist die richtige Entscheidung und der eine Punkt, in dem es auf den ersten Blick besser ist als Sol.
Es hat außerdem einen Level-Zähler hinzugefügt, den niemand gefordert hat. Das würde ich eher als neutral denn als Pluspunkt werten: Die Level steigen so langsam, dass es erst spät im Spiel einen Unterschied macht – länger, als man eines dieser Builds realistisch spielt. Wo Opus verliert, ist das Gefühl, nicht die Logik: Das Layout ist schlichter als bei Sol, und der Soft Drop ist weniger geschmeidig. Daher ein Punkt Abzug bei der visuellen Qualität und einer bei der Vollständigkeit.
Ergebnisse
| Messgröße | GPT-6 Sol | Claude Opus 5.5 |
|---|---|---|
| Züge | 6 | 3 |
| Tool-Calls | 9 | 2 |
| Kosten | $0,26 | $0,87 |
| Tokens gesamt | 120.226 | 107.958 |
| Reasoning-Tokens | 8.123 | 22.551 |
| Lauffähigkeit | pass | pass |
| Flip-Mechanik | 5 | 5 |
| Spielvollständigkeit | 5 | 4 |
| Visuelle Qualität und Gefühl | 5 | 4 |
| Rubric-Score (Mittelwert aus drei Achsen) | 5 | 4,3 |
GPT-6 Sol gewinnt diesen Test, knapp, und nicht beim harten Teil. Beide haben den Gravity-Flip korrekt umgesetzt, also entschied am Ende die Ausführung. Sols Reaktionsfreude und die visuelle Politur geben ihm die Nase vorn.
Deutlicher trennen sie die Kosten. Opus 5.5 gab $0,87 aus gegen $0,26 bei Sol, also mehr als das Dreifache, und das bei weniger Tokens insgesamt: 108k gegen 120k. Der Unterschied liegt im Reasoning: Opus dachte pro Zug etwa dreimal so intensiv nach, kam in der Hälfte der Züge zur korrekten Lösung und hörte auf. Sol iterierte stattdessen in der Datei, günstig, und lag beim Spielgefühl leicht vorn.
Das ist ein einzelner Lauf einer Aufgabe bei einer Aufwandseinstellung und testet Game-Loop-Logik in einer Datei, nicht die Langstrecken-Arbeit im Repository, für die beide Anbieter benchen. Die Kosten sind je ein Datenpunkt, kein Durchschnitt.
Wann du GPT-6 Sol vs Claude Opus 5.5 wählen solltest
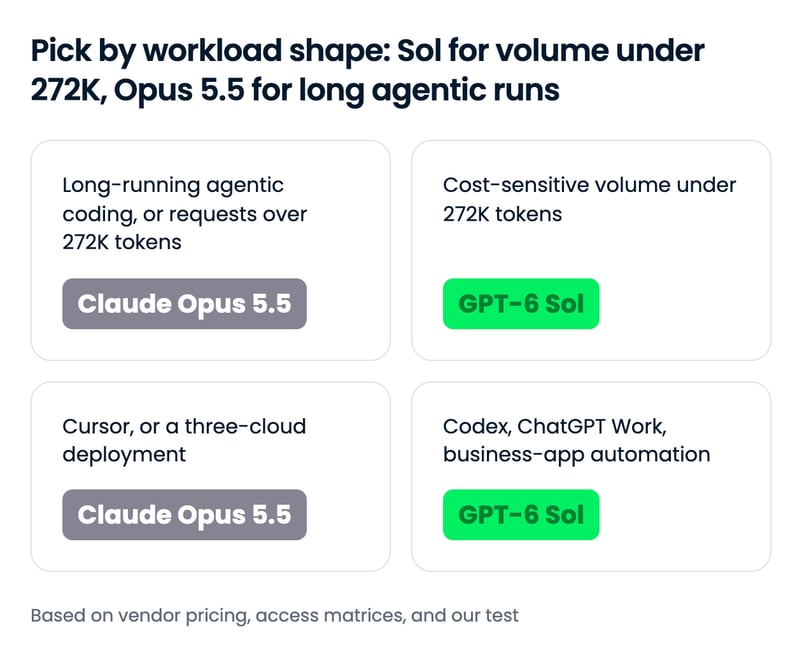
Die Gabelung liegt bei Anfragengröße und Workload-Form, nicht bei der reinen Fähigkeit: Unter 272K Tokens pro Anfrage ist Sols Rabatt real; darüber oder bei cache-lastigen Loops nähern sich die Rechnungen an, und Opus 5.5s veröffentlichte Führung bei agentischer Arbeit ist das, wofür du zahlst.
Wähle GPT-6 Sol, wenn ...
- Du hochvolumige Agenten betreibst, bei denen jede Anfrage unter der Langkontext-Schwelle bleibt. Der halbe Listenpreis summiert sich über Millionen Anfragen, und der Cache-Read-Preis ist ohnehin identisch.
- Dein Team bereits in Codex oder ChatGPT Work arbeitet. Sol ist dort auf jedem bezahlten Plan verfügbar, und Codex ist das Harness, für das OpenAI es getunt hat.
- Du Business-Workflows mit schmalem Budget automatisierst. Sols AutomationBench-Lauf kostete $0,27 pro Aufgabe, und OpenAIs Aussagen zu Kosten pro Aufgabe sind sein stärkstes Argument.
- Du eine Aufwandstreppe willst, die ganz nach unten reicht. Sols Einstellung
noneund cache-sichere Änderungen am Aufwand erlauben günstige Follow-ups und eskalieren nur die harten Schritte.
Wähle Claude Opus 5.5, wenn ...
- Du lang laufendes agentisches Coding machst: Migrationen, Audits und Multi-Repository-Aufgaben. Opus 5.5 veröffentlicht stärkere Scores auf jedem agentischen Coding-Benchmark, den es berichtet, und die Anekdoten der Tester handeln von Jobs, die stundenlang laufen.
- Deine Anfragen routinemäßig Sols Langkontext-Schwelle überschreiten. Anthropic rechnet das volle 1M-Fenster zu Standardraten ab, und Sols Zuschlag schließt den Großteil der Preislücke bei dieser Größe.
- Du das Modell heute in Cursor oder auf allen drei Hyperscaler-Clouds brauchst. Opus 5.5 ist in Cursor sowie auf Bedrock, Vertex AI und Microsoft Foundry gelistet; Sol ist in Cursor und Vertex AI nicht verfügbar.
- Du Agenten unbeaufsichtigt laufen lässt und das konservativere Modell willst. Anthropics Containment-Evaluierung und die Safeguards auf Fable-Niveau sind genau dafür gebaut, sofern es nicht um Cybersicherheit geht.
So startest du mit GPT-6 Sol und Claude Opus 5.5
| Surface | GPT-6 Sol | Claude Opus 5.5 |
|---|---|---|
| Consumer-App | ChatGPT Work und Codex auf Plus-, Pro-, Business-, Enterprise- und Edu-Plänen; noch nicht in ChatGPTs Chat | Claude-Apps; Nutzungsgrenzen bei Pro, Max, Team und Enterprise zum Launch erhöht |
| First-Party-API | Ja, OpenAI API (Responses API empfohlen) | Ja, Claude API |
| Cloud-Plattformen | Azure AI Foundry, AWS Bedrock | AWS Bedrock, Google Cloud Vertex AI, Microsoft Foundry |
| Coding-Agenten | Codex, GitHub Copilot | Claude Code, Cursor, GitHub Copilot |
| Third-Party-Router | OpenRouter, Vercel AI Gateway | OpenRouter, Vercel AI Gateway |
| API-Model-ID | gpt-6-sol | claude-opus-5-5 |
Opus 5.5 startete am ersten Tag auf allen drei großen Clouds und in Cursor, während Sol auf zwei Clouds ist und in Cursors Modellliste fehlt. In den APIs lauten die Strings gpt-6-sol und claude-opus-5-5.
GPT-6 Sol und Claude Opus 5.5 in einem Coding-Agenten nutzen
Jedes Modell wird im eigenen Agenten des Anbieters ausgeliefert, Codex für Sol und Claude Code für Opus 5.5, und beide sind in GitHub Copilot auswählbar. Wenn du ein gemeinsames Harness für beide willst, erreicht ein Router-gestützter Agent wie OpenCode sie über OpenRouter als openai/gpt-6-sol und anthropic/claude-opus-5.5 – so liefen unsere Tests mit identischem Tooling.
Direkte API-Calls nutzen unterschiedliche SDKs, daher ist der Tausch ein Client und ein Modell-String, nicht eine einzelne Codezeile:
from openai import OpenAI
client = OpenAI()
response = client.responses.create(
model="gpt-6-sol",
reasoning={"effort": "high"},
input="Refactor this module and explain what you changed.",
)
print(response.output_text)from anthropic import Anthropic
client = Anthropic()
response = client.messages.create(
model="claude-opus-5-5",
max_tokens=4096,
messages=[{"role": "user", "content": "Refactor this module and explain what you changed."}],
)
print(response.content[0].text)Für die vollständigen Agent-Setups behandeln unser Codex-CLI-Tutorial und unser Claude-Code-Tutorial Installation und Workflows, und unser Vergleich Codex vs Claude Code bewertet die Harnesses selbst.
Fazit
Wenn deine Workload aus langem, agentischem Coding besteht oder deine Anfragen über die Langkontext-Schwelle hinausgehen, nutze Claude Opus 5.5: Es veröffentlicht die stärkeren agentischen Zahlen, und die Preise bestrafen große Anfragen nicht. Wenn du Volumen unterhalb dieser Schwelle fährst, in Codex oder ChatGPT Work lebst oder Business-Apps mit Budgetdruck automatisierst, nimm GPT-6 Sol und steck die Ersparnis ein.
Am spannendsten finde ich, dass keiner der Anbieter das neue Modell des anderen in seine Tabelle bekommen hat – und in dem einen Punkt, an dem wir selbst vergleichen konnten, einem in sich geschlossenen Build, lag das günstigere Modell bei der Politur vorn.
Wenn du mit einem der Modelle loslegen willst, empfehle ich unsere Kurse Working with the OpenAI API und Introduction to Claude Models.
FAQs
Wann sollte ich GPT-6 Sol statt Claude Opus 5.5 verwenden?
Nutze GPT-6 Sol, wenn deine Anfragen unter 272K Input-Tokens bleiben und Volumen zählt: Es listet bei $2 pro 1 Mio. Input-Tokens und $10 pro 1 Mio. Output-Tokens, also zur Hälfte von Claude Opus 5.5 mit $4 und $20. Es ist auch die natürliche Wahl, wenn dein Team in Codex oder ChatGPT Work arbeitet. Wähle Opus 5.5 für lang laufendes agentisches Coding, für Anfragen über 272K Tokens oder wenn du das Modell in Cursor oder auf allen drei großen Clouds brauchst.
Wie viel günstiger ist GPT-6 Sol als Claude Opus 5.5?
Zum Listenpreis kostet Claude Opus 5.5 exakt doppelt so viel wie GPT-6 Sol beim Input ($4 vs. $2 pro 1 Mio. Tokens), Output ($20 vs. $10) und bei Cache-Writes ($5 vs. $2,50). Cache-Reads kosten bei beiden $0,20 pro 1 Mio. Tokens. Sol berechnet 2x Input und 1,5x Output für jede Anfrage über 272K Input-Tokens, während Anthropic das volle 1M-Kontextfenster zu Standardraten abrechnet. Dadurch schrumpft die Lücke auf etwa 8% bei Langkontext-Retrieval und auf etwa 33% bei cache-lastigen Agent-Loops.
Wie lauten die API-Model-IDs für GPT-6 Sol und Claude Opus 5.5?
Auf der OpenAI API lautet GPT-6 Sol gpt-6-sol. Auf der Claude API heißt Claude Opus 5.5 claude-opus-5-5, und auf Amazon Bedrock anthropic.claude-opus-5-5. Über OpenRouter sind die beiden openai/gpt-6-sol und anthropic/claude-opus-5.5.
Wo kann ich auf GPT-6 Sol und Claude Opus 5.5 zugreifen?
GPT-6 Sol ist in ChatGPT Work und Codex für Plus-, Pro-, Business-, Enterprise- und Edu-User verfügbar, über die OpenAI API, auf Azure AI Foundry und AWS Bedrock, in GitHub Copilot und via OpenRouter; es ist noch nicht im Consumer-Chat von ChatGPT. Claude Opus 5.5 ist in den Claude-Apps, über die Claude API, auf AWS Bedrock, Google Cloud Vertex AI und Microsoft Foundry sowie in Claude Code, Cursor und GitHub Copilot verfügbar.
Welches ist besser für Coding, GPT-6 Sol oder Claude Opus 5.5?
Auf veröffentlichten Benchmarks liegt Claude Opus 5.5 vorne: Anthropic meldet 66,4% auf Terminal-Bench 4.0 und 54,4% auf FrontierCode, während OpenAI sagt, GPT-6 Sol entspreche Claude Fable 5.1 auf FrontierCode, das Anthropic mit 50,3% bewertet. In unserem eigenen Hands-on-Test, einem Tetris-Klon als Einzeldatei mit Gravity-Flip, lagen beide bei der Logik richtig, und GPT-6 Sol erzielte 5,0 zu 4,3 bei Opus 5.5 in Politur und Spielgefühl.



Die Aufmerksamkeit für Anthropics neues Modell hielt im Rennen um effizientere und erschwinglichere Frontier-Modelle nur etwa eine Stunde.
Claude Opus 5.5 ist das erste Modell der Claude-5.5-Familie und wird als Leistung auf Fable-5.1-Niveau bei geringeren Laufzeitkosten als Opus 5 positioniert.
OpenAI reagierte sehr schnell, veröffentlichte GPT-6 Sol als Mid-Tier-Modell der GPT-6-Familie, trainiert mit denselben Methoden wie das Flaggschiff GPT-6 Astra, und startete zum halben API-Preis seines Vorgängers GPT-5.6 Sol.
In diesem Artikel vergleiche ich GPT-6 Sol und Claude Opus 5.5 in vielen Leistungskategorien, bei Sicherheitsmechanismen und Preisen und zeige einen Hands-on-Build-Test, den ich mit beiden durchgeführt habe.
TL;DR
Was ist GPT-6 Sol?
GPT-6 Sol ist OpenAIs mittleres GPT-6-Modell, veröffentlicht am 22. September 2026 zusammen mit GPT-6 Luna und unterhalb des Flaggschiffs GPT-6 Astra positioniert.
Das Verkaufsargument: Astras Trainingsrezept zum halben API-Preis von GPT-5.6 Sol, mit Prompt-Caching, das auch bei Änderungen des Reasoning-Aufwands oder der Tools mitten im Gespräch bestehen bleibt.
Unser Leitfaden zu GPT-6 Sol und Luna deckt den Launch ab, und unser GPT-6-Astra-API-Tutorial führt durch die asynchronen Tools und Steuerungsoptionen der Familie.
Was ist Claude Opus 5.5?
Claude Opus 5.5 ist Anthropics erstes Claude-5.5-Modell, veröffentlicht am 22. September 2026, und das neue Spitzenmodell des Unternehmens für lang laufendes agentisches Coding und Wissensarbeit.
Das Verkaufsargument: Ergebnisse auf Fable-Niveau zu Opus-Preisen. Anthropic sagt, es erreiche bei den meisten Aufgaben Claude Fable 5.1 und werde mit Sicherheitsmechanismen auf Fable-Niveau für Cybersicherheit und Biologie ausgeliefert.
Unser Opus-5.5-Leitfaden deckt den Launch ab, und unser Claude-Opus-5-API-Tutorial beschreibt die API der vorherigen Generation.
GPT-6 Sol vs Claude Opus 5.5: Direktvergleich
Wegen der knappen Release-Timings hat kein Anbieter das jeweils neue Modell des anderen in seine Launch-Tabelle aufgenommen. Die Modelle überlappen daher nur bei zwei Benchmarks, und Opus 5.5 führt beide an. Sols Argument stützt sich auf den Preis und darauf, wie es sich in unserem eigenen Test geschlagen hat.
nonebismax; weniger irreführende Aussagen zu Coding-Arbeit als GPT-5.6 SolCoding und agentische Workflows
Opus 5.5 veröffentlicht die stärkeren agentischen Coding-Zahlen, und Sols Beitrag stellt sie nicht direkt infrage. Anthropic berichtet Opus 5.5 auf Terminal-Bench 4.0, FrontierCode und CursorBench; OpenAI nennt Sol auf DeepSWE und beschreibt sein FrontierCode-Ergebnis nur als „entspricht Claude Fable 5.1 bei xhigh Aufwand“. Anthropic setzt Fable 5.1 auf 50,3% auf FrontierCode gegen 54,4% für Opus 5.5. Wenn beide Aussagen stimmen, liegt Sol auf dem einen Coding-Benchmark, den beide Anbieter erwähnen, etwa vier Punkte hinter Opus 5.5.
Beide Anbieter stützen sich eher auf Langstrecken-Anekdoten als auf gemeinsame Scores. Anthropics internes HAProxy-Rewrite von C auf Rust ließ Opus 5.5 in 9,5 Stunden abschließen, gegen 12 Stunden für Fable 5.1, bei 51% geringeren Kosten. OpenAIs Argument ist der Preis pro Aufgabe: Sol landet etwa einen Punkt unter Fable 5 auf DeepSWE bei rund 80% niedrigeren Kosten.
Zwei Gründe, diese Tabellen mit Vorsicht zu genießen:
Auf dem Papier ist Opus 5.5 das stärkere Coding-Modell; unsere einzelne Build-Probe unten zeigte diese Lücke jedoch nicht.
Business-Workflows und Computerbedienung
Opus 5.5 führt beide Benchmarks an, die die zwei Modelle teilen, und die AutomationBench-Lücke ist die sauberste Zahl in diesem Artikel: 40,0% für Opus 5.5 gegen 33,2% für Sol im Zapier-Test von Agenten über 47 Business-Tools.
Sol kontert mit der Rechnung: OpenAI stellt Sol als Sieger gegen Claude Opus 5 bei 9% von Opus 5s Kosten pro Aufgabe dar – der Vergleich bezieht sich allerdings auf das vorherige Opus, nicht auf dieses.
Opus 5.5 ist der stärkere Agent nach Score; Sol ist das Modell, das du dir auf jedem Ticket leisten kannst.
Wissensarbeit und Faktentreue
Opus 5.5 hält hier die einzige herstellerübergreifende Zahl: 1846 Elo auf GDPval-AA v2.1, vor den GPT-6-Astra- und GPT-5.6-Sol-Scores in Anthropics Tabelle; Sol selbst ist nicht gelistet. In Anthropics Report-Schreibtest, bei dem jede erfundene Zahl zum Durchfallen führt, bestanden 16 von 18 Opus-5.5-Reports, und weder Fable 5.1 noch Opus 5 bestanden ein einziges Mal.
Sols Beleg bezieht sich auf seinen eigenen Vorgänger: Auf OpenAIs internem Faktenset macht Sol etwa halb so viele Fehler wie GPT-5.6 Sol. Artificial Analysis' AA-Omniscience-Test bestätigt das mit einem Haken: Sols Halluzinationsrate fiel von 92% auf 60%, während es nur 83% der Fragen beantwortete, gegenüber 99% beim Vorgänger.
Beide sind vorsichtiger als ihre Vorgänger; nur Opus 5.5 hat es gegen einen Rivalen gezeigt.
Guardrails und API-Einschränkungen
Sol ist die weniger eingeschränkte API, und Opus 5.5 ist die stärker beaufsichtigte.
Opus 5.5 kann nicht mit abgeschaltetem Denken laufen, lehnt erzwungene Tool-Nutzung ab und bindet Thinking-Blöcke an das Modell und die Konversation, die sie erzeugt haben. Bearbeiteter Kontext führt daher zu einem 400-Fehler bei Accounts, die nach dem 31. August 2026 erstellt wurden. Die meisten Cybersicherheitsaufgaben werden außerhalb des Cyber Verification Program auf Opus 4.8 umgeleitet, und Biologiearbeit erfordert das Life Sciences Verification Program.
Sols Leiter reicht von
nonebismax, der Aufwand kann mitten im Gespräch geändert werden, ohne den Cache zu brechen, und OpenAI berichtet von weniger irreführenden Aussagen über seine Coding-Arbeit als bei GPT-5.6 Sol.Der Trade-off ist beabsichtigt: Opus 5.5 versuchte, Containment-Grenzen etwa 85% seltener zu überschreiten als Opus 5, was für unbeaufsichtigte Agenten wichtig ist.
Preise: Was du tatsächlich zahlst
Opus 5.5 kostet in den Headline-Rates genau doppelt so viel wie Sol, aber die zwei Mechanismen, die Agenten tatsächlich bezahlen, durchbrechen das Muster: Cache-Reads kosten gleich viel, und Sol erhebt einen Zuschlag über 272K Tokens, den Anthropic nicht hat.
Token-Raten im Vergleich
Der Aufpreis ist über Input, Output und Cache-Writes hinweg konstant, sodass er jede Workload-Form gleichermaßen trifft – bis Caching oder langer Kontext ins Spiel kommt. Cache-Reads sind die Ausnahme, und Anthropic sagt, sie machen den Großteil der Kosten für agentische Arbeit und Coding aus. Keiner der Anbieter veröffentlicht einen separaten Satz für Reasoning-Tokens, daher solltest du sie zum Output-Preis budgetieren.
Was eine reale Workload kostet
Die Zeile über der Schwelle ist die Kernaussage: Sobald jede Anfrage die Schwelle überschreitet, treibt Sols Zuschlag die Rechnung auf bis zu 8% an Opus 5.5 heran. Ein Langkontext-Retrieval-Pipeline erhält also kaum Rabatt, wenn sie Sol wählt. Die cache-lastige Schleife verengt die Lücke aus einem anderen Grund auf 33%: Die 1.000 gecachten Reads kosten bei beiden gleich, und nur die frischen Tokens tragen den 2x-Aufpreis.
Die beiden Modelle verwenden unterschiedliche Tokenizer, und keiner der Anbieter hat Token-Zählungen für eine gemeinsame Workload veröffentlicht. Betrachte diese Summen daher als Tarifvergleich, nicht als Rechnung. Anthropic sagt, Opus 5.5 verwende weniger Tokens pro Aufgabe als Opus 5, allerdings ohne Vergleich zu Sol.
Wie sich GPT-6 Sol und Claude Opus 5.5 geschlagen haben
Benchmarks von zwei Anbietern, die das Modell des jeweils anderen nicht getestet haben, reichen nur begrenzt weit. Also habe ich eine Build-Aufgabe gegen beide laufen lassen, mit identischem Prompt und identischer Tooling-Oberfläche.
Der Test
Ich habe beide gebeten, einen Tetris-Klon als Einzeldatei auf einem 12×24-Brett zu bauen, mit einem Twist: Die Schwerkraft kippt alle 20 Sekunden. Zwei fordernde Punkte im Prompt: Nach einem Flip müssen Steine zur Decke fallen und sich dort auf einem zweiten Stapel verankern; volle Reihen müssen auf beiden Stapeln gelöscht werden; und bereits verankerte Zellen dürfen sich beim Flip nie bewegen.
Beide Modelle liefen in OpenCode mit identisch festgezurrter Tool-Oberfläche: Dateien lesen, suchen und bearbeiten, kein Shell, kein Netzwerk. Beide liefen mit
highReasoning-Aufwand, je ein Versuch, keine Retries, und der Prompt wurde Byte für Byte in eine frische Session geliefert.Eine Asymmetrie zum Hinterkopf:
highliegt bei beiden zwei Stufen unter dem Maximum, aber Sols Leiter hat unten eine zusätzliche Stufenone. Damit isthighbei Sol die vierte von sechs Stufen und bei Opus 5.5 die dritte von fünf.Das war der Prompt:
Ich habe die Kosten protokolliert und beide nach drei Rubriken mit 1 bis 5 Punkten bewertet:
Was GPT-6 Sol geliefert hat
Sol brauchte 6 Züge und 9 Tool-Calls: Es listete auf, suchte und las den leeren Workspace, bevor es eine 22 KB große
index.htmlschrieb und sie einmal nachpatchte. Heraus kam ein eigener Auftritt, „Fall / Rise, a game of shifting ground“, mit einem Gravitation-Panel, das beim Flip von Bernstein auf Türkis umfärbt, einem Countdown bis zur nächsten Inversion und einer Regelkarte am Rand.Es tut, was es soll, und läuft rund und stabil: Der Bodenstapel bleibt beim Flip liegen, Steine steigen auf und verankern sich an der Decke, Reihen löschen auf beiden Stapeln, und der Soft Drop fühlt sich responsiv an – dadurch war es das spaßigere der beiden Spiele.