A prévia da próxima peça mostra a letra do tetraminó — O, I, T, S, Z — em vez de desenhar a peça. Dá para entender quando você conhece a notação, mas você perde um instante a cada olhada, e em velocidade isso pesa. Nenhum dos modelos foi solicitado a exibir prévia, então foi uma escolha voluntária do Sol — e subentregue. É o único ponto em que o build mais polido é o menos legível.
O que o Claude Opus 5.5 produziu
O Opus 5.5 precisou de 3 turnos e 2 chamadas de ferramenta, um glob e uma escrita, para entregar um index.html de 19 KB chamado "Flip Tetris". Seu comentário de cabeçalho é a especificação mais cuidadosa entre os dois: randomizador 7-bag com seed fixa, rotação com wall kicks, colapso de linhas por pilha e a observação de que uma peça em queda apenas inverte a direção quando a gravidade muda.
O jogo funciona exatamente como descrito e tão estável quanto o do Sol, com peça fantasma e uma barra de contagem regressiva que fica vermelha antes de cada inversão. A prévia da próxima peça desenha o formato real, que é a decisão certa e o único aspecto em que ele supera o Sol no olhar rápido.
Ele também adicionou um contador de nível que ninguém pediu, e eu considero isso neutro: os níveis sobem devagar o bastante para não fazer diferença até muito tarde numa partida, mais fundo do que esses builds serão jogados na prática. Onde o Opus perde é na sensação, não na lógica: o layout é mais simples que o do Sol e o soft drop é menos suave, então ele perde um ponto em qualidade visual e um em completude.
Resultados
| Métrica | GPT-6 Sol | Claude Opus 5.5 |
|---|---|---|
| Turnos | 6 | 3 |
| Chamadas de ferramenta | 9 | 2 |
| Custo | US$ 0,26 | US$ 0,87 |
| Tokens totais | 120.226 | 107.958 |
| Tokens de raciocínio | 8.123 | 22.551 |
| Executabilidade | pass | pass |
| Mecânica da inversão | 5 | 5 |
| Completude do jogo | 5 | 4 |
| Qualidade visual e sensação | 5 | 4 |
| Nota (média dos três eixos) | 5 | 4,3 |
O GPT-6 Sol vence este teste, mas por pouco — e não na parte difícil. Ambos acertaram a inversão da gravidade, então a margem ficou no capricho: a responsividade e o polimento visual do Sol deram a ele uma vantagem sobre o Opus.
O que os separa mais claramente é o custo das execuções. O Opus 5.5 gastou US$ 0,87 contra US$ 0,26 do Sol, mais que o triplo, e fez isso com menos tokens totais: 108k contra 120k. A diferença está no raciocínio: o Opus pensou cerca de três vezes mais por turno, chegou ao build correto em metade dos turnos e parou. O Sol iterou no arquivo, de forma barata, e saiu um pouco à frente na sensação.
Este é um único run de uma tarefa em um nível de esforço, e testa lógica de game loop em um arquivo, não o trabalho de repositório de longo prazo que ambos os fornecedores avaliam. Os custos são um ponto de dados por modelo, não uma média.
Quando escolher GPT-6 Sol vs Claude Opus 5.5
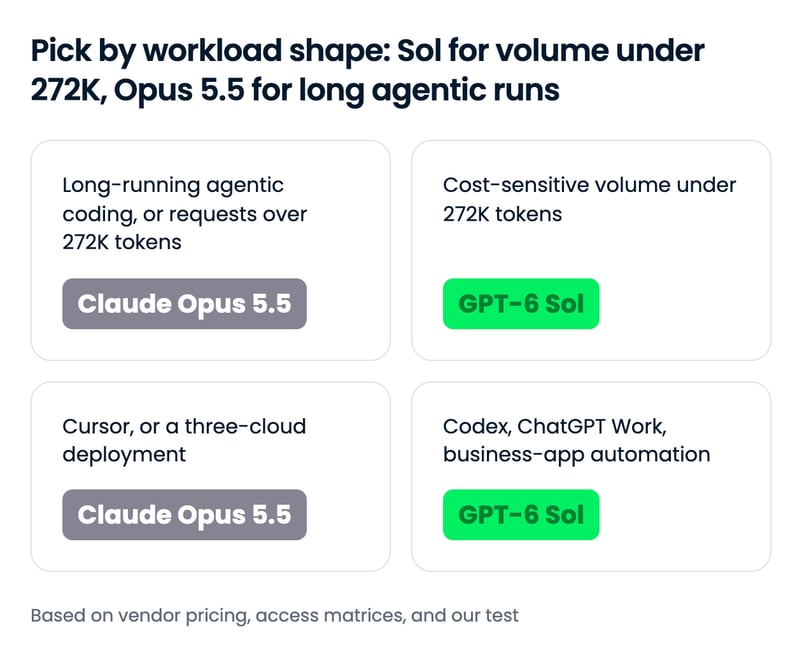
A bifurcação está no tamanho da requisição e no formato do workload, não em capacidade bruta: abaixo de 272K tokens por requisição, o desconto do Sol é real; acima disso, ou em loops com muito cache, as contas convergem — e a liderança publicada do Opus 5.5 em trabalho agentic é o que você está pagando.
Escolha o GPT-6 Sol se...
- Você roda agentes em alto volume e cada requisição fica abaixo do limite de long context. Metade do preço de tabela se compõe em milhões de requisições, e a leitura de cache custa o mesmo de qualquer forma.
- Seu time já trabalha no Codex ou no ChatGPT Work. O Sol está disponível lá em todos os planos pagos, e o Codex é o arnês para o qual a OpenAI o ajustou.
- Você automatiza workflows de negócio com orçamento limitado. A execução do Sol no AutomationBench custou US$ 0,27 por tarefa, e as alegações de custo por tarefa da OpenAI são seu argumento mais forte.
- Você quer uma escada de esforço que vá até o mínimo. O nível
nonedo Sol e as mudanças de esforço que não quebram o cache permitem ao agente fazer seguimentos baratos e escalar só nos passos difíceis.
Escolha o Claude Opus 5.5 se...
- Seu trabalho é agentic coding de longa duração: migrações, auditorias e tarefas multi-repositório. O Opus 5.5 publica pontuações mais fortes em todos os benchmarks de agentic coding que reporta, e os relatos de teste falam de jobs de horas.
- Suas requisições passam rotineiramente do limite de long context do Sol. A Anthropic cobra a janela completa de 1M na tarifa padrão, e a sobretaxa do Sol fecha quase toda a diferença nesse tamanho.
- Você precisa do modelo no Cursor ou nas três hyperscalers hoje. O Opus 5.5 está listado no Cursor e no Bedrock, Vertex AI e Microsoft Foundry; o Sol não está disponível no Cursor nem no Vertex AI.
- Você roda agentes sem supervisão e quer o modelo mais conservador. A avaliação de contenção da Anthropic e as salvaguardas classe Fable foram feitas para isso — desde que seu trabalho não seja cibersegurança.
Como começar com GPT-6 Sol e Claude Opus 5.5
| Surface | GPT-6 Sol | Claude Opus 5.5 |
|---|---|---|
| App para consumidor | ChatGPT Work e Codex nos planos Plus, Pro, Business, Enterprise e Edu; ainda não no Chat do ChatGPT | Apps Claude; limites aumentados nos planos Pro, Max, Team e Enterprise no lançamento |
| API first-party | Sim, OpenAI API (Responses API recomendada) | Sim, Claude API |
| Plataformas de nuvem | Azure AI Foundry, AWS Bedrock | AWS Bedrock, Google Cloud Vertex AI, Microsoft Foundry |
| Agentes de código | Codex, GitHub Copilot | Claude Code, Cursor, GitHub Copilot |
| Roteadores de terceiros | OpenRouter, Vercel AI Gateway | OpenRouter, Vercel AI Gateway |
| ID do modelo na API | gpt-6-sol | claude-opus-5-5 |
O Opus 5.5 lançou nas três grandes nuvens e no Cursor já no dia um, enquanto o Sol está em duas nuvens e não aparece na lista de modelos do Cursor. Nas APIs, as strings são gpt-6-sol e claude-opus-5-5.
Usando GPT-6 Sol e Claude Opus 5.5 em um agente de código
Cada modelo vem dentro do agente do seu fornecedor — Codex para o Sol e Claude Code para o Opus 5.5 — e ambos podem ser selecionados no GitHub Copilot. Se você quer um arnês único para os dois, um agente com roteador como o OpenCode acessa-os via OpenRouter como openai/gpt-6-sol e anthropic/claude-opus-5.5, que foi como rodamos nosso teste sob ferramentas idênticas.
Chamadas diretas de API usam SDKs diferentes, então a troca envolve cliente e string de modelo, não uma única linha:
from openai import OpenAI
client = OpenAI()
response = client.responses.create(
model="gpt-6-sol",
reasoning={"effort": "high"},
input="Refactor this module and explain what you changed.",
)
print(response.output_text)from anthropic import Anthropic
client = Anthropic()
response = client.messages.create(
model="claude-opus-5-5",
max_tokens=4096,
messages=[{"role": "user", "content": "Refactor this module and explain what you changed."}],
)
print(response.content[0].text)Para as configurações completas de agente, nossos tutorial do Codex CLI e tutorial do Claude Code cobrem instalação e fluxos de trabalho, e nossa comparação Codex vs Claude Code avalia os próprios arneses.
Considerações finais
Se seu workload é code agentic longo ou suas requisições passam do limite de long context, use o Claude Opus 5.5: ele publica números mais fortes em agentic coding e sua precificação não pune requisições grandes. Se você roda volume abaixo desse limite, vive no Codex ou no ChatGPT Work, ou automatiza apps de negócio com orçamento justo, use o GPT-6 Sol e guarde a diferença.
O mais interessante é que nenhum fornecedor conseguiu colocar o novo modelo do outro na sua tabela, e no único ponto em que pudemos compará-los diretamente — um build autocontido — o modelo mais barato saiu na frente em polimento.
Se você quer começar a construir com qualquer um dos modelos, recomendo nossos cursos Working with the OpenAI API e Introduction to Claude Models.
FAQs
Quando devo usar o GPT-6 Sol em vez do Claude Opus 5.5?
Use o GPT-6 Sol quando suas requisições ficam abaixo de 272K tokens de input e o volume importa: ele lista a US$ 2 por 1M tokens de input e US$ 10 por 1M tokens de output, metade dos US$ 4 e US$ 20 do Claude Opus 5.5. É também a escolha natural se seu time trabalha no Codex ou no ChatGPT Work. Escolha o Opus 5.5 para agentic coding de longa duração, para requisições acima de 272K tokens ou quando você precisa do modelo no Cursor ou nas três grandes nuvens.
Quão mais barato é o GPT-6 Sol que o Claude Opus 5.5?
Na tabela, o Claude Opus 5.5 custa exatamente o dobro do GPT-6 Sol em input (US$ 4 vs US$ 2 por 1M tokens), output (US$ 20 vs US$ 10) e gravação de cache (US$ 5 vs US$ 2,50). Leituras de cache custam US$ 0,20 por 1M tokens em ambos. O Sol cobra 2x em input e 1,5x em output em qualquer requisição acima de 272K tokens de input, enquanto a Anthropic cobra a janela completa de 1M na tarifa padrão. Com isso, a diferença cai para cerca de 8% em retrieval com long context e para cerca de 33% em loops de agente com muito cache.
Quais são os IDs de modelo na API para GPT-6 Sol e Claude Opus 5.5?
Na OpenAI API, o GPT-6 Sol é gpt-6-sol. Na Claude API, o Claude Opus 5.5 é claude-opus-5-5, e no Amazon Bedrock é anthropic.claude-opus-5-5. Pelo OpenRouter, os dois são openai/gpt-6-sol e anthropic/claude-opus-5.5.
Onde posso acessar o GPT-6 Sol e o Claude Opus 5.5?
O GPT-6 Sol está disponível no ChatGPT Work e no Codex para usuários Plus, Pro, Business, Enterprise e Edu, pela OpenAI API, no Azure AI Foundry e no AWS Bedrock, no GitHub Copilot e via OpenRouter; ele ainda não está no chat consumidor do ChatGPT. O Claude Opus 5.5 está disponível nos apps Claude, pela Claude API, no AWS Bedrock, Google Cloud Vertex AI e Microsoft Foundry, e no Claude Code, Cursor e GitHub Copilot.
Qual é melhor para programar: GPT-6 Sol ou Claude Opus 5.5?
Nos benchmarks publicados, o Claude Opus 5.5 lidera: a Anthropic reporta 66,4% no Terminal-Bench 4.0 e 54,4% no FrontierCode, enquanto a OpenAI diz que o GPT-6 Sol iguala o Claude Fable 5.1 no FrontierCode, que a Anthropic pontua em 50,3%. No nosso teste prático, um clone de Tetris em arquivo único com inversão de gravidade, ambos acertaram a lógica e o GPT-6 Sol marcou 5,0 contra 4,3 do Opus 5.5 em polimento e sensação.









A atenção ao novo modelo da Anthropic durou cerca de uma hora na corrida por modelos de fronteira mais eficientes e acessíveis.
O Claude Opus 5.5 é o primeiro modelo da família Claude 5.5, apresentado como desempenho no nível do Fable 5.1 com um custo de execução menor que o do Opus 5.
A OpenAI respondeu rápido, publicando o GPT-6 Sol como o modelo intermediário da família GPT-6, treinado com os mesmos métodos do carro-chefe GPT-6 Astra e lançado pela metade do preço de API do seu antecessor, o GPT-5.6 Sol.
Neste artigo, comparo GPT-6 Sol e Claude Opus 5.5 em várias categorias de desempenho, guardrails e preços, e incluo um teste prático de build que rodei nos dois.
Resumo
O que é o GPT-6 Sol?
O GPT-6 Sol é o modelo intermediário da OpenAI na linha GPT-6, lançado em 22 de setembro de 2026 ao lado do GPT-6 Luna e posicionado abaixo do carro-chefe GPT-6 Astra.
O diferencial é a receita de treinamento do Astra por metade do preço de API do GPT-5.6 Sol, com cache de prompt que sobrevive a mudanças, no meio da conversa, no esforço de raciocínio ou nas ferramentas.
Nosso guia do GPT-6 Sol e Luna cobre o lançamento, e nosso tutorial da API do GPT-6 Astra mostra as ferramentas assíncronas e o steering da família.
O que é o Claude Opus 5.5?
O Claude Opus 5.5 é o primeiro modelo Claude 5.5 da Anthropic, lançado em 22 de setembro de 2026 como o novo modelo líder da empresa para agentic coding de longa duração e trabalho de conhecimento.
Seu argumento é desempenho classe Fable a preço de Opus: a Anthropic diz que ele iguala o Claude Fable 5.1 na maior parte do trabalho e chega com salvaguardas de cibersegurança e biologia em nível Fable.
Nosso guia do Opus 5.5 cobre o lançamento, e nosso tutorial da API do Claude Opus 5 cobre a geração anterior.
GPT-6 Sol vs Claude Opus 5.5: comparação direta
Por causa do timing apertado, nenhum fornecedor incluiu o novo modelo do outro na sua tabela de lançamento, então os dois modelos se sobrepõem em apenas dois benchmarks — e o Opus 5.5 lidera em ambos. O caso do Sol se apoia no preço e em como ele se saiu no nosso teste.
noneamax; menos alegações enganosas sobre seu trabalho de código que o GPT-5.6 SolCode e fluxos agentic
O Opus 5.5 publica números mais fortes em agentic coding, e o post do Sol não os contesta diretamente. A Anthropic reporta Opus 5.5 no Terminal-Bench 4.0, FrontierCode e CursorBench; a OpenAI reporta Sol no DeepSWE e descreve o resultado no FrontierCode apenas como igual ao Claude Fable 5.1 em xhigh. A Anthropic coloca o Fable 5.1 em 50,3% no FrontierCode, contra 54,4% do Opus 5.5; se ambos os relatos se mantêm, o Sol fica cerca de quatro pontos atrás do Opus 5.5 no único benchmark de código citado por ambos.
Ambos os fornecedores apoiam-se mais em relatos de longo prazo do que em pontuações compartilhadas. A reescrita interna do HAProxy de C para Rust, da Anthropic, teve o Opus 5.5 concluindo em 9,5 horas contra 12 do Fable 5.1, a 51% menos custo. O argumento da OpenAI é custo por tarefa: o Sol ficou a cerca de um ponto da pontuação do Fable 5 no DeepSWE a um custo cerca de 80% menor.
Duas razões para ver essas tabelas com cautela:
No papel, o Opus 5.5 é o modelo de código mais forte; nosso único teste de build abaixo foi onde essa diferença não apareceu.
Workflows de negócios e uso de computador
O Opus 5.5 lidera nos dois benchmarks que os modelos compartilham, e a diferença no AutomationBench é o número mais limpo deste artigo: 40,0% para o Opus 5.5 contra 33,2% para o Sol no teste da Zapier com agentes operando em 47 ferramentas de negócio.
O contraponto do Sol é a conta: a OpenAI enquadra o Sol como superando o Claude Opus 5 a 9% do custo por tarefa do Opus 5 — embora essa comparação seja com o Opus anterior, não com este.
O Opus 5.5 é o agente mais forte em pontuação; o Sol é o que você consegue rodar em todos os tickets.
Trabalho de conhecimento e confiabilidade factual
O Opus 5.5 tem o único número cruzado entre fornecedores aqui: 1846 Elo no GDPval-AA v2.1, à frente das pontuações do GPT-6 Astra e do GPT-5.6 Sol na tabela da Anthropic; o próprio Sol não está listado. No teste de relatórios da Anthropic, em que qualquer número inventado reprova a execução, 16 de 18 relatórios do Opus 5.5 passaram, e nem o Fable 5.1 nem o Opus 5 passaram uma única vez.
A evidência do Sol é contra seu antecessor: no conjunto interno de factualidade da OpenAI, o Sol comete cerca de metade dos erros do GPT-5.6 Sol. O teste AA-Omniscience da Artificial Analysis concorda, com um detalhe: a taxa de alucinação do Sol caiu de 92% para 60% enquanto ele respondeu a apenas 83% das perguntas, contra 99% do antecessor.
Ambos estão mais cautelosos que seus predecessores; só o Opus 5.5 mostrou isso contra um rival.
Guardrails e restrições de API
O Sol é a API menos restrita, e o Opus 5.5 é a mais supervisionada.
O Opus 5.5 não pode rodar com o thinking desligado, rejeita uso forçado de ferramentas e vincula os blocos de thinking ao modelo e à conversa que os gerou, então contexto editado falha com erro 400 em contas criadas após 31 de agosto de 2026. A maioria das tarefas de cibersegurança é redirecionada ao Opus 4.8 fora do seu Cyber Verification Program, e trabalhos de biologia exigem o Life Sciences Verification Program.
A escada do Sol vai de
noneamax, o esforço pode mudar no meio da conversa sem quebrar o cache, e a OpenAI reporta menos alegações enganosas sobre seu trabalho de código do que no GPT-5.6 Sol.A troca é deliberada: o Opus 5.5 tentou cruzar limites de contenção cerca de 85% menos vezes do que o Opus 5, o que importa para agentes autônomos.
Preços: o que você realmente paga
O Opus 5.5 custa exatamente o dobro do Sol nas tarifas de vitrine, mas dois mecanismos que agentes realmente pagam quebram o padrão: leituras de cache custam o mesmo, e o Sol adiciona sobretaxa acima de 272K tokens que a Anthropic não cobra.
Tarifas de tokens lado a lado
O ágio é plano em input, output e gravações de cache, então afeta igualmente qualquer formato de workload até que caching ou long context entrem em cena. Leituras em cache são a exceção, e a Anthropic diz que elas compõem a maior parte do custo em trabalho agentic e de código. Nenhum fornecedor publica uma tarifa separada para tokens de raciocínio, então estime-os na tarifa de output.
Quanto custa um workload real
A linha acima do limite é o destaque: quando cada requisição passa do limite, a sobretaxa do Sol eleva a conta para ficar a 8% do Opus 5.5, então um pipeline de retrieval com long context quase não recebe desconto por escolher o Sol. O loop com cache pesado reduz a diferença para 33% por outro motivo: as 1.000 leituras em cache custam o mesmo nos dois modelos, e só os tokens novos carregam o ágio de 2x.
Os dois modelos usam tokenizers diferentes e nenhum fornecedor publicou contagens de tokens para um workload compartilhado, então trate esses totais como comparação de tarifas, não de fatura. A Anthropic diz que o Opus 5.5 usa menos tokens por tarefa que o Opus 5, mas não compara com o Sol.
Como GPT-6 Sol e Claude Opus 5.5 se saíram
Benchmarks de dois fornecedores que não testaram o modelo um do outro vão até certo ponto, então rodei uma tarefa de build nos dois com prompt e ferramentas idênticos.
O teste
Pedi a ambos para construir um clone de Tetris em arquivo único numa grade 12×24 com um detalhe: a gravidade inverte a cada 20 segundos. Duas exigências do prompt tornam isso difícil: após a inversão, as peças precisam cair em direção ao teto e travar numa segunda pilha lá, com linhas completas limpando em qualquer pilha, e células já travadas nunca podem se mover.
Ambos rodaram dentro do OpenCode com a mesma superfície de ferramentas fixada: apenas leitura, busca e edição de arquivos, sem shell e sem rede. Ambos rodaram com esforço de raciocínio
high, uma tentativa cada, sem retries, e o prompt foi entregue byte por byte a uma sessão nova.Uma assimetria a ter em mente:
highfica dois degraus abaixo do teto em ambas as escadas, mas a escada do Sol tem um degrau extranonena base, entãohighé o quarto de seis níveis nele e o terceiro de cinco no Opus 5.5.Este foi o prompt:
Registrei o custo e avaliei ambos nas três rubricas abaixo, com notas de 1 a 5:
O que o GPT-6 Sol produziu
O Sol levou 6 turnos e 9 chamadas de ferramenta: ele listou, buscou e leu o workspace vazio antes de escrever um
index.htmlde 22 KB, depois fez um patch. O resultado tem branding próprio, "Fall / Rise, a game of shifting ground", com um painel de gravidade que muda de âmbar para teal na inversão, um contador regressivo para a próxima inversão e uma cartela de regras na margem.Ele faz o que deve e funciona suave e estável: a pilha do piso fica parada na inversão, as peças sobem e travam no teto, linhas limpam em ambas as pilhas e o soft drop é responsivo — o que tornou este o mais divertido de jogar.