Förhandsvisningen av nästa bit visar tetrominots bokstav — O, I, T, S, Z — i stället för att rita biten. Du kan läsa det när du kan notationerna, men det kostar dig ett ögonblick varje gång du kastar en blick, och i hastighet spelar det roll. Ingen modell blev ombedd om någon förhandsvisning alls, så detta är ett val Sol bjöd till med och sedan underbyggde lite. Det är det enda stället där det mer polerade bygget är det mindre läsbara.
Vad Claude Opus 5.5 producerade
Opus 5.5 behövde 3 varv och 2 verktygsanrop, en glob och en skrivning, för att leverera en 19 KB index.html kallad "Flip Tetris". Dess header-kommentar är den mer noggranna specifikationen av de två: en 7-påse-slumptagare på ett fast frö, rotation med väggknuffar, radkollaps per stapel och en not om att en bit mitt i fallet helt enkelt byter riktning när gravitationen vänder.
Spelet fungerar exakt som beskrivet och lika stabilt som Sols, med en spökbit och en nedräkningsbar som blir röd före varje flip. Dess förhandsvisning av nästa bit ritar den faktiska formen, vilket är rätt val och den enda saken den gör bättre än Sol på ögonblicksnivå.
Det lade också till en nivåräknare som ingen bad om, och jag skulle kalla det oavgjort snarare än en förtjänst: nivåer stiger så långsamt att de inte gör någon skillnad förrän långt in i ett parti, längre än vad något av dessa byggen realistiskt kommer att spelas. Där Opus förlorar är känsla snarare än logik: layouten är enklare än Sols och soft drop är mindre mjuk, så den tappar en poäng på visuell kvalitet och en på kompletthet.
Resultat
| Mått | GPT-6 Sol | Claude Opus 5.5 |
|---|---|---|
| Varv | 6 | 3 |
| Verktygsanrop | 9 | 2 |
| Kostnad | $0,26 | $0,87 |
| Totalt antal tokens | 120 226 | 107 958 |
| Resonemangs-tokens | 8 123 | 22 551 |
| Körbarhet | godkänd | godkänd |
| Flip-mekanik | 5 | 5 |
| Spelkomplettering | 5 | 4 |
| Visuell kvalitet och känsla | 5 | 4 |
| Bedömningspoäng (medel av tre axlar) | 5 | 4,3 |
GPT-6 Sol vinner detta test, men knappt, och inte på den svåra delen. Båda fick gravitationsflippen rätt, så marginalen avgjordes av hantverk, och Sols responsivitet och visuella finish ger den ett övertag över Opus.
Det som skiljer dem tydligare är vad körningarna kostade. Opus 5.5 spenderade $0,87 mot Sols $0,26, mer än tre gånger så mycket, och det gjorde den på färre totala tokens: 108k mot 120k. Skillnaden är resonemang: Opus tänkte ungefär tre gånger så hårt per varv, nådde ett korrekt bygge på halva antalet varv och stannade. Sol itererade i filen i stället, billigt, och kom ut något före i känsla.
Detta är en enstaka körning av en uppgift på en insatsnivå, och den testar spellogik i en fil, inte det långhorisontella repo-arbete som båda leverantörer benchmarkar. Kostnadssiffrorna är vardera en datapunkt, inte ett snitt.
När du ska välja GPT-6 Sol vs Claude Opus 5.5
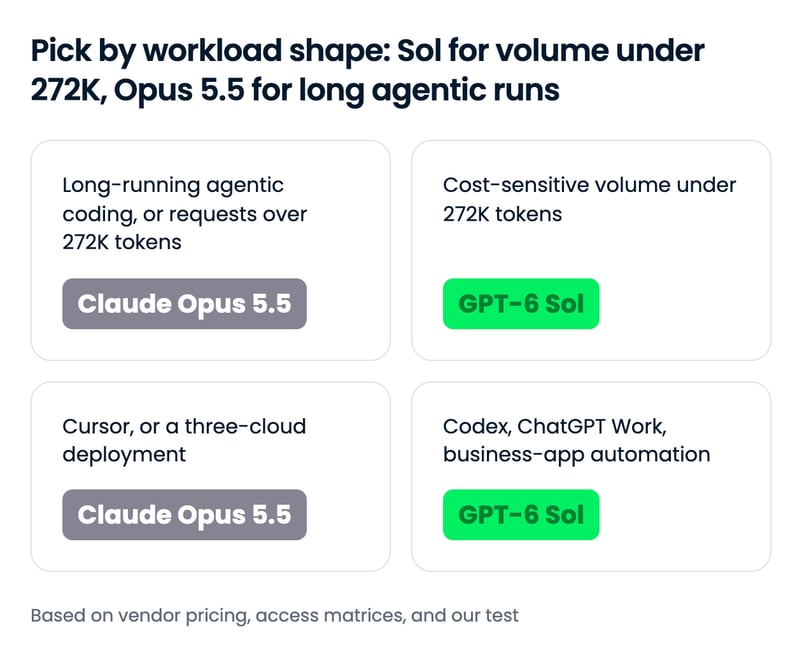
Gaffeln handlar om förfrågans storlek och arbetslastens form snarare än rå kapacitet: under 272K tokens per förfrågan är Sols rabatt verklig; över det, eller i cache-tunga loopar, konvergerar notorna, och Opus 5.5:s publicerade försprång på agentiskt arbete är vad du betalar för.
Välj GPT-6 Sol om...
- Du kör högvolymsagenter där varje förfrågan håller sig under tröskeln för lång kontext. Halva listpriset multipliceras över miljoner förfrågningar, och cache-läspriset är ändå identiskt.
- Ditt team redan arbetar i Codex eller ChatGPT Work. Sol finns där på varje betald plan, och Codex är selen OpenAI har fintrimmat den för.
- Du automatiserar affärsarbetsflöden med begränsad budget. Sols AutomationBench-körning kostade $0,27 per uppgift, och OpenAIs påståenden om kostnad per uppgift är dess starkaste argument.
- Du vill ha en insatsstege som går hela vägen ner. Sols
none-inställning och cache-säkra insatsändringar låter en agent köra billiga uppföljningar och bara eskalera de svåra stegen.
Välj Claude Opus 5.5 om...
- Ditt arbete är långvarig agentisk kodning: migreringar, granskningar och multi-repo-uppgifter. Opus 5.5 publicerar starkare resultat på varje agentisk kodningsbenchmark den rapporterar, och dess testaress anekdoter handlar om jobb som pågår i timmar.
- Dina förfrågningar överskrider rutinmässigt Sols tröskel för lång kontext. Anthropic fakturerar hela 1M-fönstret till standardpriser, och Sols tillägg stänger mesta delen av prisskillnaden i den storleken.
- Du behöver modellen i Cursor eller på alla tre hyperscaler-molnen idag. Opus 5.5 finns listad i Cursor och på Bedrock, Vertex AI och Microsoft Foundry; Sol finns inte i Cursor eller Vertex AI.
- Du kör agenter obevakade och vill ha den mer konservativa modellen. Anthropics inneslutningsutvärdering och dess skydd i Fable-klass är byggda för just det, förutsatt att ditt arbete inte är cybersäkerhet.
Så kommer du igång med GPT-6 Sol och Claude Opus 5.5
| Yta | GPT-6 Sol | Claude Opus 5.5 |
|---|---|---|
| Konsumentapp | ChatGPT Work och Codex på Plus-, Pro-, Business-, Enterprise- och Edu-planer; ännu inte i ChatGPTs Chat | Claude-appar; användningsgränser höjda på Pro-, Max-, Team- och Enterprise-planer vid lansering |
| Förstaparts-API | Ja, OpenAI API (Responses API rekommenderas) | Ja, Claude API |
| Molnplattformar | Azure AI Foundry, AWS Bedrock | AWS Bedrock, Google Cloud Vertex AI, Microsoft Foundry |
| Kodningsagenter | Codex, GitHub Copilot | Claude Code, Cursor, GitHub Copilot |
| Tredjepartsroutrar | OpenRouter, Vercel AI Gateway | OpenRouter, Vercel AI Gateway |
| API-modell-ID | gpt-6-sol | claude-opus-5-5 |
Opus 5.5 lanserades på alla tre stora moln och i Cursor dag ett, medan Sol finns på två moln och saknas i Cursors modellista. I API:erna är strängarna gpt-6-sol och claude-opus-5-5.
Använda GPT-6 Sol och Claude Opus 5.5 i en kodningsagent
Varje modell levereras i sin leverantörs egen agent, Codex för Sol och Claude Code för Opus 5.5, och båda kan väljas i GitHub Copilot. Om du vill ha en sele för båda når en router-baserad agent som OpenCode dem via OpenRouter som openai/gpt-6-sol och anthropic/claude-opus-5.5, vilket är hur vårt test körde dem under identiska verktyg.
Direkta API-anrop använder olika SDK:er, så bytet är en klient och en modellsträng snarare än en enstaka rad:
from openai import OpenAI
client = OpenAI()
response = client.responses.create(
model="gpt-6-sol",
reasoning={"effort": "high"},
input="Refactor this module and explain what you changed.",
)
print(response.output_text)from anthropic import Anthropic
client = Anthropic()
response = client.messages.create(
model="claude-opus-5-5",
max_tokens=4096,
messages=[{"role": "user", "content": "Refactor this module and explain what you changed."}],
)
print(response.content[0].text)För fullständiga agentuppsättningar täcker vår Codex CLI-handledning och vår Claude Code-handledning installation och arbetsflöden, och vår jämförelse mellan Codex och Claude Code väger själva selarna.
Avslutande tankar
Om din arbetslast är lång, agentisk kodning, eller dina förfrågningar passerar tröskeln för lång kontext, använd Claude Opus 5.5: den publicerar starkare agentiska siffror, och dess prissättning bestraffar inte stora förfrågningar. Om du kör volym under den tröskeln, lever i Codex eller ChatGPT Work, eller automatiserar affärsappar med begränsad budget, använd GPT-6 Sol och banka skillnaden.
Det jag finner mest intressant är att ingen av leverantörerna kunde ta med den andras nya modell i sin tabell, och på det enda stället där vi själva kunde jämföra dem, ett självbärande bygge, kom den billigare modellen ut före i finish.
Om du är sugen på att bygga med någon av modellerna rekommenderar jag våra kurser Working with the OpenAI API och Introduction to Claude Models.
FAQs
När ska jag använda GPT-6 Sol i stället för Claude Opus 5.5?
Använd GPT-6 Sol när dina förfrågningar håller sig under 272K indata-tokens och volymen är viktig: den listas på $2 per 1 M indata-tokens och $10 per 1 M utdata-tokens, hälften av Claude Opus 5.5:s $4 och $20. Det är också det naturliga valet om ditt team arbetar i Codex eller ChatGPT Work. Välj Opus 5.5 för långvarig agentisk kodning, för förfrågningar över 272K tokens eller när du behöver modellen i Cursor eller på alla tre stora moln.
Hur mycket billigare är GPT-6 Sol än Claude Opus 5.5?
Till listpris kostar Claude Opus 5.5 exakt dubbelt mot GPT-6 Sol för indata ($4 vs $2 per 1 M tokens), utdata ($20 vs $10) och cache-skrivningar ($5 vs $2,50). Cache-läsningar kostar $0,20 per 1 M tokens på båda. Sol tar 2x indata och 1,5x utdata på varje förfrågan över 272K indata-tokens, medan Anthropic fakturerar hela 1M-konteksten till standardpriser, så gapet krymper till cirka 8% på återhämtning med lång kontext och cirka 33% på cache-tunga agentloopar.
Vilka är API-modell-ID:na för GPT-6 Sol och Claude Opus 5.5?
På OpenAI API är GPT-6 Sol gpt-6-sol. På Claude API är Claude Opus 5.5 claude-opus-5-5, och på Amazon Bedrock är det anthropic.claude-opus-5-5. Via OpenRouter är de två openai/gpt-6-sol och anthropic/claude-opus-5.5.
Var kan jag komma åt GPT-6 Sol och Claude Opus 5.5?
GPT-6 Sol är tillgänglig i ChatGPT Work och Codex för Plus-, Pro-, Business-, Enterprise- och Edu-användare, via OpenAI API, på Azure AI Foundry och AWS Bedrock, i GitHub Copilot och via OpenRouter; den finns ännu inte i ChatGPTs konsumentchatt. Claude Opus 5.5 finns i Claude-apparna, via Claude API, på AWS Bedrock, Google Cloud Vertex AI och Microsoft Foundry, samt i Claude Code, Cursor och GitHub Copilot.
Vilken är bättre för kodning, GPT-6 Sol eller Claude Opus 5.5?
På publicerade benchmarks leder Claude Opus 5.5: Anthropic rapporterar 66,4% på Terminal-Bench 4.0 och 54,4% på FrontierCode, medan OpenAI säger att GPT-6 Sol matchar Claude Fable 5.1 på FrontierCode, som Anthropic sätter till 50,3%. I vårt eget praktiska test, en Tetris-klon i en fil med gravitationsflip, fick båda modellerna logiken rätt och GPT-6 Sol fick 5,0 mot Opus 5.5:s 4,3 på finish och känsla.
Uppmärksamheten på Anthropics nya modell varade bara i ungefär en timme i jakten på mer effektiva och prisvärda frontlinjemodeller.
Deras Claude Opus 5.5 är den första modellen i familjen Claude 5.5, lanserad som prestanda i nivå med Fable 5.1 till en lägre driftkostnad än Opus 5.
OpenAI svarade mycket snabbt och publicerade GPT-6 Sol som mellanskiktet i GPT-6-familjen, tränad med samma metoder som flaggskeppet GPT-6 Astra och lanserad till halva API-priset jämfört med föregångaren GPT-5.6 Sol.
I den här artikeln jämför jag GPT-6 Sol och Claude Opus 5.5 inom många prestandakategorier, skyddsräcken och prissättning, och jag inkluderar ett praktiskt bygga-test jag körde på båda.
TL;DR
Vad är GPT-6 Sol?
GPT-6 Sol är OpenAIs mellannivåmodell i GPT-6, släppt den 22 september 2026 tillsammans med GPT-6 Luna och positionerad under flaggskeppet GPT-6 Astra.
Försäljningsargumentet är Astras träningsrecept till halva GPT-5.6 Sols API-pris, med prompt-caching som överlever ändringar mitt i samtal avseende resonemangsinsats eller verktyg.
Vår guide till GPT-6 Sol och Luna täcker lanseringen, och vår GPT-6 Astra API-handledning går igenom familjens asynkrona verktyg och styrning.
Vad är Claude Opus 5.5?
Claude Opus 5.5 är Anthropics första Claude 5.5-modell, släppt den 22 september 2026, som företagets nya ledande modell för långvarig agentisk kodning och kunskapsarbete.
Försäljningsargumentet är resultat i Fable-klass till Opus-priser: Anthropic säger att den matchar Claude Fable 5.1 på det mesta, och den levereras med cybersäkerhets- och biologiskapsguardrails i Fable-klass.
Vår guide till Opus 5.5 täcker lanseringen, och vår Claude Opus 5 API-handledning täcker föregående generations API.
GPT-6 Sol vs Claude Opus 5.5: Direkt jämförelse
På grund av de snäva lanseringstiderna tog ingen leverantör med den andras nya modell i sin lanseringstabell, så modellerna överlappar bara på två benchmarks, och Opus 5.5 leder båda. Sols argument vilar på priset och på hur den stod sig i vårt eget test.
nonetillmax; färre vilseledande påståenden om sitt kodningsarbete än GPT-5.6 SolKodning och agentiska arbetsflöden
Opus 5.5 publicerar starkare agentiska kodningssiffror, och Sols inlägg bestrider dem inte direkt. Anthropic rapporterar Opus 5.5 på Terminal-Bench 4.0, FrontierCode och CursorBench; OpenAI rapporterar Sol på DeepSWE och beskriver dess FrontierCode-resultat endast som att matcha Claude Fable 5.1 vid xhigh-insats. Anthropic sätter Fable 5.1 på 50,3% på FrontierCode mot 54,4% för Opus 5.5, så om båda påståenden håller, ligger Sol runt fyra poäng bakom Opus 5.5 på den enda kodningsbenchmark som båda leverantörer nämner.
Båda leverantörerna lutar sig mot långhorisontella anekdoter snarare än delade siffror. Anthropics interna omskrivning av HAProxy från C till Rust lät Opus 5.5 bli klar på 9,5 timmar mot 12 för Fable 5.1 till 51% lägre kostnad. OpenAIs argument är kostnad per uppgift: Sol hamnar inom ungefär en poäng från Fable 5:s DeepSWE-resultat till cirka 80% lägre kostnad.
Två skäl att ta dessa tabeller med en nypa salt:
På pappret är Opus 5.5 den starkare kodningsmodellen; vårt enda bygga-test nedan är där det glappet inte syntes.
Affärsarbetsflöden och datoranvändning
Opus 5.5 leder båda benchmarks som modellerna delar, och AutomationBench-gapet är den renaste siffran i artikeln: 40,0% för Opus 5.5 mot 33,2% för Sol på Zapiers test av agenter som arbetar över 47 affärsverktyg.
Sols motargument är fakturan: OpenAI framställer Sol som att slå Claude Opus 5 till 9% av Opus 5:s kostnad per uppgift, även om den jämförelsen gäller föregående Opus, inte denna.
Opus 5.5 är den starkare agenten på poäng; Sol är den du har råd att köra på varje ärende.
Kunskapsarbete och faktamässig tillförlitlighet
Opus 5.5 håller den enda korsleverantörssiffran här: 1846 Elo på GDPval-AA v2.1, före GPT-6 Astra och GPT-5.6 Sol i Anthropics tabell; Sol själv listas inte. I Anthropics rapportskrivningstest, där vilken påhittad siffra som helst underkänner körningen, klarade 16 av 18 Opus 5.5-rapporter testet, och varken Fable 5.1 eller Opus 5 klarade en enda gång.
Sols bevis gäller mot sin egen föregångare: på OpenAIs interna faktasätt gör Sol ungefär hälften så många misstag som GPT-5.6 Sol. Artificial Analysis AA-Omniscience-test håller med, med en hake: Sols hallucinationsfrekvens föll från 92% till 60% medan den bara besvarade 83% av frågorna mot föregångarens 99%.
Båda är mer försiktiga än sina föregångare; endast Opus 5.5 har visat det mot en konkurrent.
Skyddsräcken och API-begränsningar
Sol är det mindre begränsade API:et, och Opus 5.5 är det mer övervakade.
Opus 5.5 kan inte köras med avstängt tänkande, avvisar framtvingad verktygsanvändning och binder thinking-block till modellen och konversationen som skapade dem, så redigerad kontext ger fel 400 på konton skapade efter 31 augusti 2026. De flesta cybersäkerhetsuppgifter omdirigeras till Opus 4.8 utanför dess Cyber Verification Program, och arbete inom biologi kräver dess Life Sciences Verification Program.
Sols stege går från
nonetillmax, insatsen kan ändras mitt i samtal utan att cachen bryts, och OpenAI rapporterar färre vilseledande påståenden om dess kodningsarbete än GPT-5.6 Sol.Avvägningen är medveten: Opus 5.5 försökte korsa inneslutningsgränser ungefär 85% mer sällan än Opus 5, vilket spelar roll för obevakade agenter.
Prissättning: vad du faktiskt betalar
Opus 5.5 kostar exakt dubbelt mot Sol på huvudpriserna, men de två mekanismer som agenter faktiskt betalar för bryter mönstret: cache-läsningar kostar samma, och Sol lägger på ett tillägg över 272K tokens som Anthropic inte gör.
Tokenpriser sida vid sida
Premien är platt över indata, utdata och cache-skrivningar, så den drabbar alla arbetsbelastningsformer lika tills caching eller lång kontext kommer in i bilden. Cacheade läsningar är undantaget, och Anthropic säger att de utgör huvuddelen av kostnaden för agentiskt arbete och kodning. Ingen av leverantörerna publicerar separat pris för resonemangstokens, så budgetera dem till utdata-priset.
Vad en verklig arbetslast kostar
Raden över tröskeln är rubriken: när varje förfrågan passerar tröskeln lyfter Sols tillägg dess nota till inom 8% av Opus 5.5, så en återhämtningspipeline med lång kontext får nästan ingen rabatt för att välja Sol. Den cache-tunga loopen krymper gapet till 33% av en annan orsak: de 1 000 cacheade läsningarna kostar samma på båda modellerna, och bara de nya tokenen bär 2x-premien.
Modellerna använder olika tokenizer, och ingen leverantör har publicerat tokenantal för en delad arbetslast, så behandla dessa totaler som en prisjämförelse snarare än en faktura. Anthropic säger att Opus 5.5 använder färre token per uppgift än Opus 5, men inte hur den står sig mot Sol.
Hur GPT-6 Sol och Claude Opus 5.5 presterade
Benchmark från två leverantörer som aldrig testade varandras modell räcker bara så långt, så jag körde ett bygguppdrag mot båda med identisk prompt och identiska verktyg.
Testet
Jag bad båda bygga en Tetris-klon i en enda fil på en 12×24-bräda med en twist: gravitationen vänder var 20:e sekund. Två saker som prompten kräver gör det svårt: efter en vändning måste bitarna falla mot taket och låsa på en andra stapel där, med fulla rader som rensas på endera stapeln, och celler som redan är låsta får aldrig flytta sig.
Båda modellerna kördes i OpenCode med identisk fast verktygsyta: bara fil-läsning, sökning och redigering, ingen shell och inget nätverk. Båda kördes på
highresonemangsinsats, ett försök var, inga omtag, och prompten levererades byte-för-byte till en ny session.En asymmetri att ha i åtanke:
highligger två steg under taket på båda stegarna, men Sols stege har ett extranone-steg längst ner, såhighär dess fjärde av sex inställningar och Opus 5.5:s tredje av fem.Detta var prompten:
Jag registrerade kostnaden och betygsatte båda enligt följande tre bedömningsmallar, med poäng från 1 till 5:
Vad GPT-6 Sol producerade
Sol tog 6 varv och 9 verktygsanrop: den listade, sökte och läste den tomma arbetsytan innan den skrev en 22 KB
index.html, och patchade den sedan en gång till. Resultatet har egen branding, "Fall / Rise, a game of shifting ground", med en gravitationspanel som byter färg från bärnsten till teal vid flippen, en nedräkning till nästa inversion och ett regelkort i marginalen.Det gör vad det ska och fungerar smidigt och stabilt: golvstapeln står kvar vid flippen, bitar stiger och låser i taket, rader rensas på båda staplarna och soft drop känns responsiv, vilket gjorde det roligare av de två att spela.