
Courses
Làm việc với OpenAI API
3 giờ
173.9K
Sự chú ý dành cho mẫu mới của Anthropic chỉ kéo dài khoảng một giờ trong cuộc đua hướng tới các mô hình biên tiên tiến hiệu quả và phải chăng hơn.
Claude Opus 5.5 của họ là mẫu đầu tiên trong dòng Claude 5.5, được định vị là hiệu năng ngang Fable 5.1 với chi phí vận hành thấp hơn Opus 5.
OpenAI phản hồi rất nhanh, công bố GPT-6 Sol như phân khúc tầm trung của dòng GPT-6, được huấn luyện bằng cùng phương pháp với mẫu đầu bảng GPT-6 Astra và ra mắt với mức giá API bằng một nửa người tiền nhiệm, GPT-5.6 Sol.
Trong bài viết này, tôi sẽ so sánh GPT-6 Sol và Claude Opus 5.5 trên nhiều hạng mục hiệu năng, rào chắn an toàn và giá, đồng thời kèm một bài kiểm thử dựng thực tế tôi đã chạy trên cả hai.
GPT-6 Sol là mẫu GPT-6 tầm trung của OpenAI, phát hành ngày 22 tháng 9 năm 2026 cùng với GPT-6 Luna và nằm dưới mẫu đầu bảng GPT-6 Astra.
Điểm bán là công thức huấn luyện của Astra với mức giá API bằng một nửa GPT-5.6 Sol, kèm bộ nhớ đệm prompt có thể giữ nguyên ngay cả khi thay đổi mức nỗ lực suy luận hoặc công cụ giữa cuộc hội thoại.
Hướng dẫn GPT-6 Sol và Luna của chúng tôi bao quát đợt ra mắt, và hướng dẫn API GPT-6 Astra trình bày chi tiết công cụ bất đồng bộ và cơ chế điều hướng của cả dòng.
Claude Opus 5.5 là mẫu Claude 5.5 đầu tiên của Anthropic, phát hành ngày 22 tháng 9 năm 2026, là mẫu dẫn đầu mới của hãng cho lập trình tác tử chạy dài và công việc tri thức.
Điểm bán là kết quả đẳng cấp Fable với giá Opus: Anthropic nói nó ngang Claude Fable 5.1 ở hầu hết công việc, và đi kèm rào chắn an ninh mạng và sinh học ở cấp Fable.
Hướng dẫn Opus 5.5 của chúng tôi bao quát đợt ra mắt, và hướng dẫn API Claude Opus 5 trình bày API thế hệ trước.
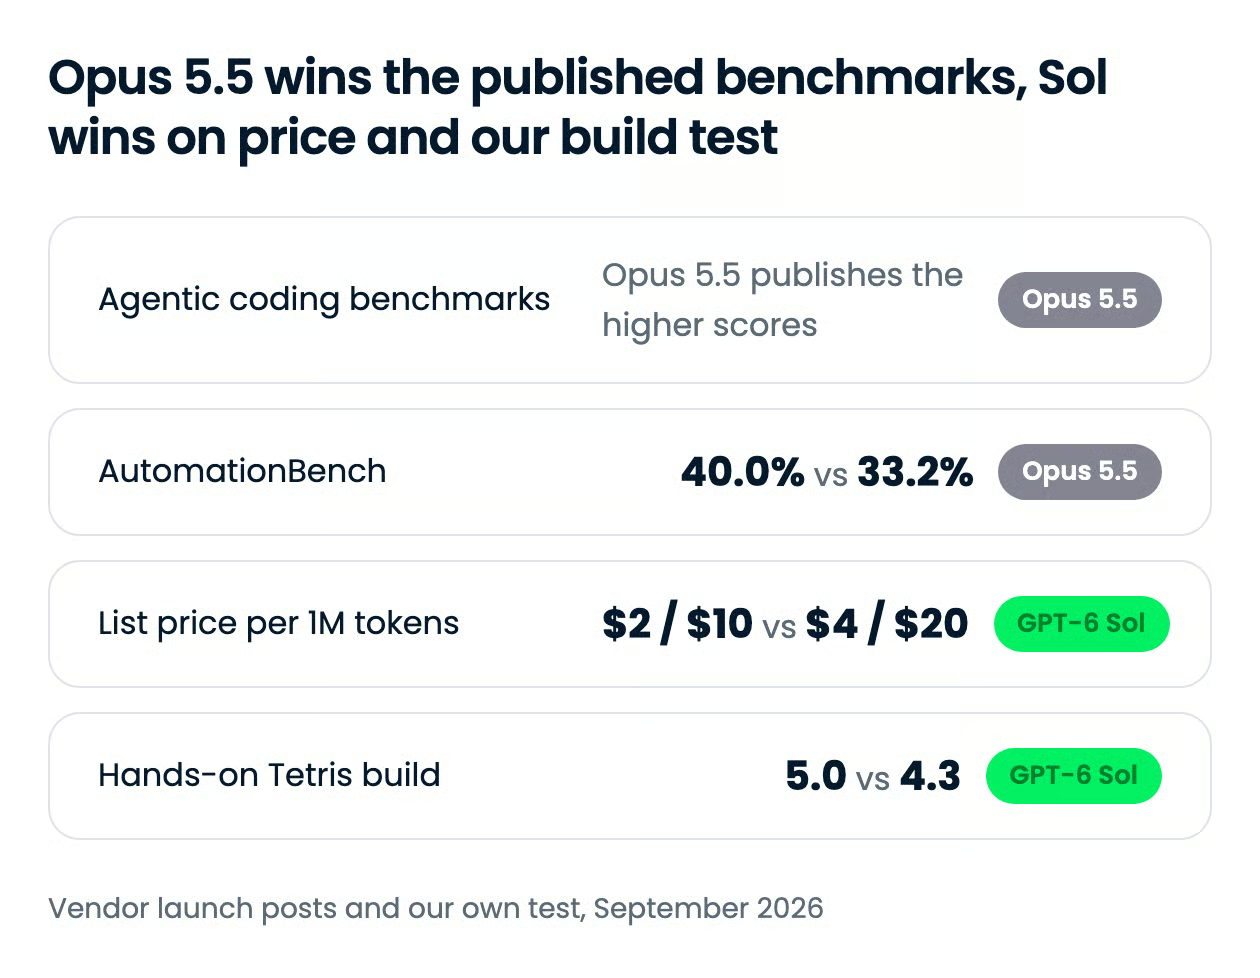
Vì thời điểm phát hành sát nhau, không bên nào đưa mẫu mới của đối thủ vào bảng công bố, nên hai mẫu chỉ trùng ở hai điểm chuẩn, và Opus 5.5 dẫn ở cả hai. Lập luận của Sol dựa vào giá và vào cách nó thể hiện trong bài kiểm thử riêng của chúng tôi.
| Tính năng | GPT-6 Sol | Claude Opus 5.5 |
|---|---|---|
| Điểm chuẩn lập trình tác tử | DeepSWE v1.1 đạt 68,8% ở mức nỗ lực tối đa; "ngang Claude Fable 5.1" trên FrontierCode, không công bố số | Terminal-Bench 4.0 đạt 66,4%, FrontierCode v1.1 đạt 54,4%, CursorBench 4.0 đạt 57,8% |
| AutomationBench (chung) | 33,2% ở mức xhigh, $0,27 mỗi tác vụ | 40,0% (chạy bởi Zapier, không mô hình dự phòng) |
| OSWorld 2.0, điểm một phần (chung) | 60,5% trên bộ offline ở mức xhigh | 81,8% |
| Công việc tri thức | Khoảng một nửa lỗi thực tế so với GPT-5.6 Sol trên đánh giá nội bộ của OpenAI | GDPval-AA v2.1 đạt 1846 Elo, vượt GPT-6 Astra và GPT-5.6 Sol |
| Cửa sổ ngữ cảnh / đầu ra tối đa | 1,05 triệu token / 128K | 1 triệu token / 128K |
| Giá niêm yết mỗi 1M token | $2 đầu vào / $10 đầu ra | $4 đầu vào / $20 đầu ra |
| Rào chắn an toàn | Nỗ lực từ none đến max; ít tuyên bố gây hiểu lầm về công việc mã hoá của mình hơn GPT-5.6 Sol |
Không thể tắt chế độ thinking; hầu hết tác vụ an ninh mạng được chuyển hướng sang Opus 4.8 |
| Bài dựng Tetris thực tế của chúng tôi (trung bình ba trục) | 5,0 | 4,3 |
Opus 5.5 công bố số liệu mã hoá tác tử mạnh hơn, và bài đăng của Sol không đối chất trực tiếp. Anthropic báo cáo Opus 5.5 trên Terminal-Bench 4.0, FrontierCode và CursorBench; OpenAI báo cáo Sol trên DeepSWE và chỉ mô tả kết quả FrontierCode là ngang Claude Fable 5.1 ở mức xhigh. Anthropic chấm Fable 5.1 ở mức 50,3% trên FrontierCode so với 54,4% của Opus 5.5, nên nếu cả hai tuyên bố đều đúng, Sol kém khoảng bốn điểm so với Opus 5.5 ở bài mã hoá mà cả hai bên đều nhắc.
| Điểm chuẩn | GPT-6 Sol | Claude Opus 5.5 | Ghi chú |
|---|---|---|---|
| Terminal-Bench 4.0 | Không công bố | 66,4% (xhigh) | Chạy bởi Anthropic; GPT-6 Astra 57,9% và GPT-5.6 Sol 37,3% theo OpenAI |
| FrontierCode v1.1 Main | Không công bố; "ngang Claude Fable 5.1 xhigh" | 54,4% | Anthropic chấm Fable 5.1 ở 50,3%; chấm theo khả năng hợp nhất mã, không chỉ đúng/sai |
| CursorBench 4.0 | Không công bố | 57,8% | Chạy bởi Anthropic; GPT-5.6 Sol 41,7% |
| DeepSWE v1.1 | 68,8% (max) | Không công bố | Chạy bởi OpenAI; điểm tốt nhất của Claude Fable 5 là 69,9% ở mức xhigh |
Cả hai nhà cung cấp đều dựa vào các giai thoại tầm nhìn dài thay vì điểm số chung. Việc viết lại HAProxy nội bộ của Anthropic từ C sang Rust cho thấy Opus 5.5 hoàn thành trong 9,5 giờ so với 12 giờ của Fable 5.1 với chi phí thấp hơn 51%. Lập luận của OpenAI là chi phí mỗi tác vụ: Sol đạt gần bằng Fable 5 trên DeepSWE với chi phí thấp hơn khoảng 80%.
Có hai lý do nên đọc các bảng này với sự dè dặt:
Trên giấy tờ, Opus 5.5 là mẫu mã hoá mạnh hơn; bài dựng đơn lẻ dưới đây là nơi khoảng cách đó không hiện rõ.
Opus 5.5 dẫn ở cả hai điểm chuẩn chung, và khoảng cách trên AutomationBench là con số rõ ràng nhất trong bài: 40,0% cho Opus 5.5 so với 33,2% cho Sol trong bài test của Zapier về tác tử làm việc trên 47 công cụ doanh nghiệp.
Phản biện của Sol là hoá đơn: OpenAI đóng khung Sol là đánh bại Claude Opus 5 với chi phí mỗi tác vụ bằng 9% của Opus 5, dù so sánh đó là với Opus thế hệ trước, không phải mẫu này.
| Điểm chuẩn | GPT-6 Sol | Claude Opus 5.5 | Ghi chú |
|---|---|---|---|
| AutomationBench | 33,2% (xhigh), $0,27 mỗi tác vụ | 40,0% | Số của Opus 5.5 từ lần chạy early-access của Zapier không có mô hình dự phòng; số của Sol từ OpenAI |
| OSWorld 2.0 (một phần) | 60,5% (bộ offline, xhigh) | 81,8% | Tập con và mức nỗ lực khác nhau; OpenAI nói Astra vẫn là mẫu dùng máy tính tốt nhất của họ |
| Agents' Last Exam | 56,4% (max) | Không công bố | OpenAI nói con số này vượt điểm tốt nhất của Claude Opus 5 với chi phí mỗi tác vụ thấp hơn 60% |
Opus 5.5 là tác tử mạnh hơn về điểm số; Sol là mẫu bạn có thể đủ sức chạy trên mọi phiếu việc.
Opus 5.5 giữ con số duy nhất qua nhà cung cấp: 1846 Elo trên GDPval-AA v2.1, vượt các điểm GPT-6 Astra và GPT-5.6 Sol trong bảng của Anthropic; bản thân Sol không được liệt kê. Trong bài kiểm thử viết báo cáo của Anthropic, nơi bất kỳ con số bịa đặt nào cũng khiến lượt đó trượt, 16/18 báo cáo của Opus 5.5 vượt, và cả Fable 5.1 lẫn Opus 5 đều không vượt lần nào.
Bằng chứng của Sol là so với người tiền nhiệm: trên bộ thực chứng nội bộ của OpenAI, Sol mắc khoảng một nửa lỗi so với GPT-5.6 Sol. Bài AA-Omniscience của Artificial Analysis đồng tình, với một lưu ý: tỷ lệ hoang tưởng giảm từ 92% xuống 60% trong khi tỷ lệ trả lời chỉ 83% so với 99% của người tiền nhiệm.
Cả hai đều cẩn trọng hơn so với thế hệ trước; chỉ Opus 5.5 đã cho thấy điều đó trước một đối thủ.
Sol là API ít bị ràng buộc hơn, còn Opus 5.5 được giám sát chặt hơn.
Opus 5.5 không thể chạy với thinking tắt, từ chối ép buộc dùng công cụ, và ràng buộc các khối thinking với mẫu và cuộc hội thoại đã tạo ra chúng, vì thế ngữ cảnh chỉnh sửa sẽ trả lỗi 400 trên các tài khoản tạo sau ngày 31/8/2026. Hầu hết tác vụ an ninh mạng được chuyển sang Opus 4.8 ngoài Chương trình Xác minh An ninh mạng, và công việc sinh học cần Chương trình Xác minh Khoa học Đời sống.
Thang của Sol chạy từ none đến max, mức nỗ lực có thể thay đổi giữa cuộc hội thoại mà không làm vỡ cache, và OpenAI báo cáo ít tuyên bố gây hiểu lầm về công việc mã hoá của nó hơn GPT-5.6 Sol.
Sự đánh đổi là có chủ đích: Opus 5.5 cố vượt rào giới hạn thấp hơn khoảng 85% so với Opus 5, điều này quan trọng cho tác tử không giám sát.
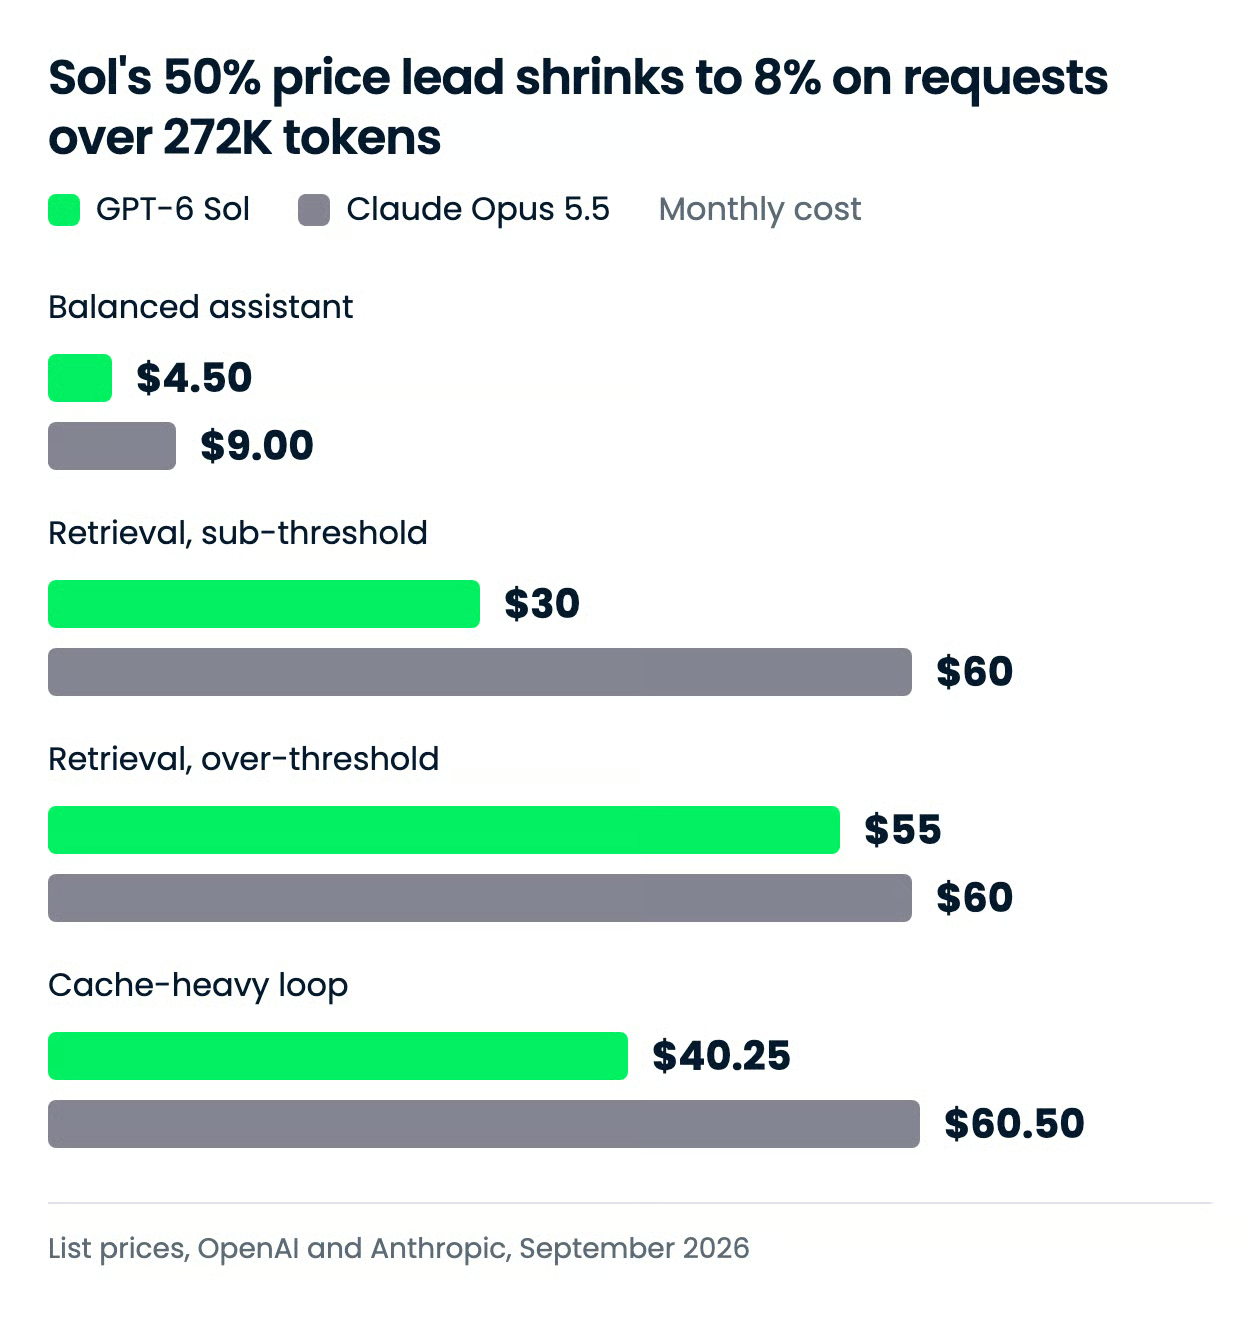
Opus 5.5 đắt gấp đúng hai lần Sol theo mức tiêu đề, nhưng hai cơ chế mà tác tử thực sự trả tiền phá vỡ khuôn mẫu: đọc cache có giá như nhau, và Sol thu phụ phí trên 272K token mà Anthropic không áp.
| Mức | GPT-6 Sol | Claude Opus 5.5 |
|---|---|---|
| Đầu vào, mỗi 1M token | $2,00 | $4,00 |
| Đầu ra, mỗi 1M token | $10,00 | $20,00 |
| Đọc đầu vào từ cache, mỗi 1M token | $0,20 | $0,20 |
| Ghi cache, mỗi 1M token | $2,50 | $5,00 (5 phút) hoặc $8,00 (1 giờ) |
| Giảm giá theo lô | 50% (Batch và Flex) | 50% |
| Giá cho ngữ cảnh dài | Trên 272K token đầu vào: gấp 2 lần giá đầu vào và cache, gấp 1,5 lần đầu ra, áp cho toàn bộ yêu cầu | Toàn bộ cửa sổ 1M theo mức chuẩn |
| Chế độ nhanh | Gấp 2 lần mức áp dụng | $8,00 đầu vào / $40,00 đầu ra, nhanh hơn đến 2,5 lần |
| Gói người dùng | ChatGPT Work và Codex trên Plus, Pro, Business, Enterprise và Edu | Ứng dụng Claude; hạn mức tăng trên Pro, Max, Team và Enterprise khi ra mắt |
Phụ phí là phẳng trên đầu vào, đầu ra và ghi cache, nên ảnh hưởng mọi dạng khối lượng công việc như nhau cho đến khi cache hoặc ngữ cảnh dài xuất hiện. Đọc cache là ngoại lệ, và Anthropic nói chúng chiếm phần lớn chi phí của công việc tác tử và mã hoá. Không bên nào công bố mức riêng cho token suy luận, nên hãy dự toán chúng theo mức đầu ra.
| Khối lượng | GPT-6 Sol | Claude Opus 5.5 | Chênh lệch |
|---|---|---|---|
| Trợ lý cân bằng: 1M vào / 250K ra | $4,50 | $9,00 | $4,50 (50%) |
| Truy xuất, dưới ngưỡng: 10M vào / 1M ra, yêu cầu dưới 272K | $30 | $60 | $30 (50%) |
| Truy xuất, trên ngưỡng: 10M vào / 1M ra, yêu cầu trên 272K | $55 | $60 | $5 (8%) |
| Vòng lặp nặng cache: tiền tố 100K ghi một lần, 1.000 lần đọc cache, 5K mới vào / 1K ra mỗi yêu cầu | $40,25 | $60,50 | $20,25 (33%) |
Hàng trên ngưỡng là điểm nhấn: một khi mọi yêu cầu vượt ngưỡng, phụ phí của Sol nâng hoá đơn lên sát Opus 5.5 trong khoảng 8%, nên pipeline truy xuất ngữ cảnh dài gần như không được giảm giá khi chọn Sol. Vòng lặp nặng cache thu hẹp khoảng cách xuống 33% vì lý do khác: 1.000 lần đọc cache có giá như nhau trên cả hai, và chỉ token mới mang phụ phí 2x.
Hai mẫu dùng bộ tách token khác nhau, và không bên nào công bố số token cho cùng một khối lượng công việc, nên hãy coi các tổng này như so sánh mức giá hơn là hoá đơn. Anthropic có nói Opus 5.5 dùng ít token mỗi tác vụ hơn Opus 5, nhưng không so với Sol ra sao.
Điểm chuẩn từ hai nhà cung cấp không thử mẫu của nhau chỉ có giới hạn, nên tôi đã chạy một tác vụ dựng trên cả hai với prompt và bộ công cụ giống hệt nhau.
Tôi yêu cầu cả hai dựng một bản Tetris một file trên bảng 12×24 với một biến tấu: trọng lực đảo chiều mỗi 20 giây. Hai điều mà prompt yêu cầu khiến bài này khó: sau khi đảo, các mảnh phải rơi lên trần và khoá vào một chồng thứ hai ở đó, với hàng đầy được xoá ở cả hai chồng, và các ô đã khoá không bao giờ được di chuyển.
Cả hai mẫu chạy trong OpenCode với bề mặt công cụ ghim giống hệt: chỉ đọc, tìm kiếm và chỉnh sửa file, không shell và không mạng. Cả hai chạy ở mức nỗ lực suy luận high, một lần thử mỗi mẫu, không lặp lại, và prompt được gửi từng byte vào một phiên mới.
Một bất đối xứng cần lưu ý: high nằm dưới trần hai bậc ở cả hai thang, nhưng thang của Sol có thêm bậc none ở đáy, nên high là mức thứ tư trong sáu mức của Sol và là mức thứ ba trong năm mức của Opus 5.5.
Đây là prompt:
Build a single-file HTML page (inline CSS and JS, canvas, no build step, no external dependencies, no network) that is a playable Tetris clone with one twist: gravity flips every 20 seconds. It needs:
- a 12×24 board, the seven tetrominoes, rotation, left/right movement, soft drop, hard drop, line clears, a score, and a game-over state, controlled with the arrow keys and the space bar;
- the twist: every 20 seconds the direction of gravity flips between down and up. Pieces then fall toward the ceiling, land on the stack that has formed there, and full rows clear on either stack. Pieces already locked in place never move when gravity flips;
- a visible gravity indicator (an arrow showing the current direction) and a countdown to the next flip, both always on screen;
- a fixed starting position: the board loads with the same flat four-row stack already locked on the floor (a few gaps, no complete rows), so the flip has a stack to leave behind;
- a fixed seed for the piece sequence, so two loads produce the same game;
- autoplay on load: with no key pressed, a simple built-in player plays at the normal starting speed of about one row per second, sliding each piece without rotating into the column where the stack it is falling toward is currently lowest (the leftmost such column on a tie) and letting it fall — never a hard drop — so pieces are seen falling the moment the page opens. Any key press hands control to the keyboard for the rest of the game;
- the whole board, indicator and countdown fit in one viewport of about 1440×900 without scrolling.

Ship it as one working file named `index.html`. Do not install packages. Do not open, screenshot, or headless-render the page (no Playwright, Puppeteer, or Chrome). Do not ask me clarifying questions — make reasonable assumptions and note them briefly in a comment at the top of the file.
Tôi ghi lại chi phí và chấm cả hai theo ba tiêu chí sau, thang điểm từ 1 đến 5:
Sol cần 6 lượt và 9 lần gọi công cụ: liệt kê, tìm kiếm và đọc không gian làm việc trống trước khi viết một index.html 22 KB, rồi vá thêm một lần nữa. Sản phẩm có thương hiệu riêng, "Fall / Rise, a game of shifting ground", với bảng trọng lực đổi màu từ hổ phách sang xanh teal khi lật, đồng hồ đếm ngược đến lần đảo tiếp theo, và thẻ luật ở lề.
Nó làm đúng như yêu cầu và hoạt động mượt mà, ổn định: chồng nền giữ nguyên khi lật, các mảnh bay lên và khoá trên trần, hàng được xoá ở cả hai chồng, và soft drop có cảm giác nhạy, khiến nó thú vị hơn khi chơi so với bản còn lại.
Nó cũng thêm bộ đếm cấp độ mà không ai yêu cầu, và tôi coi đây là hoà, không phải điểm cộng: cấp độ tăng đủ chậm để không tạo khác biệt cho đến rất muộn so với thời lượng chơi thực tế của hai bản này. Điểm Opus mất là cảm giác hơn là logic: bố cục giản dị hơn Sol và soft drop kém mượt, nên mất một điểm về chất lượng hình ảnh và một điểm về độ hoàn chỉnh.
| Thước đo | GPT-6 Sol | Claude Opus 5.5 |
|---|---|---|
| Lượt | 6 | 3 |
| Lần gọi công cụ | 9 | 2 |
| Chi phí | $0,26 | $0,87 |
| Tổng token | 120.226 | 107.958 |
| Token suy luận | 8.123 | 22.551 |
| Khả năng chạy | đạt | đạt |
| Cơ chế đảo trọng lực | 5 | 5 |
| Độ hoàn chỉnh trò chơi | 5 | 4 |
| Chất lượng hình ảnh và cảm giác | 5 | 4 |
| Điểm trung bình (trung bình ba trục) | 5 | 4,3 |
GPT-6 Sol thắng bài kiểm thử này, nhưng sát nút, và không phải ở phần khó. Cả hai đều xử lý đúng cú lật trọng lực, nên biên độ thắng đến từ mức độ hoàn thiện, và sự nhạy cùng độ trau chuốt hình ảnh của Sol giúp nó nhỉnh hơn Opus.
Điều phân tách chúng rõ hơn là chi phí chạy. Opus 5.5 tốn $0,87 so với $0,26 của Sol, hơn ba lần, và nó làm điều đó với ít tổng token hơn: 108k so với 120k. Khác biệt nằm ở suy luận: Opus suy nghĩ gấp khoảng ba lần mỗi lượt, đạt bản dựng đúng trong nửa số lượt, và dừng. Sol thì lặp trong file, rẻ, và về đích nhỉnh hơn một chút về cảm giác.
Đây là một lần chạy đơn của một tác vụ ở một mức nỗ lực, và nó kiểm tra logic vòng lặp trò chơi trong một file, không phải công việc kho lưu trữ dài hơi mà cả hai hãng dùng để làm điểm chuẩn. Các con số chi phí là một điểm dữ liệu mỗi bên, không phải trung bình.
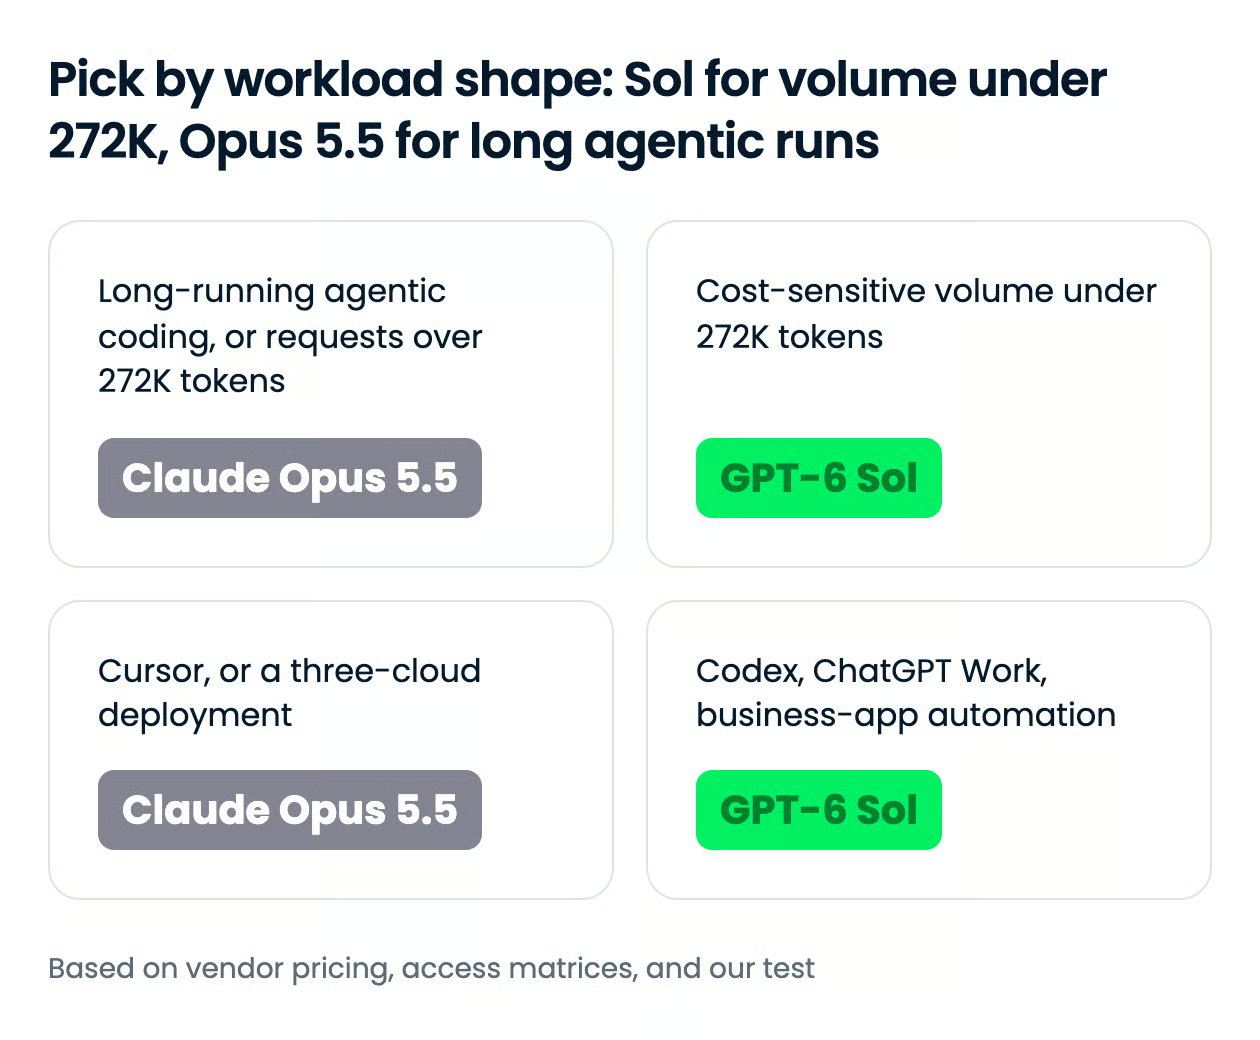
Ngã rẽ nằm ở kích thước yêu cầu và hình dạng khối lượng công việc hơn là năng lực thô: dưới 272K token mỗi yêu cầu, mức giảm của Sol là thực; trên mức đó, hoặc ở các vòng lặp nặng cache, hai hoá đơn hội tụ, và lợi thế công bố của Opus 5.5 trên công việc tác tử là điều bạn trả tiền.
none của Sol và thay đổi nỗ lực an toàn với cache cho phép tác tử chạy các bước tiếp theo giá rẻ và chỉ tăng cấp ở bước khó.| Bề mặt | GPT-6 Sol | Claude Opus 5.5 |
|---|---|---|
| Ứng dụng người dùng | ChatGPT Work và Codex trên các gói Plus, Pro, Business, Enterprise và Edu; chưa có trong Chat của ChatGPT | Ứng dụng Claude; hạn mức sử dụng tăng trên các gói Pro, Max, Team và Enterprise khi ra mắt |
| API chính hãng | Có, OpenAI API (khuyến nghị dùng Responses API) | Có, Claude API |
| Nền tảng đám mây | Azure AI Foundry, AWS Bedrock | AWS Bedrock, Google Cloud Vertex AI, Microsoft Foundry |
| Tác tử mã hoá | Codex, GitHub Copilot | Claude Code, Cursor, GitHub Copilot |
| Bộ định tuyến bên thứ ba | OpenRouter, Vercel AI Gateway | OpenRouter, Vercel AI Gateway |
| ID mẫu API | gpt-6-sol |
claude-opus-5-5 |
Opus 5.5 ra mắt trên cả ba đám mây lớn và trong Cursor ngay ngày đầu, trong khi Sol có mặt trên hai đám mây và vắng trong danh sách mẫu của Cursor. Trên API, chuỗi lần lượt là gpt-6-sol và claude-opus-5-5.
Mỗi mẫu đều xuất hiện trong tác tử riêng của nhà cung cấp, Codex cho Sol và Claude Code cho Opus 5.5, và cả hai đều có thể chọn trong GitHub Copilot. Nếu bạn muốn một khung cho cả hai, một tác tử dựa trên bộ định tuyến như OpenCode có thể truy cập chúng qua OpenRouter dưới dạng openai/gpt-6-sol và anthropic/claude-opus-5.5, đó là cách chúng tôi chạy bài kiểm thử với bộ công cụ giống hệt.
Gọi API trực tiếp dùng SDK khác nhau, nên việc hoán đổi là đổi client và chuỗi model thay vì một dòng duy nhất:
from openai import OpenAI

client = OpenAI()
response = client.responses.create(
    model="gpt-6-sol",
    reasoning={"effort": "high"},
    input="Refactor this module and explain what you changed.",
)
print(response.output_text)
from anthropic import Anthropic
client = Anthropic()
response = client.messages.create(
model="claude-opus-5-5",
max_tokens=4096,
messages=[{"role": "user", "content": "Refactor this module and explain what you changed."}],
)
print(response.content[0].text)Với thiết lập tác tử đầy đủ, hướng dẫn Codex CLI và hướng dẫn Claude Code của chúng tôi bao quát cài đặt và quy trình làm việc, và so sánh Codex vs Claude Code cân nhắc chính các khung này.
Nếu khối lượng công việc của bạn là lập trình tác tử chạy dài, hoặc các yêu cầu vượt ngưỡng ngữ cảnh dài, hãy dùng Claude Opus 5.5: nó công bố số liệu tác tử mạnh hơn, và mức giá không phạt yêu cầu lớn. Nếu bạn chạy khối lượng dưới ngưỡng đó, làm việc trong Codex hoặc ChatGPT Work, hoặc tự động hoá ứng dụng doanh nghiệp với ngân sách hạn chế, hãy dùng GPT-6 Sol và tiết kiệm phần chênh lệch.
Điều tôi thấy thú vị nhất là không nhà cung cấp nào có thể đưa mẫu mới của đối thủ vào bảng của mình, và nơi duy nhất chúng tôi có thể tự so sánh, một bài dựng tự chứa, mẫu rẻ hơn lại vượt trội về độ trau chuốt.
Nếu bạn muốn bắt tay xây dựng với bất kỳ mẫu nào, tôi khuyến nghị các khoá học Làm việc với OpenAI API và Nhập môn các mẫu Claude của chúng tôi.
Học AI cùng DataCamp!
Courses
Courses
Tracks
blogs
Matt Crabtree
10 phút
