Cours
Travailler avec l'API OpenAI
3 h
173.9K
L’attention portée au nouveau modèle d’Anthropic n’aura duré qu’une heure à peine dans la course aux modèles de pointe plus efficaces et abordables.
Leur Claude Opus 5.5 est le premier modèle de la famille Claude 5.5, présenté comme offrant des performances de niveau Fable 5.1, avec un coût d’exécution inférieur à Opus 5.
OpenAI a répliqué très vite, en publiant GPT-6 Sol comme modèle intermédiaire de la famille GPT-6, entraîné avec les mêmes méthodes que le fleuron GPT-6 Astra et lancé à la moitié du prix API de son prédécesseur, GPT-5.6 Sol.
Dans cet article, je compare GPT-6 Sol et Claude Opus 5.5 sur de nombreuses catégories de performance, les garde-fous, la tarification, et j’inclus un test pratique de build réalisé sur les deux.
GPT-6 Sol est le modèle intermédiaire de la gamme GPT-6 d’OpenAI, sorti le 22 septembre 2026 aux côtés de GPT-6 Luna et positionné sous le fleuron GPT-6 Astra.
Son atout : la recette d’entraînement d’Astra à la moitié du prix API de GPT-5.6 Sol, avec un cache d’invite qui survit aux changements d’effort de raisonnement ou d’outils en cours de conversation.
Notre guide GPT-6 Sol et Luna couvre le lancement, et notre tutoriel API GPT-6 Astra présente les outils asynchrones et le pilotage de la famille.
Claude Opus 5.5 est le premier modèle Claude 5.5 d’Anthropic, sorti le 22 septembre 2026, nouveau modèle phare de la marque pour le code agentique longue durée et le travail de connaissance.
Son atout : des résultats de classe Fable à des prix Opus. Anthropic indique qu’il égale Claude Fable 5.1 sur la plupart des tâches, et il est livré avec des garde-fous cybersécurité et biologie de niveau Fable.
Notre guide Opus 5.5 couvre le lancement, et notre tutoriel API Claude Opus 5 couvre l’API de la génération précédente.
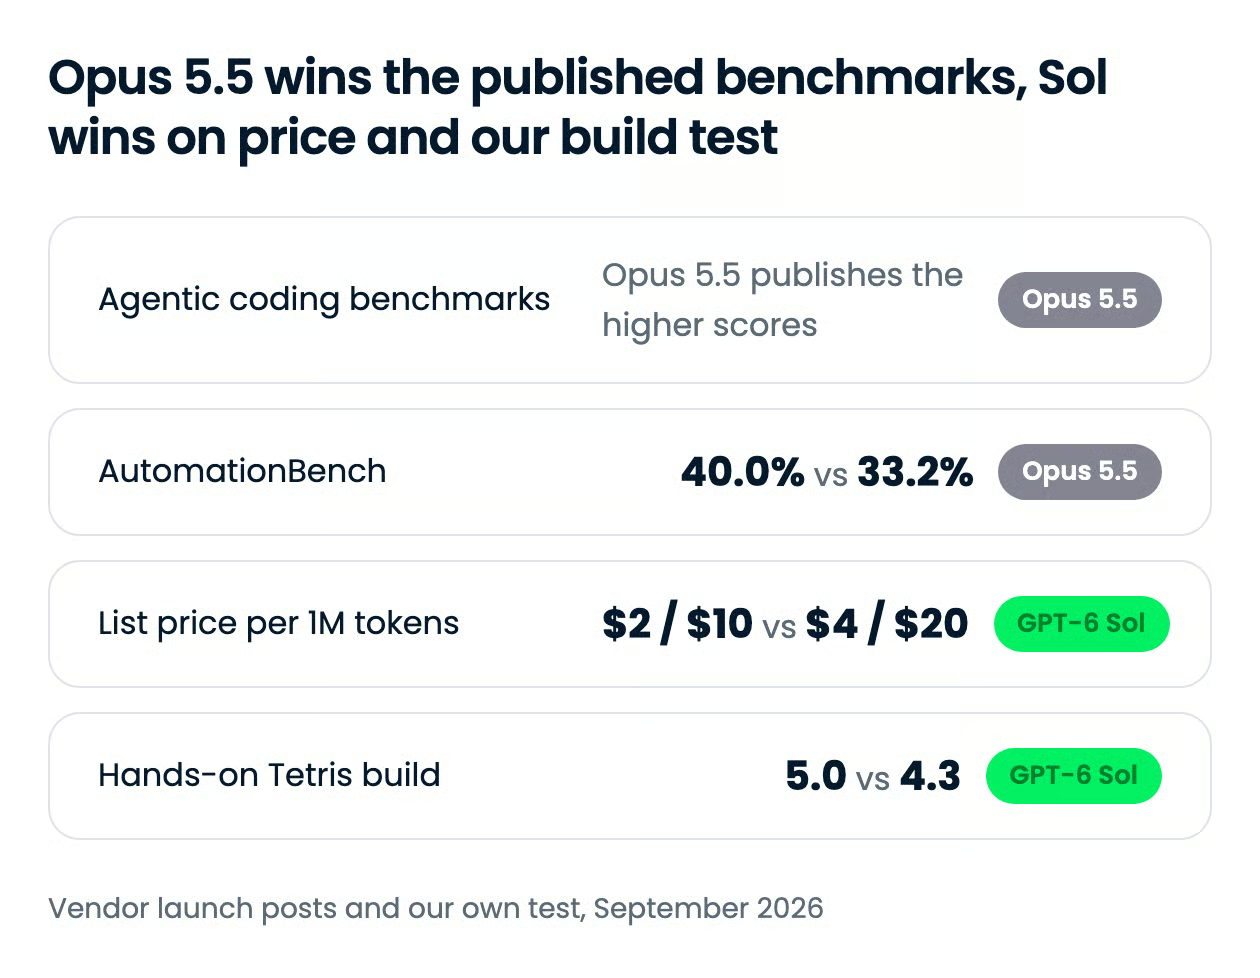
En raison du timing très rapproché des sorties, aucun éditeur n’a inclus le nouveau modèle de l’autre dans sa table de lancement. Les deux modèles ne se recoupent donc que sur deux benchmarks, et Opus 5.5 mène sur les deux. L’argument de Sol repose sur le prix et sur sa tenue dans notre propre test.
| Fonctionnalité | GPT-6 Sol | Claude Opus 5.5 |
|---|---|---|
| Benchmarks de code agentique | DeepSWE v1.1 68,8 % à effort max ; « égale Claude Fable 5.1 » sur FrontierCode, sans chiffre publié | Terminal-Bench 4.0 66,4 %, FrontierCode v1.1 54,4 %, CursorBench 4.0 57,8 % |
| AutomationBench (commun) | 33,2 % à effort xhigh, 0,27 $ par tâche | 40,0 % (run de Zapier, sans modèles de secours) |
| OSWorld 2.0, score partiel (commun) | 60,5 % sur le lot hors ligne à effort xhigh | 81,8 % |
| Travail de connaissance | Environ deux fois moins d’erreurs factuelles que GPT-5.6 Sol sur l’évaluation interne d’OpenAI | GDPval-AA v2.1 1846 Elo, devant GPT-6 Astra et GPT-5.6 Sol |
| Fenêtre de contexte / sortie max | 1,05 M de tokens / 128 K | 1 M de tokens / 128 K |
| Prix catalogue par 1 M de tokens | 2 $ entrée / 10 $ sortie | 4 $ entrée / 20 $ sortie |
| Garde-fous | Effort de none à max ; moins d’affirmations trompeuses sur son travail de code que GPT-5.6 Sol |
Le thinking ne peut pas être désactivé ; la plupart des tâches cybersécurité sont redirigées vers Opus 4.8 |
| Notre build Tetris pratique (moyenne de trois axes) | 5,0 | 4,3 |
Opus 5.5 publie des chiffres plus forts en code agentique, et le billet de Sol ne les conteste pas directement. Anthropic rapporte Opus 5.5 sur Terminal-Bench 4.0, FrontierCode et CursorBench ; OpenAI rapporte Sol sur DeepSWE et décrit son résultat FrontierCode comme égalant Claude Fable 5.1 à effort xhigh, sans chiffre. Anthropic place Fable 5.1 à 50,3 % sur FrontierCode contre 54,4 % pour Opus 5.5, donc si les deux affirmations tiennent, Sol se situe environ quatre points derrière Opus 5.5 sur le seul benchmark de code que les deux évoquent.
| Benchmark | GPT-6 Sol | Claude Opus 5.5 | Notes |
|---|---|---|---|
| Terminal-Bench 4.0 | Non publié | 66,4 % (xhigh) | Run Anthropic ; GPT-6 Astra 57,9 % et GPT-5.6 Sol 37,3 % selon OpenAI |
| FrontierCode v1.1 Main | Non publié ; « égale Claude Fable 5.1 xhigh » | 54,4 % | Anthropic évalue Fable 5.1 à 50,3 % ; noté sur la mergeability, pas seulement la justesse |
| CursorBench 4.0 | Non publié | 57,8 % | Run Anthropic ; GPT-5.6 Sol 41,7 % |
| DeepSWE v1.1 | 68,8 % (max) | Non publié | Run OpenAI ; meilleur score de Claude Fable 5 à 69,9 % en xhigh |
Les deux éditeurs s’appuient davantage sur des anecdotes de longues tâches que sur des scores communs. En interne, la réécriture d’HAProxy de C vers Rust chez Anthropic a vu Opus 5.5 terminer en 9,5 heures contre 12 pour Fable 5.1, à un coût inférieur de 51 %. L’argument d’OpenAI est le coût par tâche : Sol se situe à environ un point du score de Fable 5 sur DeepSWE pour un coût environ 80 % plus bas.
Deux raisons de prendre ces tableaux avec prudence :
Sur le papier, Opus 5.5 est le meilleur modèle de code ; notre unique test de build ci-dessous est l’endroit où cet écart ne s’est pas manifesté.
Opus 5.5 mène sur les deux benchmarks communs, et l’écart sur AutomationBench est le chiffre le plus net de cet article : 40,0 % pour Opus 5.5 contre 33,2 % pour Sol sur le test de Zapier d’agents travaillant sur 47 outils métier.
La réplique de Sol, c’est la facture : OpenAI présente Sol comme battant Claude Opus 5 à 9 % du coût par tâche d’Opus 5, bien que cette comparaison vise l’Opus précédent, pas celui-ci.
| Benchmark | GPT-6 Sol | Claude Opus 5.5 | Notes |
|---|---|---|---|
| AutomationBench | 33,2 % (xhigh), 0,27 $ par tâche | 40,0 % | Chiffre Opus 5.5 issu du run early-access de Zapier sans modèles de secours ; chiffre Sol fourni par OpenAI |
| OSWorld 2.0 (partiel) | 60,5 % (lot hors ligne, xhigh) | 81,8 % | Lots et réglages d’effort différents ; OpenAI indique qu’Astra reste son meilleur modèle d’usage ordinateur |
| Agents' Last Exam | 56,4 % (max) | Non publié | OpenAI indique que cela dépasse le meilleur score de Claude Opus 5 pour un coût par tâche 60 % inférieur |
Opus 5.5 est l’agent le plus performant en score ; Sol est celui que vous pouvez vous permettre de faire tourner sur chaque ticket.
Opus 5.5 détient le seul chiffre inter-éditeurs ici : 1846 Elo sur GDPval-AA v2.1, devant les scores de GPT-6 Astra et GPT-5.6 Sol dans le tableau d’Anthropic ; Sol lui-même n’y figure pas. Dans le test de rédaction de rapports d’Anthropic, où toute donnée inventée invalide la tentative, 16 rapports sur 18 d’Opus 5.5 ont réussi, et ni Fable 5.1 ni Opus 5 n’ont réussi une seule fois.
La preuve de Sol est interne : sur le jeu de factualité d’OpenAI, Sol commet environ deux fois moins d’erreurs que GPT-5.6 Sol. Le test AA-Omniscience d’Artificial Analysis confirme, avec une nuance : le taux d’hallucination de Sol est passé de 92 % à 60 %, mais il a répondu à 83 % des questions contre 99 % pour son prédécesseur.
Les deux sont plus prudents que leurs aînés ; seul Opus 5.5 l’a montré face à un rival.
Sol est l’API la moins contrainte, et Opus 5.5 la plus supervisée.
Opus 5.5 ne peut pas tourner avec le thinking désactivé, refuse l’usage forcé d’outils, et lie les blocs de thinking au modèle et à la conversation qui les ont produits : un contexte édité renvoie une erreur 400 pour les comptes créés après le 31 août 2026. La plupart des tâches cybersécurité sont redirigées vers Opus 4.8 hors de son Cyber Verification Program, et les travaux en biologie requièrent son Life Sciences Verification Program.
L’échelle de Sol va de none à max, l’effort peut changer en cours de conversation sans casser le cache, et OpenAI rapporte moins d’affirmations trompeuses sur son travail de code que GPT-5.6 Sol.
Le compromis est assumé : Opus 5.5 a tenté de franchir des limites de confinement environ 85 % moins souvent qu’Opus 5, ce qui compte pour des agents non supervisés.
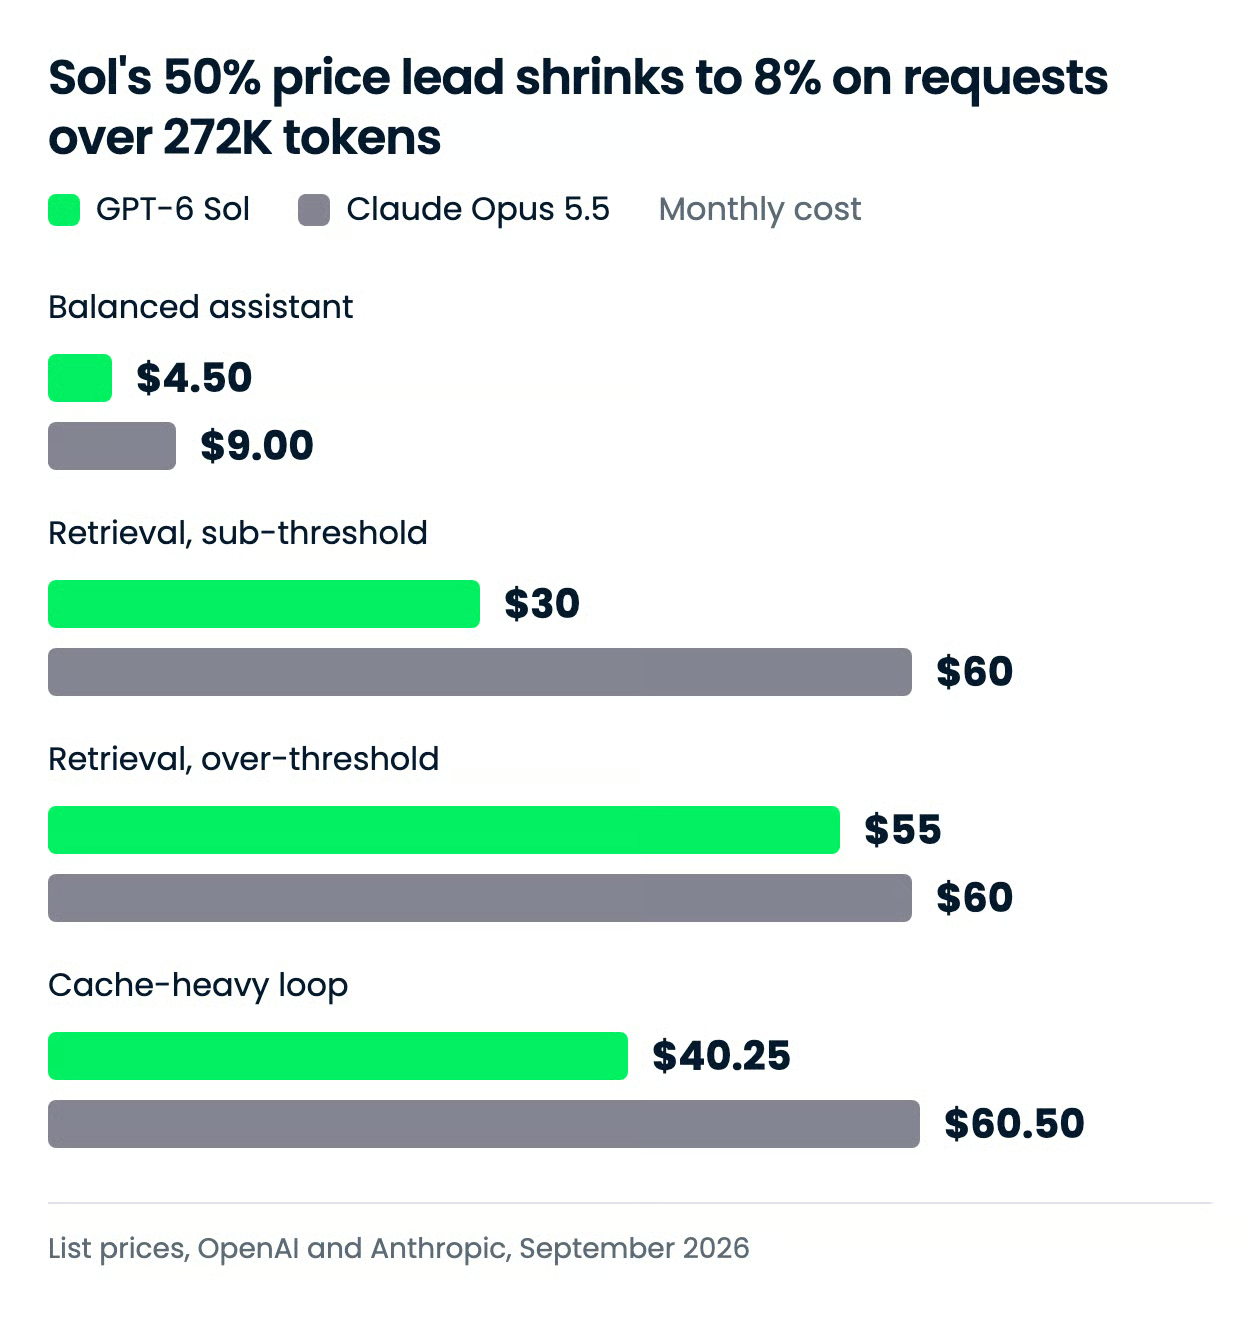
Opus 5.5 coûte exactement deux fois Sol sur les tarifs affichés, mais deux mécanismes réellement utilisés par les agents cassent ce schéma : les lectures de cache coûtent le même prix, et Sol ajoute une surtaxe au‑delà de 272 K tokens qu’Anthropic n’applique pas.
| Tarif | GPT-6 Sol | Claude Opus 5.5 |
|---|---|---|
| Entrée, par 1 M de tokens | 2,00 $ | 4,00 $ |
| Sortie, par 1 M de tokens | 10,00 $ | 20,00 $ |
| Lecture d’entrée en cache, par 1 M de tokens | 0,20 $ | 0,20 $ |
| Écriture en cache, par 1 M de tokens | 2,50 $ | 5,00 $ (5 minutes) ou 8,00 $ (1 heure) |
| Remise batch | 50 % (Batch et Flex) | 50 % |
| Tarification long contexte | Au‑delà de 272 K tokens d’entrée : 2× les tarifs d’entrée et de cache, 1,5× la sortie, sur toute la requête | Fenêtre complète de 1 M aux tarifs standards |
| Mode rapide | 2× les tarifs applicables | 8,00 $ entrée / 40,00 $ sortie, jusqu’à 2,5× plus rapide |
| Offres grand public | ChatGPT Work et Codex sur Plus, Pro, Business, Enterprise et Edu | Applications Claude ; limites relevées sur Pro, Max, Team et Enterprise au lancement |
La prime est uniforme sur l’entrée, la sortie et les écritures de cache, donc elle pèse sur toutes les charges de travail de la même manière jusqu’à ce que le cache ou le long contexte entre en jeu. Les lectures en cache font exception, et Anthropic indique qu’elles représentent l’essentiel du coût du travail agentique et de code. Aucun éditeur ne publie de tarif séparé pour les tokens de raisonnement, donc budgétez-les au tarif sortie.
| Charge | GPT-6 Sol | Claude Opus 5.5 | Différence |
|---|---|---|---|
| Assistant équilibré : 1 M entrée / 250 K sortie | 4,50 $ | 9,00 $ | 4,50 $ (50 %) |
| Retrieval, sous seuil : 10 M entrée / 1 M sortie, requêtes sous 272 K | 30 $ | 60 $ | 30 $ (50 %) |
| Retrieval, au‑delà du seuil : 10 M entrée / 1 M sortie, requêtes au‑delà de 272 K | 55 $ | 60 $ | 5 $ (8 %) |
| Boucle très cache : préfixe 100 K écrit une fois, 1 000 lectures en cache, 5 K neuf en entrée / 1 K en sortie par requête | 40,25 $ | 60,50 $ | 20,25 $ (33 %) |
La ligne « au‑delà du seuil » est le point clé : dès que chaque requête dépasse le seuil, la surtaxe de Sol fait monter sa facture à 8 % d’Opus 5.5, si bien qu’un pipeline de retrieval long contexte bénéficie de peu de remise en choisissant Sol. La boucle très cache réduit l’écart à 33 % pour une autre raison : les 1 000 lectures en cache coûtent le même prix sur les deux modèles, et seuls les tokens neufs portent la prime 2×.
Les deux modèles utilisent des tokenizeurs différents, et aucun éditeur n’a publié de comptes de tokens sur une charge commune ; considérez donc ces totaux comme une comparaison de tarifs plutôt qu’une facture. Anthropic précise qu’Opus 5.5 consomme moins de tokens par tâche qu’Opus 5, sans comparaison directe avec Sol.
Des benchmarks publiés par deux éditeurs qui n’ont pas testé le modèle de l’autre ont leurs limites, donc j’ai lancé une tâche de build sur les deux avec un prompt et des outils strictement identiques.
J’ai demandé aux deux de construire un Tetris monofichier sur une grille 12×24 avec une contrainte : la gravité s’inverse toutes les 20 secondes. Deux exigences du prompt rendent l’exercice difficile : après l’inversion, les pièces doivent tomber vers le plafond et se verrouiller sur une seconde pile en haut, avec des lignes complètes qui se nettoient sur l’une ou l’autre pile, et les cellules déjà verrouillées ne doivent jamais bouger.
Les deux modèles ont tourné dans OpenCode avec la même surface d’outils épinglée : lecture, recherche et édition de fichiers uniquement, sans shell et sans réseau. Les deux en high pour l’effort de raisonnement, une tentative chacun, sans relance, et le prompt a été transmis octet pour octet à une session vierge.
Une asymétrie à garder en tête : high se situe à deux crans du plafond sur les deux échelles, mais l’échelle de Sol a un échelon none supplémentaire en bas, donc high est son quatrième niveau sur six et le troisième sur cinq pour Opus 5.5.
Voici le prompt :
Build a single-file HTML page (inline CSS and JS, canvas, no build step, no external dependencies, no network) that is a playable Tetris clone with one twist: gravity flips every 20 seconds. It needs:
- a 12×24 board, the seven tetrominoes, rotation, left/right movement, soft drop, hard drop, line clears, a score, and a game-over state, controlled with the arrow keys and the space bar;
- the twist: every 20 seconds the direction of gravity flips between down and up. Pieces then fall toward the ceiling, land on the stack that has formed there, and full rows clear on either stack. Pieces already locked in place never move when gravity flips;
- a visible gravity indicator (an arrow showing the current direction) and a countdown to the next flip, both always on screen;
- a fixed starting position: the board loads with the same flat four-row stack already locked on the floor (a few gaps, no complete rows), so the flip has a stack to leave behind;
- a fixed seed for the piece sequence, so two loads produce the same game;
- autoplay on load: with no key pressed, a simple built-in player plays at the normal starting speed of about one row per second, sliding each piece without rotating into the column where the stack it is falling toward is currently lowest (the leftmost such column on a tie) and letting it fall — never a hard drop — so pieces are seen falling the moment the page opens. Any key press hands control to the keyboard for the rest of the game;
- the whole board, indicator and countdown fit in one viewport of about 1440×900 without scrolling.

Ship it as one working file named `index.html`. Do not install packages. Do not open, screenshot, or headless-render the page (no Playwright, Puppeteer, or Chrome). Do not ask me clarifying questions — make reasonable assumptions and note them briefly in a comment at the top of the file.
J’ai relevé le coût et noté les deux sur trois rubriques, avec des scores de 1 à 5 :
Sol a pris 6 tours et 9 appels d’outil : il a listé, cherché et lu l’espace de travail vide avant d’écrire un index.html de 22 Ko, puis l’a corrigé une fois. Le résultat a son propre branding, « Fall / Rise, a game of shifting ground », avec un panneau de gravité qui passe de l’ambre au sarcelle lors du flip, un compte à rebours jusqu’à la prochaine inversion, et une carte de règles en marge.
Ça fait ce que ça doit faire, et ça tourne de façon fluide et stable : la pile au sol ne bouge pas lors du flip, les pièces montent et se verrouillent au plafond, les lignes se nettoient sur les deux piles, et le soft drop est réactif, ce qui le rend plus agréable à jouer.
Il a aussi ajouté un compteur de niveau que personne n’avait demandé, et j’appellerais cela neutre plutôt qu’un plus : les niveaux montent si lentement qu’ils ne changent rien avant bien plus loin qu’aucun de ces builds ne sera réellement joué. Là où Opus perd, c’est sur le ressenti plus que sur la logique : la mise en page est plus sobre que celle de Sol et le soft drop est moins fluide, d’où un point en moins sur la qualité visuelle et un sur la complétude.
| Mesure | GPT-6 Sol | Claude Opus 5.5 |
|---|---|---|
| Tours | 6 | 3 |
| Appels d’outil | 9 | 2 |
| Coût | 0,26 $ | 0,87 $ |
| Tokens totaux | 120 226 | 107 958 |
| Tokens de raisonnement | 8 123 | 22 551 |
| Exécution | pass | pass |
| Mécanique de flip | 5 | 5 |
| Complétude du jeu | 5 | 4 |
| Qualité visuelle et ressenti | 5 | 4 |
| Score (moyenne des trois axes) | 5 | 4,3 |
GPT-6 Sol gagne ce test, de peu, et pas sur la partie difficile. Les deux ont bien géré l’inversion de gravité, donc l’écart s’est joué à l’exécution, et la réactivité et le soin visuel de Sol lui donnent un avantage sur Opus.
La vraie différence tient davantage au coût des runs. Opus 5.5 a dépensé 0,87 $ contre 0,26 $ pour Sol, plus de trois fois plus, et cela avec moins de tokens au total : 108 k contre 120 k. La cause, c’est le raisonnement : Opus a « réfléchi » environ trois fois plus par tour, est parvenu à un build correct en deux fois moins de tours, puis s’est arrêté. Sol a itéré dans le fichier, à moindre coût, et a fini légèrement devant sur le ressenti.
Ceci est un run unique d’une seule tâche à un seul réglage d’effort, et il sonde la logique d’une boucle de jeu dans un fichier, pas le travail sur dépôt long terme que benchmarkent les deux éditeurs. Les coûts sont des points de données isolés, pas une moyenne.
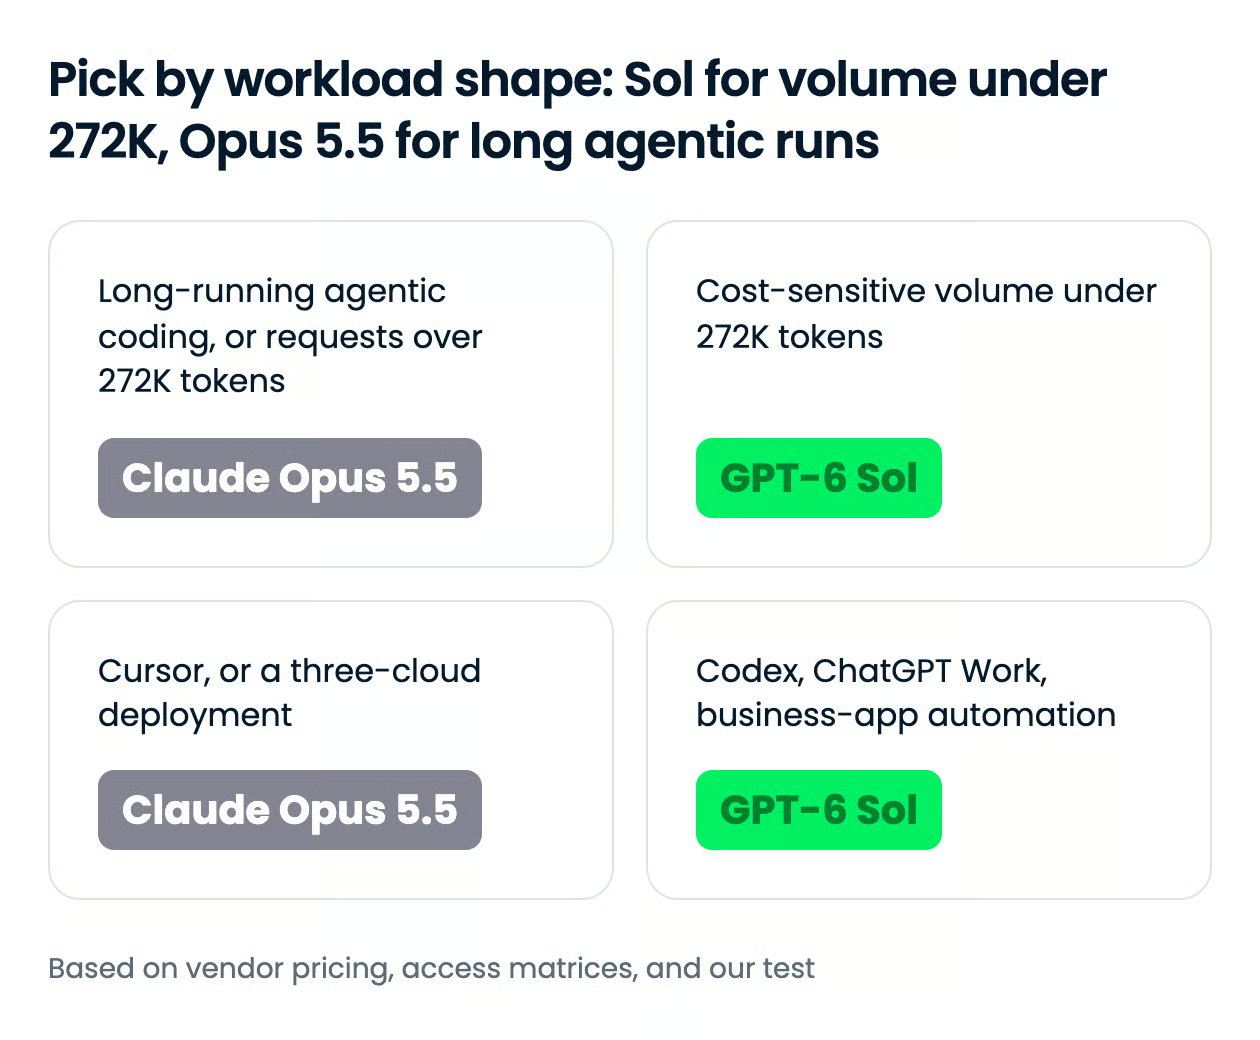
Le choix dépend davantage de la taille des requêtes et de la forme de la charge que de la « puissance brute » : sous 272 K tokens par requête, la remise de Sol est réelle ; au‑delà, ou sur des boucles très dépendantes du cache, les factures convergent, et l’avance publiée d’Opus 5.5 sur le travail agentique est ce pour quoi vous payez.
none de Sol et les changements d’effort compatibles avec le cache permettent à un agent d’enchaîner des suivis à bas coût et de n’escalader que les étapes difficiles.| Surface | GPT-6 Sol | Claude Opus 5.5 |
|---|---|---|
| Application grand public | ChatGPT Work et Codex sur les offres Plus, Pro, Business, Enterprise et Edu ; pas encore dans le Chat grand public de ChatGPT | Applications Claude ; limites relevées sur Pro, Max, Team et Enterprise au lancement |
| API propriétaire | Oui, OpenAI API (Responses API recommandée) | Oui, Claude API |
| Plateformes cloud | Azure AI Foundry, AWS Bedrock | AWS Bedrock, Google Cloud Vertex AI, Microsoft Foundry |
| Agents de code | Codex, GitHub Copilot | Claude Code, Cursor, GitHub Copilot |
| Routeurs tiers | OpenRouter, Vercel AI Gateway | OpenRouter, Vercel AI Gateway |
| ID du modèle API | gpt-6-sol |
claude-opus-5-5 |
Opus 5.5 a été lancé dès le premier jour sur les trois grands clouds et dans Cursor, tandis que Sol est sur deux clouds et absent de la liste de Cursor. Sur les API, les identifiants sont gpt-6-sol et claude-opus-5-5.
Chaque modèle est intégré à l’agent de son éditeur, Codex pour Sol et Claude Code pour Opus 5.5, et tous deux sont sélectionnables dans GitHub Copilot. Si vous voulez un harnais commun, un agent adossé à un routeur comme OpenCode les atteint via OpenRouter sous openai/gpt-6-sol et anthropic/claude-opus-5.5, ce qui nous a permis de les exécuter avec des outils identiques.
Les appels API directs utilisent des SDK différents, donc l’échange consiste à changer de client et de chaîne de modèle plutôt qu’une seule ligne :
from openai import OpenAI

client = OpenAI()
response = client.responses.create(
    model="gpt-6-sol",
    reasoning={"effort": "high"},
    input="Refactor this module and explain what you changed.",
)
print(response.output_text)
from anthropic import Anthropic
client = Anthropic()
response = client.messages.create(
model="claude-opus-5-5",
max_tokens=4096,
messages=[{"role": "user", "content": "Refactor this module and explain what you changed."}],
)
print(response.content[0].text)Pour des configurations d’agents complètes, nos tutoriel Codex CLI et tutoriel Claude Code couvrent l’installation et les workflows, et notre comparatif Codex vs Claude Code évalue les deux harnais eux‑mêmes.
Si votre charge est du code agentique long ou si vos requêtes dépassent le seuil long contexte, utilisez Claude Opus 5.5 : il publie de meilleurs chiffres agentiques, et sa tarification ne pénalise pas les grosses requêtes. Si vous traitez du volume sous ce seuil, travaillez dans Codex ou ChatGPT Work, ou automatisez des apps métier avec un budget serré, utilisez GPT-6 Sol et capitalisez l’écart.
Ce que je trouve le plus intéressant, c’est qu’aucun éditeur n’a pu intégrer le nouveau modèle de l’autre dans son tableau, et que dans l’unique endroit où nous avons pu les comparer nous‑mêmes, un build autonome, le modèle moins cher s’est imposé sur la finition.
Si vous avez envie de construire avec l’un ou l’autre, je vous recommande nos cours Working with the OpenAI API et Introduction to Claude Models.
Apprenez l’IA avec DataCamp !
Cours
Cours
Cursus
blog
Kurtis Pykes
9 min
blog
Lynn Heidmann
blog
Kurtis Pykes
15 min
Tutoriel
Tutoriel
Matt Crabtree
5 min
Tutoriel
Laiba Siddiqui
14 min