Curs
Deep Reinforcement Learning în Python
4 ore
6K
Imaginează-ți că îi ceri unui prieten să-ți întindă un măr dintr-un bol cu fructe. Se uită la bol, își dă seama care dintre ele e mărul și îl ridică suficient de delicat încât să nu-l strivească înainte să ți-l dea.
Acum hai să-i cerem același lucru unui chatbot. Îți poate spune exact cum să ridici un măr, ce degete să folosești și cam cât de tare să strângi, dar nu poate să-l și ridice. Nu are mâini și nicio idee despre cum se simte un măr.
AI-ul întrupat este domeniul care încearcă să reducă această diferență. Pe scurt, este un AI care are un corp fizic (cum ar fi un robot, o mașină sau o dronă) și învață făcând lucruri în lumea reală, nu doar citind despre ele. Vei vedea și termenul înrudit „AI fizic” folosit pentru aceeași idee.
În acest moment, domeniul are un avânt puternic. La CES, în ianuarie 2026, Jensen Huang de la NVIDIA l-a numit „momentul ChatGPT pentru robotică”.
Banii au urmat. Datele Dealroom raportate de CNBC arată că firmele de robotică au strâns 55,8 miliarde $ în 2026 până la început de iunie, aproape dublu față de precedentul record anual.
În acest articol, voi acoperi:
Nu-ți face griji dacă nu ai lucrat niciodată cu un robot. O minimă familiaritate cu machine learning ajută, dar voi construi fiecare idee de la zero, astfel încât să poți urmări oricum.
AI-ul întrupat este un sistem de inteligență artificială încorporat într-un corp fizic, cum ar fi un robot, un vehicul autonom sau o dronă, care percepe mediul prin senzori, raționează despre ce să facă și acționează în lume prin motoare, învățând din rezultatele propriilor acțiuni.
Termenul-cheie aici este întrupat.
Cele mai multe modele de AI învață observând date colectate de altcineva. Un sistem întrupat învață interacționând cu mediul său, de exemplu împingând o ceașcă, urmărind cum alunecă și actualizând ce știe despre cum se comportă ceștile când sunt împinse.
Iată un exemplu. Un model de viziune antrenat pe milioane de fotografii cu uși știe cum arată o ușă. Un robot care a încercat efectiv să deschidă 500 de uși știe că unele se împing, altele se trag, unele sunt grele și altele au mânere pe care trebuie mai întâi să le apeși în jos.
Nu poți obține această profunzime a cunoașterii dintr-o fotografie.
Îmi place să o spun așa: majoritatea AI-urilor învață despre lume citind despre ea; AI-ul întrupat învață despre lume atingând-o și experimentând-o.
Această singură diferență schimbă datele de care ai nevoie, modul de antrenare și felul în care pot apărea erorile.
Până acum, am comparat AI-ul întrupat cu un chatbot. Să-l comparăm acum cu cele două lucruri cu care este cel mai des confundat: modelele mari de limbaj (LLM-urile) și robotica tradițională bazată pe reguli.
| AI întrupat | Modele mari de limbaj (LLM-uri) | Robotică tradițională bazată pe reguli | |
|---|---|---|---|
| Învățare din mediu | Da, prin interacțiune și feedback | Mai degrabă nu, învață dintr-un corpus fix de text | Nu, comportamentul este programat manual |
| Acțiuni fizice | Da | Nu | Da |
| Antrenare pe date de pe internet | Parțial (backbone-urile sale de viziune și limbaj) | Da, trilioane de tokeni | Nu |
| Generalizare la medii noi | Moderată, și se îmbunătățește rapid | Foarte bine, în cadrul sarcinilor de limbaj | Slab, cedează când se schimbă configurația |
| Maturitate comercială în 2026 | Producție timpurie (depozite, proiecte pilot în fabrici) | Matură și larg implementată | Matură, decenii de utilizare în fabrici |
Ultimele 2 rânduri sunt cele pe care vreau să le evidențiez.
Brațele industriale bazate pe reguli sudează mașini de zeci de ani și sunt extrem de fiabile, dar doar pentru că nimic din celula lor de lucru nu se schimbă vreodată. AI-ul întrupat încearcă să păstreze acea fiabilitate permițând totodată ca lumea să fie dezordonată, ceea ce cercetătorii numesc generalizare.
LLM-urile și AI-ul întrupat învață ambele din cantități uriașe de date, dar rezolvă probleme foarte diferite. Un LLM primește text și prezice ce token ar trebui să urmeze, în timp ce un sistem întrupat primește cadre de la camere, unghiuri de articulație și citiri tactile și prezice ce mișcare ar trebui să urmeze.
Pe scurt, LLM-urile cunosc despre lumea fizică, în timp ce AI-ul întrupat acționează în ea. Revenind la măr: un LLM poate descrie exact cum să-l ridici, iar un robot cu AI întrupat chiar o poate face.
Și costul unei greșeli este foarte diferit. Dacă un LLM greșește, obții o propoziție ușor ciudată. Dacă un sistem întrupat greșește, un pahar poate ajunge pe jos sau ceva mai rău.
Iar aici este partea pe care cred că mulți o scapă din vedere: cele două lucrează împreună.
În modelele viziune–limbaj–acțiune (VLA), un model de viziune–limbaj preantrenat stă în centrul sistemului. Citește imaginile camerei și instrucțiunea ta („pune fructele în bol”), apoi își transmite înțelegerea către un decodor de acțiuni care produce comenzile reale pentru motoare.
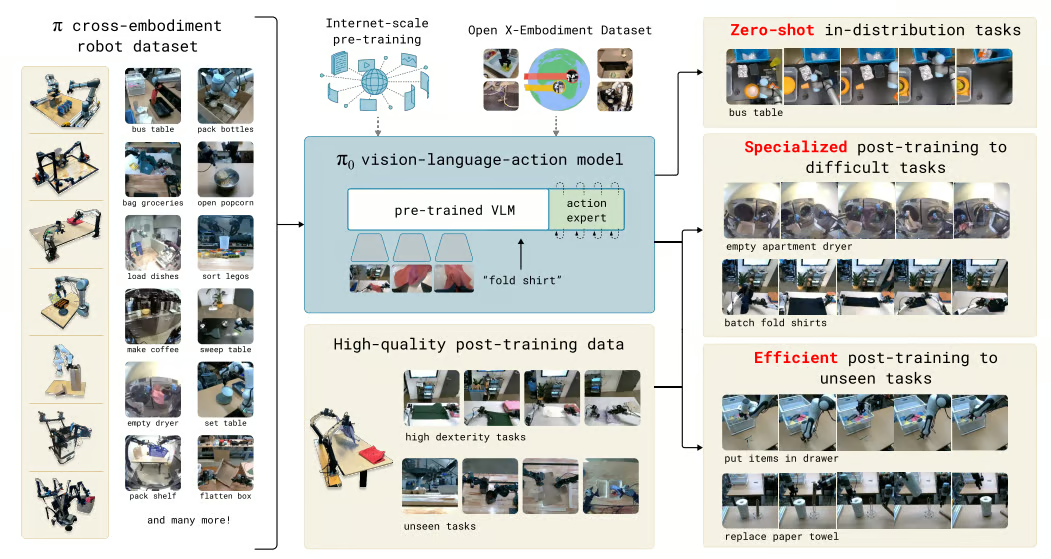
Cum se conectează un model viziune–limbaj preantrenat la acțiunile robotului în π₀ (pi-zero). Imagine din sursă: Black et al., 2024
AI-ul fizic este mai greu decât AI-ul digital în principal din cauza datelor.
Modelele de limbaj au avansat rapid datorită deceniilor în care oamenii au partajat online text, cod și imagini, dar nu există o sursă comparabilă de date de la senzori din lumea reală. Există mult mai puține fluxuri de unghiuri de articulație, măsurători de forță și cadre de la camere cu roboți care interacționează cu obiecte cotidiene.
Hai să privim mai în detaliu cerințele de date. Un sistem întrupat are nevoie de 3 tipuri de date greu de găsit:
Acum să punem și niște cifre.
LLM-urile de frontieră sunt antrenate pe trilioane de tokeni. Open X-Embodiment, unul dintre cele mai mari seturi de date open pentru robotică, a reunit date de la 22 de tipuri de roboți din 21 de instituții și a ajuns la puțin peste 1 milion de traiectorii reale.
Roboții și sarcinile agregate în setul de date Open X-Embodiment. Imagine din sursă: Open X-Embodiment Collaboration, 2023
De ce atât de puține? Fiecare traiectorie necesită un robot real care face o sarcină reală, de obicei controlat de un om prin teleoperare, ceea ce este lent și costisitor.
Acest decalaj este și motivul pentru care AI-ul fizic generalizează mai lent decât AI-ul digital. Un model gestionează cel mai bine variațiile atunci când a văzut ceva similar înainte, iar un milion de traiectorii acoperă mult mai puține bucătării, iluminări și forme de obiecte decât acoperă trilioanele de tokeni propoziții.
Ține problema datelor în minte pentru restul articolului. Multe dintre deciziile de proiectare pe care le vei vedea mai jos, de la simulare la randomizare de domeniu până la împrumutarea backbone-urilor viziune–limbaj preantrenate, sunt soluții de avarie pentru asta.
AI-ul întrupat funcționează rulând continuu o buclă din 3 etape:
Această buclă se repetă de multe ori pe secundă, iar fiecare mișcare schimbă ce percepe robotul în pasul următor, astfel încât ieșirea unui ciclu devine intrarea celui următor.
Aceași buclă stă la baza modelor de lume. Lucrarea „World Models” din 2018 a lui Ha și Schmidhuber a împărțit un agent într-un modul de viziune, un modul de memorie și un controler și l-a testat pe o mașină într-un joc de curse. AI-ul întrupat aplică aceeași idee unui robot complet.
O modalitate bună de a înțelege bucla este să îți imaginezi că prinzi o minge:
Un robot face același lucru, doar că are camere în loc de ochi și motoare în loc de mușchi.
Hai să luăm pe rând fiecare etapă.
Percepția este etapa care transformă citirile brute ale senzorilor în ceva cu care restul sistemului poate raționa. O singură cameră rareori e de ajuns, așa că majoritatea roboților combină mai mulți senzori:
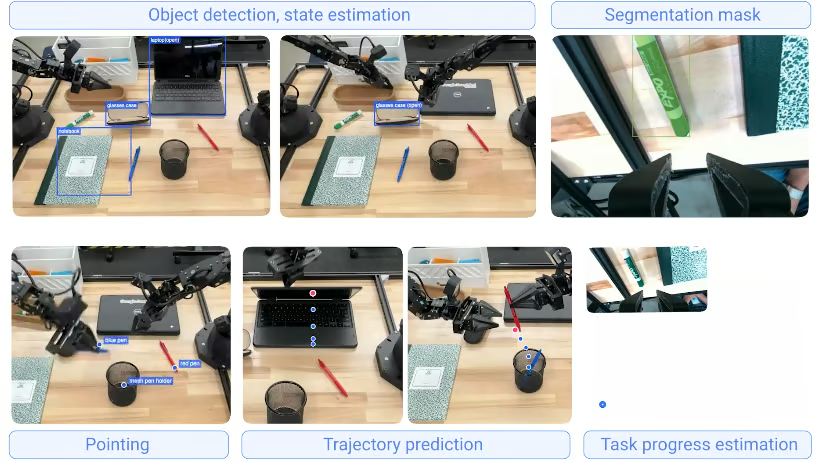
Exemple de ieșiri de percepție din Gemini Robotics-ER 1.5. Imagine din sursă: Google DeepMind
Modelele de percepție transformă apoi aceste citiri în hărți spațiale, identități de obiecte, poziții de obstacole și o înțelegere generală a scenei.
Cea mai mare parte este viziune computerizată standard, cum ar fi detecția de obiecte, segmentarea și estimarea profunzimii, de obicei construite pe transformere vizuale preantrenate precum DINOv2 sau SigLIP.
După părerea mea însă, atingerea este cea mai subestimată parte a percepției acum. O cameră îți poate spune că este un pahar pe masă, dar atingerea îți spune că paharul începe să-ți alunece din strânsoare.
Ca să îți faci o idee unde suntem, XELA Robotics a prezentat la Automate 2026 un vârf de deget robotic cu 30 de puncte de măsurare a forței pe trei axe, înghesuite în pernă. Compania spune, de asemenea, că senzorii săi uSkin pot detecta forțe de până la 0,1 gram-forță.
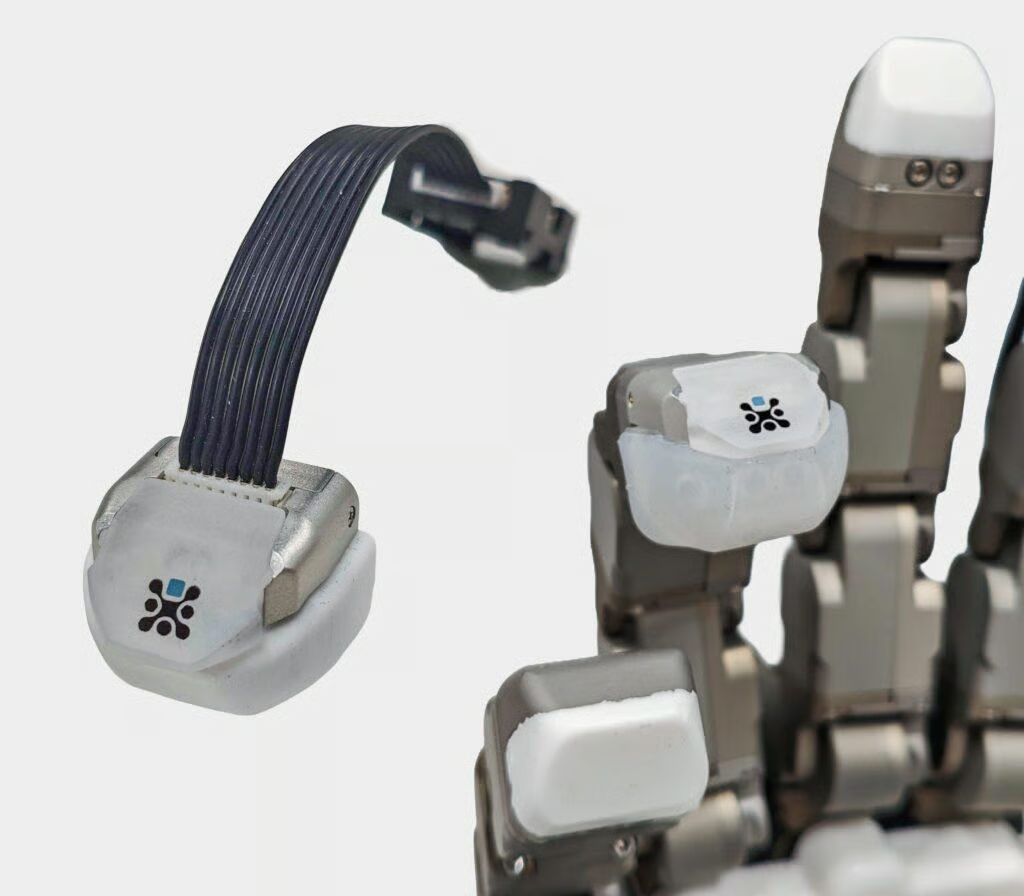
Un vârf de deget robotic uSkin ce conține o matrice de puncte tactile pe trei axe. Imagine din sursă: XELA Robotics
Raționamentul este etapa care decide ce să facă în continuare. În sistemele mai noi, are de obicei 2 straturi:
Modelele de lume sunt cele care îi permit robotului să-și imagineze înainte să acționeze.
DreamerV3 este un exemplu bun. Învață un model compact al mediului și apoi își antrenează politica aproape în întregime în acea lume imaginară.
Folosesc DreamerV3 în cercetarea mea, iar ceea ce m-a surprins cel mai mult e cât de mult timp petrece agentul exersând în „capul” său față de mediul real. Asta contează, pentru că antrenarea devine mai rapidă și mult mai ieftină.
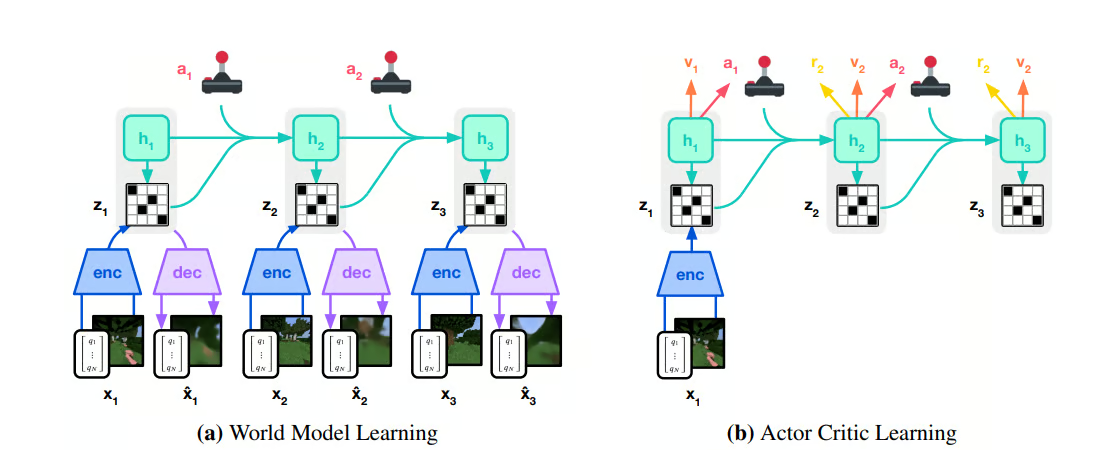
DreamerV3 își antrenează politica pe derulări imaginate din modelul său de lume. Imagine din sursă: Hafner et al., 2023
Planificarea, pe de altă parte, este gestionată din ce în ce mai mult de modelele de limbaj.
Un exemplu bun este Gemini Robotics-ER 1.5 de la Google DeepMind, care acționează ca planificator de nivel înalt. Dată o sarcină precum sortarea deșeurilor în funcție de regulile locale de reciclare, poate căuta regulile cu Google Search, sparge treaba în pași și predă fiecare pas modelului VLA Gemini Robotics 1.5, care execută partea fizică.
Te poți gândi la modelul de limbaj ca la manager, iar la modelul VLA ca la muncitorul care face efectiv treaba.
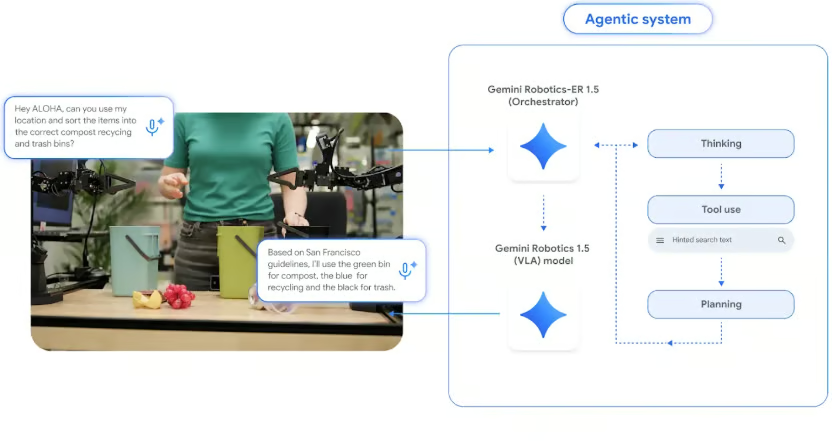
Gemini Robotics-ER 1.5 planifică sarcina și deleagă execuția fizică modelului VLA Gemini Robotics 1.5. Imagine din sursă: Google DeepMind, 2025
Acțiunea este etapa care convertește o decizie în comenzi precise pentru fiecare articulație și motor, de obicei de zeci până la sute de ori pe secundă (măsurat în hertzi sau Hz). Partea de nivel jos a acestei etape se numește control.
De exemplu, o comandă precum „Mută griperul cu 5 cm spre stânga” sună simplu, dar pe un braț cu 7 articulații trebuie transformată într-un cuplu specific pentru fiecare motor, recalculat continuu pe măsură ce brațul se mișcă.
Partea grea este că realitatea rareori corespunde cu ce aștepta robotul. Obiectele alunecă, podelele sunt ușor denivelate, iluminarea se schimbă când cineva ridică jaluzeaua, iar un cablu se îndoaie altfel decât a fost prezis.
Un controler bun observă diferența dintre ce aștepta și ce s-a întâmplat și corectează imediat.
Eu cred că acțiunea este etapa cea mai grea de făcut bine în medii haotice, nestructurate. O greșeală de percepție poate fi corectată uitându-te din nou, iar una de planificare prin replanificare, dar o greșeală de control se întâmplă în timp real.
AI-ul întrupat este antrenat pe un amestec de simulare și date din lumea reală. Simularea înseamnă medii virtuale pline cu obiecte 3D cu fizică realistă, unde un robot poate exersa de milioane de ori înainte să atingă vreodată hardware-ul real.
Îți amintești problema datelor de mai devreme? Simularea este unul dintre principalele remedii, în special pentru învățarea prin întărire a locomoției și manipulării. Modelele fundaționale precum π₀ se bazează încă puternic pe demonstrații reale, așa că majoritatea echipelor folosesc ambele.
Colectarea de date în lumea reală are 3 probleme mari:
Un simulator rezolvă toate cele 3 deodată. Poți rula mii de roboți virtuali în paralel pe un singur GPU și îi poți lăsa să eșueze și să reia cât e nevoie. Asta condensează ani de experiență a robotului în câteva ore.
Nu orice simulator este la fel de util pentru antrenarea roboților. Din propria mea experiență cu brațe robotice în simulare, aș spune că unul bun are nevoie de 3 lucruri:
Platformele cu care te vei întâlni cel mai des sunt NVIDIA Isaac Sim (cu Isaac Lab) și MuJoCo:
| Platformă | Dezvoltator | La ce e bună | Cel mai potrivit pentru |
|---|---|---|---|
| NVIDIA Isaac Sim și Isaac Lab | NVIDIA | Randare fotorealistă, simulare de senzori, mii de medii paralele pe GPU | Rulări mari de RL și date sintetice pentru camere |
| MuJoCo | Google DeepMind (open source) | Fizică de contact rapidă și precisă, ușor, comunitate mare de cercetare | Cercetare, benchmark-uri de locomoție și manipulare |
Cea mai nouă adiție este Newton, un motor de fizică open-source, accelerat pe GPU, construit de NVIDIA, Google DeepMind și Disney Research și administrat prin Linux Foundation.
Newton 1.0 a fost lansat la NVIDIA GTC în martie 2026. Se conectează la Isaac Lab ca backend de fizică, cu MuJoCo Warp ca unul dintre solvere și solvere suplimentare pentru obiecte deformabile precum cabluri și textile.
Deformabilele contează mai mult decât par. Simulatoarele mai vechi gestionau prost cablurile și țesăturile, iar fabricile au nevoie de roboți care să se descurce cu ambele.
Decalajul sim-to-real este scăderea performanței care apare când o politică antrenată în simulare este transferată pe un robot real și este una dintre cele mai mari probleme în sistemele întrupate.
De exemplu, frecarea simulată nu este niciodată chiar corectă, camerele simulate sunt prea curate, iar obiectele simulate pot fi prea perfecte, astfel încât o politică ce reușește în 95% din cazuri în simulare se poate „rupe” în clipa în care întâlnește hardware-ul real.
Există 2 moduri principale prin care echipele reduc acest decalaj:
În loc să încerce să facă simulatorul perfect, echipele îl randomizează în multe feluri.
Tobin et al. (2017) au randomizat atât de puternic texturile și iluminarea încât lumea reală arăta pentru model ca încă o variație. Mâna de robot Rubik a OpenAI pentru cubul Rubik a mers mai departe, lărgind automat randomizarea pe măsură ce politica se îmbunătățea.
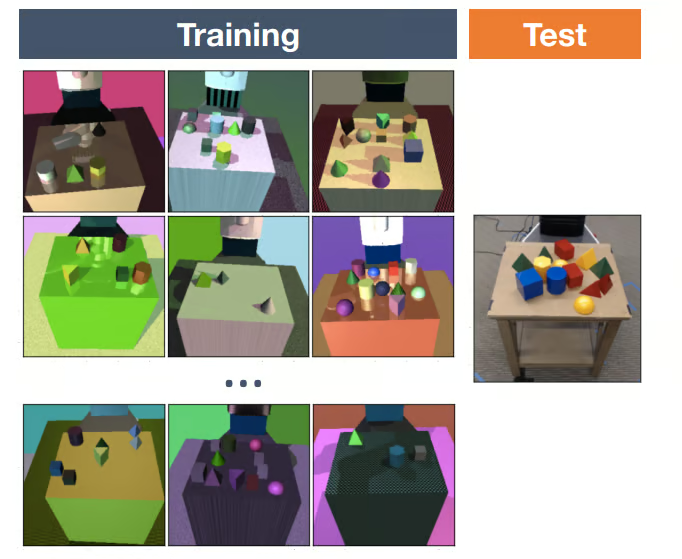
O politică preantrenată în simulare are adesea nevoie doar de un set mic de demonstrații reale pentru a se adapta, pentru că a învățat deja forma generală a sarcinii.
Niciuna dintre tehnici nu elimină complet decalajul, așa că echipele continuă să lucreze pentru a-i reduce impactul asupra performanței în lumea reală.
AI-ul întrupat rulează acum în afara laboratorului în mai multe industrii, deși foarte inegal.
Modelul pe care îl văd este că ajunge mai întâi acolo unde mediul se schimbă prea mult pentru a fi scriptat manual, dar unde un om poate interveni dacă ceva merge prost.
Mașinile autonome sunt unul dintre cele mai flămânde tipuri de AI întrupat în privința datelor.
Waymo Driver a parcurs aproape 200 de milioane de mile complet autonome și se antrenează și testează și pe miliarde de mile în simulare, conform postării Waymo din februarie 2026 despre World Model. Simularea permite Waymo să redea incidente reale și să genereze scenarii rare (de exemplu, un copil care sare dintre mașini parcate) pe care o flotă de test le-ar putea să nu întâlnească niciodată pe drumurile reale.
Mașinile autonome sunt și un exemplu bun al buclei percepție–raționament–acțiune rulând la viteză maximă. Un vehicul Waymo percepe cu camere, lidar și radar, raționează despre ce e probabil să facă fiecare pieton și vehicul în continuare și acționează controlând direcția și frânele de multe ori pe secundă.
În opinia mea, depozitele sunt cea mai firească utilizare comercială a AI-ului întrupat acum.
Tranziția este de la roboți cu traseu fix, care urmează linii pe podea, la sisteme care pot gestiona stocuri dinamice și dezordonate, cum ar fi preluarea dintr-un container cu 40 de produse diferite aruncate laolaltă.
Humanoidul Digit de la Agility Robotics a mutat containere la GXO Logistics în baza unui acord pe mai mulți ani semnat în 2024, iar Stretch de la Boston Dynamics descarcă cutii din camioane.
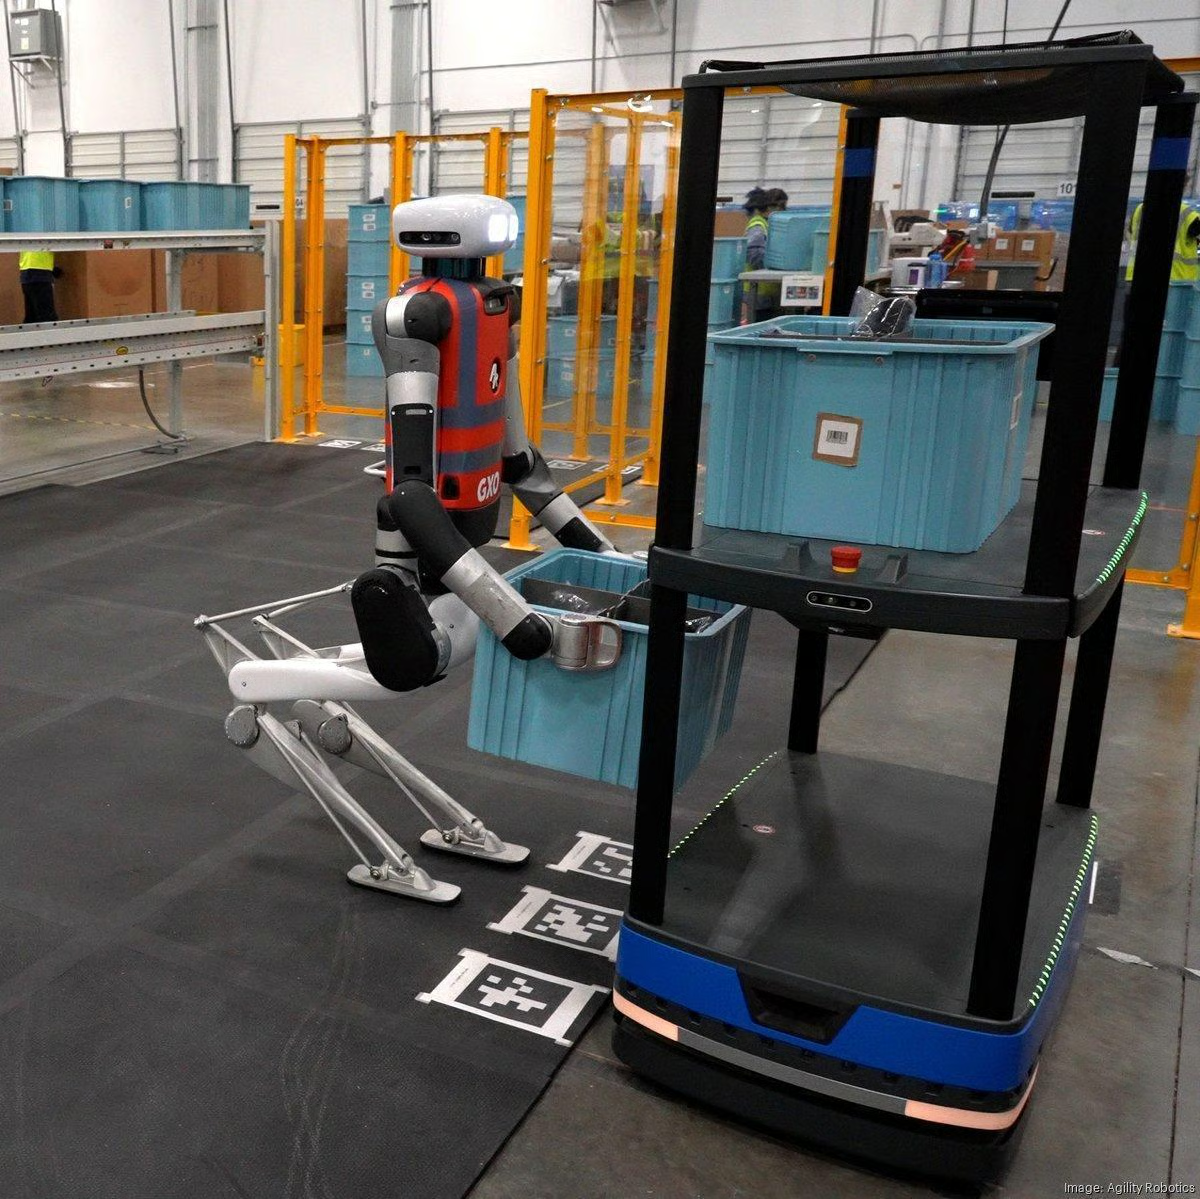
Digit de la Agility Robotics mutând containere între roboți mobili autonomi și un conveior într-un depozit GXO. Imagine din sursă: Agility Robotics/The Robot Report
Sănătatea este zona unde mă aștept ca AI-ul întrupat să avanseze cel mai prudent.
Sistemele chirurgicale precum da Vinci de la Intuitive sunt deja folosite în spitale din toată lumea, dar un chirurg le controlează, iar cea mai mare parte a cercetării AI de aici se concentrează pe asistență, cum ar fi urmărirea instrumentelor, controlul camerei și suportul pentru sutură.
În sănătate, aprobarea de reglementare este adesea o constrângere mai mare decât capabilitatea modelului, și pe bună dreptate. Eu m-aș aștepta personal ca utilizările de asistență și instruire să apară cu mult înaintea a ceva apropiat de chirurgia autonomă.
Umanoizii primesc cea mai multă atenție și sunt printre cei mai puțin validați.
La CES 2026, Boston Dynamics a prezentat versiunea de producție a lui Atlas și a spus că fiecare unitate construită în 2026 este deja rezervată pentru Hyundai și Google DeepMind. Figure, între timp, a rulat o implementare de 11 luni a humanoidului Figure 02 la fabrica BMW din Spartanburg, Carolina de Sud, încărcând tablă.
Dar vreau să fiu sincer: majoritatea implementărilor cu umanoizi sunt încă proiecte pilot cu un set îngust de sarcini. Hyundai, de exemplu, plănuiește să înceapă să folosească Atlas pentru secvențiere de piese în 2028, un semn al prudenței chiar și din partea celor mai mari susținători.
Hai să vorbim acum despre cine construiește toate acestea în mod concret. Iată cele 5 organizații pe care cred că oricine e nou în AI-ul întrupat ar trebui să le recunoască:
| Organizație | Ce construiesc | De ce contează |
|---|---|---|
| NVIDIA | Isaac Sim, Isaac Lab, Newton, GR00T și Cosmos | Stiva de simulare și compute pe care se antrenează cele mai multe echipe |
| Physical Intelligence | Familia de modele fundaționale de roboți π₀ | Politici de roboți cu scop general, cu checkpoint-uri deschise |
| Agility Robotics | Humanoidul Digit | Gândit pentru logistică în depozite și deja în lucru cu clienți |
| Boston Dynamics | Atlas, Stretch și Spot | Trecerea lui Atlas de la demo-uri de cercetare la unități de producție în 2026 |
| AMI Labs (Yann LeCun) | Modele de lume în stil JEPA | Un pariu contrarian pe modele de lume care nu generează pixeli |
NVIDIA construiește mai ales instrumentele din jurul robotului, nu robotul în sine.
Isaac Sim se ocupă de simulare fotorealistă, Isaac Lab de RL peste aceasta, iar Newton poate acum oferi fizica. Multe echipe de robotică se antrenează pe software NVIDIA chiar dacă NVIDIA nu vinde un robot cu scop general.
Physical Intelligence a construit π₀, un model viziune–limbaj–acțiune cu 3,3 miliarde de parametri care folosește flow matching pentru a produce bucăți line de acțiuni pentru sarcini precum împăturirea rufelor.
Este cel mai bun exemplu pe care îl știu de model de robot cu scop general pe care îl poți descărca efectiv, prin repository-ul openpi.
Dacă noțiunea de „model fundațional” îți este nouă, ghidul nostru Introducere în modelele fundaționale explică bine ideea.
Agility Robotics a ales ruta îngustă cu Digit.
A fost proiectat din prima zi în jurul mutării containerelor în depozite, iar acel focus îngust este un motiv important pentru care a ajuns la clienți plătitori mai devreme decât majoritatea umanoizilor.
Boston Dynamics a ales ruta opusă cu Atlas.
A petrecut ani împingând limitele atletice ale robotului (probabil ai văzut videoclipurile cu parkour) înainte de a-l transforma într-un produs complet electric pentru fabrici, pe care Google DeepMind plănuiește să-l alimenteze cu modelele Gemini Robotics.
AMI Labs este startup-ul lui Yann LeCun din Paris, care a închis o rundă seed de 1,03 miliarde $ în martie 2026 la o evaluare pre-money de 3,5 miliarde $. Runda a fost co-condusă de Cathay Innovation, Greycroft, Hiro Capital, HV Capital și Bezos Expeditions, cu NVIDIA și Samsung printre alți investitori.
LeCun a susținut ani la rând că prezicerea fiecărui pixel al viitorului este risipitoare, așa că Joint Embedding Predictive Architecture (JEPA) își face predicțiile într-un spațiu de reprezentare abstract, o idee deja testată de Meta cu V-JEPA 2.
Ce face AMI demn de urmărit este că merge împotriva direcției principale a domeniului. Încă nu a livrat nimic, totuși, așa că aș trata-o deocamdată ca pe un pariu de cercetare cu mulți bani în spate, nu ca pe o abordare dovedită.
AI-ul întrupat nu este doar o problemă de inginerie robotică. Multă muncă, și aș spune că cea mai mare parte, este muncă de machine learning.
Competențele care se transferă cel mai direct sunt:
Nu ai nevoie de un robot ca să începi. Biblioteca gymnasium vine cu medii MuJoCo, așa că după ce rulezi pip install "gymnasium[mujoco]" poți rula întreaga buclă pe un robot simulat:
import gymnasium as gym

# HalfCheetah is a 2D cheetah-like robot simulated with the MuJoCo physics engine
env = gym.make("HalfCheetah-v5")
observation, info = env.reset(seed=42)

for step in range(1000):
    # Perception: the observation holds joint angles and velocities
    # Reasoning: a trained policy would choose the action here, we pick randomly
    action = env.action_space.sample()

    # Action: apply torques to the joints and move the physics forward one step
    observation, reward, terminated, truncated, info = env.step(action)

    if terminated or truncated:
        observation, info = env.reset()

env.close()
Acum, ghepardul doar se zbate haotic pentru că pasul de „raționament” este env.action_space.sample(), care alege de fiecare dată o acțiune aleatoare.
Înlocuirea acelei singure linii cu o politică antrenată este exact ce face învățarea prin întărire, și ți-aș recomanda să o încerci înainte să treci la ceva mai mare.
AI-ul întrupat avansează rapid, dar încă se poticnește în 4 locuri, și cred că merită să le știi:
AI-ul întrupat oferă mașinilor un corp fizic și inteligența de a-l folosi. Funcționează prin bucla percepție–raționament–acțiune, este tras înapoi în principal de puținele date fizice existente și, în 2026, iese din laboratoare și intră în depozite și în primele proiecte pilot din fabrici.
Ce mă surprinde cu adevărat este cum s-a schimbat întrebarea. Acum câțiva ani, oamenii întrebau dacă LLM-urile vor face cercetarea în robotică irelevantă. În schimb, LLM-urile devin stratul de raționament din sistemele întrupate, iar cele două domenii cresc unul în altul.
Îți amintești mărul de la începutul articolului? Să știi cum să-l ridici și să-l ridici efectiv s-au dovedit a fi două probleme foarte diferite, iar AI-ul întrupat este domeniul care lucrează la a doua.
Dacă vrei să construiești fundațiile ML pentru asta, începe cu track-ul Reinforcement Learning in Python. Pentru latura de limbaj a stack-ului, cursul nostru Large Language Models (LLMs) Concepts și track-ul Developing Large Language Models sunt pași buni mai departe.
Cursuri DataCamp de top
Curs
Curs
Traseu de învățare