
कोर्स
Python में Deep Reinforcement Learning
4 घंटा
6K
कल्पना करें कि आप किसी मित्र से फल की टोकरी में से एक सेब देने को कहते हैं। वह टोकरी को देखता है, पहचानता है कि सेब कौन सा है, और उसे इतना धीरे-से उठाता है कि वह दबे नहीं, फिर आपको पकड़ा देता है।
अब वही काम एक चैटबॉट से कराते हैं। वह आपको बिल्कुल बता सकता है कि सेब कैसे उठाया जाए, किन उंगलियों का उपयोग किया जाए, और लगभग कितनी ताकत लगाई जाए, लेकिन वह वास्तव में सेब उठा नहीं सकता। उसके पास न हाथ हैं और न ही उसे पता है कि सेब छूने में कैसा लगता है।
Embodied AI इसी खाई को पाटने की कोशिश करने वाला क्षेत्र है। सरल शब्दों में, यह वह AI है जिसका एक भौतिक शरीर होता है (जैसे रोबोट, कार, या ड्रोन) और जो वास्तविक दुनिया में करतब करके सीखता है, न कि केवल उनके बारे में पढ़कर। इसी विचार के लिए आप “physical AI” शब्द भी देखते हैं।
अभी, यह क्षेत्र बड़े उभार पर है। जनवरी 2026 के CES में, NVIDIA के Jensen Huang ने इसे कहा कि यह “रोबोटिक्स के लिए ChatGPT क्षण” है।
इसके साथ धन भी आया है। CNBC द्वारा रिपोर्ट किए गए Dealroom डेटा के अनुसार, रोबोटिक्स कंपनियों ने 2026 में जून की शुरुआत तक $55.8 बिलियन जुटाए, जो पिछले वार्षिक रिकॉर्ड का लगभग दोगुना है।
इस लेख में, मैं कवर करूंगा:
यदि आपने पहले कभी रोबोट के साथ काम नहीं किया है तो भी चिंता न करें। मशीन लर्निंग की कुछ जानकारी मदद करेगी, लेकिन मैं हर विचार को शुरुआत से बनाऊंगा ताकि आप किसी भी स्तर से साथ चल सकें।
Embodied AI वह कृत्रिम बुद्धिमत्ता प्रणाली है जो रोबोट, स्वायत्त वाहन, या ड्रोन जैसे भौतिक शरीर में निर्मित होती है, जो सेंसरों के माध्यम से अपने वातावरण को अनुभव करती है, क्या करना है इस पर विचार करती है, और मोटर्स के जरिए दुनिया पर क्रिया करती है, अपनी ही क्रियाओं के परिणामों से सीखते हुए।
यहां मुख्य शब्द है embodied।
ज्यादातर AI मॉडल वह डेटा देखकर सीखते हैं जो किसी और ने एकत्र किया है। एक embodied सिस्टम अपने वातावरण से संवाद करके सीखता है, जैसे कप को धक्का देना, कप को फिसलते हुए देखना, और यह अद्यतन करना कि कप धक्का देने पर कैसे बर्ताव करते हैं।
यहां एक उदाहरण है। दरवाजों की लाखों तस्वीरों पर प्रशिक्षित एक विज़न मॉडल जानता है कि दरवाजा कैसा दिखता है। एक रोबोट जिसने वास्तव में 500 दरवाजे खोलने की कोशिश की है, वह जानता है कि कुछ दरवाजे धक्के से खुलते हैं, कुछ अपनी ओर खींचने से, कुछ भारी होते हैं, और कुछ के हैंडल पहले नीचे दबाने पड़ते हैं।
आप यह गहराई एक तस्वीर से नहीं पा सकते।
मैं इसे ऐसे रखता हूं: अधिकांश AI दुनिया के बारे में पढ़कर जानता है; embodied AI दुनिया को छूकर और अनुभव करके जानता है।
यही एक फर्क आपके आवश्यक डेटा, प्रशिक्षण के तरीके, और गलतियां कहां हो सकती हैं—सबकुछ बदल देता है।
अभी तक, मैंने embodied AI की तुलना एक चैटबॉट से की है। अब इसकी तुलना उन 2 चीजों से करते हैं जिनसे इसे लोग अक्सर मिलाते हैं: बड़े भाषा मॉडल (LLMs) और पारंपरिक नियम-आधारित रोबोटिक्स।
| Embodied AI | बड़े भाषा मॉडल (LLMs) | पारंपरिक नियम-आधारित रोबोटिक्स | |
|---|---|---|---|
| पर्यावरण से सीखता है | हां, अन्तरक्रिया और फीडबैक के जरिए | अधिकतर नहीं, स्थिर पाठ कॉर्पस से सीखता है | नहीं, बर्ताव हाथों से प्रोग्राम किया जाता है |
| भौतिक क्रियाएं करता है | हां | नहीं | हां |
| इंटरनेट डेटा पर प्रशिक्षण | आंशिक रूप से (इसके विज़न और लैंग्वेज बैकबोन्स) | हां, ट्रिलियंस टोकन | नहीं |
| नए परिवेशों में सामान्यीकरण | मध्यम, और तेजी से सुधर रहा है | अच्छा, भाषा कार्यों के भीतर | कमजोर, सेटअप बदलते ही टूटता है |
| 2026 में व्यावसायिक परिपक्वता | शुरुआती प्रोडक्शन (वेयरहाउस, फैक्टरी पायलट) | परिपक्व और व्यापक तैनाती | परिपक्व, दशकों से फैक्ट्रियों में |
आखिरी 2 पंक्तियों पर खास ध्यान दें।
नियम-आधारित औद्योगिक आर्म्स दशकों से कारें वेल्ड कर रहे हैं, और वे बेहद भरोसेमंद हैं, पर इसलिए कि उनके वर्क-सेल के भीतर कुछ भी बदलता नहीं। Embodied AI उसी भरोसे को बनाए रखते हुए दुनिया को अव्यवस्थित रहने देने की कोशिश करता है, जिसे शोधकर्ता generalization कहते हैं।
LLMs और embodied AI दोनों बड़े पैमाने के डेटा से सीखते हैं, लेकिन वे बिल्कुल अलग समस्याएं हल करते हैं। एक LLM इनपुट में पाठ लेता है और अगला टोकन क्या होना चाहिए, यह भविष्यवाणी करता है; जबकि एक embodied सिस्टम कैमरा फ्रेम, जॉइंट एंगल्स, और टच रीडिंग्स इनपुट में लेकर अगली मूवमेंट क्या होनी चाहिए, यह भविष्यवाणी करता है।
संक्षेप में, LLMs भौतिक दुनिया के बारे में जानते हैं, जबकि embodied AI उसमें क्रिया करता है। हमारे सेब पर लौटें: एक LLM ठीक-ठीक बता सकता है कि उसे कैसे उठाया जाए, और एक embodied AI रोबोट वास्तव में उसे उठा सकता है।
गलती की कीमत भी बहुत अलग होती है। यदि LLM कुछ गलत कर दे, तो आपको थोड़ा अजीब वाक्य मिलता है। अगर embodied सिस्टम गलती करे, तो गिलास फर्श पर जा सकता है—या इससे भी बुरा।
अब वह हिस्सा जिसे मेरा मानना है कि कई लोग चूक जाते हैं: दोनों साथ मिलकर काम करते हैं।
विज़न-लैंग्वेज-एक्शन (VLA) मॉडल्स में, एक प्रीट्रेंड विज़न-लैंग्वेज मॉडल सिस्टम के केंद्र में बैठता है। यह कैमरा इमेज और आपका निर्देश (“फल को कटोरे में रखो”) पढ़ता है, फिर अपनी समझ को एक एक्शन डिकोडर को पास करता है, जो वास्तविक मोटर कमांड्स बनाता है।
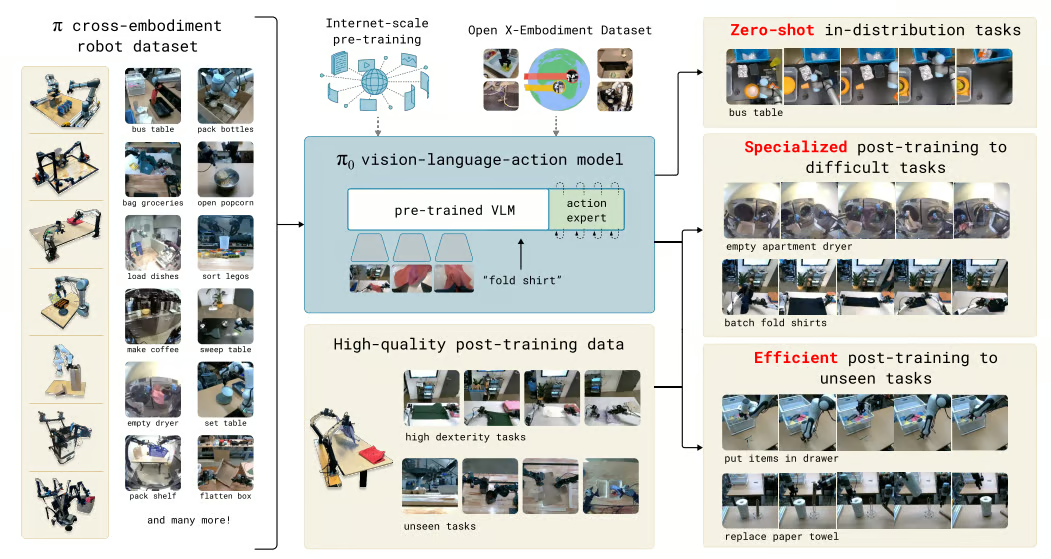
π₀ (पाई-ज़ीरो) में प्रीट्रेंड विज़न-लैंग्वेज मॉडल रोबोट क्रियाओं से कैसे जुड़ता है। स्रोत: Black et al., 2024
Physical AI, मुख्यतः डेटा की वजह से, Digital AI से कठिन है।
भाषा मॉडल तेज़ी से आगे बढ़े क्योंकि दशकों से लोग ऑनलाइन पाठ, कोड, और चित्र साझा कर रहे हैं, लेकिन वास्तविक-विश्व सेंसर डेटा का कोई तुलनीय स्रोत नहीं है। रोज़मर्रा की वस्तुओं से संवाद करते रोबोट्स के जॉइंट एंगल्स, फोर्स रीडिंग्स, और कैमरा फ्रेम्स की धाराएं बहुत कम हैं।
डेटा आवश्यकताओं को ज़रा विस्तार से देखें। एक embodied सिस्टम को 3 तरह के डेटा चाहिए, जो मिलना मुश्किल है:
अब इस पर कुछ संख्याएं लगाते हैं।
फ्रंटियर LLMs ट्रिलियंस टोकन पर प्रशिक्षित होते हैं। Open X-Embodiment, जो सबसे बड़े खुले रोबोटिक्स डेटासेट्स में से एक है, ने 21 संस्थानों के 22 रोबोट प्रकारों से डेटा जोड़ा और वास्तविक दुनिया की बस 10 लाख से थोड़ी अधिक trajectories पर पहुँचा।
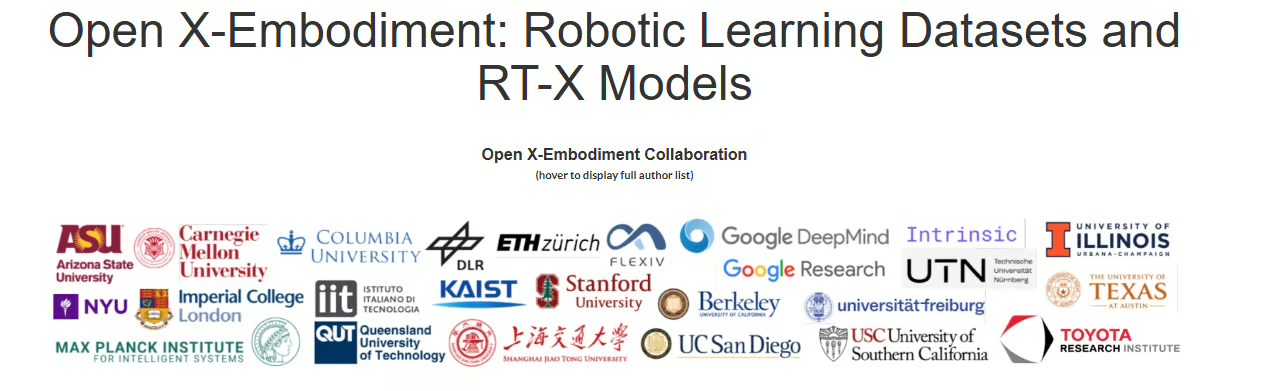
Open X-Embodiment डेटासेट में जोड़े गए रोबोट्स और कार्य। स्रोत: Open X-Embodiment Collaboration, 2023
इतना कम क्यों? हर trajectory के लिए एक असली रोबोट को एक असली काम करना पड़ता है, जिसे आमतौर पर इंसान टेलीऑपरेशन से नियंत्रित करता है—जो धीमा और महंगा है।
यही अंतर कारण है कि Physical AI, Digital AI की तुलना में धीरे सामान्यीकृत होता है। कोई मॉडल विविधता को सबसे अच्छा तब संभालता है जब उसने पहले कुछ समान देखा हो, और 10 लाख trajectories रसोईघरों, रोशनी के सेटअप्स, और वस्तुओं के आकारों का कहीं कम कवरेज देती हैं, जितना ट्रिलियंस टोकन वाक्यों का देते हैं।
मैं चाहूंगा कि आप इस डेटा समस्या को लेख के बाकी हिस्से के लिए दिमाग में रखें। आगे जो भी डिजाइन निर्णय दिखेंगे—सिमुलेशन से लेकर डोमेन रैंडमाइजेशन तक और प्रीट्रेंड विज़न-लैंग्वेज बैकबोन्स उधार लेने तक—वे इसी के उपाय हैं।
Embodied AI 3 चरणों के एक सतत लूप से काम करता है:
यह लूप प्रति सेकंड कई बार दोहरता है, और हर मूवमेंट अगली बार रोबोट जो महसूस करता है उसे बदल देता है, इसलिए एक चक्र का आउटपुट अगले चक्र का इनपुट बन जाता है।
यही लूप वर्ल्ड मॉडल्स के पीछे भी बैठा है। Ha और Schmidhuber के 2018 के “World Models” पेपर ने एक एजेंट को विज़न मॉड्यूल, मेमोरी मॉड्यूल, और कंट्रोलर में बांटा और इसे रेसिंग गेम में कार पर परखा। Embodied AI यही विचार एक पूरे रोबोट पर लागू करता है।
लूप को समझने का अच्छा तरीका एक गेंद पकड़ने की कल्पना करना है:
रोबोट भी यही करता है, बस आंखों की जगह कैमरे और मांसपेशियों की जगह मोटर्स होते हैं।
अब हर चरण को बारी-बारी से लें।
Perception वह चरण है जो कच्ची सेंसर रीडिंग्स को ऐसी चीज में बदलता है जिस पर सिस्टम का बाकी हिस्सा तर्क कर सके। अकेला कैमरा शायद ही काफी होता है, इसलिए अधिकांश रोबोट कई सेंसर जोड़ते हैं:
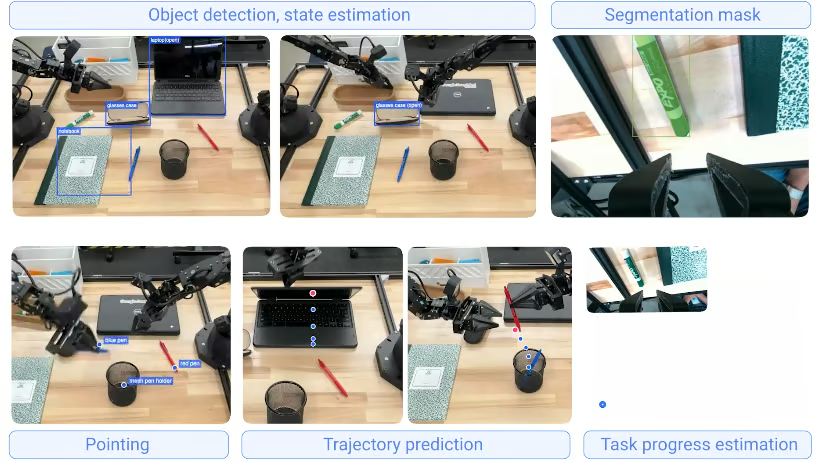
Gemini Robotics-ER 1.5 से perception आउटपुट के उदाहरण। स्रोत: Google DeepMind
इसके बाद perception मॉडल्स इन रीडिंग्स को स्पैटियल मैप्स, ऑब्जेक्ट पहचान, बाधाओं की स्थिति, और दृश्य की सामान्य समझ में बदलते हैं।
इसका अधिकांश हिस्सा मानक कंप्यूटर विज़न है, जैसे ऑब्जेक्ट डिटेक्शन, सेगमेंटेशन, और डेप्थ एस्टीमेशन, जो आम तौर पर DINOv2 या SigLIP जैसे प्रीट्रेंड विज़न ट्रांसफॉर्मर्स पर बने होते हैं।
मेरे विचार में, हालांकि, स्पर्श अभी perception का सबसे कम आंका गया हिस्सा है। कैमरा आपको बता सकता है कि मेज पर एक गिलास है, लेकिन स्पर्श बताता है कि गिलास आपकी पकड़ से फिसलना शुरू हो रहा है।
स्थिति का अंदाजा देने के लिए, XELA Robotics ने Automate 2026 में एक रोबोटिक फिंगरटिप दिखाया जिसमें पैड में 30 तीन-अक्ष बल-संवेदन बिंदु समाए हैं। कंपनी यह भी कहती है कि उसके uSkin सेंसर 0.1 ग्राम-फोर्स जितनी छोटी ताकत का भी पता लगा सकते हैं।
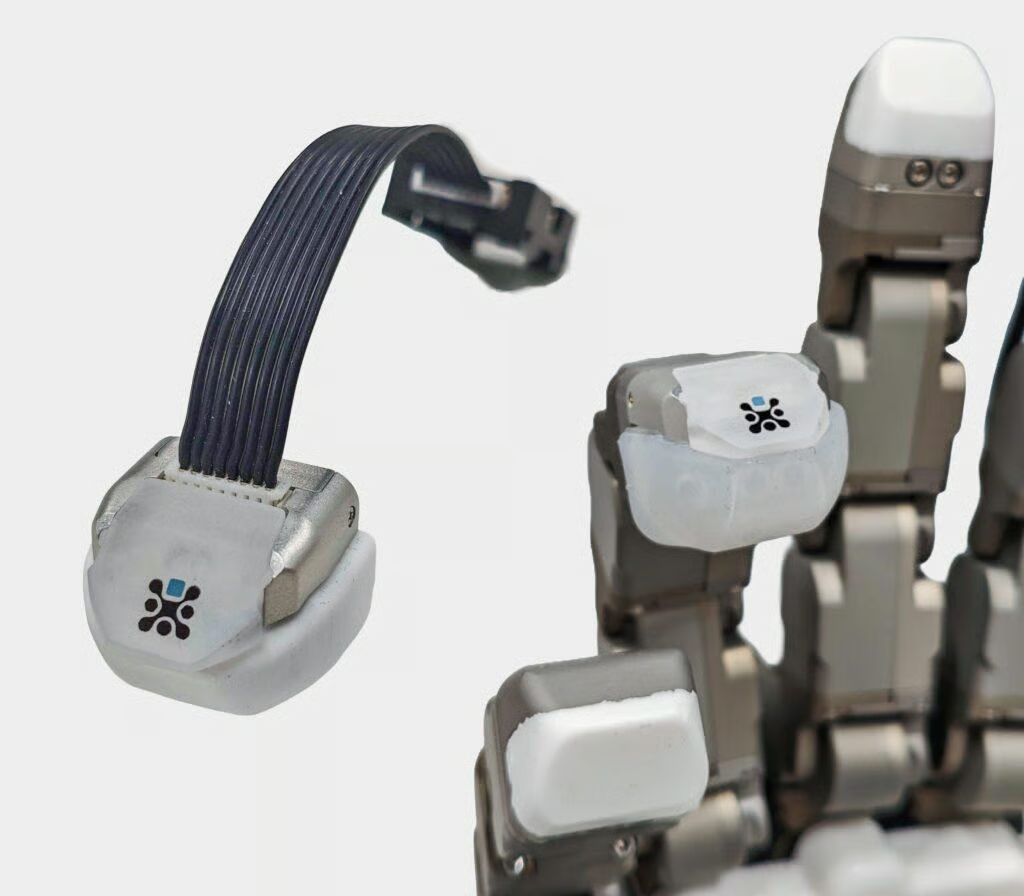
तीन-अक्षीय टैक्टाइल सेंसिंग बिंदुओं की array युक्त एक uSkin रोबोटिक फिंगरटिप। स्रोत: XELA Robotics
Reasoning वह चरण है जो तय करता है कि आगे क्या करना है। नए सिस्टम्स में, इसमें आमतौर पर 2 लेयर होते हैं:
वर्ल्ड मॉडल्स ही रोबोट को क्रिया से पहले कल्पना करने देते हैं।
DreamerV3 एक अच्छा उदाहरण है। यह अपने वातावरण का कॉम्पैक्ट मॉडल सीखता है और फिर अपनी पॉलिसी का प्रशिक्षण लगभग पूरी तरह उसी कल्पित दुनिया के भीतर करता है।
मैं अपने शोध में DreamerV3 का उपयोग करता हूं, और जिसने मुझे सबसे अधिक चौंकाया है वह यह है कि एजेंट वास्तविक वातावरण की तुलना में अपनी “सोच” में कितनी अधिक देर अभ्यास करता है। यह मायने रखता है क्योंकि प्रशिक्षण तेज़ और बहुत सस्ता हो जाता है।
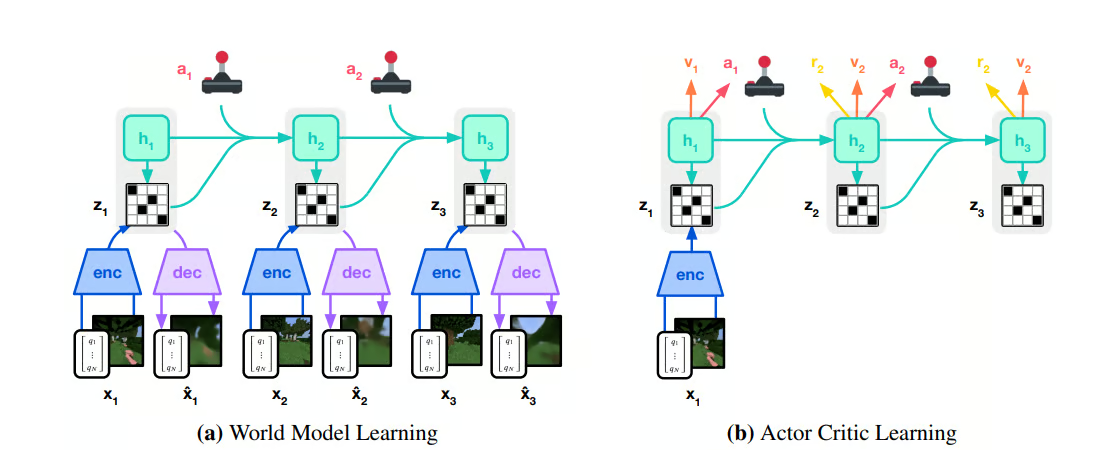
DreamerV3 अपनी पॉलिसी का प्रशिक्षण अपने वर्ल्ड मॉडल से आने वाले imagined rollouts पर करता है। स्रोत: Hafner et al., 2023
दूसरी ओर, प्लानिंग तेजी से भाषा मॉडलों द्वारा संभाली जा रही है।
Google DeepMind का Gemini Robotics-ER 1.5 एक अच्छा उदाहरण है, जो उच्च-स्तरीय प्लानर की तरह काम करता है। कचरा स्थानीय रीसाइक्लिंग नियमों के अनुसार छांटने जैसे काम पर, यह Google Search से नियम देख सकता है, काम को चरणों में तोड़ सकता है, और हर चरण को Gemini Robotics 1.5 VLA मॉडल को सौंप सकता है जो भौतिक कार्य करता है।
आप भाषा मॉडल को मैनेजर और VLA मॉडल को वह वर्कर समझ सकते हैं जो वास्तव में काम करता है।
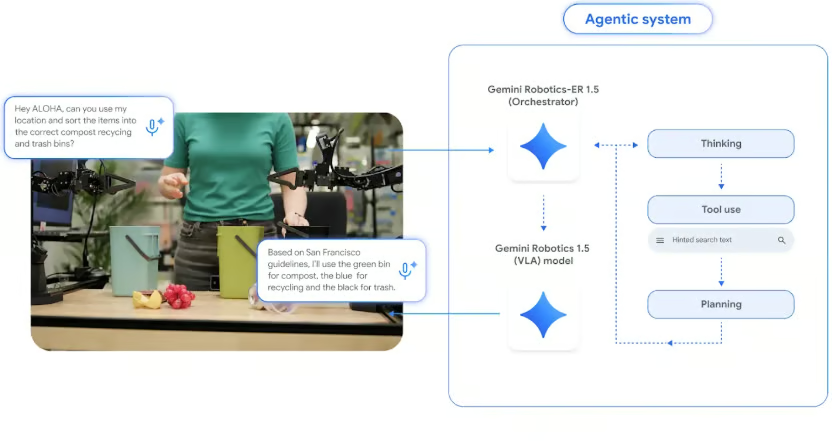
Gemini Robotics-ER 1.5 काम की योजना बनाता है और भौतिक निष्पादन Gemini Robotics 1.5 VLA को सौंपता है। स्रोत: Google DeepMind, 2025
Action वह चरण है जो किसी निर्णय को हर जोड़ और मोटर के लिए सटीक कमांड्स में बदलता है, आमतौर पर प्रति सेकंड दर्जनों से सैकड़ों बार (हर्ट्ज़, या Hz में मापा जाता है)। इस चरण के लो-लेवल हिस्से को कंट्रोल कहते हैं।
मसलन, “ग्रिपर को 5 सेमी बाईं ओर ले जाओ” जैसा कमांड सुनने में सरल है, पर 7-जॉइंट आर्म पर इसे हर जॉइंट मोटर के लिए विशिष्ट टॉर्क में बदलना पड़ता है, और जैसे-जैसे आर्म चलता है, यह लगातार दोबारा गणना होता रहता है।
कठिनाई यह है कि हकीकत शायद ही वैसी होती है जैसी रोबोट ने अपेक्षा की थी। चीजें फिसलती हैं, फर्श थोड़ा असमतल होता है, कोई ब्लाइंड खोल दे तो रोशनी बदल जाती है, और कोई केबल भविष्यवाणी से अलग तरीके से मुड़ जाती है।
एक अच्छा कंट्रोलर जो उम्मीद थी और जो वास्तव में हुआ, उनके बीच के फर्क को नोटिस करता है, फिर तुरंत सुधार करता है।
मेरे विचार में, अव्यवस्थित, असंरचित वातावरणों में एक्शन सबसे कठिन चरण है। Perception की गलती फिर से देखकर सुधारी जा सकती है और प्लानिंग की गलती फिर से योजना बनाकर, लेकिन कंट्रोल की गलती वास्तविक समय में होती है।
Embodied AI का प्रशिक्षण सिमुलेशन और वास्तविक दुनिया के डेटा के मिश्रण पर होता है। सिमुलेशन का मतलब है भौतिकी-सटीक 3D वस्तुओं से भरे वर्चुअल वातावरण, जहां रोबोट असली हार्डवेयर को छूने से पहले लाखों बार अभ्यास कर सकता है।
पहले वाली डेटा समस्या याद है? सिमुलेशन इसका एक मुख्य उपाय है, खासकर लोकोमोशन और मैनिपुलेशन के रिइन्फोर्समेंट लर्निंग के लिए। π₀ जैसे फाउंडेशन मॉडल अभी भी वास्तविक प्रदर्शनियों पर बहुत निर्भर हैं, इसलिए अधिकांश टीमें दोनों का उपयोग करती हैं।
वास्तविक दुनिया में डेटा एकत्र करना 3 बड़े मुद्दों से ग्रस्त है:
एक सिम्युलेटर तीनों का एक साथ समाधान करता है। आप एक ही GPU पर हजारों वर्चुअल रोबोट्स समानांतर में चला सकते हैं और उन्हें जितनी बार चाहिए फेल होकर फिर शुरू होने दे सकते हैं। इससे वर्षों का रोबोट अनुभव कुछ घंटों में सिमट जाता है।
हर सिम्युलेटर रोबोट्स को प्रशिक्षित करने के लिए समान रूप से उपयोगी नहीं होता। खुद रोबोट आर्म्स के साथ सिमुलेशन में काम करने के अनुभव से, मैं कहूंगा कि एक अच्छे सिम्युलेटर में 3 चीजें चाहिए:
आप दो प्लेटफॉर्म सबसे ज्यादा देखेंगे—NVIDIA Isaac Sim (Isaac Lab के साथ) और MuJoCo:
| प्लेटफॉर्म | डेवलपर | किसमें अच्छा | किसके लिए सर्वोत्तम |
|---|---|---|---|
| NVIDIA Isaac Sim और Isaac Lab | NVIDIA | फोटोरियलिस्टिक रेंडरिंग, सेंसर सिमुलेशन, GPU पर हजारों समानांतर वातावरण | बड़े रिइन्फोर्समेंट लर्निंग रन और सिंथेटिक कैमरा डेटा |
| MuJoCo | Google DeepMind (ओपन सोर्स) | तेज, सटीक संपर्क-भौतिकी, हल्का, विशाल शोध समुदाय | शोध, लोकोमोशन और मैनिपुलेशन बेंचमार्क |
नवीनतम जोड़ है Newton, एक ओपन-सोर्स, GPU-एक्सेलरेटेड फिजिक्स इंजन जिसे NVIDIA, Google DeepMind, और Disney Research ने बनाया है और Linux Foundation के माध्यम से प्रबंधित किया जाता है।
Newton 1.0 को मार्च 2026 के NVIDIA GTC में जारी किया गया। यह Isaac Lab में एक फिजिक्स बैकएंड की तरह प्लग-इन होता है, जिसमें MuJoCo Warp इसके सॉल्वर्स में से एक है और डिफॉर्मेबल ऑब्जेक्ट्स जैसे केबल्स और कपड़े के लिए अतिरिक्त सॉल्वर्स हैं।
डिफॉर्मेबल्स उनकी सुनाई देने से ज्यादा मायने रखते हैं। पुराने सिम्युलेटर्स केबल्स और फैब्रिक को खराब तरीके से संभालते थे, और फैक्ट्रियों को रोबोट्स चाहिए जो दोनों संभाल सकें।
Sim-to-Real गैप वह प्रदर्शन-गिरावट है जो तब होती है जब सिमुलेशन में प्रशिक्षित पॉलिसी को असली रोबोट पर ले जाया जाता है, और यह embodied सिस्टम्स की सबसे बड़ी समस्याओं में से एक है।
उदाहरण के लिए, सिम्युलेटेड घर्षण कभी ठीक वैसा नहीं होता, सिम्युलेटेड कैमरे बहुत साफ होते हैं, और सिम्युलेटेड ऑब्जेक्ट बहुत परफेक्ट हो सकते हैं, इसलिए जो पॉलिसी सिमुलेशन में 95% बार सफल होती है, वह वास्तविक हार्डवेयर से टकराते ही टूट सकती है।
टीमें यह गैप बंद करने के 2 मुख्य तरीकों का इस्तेमाल करती हैं:
सिम्युलेटर को परफेक्ट बनाने की कोशिश करने के बजाय, टीमें उसे कई तरीकों से रैंडमाइज करती हैं।
Tobin et al. (2017) ने टेक्स्चर और रोशनी को इतना रैंडमाइज किया कि वास्तविक दुनिया मॉडल को बस एक और विविधता लगने लगी। OpenAI के रूबिक क्यूब रोबोट हाथ ने इससे आगे बढ़ते हुए पॉलिसी बेहतर होते ही रैंडमाइजेशन को स्वतः व्यापक कर दिया।
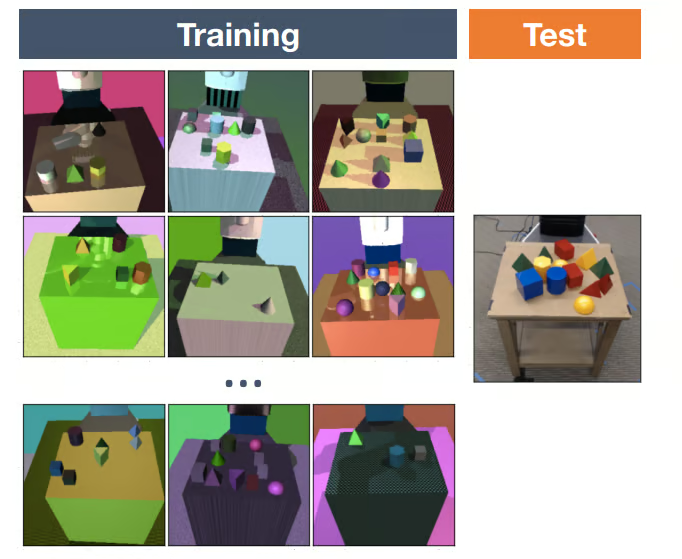
सिमुलेशन में प्रीट्रेंड पॉलिसी को अक्सर अनुकूलन के लिए केवल वास्तविक प्रदर्शनों के एक छोटे सेट की जरूरत होती है, क्योंकि वह पहले ही कार्य का सामान्य आकार सीख चुकी होती है।
कोई भी तकनीक गैप को पूरी तरह नहीं हटाती, इसलिए टीमें इसके वास्तविक-विश्व प्रदर्शन पर प्रभाव को कम करने पर काम जारी रखती हैं।
Embodied AI अब कई उद्योगों में लैब के बाहर चल रहा है, हालांकि बहुत असमान रूप से।
जो पैटर्न मैं देखता हूं वह यह है कि यह सबसे पहले वहां उतरता है जहां वातावरण इतना बदलता है कि उसे हाथों से स्क्रिप्ट करना मुश्किल हो, पर जहां कुछ गलत होने पर इंसान फिर भी कदम रख सके।
सेल्फ-ड्राइविंग कारें embodied AI की सबसे डेटा-लालायित किस्मों में से हैं।
Waymo Driver लगभग 200 मिलियन पूरी तरह स्वायत्त मील चल चुका है, और यह अपने वर्ल्ड मॉडल पर Waymo की फरवरी 2026 की पोस्ट के अनुसार अरबों सिम्युलेटेड मील पर भी ट्रेन और टेस्ट करता है। सिमुलेशन Waymo को वास्तविक घटनाओं को फिर चलाने और दुर्लभ परिदृश्य (जैसे खड़ी कारों के बीच से भागता हुआ बच्चा) बनाने देता है, जो टेस्ट फ्लीट को कभी वास्तविक सड़कों पर न मिलें।
सेल्फ-ड्राइविंग कारें perception-reasoning-action लूप के पूरे वेग से चलने का भी अच्छा उदाहरण हैं। एक Waymo वाहन कैमरे, लाइडार, और रडार से perception करता है, हर पैदल यात्री और वाहन के अगले कदम का अनुमान लगाता है, और प्रति सेकंड कई बार स्टीयरिंग और ब्रेक्स को कंट्रोल करके act करता है।
मेरे विचार में, वेयरहाउस अभी embodied AI का सबसे स्वाभाविक व्यावसायिक उपयोग हैं।
शिफ्ट फिक्स्ड-पाथ रोबोट्स से है जो फर्श पर लाइनों का अनुसरण करते थे, उन सिस्टम्स की ओर जो डायनेमिक, अव्यवस्थित इन्वेंटरी से निपट सकें—जैसे ऐसे टोट से पिक करना जिसमें 40 अलग-अलग उत्पाद एक साथ फेंके गए हों।
Agility Robotics का Digit ह्यूमनॉइड GXO Logistics में 2024 में साइन हुए बहुवर्षीय समझौते के तहत टोट्स मूव कर रहा है, और Boston Dynamics का Stretch रोबोट ट्रकों से बॉक्स उतारता है।
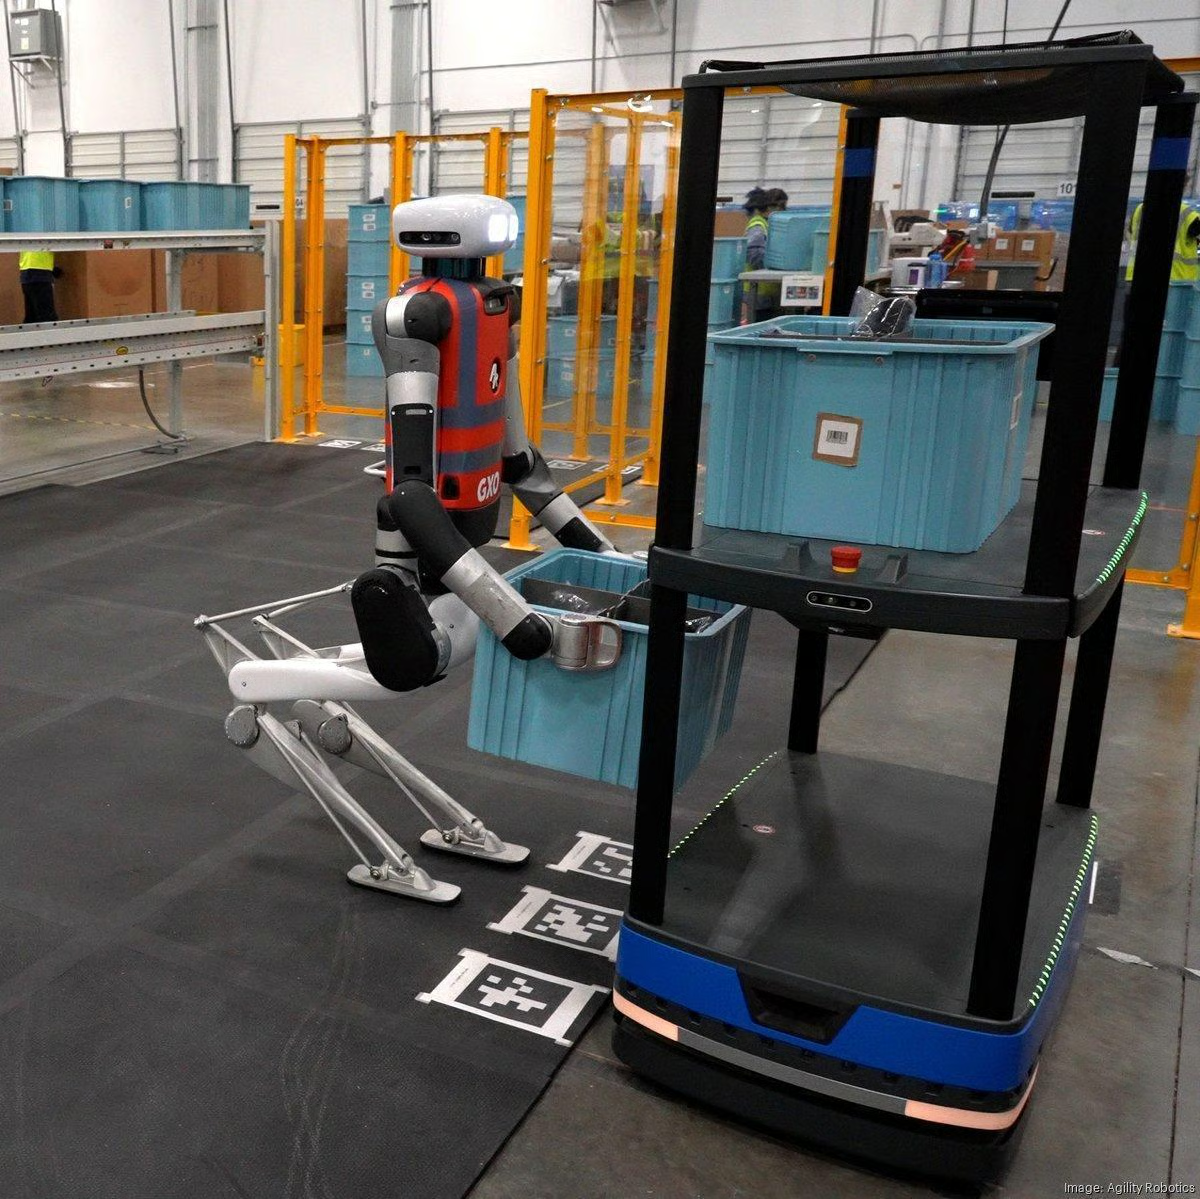
Agility Robotics का Digit GXO वेयरहाउस में स्वायत्त मोबाइल रोबोट्स और कन्वेयर के बीच टोट्स मूव करता हुआ। स्रोत: Agility Robotics/The Robot Report
हेल्थकेयर वह क्षेत्र है जहां मुझे अपेक्षा है कि Embodied AI सबसे सावधानी से आगे बढ़ेगा।
Intuitive के da Vinci जैसे सर्जिकल सिस्टम पहले से दुनिया भर के अस्पतालों में उपयोग में हैं, पर उन्हें सर्जन नियंत्रित करता है, और यहां अधिकांश AI शोध सहायता पर केंद्रित है—जैसे इंस्ट्रूमेंट ट्रैकिंग, कैमरा नियंत्रण, और स्यूचरिंग सपोर्ट।
हेल्थकेयर में, विनियामक स्वीकृति अक्सर मॉडल क्षमता से बड़ा अवरोध होती है—और वाजिब है। व्यक्तिगत तौर पर, मैं उम्मीद करूंगा कि सहायक और प्रशिक्षण उपयोग पूर्णतः स्वायत्त सर्जरी से बहुत पहले आएंगे।
ह्यूमनॉइड्स को सबसे ज्यादा ध्यान मिलता है और वे सबसे कम साबित हुए हैं।
CES 2026 में, Boston Dynamics ने Atlas के प्रोडक्शन संस्करण का अनावरण किया और कहा कि 2026 में वह जितनी भी यूनिट्स बनाएगा, वे सभी Hyundai और Google DeepMind को समर्पित हैं। इसी बीच Figure ने South Carolina के Spartanburg में BMW के प्लांट पर अपने Figure 02 ह्यूमनॉइड की 11-महीने की तैनाती चलाई, जिसमें शीट मेटल लोडिंग की।
लेकिन मैं यहां ईमानदार रहना चाहता हूं: अधिकांश ह्यूमनॉइड तैनातियां अभी भी सीमित कार्यों वाले पायलट हैं। उदाहरण के लिए, Hyundai 2028 में Atlas का उपयोग पार्ट्स सीक्वेंसिंग के लिए शुरू करने की योजना बना रहा है—यह दिखाता है कि सबसे बड़े समर्थक भी कितनी सतर्कता से आगे बढ़ रहे हैं।
अब बात करते हैं कि यह सब वास्तव में कौन बना रहा है। यहां 5 संगठन हैं जिन्हें मैं मानता हूं कि Embodied AI में नए किसी भी व्यक्ति को पहचानना चाहिए:
| संगठन | वे क्या बनाते हैं | क्यों महत्व रखता है |
|---|---|---|
| NVIDIA | Isaac Sim, Isaac Lab, Newton, GR00T, और Cosmos | वह सिमुलेशन और कंप्यूट स्टैक जिस पर ज्यादातर टीमें ट्रेन करती हैं |
| Physical Intelligence | π₀ परिवार के रोबोट फाउंडेशन मॉडल्स | ओपन चेकपॉइंट्स वाले जनरल-पर्पज़ रोबोट पॉलिसीज़ |
| Agility Robotics | Digit ह्यूमनॉइड | वेयरहाउस लॉजिस्टिक्स के लिए बना और पहले से ग्राहकों के साथ काम में |
| Boston Dynamics | Atlas, Stretch, और Spot | 2026 में Atlas को शोध डेमोज़ से प्रोडक्शन यूनिट्स में ले जाना |
| AMI Labs (Yann LeCun) | JEPA-स्टाइल वर्ल्ड मॉडल्स | ऐसे वर्ल्ड मॉडल्स पर अलग दांव जो पिक्सल जेनरेट नहीं करते |
NVIDIA ज़्यादातर रोबोट के आसपास के टूल्स बनाता है, खुद रोबोट नहीं।
Isaac Sim फोटोरियलिस्टिक सिमुलेशन संभालता है, Isaac Lab उसके ऊपर रिइन्फोर्समेंट लर्निंग, और Newton अब फिजिक्स दे सकता है। कई रोबोटिक्स टीमें NVIDIA सॉफ़्टवेयर पर ट्रेन करती हैं, भले ही NVIDIA कोई जनरल-पर्पज़ रोबोट नहीं बेचता।
Physical Intelligence ने π₀ बनाया, 3.3-बिलियन-पैरामीटर का विज़न-लैंग्वेज-एक्शन मॉडल जो फोल्डिंग लॉन्ड्री जैसे कार्यों के लिए स्मूद एक्शन चंक्स पैदा करने में फ्लो मैचिंग का उपयोग करता है।
यह वह सबसे अच्छा उदाहरण है जिसे मैं जानता हूं कि आप वास्तव में डाउनलोड कर सकते हैं—openpi रिपॉज़िटरी के जरिए—एक जनरल-पर्पज़ रोबोट मॉडल का।
यदि “फाउंडेशन मॉडल” की अवधारणा आपके लिए नई है, तो हमारा Introduction to Foundation Models गाइड इसे अच्छी तरह समझाता है।
Agility Robotics ने Digit के साथ संकुचित मार्ग चुना।
इसे दिन एक से वेयरहाउस में टोट्स मूव करने के इर्द-गिर्द डिज़ाइन किया गया था, और यही संकीर्ण फोकस एक बड़ा कारण है कि यह अधिकांश ह्यूमनॉइड्स से पहले भुगतान करने वाले ग्राहकों तक पहुंचा।
Boston Dynamics ने Atlas के साथ विपरीत मार्ग चुना।
उसने वर्षों तक रोबोट की एथलेटिक सीमाओं को धकेला (आपने शायद पार्कौर वीडियो देखे होंगे) फिर इसे एक पूर्ण-इलेक्ट्रिक फैक्ट्री उत्पाद में बदला, जिसे Google DeepMind अपनी Gemini Robotics मॉडल्स से संचालित करने की योजना बना रहा है।
AMI Labs Yann LeCun का पेरिस-स्थित स्टार्टअप है, जिसने मार्च 2026 में $3.5 बिलियन प्री-मनी वैल्यूएशन पर $1.03 बिलियन की सीड राउंड बंद की। राउंड का सह-नेतृत्व Cathay Innovation, Greycroft, Hiro Capital, HV Capital, और Bezos Expeditions ने किया, अन्य निवेशकों में NVIDIA और Samsung भी थे।
LeCun वर्षों से तर्क देते आए हैं कि भविष्य के हर पिक्सल की भविष्यवाणी करना अप्रभावी है, इसलिए उनकी Joint Embedding Predictive Architecture (JEPA) अपने पूर्वानुमान एक अमूर्त निरूपण स्पेस में बनाती है—एक विचार जिसे Meta ने पहले ही V-JEPA 2 के साथ परखा है।
AMI पर नजर रखने लायक यह बनता है कि यह क्षेत्र की मुख्य धारा के विपरीत जा रहा है। हालांकि, इसने अभी कुछ शिप नहीं किया है, इसलिए फिलहाल मैं इसे एक बड़े फंडिंग वाले शोध दांव की तरह देखूंगा, न कि सिद्ध दृष्टिकोण की तरह।
Embodied AI केवल रोबोटिक्स इंजीनियरिंग की समस्या नहीं है। काम का बड़ा हिस्सा—और मैं कहूंगा अधिकांश—मशीन लर्निंग का काम है।
जो कौशल सबसे सीधे ट्रांसफर होते हैं, वे हैं:
शुरू करने के लिए आपको रोबोट की जरूरत नहीं। gymnasium लाइब्रेरी MuJoCo वातावरणों के साथ आती है, तो pip install "gymnasium[mujoco]" चलाने के बाद आप पूरा लूप एक सिम्युलेटेड रोबोट पर चला सकते हैं:
import gymnasium as gym

# HalfCheetah is a 2D cheetah-like robot simulated with the MuJoCo physics engine
env = gym.make("HalfCheetah-v5")
observation, info = env.reset(seed=42)

for step in range(1000):
    # Perception: the observation holds joint angles and velocities
    # Reasoning: a trained policy would choose the action here, we pick randomly
    action = env.action_space.sample()

    # Action: apply torques to the joints and move the physics forward one step
    observation, reward, terminated, truncated, info = env.step(action)

    if terminated or truncated:
        observation, info = env.reset()

env.close()
अभी, चीता बस हाथ-पांव मारता है क्योंकि “reasoning” चरण में env.action_space.sample() है, जो हर बार एक रैंडम एक्शन चुनता है।
उस एक पंक्ति को प्रशिक्षित पॉलिसी से बदल देना ही रिइन्फोर्समेंट लर्निंग का मूल है, और मैं सुझाव दूंगा कि किसी बड़े काम पर जाने से पहले इसे आजमाएं।
Embodied AI तेजी से आगे बढ़ रहा है, पर अभी भी 4 जगहों पर जूझता है, और इन्हें जानना उपयोगी है:
Embodied AI मशीनों को भौतिक शरीर देता है और उसे उपयोग करने की बुद्धिमत्ता भी। यह perception-reasoning-action लूप से काम करता है, मुख्यतः सीमित भौतिक डेटा से बंधा है, और 2026 में शोध लैब्स से निकलकर वेयरहाउस और शुरुआती फैक्ट्री पायलट्स तक पहुंच रहा है।
जो बात मुझे सचमुच चौंकाती है, वह यह है कि सवाल कैसे बदल गया है। कुछ साल पहले, लोग पूछते थे कि क्या LLMs रोबोटिक्स शोध को अप्रासंगिक बना देंगे। इसके बजाय, LLMs embodied सिस्टम्स के भीतर reasoning लेयर बनते जा रहे हैं, और दोनों क्षेत्र एक-दूसरे में घुलते जा रहे हैं।
लेख की शुरुआत का सेब याद है? उसे कैसे उठाना है जानना और वास्तव में उठाना—ये दो बहुत अलग समस्याएं निकलीं, और Embodied AI दूसरा काम करने वाला क्षेत्र है।
यदि आप इसके लिए ML नींव बनाना चाहते हैं, तो हमारे Reinforcement Learning in Python ट्रैक से शुरुआत करें। स्टैक के भाषा पक्ष के लिए, हमारा Large Language Models (LLMs) Concepts कोर्स और हमारा Developing Large Language Models ट्रैक अच्छे अगले कदम हैं।
शीर्ष DataCamp कोर्सेज़
कोर्स
कोर्स
लर्निंग पाथ