
课程
Python 中的深度强化学习
4 小时
6K
想象您让一位朋友从水果碗里递给您一颗苹果。他看一眼水果碗,分辨出哪一个是苹果,轻轻拿起以免被捏坏,然后递到您手上。
现在我们让一个聊天机器人做同样的事。它可以精确地告诉您如何拿起苹果、该用哪些手指、需要多大力度,但它根本拿不起来。它没有手,也不知道苹果摸起来是什么感觉。
具身智能(Embodied AI)正是试图弥合这道鸿沟的领域。简单来说,它是拥有物理载体(如机器人、汽车或无人机)的 AI,通过在真实世界中做事来学习,而不是只靠“阅读”世界。同时,您也会看到与之紧密相关的术语“physical AI(物理智能)”用来描述同一理念。
眼下,这一领域正迎来高光时刻。2026 年 1 月的 CES 上,NVIDIA 的黄仁勋在演讲中称其为“机器人领域的 ChatGPT 时刻”。
资本随后涌入。CNBC援引 Dealroom 数据称,截至 2026 年 6 月初,机器人公司共融资 558 亿美元,几乎是以往年度纪录的两倍。
本文将涵盖:
即便您从未接触过机器人也不必担心。熟悉一些机器学习会有帮助,但我会从零开始搭建每个概念,便于您顺畅跟进。
具身智能是嵌入物理载体(如机器人、自动驾驶车辆或无人机)中的人工智能系统,它通过传感器对环境进行感知,对接下来要做什么进行推理,并通过电机对世界施加动作,从自身行动的结果中学习。
这里的关键词是“具身”(embodied)。
大多数 AI 模型通过观察他人采集的数据来学习。具身系统则通过与环境交互来学习,比如推一下杯子、看它如何滑动,并据此更新对“杯子被推动时会如何表现”的认知。
举个例子。一个在数百万张门的照片上训练的视觉模型知道门长什么样;而一个实际尝试过打开 500 扇门的机器人则知道,有的门要推、有的要拉、有的很重、有的需要您先按下门把手。
这种认知深度,单靠一张照片得不到。
我喜欢这样表达:大多数 AI 通过“阅读”了解世界;具身智能通过“触摸与体验”了解世界。
这一个差异会改变所需数据、训练方式,以及可能出错的地方。
到目前为止,我一直把具身智能与聊天机器人作比较。现在我们将它与人们最常混淆的两者对比:大型语言模型(LLM)与传统的基于规则的机器人学。
| 具身智能 | 大型语言模型(LLM) | 传统基于规则的机器人学 | |
|---|---|---|---|
| 从环境中学习 | 是,通过交互与反馈 | 大多否,主要从固定文本语料学习 | 否,行为由人工编程 |
| 执行物理动作 | 是 | 否 | 是 |
| 在互联网数据上训练 | 部分(其视觉与语言骨干) | 是,规模达数万亿 token | 否 |
| 向新环境泛化 | 中等,且快速提升中 | 好(在语言任务内) | 差,一旦设置变化就失效 |
| 2026 年的商业成熟度 | 早期量产(仓库、工厂试点) | 成熟且广泛部署 | 成熟,工厂应用数十年 |
我想强调的是最后两行。
基于规则的工业机械臂焊接汽车已数十年,极其可靠,但前提是其工作单元内的一切从不改变。具身智能则试图在允许世界保持“凌乱”的同时维持这种可靠性,研究者把这称为“泛化”。
LLM 与具身智能都依赖海量数据学习,但它们解决的问题截然不同。一个LLM读入文本并预测下一个 token;而一个具身系统读入相机画面、关节角度与触觉读数,并预测下一步该如何运动。
简言之,LLM 是“知道”物理世界,而具身智能是在其中“行动”。回到我们的苹果:LLM 能精确描述如何拿起它,而具身智能机器人能真正把它拿起来。
犯错的代价也完全不同。LLM 出错,最多是一句有点奇怪的话;具身系统出错,一个玻璃杯可能就掉到地上,甚至更糟。
而很多人忽略的一点是:二者可以协同。
在视觉—语言—行动(VLA)模型中,预训练的视觉—语言模型是系统的核心。它读取相机图像与您的指令(“把水果放进碗里”),再将其理解传给动作解码器,生成真正的电机控制命令。
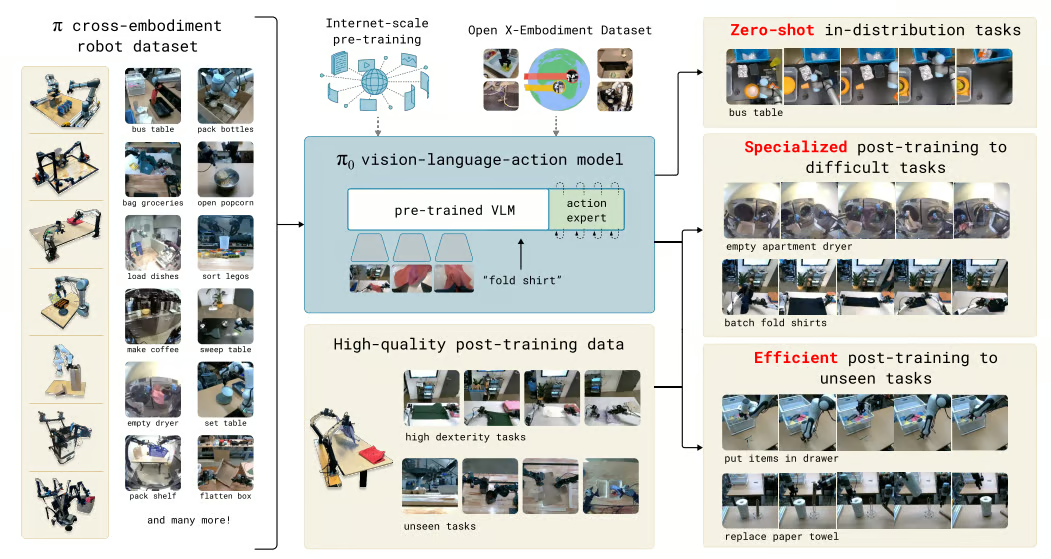
在 π₀(pi-zero)中,预训练视觉—语言模型如何连接到机器人动作。图片来源:Black 等,2024
物理智能之所以更难,主要因为数据。
语言模型之所以快速进步,得益于数十年来人们在线分享的文本、代码与图像;但在真实世界的传感器数据上并无可比拟的来源。几乎没有大量来自机器人与日常物体交互产生的关节角、受力读数与相机帧序列。
更细致地看,具身系统需要三类难以获得的数据:
我们来上些数字。
前沿 LLM 的训练数据规模达万亿级 token。Open X-Embodiment 是最大的开源机器人数据集之一,汇聚了 21 家机构、22 种机器人类型的数据,总计也就 100 多万条真实轨迹。
Open X-Embodiment 数据集中汇聚的机器人与任务。图片来源:Open X-Embodiment Collaboration,2023
为何如此之少?因为每条轨迹都需要一台真实机器人执行真实任务,通常由人类远程操控,这既慢又贵。
这也是物理智能泛化更慢于数字智能的原因。模型在见过相似样本时最能处理变化;而一百万条轨迹覆盖的厨房、光照与物体形状远少于数万亿 token 覆盖的句子种类。
在阅读下文时,我建议您始终记住这个数据难题。您将看到的许多设计决策——从仿真、领域随机化,到借用预训练的视觉—语言骨干——都是围绕它的权衡。
具身智能通过一个持续循环的三阶段流程运行:
这一闭环以每秒多次的频率反复执行;每次移动都会改变下一步的感知输入,因此上一轮的输出会成为下一轮的输入。
同样的闭环也支撑着世界模型。Ha 与 Schmidhuber 在2018 年《World Models》论文中将智能体划分为视觉模块、记忆模块与控制器,并在一款赛车游戏中测试。具身智能将同一理念应用于完整机器人。
理解这一闭环的好方式是想象接球:
机器人也一样,只是用相机代替眼睛、用电机代替肌肉。
我们逐一展开。
感知阶段将原始传感器读数转化为系统其余部分可用于推理的表征。单个相机通常不够,因此大多数机器人会组合多种传感器:
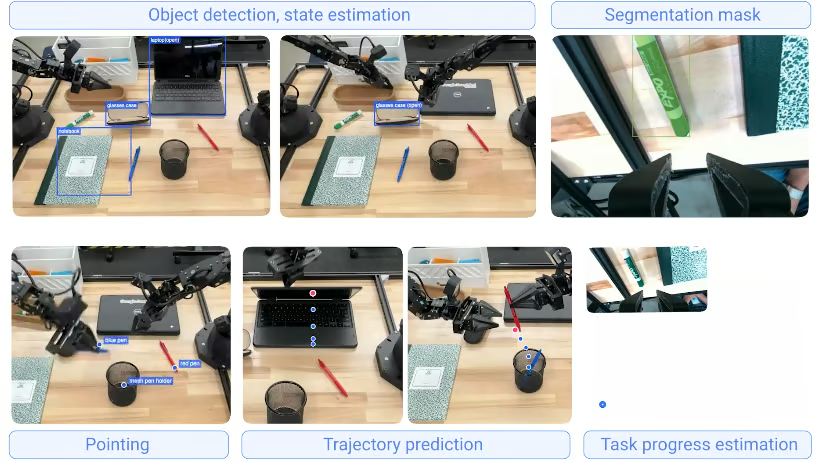
Gemini Robotics-ER 1.5 的部分感知输出示例。图片来源:Google DeepMind
随后,感知模型将这些读数转化为空间地图、物体身份、障碍位置与对场景的整体理解。
其中大多数属于标准的计算机视觉任务,如目标检测、分割与深度估计,通常构建在 DINOv2、SigLIP 等预训练视觉 Transformer之上。
不过在我看来,触觉是当前最被低估的感知要素。相机能告诉您桌上有个玻璃杯,但触觉能告诉您玻璃杯正开始从手中打滑。
为给您一个直观印象,XELA Robotics 在 Automate 2026 上展示了一款机器人指尖,在指腹上密集布置了30 个三轴受力感知点。该公司还称其 uSkin 传感器可检测小至 0.1 gf(克力)的力。
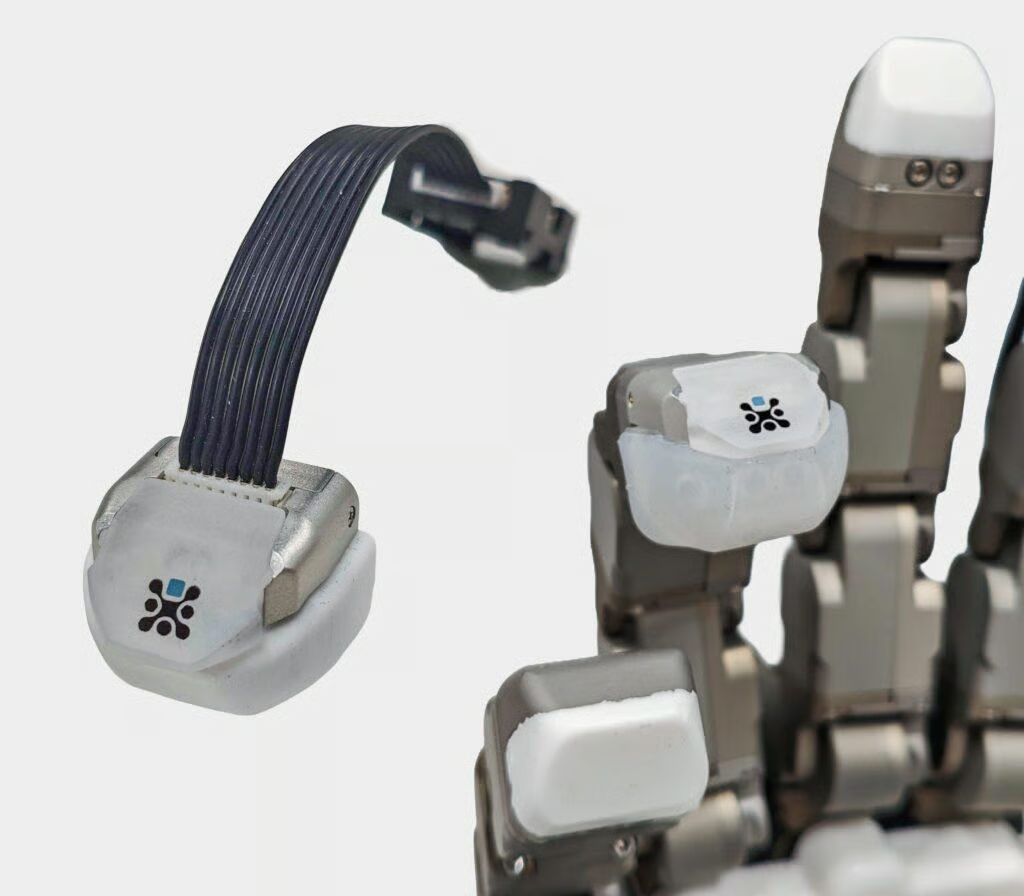
一枚包含三轴触觉感知点阵列的 uSkin 机器人指尖。图片来源:XELA Robotics
推理阶段用于决定下一步的动作。在较新的系统中,它通常包含两层:
世界模型让机器人在行动前能够“想象”。
DreamerV3 是很好的例子。它学习环境的紧凑模型,然后几乎完全在这个“想象世界”中训练其策略。
我在自己的研究中使用 DreamerV3,最让我惊讶的是智能体在“头脑中”练习的时间远多于在真实环境中训练。这很关键,因为训练因此更快且更便宜。
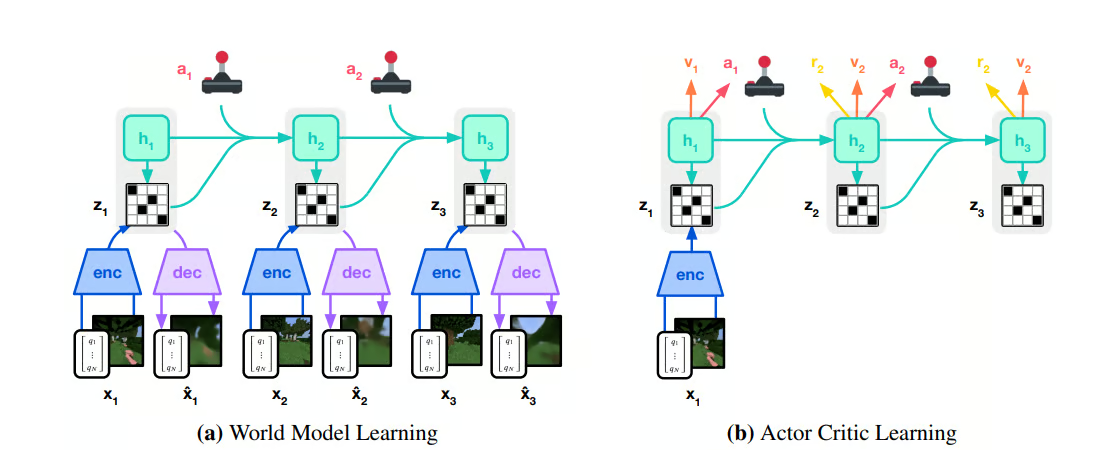
DreamerV3 在其世界模型“想象”的 rollout 上训练策略。图片来源:Hafner 等,2023
另一方面,规划越来越多地由语言模型承担。
Google DeepMind 的 Gemini Robotics-ER 1.5 就是一个很好的例子,它充当高层规划器。面对诸如按本地回收规则分类垃圾的任务,它可以通过 Google 搜索查找规则,将任务拆解为步骤,并将每个步骤交给负责物理执行的 Gemini Robotics 1.5 VLA 模型。
您可以把语言模型看作“经理”,而 VLA 模型是实际干活的“工人”。
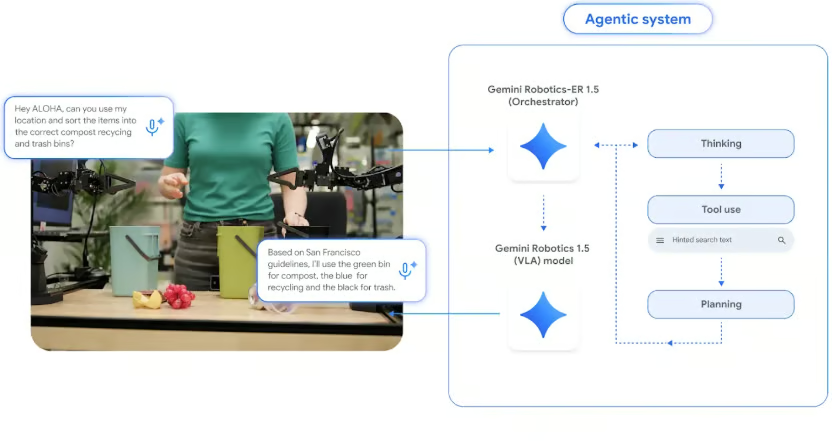
Gemini Robotics-ER 1.5 负责规划任务,并将物理执行委托给 Gemini Robotics 1.5 VLA。图片来源:Google DeepMind,2025
行动阶段将决策转换为对每个关节和电机的精确指令,通常以每秒几十到上百次的频率执行(以赫兹 Hz 计)。这一阶段的低层部分称为控制。
例如,“把夹爪向左移动 5 厘米”听起来很简单,但在一条 7 关节机械臂上,它必须转化为每个关节电机的具体力矩,并在手臂移动过程中持续重新计算。
难点在于,现实很少与机器人预期完全一致。物体会打滑、地面可能略不平、有人拉开百叶窗光照就变了、线缆的弯曲也可能与预测不同。
一个优秀的控制器会察觉预期与实际的偏差,并立刻修正。
在我看来,在混乱、非结构化的环境中,行动是最难做到正确的一环。感知错误可以通过再看一眼修复,规划错误可以重新规划,但控制错误发生在实时。
具身智能的训练结合了仿真与真实世界数据。仿真指在物理精确的 3D 虚拟环境中,让机器人在不接触真实硬件的情况下练习数百万次。
还记得前面的数据问题吗?仿真是解决它的主要手段之一,尤其是在行走与操作的强化学习中。像 π₀ 这样的基础模型仍高度依赖真实示教,因此大多数团队二者并用。
在真实世界采集数据有三大难题:
一个模拟器可以同时解决这三点。您可以在单张 GPU 上并行运行成千上万个虚拟机器人,让它们随时失败、重启。这样能把原本需要数年的机器人经验压缩到数小时。
并非所有模拟器都同样适用于机器人训练。以我自己在仿真中使用机械臂的经验来看,一个好的模拟器需要三点:
您最常遇到的两个平台是 NVIDIA Isaac Sim(配合 Isaac Lab)与 MuJoCo:
| 平台 | 开发者 | 擅长 | 最佳用途 |
|---|---|---|---|
| NVIDIA Isaac Sim 与 Isaac Lab | NVIDIA | 照片级渲染、传感器仿真、在 GPU 上并行运行上千环境 | 大规模强化学习与合成相机数据 |
| MuJoCo | Google DeepMind(开源) | 快速、精确的接触物理,轻量,研究社区庞大 | 研究、行走与操作基准 |
最新加入的是Newton,一款由 NVIDIA、Google DeepMind 与 Disney Research 构建、由 Linux 基金会管理的开源 GPU 加速物理引擎。
Newton 1.0 于2026 年 3 月的 NVIDIA GTC发布。它作为 Isaac Lab 的物理后端接入,采用 MuJoCo Warp 作为求解器之一,并增加了适用于电缆、布料等可形变物体的额外求解器。
可形变体的重要性超乎想象。早期模拟器对电缆与织物的处理很差,而工厂需要能处理二者的机器人。
仿真到现实差距(sim-to-real gap)指在仿真中训练的策略迁移到真实机器人上时性能下滑,这是具身系统最大的难题之一。
比如,仿真的摩擦总不够准确、仿真相机过于“干净”、仿真物体过于理想,因此一个在仿真中成功率 95% 的策略,一旦遇到真实硬件就可能崩溃。
团队通常用两种主要方法来缩小差距:
与其把模拟器打磨到尽善尽美,不如在各种维度上对其进行随机化。
Tobin 等(2017)对纹理与光照做了极度随机化,让真实世界在模型眼里看起来只是另一种变体。OpenAI 的魔方机器人手更进一步,随着策略变强自动扩大随机化范围。
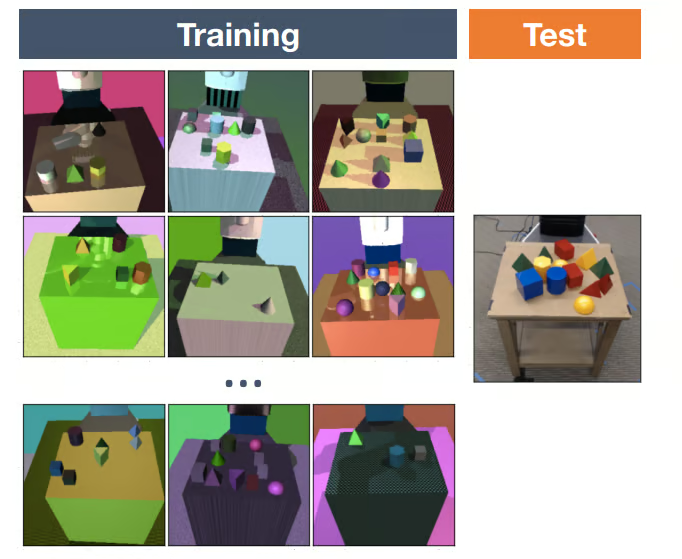
在仿真中预训练过的策略,往往只需一小批真实示教即可适配,因为它已学到任务的大致“形状”。
两种技术都无法彻底消除差距,因此团队会持续努力,降低其对真实世界表现的影响。
具身智能已在若干行业走出实验室,但发展极不均衡。
我观察到的规律是:它会优先落地在那些环境变化过大、无法手工脚本化的场景,但又能在出错时由人类接手干预。
自动驾驶汽车是最“吃数据”的具身智能之一。
Waymo Driver 已完成近 2 亿英里的全自动驾驶旅程,且据 Waymo 2026 年 2 月关于其 World Model 的文章介绍,还在仿真中训练与测试了数十亿英里。仿真让 Waymo 能重放真实事件,并生成测试车队在现实道路上几乎不会遇到的罕见场景(例如小孩从两辆停靠车之间突然跑出)。
自动驾驶也很好地展示了感知—推理—行动闭环的满速运行。Waymo 车辆通过相机、激光雷达与雷达进行感知,对每个行人和车辆的下一步动作进行推理,并以每秒多次频率控制方向与制动。
在我看来,仓库是当前具身智能最自然的商业应用。
行业正从沿地面线路行驶的固定路径机器人,转向能处理动态、杂乱库存的系统,比如从一个装有 40 种不同产品的料箱中抓取。
Agility Robotics 的人形机器人 Digit 已在 GXO Logistics 开始搬运料箱,双方于 2024 年签订了多年协议;Boston Dynamics 的 Stretch 则负责从货车上卸箱。
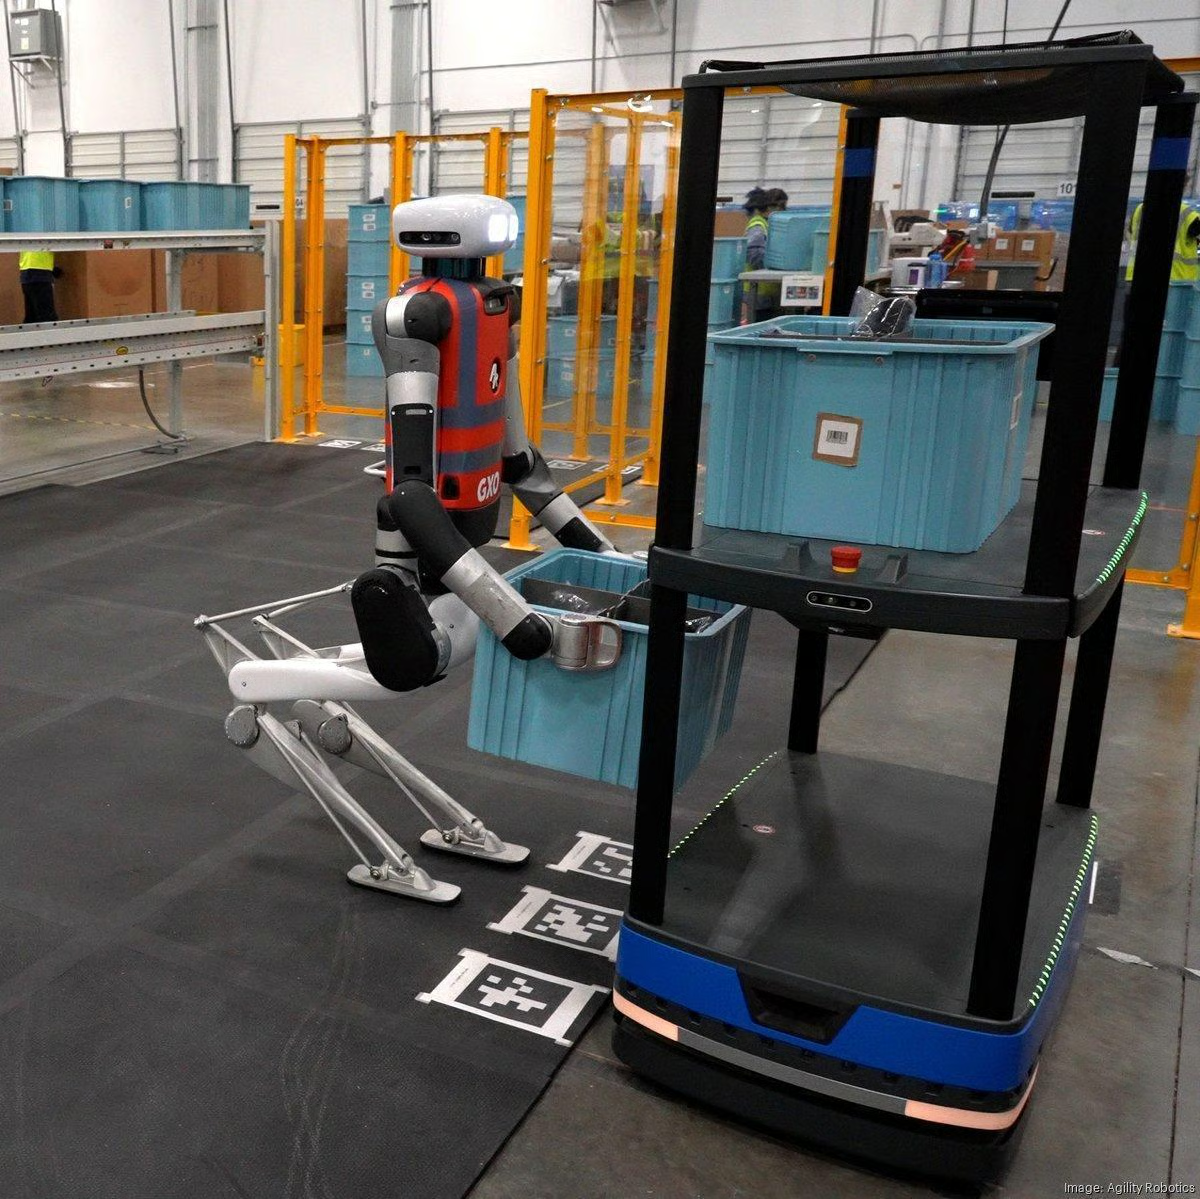
Agility Robotics 的 Digit 在 GXO 仓库中,将料箱在自主移动机器人与传送带之间搬运。图片来源:Agility Robotics/The Robot Report
在医疗领域,我预计具身智能会最为谨慎地推进。
如 Intuitive 的达芬奇手术系统已在全球医院使用,但由外科医生操控。该领域的大多数 AI 研究集中在辅助功能上,如器械跟踪、相机控制与缝合支持。
在医疗领域,监管批准往往比模型能力更大的约束——理所当然。我个人预计各类辅助与培训用途会远早于接近自主手术的应用落地。
人形机器人最受关注,但也是最缺乏验证的类别之一。
在 2026 年 CES 上,Boston Dynamics 发布了Atlas 的量产版,并表示 2026 年产出的每一台都已内定给现代与 Google DeepMind。另一方面,Figure 在宝马南卡斯罗特堡工厂对其 Figure 02 人形机器人进行了为期 11 个月的部署,负责装载钣金。
但我想坦诚的是:大多数人形机器人的部署仍是执行一小撮任务的试点。比如现代计划在 2028 年开始用 Atlas 做部件分拣,这也说明哪怕是最坚定的支持者也在谨慎推进。
接下来看看究竟是谁在打造这些系统。以下五家机构,我认为是所有具身智能新手都应认识的:
| 机构 | 他们的产品 | 重要性 |
|---|---|---|
| NVIDIA | Isaac Sim、Isaac Lab、Newton、GR00T 与 Cosmos | 大多数团队用于训练的仿真与算力栈 |
| Physical Intelligence | π₀ 系列机器人基础模型 | 通用机器人策略,提供开放模型检查点 |
| Agility Robotics | Digit 人形机器人 | 面向仓储物流而建,已与客户合作 |
| Boston Dynamics | Atlas、Stretch、Spot | 2026 年将 Atlas 从研究演示转向量产 |
| AMI Labs(Yann LeCun) | JEPA 风格世界模型 | 押注不生成像素的世界模型的逆向思路 |
NVIDIA 更多是在构建围绕机器人的工具,而非机器人本体。
Isaac Sim 负责照片级仿真,Isaac Lab 在其之上处理强化学习,Newton 则可提供物理引擎。许多机器人团队都在使用 NVIDIA 的软件进行训练,尽管 NVIDIA 并不销售通用型机器人。
Physical Intelligence 构建了 π₀,一款 33 亿参数的视觉—语言—行动模型,使用流匹配(flow matching)生成平滑的动作片段,用于如叠衣服等任务。
在我所知的通用机器人模型中,它是您实际可以下载使用的最佳范例,代码在 openpi 仓库。
如果“基础模型”这个概念对您来说较新,我们的基础模型入门指南讲解得很清楚。
Agility Robotics 用 Digit 走的是聚焦路线。
它从第一天起就围绕仓库内的料箱搬运而设计,正是这种聚焦让它比多数人形机器人更早获得付费客户。
Boston Dynamics 则在 Atlas 上走了相反路线。
它先花多年把机器人的“运动能力上限”推到极致(您大概看过跑酷视频),然后再将其打磨为全电动的工厂产品,Google DeepMind 计划用其 Gemini Robotics 模型为之提供智能。
AMI Labs 是 Yann LeCun 在巴黎创立的初创公司,2026 年 3 月完成 10.3 亿美元种子轮融资,投前估值 35 亿美元。本轮由 Cathay Innovation、Greycroft、Hiro Capital、HV Capital 与 Bezos Expeditions 共同领投,NVIDIA 与三星等参与投资。
LeCun 多年来一直主张:逐像素预测未来是低效的,因此其联合嵌入预测架构(JEPA)转而在抽象表征空间中进行预测。Meta 已用 V-JEPA 2 测试过这一思路。
AMI 值得关注之处在于,它走在与大多数领域趋势相反的道路上。不过其尚未发布产品,因此我会将其视为一项资金雄厚但尚待验证的研究型押注。
具身智能不仅仅是机器人工程问题。我认为,其中很大一部分、甚至大多数,属于机器学习工作。
最直接可迁移的技能包括:
您不需要机器人就能上手。gymnasium 库自带 MuJoCo 环境,因此在运行 pip install "gymnasium[mujoco]" 之后,您就可以在仿真机器人上跑完整个闭环:
import gymnasium as gym

# HalfCheetah is a 2D cheetah-like robot simulated with the MuJoCo physics engine
env = gym.make("HalfCheetah-v5")
observation, info = env.reset(seed=42)

for step in range(1000):
    # Perception: the observation holds joint angles and velocities
    # Reasoning: a trained policy would choose the action here, we pick randomly
    action = env.action_space.sample()

    # Action: apply torques to the joints and move the physics forward one step
    observation, reward, terminated, truncated, info = env.step(action)

    if terminated or truncated:
        observation, info = env.reset()

env.close()
现在,猎豹只是胡乱挥舞,因为“推理”步骤是 env.action_space.sample(),每次随机选择动作。
把这一行替换为训练好的策略,正是强化学习要做的事。我建议您在上手更复杂内容之前先试一试。
具身智能进展很快,但仍在四个方面存在困难,我认为值得了解:
具身智能赋予机器以物理之身与运用它的智能。它通过感知—推理—行动闭环运作,主要受限于物理数据的稀缺;到 2026 年,它正从研究实验室走向仓库与首批工厂试点。
真正令我惊讶的是问题的转变。几年前,人们问 LLM 是否会让机器人研究变得无关紧要;而如今,LLM 正成为具身系统内的推理层,两个领域彼此融合。
还记得文章开头的那个苹果吗?“知道如何拿起它”和“真正把它拿起来”原来是两件截然不同的事,而具身智能正是致力于解决后者的领域。
如果您想为此打好机器学习基础,可以从我们的Python 强化学习学习路径开始。对于技术栈中的语言部分,我们的大型语言模型(LLM)概念课程与大型语言模型开发学习路径是不错的下一步。
DataCamp 热门课程
课程
课程
学习路径