คอร์ส
Deep Reinforcement Learning ด้วย Python
4 ชม.
6K
ลองนึกภาพว่าคุณขอให้เพื่อนส่งแอปเปิลจากชามผลไม้ให้ พวกเขามองไปที่ชาม แยกแยะว่าอันไหนคือแอปเปิล แล้วหยิบขึ้นมาอย่างนุ่มนวลพอที่จะไม่บี้ก่อนจะส่งให้คุณ
ทีนี้ลองขอให้แชทบอททำแบบเดียวกัน มันจะบอกได้อย่างละเอียดว่าจะหยิบแอปเปิลอย่างไร ใช้นิ้วไหน และควรบีบแรงแค่ไหนคร่าวๆ แต่ไม่สามารถหยิบจริงได้ เพราะมันไม่มีมือและไม่รู้ว่าแอปเปิลให้ความรู้สึกอย่างไร
Embodied AI คือสาขาที่พยายามปิดช่องว่างนี้ พูดง่ายๆ คือ AI ที่มีร่างกายทางกายภาพ (เช่น หุ่นยนต์ รถ หรือโดรน) และเรียนรู้จากการลงมือทำในโลกจริง แทนที่จะเรียนรู้จากการอ่านเพียงอย่างเดียว จะเห็นได้ว่ามีคำที่เกี่ยวข้องใกล้เคียงกันอย่าง “physical AI” ใช้ในความหมายเดียวกัน
ตอนนี้สาขานี้กำลังมาแรงมาก ที่งาน CES เดือนมกราคม 2026 Jensen Huang จาก NVIDIA เรียกมันว่า “ช่วงเวลาแบบ ChatGPT ของหุ่นยนต์”
เงินทุนก็ตามมา ข้อมูลจาก Dealroom ที่รายงานโดย CNBC ระบุว่าบริษัทหุ่นยนต์ระดมทุนได้ 55.8 พันล้านดอลลาร์ ภายในต้นเดือนมิถุนายน 2026 เกือบเท่าตัวของสถิติรายปีก่อนหน้า
ในบทความนี้ จะครอบคลุม:
ไม่ต้องกังวลหากไม่เคยทำงานกับหุ่นยนต์มาก่อน ความคุ้นเคยกับการเรียนรู้ของเครื่องจะช่วยได้ แต่จะปูพื้นทุกแนวคิดตั้งแต่ต้นเพื่อให้ตามทันไม่ว่าจะมีพื้นฐานหรือไม่
Embodied AI คือระบบปัญญาประดิษฐ์ที่ฝังอยู่ในร่างกายทางกายภาพ เช่น หุ่นยนต์ รถยนต์อัตโนมัติ หรือโดรน ที่รับรู้สภาพแวดล้อมผ่านเซนเซอร์ ให้เหตุผลว่าจะทำอะไร และลงมือทำกับโลกผ่านมอเตอร์ โดยเรียนรู้จากผลลัพธ์ของการกระทำของตนเอง
คำสำคัญที่นี่คือคำว่า embodied
โมเดล AI ส่วนใหญ่เรียนรู้โดยสังเกตข้อมูลที่ผู้อื่นเก็บมาให้ ระบบแบบ embodied เรียนรู้โดยปฏิสัมพันธ์กับสภาพแวดล้อม เช่น ดันถ้วย ดูถ้วยลื่นไถล แล้วอัปเดตความรู้เกี่ยวกับพฤติกรรมของถ้วยเมื่อตั้งใจดัน
ตัวอย่างเช่น โมเดลวิชันที่ฝึกจากรูปประตูเป็นล้านภาพรู้ว่าประตูหน้าตาอย่างไร แต่หุ่นยนต์ที่เคยลองเปิดประตู 500 บานจริงๆ จะรู้ว่าบางบานต้องผลัก บางบานต้องดึง บางบานหนัก และบางบานมีมือจับที่ต้องกดลงก่อน
ความลึกของความรู้แบบนี้หาไม่ได้จากรูปภาพ
ชอบอธิบายแบบนี้: AI ส่วนใหญ่เรียนรู้เรื่องโลกด้วยการอ่านเกี่ยวกับมัน ส่วน Embodied AI เรียนรู้เรื่องโลกด้วยการสัมผัสและประสบกับมัน
ความต่างเพียงข้อนี้เปลี่ยนทั้งข้อมูลที่ต้องใช้ วิธีการฝึก และวิธีที่สิ่งต่างๆ อาจผิดพลาด
ที่ผ่านมาได้เปรียบเทียบ Embodied AI กับแชทบอท ทีนี้มาเปรียบเทียบกับสองสิ่งที่คนมักสับสนด้วยมากที่สุด: โมเดลภาษาขนาดใหญ่ (LLM) และหุ่นยนต์แบบกฎเกณฑ์ดั้งเดิม
| Embodied AI | โมเดลภาษาขนาดใหญ่ (LLM) | หุ่นยนต์แบบกฎเกณฑ์ดั้งเดิม | |
|---|---|---|---|
| เรียนรู้จากสภาพแวดล้อม | ใช่ ผ่านปฏิสัมพันธ์และฟีดแบ็ก | ส่วนใหญ่ไม่ เรียนจากคลังข้อความคงที่ | ไม่ พฤติกรรมถูกโปรแกรมด้วยมือ |
| กระทำทางกายภาพได้ | ใช่ | ไม่ | ใช่ |
| ฝึกบนข้อมูลจากอินเทอร์เน็ต | บางส่วน (แบ็กโบนวิชันและภาษา) | ใช่ ระดับล้านล้านโทเคน | ไม่ |
| เหมารวมไปยังสภาพแวดล้อมใหม่ | ปานกลาง และดีขึ้นอย่างรวดเร็ว | ดี ภายในงานด้านภาษา | แย่ พังเมื่อการตั้งค่าเปลี่ยน |
| ความพร้อมเชิงพาณิชย์ในปี 2026 | เริ่มผลิตจริง (คลังสินค้า โครงการนำร่องในโรงงาน) | แก่จัดและใช้งานอย่างแพร่หลาย | แก่จัด ใช้งานในโรงงานมาหลายทศวรรษ |
สองแถวสุดท้ายคือสิ่งที่อยากเน้น
แขนกลอุตสาหกรรมแบบกฎเกณฑ์เชื่อมรถยนต์มาหลายสิบปี และเชื่อถือได้สูง แต่ก็เพราะไม่มีอะไรในเซลล์งานของมันเปลี่ยนเลย Embodied AI พยายามคงความเชื่อถือได้นั้นไว้ พร้อมเปิดให้โลกจริงเลอะเทอะได้ ซึ่งนักวิจัยเรียกสิ่งนี้ว่าความสามารถในการเหมารวม
LLM และ Embodied AI ต่างก็เรียนรู้จากข้อมูลจำนวนมหาศาล แต่แก้ปัญหาคนละแบบโดยสิ้นเชิง LLM รับข้อความเข้าและทำนายโทเคนถัดไป ขณะที่ระบบ embodied รับภาพจากกล้อง มุมข้อต่อ และการรับสัมผัส แล้วทำนายการเคลื่อนไหวถัดไป
สรุปคือ LLM รู้เกี่ยวกับโลกกายภาพ ขณะที่ Embodied AI ลงมือทำในโลกนั้น กลับมาที่แอปเปิล: LLM อธิบายได้อย่างละเอียดว่าจะหยิบอย่างไร และหุ่นยนต์ Embodied AI ทำได้จริง
ต้นทุนของความผิดพลาดก็แตกต่างกันมาก หาก LLM ผิด คุณจะได้ประโยคแปลกๆ เล็กน้อย หากระบบ embodied ผิด แก้วอาจตกพื้น หรืออาจแย่กว่านั้น
และนี่คือส่วนที่หลายคนมักมองข้าม: ทั้งสองทำงานร่วมกัน
ในโมเดลวิชัน-ภาษา-การกระทำ (VLA) โมเดลวิชัน-ภาษาที่พรีเทรนทำหน้าที่แกนกลางของระบบ มันอ่านภาพจากกล้องและคำสั่งของคุณ (“วางผลไม้ลงในชาม”) แล้วถ่ายทอดความเข้าใจให้ดีโค้ดเดอร์การกระทำที่สร้างคำสั่งมอเตอร์จริง
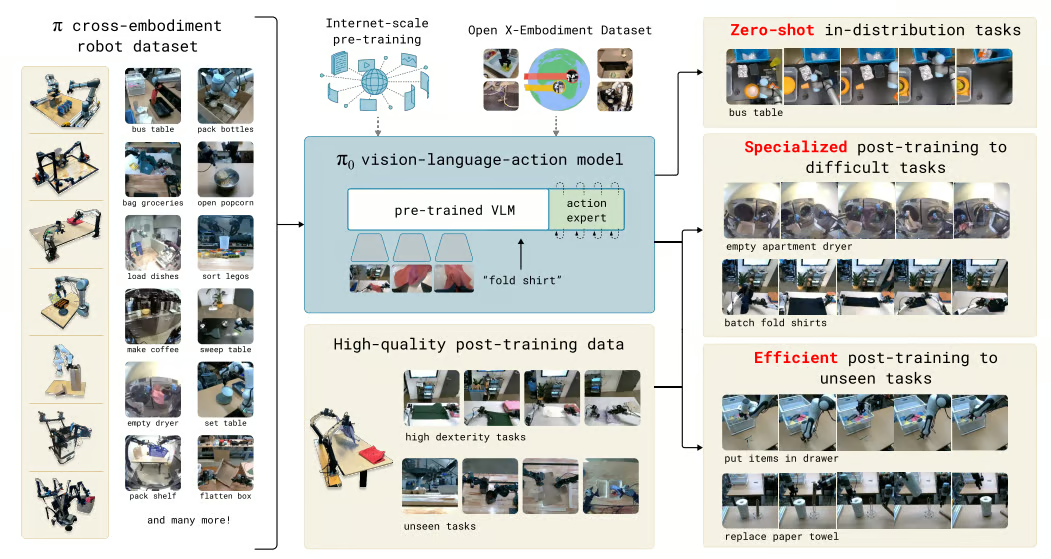
โมเดลวิชัน-ภาษาที่พรีเทรนเชื่อมไปยังการกระทำของหุ่นยนต์ใน π₀ (pi-zero) ที่มา: Black et al., 2024
Physical AI ยากกว่า Digital AI หลักๆ เพราะเรื่องข้อมูล
โมเดลภาษาเดินหน้ารวดเร็วจากการที่ผู้คนแชร์ข้อความ โค้ด และภาพออนไลน์มาหลายสิบปี แต่ไม่มีแหล่งข้อมูลเซนเซอร์โลกจริงที่เทียบได้ แทบไม่มีสตรีมมุมข้อต่อ แรงสัมผัส และเฟรมจากกล้องของหุ่นยนต์ที่ปฏิสัมพันธ์กับวัตถุในชีวิตประจำวัน
มาดูข้อกำหนดด้านข้อมูลละเอียดขึ้น ระบบ embodied ต้องการข้อมูล 3 ประเภทที่หาได้ยาก:
มาลองใส่ตัวเลขกัน
LLM ระดับแนวหน้าได้รับการฝึกจากโทเคนระดับล้านล้าน Open X-Embodiment ซึ่งเป็นหนึ่งในชุดข้อมูลหุ่นยนต์แบบเปิดที่ใหญ่ที่สุด รวบรวมข้อมูลจากหุ่นยนต์ 22 แบบใน 21 สถาบัน ได้เพียงกว่า 1 ล้าน trajectory จริง
หุ่นยนต์และงานที่ถูกรวมในชุดข้อมูล Open X-Embodiment ที่มา: Open X-Embodiment Collaboration, 2023
ทำไมน้อย? เพราะทุก trajectory ต้องใช้หุ่นยนต์จริงทำงานจริง โดยมักถูกควบคุมโดยมนุษย์ผ่านเทเลโอเปอเรชัน ซึ่งช้าและมีค่าใช้จ่ายสูง
ช่องว่างนี้ยังเป็นเหตุผลว่าทำไม Physical AI จึงเหมารวมได้ช้ากว่า Digital AI โมเดลจะรับมือกับความแปรผันได้ดีที่สุดเมื่อเคยเห็นสิ่งที่คล้ายกันมาก่อน และหนึ่งล้าน trajectory ครอบคลุมห้องครัว การจัดแสง และรูปทรงวัตถุน้อยกว่าที่ล้านล้านโทเคนครอบคลุมประโยคมากนัก
ขอให้เก็บปัญหาข้อมูลนี้ไว้ในใจตลอดบทความ การออกแบบหลายอย่างที่เห็นต่อไป ตั้งแต่ซิมูเลชัน การสุ่มโดเมน ไปจนถึงการยืมแบ็กโบนวิชัน-ภาษาที่พรีเทรน ล้วนเป็นหนทางเลี่ยงปัญหานี้
Embodied AI ทำงานด้วยการวนลูปอย่างต่อเนื่อง 3 ขั้นตอน:
ลูปนี้เกิดซ้ำหลายครั้งต่อวินาที และการเคลื่อนไหวทุกครั้งเปลี่ยนสิ่งที่หุ่นยนต์รับรู้ในเฟรมถัดไป ดังนั้นเอาต์พุตของหนึ่งรอบจึงกลายเป็นอินพุตของรอบถัดไป
ลูปเดียวกันนี้อยู่เบื้องหลังเวิลด์โมเดล Ha และ Schmidhuber ในบทความ “World Models” ปี 2018 แบ่งเอเจนต์ออกเป็นโมดูลวิชัน โมดูลหน่วยความจำ และคอนโทรลเลอร์ แล้วทดสอบกับรถในเกมแข่งรถ Embodied AI นำแนวคิดเดียวกันมาใช้กับหุ่นยนต์เต็มตัว
วิธีเข้าใจลูปที่ดีคือลองจินตนาการถึงการรับลูกบอล:
หุ่นยนต์ก็ทำแบบเดียวกัน เพียงแต่ใช้กล้องแทนตา และมอเตอร์แทนกล้ามเนื้อ
ลองดูแต่ละขั้นตอนกัน
การรับรู้คือตอนที่แปลงสัญญาณดิบจากเซนเซอร์ให้เป็นสิ่งที่ส่วนอื่นของระบบใช้ให้เหตุผลได้ กล้องตัวเดียวมักไม่พอ ดังนั้นหุ่นยนต์ส่วนใหญ่จึงรวมหลายเซนเซอร์เข้าด้วยกัน:
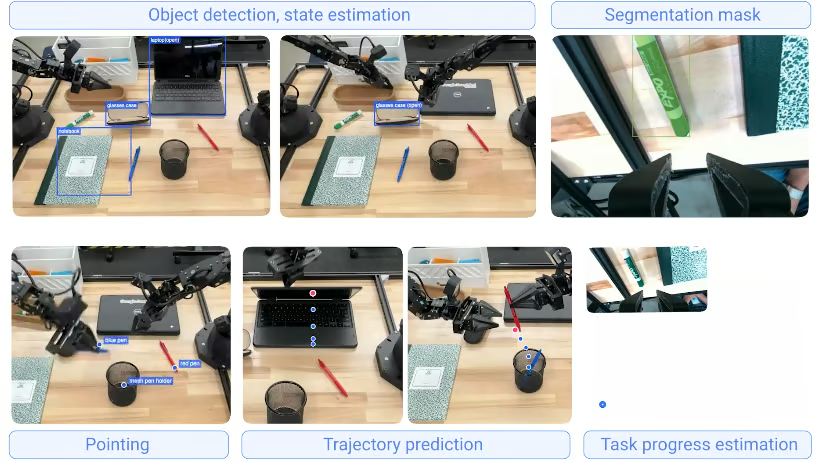
ตัวอย่างเอาต์พุตการรับรู้จาก Gemini Robotics-ER 1.5 ที่มา: Google DeepMind
โมเดลการรับรู้จะแปลงสัญญาณเหล่านี้เป็นแผนที่เชิงพื้นที่ อัตลักษณ์ของวัตถุ ตำแหน่งสิ่งกีดขวาง และความเข้าใจฉากโดยรวม
ส่วนใหญ่เป็นงานมาตรฐานของคอมพิวเตอร์วิทัศน์ เช่น การตรวจจับวัตถุ การแบ่งส่วนภาพ และการประมาณความลึก โดยมักสร้างบนวิชันทรานส์ฟอร์เมอร์ที่พรีเทรนอย่าง DINOv2 หรือ SigLIP
อย่างไรก็ตาม การสัมผัสเป็นส่วนที่ถูกมองข้ามมากที่สุดของการรับรู้ในตอนนี้ กล้องบอกได้ว่ามีแก้วอยู่บนโต๊ะ แต่การสัมผัสบอกได้ว่าแก้วเริ่มลื่นออกจากมือ
เพื่อให้เห็นภาพว่าไปถึงไหนแล้ว XELA Robotics สาธิตปลายนิ้วหุ่นยนต์ที่งาน Automate 2026 โดยมีจุดรับแรงแบบสามแกน 30 จุด อัดแน่นในแผ่นนิ้ว บริษัทยังระบุว่าเซนเซอร์ uSkin สามารถตรวจจับแรงเล็กสุดได้ 0.1 กรัมแรง
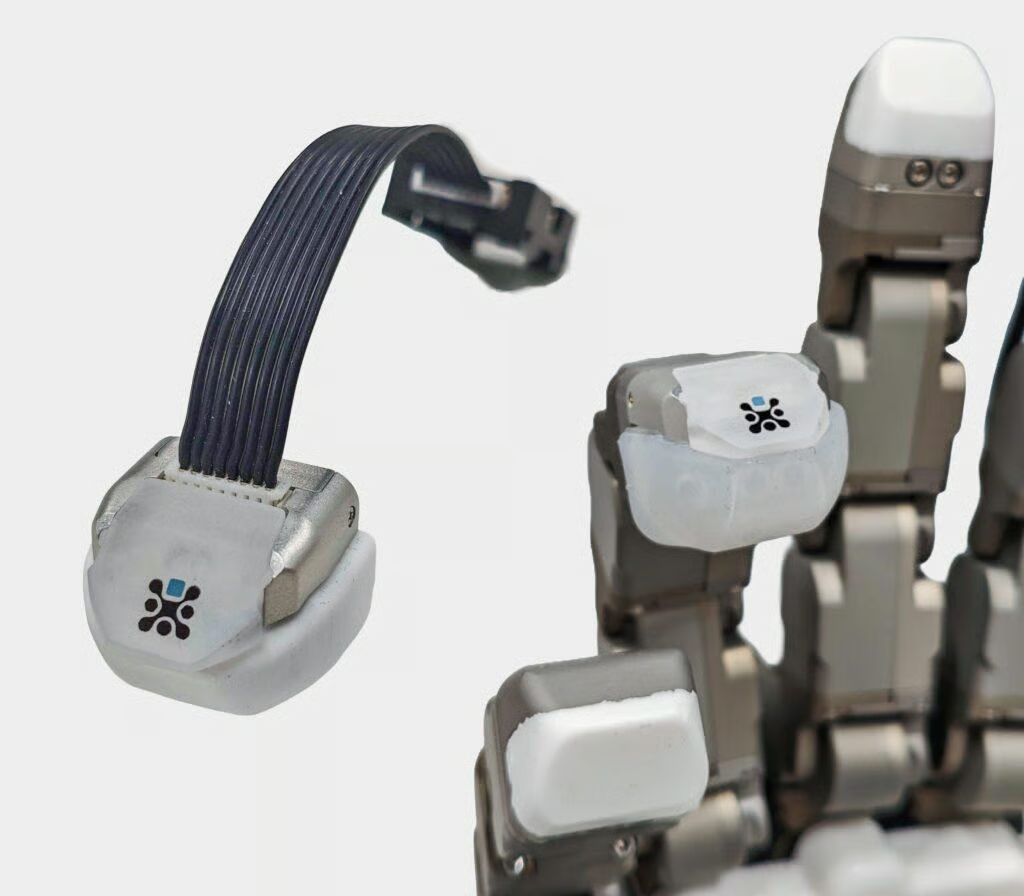
ปลายนิ้วหุ่นยนต์ uSkin ที่มีอาร์เรย์จุดรับสัมผัสสามแกน ที่มา: XELA Robotics
การให้เหตุผลคือขั้นตอนที่ตัดสินใจว่าจะทำอะไรต่อไป ในระบบใหม่ๆ มักมี 2 ชั้น:
เวิลด์โมเดลทำให้หุ่นยนต์ “จินตนาการ” ก่อนลงมือได้
DreamerV3 เป็นตัวอย่างที่ดี มันเรียนรู้โมเดลกระชับของสภาพแวดล้อม แล้วฝึกนโยบายเกือบทั้งหมดภายในโลกที่จินตนาการนั้น
ใช้งาน DreamerV3 ในงานวิจัยของตัวเอง สิ่งที่ประหลาดใจที่สุดคือเอเจนต์ใช้เวลา “ฝึกในหัว” มากกว่าฝึกในสภาพแวดล้อมจริงมาก นั่นสำคัญเพราะทำให้การฝึกเร็วขึ้นและถูกลงมาก
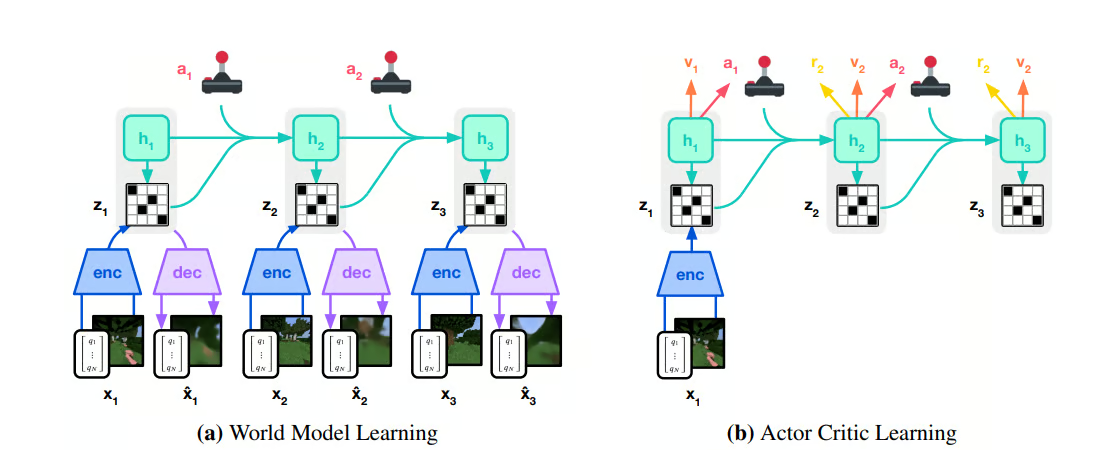
DreamerV3 ฝึกนโยบายบนโรลเอาต์จินตนาการจากเวิลด์โมเดลของตน ที่มา: Hafner et al., 2023
ด้านการวางแผน ปัจจุบันถูกขับเคลื่อนโดยโมเดลภาษามากขึ้นเรื่อยๆ
ตัวอย่างที่ดีคือ Gemini Robotics-ER 1.5 ของ Google DeepMind ซึ่งทำหน้าที่เป็นผู้วางแผนระดับสูง เมื่อได้รับงานอย่างการคัดแยกขยะตามกฎรีไซเคิลท้องถิ่น มันค้นหากฎด้วย Google Search แบ่งงานเป็นขั้น แล้วส่งแต่ละขั้นให้โมเดล VLA Gemini Robotics 1.5 ที่ทำงานกายภาพจริง
นึกถึงโมเดลภาษาเป็นผู้จัดการ และโมเดล VLA เป็นผู้ปฏิบัติงานที่ทำงานจริง
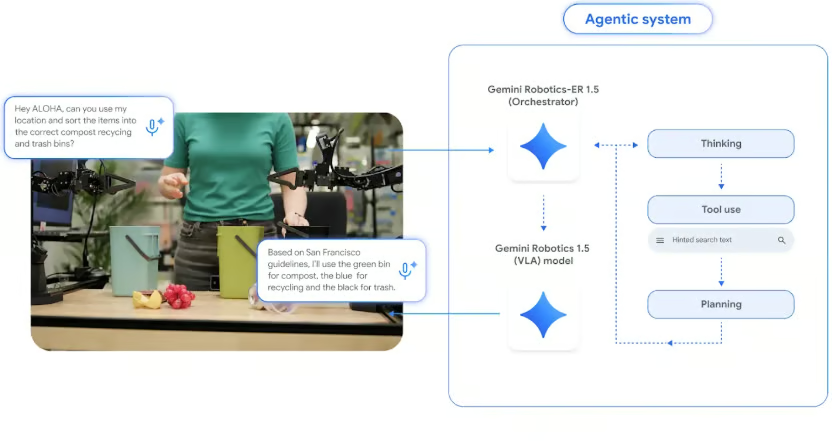
Gemini Robotics-ER 1.5 วางแผนงานและมอบหมายการปฏิบัติให้ Gemini Robotics 1.5 VLA ที่มา: Google DeepMind, 2025
การกระทำคือการแปลงการตัดสินใจเป็นคำสั่งละเอียดสำหรับทุกข้อต่อและมอเตอร์ โดยทั่วไปสิบถึงหลายร้อยครั้งต่อวินาที (หน่วยเป็นเฮิร์ตซ์ หรือ Hz) ส่วนระดับล่างของขั้นนี้เรียกว่าคอนโทรล
ตัวอย่างเช่น คำสั่ง “ขยับกริปเปอร์ไปซ้าย 5 ซม.” ฟังดูง่าย แต่บนแขน 7 ข้อต้อยมันต้องกลายเป็นแรงบิดเฉพาะของมอเตอร์แต่ละข้อ และต้องคำนวณซ้ำอย่างต่อเนื่องขณะเคลื่อน
ส่วนที่ยากคือ ความจริงมักไม่ตรงกับที่หุ่นยนต์คาดไว้ วัตถุลื่น พื้นไม่ราบเล็กน้อย แสงเปลี่ยนเมื่อมีคนเปิดมู่ลี่ สายเคเบิลงอต่างจากที่คาด
คอนโทรลเลอร์ที่ดีจะสังเกตความต่างระหว่างสิ่งที่คาดกับสิ่งที่เกิดขึ้นจริง แล้วแก้ไขทันที
คิดว่าการกระทำเป็นขั้นที่ยากที่สุดในสภาพแวดล้อมที่เละเทะและไม่เป็นโครงสร้าง ความผิดพลาดด้านการรับรู้แก้ได้ด้วยการมองใหม่ และความผิดพลาดด้านการวางแผนแก้ได้ด้วยการวางแผนใหม่ แต่ความผิดพลาดด้านคอนโทรลเกิดขึ้นแบบเรียลไทม์
Embodied AI ถูกฝึกด้วยการผสมผสานระหว่างซิมูเลชันและข้อมูลโลกจริง ซิมูเลชันหมายถึงสภาพแวดล้อมเสมือนที่เต็มไปด้วยวัตถุ 3 มิติที่มีฟิสิกส์แม่นยำ ซึ่งหุ่นยนต์สามารถฝึกซ้ำได้นับล้านครั้งก่อนแตะฮาร์ดแวร์จริง
จำปัญหาข้อมูลจากข้างต้นได้ไหม ซิมูเลชันเป็นหนึ่งในทางเลี่ยงหลัก โดยเฉพาะสำหรับการเรียนรู้เสริมกำลังในงานเคลื่อนที่และหยิบจับ โมเดลฐานอย่าง π₀ ยังพึ่งพาการสาธิตจริงอย่างมาก ดังนั้นส่วนใหญ่จึงใช้ทั้งสองแบบ
การเก็บข้อมูลในโลกจริงมี 3 ปัญหาใหญ่:
ซิมูเลเตอร์แก้ทั้ง 3 ข้อพร้อมกัน คุณสามารถรันหุ่นยนต์เสมือนนับพันตัวแบบขนานบน GPU เดียว และปล่อยให้มันล้มเหลวแล้วรีสตาร์ตได้ตามต้องการ ทำให้ประสบการณ์หุ่นยนต์หลายปีถูกย่อเหลือไม่กี่ชั่วโมง
ไม่ใช่ซิมูเลเตอร์ทุกตัวจะมีประโยชน์เท่ากันสำหรับการฝึกหุ่นยนต์ จากประสบการณ์ทำงานกับแขนกลในซิมูเลชัน เห็นว่าของดีต้องมี 3 อย่าง:
แพลตฟอร์มที่พบบ่อยที่สุดคือ NVIDIA Isaac Sim (พร้อม Isaac Lab) และ MuJoCo:
| แพลตฟอร์ม | ผู้พัฒนา | จุดเด่น | เหมาะสำหรับ |
|---|---|---|---|
| NVIDIA Isaac Sim และ Isaac Lab | NVIDIA | เรนเดอร์เหมือนจริงระดับสูง จำลองเซนเซอร์ รันสภาพแวดล้อมขนานนับพันบน GPU | การรัน RL ขนาดใหญ่และข้อมูลภาพสังเคราะห์ |
| MuJoCo | Google DeepMind (โอเพ่นซอร์ส) | ฟิสิกส์การสัมผัสเร็วและแม่น น้ำหนักเบา ชุมชนวิจัยใหญ่ | งานวิจัย เบนช์มาร์กการเคลื่อนที่และการหยิบจับ |
สมาชิกใหม่ล่าสุดคือ Newton เอนจินฟิสิกส์แบบโอเพ่นซอร์สเร่งด้วย GPU ที่สร้างโดย NVIDIA, Google DeepMind และ Disney Research และดูแลโดย Linux Foundation
Newton 1.0 เปิดตัวที่ NVIDIA GTC มีนาคม 2026 และเสียบเป็นแบ็กเอนด์ฟิสิกส์ใน Isaac Lab โดยมี MuJoCo Warp เป็นหนึ่งในโซลเวอร์ พร้อมโซลเวอร์เพิ่มเติมสำหรับวัตถุเสียรูปอย่างสายเคเบิลและผ้า
วัตถุเสียรูปสำคัญกว่าที่คิด ซิมูเลเตอร์รุ่นเก่าจัดการสายและผ้าได้ไม่ดี แต่งานโรงงานต้องการหุ่นยนต์ที่รับมือทั้งคู่ได้
ช่องว่าง sim-to-real คือการที่ประสิทธิภาพตกลงเมื่อย้ายนโยบายที่ฝึกในซิมูเลชันไปยังหุ่นยนต์จริง และเป็นหนึ่งในปัญหาใหญ่ของระบบ embodied
เช่น แรงเสียดทานที่จำลองไม่เคยตรงเป๊ะ กล้องจำลองสะอาดเกินไป วัตถุจำลองอาจสมบูรณ์แบบเกินจริง ดังนั้นนโยบายที่สำเร็จ 95% ในซิมอาจพังทันทีเมื่อเจอฮาร์ดแวร์จริง
มี 2 วิธีหลักที่ทีมใช้ปิดช่องว่างนี้:
แทนที่จะพยายามทำซิมูเลเตอร์ให้สมบูรณ์แบบ ทีมงานจะสุ่มหลากหลายรูปแบบ
Tobin et al. (2017) สุ่มพื้นผิวและแสงหนักมากจนโลกจริงดูเหมือนอีกหนึ่งรูปแบบให้โมเดล ส่วนหุ่นยนต์มือแก้รูบิกของ OpenAI Rubik’s Cube ไปไกลกว่านั้นด้วยการขยายการสุ่มอัตโนมัติเมื่อประสิทธิภาพดีขึ้น
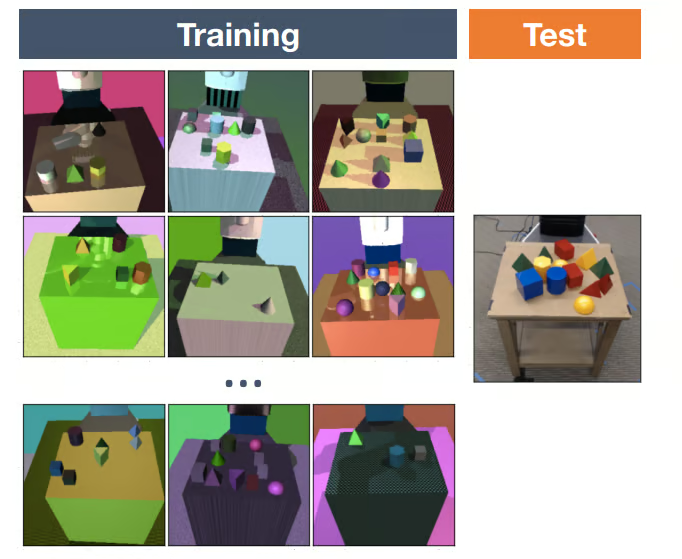
นโยบายที่พรีเทรนในซิมมักต้องการเพียงชุดเดโมจริงขนาดเล็กเพื่อปรับตัว เพราะได้เรียนรู้โครงร่างทั่วไปของงานมาแล้ว
ไม่มีเทคนิคใดลบช่องว่างได้หมด จึงยังต้องทำงานต่อเพื่อลดผลกระทบต่อประสิทธิภาพโลกจริง
Embodied AI ทำงานนอกห้องแล็บแล้วในหลายอุตสาหกรรม แม้จะกระจายตัวไม่สม่ำเสมอ
รูปแบบที่เห็นคือ เริ่มปักหลักในที่ที่สภาพแวดล้อมเปลี่ยนมากเกินจะสคริปต์ด้วยมือได้ แต่ยังมีมนุษย์เข้าแทรกได้หากมีปัญหา
รถไร้คนขับเป็นหนึ่งใน Embodied AI ที่หิวข้อมูลมากที่สุด
Waymo Driver เดินทางแบบอัตโนมัติเต็มรูปแบบเกือบ 200 ล้านไมล์ และยังฝึกและทดสอบบนพันล้านไมล์ในซิมูเลชัน ตามโพสต์เดือนกุมภาพันธ์ 2026 เกี่ยวกับ World Model ของ Waymo ซิมูเลชันช่วยให้ Waymo เล่นซ้ำเหตุการณ์จริง และสร้างสถานการณ์หายาก (เช่น เด็กวิ่งพรวดออกมาระหว่างรถที่จอด) ที่กองทดสอบอาจไม่เจอบนถนนจริง
รถไร้คนขับยังเป็นตัวอย่างที่ดีของลูปการรับรู้-เหตุผล-การกระทำที่ทำงานเต็มสปีด รถของ Waymo รับรู้ด้วยกล้อง ไลดาร์ และเรดาร์ ให้เหตุผลว่าคนเดินถนนและยานพาหนะแต่ละคันน่าจะทำอะไรต่อ แล้วควบคุมพวงมาลัยและเบรกหลายครั้งต่อวินาที
มองว่าคลังสินค้าเป็นการใช้งานเชิงพาณิชย์ที่ลงตัวที่สุดของ Embodied AI ตอนนี้
กำลังเปลี่ยนจากหุ่นยนต์ตามเส้นทางตายตัวบนพื้น ไปสู่ระบบที่รับมือกับสต็อกที่พลวัตและเละเทะ เช่น การหยิบจากถังที่มีสินค้า 40 อย่างปะปนกัน
Digit หุ่นยนต์ฮิวแมนนอยด์ของ Agility Robotics เคลื่อนย้ายถังที่ GXO Logistics ภายใต้ข้อตกลงหลายปีที่ลงนามในปี 2024 และ Stretch ของ Boston Dynamics ขนกล่องลงจากรถบรรทุก
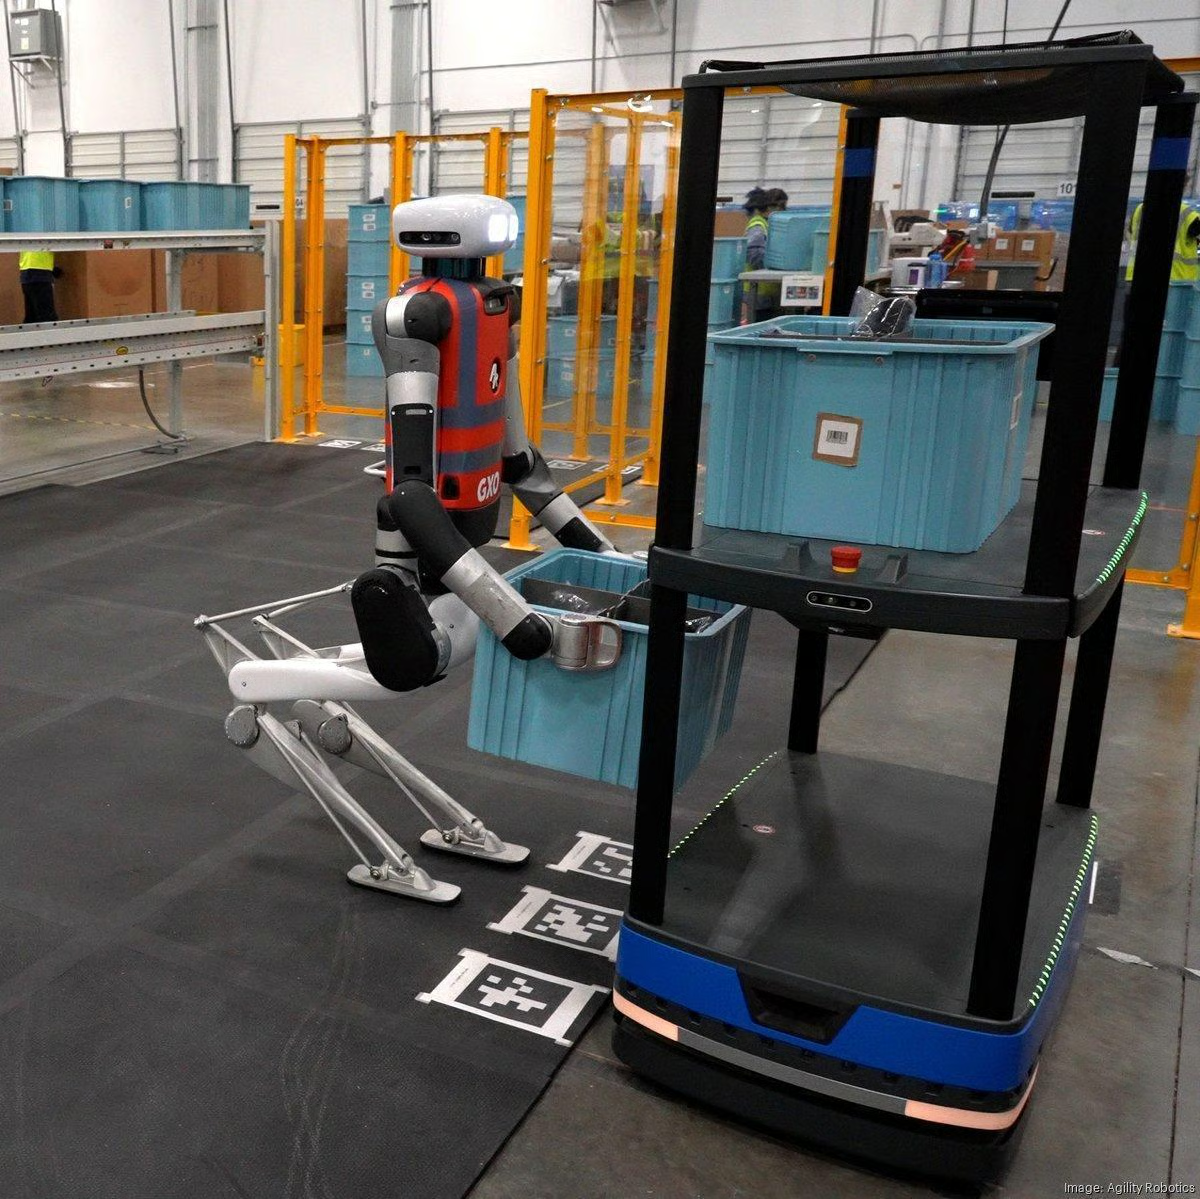
Digit ของ Agility Robotics ย้ายถังระหว่างหุ่นยนต์เคลื่อนที่อัตโนมัติและสายพานในคลัง GXO ที่มา: Agility Robotics/The Robot Report
ด้านสุขภาพน่าจะเป็นที่ที่ Embodied AI เคลื่อนไหวอย่างระมัดระวังที่สุด
ระบบผ่าตัดอย่าง da Vinci ของ Intuitive ถูกใช้ในโรงพยาบาลทั่วโลกแล้ว แต่ยังมีศัลยแพทย์ควบคุมอยู่ และงานวิจัย AI ส่วนใหญ่เน้นงานช่วยเหลือ เช่น ติดตามเครื่องมือ ควบคุมกล้อง และช่วยเย็บแผล
ในการแพทย์ การอนุมัติตามกฎระเบียบมักเป็นข้อจำกัดที่ใหญ่กว่าความสามารถของโมเดล และสมควรเป็นเช่นนั้น คาดว่าการใช้งานช่วยเหลือและฝึกอบรมจะมาก่อนสิ่งที่ใกล้เคียงการผ่าตัดอัตโนมัติจริงๆ อีกนาน
หุ่นยนต์ฮิวแมนนอยด์ได้รับความสนใจมากที่สุดและพิสูจน์ตัวเองน้อยที่สุด
ที่ CES 2026 Boston Dynamics เปิดตัวเวอร์ชันผลิตจริงของ Atlas และระบุว่าทุกยูนิตที่สร้างในปี 2026 ถูกจองโดย Hyundai และ Google DeepMind แล้ว ส่วน Figure ทดสอบใช้งาน 11 เดือน ของ Figure 02 ในโรงงาน BMW เมืองสปาร์ตันเบิร์ก รัฐเซาท์แคโรไลนา สำหรับงานโหลดแผ่นโลหะ
อย่างไรก็ดี ต้องพูดตรงๆ ว่าการใช้งานฮิวแมนนอยด์ส่วนใหญ่ยังเป็นโครงการนำร่องที่ทำงานชุดแคบๆ ตัวอย่าง Hyundai วางแผนเริ่มใช้ Atlas สำหรับจัดคิวชิ้นส่วนในปี 2028 แสดงให้เห็นว่าผู้สนับสนุนรายใหญ่ก็เดินหน้าอย่างรอบคอบ
ต่อไปมาดูว่ามีใครสร้างสิ่งเหล่านี้จริงบ้าง นี่คือ 5 องค์กรที่คิดว่าผู้เริ่มต้นด้าน Embodied AI ควรรู้จัก:
| องค์กร | สิ่งที่สร้าง | เหตุผลที่สำคัญ |
|---|---|---|
| NVIDIA | Isaac Sim, Isaac Lab, Newton, GR00T และ Cosmos | สแต็กซิมูเลชันและคอมพิวต์ที่ทีมส่วนใหญ่ใช้ฝึก |
| Physical Intelligence | ตระกูลโมเดลฐานสำหรับหุ่นยนต์ π₀ | นโยบายหุ่นยนต์อเนกประสงค์พร้อมเช็คพอยต์แบบเปิด |
| Agility Robotics | หุ่นยนต์ฮิวแมนนอยด์ Digit | ออกแบบเพื่อโลจิสติกส์คลังสินค้าและทำงานกับลูกค้าแล้ว |
| Boston Dynamics | Atlas, Stretch และ Spot | พัฒนา Atlas จากเดโมวิจัยสู่ยูนิตผลิตในปี 2026 |
| AMI Labs (Yann LeCun) | เวิลด์โมเดลสไตล์ JEPA | เดิมพันนอกกระแสกับเวิลด์โมเดลที่ไม่สร้างพิกเซล |
NVIDIA ส่วนใหญ่สร้างเครื่องมือรอบๆ หุ่นยนต์มากกว่าสร้างหุ่นยนต์เอง
Isaac Sim ดูแลซิมูเลชันเหมือนจริง Isaac Lab ดูแล RL ที่รันบนมัน และ Newton ให้ฟิสิกส์ได้ ปัจจุบันทีมโรบอติกส์จำนวนมากฝึกบนซอฟต์แวร์ของ NVIDIA แม้ NVIDIA จะไม่ได้ขายหุ่นยนต์อเนกประสงค์
Physical Intelligence สร้าง π₀ โมเดลวิชัน-ภาษา-การกระทำขนาด 3.3 พันล้านพารามิเตอร์ ที่ใช้ flow matching เพื่อสร้างบล็อกการกระทำที่ลื่นไหลสำหรับงานอย่างพับผ้า
นี่คือตัวอย่างที่ดีที่สุดของโมเดลหุ่นยนต์อเนกประสงค์ที่ดาวน์โหลดได้จริง ผ่าน รีโป openpi
หาก “โมเดลฐาน” เป็นแนวคิดใหม่ Introduction to Foundation Models ของเราช่วยอธิบายได้ดี
Agility Robotics เลือกเส้นทางแคบด้วย Digit
มันถูกออกแบบรอบๆ งานย้ายถังในคลังสินค้าตั้งแต่วันแรก และความโฟกัสแคบนี้เป็นเหตุผลใหญ่ที่ไปถึงลูกค้าที่จ่ายเงินจริงได้เร็วกว่าฮิวแมนนอยด์ส่วนใหญ่
Boston Dynamics เลือกเส้นทางตรงข้ามกับ Atlas
ใช้เวลาหลายปีดันขีดจำกัดทางกายภาพของหุ่นยนต์ (น่าจะเคยเห็นวิดีโอปาร์กัวร์) ก่อนจะเปลี่ยนให้เป็นผลิตภัณฑ์ไฟฟ้าล้วนสำหรับโรงงาน ซึ่ง Google DeepMind วางแผนจะขับเคลื่อนด้วยโมเดล Gemini Robotics
AMI Labs คือสตาร์ทอัพในปารีสของ Yann LeCun ระดมทุนซีดรอบ $1.03 พันล้านในมีนาคม 2026 ที่มูลค่าก่อนเงิน $3.5 พันล้าน รอบนี้ร่วมคุมโดย Cathay Innovation, Greycroft, Hiro Capital, HV Capital และ Bezos Expeditions โดยมี NVIDIA และ Samsung ร่วมลงทุน
LeCun โต้แย้งมาหลายปีว่าการทำนายทุกพิกเซลของอนาคตนั้นสิ้นเปลือง Joint Embedding Predictive Architecture (JEPA) ของเขาจึงทำนายในพื้นที่การแทนเชิงนามธรรมแทน ไอเดียที่ Meta ทดสอบแล้วกับ V-JEPA 2
สิ่งที่ทำให้ AMI น่าจับตาคือไปคนละทางกับกระแสหลักของสาขา ยังไม่ปล่อยของจริง จึงควรมองเป็นเดิมพันเชิงวิจัยที่มีเงินหนุนมหาศาล มากกว่าวิธีที่พิสูจน์แล้วในตอนนี้
Embodied AI ไม่ใช่ปัญหาวิศวกรรมหุ่นยนต์อย่างเดียว งานจำนวนมาก—และน่าจะส่วนใหญ่—เป็นงานแมชชีนเลิร์นนิง
ทักษะที่ต่อยอดได้ตรงที่สุด ได้แก่:
ไม่จำเป็นต้องมีหุ่นยนต์เพื่อเริ่มต้น ไลบรารี gymnasium มาพร้อมสภาพแวดล้อม MuJoCo ดังนั้นหลังจากรัน pip install "gymnasium[mujoco]" ก็สามารถรันลูปทั้งหมดบนหุ่นยนต์จำลองได้:
import gymnasium as gym

# HalfCheetah is a 2D cheetah-like robot simulated with the MuJoCo physics engine
env = gym.make("HalfCheetah-v5")
observation, info = env.reset(seed=42)

for step in range(1000):
    # Perception: the observation holds joint angles and velocities
    # Reasoning: a trained policy would choose the action here, we pick randomly
    action = env.action_space.sample()

    # Action: apply torques to the joints and move the physics forward one step
    observation, reward, terminated, truncated, info = env.step(action)

    if terminated or truncated:
        observation, info = env.reset()

env.close()
ตอนนี้ เสือชีตาห์ยังดิ้นสะเปะสะปะ เพราะขั้น “การให้เหตุผล” คือ env.action_space.sample() ซึ่งสุ่มการกระทำทุกครั้ง
การแทนที่เพียงบรรทัดเดียวด้วยนโยบายที่ฝึกแล้วคือสิ่งที่ RL ทำ และแนะนำให้ลองก่อนขยับไปงานที่ใหญ่กว่า
Embodied AI ก้าวเร็ว แต่ยังติดขัด 4 จุด ซึ่งควรรู้ไว้:
Embodied AI ให้ร่างกายทางกายภาพแก่เครื่องจักรและความฉลาดในการใช้มัน มันทำงานผ่านลูปการรับรู้-เหตุผล-การกระทำ ถูกถ่วงด้วยปริมาณข้อมูลกายภาพที่มีอยู่น้อย และในปี 2026 กำลังก้าวออกจากแล็บสู่คลังสินค้าและโครงการนำร่องในโรงงานชุดแรก
สิ่งที่น่าประหลาดใจคือคำถามเปลี่ยนไปไม่กี่ปีนี้ ผู้คนเคยถามว่า LLM จะทำให้การวิจัยหุ่นยนต์หมดความหมายหรือไม่ แต่กลับกัน LLM กำลังกลายเป็นชั้นเหตุผลภายในระบบ embodied และสองสาขากำลังก้าวมาบรรจบกัน
จำแอปเปิลตอนต้นบทความได้ไหม การ “รู้วิธีหยิบ” กับ “หยิบได้จริง” กลายเป็นคนละปัญหา และ Embodied AI คือสาขาที่ทำงานกับปัญหาที่สอง
หากอยากสร้างรากฐาน ML สำหรับสิ่งนี้ เริ่มจาก เส้นทาง Reinforcement Learning in Python ของเรา สำหรับด้านภาษาของสแต็ก ลอง คอร์ส Large Language Models (LLMs) Concepts และ เส้นทาง Developing Large Language Models ต่อได้
คอร์สยอดนิยมจาก DataCamp
คอร์ส
คอร์ส
แทร็ก