Curso
Aprendizado por reforço profundo em Python
4 h
6K
Imagine que você pede a um amigo para te passar uma maçã da fruteira. Ele olha para a tigela, identifica qual é a maçã e a pega com cuidado para não amassar antes de te entregar.
Agora vamos pedir o mesmo a um chatbot. Ele consegue te explicar exatamente como pegar uma maçã, quais dedos usar e com que força aproximada apertar, mas não consegue, de fato, pegar uma. Ele não tem mãos — e nenhuma noção de como uma maçã se parece ao toque.
Embodied AI é o campo que tenta fechar essa lacuna. Em termos simples, é uma IA com um corpo físico (como um robô, um carro ou um drone) que aprende fazendo coisas no mundo real — e não apenas lendo sobre elas. Você também pode ver o termo relacionado “physical AI” usado com o mesmo sentido.
Neste momento, a área está em alta. Na CES, em janeiro de 2026, Jensen Huang, da NVIDIA, disse que este é “o momento ChatGPT da robótica”.
O dinheiro acompanhou. Dados da Dealroom reportados pela CNBC mostram que empresas de robótica levantaram US$ 55,8 bilhões em 2026 até o início de junho — quase o dobro do recorde anual anterior.
Neste artigo, você vai ver:
Sem estresse se você nunca trabalhou com robôs. Ter alguma familiaridade com machine learning ajuda, mas vou construir cada ideia do zero para você acompanhar do início ao fim.
Embodied AI é um sistema de inteligência artificial embarcado em um corpo físico — como um robô, um veículo autônomo ou um drone — que percebe o ambiente por sensores, raciocina sobre o que fazer e age no mundo por motores, aprendendo com os resultados das próprias ações.
A palavra-chave aqui é embodied — com corpo.
A maioria dos modelos de IA aprende observando dados coletados por outras pessoas. Um sistema embodied aprende interagindo com o ambiente, por exemplo, empurrando um copo, vendo o copo deslizar e atualizando o que sabe sobre como copos se comportam quando empurrados.
Exemplo: um modelo de visão treinado em milhões de fotos de portas sabe como uma porta parece. Um robô que tentou abrir 500 portas sabe que algumas empurram, outras puxam, algumas são pesadas e outras têm maçanetas que você precisa pressionar antes.
Você não alcança essa profundidade de conhecimento com uma foto.
Gosto de resumir assim: a maior parte da IA aprende sobre o mundo lendo sobre ele; embodied AI aprende sobre o mundo tocando e experimentando.
Essa única diferença muda os dados de que você precisa, como treinar — e como as coisas podem dar errado.
Até aqui, comparei embodied AI com um chatbot. Agora vamos compará-la com as 2 coisas com que ela mais é confundida: large language models (LLMs) e a robótica tradicional baseada em regras.
| Embodied AI | Large language models (LLMs) | Robótica tradicional baseada em regras | |
|---|---|---|---|
| Aprende com o ambiente | Sim, por interação e feedback | Em geral não, aprende de um corpus de texto fixo | Não, o comportamento é programado manualmente |
| Toma ações físicas | Sim | Não | Sim |
| Treina em dados da internet | Parcialmente (seus backbones de visão e linguagem) | Sim, trilhões de tokens | Não |
| Generaliza para novos ambientes | Moderadamente, e melhorando rápido | Bem, dentro de tarefas de linguagem | Mal, quebra quando o setup muda |
| Maturidade comercial em 2026 | Produção inicial (armazéns, pilotos em fábricas) | Madura e amplamente implantada | Madura, décadas de uso em fábricas |
As 2 últimas linhas são as que quero destacar.
Braços industriais baseados em regras soldam carros há décadas e são extremamente confiáveis — mas só porque nada dentro da sua célula de trabalho muda. Embodied AI tenta manter essa confiabilidade deixando o mundo ser bagunçado, o que os pesquisadores chamam de generalização.
LLMs e embodied AI aprendem com grandes volumes de dados, mas resolvem problemas muito diferentes. Uma LLM recebe texto e prevê qual token vem a seguir; um sistema embodied recebe quadros de câmera, ângulos de juntas e leituras táteis e prevê qual movimento deve vir a seguir.
Em resumo, LLMs sabem sobre o mundo físico, enquanto embodied AI age nele. Voltando à maçã: uma LLM descreve exatamente como pegar, e um robô com embodied AI realmente pega.
O custo do erro também é muito diferente. Se uma LLM erra, sai uma frase meio estranha. Se um sistema embodied erra, um copo pode parar no chão — ou pior.
E tem um ponto que muita gente perde: as duas trabalham juntas.
Nos modelos visão–linguagem–ação (VLA), um modelo de visão–linguagem pré-treinado fica no núcleo do sistema. Ele lê as imagens da câmera e a sua instrução (“coloque as frutas na tigela”), depois repassa seu entendimento a um decodificador de ação que produz os comandos de motor.
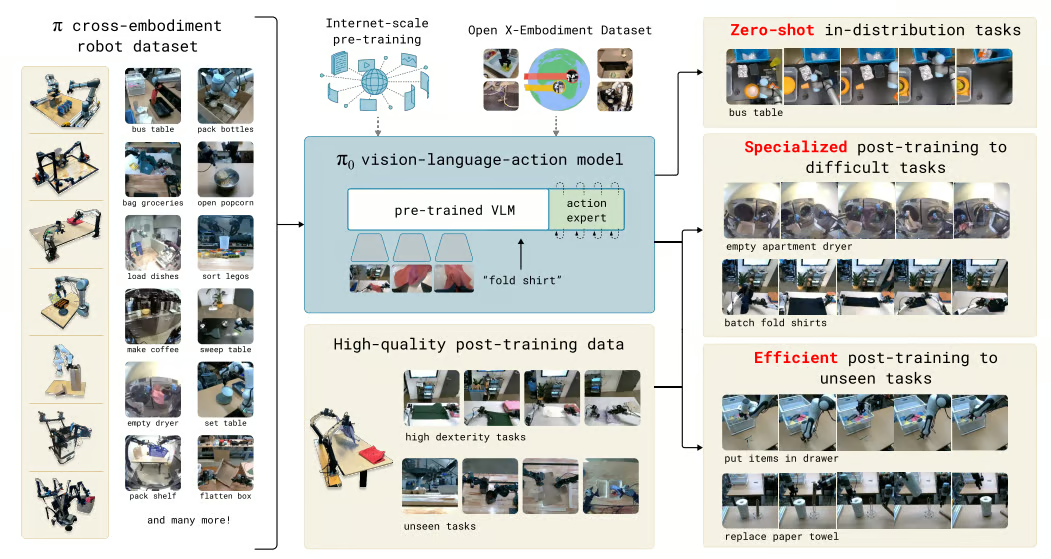
Como um modelo de visão–linguagem pré-treinado se conecta às ações do robô no π₀ (pi-zero). Imagem da fonte: Black et al., 2024
Physical AI é mais difícil do que IA digital principalmente por causa de dados.
Modelos de linguagem avançaram rápido graças a décadas de textos, códigos e imagens compartilhados online, mas não existe uma fonte comparável de dados sensoriais do mundo real. São muito menos comuns fluxos de ângulos de juntas, leituras de força e quadros de câmera de robôs interagindo com objetos do dia a dia.
Vamos detalhar os requisitos de dados. Um sistema embodied precisa de 3 tipos de dados difíceis de obter:
Agora vamos colocar números nisso.
LLMs de fronteira são treinadas em trilhões de tokens. O Open X-Embodiment, um dos maiores datasets abertos de robótica, uniu dados de 22 tipos de robôs em 21 instituições e terminou com pouco mais de 1 milhão de trajetórias reais.
Os robôs e tarefas agrupados no dataset Open X-Embodiment. Imagem da fonte: Open X-Embodiment Collaboration, 2023
Por que tão pouco? Cada trajetória exige um robô real fazendo uma tarefa real, geralmente controlado por um humano via teleoperação — o que é lento e caro.
Essa lacuna também explica por que a physical AI generaliza mais devagar do que a IA digital. Um modelo lida melhor com variação quando já viu algo semelhante, e um milhão de trajetórias cobrem muito menos cozinhas, iluminações e formatos de objetos do que trilhões de tokens cobrem frases.
Guarde esse problema de dados em mente para o resto do texto. Muitas das decisões de design que você verá — de simulação a domain randomization e o uso de backbones de visão–linguagem pré-treinados — são maneiras de contorná-lo.
Embodied AI funciona rodando continuamente um ciclo de 3 estágios:
Esse loop se repete muitas vezes por segundo, e cada movimento muda o que o robô percebe em seguida, então a saída de um ciclo vira a entrada do próximo.
O mesmo loop está por trás dos world models. O artigo “World Models” de 2018, de Ha e Schmidhuber, dividiu um agente em módulos de visão, memória e controle e testou em um carro num jogo de corrida. Embodied AI aplica a mesma ideia a um robô completo.
Uma boa forma de entender o loop é imaginar pegar uma bola:
Um robô faz o mesmo — só que com câmeras no lugar de olhos e motores no lugar de músculos.
Vamos ver cada estágio.
Percepção é o estágio que transforma leituras brutas dos sensores em algo com que o restante do sistema pode raciocinar. Uma única câmera raramente basta, então a maioria dos robôs combina vários sensores:
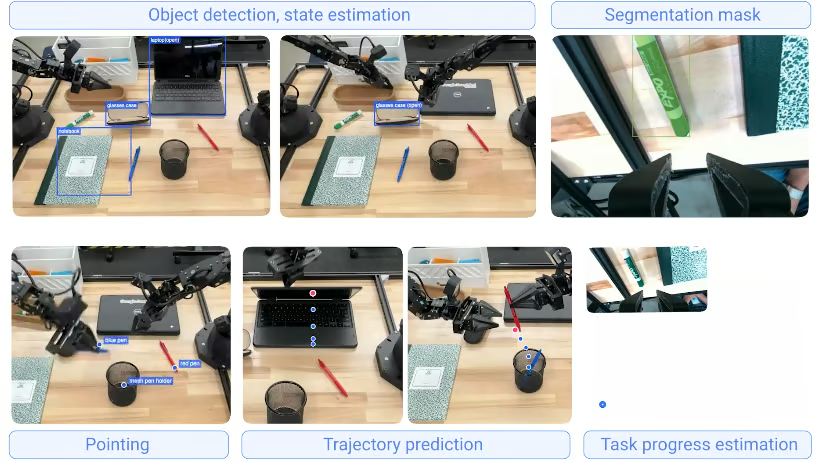
Exemplos de saídas de percepção do Gemini Robotics-ER 1.5. Imagem da fonte: Google DeepMind
Modelos de percepção então transformam essas leituras em mapas espaciais, identidades de objetos, posições de obstáculos e um entendimento geral da cena.
Grande parte disso é visão computacional clássica — como detecção de objetos, segmentação e estimativa de profundidade — geralmente construída sobre transformers de visão pré-treinados como DINOv2 ou SigLIP.
Na minha opinião, porém, o tato é a parte mais subestimada da percepção hoje. A câmera te diz que há um copo na mesa, mas é o tato que avisa quando ele começa a escorregar da sua mão.
Para você ter uma noção do estado da arte, a XELA Robotics mostrou na Automate 2026 uma ponta de dedo robótica com 30 pontos de detecção de força tridimensionais no acolchoado. A empresa também diz que seus sensores uSkin detectam forças de até 0,1 grama-força.
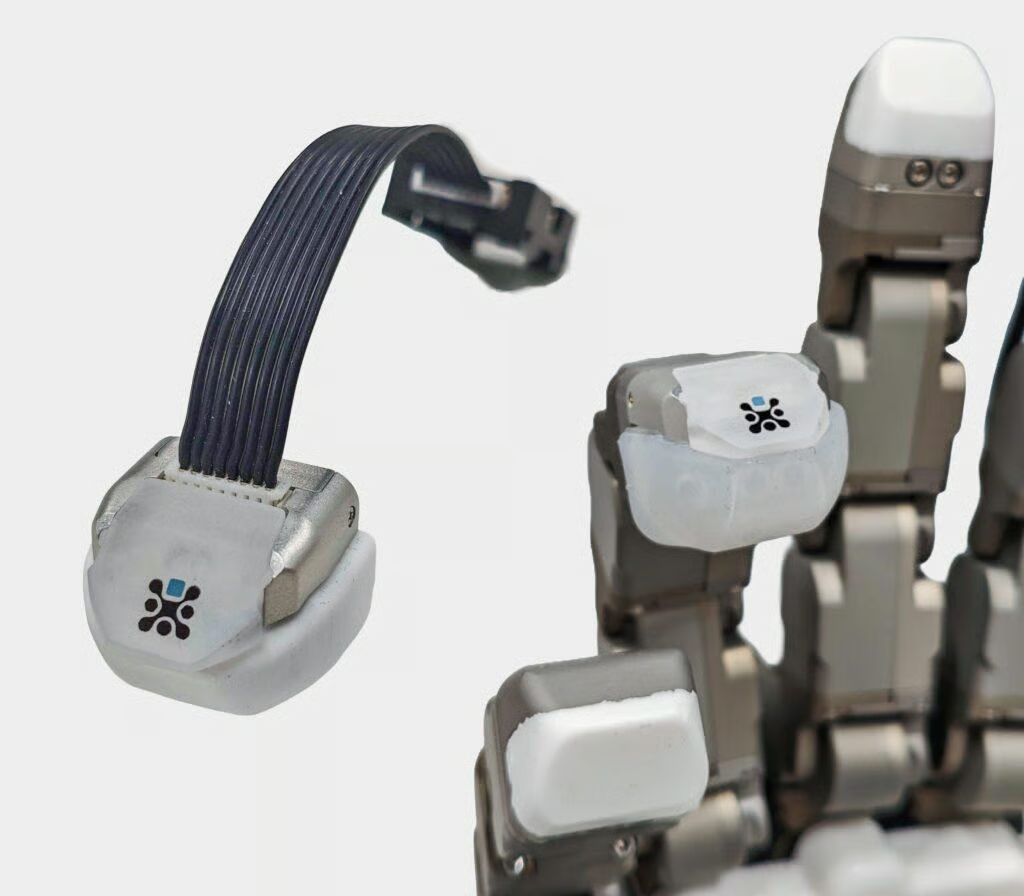
Uma ponta de dedo robótica uSkin com uma matriz de sensores táteis tridimensionais. Imagem da fonte: XELA Robotics
Raciocínio é o estágio que decide o que fazer a seguir. Nos sistemas mais novos, ele costuma ter 2 camadas:
World models permitem que o robô imagine antes de agir.
O DreamerV3 é um bom exemplo. Ele aprende um modelo compacto do ambiente e treina sua política quase inteiramente dentro desse mundo imaginado.
Eu uso o DreamerV3 nas minhas pesquisas e o que mais me surpreendeu é quanto tempo o agente passa praticando na sua “cabeça” em relação ao ambiente real. Isso importa porque o treinamento fica mais rápido e muito mais barato.
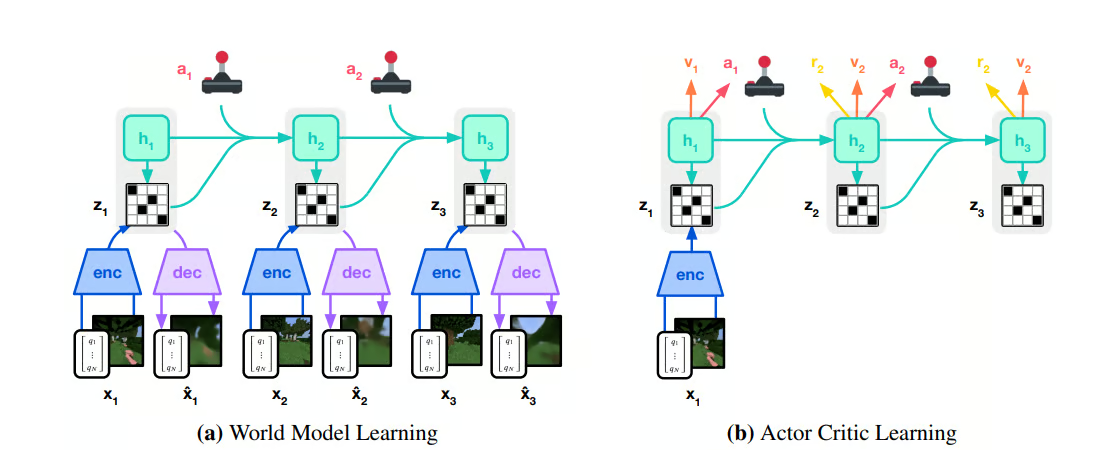
O DreamerV3 treina sua política em rollouts imaginados do world model. Imagem da fonte: Hafner et al., 2023
Já o planejamento está cada vez mais sendo feito por modelos de linguagem.
Um bom exemplo é o Gemini Robotics-ER 1.5, do Google DeepMind, que atua como planejador de alto nível. Dada uma tarefa como separar lixo de acordo com regras locais de reciclagem, ele consulta as regras no Google Search, divide o trabalho em etapas e entrega cada etapa ao modelo VLA Gemini Robotics 1.5, que executa o trabalho físico.
Pense no modelo de linguagem como o gestor — e no modelo VLA como o executor que põe a mão na massa.
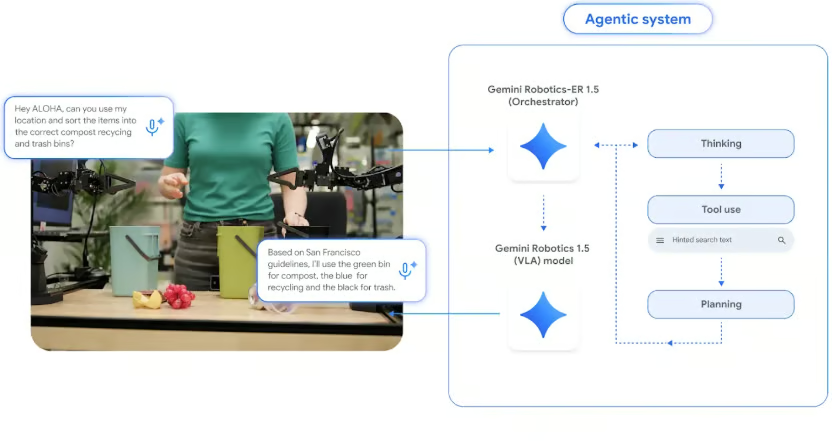
O Gemini Robotics-ER 1.5 planeja a tarefa e delega a execução física ao Gemini Robotics 1.5 VLA. Imagem da fonte: Google DeepMind, 2025
Ação é o estágio que converte uma decisão em comandos precisos para cada junta e motor, geralmente dezenas a centenas de vezes por segundo (em hertz, ou Hz). A parte de baixo nível é chamada de controle.
Por exemplo, um comando como “Mova a garra 5 cm para a esquerda” parece simples, mas em um braço de 7 juntas isso vira um torque específico para cada motor, recalculado continuamente conforme o braço se move.
A parte difícil é que a realidade raramente bate com o que o robô esperava. Objetos escorregam, pisos são levemente irregulares, a iluminação muda quando alguém abre a persiana e um cabo entorta diferente do previsto.
Um bom controlador nota a diferença entre o esperado e o observado — e corrige na hora.
Eu diria que ação é o estágio mais difícil de acertar em ambientes bagunçados e não estruturados. Um erro de percepção dá para corrigir olhando de novo; um erro de planejamento dá para corrigir replanejando; mas um erro de controle acontece em tempo real.
Embodied AI é treinada com uma mistura de simulação e dados do mundo real. Simulação significa ambientes virtuais com objetos 3D fisicamente realistas, onde um robô pode praticar milhões de vezes antes de tocar no hardware.
Lembra do problema de dados? Simulação é um dos principais contornos, especialmente para reinforcement learning de locomoção e manipulação. Foundation models como o π₀ ainda dependem bastante de demonstrações reais, então a maioria das equipes usa ambos.
Coletar dados no mundo real tem 3 grandes problemas:
Um simulador ataca os 3 de uma vez. Você pode rodar milhares de robôs virtuais em paralelo em uma única GPU e deixá-los falhar e reiniciar à vontade. Isso condensa anos de experiência do robô em poucas horas.
Nem todo simulador é igualmente útil para treinar robôs. Trabalhando com braços robóticos em simulação, eu diria que um bom precisa de 3 coisas:
As 2 plataformas mais comuns são o NVIDIA Isaac Sim (com Isaac Lab) e o MuJoCo:
| Plataforma | Desenvolvedor | Pontos fortes | Melhor para |
|---|---|---|---|
| NVIDIA Isaac Sim e Isaac Lab | NVIDIA | Renderização fotorrealista, simulação de sensores, milhares de ambientes paralelos na GPU | Grandes execuções de reinforcement learning e dados sintéticos de câmera |
| MuJoCo | Google DeepMind (open source) | Física de contato rápida e precisa, leve, comunidade de pesquisa enorme | Pesquisa, benchmarks de locomoção e manipulação |
A adição mais recente é o Newton, um engine de física open source e acelerado por GPU, criado por NVIDIA, Google DeepMind e Disney Research e gerenciado pela Linux Foundation.
O Newton 1.0 foi lançado no NVIDIA GTC em março de 2026. Ele se integra ao Isaac Lab como backend de física, com o MuJoCo Warp como um dos solvers e solvers extras para objetos deformáveis como cabos e tecidos.
Deformáveis importam mais do que parecem. Simuladores antigos lidavam mal com cabos e tecidos — e fábricas precisam que robôs manipulem ambos.
O gap sim-to-real é a queda de performance que acontece quando uma política treinada em simulação é levada para um robô real — e é um dos maiores problemas em sistemas embodied.
Por exemplo, o atrito simulado nunca bate perfeitamente, câmeras simuladas são limpas demais e objetos simulados são perfeitinhos — então uma política que acerta 95% das vezes na simulação pode falhar assim que encontra o hardware real.
Há 2 formas principais de reduzir esse gap:
Em vez de tentar deixar o simulador perfeito, as equipes randomizam muita coisa.
Tobin et al. (2017) randomizaram texturas e iluminação tão fortemente que o mundo real virou só mais uma variação para o modelo. A mão robótica do Cubo de Rubik da OpenAI foi além, ampliando automaticamente a randomização conforme a política melhorava.
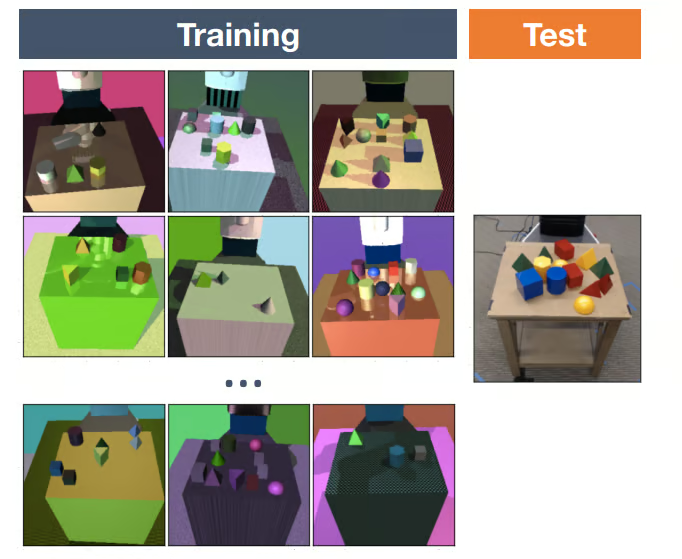
Uma política pré-treinada em simulação geralmente precisa de apenas um conjunto pequeno de demonstrações reais para se adaptar, porque já aprendeu o formato geral da tarefa.
Nenhuma das técnicas elimina o gap por completo, então as equipes seguem trabalhando para reduzir o impacto na performance em campo.
Embodied AI já roda fora do laboratório em vários setores — embora de forma desigual.
O padrão que vejo é: ela chega primeiro onde o ambiente muda demais para ser roteirizado à mão, mas onde um humano ainda pode intervir se algo sair do esperado.
Carros autônomos estão entre os tipos mais famintos por dados de embodied AI.
O Waymo Driver percorreu quase 200 milhões de milhas totalmente autônomas, e também treina e testa em bilhões de milhas em simulação, segundo o post da Waymo de fevereiro de 2026 sobre seu World Model. A simulação permite reencenar incidentes reais e gerar cenários raros (por exemplo, uma criança correndo entre carros estacionados) que uma frota de testes talvez nunca encontre nas ruas.
Carros autônomos também são um bom exemplo do ciclo percepção–raciocínio–ação rodando no talo. Um veículo Waymo percebe com câmeras, lidar e radar; raciocina sobre o que cada pedestre e veículo provavelmente fará; e age controlando direção e freios muitas vezes por segundo.
Na minha visão, armazéns são hoje o uso comercial mais natural de embodied AI.
A mudança é de robôs de trajeto fixo, que seguem linhas no chão, para sistemas capazes de lidar com inventário dinâmico e bagunçado — como separar itens em um tote com 40 produtos misturados.
O humanoide Digit, da Agility Robotics, vem movendo totes na GXO Logistics sob um acordo plurianual assinado em 2024, e o Stretch, da Boston Dynamics, descarrega caixas de caminhões.
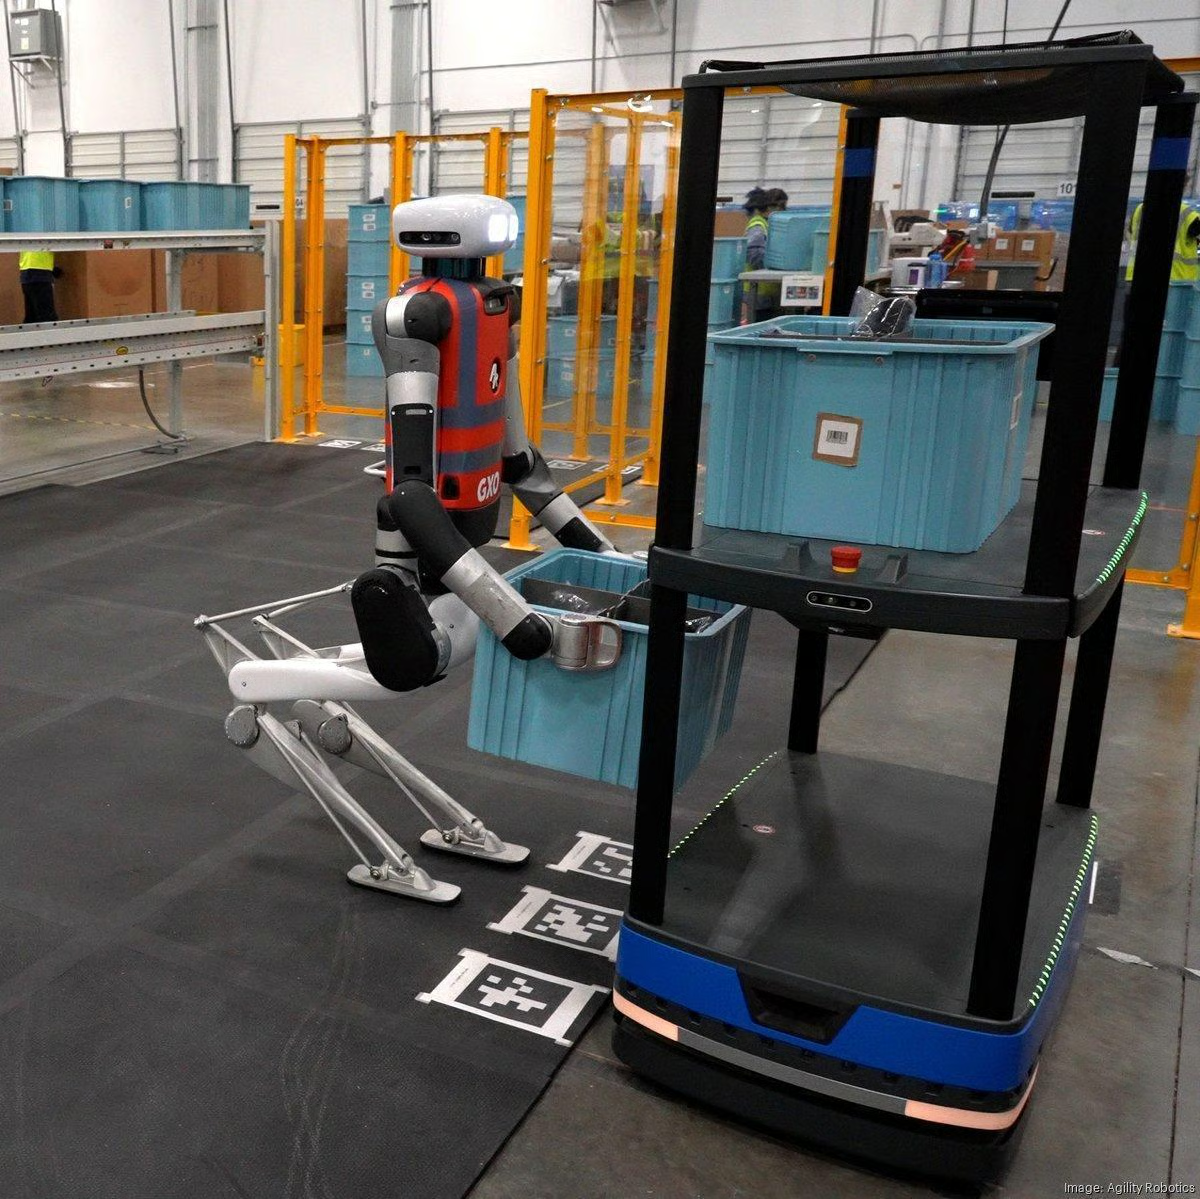
O Digit, da Agility Robotics, movendo totes entre robôs móveis autônomos e uma esteira em um armazém da GXO. Imagem da fonte: Agility Robotics/The Robot Report
Na saúde, espero que embodied AI avance com mais cautela.
Sistemas cirúrgicos como o da Vinci, da Intuitive, já são usados em hospitais no mundo todo, mas sob controle de um cirurgião — e a maior parte da pesquisa em IA aqui foca em assistência: rastreamento de instrumentos, controle de câmera e apoio à sutura.
Em saúde, aprovação regulatória costuma ser um limitador maior do que a capacidade do modelo — e com razão. Eu pessoalmente esperaria usos assistivos e de treinamento chegarem muito antes de algo próximo a cirurgia autônoma.
Humanoides chamam mais atenção — e estão entre os menos comprovados.
Na CES 2026, a Boston Dynamics apresentou a versão de produção do Atlas e disse que todas as unidades que fabricar em 2026 já estão comprometidas com a Hyundai e o Google DeepMind. Já a Figure fez um deployment de 11 meses do Figure 02 na fábrica da BMW em Spartanburg, na Carolina do Sul, carregando chapas metálicas.
Mas sendo bem franco: a maioria dos deployments de humanoides ainda são pilotos em um conjunto restrito de tarefas. A Hyundai, por exemplo, planeja começar a usar o Atlas para sequenciamento de peças em 2028 — sinal de como até os maiores patrocinadores estão avançando com cuidado.
Quem está construindo tudo isso? Aqui vão 5 organizações que quem está começando em embodied AI deve reconhecer:
| Organização | O que constroem | Por que importa |
|---|---|---|
| NVIDIA | Isaac Sim, Isaac Lab, Newton, GR00T e Cosmos | A pilha de simulação e computação em que a maioria das equipes treina |
| Physical Intelligence | Família de foundation models robóticos π₀ | Políticas robóticas de uso geral com checkpoints abertos |
| Agility Robotics | Humanoide Digit | Feito para logística em armazéns e já trabalhando com clientes |
| Boston Dynamics | Atlas, Stretch e Spot | Levando o Atlas de demos de pesquisa a unidades de produção em 2026 |
| AMI Labs (Yann LeCun) | World models no estilo JEPA | Uma aposta contrária em world models que não geram pixels |
A NVIDIA constrói principalmente as ferramentas ao redor do robô — não o robô em si.
O Isaac Sim cuida da simulação fotorrealista, o Isaac Lab cuida de reinforcement learning por cima disso, e o Newton agora fornece a física. Muitos times treinam em software da NVIDIA, mesmo que a NVIDIA não venda um robô de uso geral.
A Physical Intelligence criou o π₀, um modelo visão–linguagem–ação de 3,3 bilhões de parâmetros que usa flow matching para gerar blocos suaves de ações em tarefas como dobrar roupas.
É o melhor exemplo que conheço de um modelo robótico de uso geral que você pode realmente baixar — pelo repositório openpi.
Se o conceito de “foundation model” é novo para você, nosso guia Introdução aos Foundation Models explica bem a ideia.
A Agility Robotics seguiu o caminho estreito com o Digit.
Ele foi projetado desde o dia 1 para mover totes em armazéns — e esse foco estreito é um dos motivos pelos quais chegou a clientes pagantes antes da maioria dos humanoides.
A Boston Dynamics seguiu o caminho oposto com o Atlas.
Passou anos forçando os limites atléticos do robô (você provavelmente viu os vídeos de parkour) antes de transformá-lo em um produto totalmente elétrico para fábricas, que o Google DeepMind planeja equipar com seus modelos Gemini Robotics.
A AMI Labs é a startup parisiense de Yann LeCun, que fechou uma rodada seed de US$ 1,03 bilhão em março de 2026, a um valuation pré-money de US$ 3,5 bilhões. A rodada foi co-liderada por Cathay Innovation, Greycroft, Hiro Capital, HV Capital e Bezos Expeditions, com NVIDIA e Samsung entre os investidores.
LeCun defende há anos que prever cada pixel do futuro é desperdício; sua Joint Embedding Predictive Architecture (JEPA) faz previsões em um espaço de representação abstrato — ideia que a Meta já testou no V-JEPA 2.
O que torna a AMI interessante é ir contra a direção predominante do campo. Ainda não lançou nada, então eu trataria como uma aposta de pesquisa com muito capital por trás — não como abordagem comprovada, por enquanto.
Embodied AI não é só um problema de engenharia robótica. Muito do trabalho — eu diria a maior parte — é de machine learning.
As habilidades que mais se transferem são:
Você não precisa de um robô para começar. A biblioteca gymnasium vem com ambientes MuJoCo, então, depois de rodar pip install "gymnasium[mujoco]", você pode executar todo o loop em um robô simulado:
import gymnasium as gym

# HalfCheetah é um robô 2D tipo guepardo, simulado com o engine de física MuJoCo
env = gym.make("HalfCheetah-v5")
observation, info = env.reset(seed=42)

for step in range(1000):
    # Percepção: observation contém ângulos e velocidades das juntas
    # Raciocínio: uma política treinada escolheria a ação aqui; vamos sortear aleatoriamente
    action = env.action_space.sample()

    # Ação: aplicar torques nas juntas e avançar a física um passo
    observation, reward, terminated, truncated, info = env.step(action)

    if terminated or truncated:
        observation, info = env.reset()

env.close()
Por enquanto, o guepardo só se debate porque o passo de “raciocínio” é env.action_space.sample(), que escolhe uma ação aleatória toda vez.
Trocar essa única linha por uma política treinada é exatamente o papel do reinforcement learning — e eu recomendo tentar isso antes de partir para algo maior.
Embodied AI avança rápido, mas ainda tropeça em 4 pontos — e vale conhecê-los:
Embodied AI dá às máquinas um corpo físico e a inteligência para usá-lo. Funciona com o ciclo percepção–raciocínio–ação, é limitada principalmente pela escassez de dados físicos e, em 2026, está saindo dos laboratórios para armazéns e os primeiros pilotos de fábrica.
O que mais me surpreende é como a pergunta mudou. Anos atrás, muita gente se perguntava se LLMs tornariam a pesquisa em robótica irrelevante. Em vez disso, LLMs estão virando a camada de raciocínio dentro dos sistemas embodied — e os dois campos estão se encontrando.
Lembra da maçã do começo? Saber como pegar e realmente pegar se mostraram problemas bem diferentes — e embodied AI é a área que trabalha no segundo.
Se você quer construir as bases de ML para isso, comece com nossa trilha de aprendizado Reinforcement Learning em Python. Para a camada de linguagem, nosso curso Large Language Models (LLMs) Concepts e a trilha Developing Large Language Models são ótimos próximos passos.
Principais cursos da DataCamp
Curso
Curso
Programa
blog
blog
Abid Ali Awan
5 min
blog
Adel Nehme
15 min
blog
Nisha Arya Ahmed
12 min
blog
Abid Ali Awan
5 min
Tutorial
Zoumana Keita
12 min