Kurs
Deep Reinforcement Learning in Python
4 Std.
6K
Stell dir vor, du bittest eine Freundin, dir einen Apfel aus einer Obstschale zu geben. Sie schaut in die Schale, erkennt den Apfel und hebt ihn so vorsichtig auf, dass er nicht zerdrückt wird, bevor sie ihn dir reicht.
Nun bitte einen Chatbot um dasselbe. Er kann dir genau beschreiben, wie man einen Apfel aufhebt, welche Finger man benutzt und wie fest man zudrückt – aber er kann keinen Apfel hochheben. Er hat keine Hände und keine Vorstellung davon, wie sich ein Apfel anfühlt.
Embodied AI versucht, diese Lücke zu schließen. Kurz gesagt ist es KI mit einem physischen Körper (zum Beispiel ein Roboter, ein Auto oder eine Drohne), die durch Handeln in der realen Welt lernt, anstatt nur darüber zu lesen. Du wirst auch den verwandten Begriff „Physical AI“ für dieselbe Idee sehen.
Aktuell erlebt das Feld einen großen Aufschwung. Auf der CES im Januar 2026 nannte NVIDIAs Jensen Huang es „den ChatGPT-Moment für die Robotik“.
Und das Geld folgt. Laut von CNBC zitierten Dealroom-Daten sammelten Robotikfirmen bis Anfang Juni 2026 55,8 Milliarden US-Dollar ein – nahezu doppelt so viel wie der bisherige Jahresrekord.
In diesem Artikel erfährst du:
Keine Sorge, wenn du noch nie mit einem Roboter gearbeitet hast. Etwas Vertrautheit mit Machine Learning hilft, aber ich baue jedes Konzept von Grund auf auf, sodass du gut folgen kannst.
Embodied AI ist ein KI-System in einem physischen Körper wie einem Roboter, einem autonomen Fahrzeug oder einer Drohne, das seine Umgebung über Sensoren wahrnimmt, über das nächste Vorgehen schließt und über Motoren auf die Welt einwirkt – und aus den Ergebnissen der eigenen Aktionen lernt.
Das entscheidende Wort ist embodied – verkörpert.
Die meisten KI-Modelle lernen, indem sie beobachtete Daten verarbeiten, die jemand anders gesammelt hat. Ein verkörpertes System lernt durch Interaktion mit seiner Umgebung, etwa indem es eine Tasse schiebt, beobachtet, wie sie rutscht, und sein Wissen darüber aktualisiert, wie sich Tassen beim Schieben verhalten.
Ein Beispiel: Ein Vision-Modell, das auf Millionen Türfotos trainiert wurde, weiß, wie eine Tür aussieht. Ein Roboter, der tatsächlich 500 Türen zu öffnen versucht hat, weiß, dass manche Türen drücken, manche ziehen, manche schwer sind und manche Klinken haben, die man erst herunterdrücken muss.
Diese Tiefe erreichst du nicht mit einem Foto.
Ich formuliere es gern so: Die meisten KI-Systeme lernen über die Welt, indem sie über sie lesen; Embodied AI lernt über die Welt, indem sie sie berührt und erlebt.
Dieser eine Unterschied verändert die benötigten Daten, das Training und die Arten von Fehlern.
Bis hierhin habe ich Embodied AI mit einem Chatbot verglichen. Jetzt vergleichen wir sie mit den zwei Dingen, mit denen sie oft verwechselt wird: großen Sprachmodellen (LLMs) und traditioneller, regelbasierter Robotik.
| Embodied AI | Large Language Models (LLMs) | Traditionelle, regelbasierte Robotik | |
|---|---|---|---|
| Lernt aus der Umgebung | Ja, über Interaktion und Feedback | Meist nein, lernt aus einem festen Textkorpus | Nein, Verhalten ist von Hand programmiert |
| Führt physische Aktionen aus | Ja | Nein | Ja |
| Trainiert auf Internetdaten | Teilweise (Vision- und Sprach-Backbones) | Ja, Billionen Tokens | Nein |
| Generalisiert auf neue Umgebungen | Mäßig, mit schneller Verbesserung | Gut, innerhalb von Sprachaufgaben | Schwach, bricht bei geändertem Setup |
| Kommerzielle Reife 2026 | Frühe Produktion (Lager, Fabrikpiloten) | Reif und weit verbreitet | Reif, seit Jahrzehnten in Fabriken |
Die letzten zwei Zeilen möchte ich hervorheben.
Regelbasierte Industrieroboterarme schweißen seit Jahrzehnten Autos und sind extrem zuverlässig – aber nur, weil sich in ihrer Zelle nie etwas ändert. Embodied AI versucht, diese Zuverlässigkeit zu bewahren und gleichzeitig die Welt unordentlich sein zu lassen – Forschende nennen das Generalisierung.
LLMs und Embodied AI lernen beide aus sehr vielen Daten, lösen aber grundverschiedene Probleme. Ein LLM nimmt Text auf und sagt das nächste Token vorher; ein verkörpertes System nimmt Kamerabilder, Gelenkwinkel und Tastsinn auf und sagt die nächste Bewegung vorher.
Kurz: LLMs wissen über die physische Welt Bescheid, während Embodied AI in ihr handelt. Zurück zum Apfel: Ein LLM kann genau beschreiben, wie man ihn aufnimmt, und ein Embodied-AI-Roboter kann es wirklich tun.
Auch die Kosten eines Fehlers unterscheiden sich stark. Wenn ein LLM danebenliegt, entsteht ein seltsamer Satz. Wenn ein verkörpertes System danebenliegt, landet das Glas auf dem Boden – oder Schlimmeres.
Und hier der Punkt, den viele übersehen: Beide arbeiten zusammen.
In Vision-Language-Action (VLA)-Modellen sitzt ein vortrainiertes Vision-Language-Modell im Kern. Es liest die Kamerabilder und deine Anweisung („Lege das Obst in die Schale“) und übergibt sein Verständnis an einen Action-Decoder, der die eigentlichen Motorbefehle erzeugt.
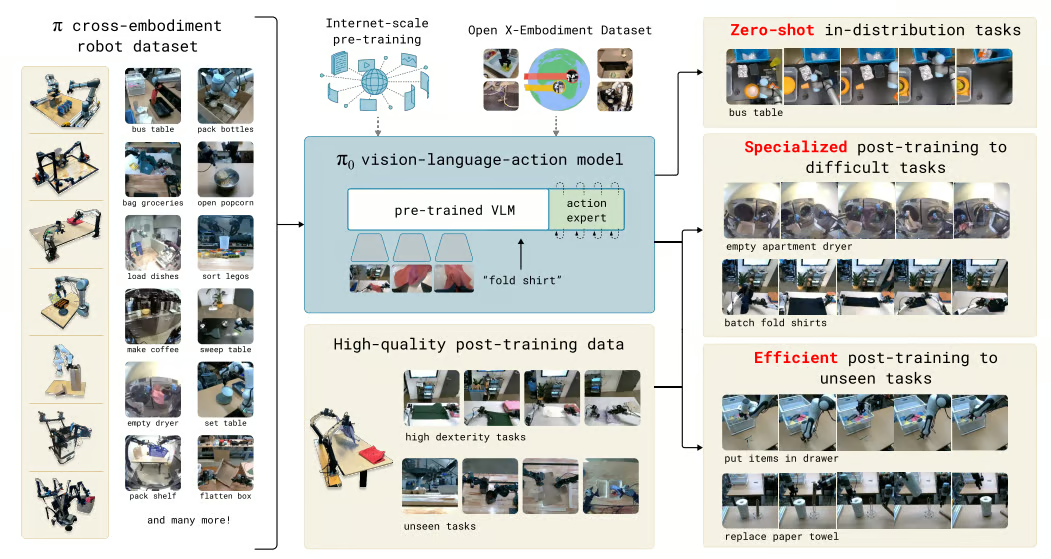
Wie ein vortrainiertes Vision-Language-Modell in π₀ (pi-zero) Robotaktionen ansteuert. Bildquelle: Black et al., 2024
Physical AI ist vor allem wegen der Daten schwieriger.
Sprachmodelle haben dank jahrzehntelanger, öffentlich geteilten Texte, Codes und Bilder schnell Fortschritte gemacht. Für reale Sensordaten gibt es keine vergleichbare Quelle. Es gibt viel weniger Ströme von Gelenkwinkeln, Kraftmessungen und Kamerabildern von Robotern, die mit Alltagsobjekten interagieren.
Schauen wir uns die Datenanforderungen genauer an. Ein verkörpertes System braucht drei Arten schwer zu beschaffender Daten:
Jetzt Zahlen dazu.
Frontrunner-LLMs werden auf Billionen Tokens trainiert. Open X-Embodiment, eines der größten offenen Robotik-Datensets, bündelte Daten von 22 Robotertypen über 21 Institutionen und kam auf etwas über 1 Million reale Trajektorien.
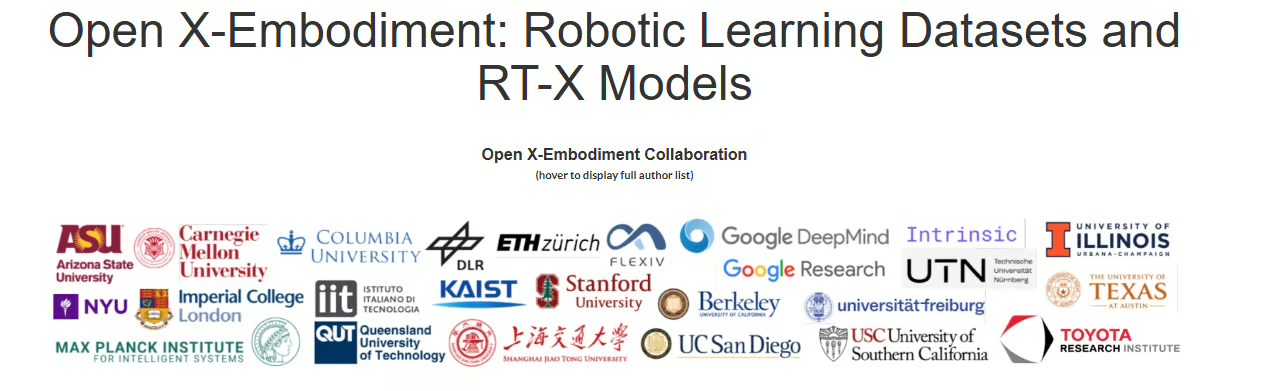
Die in Open X-Embodiment gebündelten Roboter und Aufgaben. Bildquelle: Open X-Embodiment Collaboration, 2023
Warum so wenig? Jede Trajektorie erfordert einen echten Roboter bei einer echten Aufgabe, meist per Teleoperation durch Menschen gesteuert – langsam und teuer.
Diese Lücke erklärt auch, warum Physical AI langsamer generalisiert als digitale KI. Modelle kommen am besten mit Variation zurecht, wenn sie Ähnliches schon gesehen haben. Eine Million Trajektorien decken deutlich weniger Küchen, Lichtsituationen und Objektformen ab als Billionen Tokens Sätze.
Behalte dieses Datenproblem im Hinterkopf. Viele Designentscheidungen unten – von Simulation über Domain Randomization bis zum Einsatz vortrainierter Vision-Language-Backbones – sind Workarounds dafür.
Embodied AI arbeitet in einem ständigen Loop aus drei Phasen:
Dieser Loop läuft viele Male pro Sekunde. Jede Bewegung verändert, was der Roboter als Nächstes wahrnimmt. Die Ausgabe eines Zyklus wird so zum Eingang des nächsten.
Der gleiche Loop steckt hinter World Models. Ha und Schmidhuber teilten 2018 einen Agenten in ein Vision-, ein Speicher- und ein Controller-Modul und testeten ihn an einem Auto in einem Rennspiel. Embodied AI überträgt die Idee auf einen vollwertigen Roboter.
Am besten verständlich wird es beim Ballfangen:
Ein Roboter macht dasselbe – nur mit Kameras statt Augen und Motoren statt Muskeln.
Schauen wir uns die Phasen im Einzelnen an.
Wahrnehmung übersetzt rohe Sensorsignale in etwas, womit der Rest des Systems arbeiten kann. Eine einzelne Kamera reicht selten, deshalb kombinieren Roboter mehrere Sensoren:
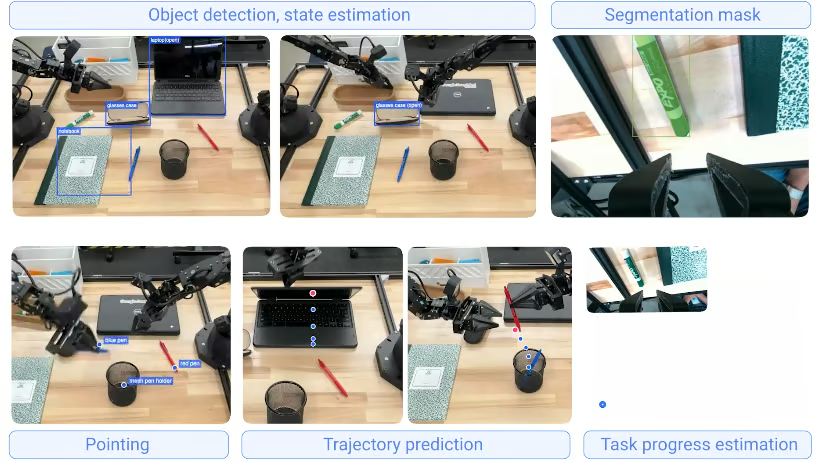
Beispiele für Wahrnehmungsausgaben von Gemini Robotics-ER 1.5. Bildquelle: Google DeepMind
Perzeptionsmodelle übersetzen diese Messungen in Räumekarten, Objektidentitäten, Hindernispositionen und ein allgemeines Verständnis der Szene.
Vieles ist Standard-Computer Vision, etwa Objekterkennung, Segmentierung und Tiefenschätzung, meist auf vortrainierten Vision-Transformern wie DINOv2 oder SigLIP.
Meiner Meinung nach ist Tastsinn aktuell der unterschätzteste Teil der Wahrnehmung. Eine Kamera sagt dir, dass ein Glas auf dem Tisch steht; der Tastsinn sagt dir, dass es dir aus der Hand zu rutschen beginnt.
Zum Einordnen: XELA Robotics zeigte auf der Automate 2026 eine robotische Fingerspitze mit 30 dreiachsigen Kraftmesspunkten im Fingerpad. Laut Unternehmen können uSkin-Sensoren Krafte ab 0,1 Grammkraft erkennen.
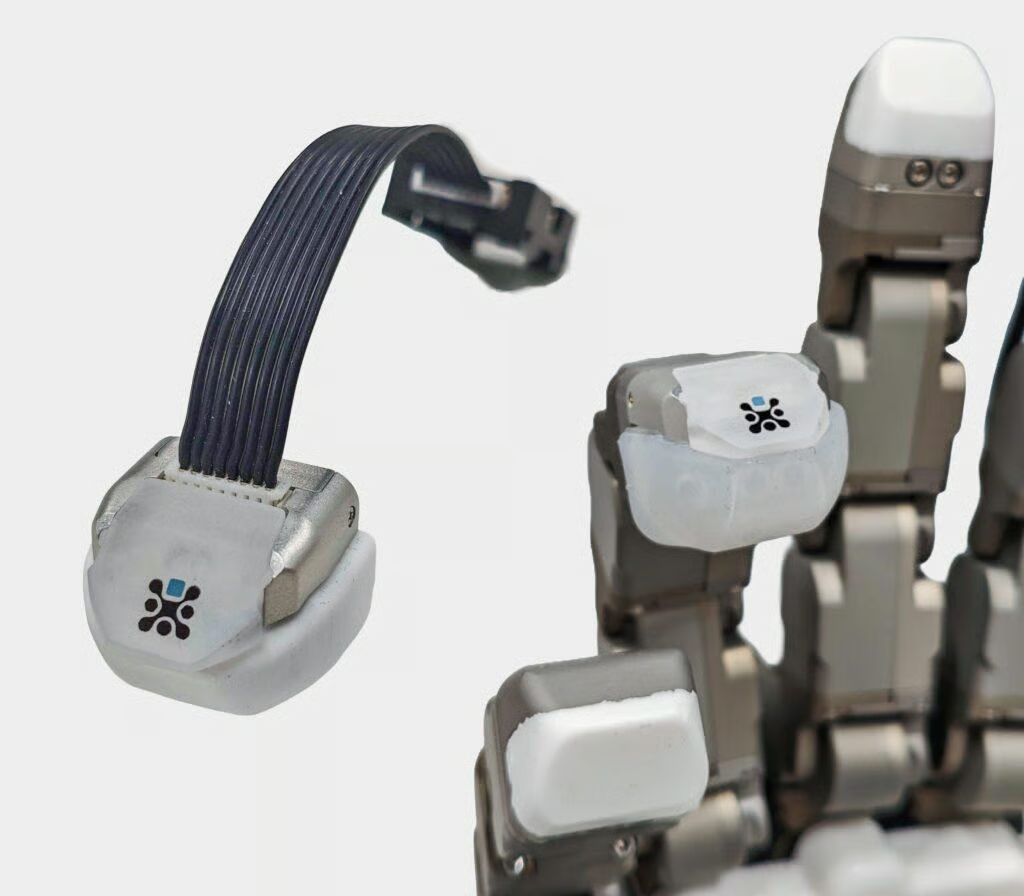
Eine uSkin-Fingerspitze mit einem Array dreiachsiger Tastsensorpunkte. Bildquelle: XELA Robotics
Schlussfolgern entscheidet über den nächsten Schritt. In neueren Systemen besteht es meist aus zwei Ebenen:
World Models ermöglichen es dem Roboter, erst zu „vorstellen“ und dann zu handeln.
DreamerV3 ist ein gutes Beispiel. Es lernt ein kompaktes Modell seiner Umgebung und trainiert seine Policy fast vollständig in dieser vorgestellten Welt.
Ich nutze DreamerV3 in meiner eigenen Forschung. Am meisten überrascht mich, wie viel mehr Zeit der Agent in seinem „Kopf“ übt als in der echten Umgebung. Das zählt, weil Training so schneller und viel günstiger wird.
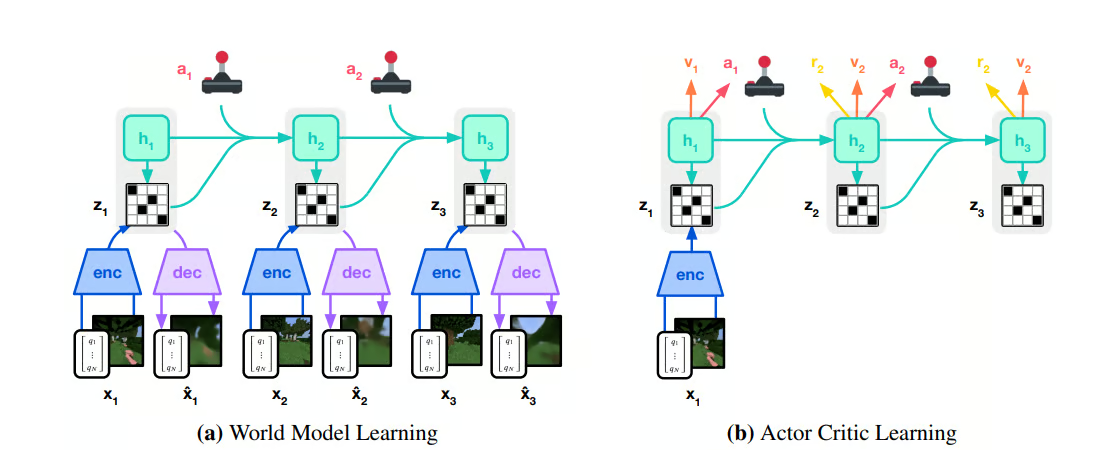
DreamerV3 trainiert seine Policy auf vorgestellten Rollouts aus dem World Model. Bildquelle: Hafner et al., 2023
Planung übernehmen dagegen zunehmend Sprachmodelle.
Ein gutes Beispiel ist Gemini Robotics-ER 1.5 von Google DeepMind als High-Level-Planer. Bei einer Aufgabe wie Mülltrennung nach lokalen Recyclingregeln kann es die Regeln via Google Search nachschlagen, die Aufgabe in Schritte zerlegen und jeden Schritt an das Gemini Robotics 1.5 VLA-Modell übergeben, das die physische Arbeit erledigt.
Du kannst dir das Sprachmodell als Manager vorstellen und das VLA-Modell als die Fachkraft, die die Arbeit ausführt.
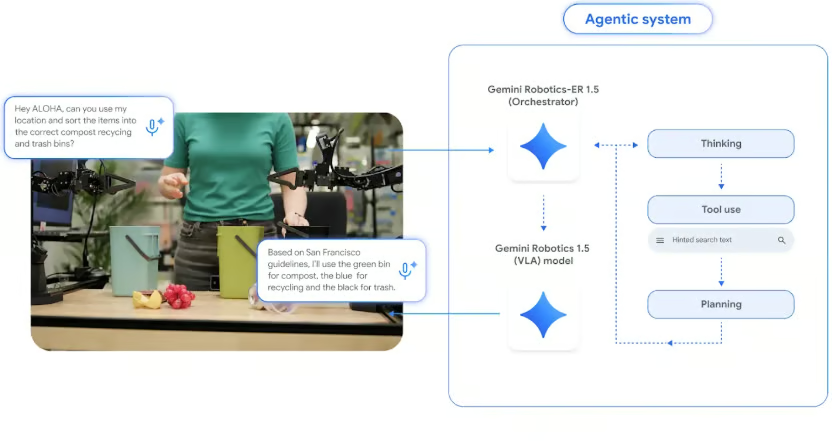
Gemini Robotics-ER 1.5 plant die Aufgabe und delegiert die Ausführung an die Gemini Robotics 1.5 VLA. Bildquelle: Google DeepMind, 2025
Handeln setzt Entscheidungen in präzise Befehle für jedes Gelenk und jeden Motor um – meist zig- bis hunderte Male pro Sekunde (in Hertz, Hz). Der Low-Level-Teil heißt Regelung.
Ein Befehl wie „Bewege den Greifer 5 cm nach links“ klingt simpel, muss auf einem 7-achsigen Arm aber in konkrete Drehmomente für jeden Gelenkmotor übersetzt und fortlaufend nachgeregelt werden, während sich der Arm bewegt.
Das Schwierige ist, dass die Realität selten der Erwartung entspricht. Objekte rutschen, Böden sind leicht uneben, das Licht ändert sich, wenn jemand die Jalousie öffnet, und ein Kabel biegt sich anders als vorhergesagt.
Ein guter Controller erkennt die Abweichung zwischen Erwartung und Wirklichkeit sofort und korrigiert direkt.
Ich halte Handeln für die schwerste Phase in unstrukturierten Umgebungen. Wahrnehmungsfehler kann man durch erneutes Hinschauen beheben, Planungsfehler durch Neuplanen – ein Regelungsfehler passiert in Echtzeit.
Embodied AI wird mit einer Mischung aus Simulation und realen Daten trainiert. Simulation bedeutet virtuelle Umgebungen mit physikalisch akkuraten 3D-Objekten, in denen ein Roboter Millionen Male üben kann, bevor er echte Hardware berührt.
Erinnerst du dich an das Datenproblem? Simulation ist einer der wichtigsten Workarounds, insbesondere für Reinforcement Learning von Fortbewegung und Manipulation. Foundation-Modelle wie π₀ stützen sich dennoch stark auf reale Demonstrationen, daher nutzen die meisten Teams beides.
Datensammeln in der realen Welt hat drei große Probleme:
Ein Simulator adressiert alle drei auf einmal. Du kannst Tausende virtueller Roboter parallel auf einer einzigen GPU laufen lassen und sie beliebig oft scheitern und neu starten. Das verdichtet Jahre Robotererfahrung in wenige Stunden.
Nicht jeder Simulator taugt gleich gut zum Trainieren. Aus eigener Arbeit mit Roboterarmen in Simulation würde ich sagen: Ein guter braucht drei Dinge:
Am häufigsten triffst du auf NVIDIA Isaac Sim (mit Isaac Lab) und MuJoCo:
| Plattform | Entwickler | Stärken | Am besten geeignet für |
|---|---|---|---|
| NVIDIA Isaac Sim und Isaac Lab | NVIDIA | Fotorealistisches Rendering, Sensorsimulation, Tausende parallele Umgebungen auf der GPU | Große RL-Läufe und synthetische Kameradaten |
| MuJoCo | Google DeepMind (Open Source) | Schnelle, genaue Kontaktphysik, leichtgewichtig, große Forschungsgemeinde | Forschung, Lokomotions- und Manipulations-Benchmarks |
Die neueste Ergänzung ist Newton, eine Open-Source, GPU-beschleunigte Physikengine von NVIDIA, Google DeepMind und Disney Research, verwaltet von der Linux Foundation.
Newton 1.0 wurde auf der NVIDIA GTC im März 2026 veröffentlicht. Es lässt sich als Physik-Backend in Isaac Lab einbinden, mit MuJoCo Warp als einem Solver und zusätzlichen Solvern für deformierbare Objekte wie Kabel und Stoff.
Deformierbare Objekte sind wichtiger, als sie klingen. Ältere Simulatoren haben Kabel und Textilien schlecht abgebildet, Fabriken brauchen aber Roboter, die beides beherrschen.
Die Sim-to-Real-Lücke ist der Leistungsabfall, wenn eine in Simulation trainierte Policy auf einen echten Roboter übertragen wird. Sie ist eines der größten Probleme verkörperter Systeme.
Beispielsweise stimmt simulierte Reibung nie ganz, simulierte Kameras sind zu sauber, simulierte Objekte zu perfekt. Eine Policy mit 95% Erfolg in der Simulation kann scheitern, sobald sie auf echte Hardware trifft.
Es gibt zwei Hauptansätze, um die Lücke zu schließen:
Statt den Simulator perfekt zu machen, wird er in vielen Dimensionen randomisiert.
Tobin et al. (2017) variierten Texturen und Beleuchtung so stark, dass die reale Welt für das Modell wie eine weitere Variation wirkte. OpenAIs Rubik’s-Cube-Roboterhand ging weiter und weitete die Randomisierung automatisch aus, je besser die Policy wurde.
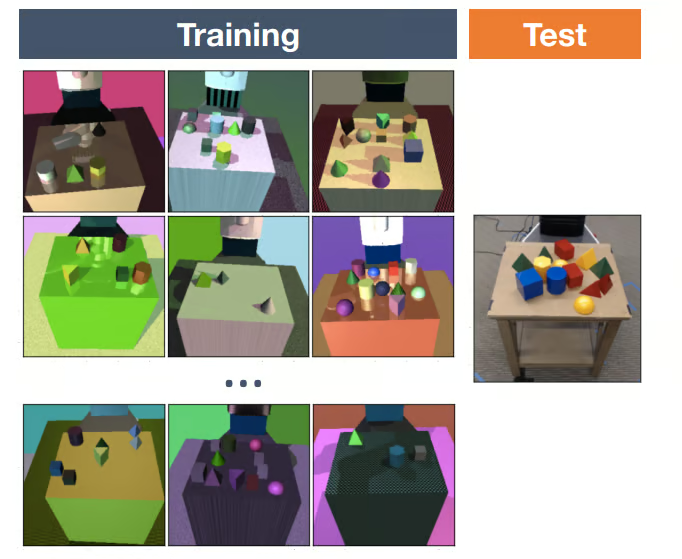
Eine in Simulation vortrainierte Policy braucht oft nur wenige reale Demonstrationen zur Adaption, weil sie die grobe Struktur der Aufgabe bereits gelernt hat.
Keiner der Ansätze beseitigt die Lücke vollständig, daher arbeiten Teams weiter daran, ihre Auswirkungen auf die reale Leistung zu verringern.
Embodied AI läuft inzwischen außerhalb von Laboren in mehreren Branchen – allerdings sehr ungleich verteilt.
Das Muster: Sie landet zuerst dort, wo sich die Umgebung zu stark verändert, um sie per Hand zu skripten, ein Mensch im Zweifel aber eingreifen kann.
Selbstfahrende Autos sind eine der datenhungrigsten Formen von Embodied AI.
Der Waymo Driver ist fast 200 Millionen vollautonome Meilen gefahren und trainiert und testet laut Waymos Beitrag vom Februar 2026 zu seinem World Model zudem auf Milliarden Simulationsmeilen. Simulation erlaubt Waymo, reale Vorfälle nachzuspielen und seltene Szenarien zu erzeugen (zum Beispiel ein Kind, das zwischen parkenden Autos hervorläuft), denen eine Testflotte auf der Straße nie begegnen könnte.
Selbstfahrende Autos sind auch ein gutes Beispiel für den kompletten Wahrnehmung–Schlussfolgerung–Handlungs-Loop: Ein Waymo-Fahrzeug nimmt mit Kameras, Lidar und Radar wahr, schließt, was Fußgänger und Fahrzeuge als Nächstes tun werden, und handelt, indem es Lenkung und Bremsen vielfach pro Sekunde steuert.
Meiner Meinung nach sind Lager derzeit das naheliegendste Einsatzfeld für Embodied AI.
Der Wandel geht von festgelegten Pfadrobotern, die Linien am Boden folgen, hin zu Systemen, die mit dynamischem, unaufgeräumtem Inventar zurechtkommen – etwa beim Picken aus einer Box mit 40 durcheinander liegenden Produkten.
Der humanoide Digit von Agility Robotics bewegt bei GXO Logistics Totes im Rahmen einer mehrjährigen Vereinbarung von 2024, und Boston Dynamics’ Stretch lädt Kisten aus LKWs.
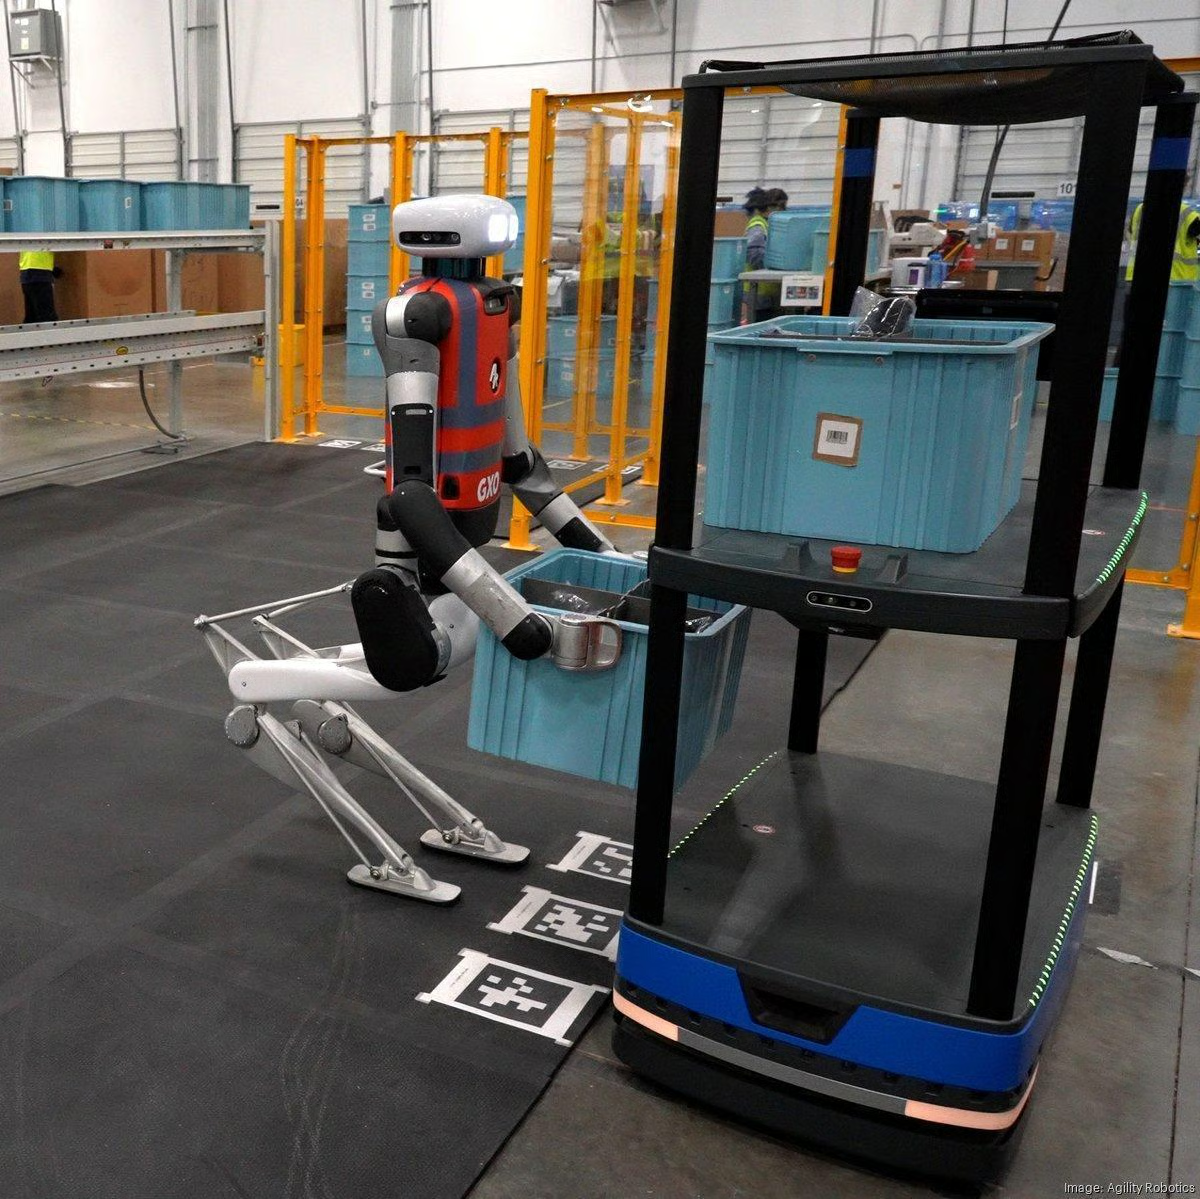
Agility Robotics’ Digit bewegt Totes zwischen autonomen mobilen Robotern und einem Förderband in einem GXO-Lager. Bildquelle: Agility Robotics/The Robot Report
Im Gesundheitswesen erwarte ich die vorsichtigste Entwicklung.
Chirurgische Systeme wie der da Vinci von Intuitive werden weltweit eingesetzt, werden aber von Chirurginnen und Chirurgen gesteuert. Die meiste KI-Forschung hier zielt auf Assistenz ab, etwa Instrumententracking, Kamerasteuerung und Nahtunterstützung.
Im Gesundheitswesen ist die Zulassung oft der größere Engpass als die Modellfähigkeit – zu Recht. Ich rechne mit Assistenz- und Trainingseinsätzen lange bevor irgendetwas in Richtung autonomer Chirurgie kommt.
Humanoide bekommen die meiste Aufmerksamkeit und sind zugleich am wenigsten bewiesen.
Auf der CES 2026 stellte Boston Dynamics die Produktversion von Atlas vor und sagte, dass alle 2026 gebauten Einheiten bereits für Hyundai und Google DeepMind verplant sind. Figure wiederum betrieb elf Monate lang seinen Figure 02 im BMW-Werk Spartanburg (South Carolina) zum Laden von Blechtafeln.
Ich will hier ehrlich sein: Die meisten humanoiden Einsätze sind noch Piloten mit engem Aufgabenspektrum. Hyundai plant etwa, Atlas ab 2028 für Teile-Sequenzierung einzusetzen – ein Zeichen, wie vorsichtig selbst die größten Unterstützer vorgehen.
Kommen wir zu den Akteuren. Fünf Organisationen, die Newcomer in Embodied AI kennen sollten:
| Organisation | Was sie bauen | Warum das zählt |
|---|---|---|
| NVIDIA | Isaac Sim, Isaac Lab, Newton, GR00T und Cosmos | Der Simulations- und Compute-Stack, auf dem die meisten Teams trainieren |
| Physical Intelligence | π₀-Familie von Robot-Foundation-Modellen | Allzweck-Roboter-Policies mit offenen Checkpoints |
| Agility Robotics | Humanoid Digit | Für Lagerlogistik gebaut und bereits mit Kundeneinsätzen |
| Boston Dynamics | Atlas, Stretch und Spot | Führt Atlas 2026 von Forschungsdemos zu Produktionseinheiten |
| AMI Labs (Yann LeCun) | JEPA-Style World Models | Eine konträre Wette auf World Models ohne Pixelgenerierung |
NVIDIA baut überwiegend die Werkzeuge rund um den Roboter statt den Roboter selbst.
Isaac Sim liefert fotorealistische Simulation, Isaac Lab RL auf dieser Basis, und Newton stellt nun die Physik. Viele Robotikteams trainieren auf NVIDIA-Software, obwohl NVIDIA keinen Allzweckroboter verkauft.
Physical Intelligence hat π₀ entwickelt, ein 3,3-Milliarden-Parameter-Vision-Language-Action-Modell, das Flow Matching nutzt, um glatte Aktionssequenzen für Aufgaben wie Wäschefalten zu erzeugen.
Es ist das beste Beispiel für ein Allzweck-Robotermodell, das du über das openpi-Repository tatsächlich herunterladen kannst.
Wenn der Begriff „Foundation Model“ für dich neu ist, erklärt unsere Introduction to Foundation Models den Ansatz gut.
Agility Robotics hat mit Digit den fokussierten Weg gewählt.
Von Tag eins um das Bewegen von Totes in Lagern herum entworfen, ist dieser Fokus ein wesentlicher Grund, warum Digit früher als die meisten Humanoiden zahlende Kunden erreichte.
Boston Dynamics wählte mit Atlas den Gegenentwurf.
Jahrelang wurden die athletischen Grenzen des Roboters ausgelotet (du kennst die Parkour-Videos), bevor er als vollelektrisches Fabrikprodukt ausgebaut wurde, das Google DeepMind mit seinen Gemini-Robotics-Modellen antreiben will.
AMI Labs ist Yann LeCuns Pariser Startup, das im März 2026 eine Seed-Runde über 1,03 Milliarden US-Dollar zu einer Pre-Money-Bewertung von 3,5 Milliarden US-Dollar abschloss. Co-geführt von Cathay Innovation, Greycroft, Hiro Capital, HV Capital und Bezos Expeditions; unter den weiteren Investoren NVIDIA und Samsung.
LeCun argumentiert seit Jahren, dass die Vorhersage jedes Pixels der Zukunft ineffizient ist. Seine Joint Embedding Predictive Architecture (JEPA) sagt stattdessen in einem abstrakten Repräsentationsraum voraus – eine Idee, die Meta bereits mit V-JEPA 2 testete.
Spannend an AMI ist der bewusste Gegenkurs zum Mainstream. Bisher wurde nichts ausgeliefert, daher würde ich es vorerst als forschungsgetriebene Wette mit viel Kapital sehen, nicht als bewiesenen Ansatz.
Embodied AI ist nicht nur ein Robotik-Engineering-Thema. Vieles, ich würde sagen das meiste, ist Machine-Learning-Arbeit.
Diese Kompetenzen übertragen sich am direktesten:
Du brauchst keinen physischen Roboter zum Einstieg. Die Bibliothek gymnasium bringt MuJoCo-Umgebungen mit. Nach pip install "gymnasium[mujoco]" kannst du den gesamten Loop auf einem simulierten Roboter ausführen:
import gymnasium as gym

# HalfCheetah is a 2D cheetah-like robot simulated with the MuJoCo physics engine
env = gym.make("HalfCheetah-v5")
observation, info = env.reset(seed=42)

for step in range(1000):
    # Perception: the observation holds joint angles and velocities
    # Reasoning: a trained policy would choose the action here, we pick randomly
    action = env.action_space.sample()

    # Action: apply torques to the joints and move the physics forward one step
    observation, reward, terminated, truncated, info = env.step(action)

    if terminated or truncated:
        observation, info = env.reset()

env.close()
Momentan rudert der Gepard nur planlos, denn der „Schlussfolgerungs“-Schritt ist env.action_space.sample() und wählt jedes Mal zufällig.
Diese eine Zeile durch eine trainierte Policy zu ersetzen, ist genau der Job von Reinforcement Learning. Ich empfehle, das auszuprobieren, bevor du zu Größerem übergehst.
Embodied AI macht Tempo, hat aber noch vier klare Schwächen, die du kennen solltest:
Embodied AI gibt Maschinen einen physischen Körper und die Intelligenz, ihn zu nutzen. Sie funktioniert über den Wahrnehmung–Schlussfolgerung–Handlungs-Loop, wird vor allem durch den Mangel an physischen Daten gebremst und wandert 2026 aus Forschungslaboren in Lager und die ersten Fabrikpiloten.
Überraschend ist für mich, wie sich die Frage verschoben hat. Vor ein paar Jahren hieß es, LLMs könnten Robotikforschung überflüssig machen. Stattdessen werden LLMs zur Schlussfolgerungsschicht in verkörperten Systemen, und beide Felder wachsen zusammen.
Erinnerst du dich an den Apfel vom Anfang? Zu wissen, wie man ihn aufhebt, und ihn wirklich aufzuheben, sind zwei verschiedene Probleme – und Embodied AI arbeitet am zweiten.
Wenn du die ML-Grundlagen dafür aufbauen willst, starte mit unserem Reinforcement Learning in Python-Lernpfad. Für die Sprachseite sind unser Kurs Large Language Models (LLMs) Concepts und der Lernpfad Developing Large Language Models gute nächste Schritte.
Top-DataCamp-Kurse
Kurs
Kurs
Lernpfad
Blog
Blog
Hesam Sheikh Hassani
15 Min.
Blog
Zoumana Keita
15 Min.
Blog
Nathaniel Taylor-Leach
4 Min.
Tutorial
Laiba Siddiqui
6 Min.
Tutorial
Derrick Mwiti
10 Min.