Cours
Apprentissage par renforcement profond en Python
4 h
6K
Imaginez que vous demandiez à un ami de vous tendre une pomme depuis un saladier. Il regarde le saladier, repère la pomme et la saisit avec assez de délicatesse pour ne pas l’écraser avant de vous la donner.
Maintenant, demandons la même chose à un chatbot. Il peut vous expliquer exactement comment saisir une pomme, quels doigts utiliser et à peu près quelle force exercer, mais il ne peut pas réellement la prendre. Il n’a ni mains ni idée de ce que ressent une pomme au toucher.
L’IA incarnée est le domaine qui cherche à combler cet écart. En termes simples, c’est une IA dotée d’un corps physique (comme un robot, une voiture ou un drone) qui apprend en agissant dans le monde réel plutôt qu’en se contentant d’en lire des descriptions. Vous verrez aussi le terme voisin « IA physique » pour désigner la même idée.
En ce moment, le domaine connaît un tournant. Au CES en janvier 2026, Jensen Huang de NVIDIA l’a qualifié de « moment ChatGPT pour la robotique ».
L’argent a suivi. D’après Dealroom, cité par CNBC, les entreprises de robotique ont levé 55,8 milliards de dollars en 2026 à début juin, soit près du double du précédent record annuel.
Dans cet article, je vais aborder :
Pas d’inquiétude si vous n’avez jamais travaillé avec un robot. Des notions de machine learning aident, mais je reconstruirai chaque idée depuis les bases pour que vous puissiez suivre dans tous les cas.
L’IA incarnée est un système d’intelligence artificielle intégré dans un corps physique, comme un robot, un véhicule autonome ou un drone, qui perçoit son environnement via des capteurs, raisonne sur ce qu’il faut faire et agit sur le monde via des moteurs, en apprenant des conséquences de ses propres actions.
Le terme clé ici est incarnée.
La plupart des modèles d’IA apprennent en observant des données collectées par d’autres. Un système incarné apprend en interagissant avec son environnement, par exemple en poussant une tasse, en la voyant glisser et en mettant à jour ce qu’il sait sur le comportement des tasses lorsqu’on les pousse.
Voici un exemple. Un modèle de vision entraîné sur des millions de photos de portes sait à quoi ressemble une porte. Un robot qui a réellement tenté d’ouvrir 500 portes sait que certaines se poussent, d’autres se tirent, que certaines sont lourdes et que certaines ont des poignées qu’il faut d’abord abaisser.
On n’obtient pas cette profondeur de connaissance à partir d’une photo.
Je le formule ainsi : la plupart des IA apprennent le monde en lisant à son sujet ; l’IA incarnée apprend le monde en le touchant et en l’expérimentant.
Cette différence change le type de données nécessaires, la façon d’entraîner et les manières dont les choses peuvent mal tourner.
Jusqu’ici, j’ai comparé l’IA incarnée à un chatbot. Comparons-la maintenant aux deux choses avec lesquelles on la confond le plus souvent : les grands modèles de langage (LLM) et la robotique traditionnelle basée sur des règles.
| IA incarnée | Grands modèles de langage (LLM) | Robotique traditionnelle à règles | |
|---|---|---|---|
| Apprend de l’environnement | Oui, par interaction et retour | Plutôt non, apprend d’un corpus de texte figé | Non, le comportement est programmé à la main |
| Réalise des actions physiques | Oui | Non | Oui |
| S’entraîne sur des données internet | En partie (ses backbones vision et langage) | Oui, des trillions de tokens | Non |
| Généralise à de nouveaux environnements | Modérément, et progresse vite | Bien, dans les tâches de langage | Mal, casse si la configuration change |
| Maturité commerciale en 2026 | Production naissante (entrepôts, pilotes en usine) | Mature et largement déployée | Mature, des décennies d’usage en usine |
Ce sont les deux dernières lignes que je veux mettre en avant.
Les bras industriels à règles soudent des voitures depuis des décennies, avec une fiabilité extrême, mais seulement parce que rien ne change jamais dans leur cellule de travail. L’IA incarnée tente de conserver cette fiabilité tout en acceptant le désordre du monde, ce que les chercheurs appellent la généralisation.
Les LLM et l’IA incarnée apprennent tous deux à partir de grandes quantités de données, mais ils résolvent des problèmes très différents. Un LLM reçoit du texte et prédit le prochain token, tandis qu’un système incarné reçoit des images caméra, des angles d’articulation et des lectures tactiles, et prédit le prochain mouvement.
En bref, les LLM connaissent le monde physique, tandis que l’IA incarnée agit dedans. Revenons à notre pomme : un LLM peut décrire exactement comment la saisir, et un robot d’IA incarnée peut réellement le faire.
Le coût d’une erreur est aussi très différent. Si un LLM se trompe, vous obtenez une phrase un peu étrange. Si un système incarné se trompe, un verre peut finir au sol, ou pire.
Voici maintenant la partie que beaucoup manquent selon moi : les deux fonctionnent ensemble.
Dans les modèles vision–langage–action (VLA), un modèle vision–langage préentraîné est au cœur du système. Il lit les images caméra et votre instruction (« mets les fruits dans le saladier »), puis transmet sa compréhension à un décodeur d’actions qui génère les commandes moteur.
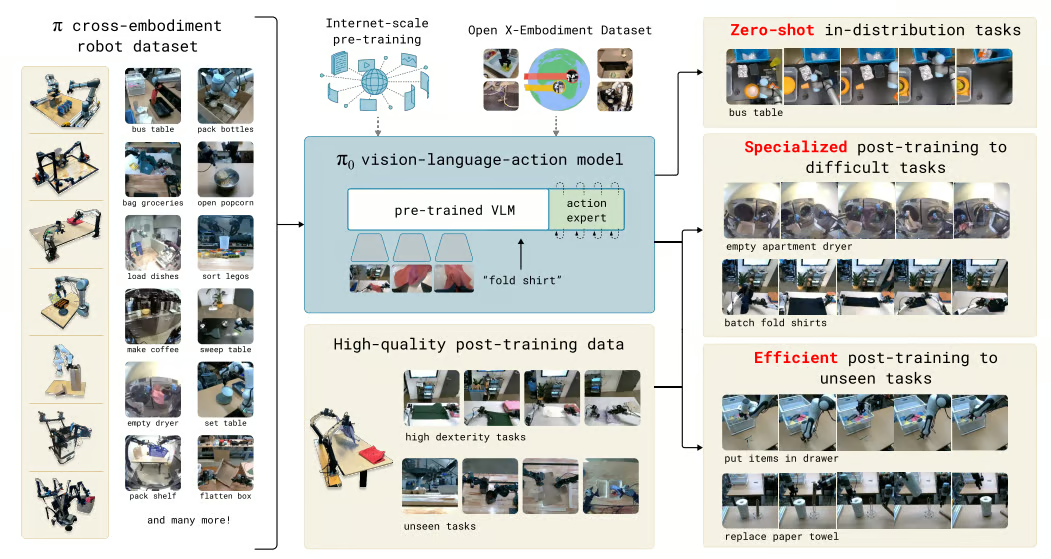
Comment un modèle vision–langage préentraîné se connecte aux actions du robot dans π₀ (pi-zero). Image source : Black et al., 2024
L’IA physique est plus difficile que l’IA numérique principalement à cause des données.
Les modèles de langage ont progressé rapidement grâce à des décennies de partage de textes, de code et d’images en ligne, mais il n’existe pas de source comparable de données issues de capteurs réels. Il y a bien moins de flux d’angles d’articulation, de forces et d’images de robots interagissant avec des objets du quotidien.
Regardons de plus près les besoins en données. Un système incarné a besoin de 3 types de données difficiles à obtenir :
Passons maintenant aux ordres de grandeur.
Les LLM de pointe sont entraînés sur des trillions de tokens. Open X-Embodiment, l’un des plus grands jeux de données ouverts en robotique, a agrégé des données provenant de 22 types de robots dans 21 institutions et a abouti à un peu plus d’un million de trajectoires réelles.
Les robots et tâches rassemblés dans le jeu de données Open X-Embodiment. Image source : Open X-Embodiment Collaboration, 2023
Pourquoi si peu ? Chaque trajectoire nécessite un vrai robot exécutant une vraie tâche, généralement piloté par un humain en téléopération, ce qui est lent et coûteux.
Cet écart explique aussi pourquoi l’IA physique généralise plus lentement que l’IA numérique. Un modèle gère mieux la variation lorsqu’il a déjà vu quelque chose de similaire, et un million de trajectoires couvrent bien moins de cuisines, d’éclairages et de formes d’objets que des trillions de tokens couvrent de phrases.
Gardez ce problème de données en tête pour la suite. Bon nombre des choix de conception que vous verrez ci-dessous — de la simulation à la randomisation de domaine en passant par l’emprunt de backbones vision–langage préentraînés — en sont des palliatifs.
L’IA incarnée fonctionne en exécutant en continu une boucle en 3 étapes :
Cette boucle se répète plusieurs fois par seconde, et chaque mouvement modifie ce que le robot perçoit ensuite : la sortie d’un cycle devient l’entrée du suivant.
La même boucle sous-tend les modèles du monde. L’article « World Models » (2018) de Ha et Schmidhuber découpe un agent en module de vision, module mémoire et contrôleur, et le teste sur une voiture dans un jeu de course. L’IA incarnée applique la même idée à un robot complet.
Une bonne manière de comprendre la boucle est d’imaginer rattraper une balle :
Un robot fait la même chose, avec des caméras plutôt que des yeux et des moteurs plutôt que des muscles.
Voyons chaque étape à son tour.
La perception transforme les lectures brutes des capteurs en informations exploitables par le reste du système. Une seule caméra suffit rarement, donc la plupart des robots combinent plusieurs capteurs :
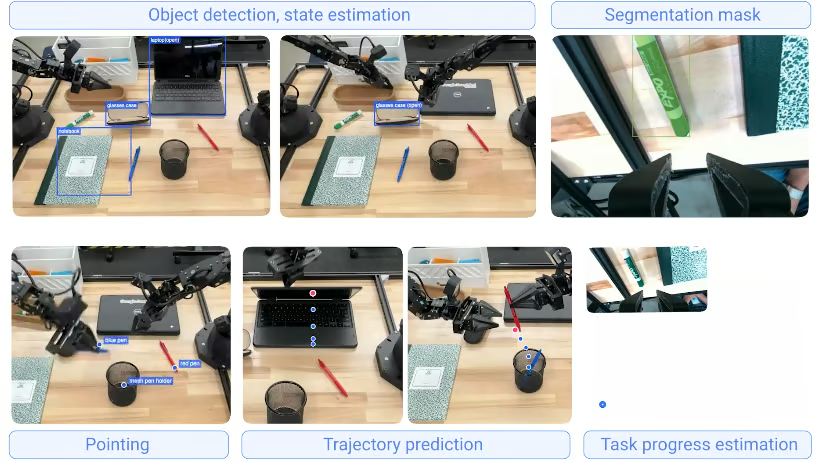
Exemples de sorties de perception de Gemini Robotics-ER 1.5. Image source : Google DeepMind
Les modèles de perception convertissent ensuite ces lectures en cartes spatiales, identités d’objets, positions d’obstacles et compréhension générale de la scène.
La plupart relèvent de la vision par ordinateur classique, comme la détection d’objets, la segmentation et l’estimation de profondeur, généralement bâties sur des transformers de vision préentraînés comme DINOv2 ou SigLIP.
À mon avis, toutefois, le toucher est aujourd’hui la partie la plus sous-estimée de la perception. Une caméra peut indiquer qu’il y a un verre sur la table, mais le toucher révèle que le verre commence à glisser de votre prise.
Pour situer l’état de l’art, XELA Robotics a présenté au salon Automate 2026 un bout de doigt robotique avec 30 points de mesure de force triaxiale intégrés dans la pulpe. L’entreprise indique aussi que ses capteurs uSkin peuvent détecter des forces aussi faibles que 0,1 gramme-force.
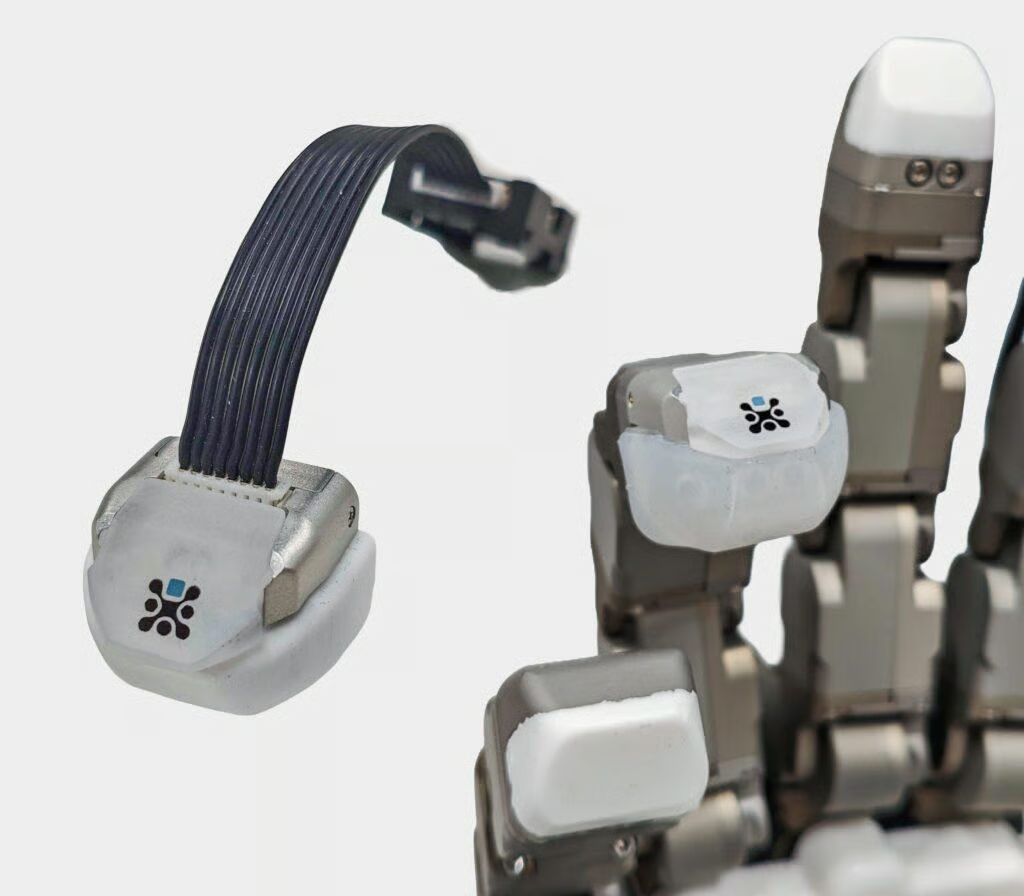
Un bout de doigt robotique uSkin intégrant un réseau de points de détection tactile triaxiale. Image source : XELA Robotics
Le raisonnement décide de la prochaine action. Dans les systèmes récents, il comporte généralement 2 couches :
Les modèles du monde permettent au robot d’imaginer avant d’agir.
DreamerV3 est un bon exemple. Il apprend un modèle compact de son environnement puis entraîne presque entièrement sa politique à l’intérieur de ce monde imaginé.
Je l’utilise dans mes propres recherches, et ce qui m’a le plus surpris est le temps passé par l’agent à s’exercer « dans sa tête » plutôt que dans l’environnement réel. C’est important car l’entraînement devient plus rapide et bien moins coûteux.
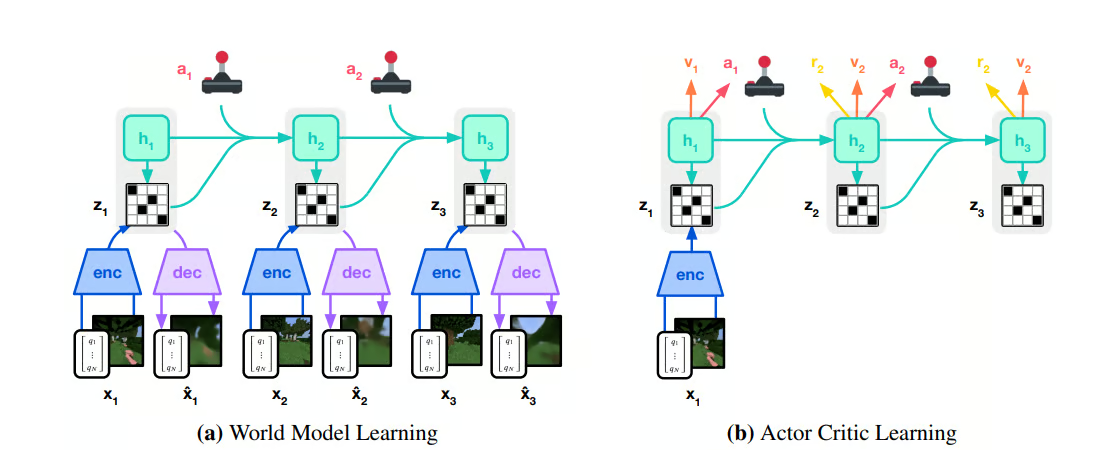
DreamerV3 entraîne sa politique sur des déploiements imaginés issus de son modèle du monde. Image source : Hafner et al., 2023
La planification, elle, est de plus en plus pilotée par des modèles de langage.
Un bon exemple est Gemini Robotics-ER 1.5 de Google DeepMind, qui agit comme planificateur de haut niveau. Pour une tâche comme trier des déchets selon les règles locales de recyclage, il peut consulter les règles avec Google Search, découper le travail en étapes et confier chaque étape au modèle VLA Gemini Robotics 1.5 qui exécute physiquement.
Pensez au modèle de langage comme au manager, et au modèle VLA comme à l’opérateur qui réalise la tâche.
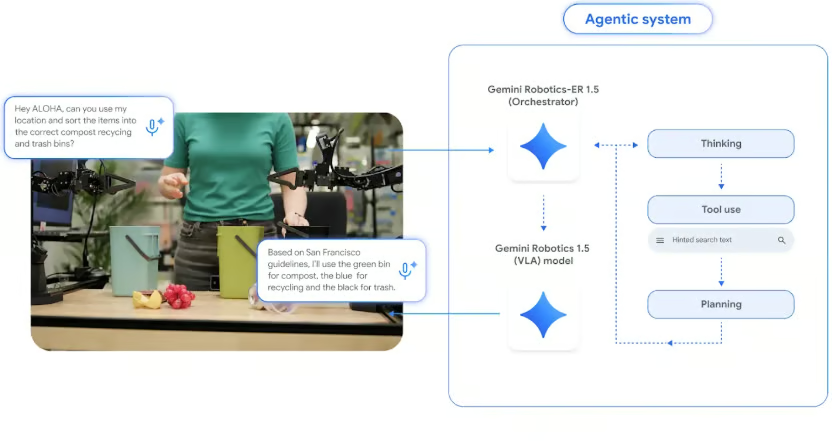
Gemini Robotics-ER 1.5 planifie la tâche et délègue l’exécution physique au VLA Gemini Robotics 1.5. Image source : Google DeepMind, 2025
L’action convertit une décision en commandes précises pour chaque articulation et moteur, généralement des dizaines à des centaines de fois par seconde (en hertz, ou Hz). La partie bas niveau s’appelle le contrôle.
Par exemple, une commande comme « Déplacez la pince de 5 cm vers la gauche » semble simple, mais sur un bras à 7 articulations, elle doit devenir un couple spécifique pour chaque moteur, recalculé en continu au fil du mouvement.
La difficulté tient au fait que la réalité ne correspond presque jamais exactement à ce que le robot attendait. Les objets glissent, les sols sont légèrement irréguliers, la lumière change quand on ouvre un store et un câble se plie différemment que prévu.
Un bon contrôleur détecte l’écart entre l’attendu et le réel, puis corrige immédiatement.
Je pense que l’action est l’étape la plus difficile à maîtriser dans des environnements désordonnés et non structurés. Une erreur de perception peut se corriger en regardant à nouveau, une erreur de planification en replanifiant, mais une erreur de contrôle se produit en temps réel.
L’IA incarnée est entraînée sur un mélange de simulation et de données réelles. La simulation désigne des environnements virtuels remplis d’objets 3D avec une physique fidèle, où un robot peut s’exercer des millions de fois avant de toucher le matériel réel.
Souvenez-vous du problème de données vu plus haut : la simulation est l’un des principaux palliatifs, notamment pour l’apprentissage par renforcement de la locomotion et de la manipulation. Les modèles fondamentaux comme π₀ s’appuient encore fortement sur des démonstrations réelles, donc la plupart des équipes combinent les deux.
La collecte de données dans le monde réel pose 3 gros problèmes :
Un simulateur répond aux 3 à la fois. Vous pouvez exécuter des milliers de robots virtuels en parallèle sur un seul GPU et les laisser échouer et redémarrer autant que nécessaire. Cela condense des années d’expérience robotique en quelques heures.
Les simulateurs ne se valent pas tous pour l’entraînement robotique. D’après mon expérience avec des bras en simulation, un bon simulateur doit offrir 3 éléments :
Les 2 plateformes que vous croiserez le plus souvent sont NVIDIA Isaac Sim (avec Isaac Lab) et MuJoCo :
| Plateforme | Éditeur | Points forts | Idéale pour |
|---|---|---|---|
| NVIDIA Isaac Sim et Isaac Lab | NVIDIA | Rendu photoréaliste, simulation de capteurs, milliers d’environnements parallèles sur GPU | Grandes exécutions RL et données caméra synthétiques |
| MuJoCo | Google DeepMind (open source) | Physique de contact rapide et précise, léger, grande communauté de recherche | Recherche, benchmarks de locomotion et manipulation |
La nouveauté la plus récente est Newton, un moteur de physique open source accéléré GPU, développé par NVIDIA, Google DeepMind et Disney Research et géré par la Linux Foundation.
Newton 1.0 a été lancé à NVIDIA GTC en mars 2026. Il s’intègre à Isaac Lab comme backend physique, avec MuJoCo Warp comme l’un de ses solveurs et des solveurs supplémentaires pour les objets déformables comme les câbles et les tissus.
Les déformables comptent plus qu’on ne le pense. Les anciens simulateurs géraient mal les câbles et les tissus, alors que les usines ont besoin de robots capables de manipuler les deux.
L’écart sim-to-real est la chute de performance qui survient lorsqu’une politique entraînée en simulation est déployée sur un robot réel, et c’est l’un des plus grands défis des systèmes incarnés.
Par exemple, la friction simulée n’est jamais tout à fait juste, les caméras simulées sont trop « propres », et les objets simulés trop parfaits ; ainsi, une politique qui réussit 95 % du temps en simulation peut échouer dès qu’elle rencontre le matériel réel.
Deux approches principales réduisent cet écart :
Plutôt que d’atteindre une simulation parfaite, les équipes la randomisent de multiples façons.
Tobin et al. (2017) ont aléatoirisé textures et éclairages au point que le monde réel apparaisse comme une variation de plus. La main robotique du Rubik’s Cube d’OpenAI est allée plus loin en élargissant automatiquement la randomisation à mesure que la politique progressait.
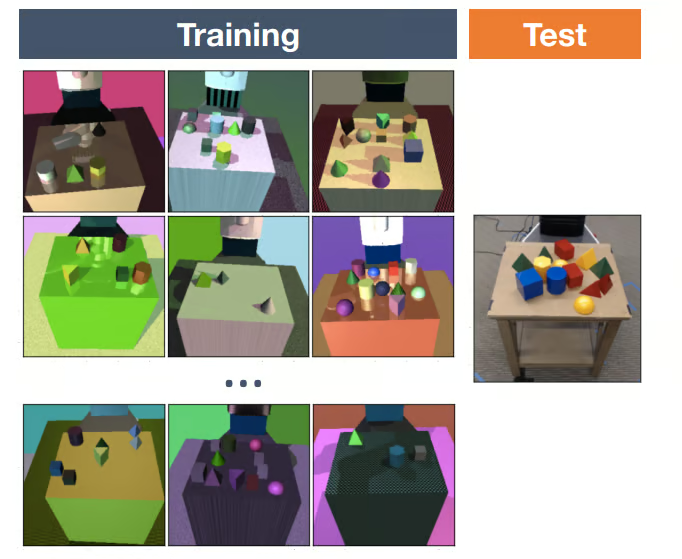
Une politique préentraînée en simulation a souvent besoin d’un petit ensemble de démonstrations réelles pour s’adapter, car elle a déjà appris la structure générale de la tâche.
Aucune de ces techniques n’élimine complètement l’écart, donc les équipes continuent de travailler pour en réduire l’impact en conditions réelles.
L’IA incarnée fonctionne désormais hors des labos dans plusieurs secteurs, mais de façon très inégale.
Le schéma que j’observe est qu’elle s’implante d’abord là où l’environnement change trop pour être scripté à la main, mais où un humain peut encore intervenir en cas de problème.
Les voitures autonomes sont l’un des types d’IA incarnée les plus gourmands en données.
Le Waymo Driver a parcouru près de 200 millions de miles en mode entièrement autonome, et il s’entraîne et se teste aussi sur des milliards de miles en simulation, selon la publication de Waymo de février 2026 sur son World Model. La simulation permet de rejouer des incidents réels et de générer des scénarios rares (par exemple, un enfant qui surgit entre deux voitures garées) qu’une flotte de test ne rencontrerait peut-être jamais sur route ouverte.
Les voitures autonomes illustrent bien la boucle perception–raisonnement–action à plein régime. Un véhicule Waymo perçoit via caméras, lidar et radar, raisonne sur ce que chaque piéton et véhicule est susceptible de faire ensuite, et agit en contrôlant volant et freins de nombreuses fois par seconde.
À mon avis, les entrepôts sont aujourd’hui l’usage commercial le plus naturel de l’IA incarnée.
On passe de robots à trajectoire fixe qui suivent des lignes au sol à des systèmes capables de gérer un inventaire dynamique et désordonné, par exemple du picking dans un bac contenant 40 produits mélangés.
Le humanoïde Digit d’Agility Robotics déplace des bacs chez GXO Logistics dans le cadre d’un accord pluriannuel signé en 2024, et le robot Stretch de Boston Dynamics décharge des cartons des camions.
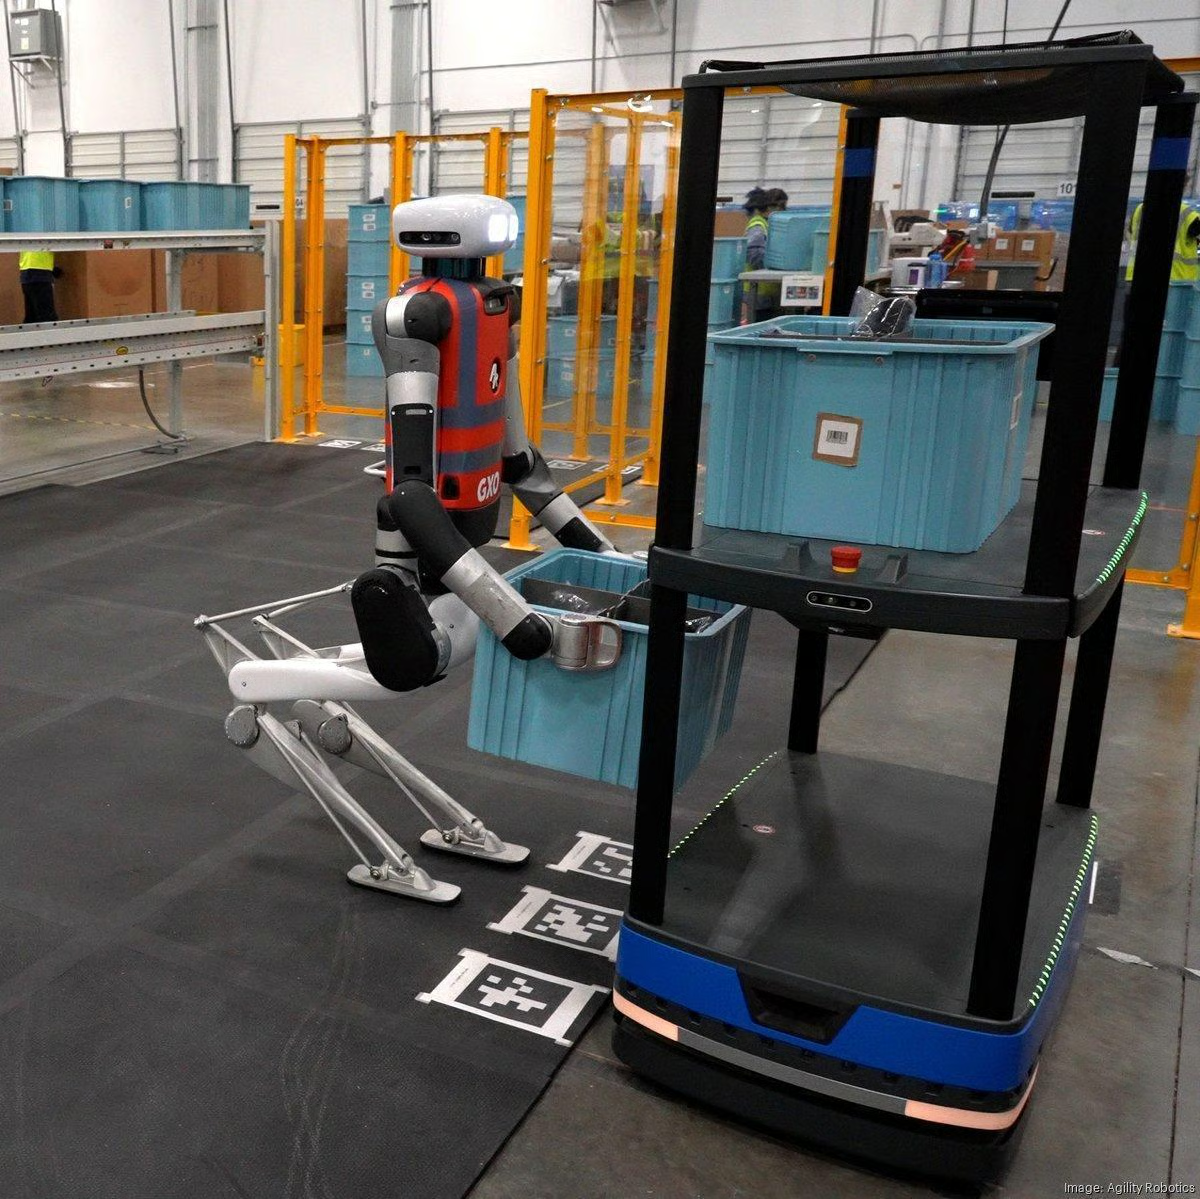
Digit d’Agility Robotics déplaçant des bacs entre des robots mobiles autonomes et un convoyeur dans un entrepôt GXO. Image source : Agility Robotics/The Robot Report
La santé est le domaine où j’attends les avancées les plus prudentes.
Des systèmes chirurgicaux comme le da Vinci d’Intuitive sont déjà utilisés dans le monde entier, mais ils sont pilotés par un chirurgien, et la plupart des travaux d’IA portent ici sur l’assistance : suivi d’instruments, contrôle caméra et aide à la suture.
En santé, l’agrément réglementaire est souvent une contrainte plus forte que la capacité des modèles, et c’est justifié. J’attendrais personnellement des usages d’assistance et de formation bien avant quoi que ce soit s’approchant d’une chirurgie autonome.
Les humanoïdes attirent le plus d’attention et restent parmi les moins éprouvés.
Au CES 2026, Boston Dynamics a dévoilé la version de production d’Atlas et a indiqué que toutes les unités construites en 2026 sont déjà réservées à Hyundai et Google DeepMind. Figure, de son côté, a mené un déploiement de 11 mois de son humanoïde Figure 02 à l’usine BMW de Spartanburg, en Caroline du Sud, pour charger des tôles.
Je veux être franc : la plupart des déploiements humanoïdes restent des pilotes sur un périmètre restreint. Hyundai, par exemple, prévoit de commencer à utiliser Atlas pour le séquençage de pièces en 2028, signe de la prudence même chez les plus grands soutiens.
Passons à celles et ceux qui construisent tout cela. Voici 5 organisations que toute personne découvrant l’IA incarnée devrait connaître :
| Organisation | Ce qu’ils développent | Pourquoi c’est important |
|---|---|---|
| NVIDIA | Isaac Sim, Isaac Lab, Newton, GR00T et Cosmos | La pile simulation et calcul utilisée par la plupart des équipes |
| Physical Intelligence | Famille de modèles fondamentaux de robots π₀ | Politiques génériques de robot avec checkpoints ouverts |
| Agility Robotics | Humanoïde Digit | Conçu pour la logistique d’entrepôt et déjà en production chez des clients |
| Boston Dynamics | Atlas, Stretch et Spot | Passage d’Atlas de démos de recherche à unités de production en 2026 |
| AMI Labs (Yann LeCun) | Modèles du monde de type JEPA | Un pari à contre-courant sur des modèles du monde qui ne génèrent pas de pixels |
NVIDIA construit surtout les outils autour du robot plutôt que le robot lui-même.
Isaac Sim gère la simulation photoréaliste, Isaac Lab l’apprentissage par renforcement par-dessus, et Newton fournit désormais la physique. De nombreuses équipes entraînent sur les logiciels NVIDIA même si NVIDIA ne vend pas de robot généraliste.
Physical Intelligence a construit π₀, un modèle vision–langage–action de 3,3 milliards de paramètres qui utilise le flow matching pour produire des séquences d’actions fluides pour des tâches comme plier du linge.
C’est le meilleur exemple que je connaisse d’un modèle de robot polyvalent réellement téléchargeable, via le référentiel openpi.
Si la notion de « modèle fondamental » est nouvelle pour vous, notre guide Introduction to Foundation Models l’explique très bien.
Agility Robotics a fait le choix du ciblage avec Digit.
Il a été conçu dès le départ pour déplacer des bacs en entrepôt, et cette focalisation explique en grande partie pourquoi il a atteint des clients payants plus tôt que la plupart des humanoïdes.
Boston Dynamics a pris l’option inverse avec Atlas.
L’entreprise a passé des années à repousser les limites athlétiques du robot (vous avez sans doute vu les vidéos de parkour) avant d’en faire un produit tout électrique pour l’usine, que Google DeepMind prévoit d’alimenter avec ses modèles Gemini Robotics.
AMI Labs est la startup parisienne de Yann LeCun, qui a bouclé un tour d’amorçage de 1,03 milliard de dollars en mars 2026 pour une valorisation pré-money de 3,5 milliards. Le tour a été co-dirigé par Cathay Innovation, Greycroft, Hiro Capital, HV Capital et Bezos Expeditions, avec NVIDIA et Samsung parmi les autres investisseurs.
LeCun soutient depuis des années que prédire chaque pixel du futur est inefficace ; son architecture Joint Embedding Predictive Architecture (JEPA) fait donc ses prédictions dans un espace de représentation abstrait, une idée déjà testée chez Meta avec V-JEPA 2.
Ce qui rend AMI à suivre, c’est sa divergence par rapport à la tendance dominante. Rien n’a encore été livré, donc je le considère pour l’instant comme un pari de recherche très financé plutôt qu’une approche éprouvée.
L’IA incarnée n’est pas qu’un problème d’ingénierie robotique. Une grande partie du travail, et j’oserais dire la majorité, relève du machine learning.
Les compétences les plus transférables sont :
Vous n’avez pas besoin d’un robot pour commencer. La bibliothèque gymnasium inclut des environnements MuJoCo, donc après avoir exécuté pip install "gymnasium[mujoco]", vous pouvez faire tourner la boucle entière sur un robot simulé :
import gymnasium as gym

# HalfCheetah est un robot 2D de type guépard simulé avec le moteur physique MuJoCo
env = gym.make("HalfCheetah-v5")
observation, info = env.reset(seed=42)

for step in range(1000):
    # Perception : l'observation contient les angles et vitesses articulaires
    # Raisonnement : une politique entraînée choisirait l'action ici, nous la tirons au hasard
    action = env.action_space.sample()

    # Action : appliquer des couples aux articulations et faire avancer la physique d'un pas
    observation, reward, terminated, truncated, info = env.step(action)

    if terminated or truncated:
        observation, info = env.reset()

env.close()
Pour l’instant, le guépard s’agite dans tous les sens car l’étape de « raisonnement » est env.action_space.sample(), qui choisit une action aléatoire à chaque fois.
Remplacer cette ligne par une politique entraînée, c’est précisément l’objet de l’apprentissage par renforcement ; je vous recommande d’essayer avant de passer à plus ambitieux.
L’IA incarnée progresse vite, mais elle bute encore sur 4 points qu’il est utile de connaître :
L’IA incarnée donne aux machines un corps physique et l’intelligence pour s’en servir. Elle fonctionne via la boucle perception–raisonnement–action, est freinée surtout par la rareté des données physiques, et en 2026 sort des labos pour entrer dans les entrepôts et les premiers pilotes en usine.
Ce qui me surprend vraiment, c’est le renversement de la question. Il y a quelques années, on se demandait si les LLM allaient rendre la recherche robotique obsolète. En réalité, les LLM deviennent la couche de raisonnement des systèmes incarnés, et les deux domaines convergent.
Souvenez-vous de la pomme du début : savoir comment la saisir et la saisir réellement sont deux problèmes bien distincts, et l’IA incarnée s’attaque au second.
Si vous voulez bâtir les fondations ML nécessaires, commencez par notre parcours Reinforcement Learning in Python. Pour la couche langage de la pile, notre cours Large Language Models (LLMs) Concepts et notre parcours Developing Large Language Models sont de bonnes prochaines étapes.
Meilleurs cours DataCamp
Cours
Cours
Cursus
blog
blog
Lynn Heidmann
blog
Kurtis Pykes
9 min
blog
Zoumana Keita
15 min
blog
Kurtis Pykes
15 min
Tutoriel