Kurs
Djup förstärkningsinlärning i Python
4 tim
6K
Föreställ dig att du ber en vän räcka dig ett äpple ur en fruktskål. Hen tittar på skålen, avgör vilket som är äpplet och plockar upp det lagom försiktigt så att det inte krossas innan hen räcker över det till dig.
Be nu en chatbot göra samma sak. Den kan berätta exakt hur man plockar upp ett äpple, vilka fingrar man ska använda och ungefär hur hårt man ska nypa, men den kan inte faktiskt plocka upp ett. Den har inga händer och ingen aning om hur ett äpple känns.
Embodied AI är området som försöker överbrygga den här klyftan. Enkelt uttryckt är det AI som har en fysisk kropp (som en robot, en bil eller en drönare) och lär sig genom att göra saker i den verkliga världen i stället för att bara läsa om dem. Du kommer också att se den närliggande termen ”physical AI” användas för samma idé.
Just nu har området ett stort genombrott. På CES i januari 2026 kallade NVIDIAs Jensen Huang det för ”robotikens ChatGPT-ögonblick”.
Pengarna har följt efter. Dealroom-data rapporterad av CNBC visar att robotikföretag hade tagit in 55,8 miljarder dollar 2026 i början av juni, nästan dubbelt så mycket som det tidigare årsrekordet.
I den här artikeln går jag igenom:
Oroa dig inte om du aldrig har arbetat med en robot tidigare. Viss vana vid maskininlärning hjälper, men jag bygger varje idé från grunden så att du kan hänga med oavsett.
Embodied AI är ett artificiellt intelligenssystem inbyggt i en fysisk kropp, såsom en robot, ett autonomt fordon eller en drönare, som uppfattar sin omgivning via sensorer, resonerar om vad det ska göra och agerar i världen via motorer, och lär sig av utfallet av sina egna handlingar.
Nyckelordet här är embodied.
De flesta AI-modeller lär sig genom att observera data som någon annan har samlat in. Ett embodied system lär sig genom att interagera med sin omgivning, till exempel genom att knuffa en kopp, se koppen glida och uppdatera sin kunskap om hur koppar beter sig när de knuffas.
Här är ett exempel. En visionsmodell tränad på miljoner foton av dörrar vet hur en dörr ser ut. En robot som faktiskt försökt öppna 500 dörrar vet att vissa dörrar ska tryckas, andra dras, vissa är tunga och vissa har handtag som du först måste trycka ned.
Du kan inte få den här kunskapsdjupet från ett foto.
Jag brukar uttrycka det så här: de flesta AI lär sig om världen genom att läsa om den; embodied AI lär sig om världen genom att känna och uppleva den.
Den här enda skillnaden förändrar vilken data du behöver, hur du tränar och hur saker kan gå fel.
Hittills har jag jämfört embodied AI med en chatbot. Låt oss nu jämföra det med de två saker som folk oftast blandar ihop det med: stora språkmodeller (LLM:er) och traditionell regelbaserad robotik.
| Embodied AI | Stora språkmodeller (LLM:er) | Traditionell regelbaserad robotik | |
|---|---|---|---|
| Lär sig från omgivningen | Ja, genom interaktion och återkoppling | Mest nej, lär sig från en fast textkorpus | Nej, beteendet programmeras för hand |
| Vidtar fysiska åtgärder | Ja | Nej | Ja |
| Tränas på internetdata | Delvis (dess vision- och språkryggrader) | Ja, biljoner token | Nej |
| Generaliserar till nya miljöer | Hyfsat, och förbättras snabbt | Bra, inom språkuppgifter | Dåligt, går sönder när uppsättningen ändras |
| Kommersiell mognad 2026 | Tidig produktion (lager, fabrikspiloter) | Mogen och brett utrullad | Mogen, decennier av fabriksanvändning |
De sista två raderna är de jag vill lyfta fram.
Regelbaserade industriarmar har svetsat bilar i decennier, och de är extremt pålitliga, men bara för att inget i deras arbetscell någonsin förändras. Embodied AI försöker behålla den tillförlitligheten samtidigt som världen får vara rörig, vilket forskare kallar generalisering.
LLM:er och embodied AI lär sig båda från enorma datamängder, men de löser mycket olika problem. En LLM tar in text och förutsäger vilken token som bör komma härnäst, medan ett embodied system tar in kamerabilder, ledvinklar och beröringsavläsningar och förutsäger vilken rörelse som ska komma härnäst.
Kort sagt, LLM:er vet om den fysiska världen, medan embodied AI agerar i den. Tillbaka till vårt äpple: en LLM kan beskriva exakt hur man plockar upp ett, och en embodied AI-robot kan faktiskt göra det.
Kostnaden för ett misstag är också mycket olika. Om en LLM har fel får du en lite märklig mening. Om ett embodied system har fel kan ett glas hamna på golvet, eller något värre.
Här är nu delen som jag tror många missar: de två arbetar tillsammans.
I vision–språk–åtgärd‑modeller (VLA) sitter en förtränad vision–språk‑modell i systemets kärna. Den läser kamerabilderna och din instruktion (”lägg frukten i skålen”) och skickar sedan sin förståelse till en åtgärdsdekoder som producerar de faktiska motorkommandona.
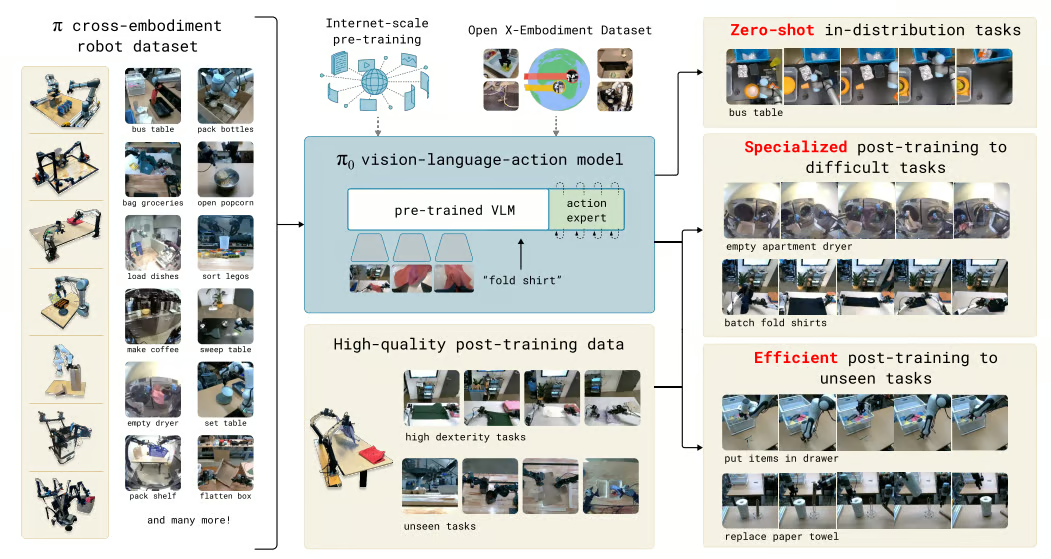
Hur en förtränad vision–språk‑modell kopplas till robotåtgärder i π₀ (pi-zero). Bildkälla: Black et al., 2024
Fysisk AI är svårare än digital AI främst på grund av data.
Språkmodeller gick snabbt framåt tack vare decennier av att människor delat text, kod och bilder online, men det finns ingen motsvarande källa till sensoriska data från verkligheten. Det finns långt färre strömmar av ledvinklar, kraftavläsningar och kamerabilder från robotar som interagerar med vardagsföremål.
Låt oss titta närmare på databehoven. Ett embodied system behöver 3 typer av data som är svåra att hitta:
Låt oss nu sätta siffror på detta.
Frontier‑LLM:er tränas på biljoner token. Open X-Embodiment, en av de största öppna robotikdatamängderna, samlade data från 22 robottyper över 21 institutioner och slutade på strax över 1 miljon verkliga trajektorier.
Robotarna och uppgifterna som samlades i datamängden Open X-Embodiment. Bildkälla: Open X-Embodiment Collaboration, 2023
Varför så lite? Varje trajektoria kräver en riktig robot som gör en riktig uppgift, vanligtvis styrd av en människa genom teleoperation, vilket är långsamt och dyrt.
Detta gap är också orsaken till att fysisk AI generaliserar långsammare än digital AI. En modell hanterar variation bäst när den har sett något liknande tidigare, och en miljon trajektorier täcker långt färre kök, ljussättningar och objektformer än vad biljoner token täcker meningar.
Jag skulle bära med mig det här dataproblemet i bakhuvudet resten av artikeln. Många av designvalen du kommer att se nedan, från simulering till domänrandomisering till att låna förtränade vision–språk‑ryggrader, är kringvägar för det.
Embodied AI fungerar genom att köra en kontinuerlig loop med 3 steg:
Denna loop repeteras många gånger per sekund, och varje rörelse ändrar vad roboten känner av härnäst, så utdata från en cykel blir indata till nästa.
Samma loop ligger bakom världsmodeller. Ha och Schmidhubers 2018 års ”World Models” delade upp en agent i en visionsmodul, en minnesmodul och en styrmodul och testade den på en bil i ett racingspel. Embodied AI tillämpar samma idé på en full robot.
Ett bra sätt att förstå loopen är att föreställa sig att fånga en boll:
En robot gör samma sak, bara med kameror i stället för ögon och motorer i stället för muskler.
Låt oss ta varje steg i tur och ordning.
Perception är steget som omvandlar råa sensoravläsningar till något som resten av systemet kan resonera om. En enda kamera räcker sällan, så de flesta robotar kombinerar flera sensorer:
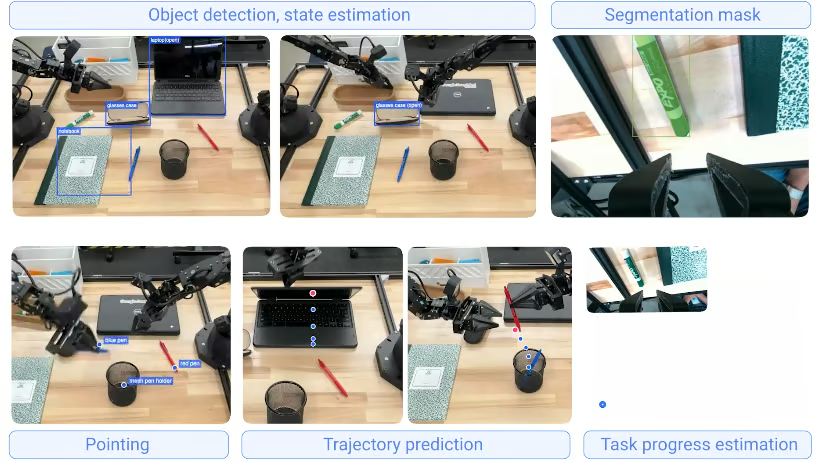
Exempel på perceptionsutdata från Gemini Robotics‑ER 1.5. Bildkälla: Google DeepMind
Perceptionsmodeller omvandlar sedan dessa avläsningar till rumsliga kartor, objektidentiteter, hinderpositioner och en allmän förståelse av scenen.
Det mesta av detta är standard‑datorseende, såsom objektdetektering, segmentering och djupskattning, vanligtvis byggt på förtränade visionstransformatorer som DINOv2 eller SigLIP.
Enligt min mening är dock beröring den mest underskattade delen av perception just nu. En kamera kan tala om att det står ett glas på bordet, men beröring berättar att glaset börjar glida ur greppet.
För att ge en bild av nuläget visade XELA Robotics ett robotfingertopp på Automate 2026 med 30 treaxliga kraftkännande punkter packade i dynan. Företaget säger också att deras uSkin‑sensorer kan detektera krafter så små som 0,1 gramkraft.
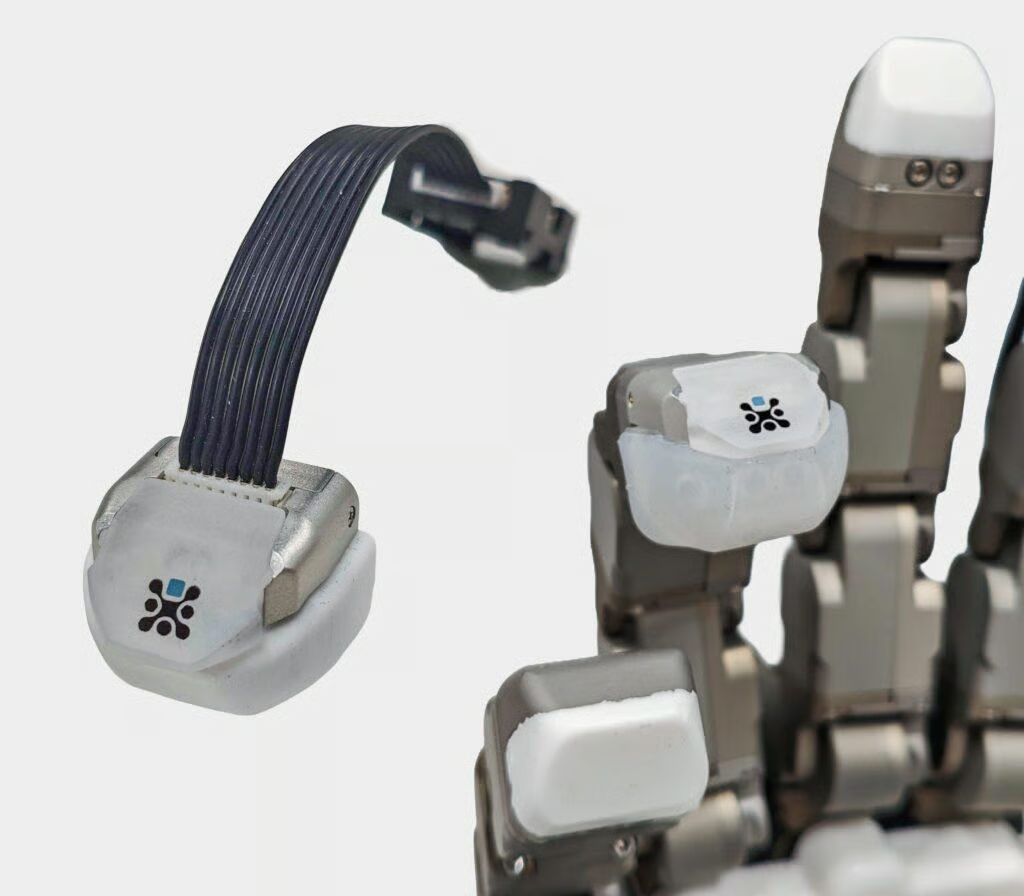
En uSkin‑robotfingertopp som innehåller ett rutnät av treaxliga taktila mätpunkter. Bildkälla: XELA Robotics
Resonemang är steget som avgör vad som ska göras härnäst. I nyare system har det vanligtvis 2 lager:
Världsmodeller är det som låter en robot föreställa sig innan den agerar.
DreamerV3 är ett bra exempel. Den lär sig en kompakt modell av sin omgivning och tränar sedan sin policy nästan helt inuti den föreställda världen.
Jag använder DreamerV3 i min egen forskning, och det som förvånat mig mest är hur mycket mer tid agenten tillbringar med att öva i sitt ”huvud” än i den faktiska miljön. Det spelar roll eftersom träningen blir snabbare och mycket billigare.
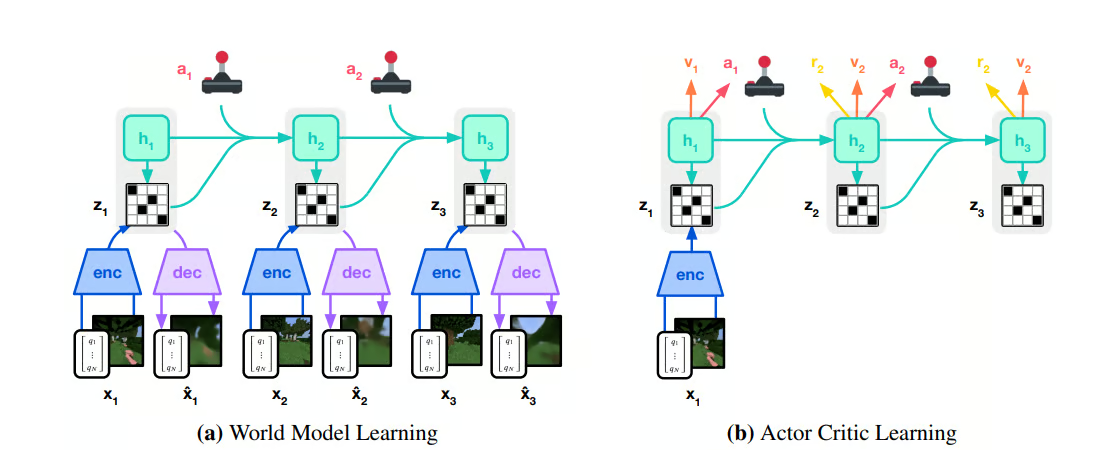
DreamerV3 tränar sin policy på föreställda rullningar från sin världsmodell. Bildkälla: Hafner et al., 2023
Planering, å andra sidan, hanteras i allt högre grad av språkmodeller.
Ett bra exempel är Google DeepMinds Gemini Robotics‑ER 1.5, som fungerar som en högnivå‑planerare. Givet en uppgift som att sortera avfall enligt lokala återvinningsregler kan den slå upp reglerna med Google Sök, dela upp jobbet i steg och överlämna varje steg till VLA‑modellen Gemini Robotics 1.5 som gör det fysiska arbetet.
Du kan tänka på språkmodellen som chefen och VLA‑modellen som arbetaren som faktiskt utför jobbet.
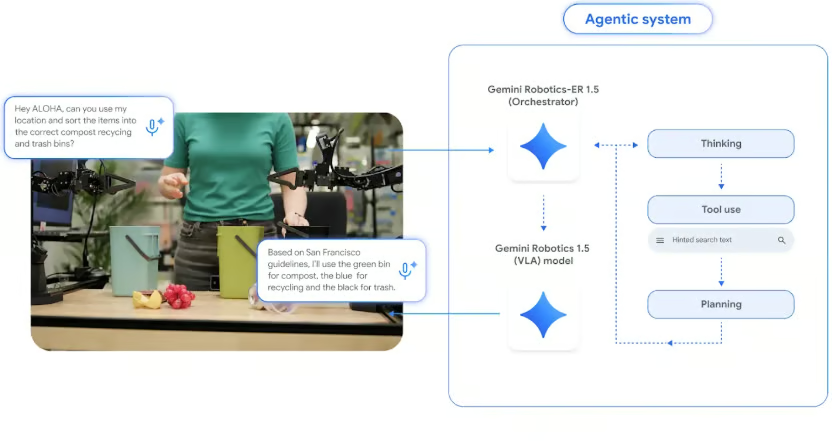
Gemini Robotics‑ER 1.5 planerar uppgiften och delegerar fysisk exekvering till Gemini Robotics 1.5 VLA. Bildkälla: Google DeepMind, 2025
Åtgärd är steget som omvandlar ett beslut till exakta kommandon för varje led och motor, vanligen tiotals till hundratals gånger per sekund (mätt i hertz, eller Hz). Den lågnivådel av detta steg kallas styrning.
Till exempel låter kommandot ”Flytta gripdonet 5 cm åt vänster” enkelt, men på en 7‑leds arm måste det bli ett specifikt vridmoment för varje ledmotor, omräknat kontinuerligt medan armen rör sig.
Det svåra är att verkligheten sällan matchar vad roboten förväntade sig. Föremål glider, golv är lite ojämna, ljuset förändras när någon drar upp en persienn, och en kabel böjer sig annorlunda än förutsett.
En bra styrenhet märker skillnaden mellan vad den förväntade sig och vad som faktiskt hände, och korrigerar direkt.
Jag tycker att åtgärdssteget är svårast att få rätt i röriga, ostrukturerade miljöer. Ett perceptionsfel kan rättas till genom att titta igen och ett planeringsfel kan rättas till genom omplanering, men ett styrfel sker i realtid.
Embodied AI tränas på en mix av simulering och data från verkliga världen. Simulering betyder virtuella miljöer fyllda med fysiktrogna 3D‑objekt, där en robot kan öva miljoner gånger innan den någonsin rör vid verklig hårdvara.
Kommer du ihåg dataproblemet från tidigare? Simulering är en av de främsta kringvägarna för det, särskilt för förstärkningsinlärning av förflyttning och manipulation. Grundmodeller som π₀ lutar sig fortfarande tungt mot verkliga demonstrationer, så de flesta team använder båda.
Att samla in data i verkligheten har 3 stora problem:
En simulator adresserar alla tre på en gång. Du kan köra tusentals virtuella robotar parallellt på en enda GPU och låta dem misslyckas och starta om så ofta som behövs. Det kondenserar år av roboterfarenhet till några timmar.
Inte varje simulator är lika användbar för att träna robotar. Av egen erfarenhet med robotarmar i simulering skulle jag säga att en bra behöver 3 saker:
De 2 plattformar du oftast stöter på är NVIDIA Isaac Sim (med Isaac Lab) och MuJoCo:
| Plattform | Utvecklare | Vad den är bra på | Bäst för |
|---|---|---|---|
| NVIDIA Isaac Sim och Isaac Lab | NVIDIA | Fotorealistisk rendering, sensorsimulering, tusentals parallella miljöer på GPU | Stora förstärkningsinlärningskörningar och syntetisk kameradata |
| MuJoCo | Google DeepMind (öppen källkod) | Snabb, exakt kontaktfysik, lättviktig, stor forskargemenskap | Forskning, benchmark för förflyttning och manipulation |
Det nyaste tillskottet är Newton, en öppen, GPU‑accelererad fysikmotor byggd av NVIDIA, Google DeepMind och Disney Research och förvaltad via Linux Foundation.
Newton 1.0 släpptes på NVIDIA GTC i mars 2026. Den ansluts till Isaac Lab som en fysikbackend, med MuJoCo Warp som en av dess lösare och extra lösare för deformabla objekt som kablar och tyg.
Deformerbara objekt är viktigare än de låter. Äldre simulatorer hanterade kablar och tyg dåligt, och fabriker behöver robotar som klarar båda.
Sim‑till‑verklighetsgapet är den prestationsminskning som sker när en policy tränad i simulering flyttas över till en verklig robot, och det är ett av de största problemen i embodied‑system.
Till exempel är simulerad friktion aldrig helt rätt, simulerade kameror är för rena och simulerade objekt kan vara för perfekta, så en policy som lyckas 95 % av gångerna i simulering kan gå sönder i samma stund den möter verklig hårdvara.
Det finns 2 huvudsakliga sätt att minska detta gap:
I stället för att försöka göra simulatorn perfekt randomiserar team den på många olika sätt.
Tobin et al. (2017) randomiserade texturer och belysning så kraftigt att den verkliga världen såg ut som ännu en variation för modellen. OpenAI:s Rubiks kub‑robothand gick längre genom att automatiskt bredda randomiseringen i takt med att policyn blev bättre.
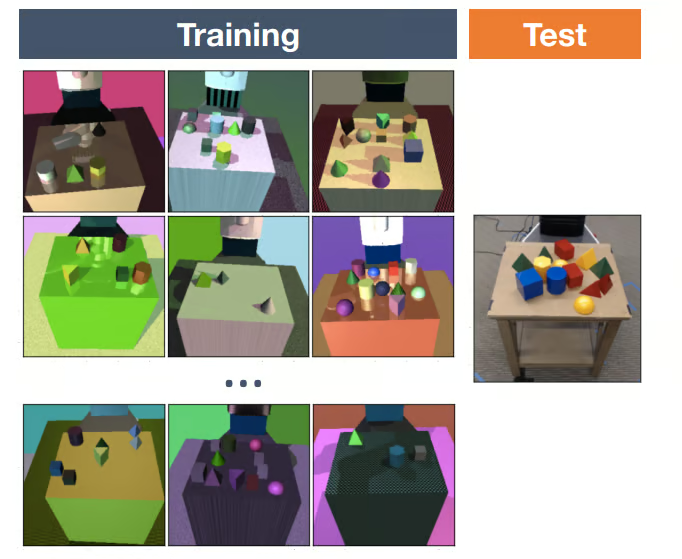
En policy förtränad i simulering behöver ofta bara en liten uppsättning verkliga demonstrationer för att anpassa sig, eftersom den redan lärt sig uppgiftens allmänna form.
Ingen av teknikerna tar bort gapet helt, så team fortsätter arbeta för att minska dess påverkan på prestanda i verkligheten.
Embodied AI körs nu utanför labbet i flera branscher, om än mycket ojämnt.
Mönstret jag ser är att den landar först där miljön förändras för mycket för att skriptas för hand, men där en människa fortfarande kan ingripa om något går fel.
Självkörande bilar är en av de mest datahungriga typerna av embodied AI.
Waymo Driver har kört nära 200 miljoner helt autonoma miles, och den tränar och testas också på miljarder miles i simulering, enligt Waymos inlägg från februari 2026 om deras World Model. Simulering låter Waymo spela upp verkliga incidenter och generera sällsynta scenarier (till exempel ett barn som springer ut mellan parkerade bilar) som en testflotta kanske aldrig möter på riktiga vägar.
Självkörande bilar är också ett bra exempel på loopen perception–resonemang–åtgärd på full fart. Ett Waymo‑fordon uppfattar med kameror, lidar och radar, resonerar om vad varje fotgängare och fordon sannolikt gör härnäst och agerar genom att styra ratt och bromsar många gånger per sekund.
Enligt min mening är lager den mest naturliga kommersiella användningen av embodied AI just nu.
Skiftet går från robotar på fasta banor som följer linjer på golvet till system som kan hantera dynamiskt, rörigt lager, som plockning från en låda med 40 olika produkter slängda tillsammans.
Agility Robotics humanoid Digit har flyttat lådor hos GXO Logistics enligt ett flerårigt avtal som tecknades 2024, och Boston Dynamics Stretch‑robot lastar av lådor från lastbilar.
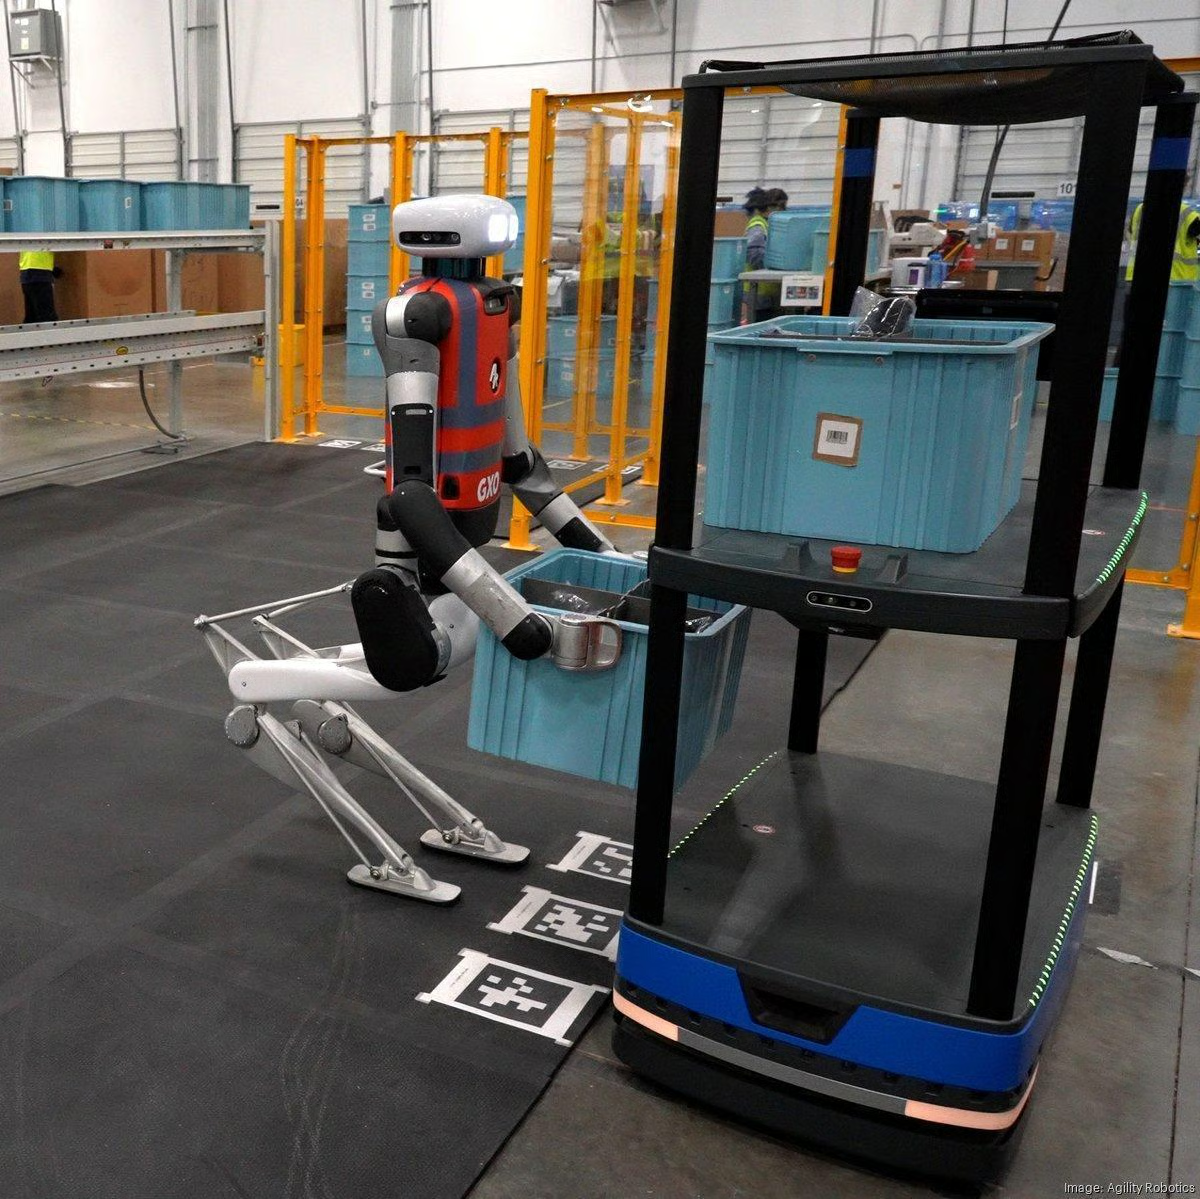
Agility Robotics Digit flyttar lådor mellan autonoma mobila robotar och ett transportband i ett GXO‑lager. Bildkälla: Agility Robotics/The Robot Report
Vården är där jag förväntar mig att embodied AI rör sig allra försiktigt.
Kirurgiska system som Intuitives da Vinci används redan på sjukhus världen över, men en kirurg styr dem, och den mesta AI‑forskningen här fokuserar på assistans, som instrumentspårning, kamerakontroll och suturstöd.
Inom vården är regulatoriskt godkännande ofta en större begränsning än modellkapacitet, och med rätta. Jag skulle personligen förvänta mig assistiva och utbildande användningar långt innan något i närheten av autonom kirurgi.
Humanoider får mest uppmärksamhet och är bland de minst beprövade.
På CES 2026 presenterade Boston Dynamics produktionsversionen av Atlas och sa att varje enhet de bygger 2026 redan är vigd åt Hyundai och Google DeepMind. Figure å sin sida genomförde en 11 månader lång utrullning av sin humanoid Figure 02 på BMW:s fabrik i Spartanburg, South Carolina, med lastning av plåt.
Jag vill vara ärlig här: de flesta humanoidutrullningar är fortfarande piloter som gör en smal uppsättning uppgifter. Hyundai planerar till exempel att börja använda Atlas för sekvensering av delar 2028, ett tecken på hur försiktigt även de största aktörerna rör sig.
Låt oss nu prata om vilka som faktiskt bygger allt detta. Här är de 5 organisationer jag tycker att alla nya inom embodied AI bör känna igen:
| Organisation | Vad de bygger | Varför det spelar roll |
|---|---|---|
| NVIDIA | Isaac Sim, Isaac Lab, Newton, GR00T och Cosmos | Simulerings- och beräkningsstacken som de flesta team tränar på |
| Physical Intelligence | π₀‑familjen av robot‑grundmodeller | Allmänna robotpolicys med öppna checkpoints |
| Agility Robotics | Humanoiden Digit | Byggd för lagerlogistik och arbetar redan med kunder |
| Boston Dynamics | Atlas, Stretch och Spot | Flyttar Atlas från forskningsdemo till produktionsenheter under 2026 |
| AMI Labs (Yann LeCun) | JEPA‑stil världsmodeller | En konträr satsning på världsmodeller som inte genererar pixlar |
NVIDIA bygger mest verktygen runt roboten snarare än själva roboten.
Isaac Sim hanterar fotorealistisk simulering, Isaac Lab hanterar förstärkningsinlärning ovanpå den och Newton kan nu stå för fysiken. Många robotikteam tränar på NVIDIAs programvara trots att NVIDIA inte säljer en allmän robot.
Physical Intelligence byggde π₀, en 3,3‑miljarder‑parameters vision–språk–åtgärd‑modell som använder flödesmatchning för att producera jämna sekvenser av åtgärder för uppgifter som att vika tvätt.
Det är det bästa exempel jag känner till på en allmän robotmodell du faktiskt kan ladda ner, via openpi‑förvaret.
Om begreppet ”grundmodell” är nytt för dig förklarar vår guide Introduktion till grundmodeller idén väl.
Agility Robotics tog den smala vägen med Digit.
Den designades från dag ett för att flytta lådor i lager, och det smala fokuset är en stor anledning till att den nådde betalande kunder tidigare än de flesta humanoider.
Boston Dynamics tog motsatt väg med Atlas.
De tillbringade år med att pressa robotens atletiska gränser (du har förmodligen sett parkourvideorna) innan de gjorde den till en helt elektrisk fabriksprodukt som Google DeepMind planerar att driva med sina Gemini Robotics‑modeller.
AMI Labs är Yann LeCuns Parisbaserade startup, som tog in 1,03 miljarder dollar i en venture‑seed i mars 2026 till en pre‑money‑värdering på 3,5 miljarder dollar. Rundans samleddes av Cathay Innovation, Greycroft, Hiro Capital, HV Capital och Bezos Expeditions, med NVIDIA och Samsung bland de övriga investerarna.
LeCun har i åratal hävdat att det är slösaktigt att förutsäga varje pixel av framtiden, så hans Joint Embedding Predictive Architecture (JEPA) gör sina förutsägelser i ett abstrakt representationsutrymme i stället, en idé som Meta redan testat med V‑JEPA 2.
Det som gör AMI värd att bevaka är att den går emot vart större delen av fältet är på väg. Den har dock inte skeppat något än, så jag skulle se den som ett forskningsbet med mycket pengar bakom snarare än en beprövad metod just nu.
Embodied AI är inte bara ett robotikingenjörsproblem. Mycket av arbetet, och jag skulle säga det mesta, är maskininlärningsarbete.
De färdigheter som överförs mest direkt är:
Du behöver ingen robot för att börja. Biblioteket gymnasium levereras med MuJoCo‑miljöer, så efter att ha kört pip install "gymnasium[mujoco]" kan du köra hela loopen på en simulerad robot:
import gymnasium as gym

# HalfCheetah is a 2D cheetah-like robot simulated with the MuJoCo physics engine
env = gym.make("HalfCheetah-v5")
observation, info = env.reset(seed=42)

for step in range(1000):
    # Perception: the observation holds joint angles and velocities
    # Reasoning: a trained policy would choose the action here, we pick randomly
    action = env.action_space.sample()

    # Action: apply torques to the joints and move the physics forward one step
    observation, reward, terminated, truncated, info = env.step(action)

    if terminated or truncated:
        observation, info = env.reset()

env.close()
Just nu fäktar geparden bara runt eftersom ”resonemangs”‑steget är env.action_space.sample(), som väljer en slumpåtgärd varje gång.
Att ersätta den raden med en tränad policy är precis vad förstärkningsinlärning är till för, och jag skulle rekommendera att testa det innan du går vidare till något större.
Embodied AI rör sig snabbt, men kämpar fortfarande på 4 områden, och jag tycker att det är värt att känna till dem:
Embodied AI ger maskiner en fysisk kropp och intelligensen att använda den. Den fungerar genom loopen perception–resonemang–åtgärd, hålls tillbaka främst av hur lite fysisk data som finns, och är 2026 på väg ut ur forskningslabben och in i lager och de första fabrikspiloterna.
Det som verkligen förvånar mig är hur frågan har skiftat. För några år sedan undrade folk om LLM:er skulle göra robotikforskning irrelevant. I stället blir LLM:er resonemangslagret inuti embodied‑system, och de två fälten växer ihop.
Kommer du ihåg äpplet från början av den här artikeln? Att veta hur man plockar upp det och faktiskt plocka upp det visade sig vara två helt olika problem, och embodied AI är området som arbetar med det senare.
Om du vill bygga ML‑grunderna för detta, börja med vår Reinforcement Learning in Python‑track. För språkstackens sida är vår kurs Large Language Models (LLMs) Concepts och vår track Developing Large Language Models bra nästa steg.
Toppkurser på DataCamp
Kurs
Kurs
Lärstig