강의
Python으로 배우는 Deep Reinforcement Learning
4시간
6K
과일 바구니에서 사과를 건네 달라고 친구에게 부탁한다고 상상해 보세요. 친구는 바구니를 보고 사과가 무엇인지 알아낸 다음, 으깨지지 않도록 충분히 살살 집어 당신에게 건넵니다.
이제 같은 일을 챗봇에게 시켜 봅시다. 챗봇은 사과를 어떻게 집어야 하는지, 어떤 손가락을 써야 하는지, 어느 정도 힘으로 쥐어야 하는지까지 자세히 설명할 수 있지만, 실제로 집어 들 수는 없습니다. 손도 없고 사과가 어떤 촉감인지도 모릅니다.
Embodied AI는 이 간극을 메우려는 분야입니다. 간단히 말해, 로봇·자동차·드론 같은 물리적 몸을 가진 AI가 텍스트만 읽는 대신 현실 세계에서 직접 행동하며 학습하는 것을 뜻합니다. 같은 아이디어를 가리키는 용어로 “physical AI”도 자주 쓰입니다.
지금 이 분야는 큰 전환점을 맞고 있습니다. 2026년 1월 CES에서 NVIDIA의 Jensen Huang은 이를 가리켜 “로보틱스의 ChatGPT 순간”이라고 말했습니다.
자금도 뒤따르고 있습니다. CNBC가 전한 Dealroom 데이터에 따르면, 2026년 6월 초까지 로보틱스 기업들은 558억 달러를 조달했으며, 이는 이전 연간 기록의 거의 두 배입니다.
이 글에서 다룰 내용은 다음과 같습니다.
로봇과 함께 일해 본 적이 없어도 걱정하지 마세요. 기계 학습에 익숙하면 도움이 되지만, 어떤 경우든 이해할 수 있도록 기초부터 차근차근 설명하겠습니다.
Embodied AI는 로봇, 자율주행차, 드론처럼 물리적 몸에 내장되어 센서를 통해 환경을 지각하고, 무엇을 할지 추론하며, 모터를 통해 세계에 행동하고, 그 결과로부터 학습하는 인공지능 시스템입니다.
여기서 핵심 용어는 embodied입니다.
대부분의 AI 모델은 다른 누군가가 수집한 데이터를 관찰하여 학습합니다. Embodied 시스템은 컵을 밀고, 미끄러지는 모습을 보고, 밀었을 때 컵이 어떻게 거동하는지에 대한 지식을 갱신하는 등 환경과 상호작용하며 학습합니다.
예를 들어 보겠습니다. 수백만 장의 문 사진으로 학습된 비전 모델은 문이 어떻게 생겼는지 압니다. 반면 실제로 500개의 문을 열어 본 로봇은 어떤 문은 밀어야 하고, 어떤 문은 당겨야 하며, 어떤 문은 무겁고, 어떤 문은 먼저 손잡이를 누르고 내려야 한다는 것을 압니다.
이 깊이의 지식은 사진만으로는 얻을 수 없습니다.
저는 이렇게 표현하곤 합니다. 대부분의 AI는 세계에 대해 ‘읽음’으로써 배우고, Embodied AI는 세계를 ‘만지고 경험함’으로써 배운다.
이 차이 하나가 필요한 데이터, 훈련 방식, 실패 양상을 모두 바꿉니다.
지금까지는 Embodied AI를 챗봇과 비교했습니다. 이제 많은 사람들이 혼동하는 두 가지, 즉 대규모 언어 모델(LLM)과 전통적 규칙 기반 로보틱스와 비교해 보겠습니다.
| Embodied AI | 대규모 언어 모델(LLM) | 전통적 규칙 기반 로보틱스 | |
|---|---|---|---|
| 환경으로부터 학습 | 예, 상호작용과 피드백을 통해 | 대체로 아니오, 고정된 텍스트 코퍼스로 학습 | 아니오, 동작은 수작업으로 프로그래밍 |
| 물리적 행동 수행 | 예 | 아니오 | 예 |
| 인터넷 데이터로 학습 | 부분적으로(비전·언어 백본) | 예, 수조 토큰 | 아니오 |
| 새 환경으로의 일반화 | 보통 수준, 빠르게 개선 중 | 언어 과제 내에서는 우수 | 미흡, 설정이 바뀌면 쉽게 깨짐 |
| 2026년 상용 성숙도 | 초기 생산(창고, 공장 파일럿) | 성숙, 널리 배포됨 | 성숙, 수십 년간 공장에서 사용 |
마지막 두 행이 특히 중요합니다.
규칙 기반 산업용 로봇암은 수십 년간 자동차를 용접해 왔고 매우 신뢰할 수 있지만, 이는 작업 셀 내부가 결코 변하지 않기 때문입니다. Embodied AI는 세상이 어질러져 있어도 그 신뢰성을 유지하려 하며, 연구자들은 이를 일반화라고 부릅니다.
LLM과 Embodied AI는 모두 막대한 데이터로부터 학습하지만, 해결하는 문제는 매우 다릅니다. LLM은 텍스트를 입력으로 받아 다음에 올 토큰을 예측하고, Embodied 시스템은 카메라 프레임·관절 각도·촉각을 입력으로 받아 다음에 취할 움직임을 예측합니다.
요약하면, LLM은 물리 세계를 알고 있고, Embodied AI는 그 안에서 행동합니다. 다시 사과 예로 돌아가면, LLM은 집는 방법을 정확히 설명할 수 있고, Embodied AI 로봇은 실제로 집을 수 있습니다.
실수의 비용도 전혀 다릅니다. LLM이 틀리면 다소 어색한 문장이 나옵니다. Embodied 시스템이 틀리면 유리가 바닥에 떨어질 수도 있고, 더 나쁜 일이 생길 수도 있습니다.
그리고 많은 분이 놓치는 부분이 있습니다. 둘은 함께 동작합니다.
비전-언어-행동(VLA) 모델에서는 사전학습된 비전-언어 모델이 시스템의 핵심에 있습니다. 카메라 이미지와 사용자의 지시(“과일을 그릇에 넣어”)를 읽고, 그 이해를 실제 모터 명령을 생성하는 액션 디코더에 전달합니다.
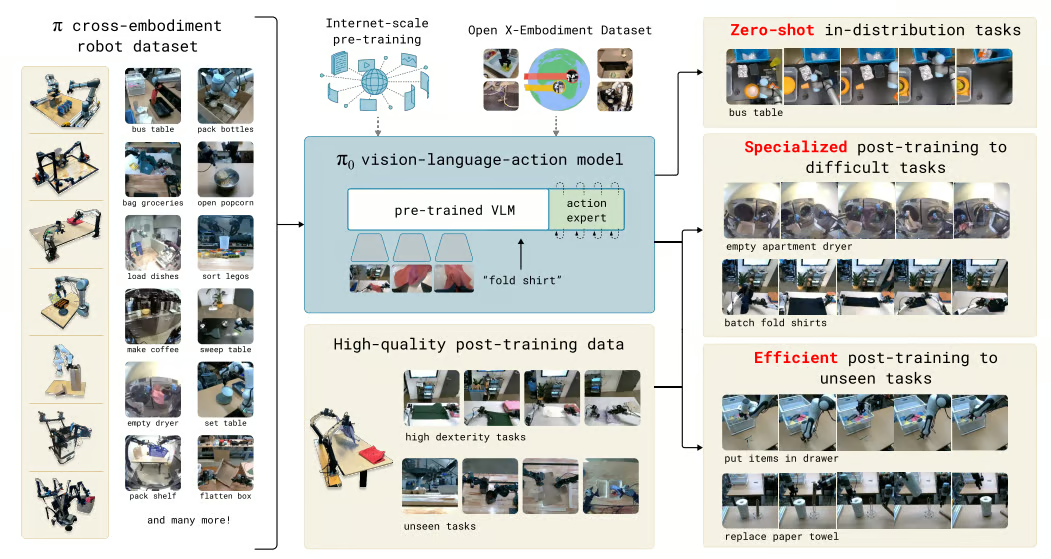
사전학습된 비전-언어 모델이 π₀(pi-zero)에서 로봇 행동과 연결되는 방식. 이미지 출처: Black et al., 2024
물리적 AI가 더 어려운 주된 이유는 데이터입니다.
언어 모델은 수십 년간 사람들이 텍스트·코드·이미지를 온라인에 공유한 덕분에 빠르게 발전했지만, 현실 세계의 센서 데이터에는 그에 상응하는 공급원이 없습니다. 일상 물체와 상호작용하는 로봇의 관절각·힘·카메라 프레임 스트림은 훨씬 적습니다.
데이터 요구사항을 좀 더 자세히 보겠습니다. Embodied 시스템이 필요로 하지만 구하기 어려운 데이터는 세 가지입니다.
이제 수치를 대입해 봅시다.
최전선 LLM은 수조 토큰으로 학습합니다. 가장 큰 오픈 로보틱스 데이터셋 중 하나인 Open X-Embodiment는 21개 기관의 22개 로봇 타입에서 데이터를 모아 실제 궤적이 100만 개 남짓입니다.
Open X-Embodiment 데이터셋에 모인 로봇과 작업. 이미지 출처: Open X-Embodiment Collaboration, 2023
왜 이렇게 적을까요? 각 궤적에는 실제 로봇이 실제 작업을 수행해야 하며, 대개 원격조작을 통해 사람이 제어해야 해서 느리고 비용이 큽니다.
이 격차 때문에 물리적 AI가 디지털 AI보다 일반화가 더 느린 것입니다. 모델은 유사 사례를 많이 봤을수록 변이에 잘 대응하는데, 100만 궤적은 수조 토큰이 문장을 커버하는 폭만큼 다양한 부엌·조명·물체 형태를 결코 담지 못합니다.
이 데이터 문제를 글의 나머지 부분 동안 염두에 두시길 권합니다. 아래에서 보게 될 시뮬레이션, 도메인 랜덤화, 사전학습된 비전-언어 백본 활용 같은 설계 선택 대부분이 이를 우회하기 위한 것입니다.
Embodied AI는 다음의 세 단계를 연속 루프로 실행합니다.
이 루프는 초당 여러 번 반복되며, 각 움직임은 다음에 로봇이 감지하는 것을 바꾸므로 한 번의 출력은 다음 사이클의 입력이 됩니다.
같은 루프는 월드 모델의 배후에도 있습니다. Ha와 Schmidhuber의 2018년 “World Models” 논문은 에이전트를 비전 모듈, 메모리 모듈, 컨트롤러로 나누고 레이싱 게임의 자동차에 테스트했습니다. Embodied AI는 같은 아이디어를 전체 로봇에 적용합니다.
이 루프를 이해하는 좋은 방법은 공을 받는 상황을 상상하는 것입니다.
로봇도 똑같이 합니다. 눈 대신 카메라, 근육 대신 모터를 쓸 뿐입니다.
이제 각 단계를 차례로 살펴보겠습니다.
지각은 원시 센서 신호를 시스템의 나머지 부분이 추론할 수 있는 표현으로 바꾸는 단계입니다. 카메라 하나만으로는 부족한 경우가 많아, 대부분의 로봇은 여러 센서를 결합합니다.
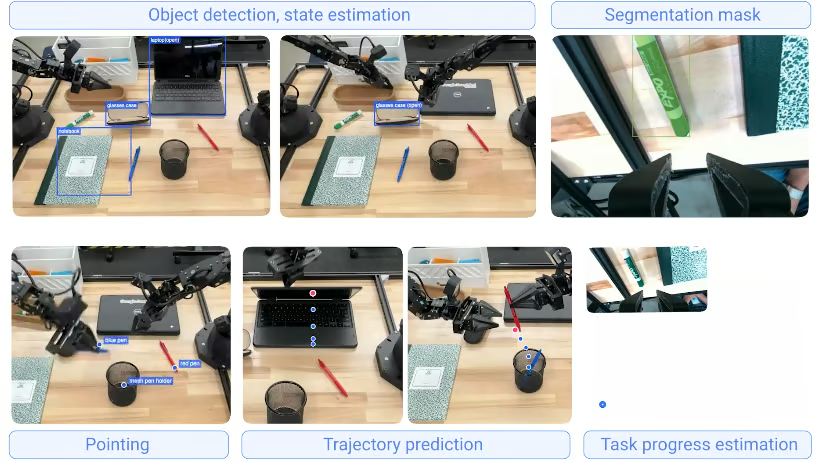
Gemini Robotics-ER 1.5의 지각 출력 예시. 이미지 출처: Google DeepMind
이후 지각 모델은 이러한 신호를 공간 지도, 객체 정체성, 장애물 위치, 장면의 일반적 이해로 변환합니다.
이는 주로 컴퓨터 비전 과제입니다. 객체 탐지, 세그멘테이션, 깊이 추정 등이며, 보통 DINOv2나 SigLIP 같은 사전학습된 비전 트랜스포머 위에 구축됩니다.
제 생각에, 촉각은 지금 가장 과소평가된 지각 요소입니다. 카메라는 탁자 위에 유리가 있다는 것을 알려 주지만, 유리가 손에서 미끄러지려 한다는 것을 알려 주는 것은 촉각입니다.
현재 수준을 가늠하자면, XELA Robotics는 Automate 2026에서 패드에 3축 힘 감지 포인트 30개를 집적한 로봇 손끝을 선보였습니다. 또한 이 회사의 uSkin 센서는 0.1 gf의 미세한 힘까지 감지할 수 있다고 합니다.
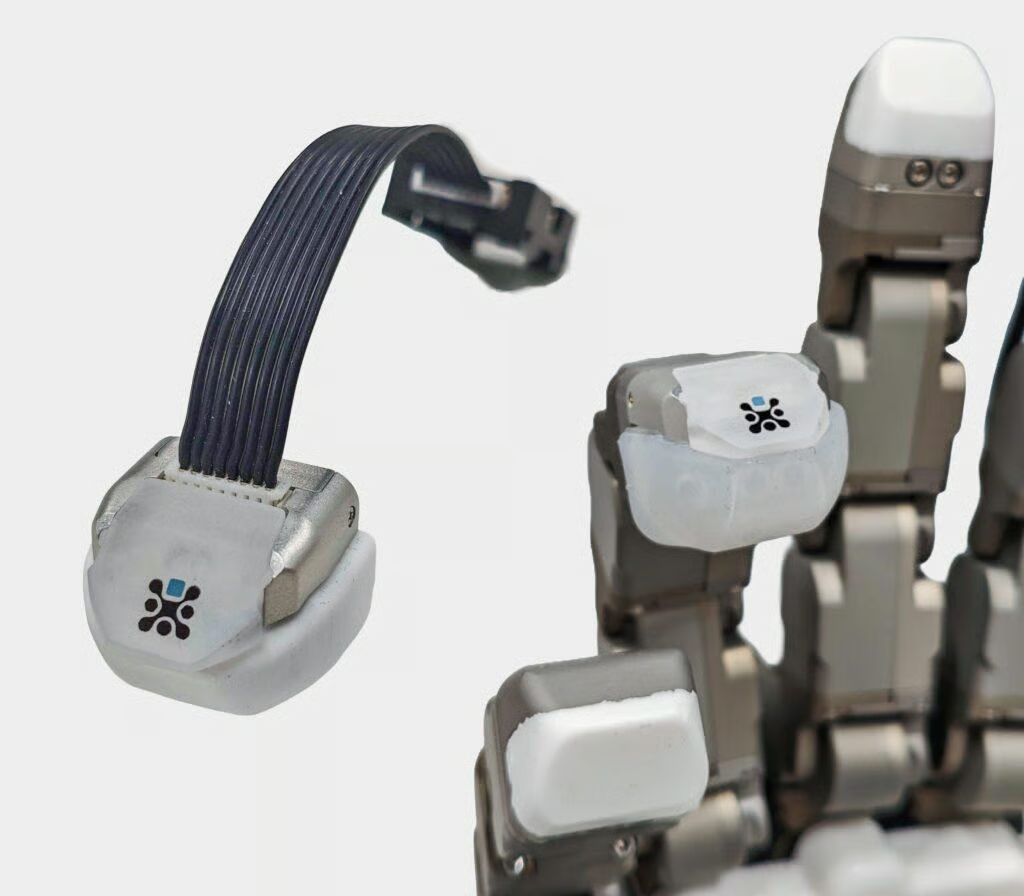
3축 촉각 감지 포인트 어레이가 내장된 uSkin 로봇 손끝. 이미지 출처: XELA Robotics
추론은 다음에 무엇을 할지 결정하는 단계입니다. 최신 시스템에서는 대개 두 층으로 구성됩니다.
월드 모델은 로봇이 행동하기 전에 상상할 수 있게 해 줍니다.
DreamerV3가 좋은 예입니다. 환경의 압축 모델을 학습한 뒤, 거의 전적으로 그 상상 세계 안에서 정책을 훈련합니다.
제가 연구에서 DreamerV3를 쓰며 가장 놀란 점은 에이전트가 실제 환경보다 자신의 “머릿속”에서 연습하는 시간이 훨씬 많다는 것입니다. 이는 훈련이 더 빠르고 훨씬 저렴해진다는 뜻입니다.
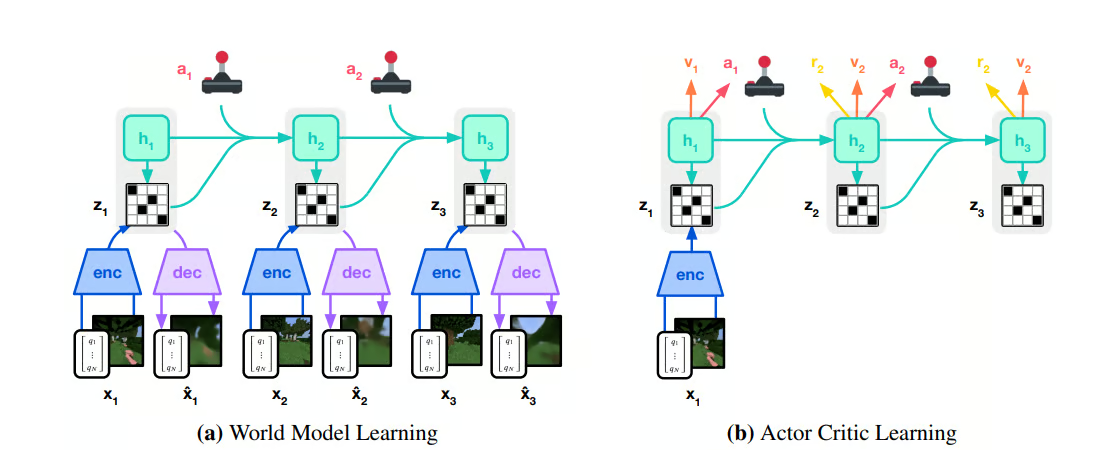
DreamerV3는 월드 모델의 상상 롤아웃으로 정책을 훈련합니다. 이미지 출처: Hafner et al., 2023
한편, 계획은 점점 언어 모델이 담당하고 있습니다.
좋은 예가 Google DeepMind의 Gemini Robotics-ER 1.5로, 고수준 플래너 역할을 합니다. 지역 재활용 규칙에 따라 쓰레기를 분류하는 작업이 주어지면, Google 검색으로 규칙을 찾아보고, 일을 단계로 쪼갠 다음, 각 단계를 실제 물리 작업을 수행하는 Gemini Robotics 1.5 VLA 모델에 넘깁니다.
언어 모델은 관리자로, VLA 모델은 실제 일을 하는 작업자로 생각할 수 있습니다.
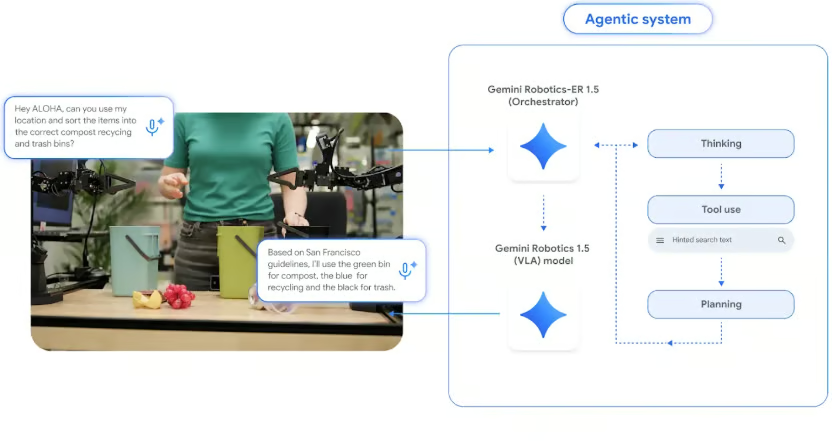
Gemini Robotics-ER 1.5가 계획을 수립하고 물리 실행을 Gemini Robotics 1.5 VLA에 위임. 이미지 출처: Google DeepMind, 2025
행동은 결정을 초당 수십~수백 회(Hz) 각 관절과 모터의 정밀한 명령으로 변환하는 단계입니다. 이 단계의 저수준 부분을 제어(control)라고 부릅니다.
예를 들어 “그리퍼를 왼쪽으로 5cm 이동” 같은 명령은 간단해 보이지만, 7자유도 로봇암에서는 각 관절 모터의 구체적 토크로 변환되어, 팔이 움직이는 내내 연속적으로 재계산되어야 합니다.
어려운 점은 현실이 로봇의 기대와 잘 맞지 않는다는 것입니다. 물체는 미끄러지고, 바닥은 약간 고르지 않으며, 누군가 블라인드를 열면 조명이 바뀌고, 케이블은 예측과 다르게 휘어집니다.
좋은 컨트롤러는 기대와 실제 사이의 차이를 즉시 감지하고 바로 보정합니다.
저는 비정형적이고 어수선한 환경에서는 행동 단계가 가장 어렵다고 봅니다. 지각 오류는 다시 보면 고칠 수 있고, 계획 오류는 재계획으로 바로잡을 수 있지만, 제어 오류는 실시간으로 발생합니다.
Embodied AI는 시뮬레이션과 실제 세계 데이터의 혼합으로 훈련됩니다. 시뮬레이션은 물리적으로 정확한 3D 객체로 채워진 가상 환경에서, 로봇이 실제 하드웨어를 만지기 전에 수백만 번 연습할 수 있게 해 줍니다.
앞서 언급한 데이터 문제를 기억하시나요? 시뮬레이션은 특히 보행과 조작의 강화학습에서 이를 해결하는 주요 수단입니다. π₀ 같은 파운데이션 모델은 여전히 실제 시범에 크게 의존하므로 대부분의 팀은 둘 다 사용합니다.
현실에서 데이터를 모으는 데는 세 가지 큰 문제가 있습니다.
시뮬레이터는 이 세 가지를 한 번에 해결합니다. 단일 GPU에서 수천 대의 가상 로봇을 병렬로 돌리며, 실패하면 필요한 만큼 재시작할 수 있습니다. 이는 수년치 로봇 경험을 몇 시간으로 압축합니다.
모든 시뮬레이터가 로봇 훈련에 똑같이 유용한 것은 아닙니다. 로봇암 시뮬레이션을 직접 다뤄본 경험상, 좋은 시뮬레이터에는 세 가지가 필요합니다.
가장 자주 마주칠 플랫폼은 NVIDIA Isaac Sim(Isaac Lab 포함)과 MuJoCo입니다.
| 플랫폼 | 개발사 | 강점 | 적합한 용도 |
|---|---|---|---|
| NVIDIA Isaac Sim 및 Isaac Lab | NVIDIA | 포토리얼 렌더링, 센서 시뮬레이션, GPU에서 수천 개 병렬 환경 | 대규모 강화학습 및 합성 카메라 데이터 |
| MuJoCo | Google DeepMind(오픈 소스) | 빠르고 정확한 접촉 물리, 경량, 거대한 연구 커뮤니티 | 연구, 보행·조작 벤치마크 |
가장 최근 추가된 것은 Newton으로, NVIDIA, Google DeepMind, Disney Research가 구축하고 리눅스 재단이 관리하는 오픈 소스 GPU 가속 물리 엔진입니다.
Newton 1.0은 2026년 3월 NVIDIA GTC에서 공개되었습니다. Isaac Lab의 물리 백엔드로 연결되며, MuJoCo Warp를 포함한 솔버와 케이블·천 등 변형체를 위한 추가 솔버를 제공합니다.
변형체는 생각보다 중요합니다. 기존 시뮬레이터는 케이블과 직물을 잘 다루지 못했고, 공장은 이 둘을 다룰 수 있는 로봇을 필요로 합니다.
Sim-to-real 갭은 시뮬레이션에서 훈련된 정책을 실제 로봇에 옮겼을 때 성능이 떨어지는 현상으로, Embodied 시스템의 가장 큰 문제 중 하나입니다.
예를 들어, 시뮬레이션의 마찰은 결코 정확하지 않고, 카메라는 지나치게 깨끗하며, 물체는 너무 완벽할 수 있습니다. 그 결과 시뮬레이션에서 성공률이 95%인 정책이 실제 하드웨어에서는 바로 깨질 수 있습니다.
이 격차를 줄이는 대표적 방법은 두 가지입니다.
시뮬레이터를 완벽하게 만들려 하기보다, 다양한 방식으로 무작위화합니다.
Tobin et al.(2017)은 텍스처와 조명을 강하게 무작위화하여, 실제 세계를 모델이 본 변이 중 하나로 보이게 만들었습니다. OpenAI의 루빅스 큐브 로봇 손은 정책이 좋아질수록 랜덤화 폭을 자동으로 넓혀 더 나아갔습니다.
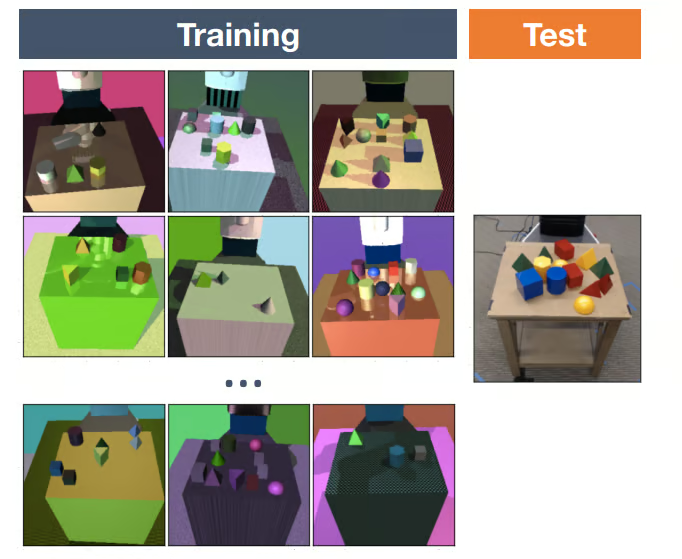
시뮬레이션에서 사전학습된 정책은 이미 과제의 일반적 구조를 배웠기 때문에, 적은 양의 실제 시범만으로도 적응하는 경우가 많습니다.
둘 중 어느 방법도 격차를 완전히 없애지는 못하므로, 팀들은 실제 성능에 미치는 영향을 줄이기 위해 계속 노력합니다.
Embodied AI는 여러 산업에서 이제 연구실을 벗어나 실제로 작동하고 있지만, 분야별로 편차가 큽니다.
제가 보는 패턴은, 환경 변화가 너무 커서 수작업 스크립팅이 어려우면서도 문제가 생기면 사람이 개입할 수 있는 곳부터 먼저 도입된다는 점입니다.
자율주행차는 Embodied AI 중에서도 데이터 요구가 가장 큰 축에 속합니다.
Waymo Driver는 완전 자율 주행으로 거의 2억 마일을 주행했으며, Waymo의 2026년 2월 World Model 게시물에 따르면 시뮬레이션에서 수십억 마일을 훈련·테스트합니다. 시뮬레이션을 통해 Waymo는 실제 사건을 재현하고(예: 주차된 차 사이에서 갑자기 뛰어나오는 아이) 시험 운행 차량이 실제 도로에서 거의 마주치지 못할 희귀 시나리오를 생성할 수 있습니다.
자율주행은 지각-추론-행동 루프가 전속력으로 돌아가는 대표 사례이기도 합니다. Waymo 차량은 카메라·라이다·레이더로 지각하고, 보행자와 차량이 다음에 무엇을 할지 추론하며, 초당 여러 번 조향과 제동을 제어해 행동합니다.
제 생각에, 창고는 현재 Embodied AI의 가장 자연스러운 상용 분야입니다.
바닥 선을 따라 이동하는 고정 경로 로봇에서, 동적이고 어수선한 재고를 처리하는 시스템으로 전환이 이뤄지고 있습니다. 예를 들어 서로 다른 40개 제품이 뒤섞인 토트에서 피킹하는 작업 등입니다.
Agility Robotics의 휴머노이드 Digit은 GXO Logistics에서 2024년에 체결된 다년 계약에 따라 토트를 옮기고 있으며, Boston Dynamics의 Stretch는 트럭에서 상자를 내립니다.
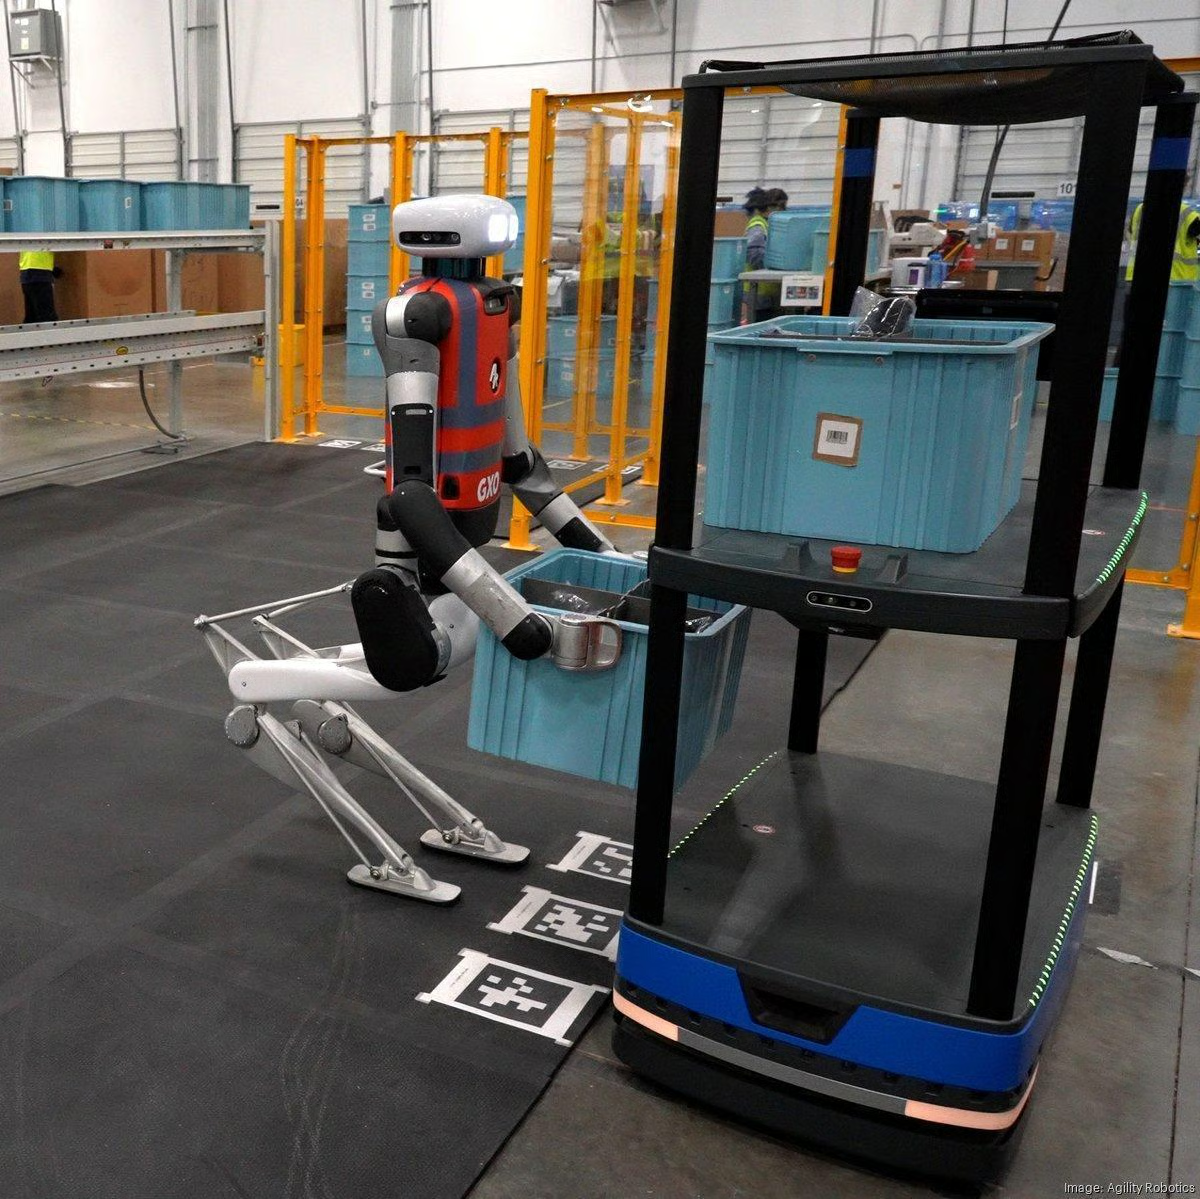
GXO 창고에서 자율 이동 로봇과 컨베이어 사이로 토트를 옮기는 Agility Robotics의 Digit. 이미지 출처: Agility Robotics/The Robot Report
헬스케어는 Embodied AI가 가장 신중하게 진입할 분야로 보입니다.
Intuitive의 다빈치 같은 수술 시스템은 이미 전 세계 병원에서 쓰이고 있지만, 외과의가 조종하며, 여기서의 대부분 AI 연구는 기구 추적, 카메라 제어, 봉합 보조 등 지원에 초점을 맞춥니다.
헬스케어에서는 모델 역량보다 규제 승인 요건이 더 큰 제약인 경우가 많으며, 이는 타당합니다. 개인적으로는 자율 수술에 근접한 것보다 보조 및 교육 활용이 훨씬 먼저 도착하리라 봅니다.
휴머노이드는 가장 큰 주목을 받지만, 검증은 가장 덜 된 분야 중 하나입니다.
CES 2026에서 Boston Dynamics는 Atlas의 양산형을 공개하며, 2026년에 제작되는 모든 유닛이 이미 현대차와 Google DeepMind에 배정되었다고 밝혔습니다. 한편 Figure는 사우스캐롤라이나 스파턴버그의 BMW 공장에서 Figure 02 휴머노이드로 판금 적재 작업을 11개월간 배치했습니다.
하지만 솔직히 말씀드리면, 대부분의 휴머노이드 배치는 여전히 좁은 작업만 수행하는 파일럿입니다. 예를 들어 현대차는 Atlas를 2028년에 부품 시퀀싱에 투입할 계획인데, 이는 최대 후원자들조차 얼마나 신중히 움직이는지 보여줍니다.
이제 이를 실제로 구축하는 곳을 살펴보겠습니다. Embodied AI를 처음 접하는 분들이 알아두면 좋은 조직 다섯 곳입니다.
| 조직 | 무엇을 만드는가 | 왜 중요한가 |
|---|---|---|
| NVIDIA | Isaac Sim, Isaac Lab, Newton, GR00T, Cosmos | 대부분의 팀이 훈련에 사용하는 시뮬레이션·컴퓨트 스택 |
| Physical Intelligence | π₀ 계열 로봇 파운데이션 모델 | 오픈 체크포인트를 제공하는 범용 로봇 정책 |
| Agility Robotics | Digit 휴머노이드 | 창고 물류에 특화되어 이미 고객과 협업 중 |
| Boston Dynamics | Atlas, Stretch, Spot | Atlas를 2026년에 연구 데모에서 양산기로 전환 |
| AMI Labs(Yann LeCun) | JEPA 스타일 월드 모델 | 픽셀 생성 없이 예측하는 월드 모델에 대한 이단아적 베팅 |
NVIDIA는 로봇 자체보다는 로봇을 둘러싼 도구를 주로 만듭니다.
Isaac Sim은 포토리얼 시뮬레이션을, Isaac Lab은 그 위의 강화학습을, Newton은 물리를 제공합니다. NVIDIA는 범용 로봇을 판매하지 않지만, 많은 로보틱스 팀이 NVIDIA 소프트웨어로 훈련합니다.
Physical Intelligence는 π₀를 구축했습니다. 33억 파라미터의 비전-언어-행동 모델로, 플로 매칭을 활용해 빨래 개기 같은 작업에서 매끄러운 동작 덩어리를 생성합니다.
openpi 저장소를 통해 실제로 다운로드할 수 있는 범용 로봇 모델의 대표적 사례입니다.
“파운데이션 모델” 개념이 낯설다면, 우리의 Introduction to Foundation Models 가이드가 개념을 잘 설명합니다.
Agility Robotics는 Digit으로 좁은 길을 택했습니다.
처음부터 창고에서 토트를 옮기는 작업에 맞춰 설계했으며, 이 집중 전략 덕분에 대부분의 휴머노이드보다 빠르게 유료 고객에 도달했습니다.
Boston Dynamics는 Atlas로 정반대 길을 택했습니다.
수년간 로봇의 운동 능력 한계를 밀어붙인(파쿠르 영상 보셨을 겁니다) 뒤, Google DeepMind의 Gemini Robotics 모델이 구동할 전기식 공장 제품으로 전환했습니다.
AMI Labs는 Yann LeCun이 파리에 설립한 스타트업으로, 2026년 3월 프리머니 35억 달러 평가로 10억 300만 달러 시드 라운드를 마쳤습니다. 라운드는 Cathay Innovation, Greycroft, Hiro Capital, HV Capital, Bezos Expeditions가 공동 주도했으며, NVIDIA와 삼성도 참여했습니다.
LeCun은 미래의 모든 픽셀을 예측하는 것은 비효율적이라고 오랫동안 주장해 왔고, 그의 Joint Embedding Predictive Architecture(JEPA)는 대신 추상 표현 공간에서 예측합니다. 이 아이디어는 Meta가 이미 V-JEPA 2로 시험했습니다.
AMI가 주목할 만한 이유는, 이곳이 현재 분야의 주류 흐름과 반대로 간다는 점입니다. 아직 제품을 내놓지는 않았으므로, 검증된 접근이라기보다는 막대한 자금이 뒷받침된 연구적 베팅으로 보는 편이 타당합니다.
Embodied AI는 로보틱스 엔지니어링 문제만이 아닙니다. 많은 부분, 어쩌면 대부분이 기계 학습 문제입니다.
가장 직접적으로 전이되는 스킬은 다음과 같습니다.
시작하려면 로봇이 필요 없습니다. gymnasium 라이브러리는 MuJoCo 환경을 포함하므로, pip install "gymnasium[mujoco]" 설치 후 시뮬레이션 로봇으로 전체 루프를 실행할 수 있습니다.
import gymnasium as gym

# HalfCheetah is a 2D cheetah-like robot simulated with the MuJoCo physics engine
env = gym.make("HalfCheetah-v5")
observation, info = env.reset(seed=42)

for step in range(1000):
    # Perception: the observation holds joint angles and velocities
    # Reasoning: a trained policy would choose the action here, we pick randomly
    action = env.action_space.sample()

    # Action: apply torques to the joints and move the physics forward one step
    observation, reward, terminated, truncated, info = env.step(action)

    if terminated or truncated:
        observation, info = env.reset()

env.close()
지금은 “추론” 단계가 매번 무작위 행동을 고르는 env.action_space.sample()이기 때문에 치타가 이리저리 허우적댈 뿐입니다.
이 한 줄을 학습된 정책으로 바꾸는 것이 바로 강화학습의 역할이며, 더 큰 과제로 넘어가기 전에 꼭 시도해 보시길 권합니다.
Embodied AI는 빠르게 발전하고 있지만, 여전히 다음 네 가지에서 어려움을 겪습니다. 알아둘 가치가 있습니다.
Embodied AI는 기계에 물리적 몸과 그것을 활용하는 지능을 부여합니다. 지각-추론-행동 루프로 작동하며, 물리 데이터의 부족이 주된 제약이고, 2026년 현재 연구실을 넘어 창고와 초기 공장 파일럿으로 진출하고 있습니다.
정말 놀라운 점은 질문의 초점이 바뀌었다는 것입니다. 몇 년 전만 해도, LLM이 로보틱스 연구를 무의미하게 만들지 묻곤 했습니다. 대신 LLM은 Embodied 시스템 내부의 추론 레이어가 되어 가고, 두 분야는 서로를 향해 수렴하고 있습니다.
글의 시작에서 언급한 사과를 기억하시나요? 사과를 집는 법을 아는 것과 실제로 집는 것은 전혀 다른 문제였고, Embodied AI는 그 두 번째 문제를 다루는 분야입니다.
이를 위한 ML 기초를 다지고 싶다면, Python으로 배우는 강화학습 트랙부터 시작하세요. 스택의 언어 측면을 위해서는 대규모 언어 모델(LLM) 개념 강의와 대규모 언어 모델 개발 트랙이 좋은 다음 단계입니다.
Top DataCamp Courses
강의
강의
트랙