Kurs
Głębokie uczenie ze wzmocnieniem w Pythonie
4 godz.
6K
Wyobraź sobie, że prosisz znajomego, żeby podał ci jabłko z misy z owocami. Patrzy na misę, rozpoznaje, które to jabłko, i podnosi je na tyle delikatnie, by go nie zgnieść, po czym ci je podaje.
Teraz poprośmy o to samo chatbota. Potrafi dokładnie opisać, jak chwycić jabłko, których palców użyć i mniej więcej z jaką siłą ścisnąć, ale nie potrafi go faktycznie podnieść. Nie ma rąk ani pojęcia, jak jabłko „czuje się” w dłoni.
Embodied AI to dziedzina, która próbuje wypełnić tę lukę. Mówiąc prosto: to AI, które ma fizyczne ciało (np. robota, samochód lub drona) i uczy się, działając w prawdziwym świecie, a nie tylko „czytając” o nim. Często spotkasz też bliskoznaczny termin „physical AI”.
To obecnie gorący temat. Na targach CES w styczniu 2026 roku Jensen Huang z NVIDIA określił to jako „moment ChatGPT dla robotyki”.
Za słowami poszły pieniądze. Dane Dealroom, cytowane przez CNBC, pokazują, że firmy robotyczne zebrały 55,8 mld USD do początku czerwca 2026 r., niemal podwajając dotychczasowy roczny rekord.
W tym artykule omówię:
Nie martw się, jeśli nigdy wcześniej nie pracowałeś z robotem. Przyda się odrobina znajomości uczenia maszynowego, ale wszystkie pojęcia zbuduję od podstaw, żebyś mógł swobodnie nadążać.
Embodied AI to system sztucznej inteligencji osadzony w fizycznym ciele, takim jak robot, pojazd autonomiczny czy dron, który postrzega swoje otoczenie przez sensory, rozumuje, co zrobić, i działa na świat przez napędy, ucząc się na podstawie skutków własnych działań.
Kluczowe słowo to embodied – ucieleśnione.
Większość modeli AI uczy się, obserwując dane zebrane przez kogoś innego. System ucieleśniony uczy się, wchodząc w interakcję z otoczeniem, np. popychając kubek, obserwując, jak się ślizga, i aktualizując wiedzę o tym, jak kubki zachowują się pod wpływem pchnięcia.
Przykład: model wizji, wytrenowany na milionach zdjęć drzwi, wie, jak drzwi wyglądają. Robot, który faktycznie próbował otworzyć 500 drzwi, wie, że jedne się pcha, inne ciągnie, niektóre są ciężkie, a w jeszcze innych trzeba najpierw nacisnąć klamkę.
Tego poziomu wiedzy nie da się wyciągnąć ze zdjęcia.
Ujmę to tak: większość AI poznaje świat, „czytając” o nim; embodied AI poznaje świat, dotykając go i doświadczając.
Ta jedna różnica zmienia to, jakich danych potrzebujesz, jak trenujesz i jak mogą wyglądać błędy.
Do tej pory porównywałem embodied AI z chatbotem. Teraz zestawmy je z dwiema rzeczami, z którymi najczęściej bywa mylone: dużymi modelami językowymi (LLM-ami) i tradycyjną, regułową robotyką.
| Embodied AI | Duże modele językowe (LLM) | Tradycyjna robotyka regułowa | |
|---|---|---|---|
| Uczy się ze środowiska | Tak, przez interakcję i informację zwrotną | Przeważnie nie, uczy się z ustalonego korpusu tekstu | Nie, zachowanie jest programowane ręcznie |
| Wykonuje działania fizyczne | Tak | Nie | Tak |
| Trenuje na danych z internetu | Częściowo (backbone’y wizji i języka) | Tak, biliony tokenów | Nie |
| Uogólnia na nowe środowiska | Średnio, ale szybko się poprawia | Dobrze, w obrębie zadań językowych | Słabo, psuje się przy zmianie ustawienia |
| Dojrzałość komercyjna w 2026 | Wczesna produkcja (magazyny, pilotaże w fabrykach) | Dojrzałe i szeroko wdrożone | Dojrzałe, dekady użycia w fabrykach |
Ostatnie 2 wiersze to te, które chcę podkreślić.
Ramiona przemysłowe oparte na regułach spawają auta od dekad i są niezwykle niezawodne, ale tylko dlatego, że w ich obszarze pracy nic się nie zmienia. Embodied AI próbuje zachować tę niezawodność, pozwalając jednocześnie na „bałagan” świata – badacze nazywają to uogólnianiem (generalizacją).
LLM-y i embodied AI uczą się z ogromnych ilości danych, ale rozwiązują zupełnie inne problemy. LLM przyjmuje tekst i przewiduje kolejny token, podczas gdy system ucieleśniony przyjmuje klatki z kamer, kąty stawów i odczyty dotyku i przewiduje kolejny ruch.
W skrócie: LLM-y wiedzą o świecie fizycznym, a embodied AI działa w nim. Wracając do jabłka: LLM potrafi opisać, jak je chwycić, a robot z embodied AI potrafi to naprawdę zrobić.
Inny jest też koszt błędu. Gdy LLM się myli, dostajesz lekko dziwne zdanie. Gdy myli się system ucieleśniony, szklanka może wylądować na podłodze – albo gorzej.
I tu dochodzimy do rzeczy, którą wiele osób moim zdaniem pomija: te dwa podejścia współpracują.
W modelach vision-language-action (VLA) wstępnie wytrenowany model wizyjno-językowy siedzi w centrum systemu. Czyta obrazy z kamer i twoją instrukcję („włóż owoce do miski”), po czym przekazuje swoje rozumienie do dekodera akcji, który generuje rzeczywiste komendy dla silników.
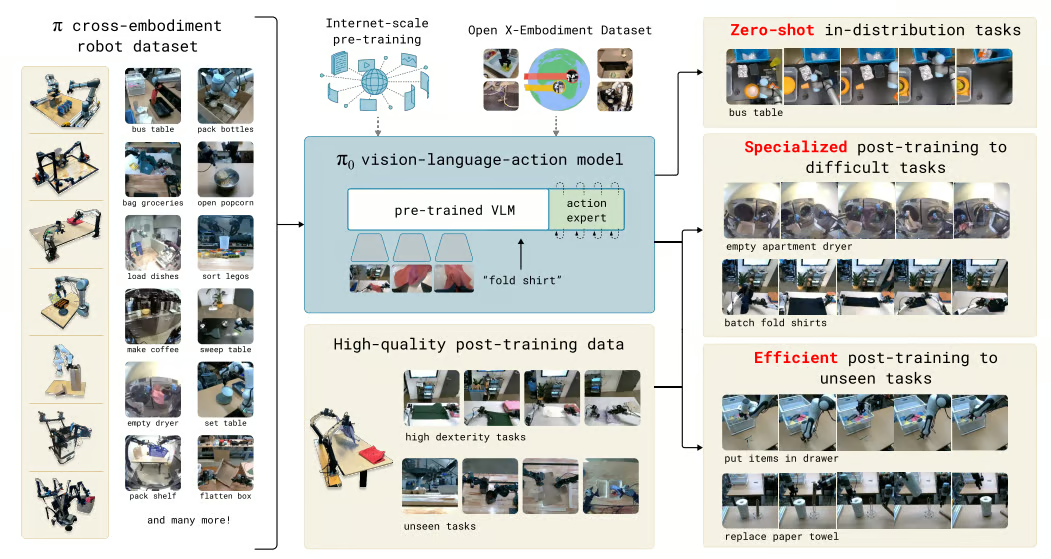
Jak wstępnie wytrenowany model wizyjno-językowy łączy się z akcjami robota w π₀ (pi-zero). Źródło ilustracji: Black i in., 2024
Głównie z powodu danych.
Modele językowe szybko poszły do przodu dzięki dekadom dzielenia się tekstem, kodem i obrazami online, ale nie ma porównywalnego źródła danych z realnych sensorów. Jest o wiele mniej strumieni kątów stawów, odczytów sił i klatek z kamer z robotów wchodzących w interakcje z codziennymi obiektami.
Przyjrzyjmy się bliżej wymaganiom dotyczącym danych. System ucieleśniony potrzebuje 3 typów danych, które trudno zdobyć:
Dodajmy do tego liczby.
Największe LLM-y trenuje się na bilionach tokenów. Open X-Embodiment, jeden z największych otwartych zbiorów dla robotyki, zebrał dane z 22 typów robotów z 21 instytucji i skończył z niewiele ponad 1 mln rzeczywistych trajektorii.
Roboty i zadania połączone w zbiorze Open X-Embodiment. Źródło ilustracji: Open X-Embodiment Collaboration, 2023
Dlaczego tak mało? Każda trajektoria wymaga prawdziwego robota wykonującego prawdziwe zadanie, zwykle sterowanego przez człowieka w teleoperacji, co jest wolne i drogie.
Ta luka sprawia też, że AI w fizycznym świecie wolniej uogólnia niż w cyfrowym. Model najlepiej radzi sobie z wariantami, które już „widział”, a milion trajektorii pokrywa o wiele mniej kuchni, oświetleń i kształtów obiektów niż biliony tokenów pokrywają zdań.
Warto mieć ten problem danych z tyłu głowy w dalszej części artykułu. Wiele decyzji projektowych, które zaraz zobaczysz – od symulacji przez randomizację domenową po zapożyczanie wstępnie wytrenowanych backbone’ów wizyjno-językowych – to sposoby obejścia tej bariery.
Embodied AI działa, uruchamiając w kółko 3 etapy:
Ta pętla powtarza się wiele razy na sekundę, a każdy ruch zmienia to, co robot widzi/wyczuwa w następnym kroku, więc wyjście jednego cyklu staje się wejściem do kolejnego.
Ta sama pętla stoi za modelami świata. W pracy Ha i Schmidhubera „World Models” z 2018 r. agent został podzielony na moduł wizji, pamięci i kontrolera i przetestowany na samochodzie w grze wyścigowej. Embodied AI stosuje tę samą ideę do pełnego robota.
Dobry sposób, by to zrozumieć, to wyobrazić sobie łapanie piłki:
Robot robi to samo, tylko zamiast oczu ma kamery, a zamiast mięśni – silniki.
Przejdźmy po kolei przez każdy etap.
Percepcja zamienia surowe odczyty sensorów w coś, na czym reszta systemu może rozumować. Pojedyncza kamera rzadko wystarcza, więc większość robotów łączy kilka sensorów:
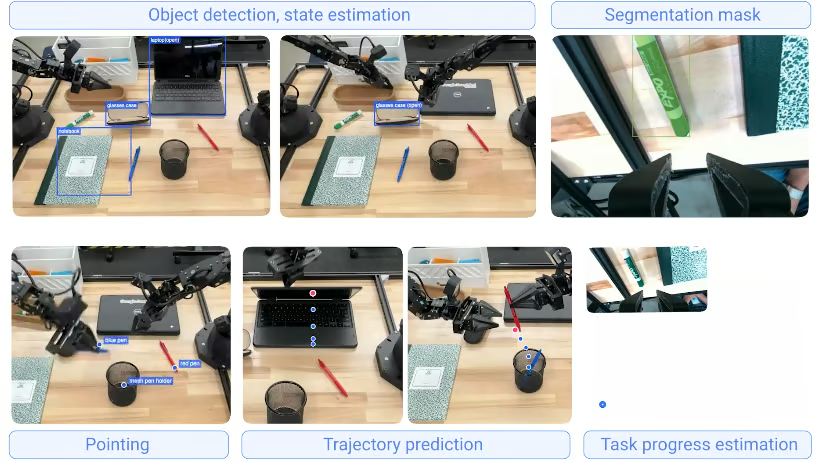
Przykłady wyjść percepcji z Gemini Robotics-ER 1.5. Źródło ilustracji: Google DeepMind
Modele percepcji zamieniają te odczyty w mapy przestrzenne, tożsamości obiektów, położenie przeszkód i ogólne zrozumienie sceny.
Większość to standardowa wizja komputerowa, np. detekcja obiektów, segmentacja czy estymacja głębi, zwykle budowane na wstępnie wytrenowanych transformerach wizji jak DINOv2 czy SigLIP.
Moim zdaniem jednak dotyk jest dziś najbardziej niedocenianą częścią percepcji. Kamera powie ci, że na stole stoi szklanka, ale to dotyk informuje, że szklanka zaczyna wymykać się z dłoni.
Dla orientacji: XELA Robotics pokazała na Automate 2026 opuszek robota z 30 trójosiowymi punktami pomiaru siły upakowanymi w poduszce palca. Firma podaje też, że sensory uSkin potrafią wykrywać siły już od 0,1 grama.
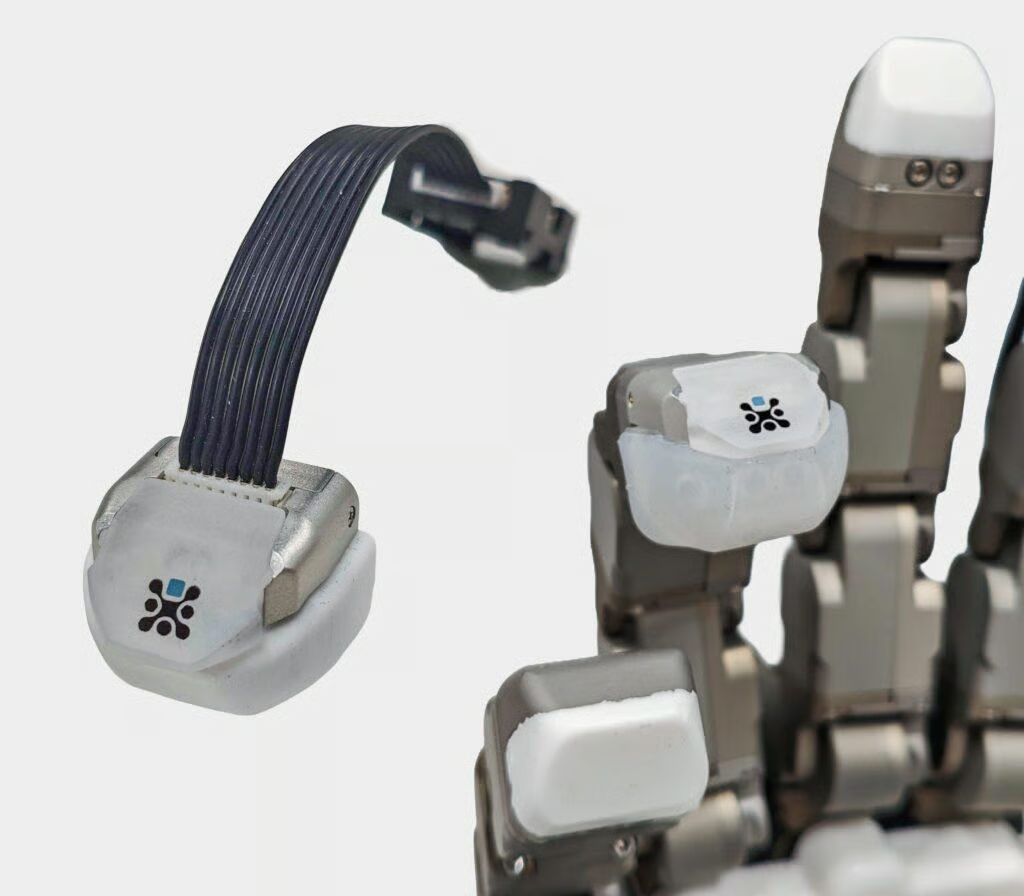
Opuszek robota uSkin z macierzą trójosiowych punktów czucia dotyku. Źródło ilustracji: XELA Robotics
Rozumowanie decyduje, co zrobić dalej. W nowszych systemach zwykle ma 2 warstwy:
To modele świata pozwalają robotowi „wyobrazić sobie” skutki działania przed działaniem.
DreamerV3 to dobry przykład. Uczy się zwartego modelu swojego środowiska, a potem trenuje politykę niemal w całości w tym wyobrażonym świecie.
Używam DreamerV3 w swoich badaniach i najbardziej zaskoczyło mnie, ile więcej czasu agent spędza na ćwiczeniach w „głowie” niż w rzeczywistym środowisku. Ma to znaczenie, bo trening staje się szybszy i znacznie tańszy.
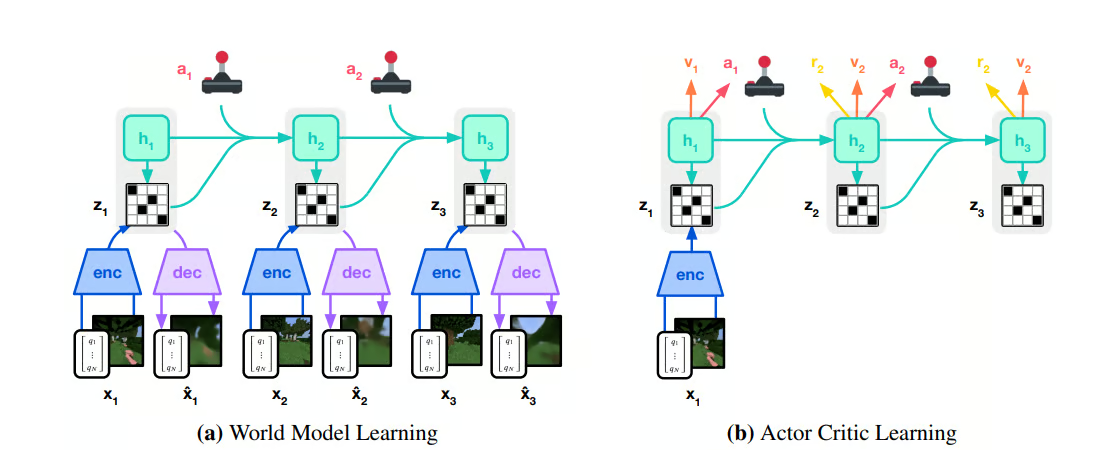
DreamerV3 trenuje politykę na wyobrażonych przebiegach z modelu świata. Źródło ilustracji: Hafner i in., 2023
Planowanie z kolei coraz częściej obsługują modele językowe.
Dobrym przykładem jest Gemini Robotics-ER 1.5 od Google DeepMind, który pełni rolę planera wysokiego poziomu. Dostając zadanie, jak sortowanie odpadów zgodnie z lokalnymi zasadami recyklingu, potrafi sprawdzić zasady w Google Search, rozbić pracę na kroki i przekazać każdy krok do modelu VLA Gemini Robotics 1.5, który wykonuje część fizyczną.
Możesz myśleć o modelu językowym jak o „kierowniku”, a o modelu VLA jak o „wykonawcy”, który realnie robi robotę.
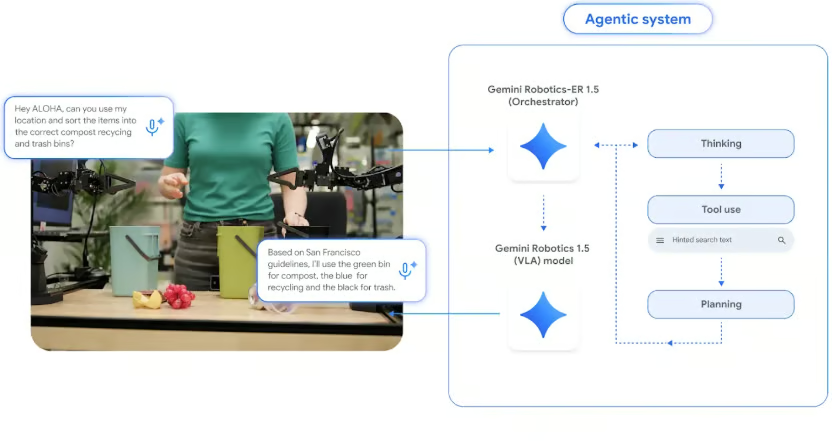
Gemini Robotics-ER 1.5 planuje zadanie i deleguje wykonanie fizyczne do Gemini Robotics 1.5 VLA. Źródło ilustracji: Google DeepMind, 2025
Działanie zamienia decyzję na precyzyjne komendy dla każdego stawu i silnika, zwykle dziesiątki–setki razy na sekundę (w hercach, Hz). Niskopoziomowa część tego etapu to sterowanie (control).
Na przykład komenda „Przesuń chwytak o 5 cm w lewo” brzmi prosto, ale w ramieniu z 7 stawami musi przełożyć się na konkretne momenty dla każdego silnika i być stale przeliczana w trakcie ruchu.
Najtrudniejsze jest to, że rzeczywistość rzadko zgadza się z oczekiwaniami robota. Obiekty się ślizgają, podłogi są lekko nierówne, oświetlenie zmienia się, gdy ktoś podniesie żaluzję, a kabel wygina się inaczej niż przewidywano.
Dobry kontroler zauważa różnicę między tym, czego się spodziewał, a tym, co faktycznie zaszło, i natychmiast koryguje.
Uważam, że działanie jest najtrudniejszym etapem w nieuporządkowanych środowiskach. Błąd percepcji można naprawić, patrząc jeszcze raz, a błąd planowania – przeplanowując, ale błąd sterowania dzieje się w czasie rzeczywistym.
Embodied AI szkoli się na mieszance symulacji i danych ze świata rzeczywistego. Symulacja to wirtualne środowiska wypełnione obiektami 3D z wierną fizyką, w których robot może przećwiczyć miliony razy, zanim dotknie prawdziwego sprzętu.
Pamiętasz problem danych? Symulacja to jedno z głównych obejść, zwłaszcza dla uczenia ze wzmocnieniem w lokomocji i manipulacji. Modele bazowe, takie jak π₀, nadal mocno opierają się na rzeczywistych demonstracjach, więc większość zespołów łączy oba podejścia.
Zbieranie danych w realu ma 3 duże problemy:
Symulator rozwiązuje wszystkie trzy naraz. Możesz uruchomić tysiące wirtualnych robotów równolegle na jednym GPU i pozwolić im dowolnie często zawodzić i restartować się. To kondensuje lata doświadczeń robota do kilku godzin.
Nie każdy symulator równie dobrze nadaje się do szkolenia robotów. Z własnych prac z ramionami w symulacji powiedziałbym, że dobry potrzebuje 3 rzeczy:
Najczęściej spotkasz dwie platformy: NVIDIA Isaac Sim (z Isaac Lab) i MuJoCo:
| Platforma | Twórca | W czym jest dobra | Najlepsza do |
|---|---|---|---|
| NVIDIA Isaac Sim i Isaac Lab | NVIDIA | Fotorealistyczny rendering, symulacja sensorów, tysiące równoległych środowisk na GPU | Duże przebiegi RL i syntetyczne dane z kamer |
| MuJoCo | Google DeepMind (open source) | Szybka, dokładna fizyka kontaktu, lekkość, ogromna społeczność naukowa | Badania, benchmarki lokomocji i manipulacji |
Najnowszym dodatkiem jest Newton, otwartoźródłowy, akcelerowany przez GPU silnik fizyki, zbudowany przez NVIDIA, Google DeepMind i Disney Research, zarządzany przez Linux Foundation.
Newton 1.0 został wydany na NVIDIA GTC w marcu 2026. Wpina się do Isaac Lab jako backend fizyki, z MuJoCo Warp jako jednym z solverów i dodatkowymi solverami dla obiektów podatnych na odkształcenia, jak kable i tkaniny.
Deformowalne obiekty są ważniejsze, niż brzmią. Starsze symulatory słabo radziły sobie z kablami i tkaninami, a fabryki potrzebują robotów, które poradzą sobie z obiema kategoriami.
Luka sim-to-real to spadek jakości, który pojawia się, gdy politykę wytrenowaną w symulacji przeniesiesz na prawdziwego robota – to jeden z największych problemów systemów ucieleśnionych.
Na przykład: symulowane tarcie nigdy nie jest idealne, kamery w symulacji są zbyt „czyste”, a obiekty zbyt doskonałe, więc polityka osiągająca 95% skuteczności w symulacji może się posypać przy kontakcie z realnym sprzętem.
Są 2 główne sposoby domykania tej luki:
Zamiast próbować uczynić symulator perfekcyjnym, zespoły silnie go losowo modyfikują na wiele sposobów.
Tobin i in. (2017) tak mocno losowali tekstury i oświetlenie, że świat rzeczywisty wyglądał dla modelu jak kolejna wariacja. Ręka do kostki Rubika od OpenAI poszła dalej, automatycznie poszerzając randomizację wraz z poprawą polityki.
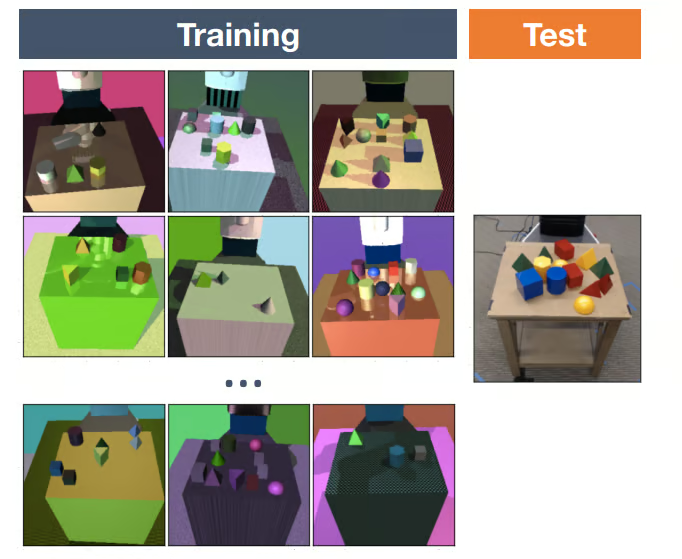
Polityka wstępnie nauczona w symulacji często potrzebuje tylko niewielkiego zbioru rzeczywistych demonstracji, by się zaadaptować, bo poznała już ogólny kształt zadania.
Żadna z technik całkowicie luki nie usuwa, więc zespoły wciąż pracują, by zmniejszać jej wpływ na wyniki w realu.
Embodied AI działa poza laboratoriami w kilku branżach, choć bardzo nierówno.
Wzorzec, który widzę, jest taki, że trafia najpierw tam, gdzie środowisko zbyt mocno się zmienia, by dało się je zascriptować ręcznie, ale człowiek nadal może wkroczyć, gdy coś pójdzie nie tak.
Samochody autonomiczne to jedne z najbardziej „głodnych danych” form embodied AI.
Waymo Driver przejechał niemal 200 mln mil w pełni autonomicznie, a także trenuje i testuje na miliardach mil w symulacji, zgodnie z postem Waymo z lutego 2026 o ich World Model. Symulacja pozwala odtwarzać prawdziwe incydenty i generować rzadkie scenariusze (np. dziecko wybiegające spomiędzy zaparkowanych aut), których flota testowa może nigdy nie napotkać na drogach.
Autonomiczne auta dobrze ilustrują pętlę percepcja–rozumowanie–działanie działającą na pełnych obrotach. Pojazd Waymo postrzega kamerami, lidarem i radarem, rozumuje, co zrobią za chwilę piesi i inni kierowcy, i działa, sterując kierownicą i hamulcami wiele razy na sekundę.
Moim zdaniem magazyny to dziś najbardziej naturalne komercyjne zastosowanie embodied AI.
Zmiana polega na przejściu od robotów poruszających się po stałych trasach do systemów radzących sobie z dynamicznym, nieuporządkowanym stanem zapasów, np. z pobieraniem przedmiotów z pojemnika, gdzie wrzucono razem 40 różnych produktów.
Humanoid Digit od Agility Robotics przenosi pojemniki w GXO Logistics na mocy wieloletniej umowy z 2024 r., a Boston Dynamics Stretch rozładowuje kartony z ciężarówek.
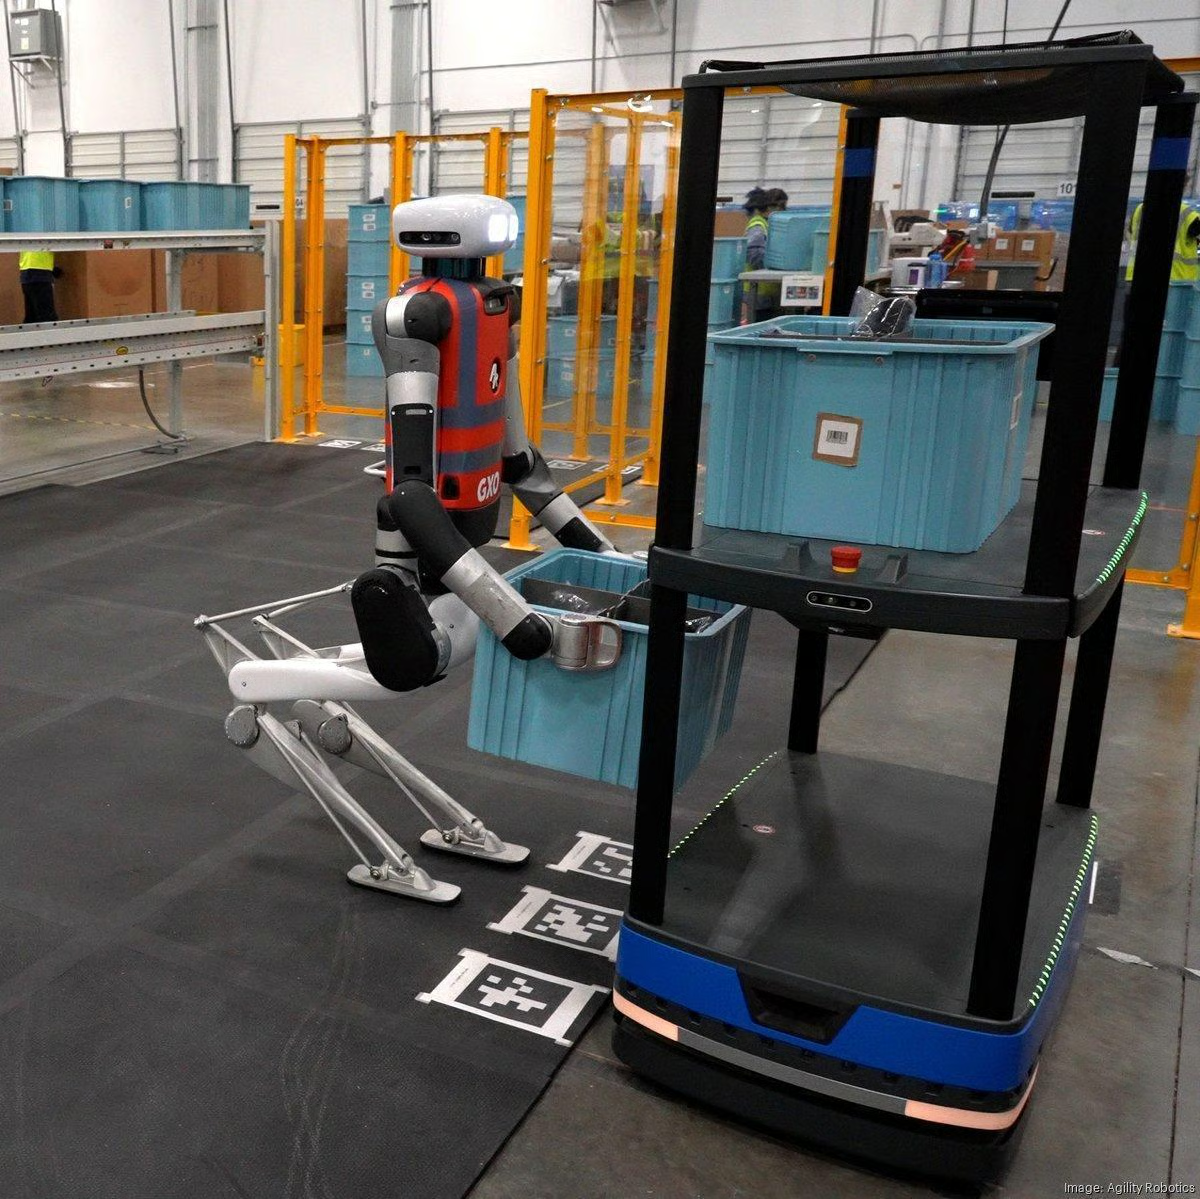
Digit od Agility Robotics przenosi pojemniki między autonomicznymi robotami mobilnymi a przenośnikiem w magazynie GXO. Źródło ilustracji: Agility Robotics/The Robot Report
W ochronie zdrowia spodziewam się najbardziej ostrożnego postępu embodied AI.
Systemy chirurgiczne, takie jak da Vinci od Intuitive, są już używane na całym świecie, ale steruje nimi chirurg, a większość badań AI koncentruje się tu na asyście: śledzeniu narzędzi, sterowaniu kamerą, wsparciu szycia.
W medycynie zgoda regulacyjna bywa większym ograniczeniem niż możliwości modeli – i słusznie. Osobiście spodziewałbym się, że zastosowania asystujące i szkoleniowe pojawią się długo przed czymkolwiek zbliżonym do autonomicznej operacji.
Humanoidy przyciągają najwięcej uwagi i są jednocześnie najmniej sprawdzone.
Na CES 2026 Boston Dynamics pokazał wersję produkcyjną Atlasa i ogłosił, że wszystkie jednostki z 2026 roku są już zarezerwowane dla Hyundaia i Google DeepMind. Z kolei Figure zrealizował 11-miesięczne wdrożenie humanoida Figure 02 w fabryce BMW w Spartanburgu (Karolina Południowa), ładując blachy.
Bądźmy jednak szczerzy: większość wdrożeń humanoidów to wciąż pilotaże wykonujące wąski zestaw zadań. Hyundai planuje np. rozpocząć użycie Atlasa do sekwencjonowania części w 2028 r., co pokazuje, jak ostrożnie posuwają się nawet najwięksi zwolennicy.
Przejdźmy teraz do tego, kto to wszystko buduje. Oto 5 organizacji, które – moim zdaniem – każdy nowy w embodied AI powinien kojarzyć:
| Organizacja | Co budują | Dlaczego to ważne |
|---|---|---|
| NVIDIA | Isaac Sim, Isaac Lab, Newton, GR00T i Cosmos | Stos symulacji i mocy obliczeniowej, na którym trenuje większość zespołów |
| Physical Intelligence | Rodzina modeli bazowych robotów π₀ | Uniwersalne polityki robotów z otwartymi checkpointami |
| Agility Robotics | Humanoid Digit | Stworzony do logistyki magazynowej i już pracuje z klientami |
| Boston Dynamics | Atlas, Stretch i Spot | Przenoszą Atlasa z demonstracji badawczych do jednostek produkcyjnych w 2026 |
| AMI Labs (Yann LeCun) | Modele świata w stylu JEPA | Kontrariański zakład na modele świata, które nie generują pikseli |
NVIDIA w większości buduje narzędzia wokół robota, a nie samego robota.
Isaac Sim odpowiada za fotorealistyczną symulację, Isaac Lab za RL ponad nią, a Newton może teraz dostarczać fizykę. Wiele zespołów robotycznych trenuje na oprogramowaniu NVIDIA, mimo że firma nie sprzedaje ogólnego robota.
Physical Intelligence stworzyło π₀, 3,3‑miliardowy model vision‑language‑action, który używa flow matchingu do generowania gładkich sekwencji akcji dla zadań takich jak składanie prania.
To najlepszy znany mi przykład uniwersalnego modelu robota, który można faktycznie pobrać – przez repozytorium openpi.
Jeśli pojęcie „modelu bazowego” jest dla ciebie nowe, nasz przewodnik Wprowadzenie do modeli bazowych dobrze je wyjaśnia.
Agility Robotics obrało wąską ścieżkę z Digit.
Od początku zaprojektowano go do przenoszenia pojemników w magazynach, a ta koncentracja była kluczowa, by dojść do płacących klientów szybciej niż większość humanoidów.
Boston Dynamics poszło przeciwną drogą z Atlasem.
Przez lata przesuwało granice sprawności robota (pewnie widziałeś filmy z parkurem), zanim przekształciło go w w pełni elektryczny produkt dla fabryk, który Google DeepMind planuje zasilać modelami Gemini Robotics.
AMI Labs to paryski startup Yanna LeCuna, który w marcu 2026 zamknął rundę seed w wysokości 1,03 mld USD przy wycenie pre-money 3,5 mld USD. Rundę współprowadziły Cathay Innovation, Greycroft, Hiro Capital, HV Capital i Bezos Expeditions, a wśród inwestorów są m.in. NVIDIA i Samsung.
LeCun od lat twierdzi, że przewidywanie każdego piksela przyszłości jest nieefektywne, więc jego Joint Embedding Predictive Architecture (JEPA) dokonuje predykcji w abstrakcyjnej przestrzeni reprezentacji – pomysł, który Meta przetestowała już w V-JEPA 2.
AMI warto obserwować, bo idzie pod prąd kierunkowi większości pola. Na razie jednak nic nie wypuściło, więc traktowałbym to jako zakład badawczy z dużymi pieniędzmi za plecami, a nie sprawdzoną ścieżkę.
Embodied AI to nie tylko inżynieria robotów. Duża część pracy – powiedziałbym, że większość – to praca z uczeniem maszynowym.
Najbardziej przenaszalne umiejętności to:
Nie potrzebujesz robota, żeby zacząć. Biblioteka gymnasium dostarcza środowiska MuJoCo, więc po uruchomieniu pip install "gymnasium[mujoco]" możesz uruchomić całą pętlę na symulowanym robocie:
import gymnasium as gym

# HalfCheetah is a 2D cheetah-like robot simulated with the MuJoCo physics engine
env = gym.make("HalfCheetah-v5")
observation, info = env.reset(seed=42)

for step in range(1000):
    # Perception: the observation holds joint angles and velocities
    # Reasoning: a trained policy would choose the action here, we pick randomly
    action = env.action_space.sample()

    # Action: apply torques to the joints and move the physics forward one step
    observation, reward, terminated, truncated, info = env.step(action)

    if terminated or truncated:
        observation, info = env.reset()

env.close()
Na razie gepard tylko się miota, bo krok „rozumowania” to env.action_space.sample(), który za każdym razem wybiera losową akcję.
Zastąpienie tej jednej linii wytrenowaną polityką to dokładnie to, do czego służy uczenie ze wzmocnieniem – polecam spróbować, zanim ruszysz do większych rzeczy.
Embodied AI szybko postępuje, ale nadal ma 4 słabe punkty – warto je znać:
Embodied AI daje maszynom fizyczne ciało i inteligencję, by z niego korzystać. Działa w pętli percepcja–rozumowanie–działanie, hamuje je głównie niedobór danych fizycznych i w 2026 roku wychodzi z laboratoriów do magazynów i pierwszych pilotaży w fabrykach.
Najbardziej zaskakuje mnie zmiana pytania. Kilka lat temu ludzie pytali, czy LLM-y nie uczynią badań nad robotyką zbędnymi. Zamiast tego LLM-y stają się warstwą rozumowania w systemach ucieleśnionych, a oba pola coraz bardziej się zazębiają.
Pamiętasz jabłko z początku? Wiedzieć, jak je podnieść, i faktycznie je podnieść okazało się dwoma zupełnie innymi problemami – a embodied AI zajmuje się tym drugim.
Jeśli chcesz zbudować fundamenty ML pod to wszystko, zacznij od naszego tracka Reinforcement Learning w Pythonie. Po stronie językowej dobrym kolejnym krokiem są kurs Koncepcje dużych modeli językowych (LLM) i track Developing Large Language Models.
Najlepsze kursy DataCamp
Kurs
Kurs
Ścieżka