コース
Pythonで学ぶDeep Reinforcement Learning
4時間
6K
友人に果物ボウルからリンゴを取って渡してもらうよう頼むところを想像してください。友人はボウルを見て、どれがリンゴかを判断し、つぶさない程度の力加減で持ち上げて、あなたに手渡します。
では同じことをチャットボットに頼んだらどうでしょう。リンゴの持ち方、どの指を使うべきか、おおよその力加減まで正確に説明はできますが、実際に持ち上げることはできません。手がなく、リンゴの触感もわからないからです。
エンボディドAIは、このギャップを埋めようとする分野です。簡単に言えば、物理的な身体(ロボット、車、ドローンなど)を持ち、単に文章を読むのではなく、現実世界で行動することで学習するAIです。同じ考え方を指す用語として「フィジカルAI」もよく使われます。
いま、この分野は大きな転機を迎えています。2026年1月のCESで、NVIDIAのJensen Huangはこれを「ロボティクスにおけるChatGPTの瞬間」と表現しました。
資金も流れ込んでいます。CNBCが報じたDealroomのデータによると、ロボティクス企業は2026年6月初旬までに558億ドルを調達し、過去の年間記録をほぼ倍増させました。
本記事では次の内容を扱います。
ロボットに触れたことがなくても心配はいりません。機械学習に多少の馴染みがあれば助けになりますが、どちらにせよ基礎から順を追って解説するので、無理なく読み進められます。
エンボディドAIは、ロボット、自動運転車、ドローンのような物理的な身体に組み込まれ、センサーで環境を知覚し、何をするかを推論し、モーターを通じて世界に作用し、自らの行動の結果から学習する人工知能システムです。
ここでの鍵はエンボディド(身体性)です。
多くのAIモデルは、他者が収集したデータを観察して学びます。これに対し、エンボディドなシステムは、コップを押して、コップが滑るのを観察し、押したときにコップがどう振る舞うかという知識を更新する、といった具合に、環境と相互作用して学びます。
例を挙げましょう。数百万枚のドアの写真で学習したビジョンモデルは、ドアがどのように見えるかを知っています。一方で、実際に500枚のドアを開けようとしたロボットは、押すドアもあれば引くドアもあり、重いものもあれば、先にハンドルを押し下げる必要があるものもある、と知っています。
このレベルの知識は写真からは得られません。
こう表現するのが好きです。多くのAIは世界について「読んで」学ぶが、エンボディドAIは世界に「触れ、体験する」ことで学ぶのです。
この違いが、必要なデータ、学習方法、そして想定外の事態の起こり方を一変させます。
ここまで、エンボディドAIをチャットボットと比べてきました。次に、人々がよく混同する2つ、すなわち大規模言語モデル(LLM)と従来のルールベースロボティクスと比較してみましょう。
| エンボディドAI | 大規模言語モデル(LLM) | 従来のルールベースロボティクス | |
|---|---|---|---|
| 環境から学習する | はい。相互作用とフィードバックを通じて | ほぼいいえ。固定のテキストコーパスから学習 | いいえ。挙動は手作業でプログラム |
| 物理的な行動をとる | はい | いいえ | はい |
| インターネットデータで学習する | 一部(ビジョンと言語のバックボーン) | はい。兆単位のトークン | いいえ |
| 新しい環境への汎化 | 中程度。急速に改善中 | 良好(言語タスク内で) | 不十分。設定が変わると破綻 |
| 2026年の商用成熟度 | 初期本番(倉庫、工場でのパイロット) | 成熟し広く展開 | 成熟。工場で数十年の実績 |
特に最後の2行に注目してください。
ルールベースの産業用アームは数十年にわたり自動車を溶接してきました。極めて信頼性が高いのは、作業セル内の何も変化しないからです。エンボディドAIは、その信頼性を保ちながら、現実世界の乱雑さを許容しようとします。研究者はこれを汎化と呼びます。
LLMとエンボディドAIはいずれも膨大なデータから学習しますが、解く問題は大きく異なります。LLMはテキストを入力として次に来るトークンを予測します。一方、エンボディドシステムはカメラ画像、関節角度、触覚の読み取り値を入力として、次に行うべき動きを予測します。
要するに、LLMは物理世界を知っており、エンボディドAIは物理世界で行動します。リンゴの例に戻ると、LLMは持ち上げ方を正確に説明でき、エンボディドAIのロボットは実際にそれを行えます。
誤りの代償もまったく違います。LLMが間違えば、やや奇妙な文章になるだけです。エンボディドシステムが間違えば、グラスが床に落ちるかもしれませんし、もっと悪い事態もあり得ます。
そして多くの人が見落とす点があります。両者は連携するということです。
VLA(ビジョン・言語・アクション)モデルでは、事前学習済みのビジョン・言語モデルがシステムの中核に位置します。これはカメラ画像とあなたの指示(「果物をボウルに入れて」)を読み取り、その理解をアクションデコーダに渡し、実際のモーターコマンドを生成します。
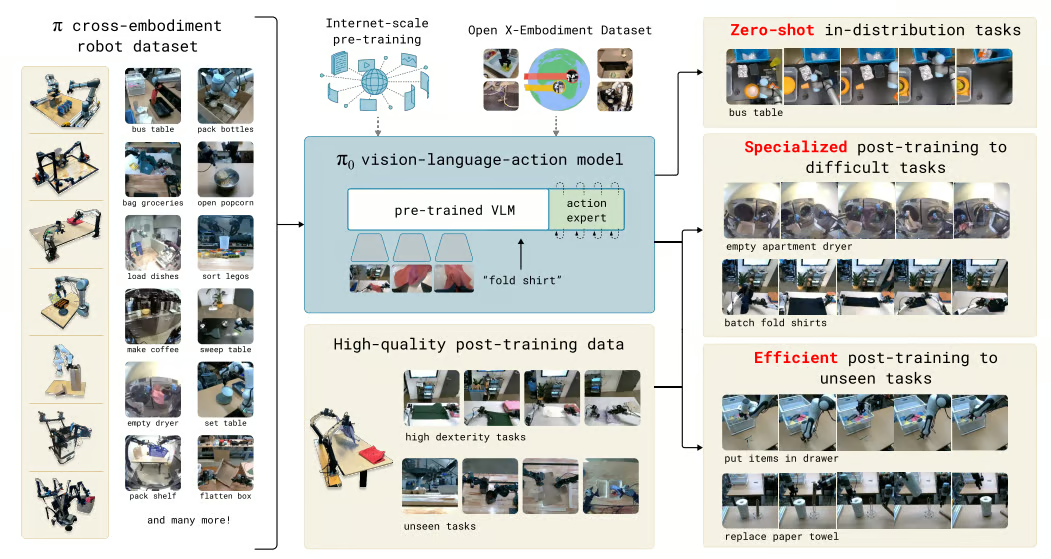
事前学習済みビジョン・言語モデルがπ₀(パイ・ゼロ)でロボットの行動に接続される仕組み。出典画像:Black et al., 2024
フィジカルAIがデジタルAIより難しい主因はデータです。
言語モデルは、何十年にもわたるテキスト、コード、画像のオンライン共有により急速に進歩しましたが、現実世界のセンサー情報に相当する共有源は存在しません。日常物体と相互作用するロボットから得られる関節角、力覚、カメラフレームの流れははるかに少ないのです。
データ要件を詳しく見てみましょう。エンボディドシステムは、入手が難しい3種類のデータを必要とします。
ここで具体的な数字を見てみます。
最先端のLLMは兆単位のトークンで学習します。最大級のオープンロボティクスデータセットであるOpen X-Embodimentは、21機関・22種のロボットからデータを集約しても、現実の軌跡は100万強にとどまりました。
Open X-Embodimentデータセットに統合されたロボットとタスク。出典画像:Open X-Embodiment Collaboration, 2023
なぜこれほど少ないのか。各軌跡は、実在のロボットが実タスクを実行する必要があり、たいていは人間がテレオペで操作します。これは時間もコストもかかります。
このギャップこそ、フィジカルAIの汎化がデジタルAIより遅い理由でもあります。モデルは、類似の事例を見ていればいるほど変動に強くなりますが、100万の軌跡では、兆単位のトークンが文章をカバーする幅に比べて、キッチン、照明、物体形状のバリエーションを大幅に取りこぼします。
この記事の残りの部分でも、このデータ問題を頭の片隅に置いてください。以下で出てくる設計判断の多く(シミュレーション、ドメインランダム化、事前学習済みのビジョン・言語バックボーンの活用など)は、すべてこの問題への対処法です。
エンボディドAIは、次の3段階の連続ループで動作します。
このループは毎秒何度も繰り返され、あらゆる動きが次の知覚に影響するため、あるサイクルの出力は次のサイクルの入力になります。
同じループはワールドモデルの背後にもあります。HaとSchmidhuberの2018年の「World Models」論文は、エージェントをビジョン、メモリ、コントローラに分け、レースゲームの車でテストしました。エンボディドAIは同じ発想をフルのロボットに適用します。
このループを理解する良い方法は、ボールをキャッチする場面を想像することです。
ロボットも同じで、目の代わりにカメラ、筋肉の代わりにモーターを使うだけです。
では各段階を見ていきましょう。
知覚は、生のセンサー値を、システム全体が推論可能な表現に変換する段階です。単一のカメラだけでは足りないことが多く、たいてい複数のセンサーを組み合わせます。
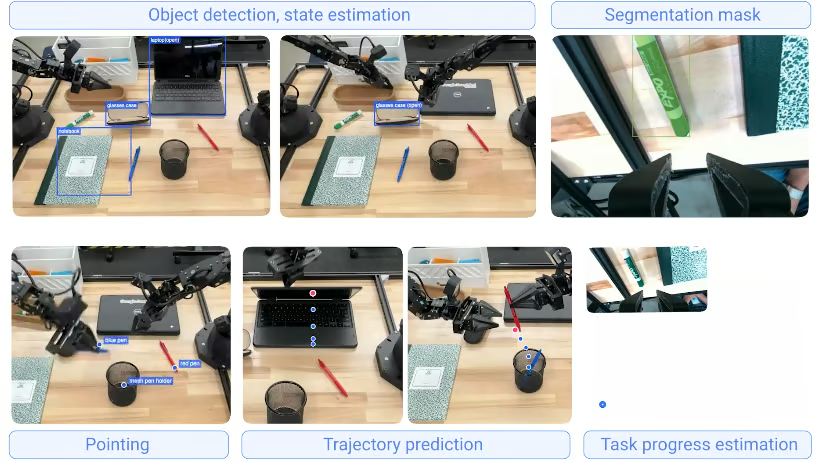
Gemini Robotics-ER 1.5の知覚出力例。出典画像:Google DeepMind
知覚モデルは、これらの読み取り値を空間地図、物体の同定、障害物の位置、シーン全体の理解へと変換します。
多くは標準的なコンピュータビジョンであり、物体検出、セグメンテーション、深度推定などが含まれ、通常はDINOv2やSigLIPのような事前学習済みのビジョントランスフォーマーの上に構築されます。
とはいえ、触覚は今もっとも過小評価されている知覚要素だと私は思います。カメラはテーブルの上にグラスがあることは教えてくれますが、グラスが手から滑り始めていることを教えるのは触覚です。
現状の一例として、XELA RoboticsはAutomate 2026で、パッド部に30個の3軸力覚センサーポイントを内蔵したロボット指先を披露しました。同社はuSkinセンサーが0.1グラム重相当の力まで検出可能だとも述べています。
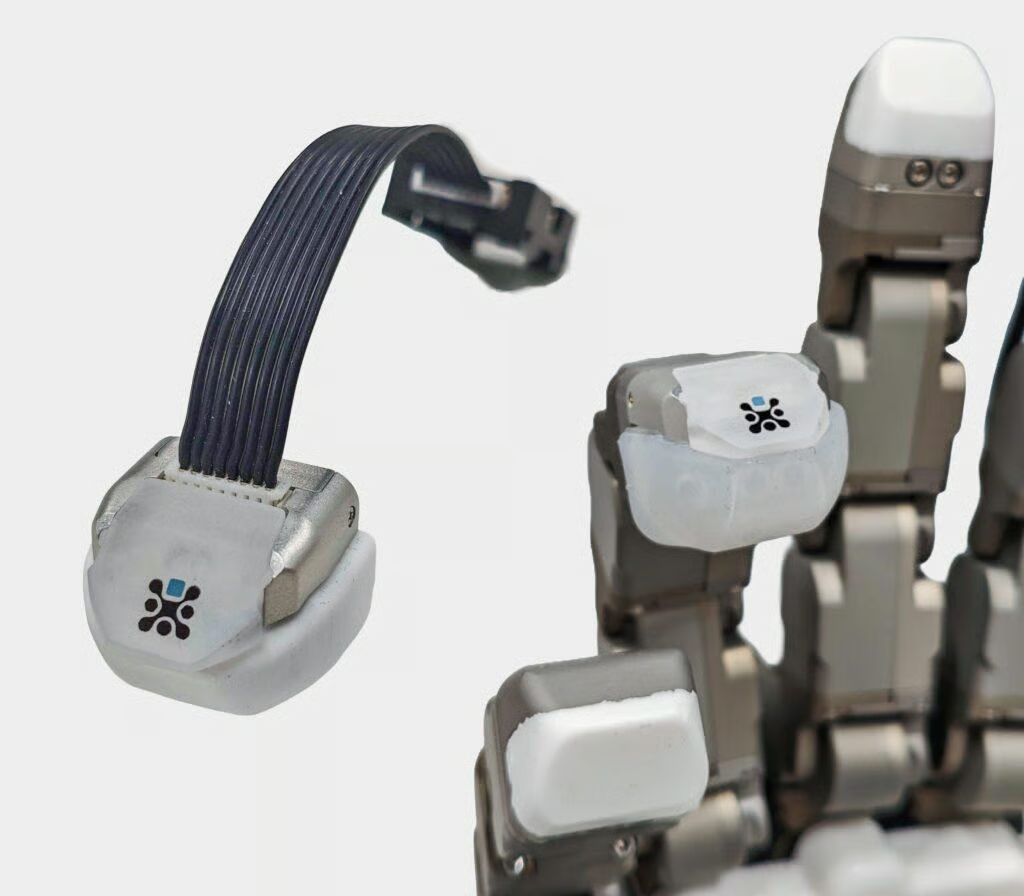
三軸触覚センサーポイント配列を内蔵したuSkinロボット指先。出典画像:XELA Robotics
推論は、次に何をするかを決める段階です。新しいシステムでは、通常2層構造になっています。
ワールドモデルは、ロボットに「行動の前に想像させる」ものです。
DreamerV3は良い例です。環境のコンパクトなモデルを学習し、その想像上の世界の中でほぼすべての方策学習を行います。
私自身の研究でもDreamerV3を使っていますが、もっとも驚いたのは、エージェントが実環境よりも「頭の中」で練習する時間の方がはるかに長いことです。これは、学習が速く、はるかに低コストになることを意味します。
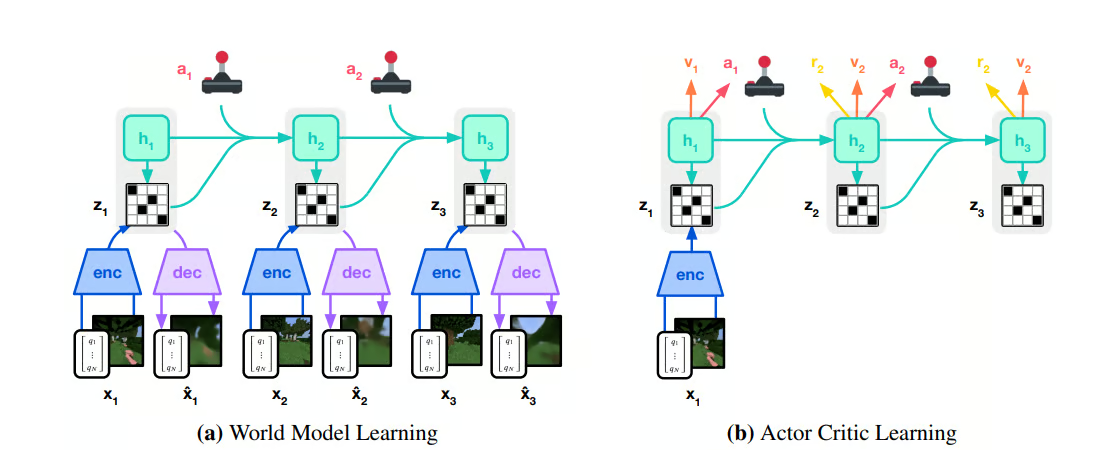
DreamerV3は、ワールドモデルの想像ロールアウトで方策を学習します。出典画像:Hafner et al., 2023
一方、プランニングは言語モデルが担うことが増えています。
好例がGoogle DeepMindのGemini Robotics-ER 1.5で、高レベルのプランナーとして機能します。地域のリサイクル規則に従って廃棄物を仕分けるようなタスクでは、Google検索で規則を調べ、作業をステップに分解し、各ステップを物理作業を行うGemini Robotics 1.5のVLAモデルに渡します。
言語モデルは管理者、VLAモデルは実際に作業をする作業者、と考えるとわかりやすいでしょう。
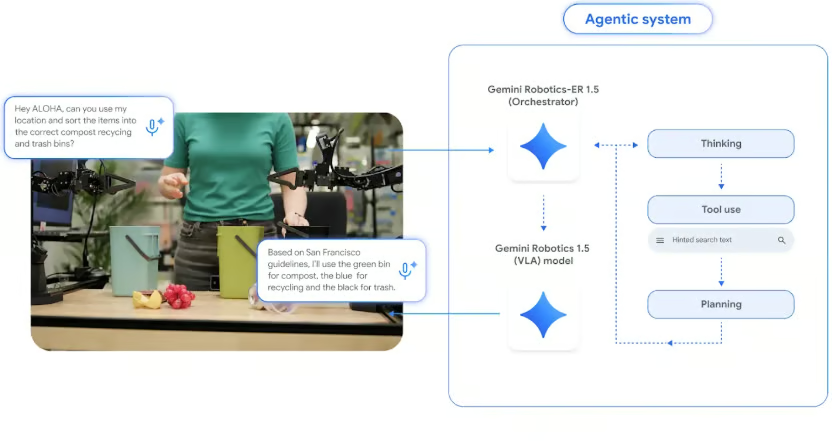
Gemini Robotics-ER 1.5はタスクを計画し、物理的な実行をGemini Robotics 1.5 VLAに委譲します。出典画像:Google DeepMind, 2025
行動は、意思決定を各関節・モーターへの精密なコマンドに変換する段階で、通常は毎秒数十〜数百回(Hz)行われます。この段階の低レベル部分が制御(コントロール)です。
例えば「グリッパーを左に5cm動かす」というコマンドは単純に聞こえますが、7関節アームでは各関節モーターに対する具体的なトルクに変換し、動作中は継続的に再計算し続けねばなりません。
難しいのは、現実がロボットの予測どおりにならないことが多い点です。物体は滑り、床はわずかに不整で、ブラインドを開けると照明が変わり、ケーブルは予測と異なる曲がり方をします。
優れたコントローラは、予測と実際の差異に気づき、即座に補正します。
私は、雑多で構造化されていない環境では、行動(制御)がもっとも難しい段階だと考えます。知覚の誤りは見直せば修正できますし、計画の誤りは再計画で修正できますが、制御の誤りはリアルタイムで発生します。
エンボディドAIは、シミュレーションと実世界データを組み合わせて学習します。シミュレーションとは、物理的に正確な3Dオブジェクトで満たされた仮想環境のことで、ロボットは現実のハードウェアに触れる前に何百万回も練習できます。
前述のデータ問題を思い出してください。シミュレーションは、特に歩行やマニピュレーションの強化学習における主な回避策のひとつです。π₀のような基盤モデルは依然として実デモに大きく依存するため、多くのチームは両方を使います。
実世界でのデータ収集には3つの大きな問題があります。
シミュレータはこれら3つを同時に解決します。単一GPU上で何千もの仮想ロボットを並列稼働させ、必要なだけ失敗・再開を繰り返せます。これは数年分のロボット経験を数時間に凝縮します。
すべてのシミュレータがロボット学習に等しく有用というわけではありません。私自身がロボットアームをシミュレーションで扱ってきた経験から、良い環境には次の3条件が必要です。
最もよく目にするプラットフォームは、NVIDIA Isaac Sim(およびIsaac Lab)とMuJoCoです。
| プラットフォーム | 開発元 | 得意分野 | 最適な用途 |
|---|---|---|---|
| NVIDIA Isaac Sim と Isaac Lab | NVIDIA | フォトリアルなレンダリング、センサーシミュレーション、GPU上での数千環境の並列実行 | 大規模強化学習と合成カメラデータ |
| MuJoCo | Google DeepMind(オープンソース) | 高速で正確な接触物理、軽量、大規模研究コミュニティ | 研究、歩行・マニピュレーションのベンチマーク |
最新の追加がNewtonで、NVIDIA、Google DeepMind、Disney Researchが構築し、Linux Foundationの管理下にあるGPU加速のオープンソース物理エンジンです。
Newton 1.0は2026年3月のNVIDIA GTCでリリースされました。Isaac Labの物理バックエンドとして接続でき、SolverとしてMuJoCo Warpを備え、ケーブルや布のような可変形物体向けの追加Solverも提供します。
可変形物は見た目以上に重要です。古いシミュレータはケーブルや布の扱いが不得手で、工場ではその両方を扱えるロボットが求められています。
シム・トゥ・リアルギャップとは、シミュレーションで学習した方策を実機に移した際に生じる性能低下のことで、エンボディドシステム最大の課題のひとつです。
例えば、シミュレーションの摩擦は常に少しずれ、カメラはきれいすぎ、物体は理想化されがちです。そのため、シミュレーションでは95%成功していた方策が、実機に出会った途端に破綻することがあります。
このギャップを埋める主要な手法は2つあります。
シミュレータを完璧に近づけるのではなく、さまざまな形でランダム化します。
Tobinら(2017)はテクスチャや照明を大きくランダム化し、実世界がモデルにとって「もうひとつのバリエーション」に見えるようにしました。OpenAIのルービックキューブ用ロボットハンドは、方策が上達するにつれてランダム化の幅を自動的に広げました。
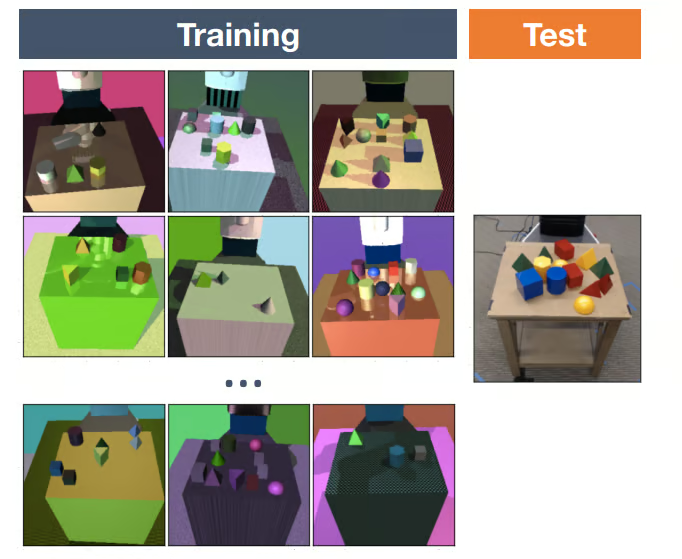
シミュレーションで事前学習した方策は、タスクの「型」をすでに学んでいるため、適応のために必要な実デモは少数で済むことが多いです。
どちらの手法もギャップを完全には消せないため、現実世界での性能への影響を抑えるべく、各チームは取り組みを続けています。
エンボディドAIは、分野によって濃淡はあるものの、すでに研究室の外で稼働しています。
私の見立てでは、人手でスクリプト化するには環境変動が大きいが、問題が起きたら人間が介入できる場所から順に導入が進みます。
自動運転は、もっともデータを必要とするエンボディドAIの一種です。
Waymo Driverは完全自動で約2億マイルを走行し、さらにシミュレーションで数十億マイルの学習・テストを行っていると、2026年2月のWaymoのWorld Modelに関する投稿で述べています。シミュレーションにより、実際のインシデントを再現したり、実路ではテスト車両が遭遇しないようなレアケース(例:駐車車両の間から子どもが飛び出す)を生成できます。
自動運転は、知覚・推論・行動ループが全開で回っている好例でもあります。Waymoの車両はカメラ、ライダー、レーダーで知覚し、歩行者や車両が次に取りそうな行動を推論し、ハンドルやブレーキを毎秒何度も制御して行動します。
私見では、倉庫は現在もっとも自然なエンボディドAIの商用用途です。
床のラインに従う固定経路型ロボットから、動的で雑多な在庫に対応できるシステムへのシフトが進んでいます。例えば40種類の製品が一緒くたに入ったトートからのピッキングなどです。
Agility Roboticsのヒューマノイド「Digit」は、2024年に締結された複数年契約のもとGXO Logisticsでトート搬送を行っており、Boston DynamicsのStretchはトラックからの箱出しを担います。
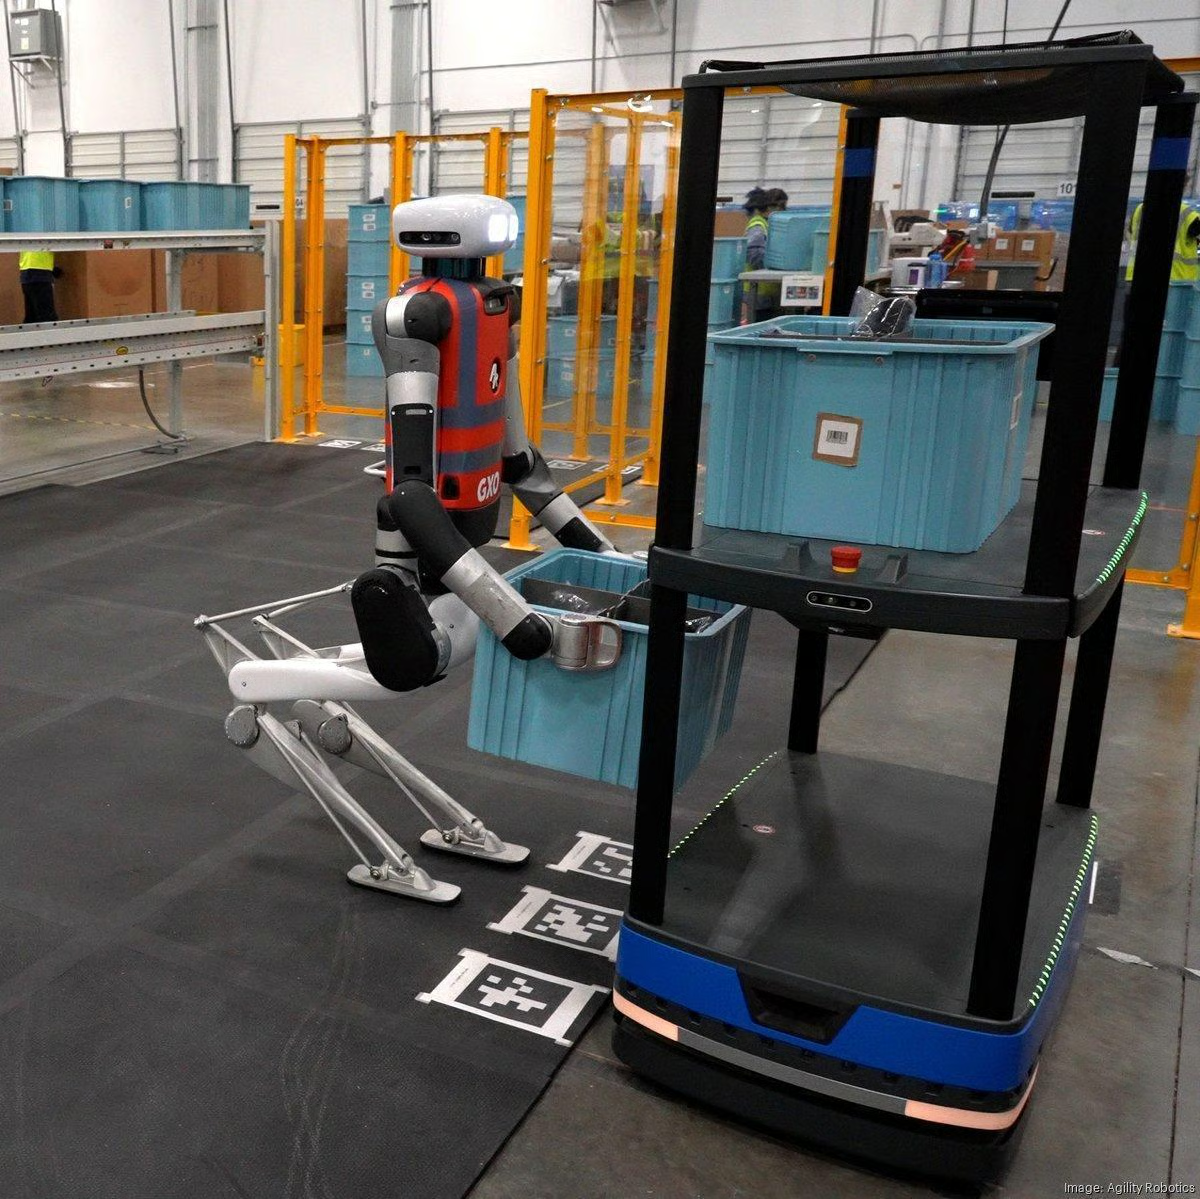
Agility RoboticsのDigitが、AMRとコンベヤ間でトートを搬送。出典画像:Agility Robotics/The Robot Report
ヘルスケアは、エンボディドAIがもっとも慎重に進む領域だと見ています。
Intuitiveのda Vinciのような手術支援システムは、すでに世界中の病院で使われていますが、操作者は外科医です。この分野のAI研究の多くは、器具追跡、カメラ制御、縫合支援といったアシストに焦点を当てています。
ヘルスケアでは、モデルの能力以上に規制承認が制約となることが多く、そしてそれは正当です。自律手術に近いものが来る前に、アシストやトレーニング用途が先に普及すると個人的には予想します。
ヒューマノイドは注目度が高い一方で、実績は限定的です。
CES 2026でBoston DynamicsはAtlasの量産版を発表し、2026年に製造する全台数はHyundaiとGoogle DeepMindにすでに割り当て済みだと述べました。一方Figureは、サウスカロライナ州スパータンバーグのBMW工場で、Figure 02ヒューマノイドによる板金ロードの11か月の導入を行いました。
率直に言えば、多くのヒューマノイド導入は、いまだ限定タスクのパイロット段階です。例えばHyundaiはAtlasを2028年に部品シーケンシングで使い始める計画で、最大手であっても極めて慎重に進めていることがわかります。
では、実際にこれらを作っているのは誰でしょうか。エンボディドAIを初めて学ぶ方に、最低限押さえてほしい5つの組織を挙げます。
| 組織 | 開発物 | 重要な理由 |
|---|---|---|
| NVIDIA | Isaac Sim、Isaac Lab、Newton、GR00T、Cosmos | 多くのチームが学習に使うシミュレーションとコンピュートのスタック |
| Physical Intelligence | π₀系のロボット基盤モデル | オープンなチェックポイントを備えた汎用ロボット方策 |
| Agility Robotics | ヒューマノイドDigit | 倉庫物流に特化し、すでに顧客と稼働 |
| Boston Dynamics | Atlas、Stretch、Spot | Atlasを研究デモから2026年に量産機へ移行 |
| AMI Labs(Yann LeCun) | JEPA系ワールドモデル | ピクセル生成を行わないワールドモデルへの逆張り |
NVIDIAは、ロボット本体というよりロボットを取り巻くツール群を主に開発しています。
Isaac Simはフォトリアルなシミュレーションを、Isaac Labはその上での強化学習を、Newtonは物理を担います。NVIDIAは汎用ロボットを販売していないにもかかわらず、多くのロボティクスチームがNVIDIAのソフトウェアで学習しています。
Physical Intelligenceは、π₀という33億パラメータのビジョン・言語・アクションモデルを構築し、フローマッチングで洗濯物たたみのようなタスク向けの滑らかなアクション列を生成します。
実際にダウンロードできる汎用ロボットモデルとして、私が知る限り最良の例です。openpiリポジトリから入手できます。
「基盤モデル」の概念が初めてであれば、Introduction to Foundation Modelsガイドがわかりやすく説明しています。
Agility Roboticsは、Digitで狭い領域に絞りました。
当初から倉庫でのトート搬送に最適化されており、この明確な焦点が、他の多くのヒューマノイドより早く有償の顧客導入に至った大きな理由です。
Boston Dynamicsは、Atlasで対照的なアプローチを取りました。
(パルクール動画でおなじみのように)長年ロボットの運動性能を限界まで高め、その後、Google DeepMindのGemini Roboticsモデルで駆動する計画の、オール電動の工場製品へと転換しました。
AMI LabsはYann LeCunのパリ拠点のスタートアップで、2026年3月に10億3000万ドルのシードラウンドを実施(プレマネー評価35億ドル)。Cathay Innovation、Greycroft、Hiro Capital、HV Capital、Bezos Expeditionsが共同主導し、NVIDIAやSamsungも出資しています。
LeCunは、将来の各ピクセルを予測するのは無駄が多いと長年主張しており、Joint Embedding Predictive Architecture(JEPA)は、代わりに抽象表現空間で予測を行います。このアイデアは、MetaがすでにV-JEPA 2で検証済みです。
AMIが注目に値するのは、分野の主流からあえて外れている点です。もっとも、まだ何も出荷していないため、現時点では実証済み手法というより、大型の資金が付いた研究上の賭けと見るのが妥当でしょう。
エンボディドAIはロボティクス工学だけの問題ではありません。作業の多く、むしろ大半は機械学習の仕事だと言ってよいでしょう。
もっとも直結するスキルは以下です。
開始にロボットは不要です。gymnasiumライブラリにはMuJoCo環境が同梱されているため、pip install "gymnasium[mujoco]"を実行すれば、シミュレーションロボットでループ全体を動かせます。
import gymnasium as gym

# HalfCheetah is a 2D cheetah-like robot simulated with the MuJoCo physics engine
env = gym.make("HalfCheetah-v5")
observation, info = env.reset(seed=42)

for step in range(1000):
    # Perception: the observation holds joint angles and velocities
    # Reasoning: a trained policy would choose the action here, we pick randomly
    action = env.action_space.sample()

    # Action: apply torques to the joints and move the physics forward one step
    observation, reward, terminated, truncated, info = env.step(action)

    if terminated or truncated:
        observation, info = env.reset()

env.close()現時点では、チェータは「推論」ステップがenv.action_space.sample()で毎回ランダムに行動を選ぶため、ただバタバタするだけです。
この1行を学習済みの方策に置き換えるのが、まさに強化学習の役割です。より大きな題材に進む前に、ぜひ試してみてください。
エンボディドAIは急速に進歩していますが、なお4つの弱点があり、知っておく価値があります。
エンボディドAIは、機械に物理的な身体と、それを使いこなす知能を与えます。知覚・推論・行動のループで動作し、主な制約は物理データの不足です。2026年現在、研究室を出て、倉庫や初期の工場パイロットへと進みつつあります。
何より驚くのは、問いの向きが変わったことです。数年前は、LLMがロボティクス研究を不要にするのでは、と問われました。実際には、LLMはエンボディドシステム内部の推論層となり、両分野は相互に融合しつつあります。
記事冒頭のリンゴを思い出してください。持ち方を「知っている」ことと、実際に「持ち上げる」ことは、まったく別の問題でした。エンボディドAIは、その後者に取り組む分野です。
この基盤となるMLを学びたいなら、まずはReinforcement Learning in Pythonトラックから始めてください。スタックの言語側は、Large Language Models (LLMs) Conceptsコースや、Developing Large Language Modelsトラックが良い次の一歩になります。
Top DataCamp Courses
コース
コース
トラック