
Cursus
Deep Reinforcement Learning in Python
4 uur
6K
Stel, je vraagt een vriend om je een appel uit een fruitschaal aan te geven. Die kijkt naar de schaal, bepaalt welke vrucht de appel is, en pakt hem voorzichtig op zodat hij niet geplet wordt, voordat hij hem aan je geeft.
Laten we nu een chatbot hetzelfde vragen. Die kan je precies vertellen hoe je een appel oppakt, welke vingers je gebruikt en ongeveer hoe hard je moet knijpen, maar kan er geen een daadwerkelijk oppakken. Hij heeft geen handen en geen idee hoe een appel aanvoelt.
Embodied AI is het vakgebied dat deze kloof probeert te dichten. Simpel gezegd is het AI met een fysiek lichaam (zoals een robot, auto of drone) die leert door dingen in de echte wereld te doen in plaats van er alleen over te lezen. Je ziet ook de nauw verwante term “physical AI” voor hetzelfde idee.
Op dit moment maakt het vak een grote sprong. Op CES in januari 2026 noemde NVIDIA’s Jensen Huang het “het ChatGPT-moment voor robotica.”
Het geld volgde. Dealroom-data, gerapporteerd door CNBC, laat zien dat roboticabedrijven in 2026 tot begin juni $55,8 miljard hebben opgehaald, bijna het dubbele van het vorige jaarrecord.
In dit artikel behandel ik:
Geen zorgen als je nog nooit met een robot hebt gewerkt. Enige bekendheid met machine learning helpt, maar ik bouw elk idee vanaf de basis op zodat je het ook dan kunt volgen.
Embodied AI is een kunstmatig intelligentiesysteem ingebouwd in een fysiek lichaam, zoals een robot, een autonoom voertuig of een drone, dat zijn omgeving waarneemt via sensoren, redeneert over wat te doen, en via motoren handelt in de wereld, waarbij het leert van de uitkomsten van zijn eigen acties.
Het sleutelwoord hier is embodied.
De meeste AI-modellen leren door te observeren wat een ander heeft verzameld. Een embodied systeem leert door te interageren met zijn omgeving, zoals een kopje duwen, kijken hoe het schuift en bijwerken wat het weet over hoe kopjes zich gedragen als je ze duwt.
Een voorbeeld: een visionmodel getraind op miljoenen foto’s van deuren weet hoe een deur eruitziet. Een robot die daadwerkelijk 500 deuren heeft geprobeerd te openen weet dat sommige deuren duwen, andere trekken, sommige zwaar zijn en sommige handgrepen hebben die je eerst omlaag moet drukken.
Die diepgang haal je niet uit een foto.
Ik zeg het graag zo: de meeste AI leert over de wereld door erover te lezen; embodied AI leert over de wereld door hem te voelen en te ervaren.
Dat ene verschil verandert welke data je nodig hebt, hoe je traint en hoe dingen mis kunnen gaan.
Tot nu toe heb ik embodied AI met een chatbot vergeleken. Laten we het nu vergelijken met de twee dingen waarmee het het vaakst wordt verward: large language models (LLM’s) en traditionele regelgebaseerde robotica.
| Embodied AI | Large language models (LLM’s) | Traditionele regelgebaseerde robotica | |
|---|---|---|---|
| Leert van de omgeving | Ja, via interactie en feedback | Meestal niet, leert van een vaste tekstcorpus | Nee, gedrag wordt met de hand geprogrammeerd |
| Neemt fysieke acties | Ja | Nee | Ja |
| Traint op internetdata | Gedeeltelijk (zijn vision- en language-backbones) | Ja, triljoenen tokens | Nee |
| Generaliseert naar nieuwe omgevingen | Matig, en snel beter | Goed, binnen taaltaken | Slecht, breekt als de setup verandert |
| Commerciële volwassenheid in 2026 | Vroege productie (magazijnen, fabriekspilots) | Volwassen en wijdverspreid ingezet | Volwassen, decennia in fabrieken gebruikt |
De laatste twee rijen wil ik uitlichten.
Regelgebaseerde industriële armen lassen al decennia auto’s en zijn extreem betrouwbaar, maar alleen omdat er in hun werkcel nooit iets verandert. Embodied AI probeert die betrouwbaarheid te behouden terwijl de wereld rommelig mag zijn, wat onderzoekers generalisatie noemen.
LLM’s en embodied AI leren allebei van enorme hoeveelheden data, maar lossen heel verschillende problemen op. Een LLM krijgt tekst binnen en voorspelt welk token daarna moet komen, terwijl een embodied systeem cameraframes, gewrichtshoeken en tastmetingen binnenkrijgt en voorspelt welke beweging daarna moet komen.
Kortom, LLM’s weten over de fysieke wereld, terwijl embodied AI er in handelt. Terug naar onze appel: een LLM kan precies beschrijven hoe je er een oppakt, en een embodied AI-robot kan het daadwerkelijk doen.
De kosten van een fout zijn ook heel anders. Als een LLM iets verkeerd doet, krijg je een wat vreemde zin. Als een embodied systeem iets verkeerd doet, ligt er een glas op de grond, of erger.
Hier is het deel dat veel mensen missen: de twee werken samen.
In vision-language-action (VLA)-modellen zit een voorgetraind vision-languagemodel in de kern. Het leest de camerabeelden en je instructie (“leg het fruit in de schaal”), en geeft zijn begrip door aan een actiedecoder die de daadwerkelijke motorcommando’s produceert.
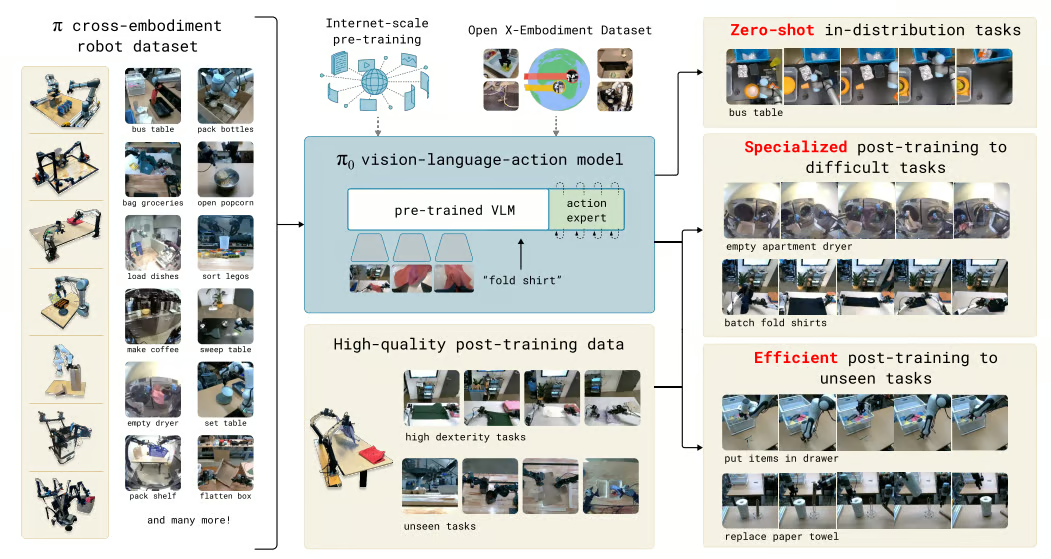
Hoe een voorgetraind vision-languagemodel in π₀ (pi-zero) verbonden is met robotacties. Afbeelding uit bron: Black et al., 2024
Physical AI is vooral moeilijker dan digitale AI vanwege data.
Taalmodellen gingen snel vooruit dankzij decennia waarin mensen tekst, code en afbeeldingen online deelden, maar er is geen vergelijkbare bron van echte sensordata. Er zijn veel minder stromen van gewrichtshoeken, krachtmetingen en cameraframes van robots die met alledaagse objecten interageren.
Laten we de dataeisen nader bekijken. Een embodied systeem heeft drie soorten data nodig die lastig te vinden zijn:
Laten we hier wat cijfers op plakken.
Frontier-LLM’s worden getraind op triljoenen tokens. Open X-Embodiment, een van de grootste open roboticadatasets, bundelde data van 22 robottype’s over 21 instellingen en kwam uit op iets meer dan 1 miljoen echte trajecten.
De robots en taken die in de Open X-Embodiment-dataset zijn gebundeld. Afbeelding uit bron: Open X-Embodiment Collaboration, 2023
Waarom zo weinig? Elk traject vereist een echte robot die een echte taak uitvoert, meestal door een mens via teleoperatie bediend, wat traag en duur is.
Dit gat is ook waarom physical AI langzamer generaliseert dan digitale AI. Een model gaat het best om met variatie als het eerder iets vergelijkbaars heeft gezien, en een miljoen trajecten dekken veel minder keukens, lichtsituaties en objectvormen dan triljoenen tokens zinnen dekken.
Houd dit dataprobleem in je achterhoofd voor de rest van het artikel. Veel ontwerpkeuzes die je hieronder ziet—van simulatie tot domeinrandomisatie tot het lenen van voorgetrainde vision-language-backbones—zijn omwegen hiervoor.
Embodied AI werkt door een continue loop van drie fasen te draaien:
Deze loop herhaalt zich vele keren per seconde, en elke beweging verandert wat de robot daarna waarneemt, dus de output van de ene cyclus wordt de input van de volgende.
Dezelfde loop zit ook achter world models. Ha en Schmidhubers “World Models”-paper uit 2018 splitste een agent in een visionmodule, een geheugeneenheid en een controller, en testte dit op een auto in een racespel. Embodied AI past hetzelfde idee toe op een volledige robot.
Een goede manier om de loop te begrijpen is een bal vangen voor te stellen:
Een robot doet hetzelfde, maar dan met camera’s in plaats van ogen en motoren in plaats van spieren.
Laten we elke fase apart bekijken.
Waarneming is de fase die ruwe sensorlezingen omzet in iets waar de rest van het systeem op kan redeneren. Eén camera is zelden genoeg, dus de meeste robots combineren meerdere sensoren:
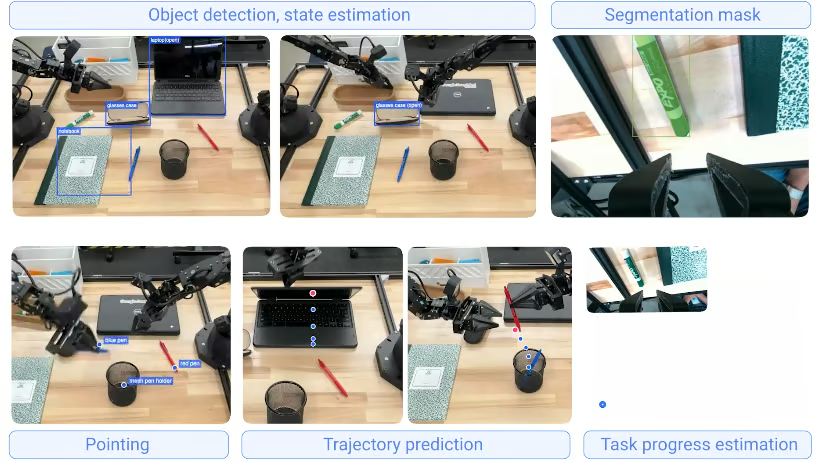
Voorbeelden van perceptie-uitvoer van Gemini Robotics-ER 1.5. Afbeelding uit bron: Google DeepMind
Perceptiemodellen zetten deze metingen vervolgens om in ruimtelijke kaarten, objectidentiteiten, obstakelposities en een algemeen begrip van de scène.
Het meeste hiervan is standaard computer vision, zoals objectdetectie, segmentatie en diepteschatting, meestal gebouwd op voorgetrainde vision transformers zoals DINOv2 of SigLIP.
Naar mijn mening is tast op dit moment het meest ondergewaardeerde deel van waarneming. Een camera kan je vertellen dat er een glas op tafel staat, maar tast vertelt je dat het glas uit je greep begint te glijden.
Ter illustratie: XELA Robotics toonde op Automate 2026 een robotvingertop met 30 drie-assige krachtmeetpunten in het kussentje. Het bedrijf zegt ook dat zijn uSkin-sensoren krachten zo klein als 0,1 gramkracht kunnen detecteren.
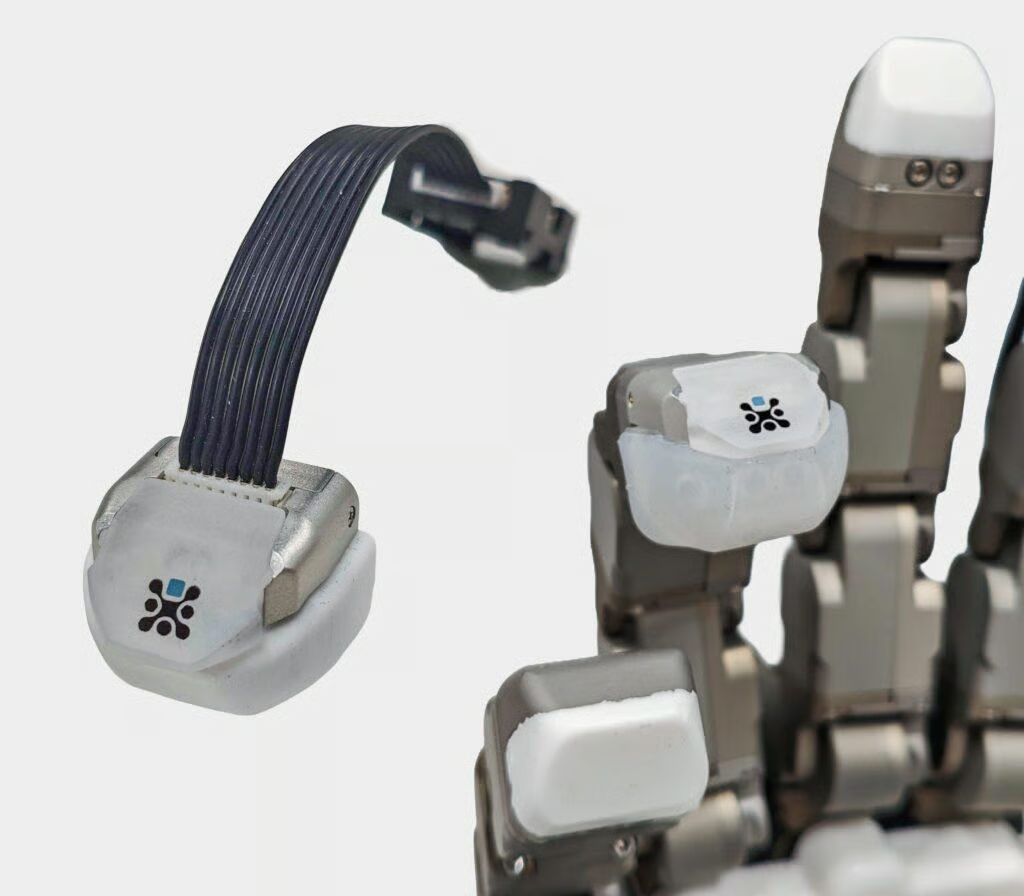
Een uSkin-robotvingertop met een array van drie-assige tactiele meetpunten. Afbeelding uit bron: XELA Robotics
Redeneren is de fase die beslist wat er nu moet gebeuren. In nieuwere systemen heeft die meestal twee lagen:
World models stellen een robot in staat om te “verbeelden” voordat hij handelt.
DreamerV3 is een goed voorbeeld. Het leert een compacte representatie van zijn omgeving en traint zijn policy vervolgens bijna volledig in die ingebeelde wereld.
Ik gebruik DreamerV3 in mijn eigen onderzoek, en wat me het meest verbaast is hoeveel meer tijd de agent in zijn “hoofd” oefent dan in de daadwerkelijke omgeving. Dat is belangrijk omdat trainen sneller en veel goedkoper wordt.
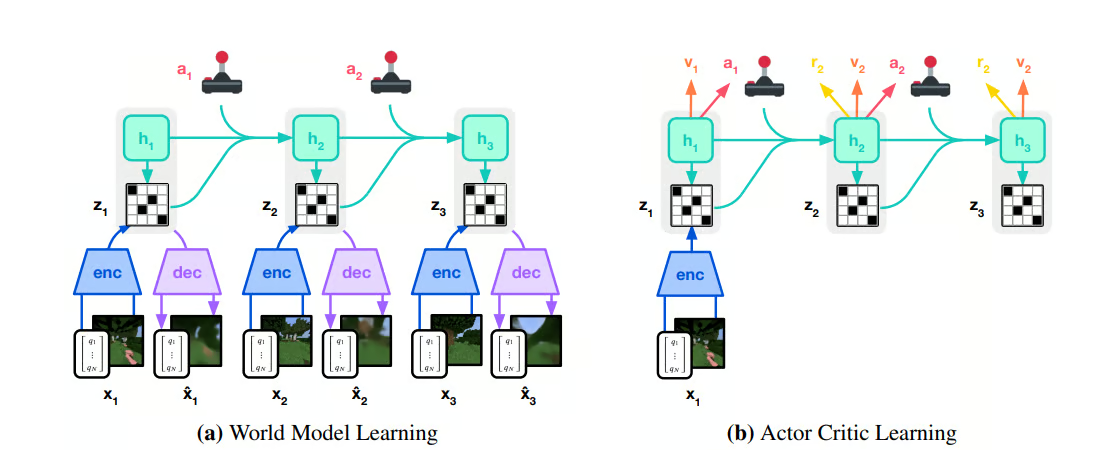
DreamerV3 traint zijn policy op ingebeelde rollouts uit zijn world model. Afbeelding uit bron: Hafner et al., 2023
Plannen wordt daarentegen steeds vaker door taalmodellen gedaan.
Een goed voorbeeld is Gemini Robotics-ER 1.5 van Google DeepMind, dat fungeert als high-level planner. Bij een taak als afval sorteren volgens lokale recyclingregels kan het met Google Search de regels opzoeken, de klus in stappen opdelen en elke stap overdragen aan het Gemini Robotics 1.5 VLA-model dat het fysieke werk doet.
Je kunt het taalmodel zien als de manager en het VLA-model als de uitvoerder die het werk daadwerkelijk doet.
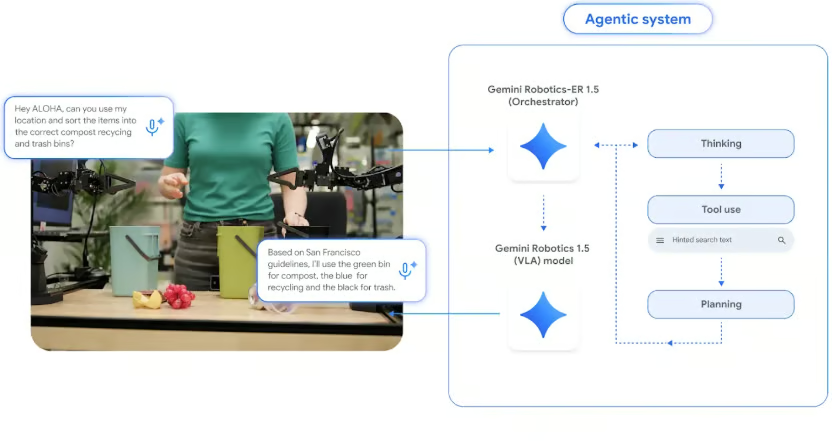
Gemini Robotics-ER 1.5 plant de taak en delegeert fysieke uitvoering aan de Gemini Robotics 1.5 VLA. Afbeelding uit bron: Google DeepMind, 2025
Actie is de fase die een beslissing omzet in precieze commando’s voor elk gewricht en elke motor, meestal tientallen tot honderden keren per seconde (gemeten in hertz, of Hz). Het laagniveaudeel hiervan heet control.
Een commando als “Verplaats de grijper 5 cm naar links” klinkt simpel, maar op een arm met zeven gewrichten moet dat worden vertaald naar een specifiek koppel per gewrichtsmotor, continu herberekend terwijl de arm beweegt.
Het moeilijke is dat de realiteit zelden precies overeenkomt met wat de robot verwachtte. Objecten slippen, vloeren zijn net niet vlak, het licht verandert als iemand een jaloezie opent, en een kabel buigt anders dan voorspeld.
Een goede controller merkt het verschil tussen verwachting en werkelijkheid en corrigeert direct.
Ik denk dat actie de lastigste fase is om goed te krijgen in rommelige, ongestructureerde omgevingen. Een waarnemingsfout kun je herstellen door nog eens te kijken en een planningsfout door opnieuw te plannen, maar een controlfout gebeurt in real time.
Embodied AI wordt getraind op een mix van simulatie en echte data. Simulatie betekent virtuele omgevingen gevuld met natuurgetrouwe 3D-fysica, waar een robot miljoenen keren kan oefenen voordat hij echte hardware aanraakt.
Weet je nog het dataprobleem van eerder? Simulatie is een van de belangrijkste omwegen, vooral voor reinforcement learning van locomotie en manipulatie. Foundation-modellen zoals π₀ leunen nog steeds sterk op echte demonstraties, dus de meeste teams gebruiken beide.
Data verzamelen in de echte wereld kent drie grote problemen:
Een simulator pakt alle drie tegelijk aan. Je kunt duizenden virtuele robots parallel op één GPU draaien en ze zo vaak laten falen en herstarten als nodig. Dit condenseert jaren aan robotervaring in een paar uur.
Niet elke simulator is even nuttig voor het trainen van robots. Uit mijn werk met robotarmen in simulatie zou ik zeggen dat een goede er drie dingen nodig heeft:
De twee platforms die je het vaakst tegenkomt zijn NVIDIA Isaac Sim (met Isaac Lab) en MuJoCo:
| Platform | Ontwikkelaar | Waar het goed in is | Beste voor |
|---|---|---|---|
| NVIDIA Isaac Sim en Isaac Lab | NVIDIA | Fotorealistische rendering, sensorsimulatie, duizenden parallelle omgevingen op GPU | Grote reinforcement-learningruns en synthetische cameradata |
| MuJoCo | Google DeepMind (open source) | Snelle, nauwkeurige contactfysica, lichtgewicht, enorme onderzoeksgemeenschap | Onderzoek, locomotie- en manipulatiebenchmarks |
De nieuwste toevoeging is Newton, een open-source, GPU-versnelde fysica-engine gebouwd door NVIDIA, Google DeepMind en Disney Research en beheerd via de Linux Foundation.
Newton 1.0 werd gelanceerd op NVIDIA GTC in maart 2026. Het plugt in op Isaac Lab als physics-backend, met MuJoCo Warp als een van zijn solvers en extra solvers voor vervormbare objecten zoals kabels en textiel.
Vervormbaren zijn belangrijker dan ze klinken. Oudere simulators gingen slecht om met kabels en stof, terwijl fabrieken robots nodig hebben die met beide overweg kunnen.
De sim-to-real-kloof is de prestatiedaling die optreedt wanneer een in simulatie getrainde policy op een echte robot wordt gezet, en het is een van de grootste problemen in embodied systemen.
Bijvoorbeeld: gesimuleerde wrijving klopt nooit helemaal, gesimuleerde camera’s zijn te schoon en gesimuleerde objecten te perfect, waardoor een policy die in simulatie 95% van de tijd slaagt kan breken zodra hij echte hardware ontmoet.
Er zijn twee hoofdmanieren waarop teams deze kloof dichten:
In plaats van de simulator perfect te maken, randomiseren teams hem op veel verschillende manieren.
Tobin et al. (2017) randomiseerden texturen en verlichting zo zwaar dat de echte wereld voor het model aanvoelde als weer een variatie. OpenAI’s Rubik’s Cube-robothand ging verder door de randomisatie automatisch te verbreden naarmate de policy beter werd.
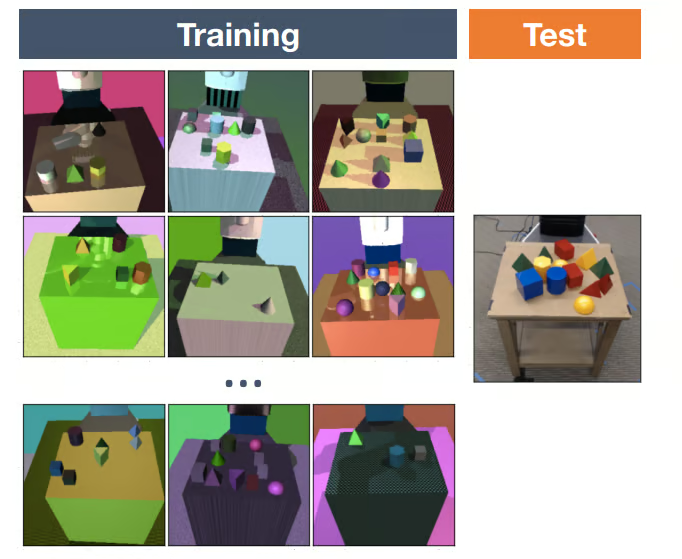
Een in simulatie voorgetrainde policy heeft vaak maar een kleine set echte demonstraties nodig om zich aan te passen, omdat hij de globale vorm van de taak al heeft geleerd.
Geen van beide technieken verwijdert de kloof volledig, dus teams blijven eraan werken om de impact op prestaties in de echte wereld te verkleinen.
Embodied AI draait nu buiten het lab in verschillende sectoren, zij het zeer ongelijkmatig.
Het patroon dat ik zie: het landt het eerst waar de omgeving te veranderlijk is om met de hand te scripten, maar waar een mens nog kan ingrijpen als het misgaat.
Zelfrijdende auto’s zijn een van de meest datahongerige vormen van embodied AI.
De Waymo Driver heeft bijna 200 miljoen volledig autonome mijlen afgelegd en traint en test ook op miljarden mijlen in simulatie, volgens Waymo’s post over zijn World Model van februari 2026. Simulatie laat Waymo echte incidenten opnieuw afspelen en zeldzame scenario’s genereren (bijvoorbeeld een kind dat tussen geparkeerde auto’s de weg op rent) die een testvloot mogelijk nooit op echte wegen tegenkomt.
Zelfrijdende auto’s zijn ook een goed voorbeeld van de waarneming-redeneren-actie-loop op volle snelheid. Een Waymo-voertuig neemt waar met camera’s, lidar en radar, redeneert over wat elke voetganger en elk voertuig waarschijnlijk hierna doet, en handelt door meerdere keren per seconde stuur en remmen aan te sturen.
Naar mijn mening zijn magazijnen nu het meest natuurlijke commerciële gebruik van embodied AI.
De verschuiving is van robots met vaste routes die lijnen op de vloer volgen naar systemen die dynamische, rommelige voorraad aankunnen, zoals picken uit een bak met 40 verschillende door elkaar gegooide producten.
De humanoïde Digit van Agility Robotics verplaatst bakken bij GXO Logistics onder een meerjarig contract uit 2024, en Boston Dynamics’ Stretch-robot lost dozen uit vrachtwagens.
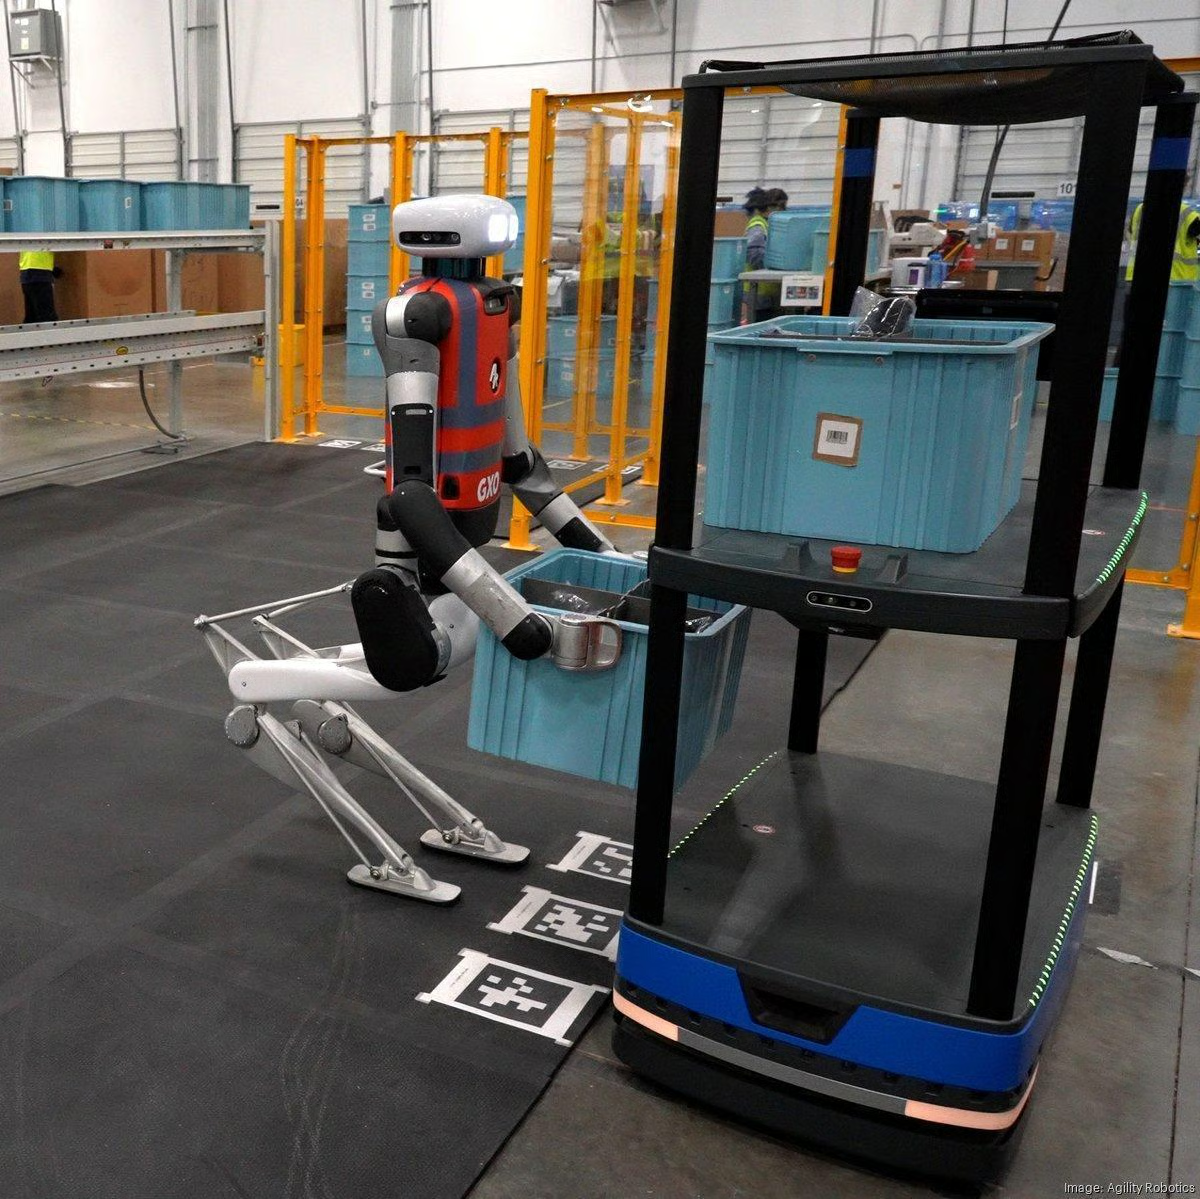
Digit van Agility Robotics verplaatst bakken tussen autonome mobiele robots en een transportband in een GXO-magazijn. Afbeelding uit bron: Agility Robotics/The Robot Report
In de zorg verwacht ik dat embodied AI het behoedzaamst zal bewegen.
Chirurgische systemen zoals de da Vinci van Intuitive worden al wereldwijd in ziekenhuizen gebruikt, maar staan onder controle van een chirurg, en het meeste AI-onderzoek hier richt zich op ondersteuning, zoals instrumenttracking, camerabediening en hulp bij hechten.
In de zorg is goedkeuring door toezichthouders vaak een grotere beperking dan modelcapaciteit, en terecht. Ik verwacht persoonlijk dat ondersteunende en trainingstoepassingen veel eerder arriveren dan iets dat in de buurt komt van autonome chirurgie.
Humanoïden krijgen de meeste aandacht en zijn tegelijk het minst bewezen.
Op CES 2026 onthulde Boston Dynamics de productieversie van Atlas en zei dat elke unit die het in 2026 bouwt al is toegezegd aan Hyundai en Google DeepMind. Figure draaide ondertussen een inzet van 11 maanden met zijn Figure 02-humanoïde in BMW’s fabriek in Spartanburg, South Carolina, voor het laden van plaatstaal.
Ik wil hier eerlijk zijn: de meeste humanoïde inzetten zijn nog pilots met een beperkte set taken. Hyundai wil bijvoorbeeld in 2028 beginnen met het inzetten van Atlas voor parts sequencing, wat aangeeft hoe voorzichtig zelfs de grootste supporters bewegen.
Laten we nu kijken wie dit allemaal bouwt. Dit zijn de vijf organisaties die iedereen die nieuw is in embodied AI zou moeten kennen:
| Organisatie | Wat ze bouwen | Waarom het ertoe doet |
|---|---|---|
| NVIDIA | Isaac Sim, Isaac Lab, Newton, GR00T en Cosmos | De simulatie- en computestack waarop de meeste teams trainen |
| Physical Intelligence | π₀-familie van robot-foundationmodellen | Algemene robotpolicies met open checkpoints |
| Agility Robotics | Digit-humanoïde | Gebouwd voor magazijnlogistiek en werkt al met klanten |
| Boston Dynamics | Atlas, Stretch en Spot | Verplaatst Atlas in 2026 van onderzoeksdemo’s naar productie-units |
| AMI Labs (Yann LeCun) | JEPA-achtige world models | Een contrair gok op world models die geen pixels genereren |
NVIDIA bouwt vooral de tools om de robot heen, niet zozeer de robot zelf.
Isaac Sim verzorgt fotorealistische simulatie, Isaac Lab regelt reinforcement learning erbovenop, en Newton kan nu de fysica leveren. Veel roboticateams trainen op NVIDIA-software, ook al verkoopt NVIDIA geen algemene robot.
Physical Intelligence bouwde π₀, een 3,3-miljard-parameter vision-language-action-model dat flow matching gebruikt om vloeiende actiesequenties te produceren voor taken zoals was vouwen.
Het is het beste voorbeeld dat ik ken van een algemeen robotmodel dat je daadwerkelijk kunt downloaden, via de openpi-repository.
Als het concept “foundationmodel” nieuw voor je is, legt onze gids Introductie tot foundationmodellen het idee goed uit.
Agility Robotics koos met Digit voor de smalle route.
Hij is vanaf dag één ontworpen rond het verplaatsen van bakken in magazijnen, en die smalle focus is een belangrijke reden dat hij eerder dan de meeste humanoïden betalende klanten bereikte.
Boston Dynamics koos met Atlas de omgekeerde route.
Het duwde jarenlang tegen de atletische grenzen van de robot (je hebt de parkourvideo’s vast gezien) voordat het er een volledig elektrisch fabrieksproduct van maakte dat Google DeepMind wil aandrijven met zijn Gemini Robotics-modellen.
AMI Labs is de Parijse startup van Yann LeCun, die in maart 2026 een seedronde van $1,03 miljard sloot bij een pre-money waardering van $3,5 miljard. De ronde werd geleid door Cathay Innovation, Greycroft, Hiro Capital, HV Capital en Bezos Expeditions, met onder meer NVIDIA en Samsung als investeerders.
LeCun betoogt al jaren dat elke pixel van de toekomst voorspellen verspilling is, dus maakt zijn Joint Embedding Predictive Architecture (JEPA) zijn voorspellingen in een abstracte representatieruimte, een idee dat Meta al testte met V-JEPA 2.
Wat AMI de moeite van het volgen waard maakt, is dat het ingaat tegen de richting van het veld. Het heeft nog niets verscheept, dus ik zou het voor nu zien als een onderzoeksinzet met veel geld erachter, niet als een bewezen aanpak.
Embodied AI is niet alleen een roboticaengineeringprobleem. Veel werk—ik zou zeggen het meeste—is machine learning-werk.
De vaardigheden die het meest rechtstreeks overdraagbaar zijn:
Je hebt geen robot nodig om te beginnen. De gymnasium-bibliotheek wordt geleverd met MuJoCo-omgevingen, dus na pip install "gymnasium[mujoco]" kun je de hele loop op een gesimuleerde robot draaien:
import gymnasium as gym

# HalfCheetah is a 2D cheetah-like robot simulated with the MuJoCo physics engine
env = gym.make("HalfCheetah-v5")
observation, info = env.reset(seed=42)

for step in range(1000):
    # Perception: the observation holds joint angles and velocities
    # Reasoning: a trained policy would choose the action here, we pick randomly
    action = env.action_space.sample()

    # Action: apply torques to the joints and move the physics forward one step
    observation, reward, terminated, truncated, info = env.step(action)

    if terminated or truncated:
        observation, info = env.reset()

env.close()
Op dit moment slaat de cheeta wild om zich heen omdat de “redeneer”-stap env.action_space.sample() is, die elke keer een willekeurige actie kiest.
Die ene regel vervangen door een getrainde policy is precies waar reinforcement learning voor is, en ik raad aan dat te proberen voordat je aan iets groters begint.
Embodied AI gaat hard, maar worstelt nog steeds op vier punten, en ik vind het de moeite waard die te kennen:
Embodied AI geeft machines een fysiek lichaam en de intelligentie om het te gebruiken. Het werkt via de waarneming-redeneren-actie-loop, wordt vooral geremd door het gebrek aan fysieke data, en beweegt in 2026 uit de onderzoekslabs richting magazijnen en de eerste fabriekspilots.
Wat mij echt verrast is hoe de vraag is verschoven. Een paar jaar geleden vroegen mensen zich af of LLM’s roboticaonderzoek overbodig zouden maken. In plaats daarvan worden LLM’s de redeneerlaag binnen embodied systemen, en groeien de twee velden naar elkaar toe.
Weet je nog de appel uit het begin? Weten hoe je hem oppakt en hem daadwerkelijk oppakken blijken twee heel verschillende problemen te zijn, en embodied AI is het vakgebied dat aan het tweede werkt.
Wil je de ML-fundamenten hiervoor leggen? Begin dan met onze Reinforcement Learning in Python-track. Voor de taalkant van de stack zijn onze cursus Large Language Models (LLM’s) Concepts en onze Developing Large Language Models-track goede volgende stappen.
Topcursussen op DataCamp
Cursus
Cursus
Leerpad
blog
Adel Nehme
15 min

