Corso
Deep Reinforcement Learning in Python
4 ore
6K
Immagina di chiedere a un amico di passarti una mela da una ciotola di frutta. Lui guarda la ciotola, capisce qual è la mela e la prende abbastanza delicatamente da non schiacciarla prima di porgertela.
Ora chiediamo a un chatbot di fare la stessa cosa. Può dirti esattamente come prendere una mela, quali dita usare e più o meno con quanta forza stringere, ma non può davvero prenderla. Non ha mani e non ha idea di che cosa si provi a toccare una mela.
Embodied AI è il campo che cerca di colmare questo divario. In parole semplici, è un'IA che ha un corpo fisico (come un robot, un'auto o un drone) e impara facendo cose nel mondo reale invece di limitarsi a leggerne. Vedrai anche il termine strettamente correlato “physical AI” usato per la stessa idea.
In questo momento, il settore sta vivendo un momento d'oro. Al CES di gennaio 2026, Jensen Huang di NVIDIA l'ha definito “il momento ChatGPT per la robotica”.
I soldi sono arrivati di conseguenza. Secondo i dati Dealroom riportati da CNBC, le aziende di robotica hanno raccolto 55,8 miliardi di dollari nel 2026 entro inizio giugno, quasi il doppio del precedente record annuale.
In questo articolo, ti parlerò di:
Non preoccuparti se non hai mai lavorato con un robot. Avere un po' di familiarità con il machine learning aiuta, ma costruirò ogni idea da zero, così potrai seguire anche senza esperienza diretta.
L'Embodied AI è un sistema di intelligenza artificiale integrato in un corpo fisico, come un robot, un veicolo autonomo o un drone, che percepisce l'ambiente tramite sensori, ragiona su cosa fare e agisce sul mondo attraverso motori, imparando dagli esiti delle proprie azioni.
La parola chiave qui è embodied.
La maggior parte dei modelli di IA imparano osservando dati raccolti da altri. Un sistema embodied impara interagendo con l'ambiente, ad esempio spingendo una tazza, osservando come scivola e aggiornando ciò che sa su come si comportano le tazze quando vengono spinte.
Ecco un esempio. Un modello di visione addestrato su milioni di foto di porte sa che aspetto ha una porta. Un robot che ha provato davvero ad aprire 500 porte sa che alcune si spingono, altre si tirano, alcune sono pesanti e alcune hanno maniglie che devi prima premere verso il basso.
Questa profondità di conoscenza non la ottieni da una foto.
Mi piace dirla così: la maggior parte dell'IA conosce il mondo leggendone; l'Embodied AI conosce il mondo toccandolo e vivendolo.
Questa sola differenza cambia i dati di cui hai bisogno, come addestri e come le cose possono andare storte.
Finora ho confrontato l'Embodied AI con un chatbot. Confrontiamola ora con le due cose con cui viene più spesso confusa: i large language model (LLM) e la robotica tradizionale basata su regole.
| Embodied AI | Large language models (LLM) | Robotica tradizionale basata su regole | |
|---|---|---|---|
| Impara dall'ambiente | Sì, tramite interazione e feedback | Perlopiù no, impara da un corpus di testo fisso | No, il comportamento è programmato a mano |
| Compie azioni fisiche | Sì | No | Sì |
| Si addestra su dati internet | In parte (i suoi backbone visione-linguaggio) | Sì, trilioni di token | No |
| Generalizza a nuovi ambienti | Moderatamente, e migliora velocemente | Bene, all'interno dei compiti linguistici | Male, si rompe quando cambia l'allestimento |
| Maturità commerciale nel 2026 | Early production (magazzini, piloti in fabbrica) | Matura e ampiamente distribuita | Matura, decenni di uso in fabbrica |
Le ultime 2 righe sono quelle che voglio evidenziare.
Le braccia industriali basate su regole saldano auto da decenni e sono estremamente affidabili, ma solo perché nulla all'interno della loro cella di lavoro cambia mai. L'Embodied AI cerca di mantenere quell'affidabilità lasciando che il mondo sia disordinato, ciò che i ricercatori chiamano generalizzazione.
LLM ed Embodied AI imparano entrambi da enormi quantità di dati, ma risolvono problemi molto diversi. Un LLM riceve testo e predice quale token debba venire dopo, mentre un sistema embodied riceve frame di telecamere, angoli delle giunture e letture tattili e predice quale movimento debba venire dopo.
In breve, gli LLM conoscono il mondo fisico, mentre l'Embodied AI agisce in esso. Tornando alla nostra mela: un LLM può descrivere esattamente come prenderla, e un robot di Embodied AI può davvero farlo.
Anche il costo di un errore è molto diverso. Se un LLM sbaglia, ottieni una frase un po' strana. Se un sistema embodied sbaglia, un bicchiere può finire per terra, o peggio.
E ora la parte che secondo me molti si perdono: i due lavorano insieme.
Nei modelli vision-language-action (VLA), un modello visione-linguaggio pre-addestrato sta al centro del sistema. Legge le immagini della camera e la tua istruzione (“metti la frutta nella ciotola”), poi passa la sua comprensione a un decoder di azioni che produce i comandi motori effettivi.
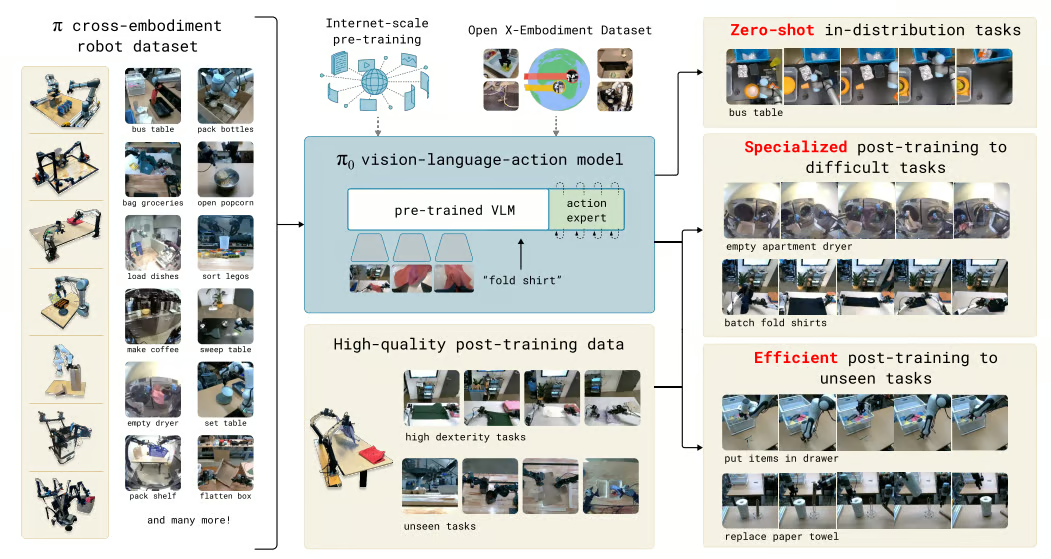
Come un modello visione-linguaggio pre-addestrato si collega alle azioni del robot in π₀ (pi-zero). Immagine dalla fonte: Black et al., 2024
La Physical AI è più difficile della Digital AI principalmente a causa dei dati.
I modelli linguistici sono avanzati rapidamente grazie a decenni di persone che hanno condiviso online testi, codice e immagini, ma non esiste una fonte comparabile di dati sensoriali del mondo reale. Ci sono molte meno serie di angoli di giunture, letture di forza e frame di telecamera di robot che interagiscono con oggetti quotidiani.
Vediamo più nel dettaglio i requisiti di dati. Un sistema embodied ha bisogno di 3 tipi di dati difficili da trovare:
Mettiamoci ora dei numeri.
Gli LLM più avanzati sono addestrati su trilioni di token. Open X-Embodiment, uno dei dataset open di robotica più grandi, ha messo insieme dati da 22 tipi di robot in 21 istituzioni e ha ottenuto poco più di 1 milione di traiettorie reali.
I robot e i compiti aggregati nel dataset Open X-Embodiment. Immagine dalla fonte: Open X-Embodiment Collaboration, 2023
Perché così poco? Ogni traiettoria richiede un robot reale che svolga un compito reale, di solito controllato da un umano tramite teleoperazione, il che è lento e costoso.
Questo divario è anche il motivo per cui la Physical AI generalizza più lentamente della Digital AI. Un modello gestisce meglio la variazione quando ha visto qualcosa di simile prima, e un milione di traiettorie copre molte meno cucine, illuminazioni e forme di oggetti rispetto a quanti frasi coprono trilioni di token.
Ti suggerisco di tenere a mente questo problema dei dati per il resto dell'articolo. Molte delle scelte progettuali che vedrai di seguito, dalla simulazione alla domain randomization fino al riuso di backbone visione-linguaggio pre-addestrati, sono modi per aggirarlo.
L'Embodied AI funziona eseguendo in continuo un ciclo di 3 fasi:
Questo ciclo si ripete molte volte al secondo e ogni movimento cambia ciò che il robot percepisce dopo, quindi l'output di un ciclo diventa l'input del successivo.
Lo stesso ciclo sta dietro ai world model. Il paper “World Models” del 2018 di Ha e Schmidhuber ha suddiviso un agente in un modulo di visione, uno di memoria e un controller, testandolo su un'auto in un gioco di corse. L'Embodied AI applica la stessa idea a un robot completo.
Un buon modo per capire il ciclo è immaginare di prendere una palla al volo:
Un robot fa la stessa cosa, solo con telecamere al posto degli occhi e motori al posto dei muscoli.
Vediamo ogni fase a turno.
La percezione è la fase che trasforma le letture grezze dei sensori in qualcosa su cui il resto del sistema può ragionare. Una singola telecamera raramente basta, quindi la maggior parte dei robot combina diversi sensori:
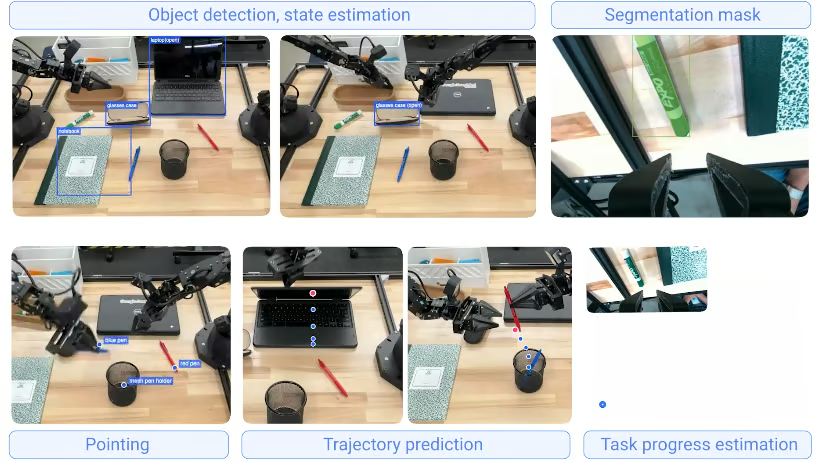
Esempi di output di percezione da Gemini Robotics-ER 1.5. Immagine dalla fonte: Google DeepMind
I modelli di percezione trasformano poi queste letture in mappe spaziali, identità degli oggetti, posizioni degli ostacoli e una comprensione generale della scena.
Gran parte di questo è computer vision standard, come object detection, segmentazione e stima della profondità, di solito costruite su vision transformer pre-addestrati come DINOv2 o SigLIP.
Secondo me, però, il tatto è la parte più sottovalutata della percezione in questo momento. Una telecamera può dirti che c'è un bicchiere sul tavolo, ma il tatto è ciò che ti dice che il bicchiere sta iniziando a scivolare dalla presa.
Per darti un'idea del livello attuale, XELA Robotics ha mostrato al salone Automate 2026 un polpastrello robotico con 30 punti di rilevazione della forza su tre assi concentrati nel cuscinetto. L'azienda afferma inoltre che i sensori uSkin possono rilevare forze piccole fino a 0,1 grammi-forza.
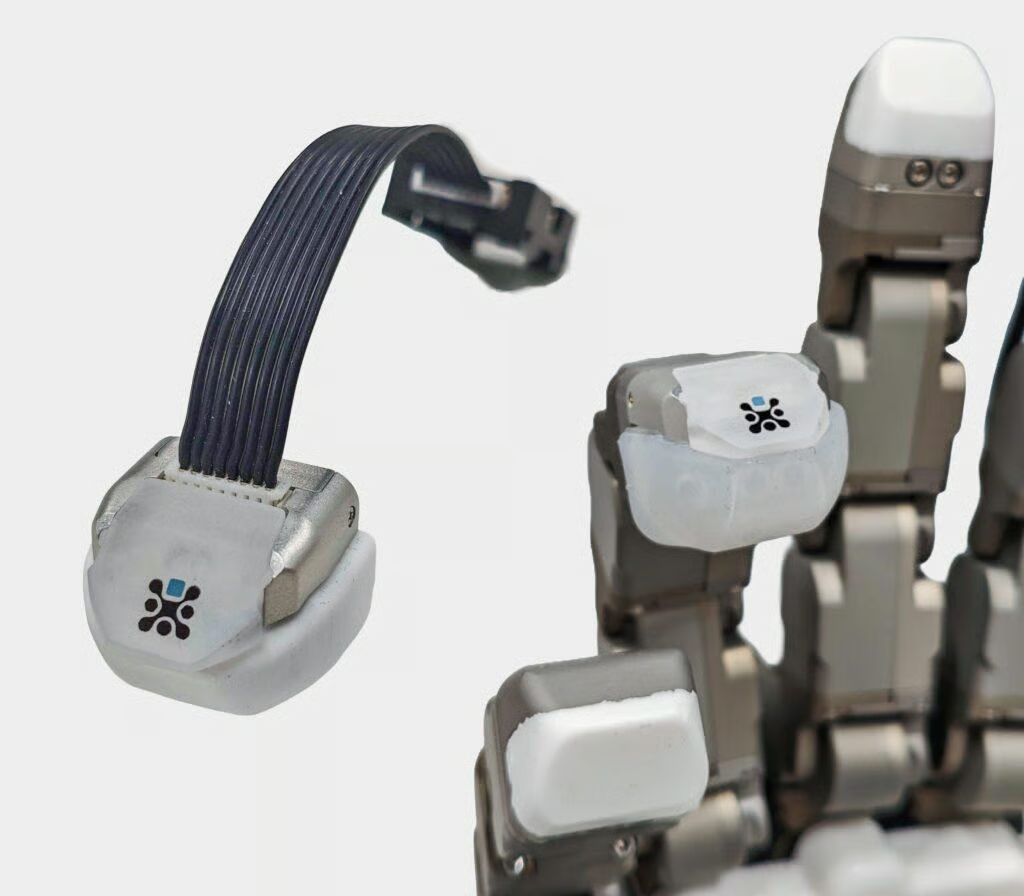
Un polpastrello robotico uSkin contenente una matrice di punti di rilevazione tattile su tre assi. Immagine dalla fonte: XELA Robotics
Il ragionamento è la fase che decide cosa fare dopo. Nei sistemi più recenti, di solito ha 2 livelli:
I world model sono ciò che permette a un robot di immaginare prima di agire.
DreamerV3 è un buon esempio. Impara un modello compatto del suo ambiente e poi addestra la sua policy quasi interamente dentro quel mondo immaginato.
Uso DreamerV3 nelle mie ricerche e ciò che mi ha sorpreso di più è quanto più tempo l'agente trascorra ad allenarsi nella sua “testa” rispetto all'ambiente reale. Conta perché l'addestramento diventa più veloce e molto più economico.
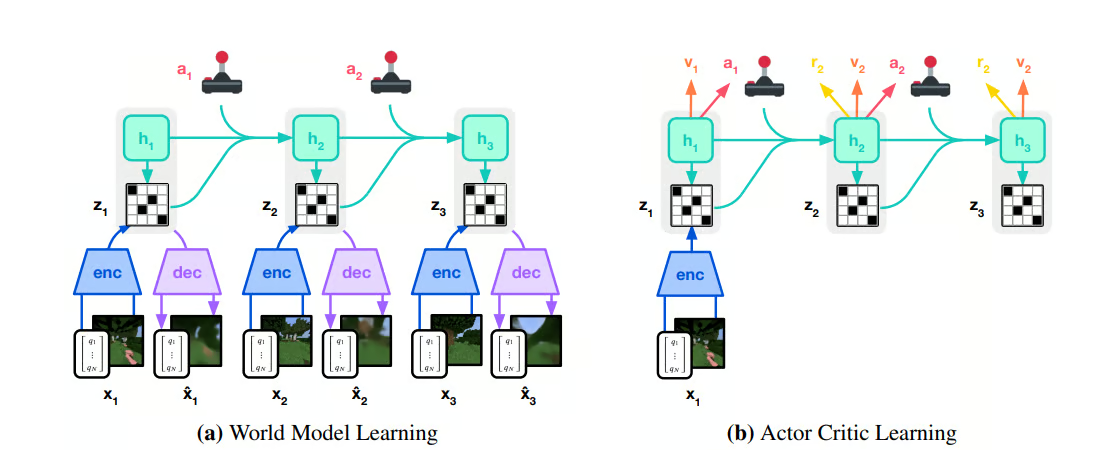
DreamerV3 addestra la sua policy su rollout immaginati dal suo world model. Immagine dalla fonte: Hafner et al., 2023
Il planning, invece, è sempre più gestito da modelli linguistici.
Un buon esempio è Gemini Robotics-ER 1.5 di Google DeepMind, che funge da pianificatore di alto livello. Dato un compito come smistare i rifiuti secondo le regole locali di riciclo, può cercare le regole con Google Search, suddividere il lavoro in passi e passare ciascun passo al modello VLA Gemini Robotics 1.5 che svolge il lavoro fisico.
Puoi pensare al modello linguistico come al manager e al modello VLA come all'operaio che fa davvero il lavoro.
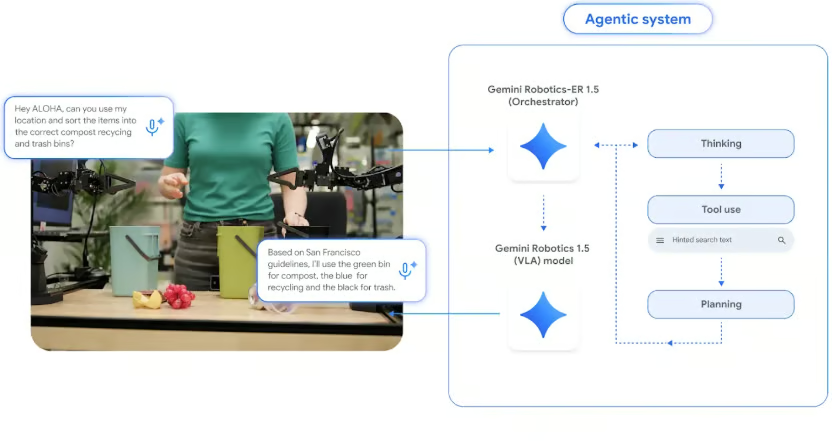
Gemini Robotics-ER 1.5 pianifica il compito e delega l'esecuzione fisica a Gemini Robotics 1.5 VLA. Immagine dalla fonte: Google DeepMind, 2025
L'azione è la fase che converte una decisione in comandi precisi per ogni giunto e motore, di solito decine o centinaia di volte al secondo (misurate in hertz, o Hz). La parte di basso livello di questa fase si chiama controllo.
Per esempio, un comando come “Sposta il gripper 5 cm a sinistra” sembra semplice, ma su un braccio a 7 giunti deve diventare una coppia specifica per ciascun motore di giunto, ricalcolata continuamente mentre il braccio si muove.
La parte difficile è che la realtà raramente corrisponde a ciò che il robot si aspettava. Gli oggetti scivolano, i pavimenti sono leggermente irregolari, l'illuminazione cambia quando qualcuno apre una tenda e un cavo si piega in modo diverso dal previsto.
Un buon controller nota la differenza tra ciò che si aspettava e ciò che è successo davvero, poi corregge subito.
Penso che l'azione sia la fase più difficile da fare bene in ambienti disordinati e non strutturati. Un errore di percezione può essere corretto guardando di nuovo e un errore di planning può essere corretto ripianificando, ma un errore di controllo accade in tempo reale.
L'Embodied AI si addestra su un mix di simulazione e dati del mondo reale. Simulazione significa ambienti virtuali pieni di oggetti 3D con fisica accurata, dove un robot può esercitarsi milioni di volte prima di toccare l'hardware reale.
Ricordi il problema dei dati di prima? La simulazione è uno dei principali modi per aggirarlo, soprattutto per il reinforcement learning di locomozione e manipolazione. I foundation model come π₀ poggiano ancora molto su dimostrazioni reali, quindi la maggior parte dei team usa entrambi.
Raccogliere dati nel mondo reale ha 3 grandi problemi:
Un simulatore affronta tutti e 3 insieme. Puoi eseguire migliaia di robot virtuali in parallelo su una singola GPU e lasciarli fallire e ripartire quante volte serve. Questo condensa anni di esperienza del robot in poche ore.
Non tutti i simulatori sono ugualmente utili per addestrare robot. Per esperienza con bracci robotici in simulazione, direi che uno buono ha bisogno di 3 cose:
Le 2 piattaforme che incontrerai più spesso sono NVIDIA Isaac Sim (con Isaac Lab) e MuJoCo:
| Piattaforma | Sviluppatore | Punti di forza | Ideale per |
|---|---|---|---|
| NVIDIA Isaac Sim e Isaac Lab | NVIDIA | Rendering fotorealistico, simulazione sensori, migliaia di ambienti paralleli su GPU | Grandi run di reinforcement learning e dati sintetici da camera |
| MuJoCo | Google DeepMind (open source) | Fisica di contatto veloce e accurata, leggero, enorme community di ricerca | Ricerca, benchmark di locomozione e manipolazione |
L'aggiunta più recente è Newton, un motore fisico open-source accelerato da GPU creato da NVIDIA, Google DeepMind e Disney Research e gestito dalla Linux Foundation.
Newton 1.0 è stato rilasciato alla NVIDIA GTC a marzo 2026. Si collega a Isaac Lab come backend fisico, con MuJoCo Warp come uno dei suoi solver e solver aggiuntivi per oggetti deformabili come cavi e tessuti.
I deformabili contano più di quanto sembri. I vecchi simulatori gestivano male cavi e tessuti, e le fabbriche hanno bisogno di robot che sappiano trattare entrambi.
Il sim-to-real gap è il calo di prestazioni che si verifica quando una policy addestrata in simulazione viene trasferita su un robot reale, ed è uno dei problemi più grandi nei sistemi embodied.
Per esempio, l'attrito simulato non è mai del tutto corretto, le telecamere simulate sono troppo pulite e gli oggetti simulati possono essere troppo perfetti, quindi una policy che ha successo il 95% delle volte in simulazione può rompersi appena incontra l'hardware reale.
Ci sono 2 modi principali con cui i team riducono questo divario:
Invece di cercare di rendere il simulatore perfetto, i team lo randomizzano in molti modi diversi.
Tobin et al. (2017) hanno randomizzato texture e illuminazione così pesantemente che il mondo reale sembrava solo un'altra variazione per il modello. La mano robotica del cubo di Rubik di OpenAI è andata oltre ampliando automaticamente la randomizzazione man mano che la policy migliorava.
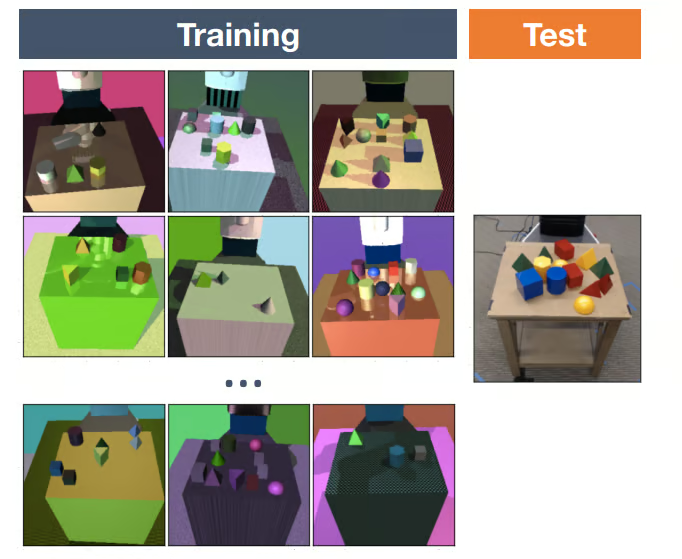
Una policy pre-addestrata in simulazione spesso ha bisogno solo di un piccolo set di dimostrazioni reali per adattarsi, perché ha già imparato la forma generale del compito.
Nessuna delle due tecniche elimina del tutto il divario, quindi i team continuano a lavorare per ridurne l'impatto sulle prestazioni nel mondo reale.
L'Embodied AI ora opera fuori dal laboratorio in diversi settori, sebbene in modo molto disomogeneo.
Il pattern che vedo è che arriva prima dove l'ambiente cambia troppo per essere scriptato a mano, ma dove un umano può comunque intervenire se qualcosa va storto.
Le auto a guida autonoma sono uno dei tipi di Embodied AI più affamati di dati.
Waymo Driver ha percorso quasi 200 milioni di miglia in piena autonomia, e si addestra e testa anche su miliardi di miglia in simulazione, secondo il post di Waymo di febbraio 2026 sul suo World Model. La simulazione permette a Waymo di rigiocare incidenti reali e generare scenari rari (per esempio, un bambino che corre fuori tra auto parcheggiate) che una flotta di test potrebbe non incontrare mai su strade reali.
Le auto a guida autonoma sono anche un buon esempio del ciclo percezione-ragionamento-azione che gira a piena velocità. Un veicolo Waymo percepisce con telecamere, lidar e radar, ragiona su cosa è probabile che faccia ogni pedone e veicolo dopo, e agisce controllando sterzo e freni molte volte al secondo.
A mio avviso, i magazzini sono l'uso commerciale più naturale dell'Embodied AI in questo momento.
Il passaggio è da robot a percorso fisso che seguono linee sul pavimento a sistemi che possono gestire inventari dinamici e disordinati, come il picking da un tote con 40 prodotti diversi mescolati insieme.
L'umanoide Digit di Agility Robotics sposta i tote da GXO Logistics in base a un accordo pluriennale firmato nel 2024, e Stretch di Boston Dynamics scarica scatole dai camion.
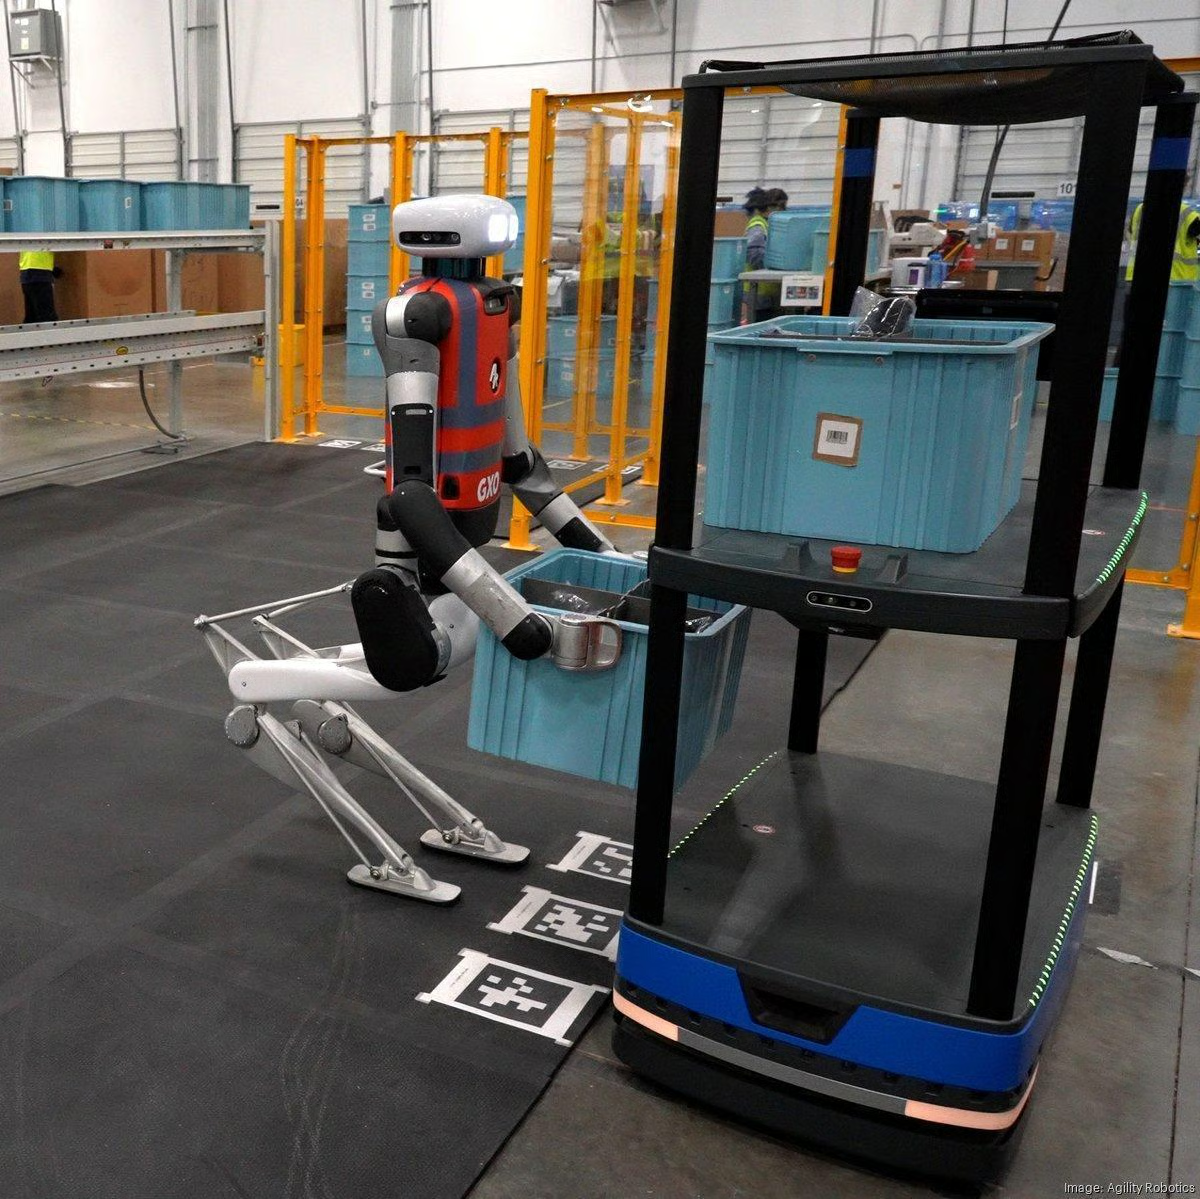
Digit di Agility Robotics sposta i tote tra robot mobili autonomi e un nastro trasportatore in un magazzino GXO. Immagine dalla fonte: Agility Robotics/The Robot Report
La sanità è dove mi aspetto che l'Embodied AI si muova con più cautela.
I sistemi chirurgici come il da Vinci di Intuitive sono già utilizzati negli ospedali di tutto il mondo, ma sono controllati da un chirurgo, e la maggior parte della ricerca IA qui si concentra sull'assistenza, come il tracciamento degli strumenti, il controllo della camera e il supporto alla sutura.
In sanità, l'approvazione normativa è spesso un vincolo più grande della capacità del modello, e a ragione. Personalmente mi aspetterei che gli usi assistivi e per la formazione arrivino molto prima di qualcosa di vicino a un intervento autonomo.
Gli umanoidi ricevono più attenzione e sono tra i meno provati.
Al CES 2026, Boston Dynamics ha presentato la versione di produzione di Atlas e ha detto che ogni unità costruita nel 2026 è già destinata a Hyundai e Google DeepMind. Figure, nel frattempo, ha condotto un deployment di 11 mesi del suo umanoide Figure 02 nello stabilimento BMW di Spartanburg, South Carolina, per caricare lamiere.
Voglio però essere onesto: la maggior parte dei deployment di umanoidi sono ancora piloti che svolgono un set ristretto di compiti. Hyundai, ad esempio, prevede di iniziare a usare Atlas per il sequenziamento di parti nel 2028, segno di quanto cautamente si muovano anche i sostenitori più grandi.
Parliamo ora di chi sta costruendo tutto questo. Ecco le 5 organizzazioni che, secondo me, chi è nuovo all'Embodied AI dovrebbe riconoscere:
| Organizzazione | Cosa costruiscono | Perché conta |
|---|---|---|
| NVIDIA | Isaac Sim, Isaac Lab, Newton, GR00T e Cosmos | Lo stack di simulazione e compute su cui si addestra la maggior parte dei team |
| Physical Intelligence | Famiglia di foundation model per robot π₀ | Policy per robot generali con checkpoint aperti |
| Agility Robotics | Umanoide Digit | Progettato per la logistica di magazzino e già operativo con clienti |
| Boston Dynamics | Atlas, Stretch e Spot | Passaggio di Atlas da demo di ricerca a unità di produzione nel 2026 |
| AMI Labs (Yann LeCun) | World model in stile JEPA | Scommessa controcorrente su world model che non generano pixel |
NVIDIA costruisce per lo più gli strumenti attorno al robot, non il robot in sé.
Isaac Sim gestisce la simulazione fotorealistica, Isaac Lab gestisce il reinforcement learning sopra di essa e Newton ora può fornire la fisica. Molti team di robotica si addestrano su software NVIDIA anche se NVIDIA non vende un robot generico.
Physical Intelligence ha costruito π₀, un modello visione-linguaggio-azione da 3,3 miliardi di parametri che usa il flow matching per produrre blocchi di azioni fluide per compiti come piegare il bucato.
È il miglior esempio che conosca di un modello per robot generalista che puoi davvero scaricare, tramite il repository openpi.
Se il concetto di “foundation model” è nuovo per te, la nostra guida Introduzione ai Foundation Model spiega bene l'idea.
Agility Robotics ha scelto la via ristretta con Digit.
È stato progettato fin dal primo giorno per spostare tote nei magazzini, e questo focus ristretto è un grande motivo per cui ha raggiunto clienti paganti prima di molti umanoidi.
Boston Dynamics ha scelto la via opposta con Atlas.
Ha passato anni a spingere i limiti atletici del robot (probabilmente hai visto i video di parkour) prima di trasformarlo in un prodotto interamente elettrico per la fabbrica che Google DeepMind prevede di alimentare con i suoi modelli Gemini Robotics.
AMI Labs è la startup parigina di Yann LeCun, che ha chiuso un round seed da 1,03 miliardi di dollari a marzo 2026 con una valutazione pre-money di 3,5 miliardi. Il round è stato co-guidato da Cathay Innovation, Greycroft, Hiro Capital, HV Capital e Bezos Expeditions, con NVIDIA e Samsung tra gli altri investitori.
LeCun sostiene da anni che predire ogni pixel del futuro sia uno spreco, quindi la sua Joint Embedding Predictive Architecture (JEPA) fa le sue previsioni in uno spazio di rappresentazione astratto, un'idea che Meta ha già testato con V-JEPA 2.
Ciò che rende AMI interessante è che va controcorrente rispetto alla direzione del campo. Non ha ancora rilasciato nulla, quindi per ora la tratterei come una scommessa di ricerca con molti fondi alle spalle, più che un approccio provato.
L'Embodied AI non è solo un problema di ingegneria robotica. Gran parte del lavoro, e direi la maggior parte, è lavoro di machine learning.
Le competenze che si trasferiscono più direttamente sono:
Non ti serve un robot per iniziare. La libreria gymnasium include ambienti MuJoCo, quindi dopo aver eseguito pip install "gymnasium[mujoco]" puoi far girare l'intero ciclo su un robot simulato:
import gymnasium as gym

# HalfCheetah is a 2D cheetah-like robot simulated with the MuJoCo physics engine
env = gym.make("HalfCheetah-v5")
observation, info = env.reset(seed=42)

for step in range(1000):
    # Perception: the observation holds joint angles and velocities
    # Reasoning: a trained policy would choose the action here, we pick randomly
    action = env.action_space.sample()

    # Action: apply torques to the joints and move the physics forward one step
    observation, reward, terminated, truncated, info = env.step(action)

    if terminated or truncated:
        observation, info = env.reset()

env.close()
Al momento, il ghepardo si dimena perché lo step di “ragionamento” è env.action_space.sample(), che sceglie un'azione casuale ogni volta.
Sostituire quella riga con una policy addestrata è esattamente ciò per cui esiste il reinforcement learning, e ti consiglierei di provarlo prima di passare a qualcosa di più grande.
L'Embodied AI si muove velocemente, ma ha ancora difficoltà in 4 punti, ed è utile conoscerli:
L'Embodied AI dà alle macchine un corpo fisico e l'intelligenza per usarlo. Funziona tramite il ciclo percezione-ragionamento-azione, è frenata soprattutto dalla scarsità di dati fisici e nel 2026 si sta spostando dai laboratori di ricerca ai magazzini e ai primi piloti in fabbrica.
Quello che mi sorprende davvero è come sia cambiata la domanda. Qualche anno fa, ci si chiedeva se gli LLM avrebbero reso irrilevante la ricerca in robotica. Invece, gli LLM stanno diventando lo strato di ragionamento all'interno dei sistemi embodied, e i due campi si stanno fondendo.
Ricordi la mela dall'inizio dell'articolo? Sapere come prenderla e prenderla davvero si sono rivelati due problemi molto diversi, e l'Embodied AI è il campo che lavora sul secondo.
Se vuoi costruire le basi di ML per questo, inizia con il nostro track Reinforcement Learning in Python. Per la parte linguistica dello stack, il nostro corso Large Language Models (LLM) Concepts e il nostro track Developing Large Language Models sono buoni prossimi passi.
I migliori corsi DataCamp
Corso
Corso
Programma
blog
Abid Ali Awan
15 min
blog
Abid Ali Awan
10 min
blog
Tim Lu
12 min