Curso
Aprendizaje profundo por refuerzo en Python
4 h
6K
Imagina que le pides a un amigo que te pase una manzana de un frutero. La mira, identifica cuál es la manzana y la coge con cuidado para no aplastarla antes de dártela.
Ahora pidámosle lo mismo a un chatbot. Puede explicarte con detalle cómo coger una manzana, qué dedos usar y con cuánta fuerza apretar, pero no puede cogerla. No tiene manos ni sabe cómo se siente una manzana al tacto.
La IA encarnada es el campo que intenta cerrar esta brecha. En pocas palabras, es una IA que tiene un cuerpo físico (como un robot, un coche o un dron) y aprende haciendo cosas en el mundo real, no solo leyendo sobre ellas. También verás el término relacionado “IA física” para referirse a la misma idea.
Ahora mismo, el campo vive un momento clave. En el CES de enero de 2026, Jensen Huang, de NVIDIA, la calificó como “el momento ChatGPT para la robótica”.
Y el dinero ha seguido. Según datos de Dealroom citados por CNBC, las empresas de robótica habían recaudado 55.800 millones de dólares en 2026 hasta principios de junio, casi el doble del récord anual anterior.
En este artículo, voy a tratar:
No te preocupes si nunca has trabajado con un robot. Te ayudará estar familiarizado con el aprendizaje automático, pero iré construyendo cada idea desde cero para que puedas seguirlo sin problema.
La IA encarnada es un sistema de inteligencia artificial integrado en un cuerpo físico, como un robot, un vehículo autónomo o un dron, que percibe su entorno mediante sensores, razona qué hacer y actúa sobre el mundo a través de motores, aprendiendo de los resultados de sus propias acciones.
La palabra clave aquí es encarnada.
La mayoría de modelos de IA aprenden observando datos que otra persona ha recopilado. Un sistema encarnado aprende interactuando con su entorno, por ejemplo, empujando una taza, viendo cómo se desliza y actualizando lo que sabe sobre cómo se comportan las tazas al empujarlas.
Un ejemplo: un modelo de visión entrenado con millones de fotos de puertas sabe cómo es una puerta. Un robot que ha intentado abrir 500 puertas sabe que algunas se empujan, otras se tiran, algunas pesan, y otras tienen manillas que hay que presionar primero.
Esa profundidad de conocimiento no se obtiene de una foto.
Me gusta decirlo así: la mayoría de la IA aprende sobre el mundo leyendo; la IA encarnada aprende sobre el mundo tocándolo y experimentándolo.
Esta diferencia cambia los datos que necesitas, cómo entrenas y cómo pueden fallar las cosas.
Hasta ahora he comparado la IA encarnada con un chatbot. Comparemos ahora con las dos cosas con las que más suele confundirse: los modelos de lenguaje grandes (LLM) y la robótica tradicional basada en reglas.
| IA encarnada | Modelos de lenguaje grandes (LLM) | Robótica tradicional basada en reglas | |
|---|---|---|---|
| Aprende del entorno | Sí, mediante interacción y feedback | En su mayoría no, aprende de un corpus de texto fijo | No, el comportamiento se programa a mano |
| Realiza acciones físicas | Sí | No | Sí |
| Se entrena con datos de internet | En parte (sus backbones de visión y lenguaje) | Sí, billones de tokens | No |
| Generaliza a nuevos entornos | Moderadamente, y mejorando rápido | Bien, dentro de tareas lingüísticas | Mal, se rompe cuando cambia el montaje |
| Madurez comercial en 2026 | Producción inicial (almacenes, pilotos en fábricas) | Madura y ampliamente desplegada | Madura, décadas en fábricas |
Quiero destacar las dos últimas filas.
Los brazos industriales basados en reglas llevan soldando coches décadas y son extremadamente fiables, pero solo porque nada cambia dentro de su celda de trabajo. La IA encarnada intenta mantener esa fiabilidad permitiendo que el mundo sea caótico, lo que los investigadores llaman generalización.
Los LLM y la IA encarnada aprenden de grandes cantidades de datos, pero resuelven problemas muy distintos. Un LLM recibe texto y predice qué token debe venir después, mientras que un sistema encarnado recibe fotogramas de cámara, ángulos articulares y lecturas táctiles, y predice qué movimiento debe venir después.
En resumen, los LLM saben sobre el mundo físico, mientras que la IA encarnada actúa en él. Volviendo a nuestra manzana: un LLM puede describir con precisión cómo cogerla, y un robot con IA encarnada puede hacerlo de verdad.
El coste del error también es muy distinto. Si un LLM se equivoca, obtienes una frase un poco rara. Si un sistema encarnado falla, un vaso puede acabar en el suelo, o algo peor.
Y aquí viene algo que muchos pasan por alto: ambos trabajan juntos.
En los modelos visión-lenguaje-acción (VLA), un modelo de visión-lenguaje preentrenado está en el núcleo del sistema. Lee las imágenes de la cámara y tu instrucción (“pon la fruta en el cuenco”), y después pasa su comprensión a un decodificador de acciones que produce los comandos de motor.
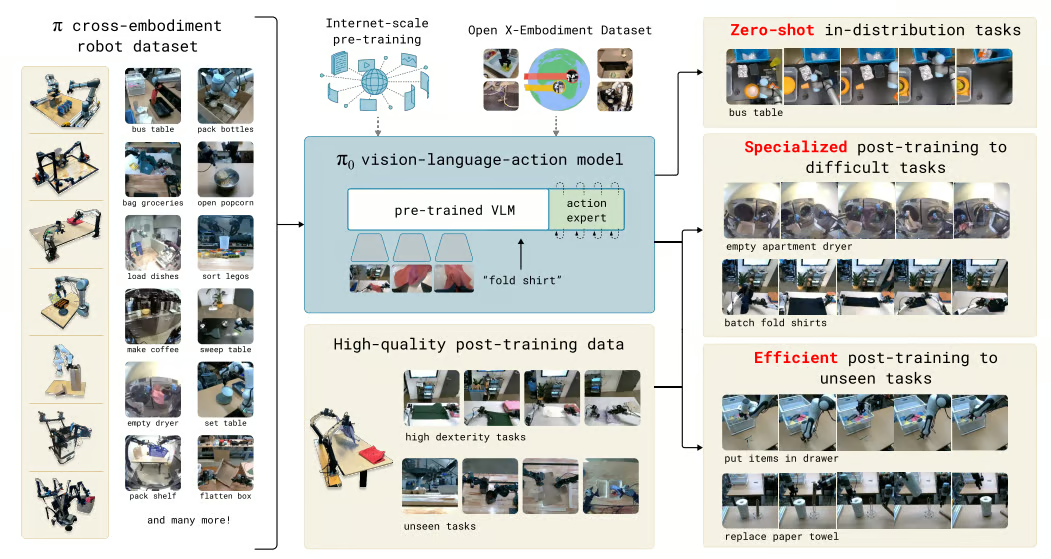
Cómo un modelo de visión-lenguaje preentrenado se conecta a acciones de robot en π₀ (pi-zero). Imagen de la fuente: Black et al., 2024
La IA física es más difícil que la digital principalmente por los datos.
Los modelos de lenguaje avanzaron rápido gracias a décadas de personas compartiendo texto, código e imágenes en internet, pero no existe una fuente comparable de datos sensoriales del mundo real. Hay muchas menos secuencias de ángulos articulares, fuerzas y fotogramas de cámara de robots interactuando con objetos cotidianos.
Veamos con más detalle las necesidades de datos. Un sistema encarnado necesita 3 tipos de datos difíciles de conseguir:
Ahora, pongamos números.
Los LLM punteros se entrenan con billones de tokens. Open X-Embodiment, uno de los mayores datasets abiertos de robótica, recopiló datos de 22 tipos de robots en 21 instituciones y logró poco más de 1 millón de trayectorias reales.
Robots y tareas combinados en el conjunto de datos Open X-Embodiment. Imagen de la fuente: Open X-Embodiment Collaboration, 2023
¿Por qué tan poco? Cada trayectoria requiere un robot real haciendo una tarea real, normalmente controlado por un humano por teleoperación, lo que es lento y caro.
Esta escasez también explica por qué la IA física generaliza más despacio que la digital. Un modelo maneja mejor la variación cuando ya ha visto algo parecido, y un millón de trayectorias cubren muchas menos cocinas, iluminaciones y formas de objetos que los billones de tokens cubren frases.
Quédate con este problema de datos para el resto del artículo. Muchas decisiones de diseño que verás más abajo, desde la simulación a la aleatorización de dominios o reutilizar backbones de visión-lenguaje preentrenados, son formas de rodearlo.
La IA encarnada funciona ejecutando de forma continua un bucle de 3 etapas:
Este bucle se repite muchas veces por segundo, y cada movimiento cambia lo que el robot percibe a continuación, de modo que la salida de un ciclo se convierte en la entrada del siguiente.
El mismo bucle está detrás de los modelos de mundo. El artículo “World Models” de 2018 de Ha y Schmidhuber dividió un agente en un módulo de visión, uno de memoria y un controlador, y lo probó con un coche en un juego de carreras. La IA encarnada aplica la misma idea a un robot completo.
Una buena forma de entender el bucle es imaginar que vas a atrapar una pelota:
Un robot hace lo mismo, solo que con cámaras en lugar de ojos y motores en lugar de músculos.
Veamos cada etapa por separado.
La percepción transforma lecturas crudas de sensores en algo con lo que el resto del sistema puede razonar. Una sola cámara rara vez basta, así que la mayoría de robots combinan varios sensores:
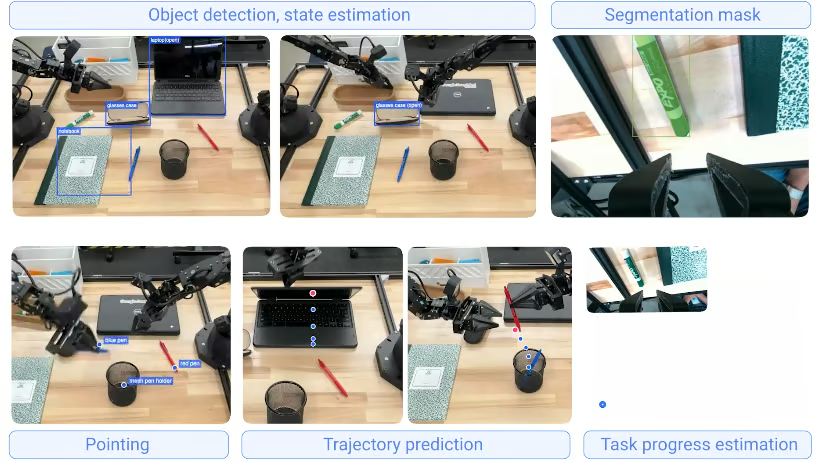
Ejemplos de salidas de percepción de Gemini Robotics-ER 1.5. Imagen de la fuente: Google DeepMind
Los modelos de percepción convierten estas lecturas en mapas espaciales, identidades de objetos, posiciones de obstáculos y una comprensión general de la escena.
La mayor parte es visión por computador estándar, como detección de objetos, segmentación y estimación de profundidad, normalmente sobre transformers de visión preentrenados como DINOv2 o SigLIP.
En mi opinión, el tacto es la parte más infravalorada de la percepción ahora mismo. Una cámara te dice que hay un vaso en la mesa, pero el tacto te dice que el vaso empieza a resbalar de tu agarre.
Para que te hagas una idea, XELA Robotics mostró en Automate 2026 una yema robótica con 30 puntos de detección de fuerza de tres ejes integrados en la almohadilla. La empresa también afirma que sus sensores uSkin pueden detectar fuerzas tan pequeñas como 0,1 gramos-fuerza.
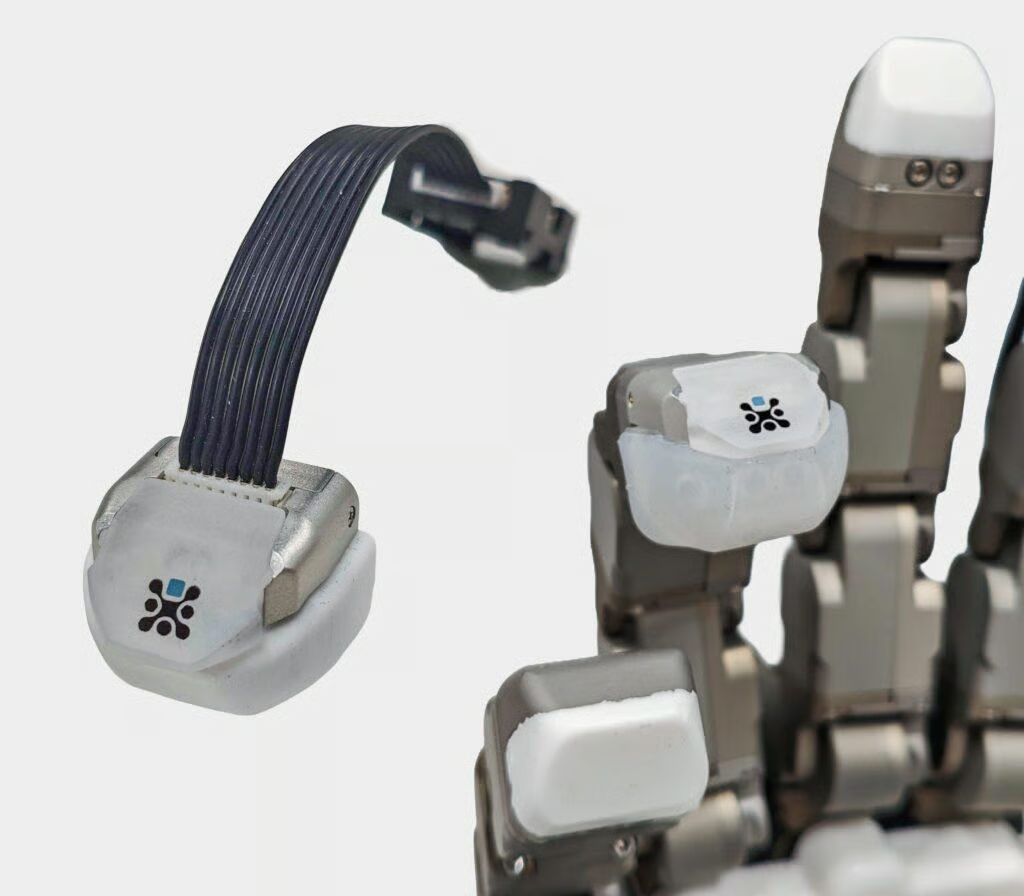
Una yema robótica uSkin con una matriz de puntos de detección táctil de tres ejes. Imagen de la fuente: XELA Robotics
El razonamiento decide qué hacer a continuación. En los sistemas más nuevos, suele tener dos capas:
Los modelos de mundo permiten al robot imaginar antes de actuar.
DreamerV3 es un buen ejemplo. Aprende un modelo compacto de su entorno y luego entrena su política casi por completo dentro de ese mundo imaginado.
Lo uso en mi investigación y me sorprende cuánto más tiempo pasa el agente practicando en su “cabeza” que en el entorno real. Eso importa porque el entrenamiento es más rápido y mucho más barato.
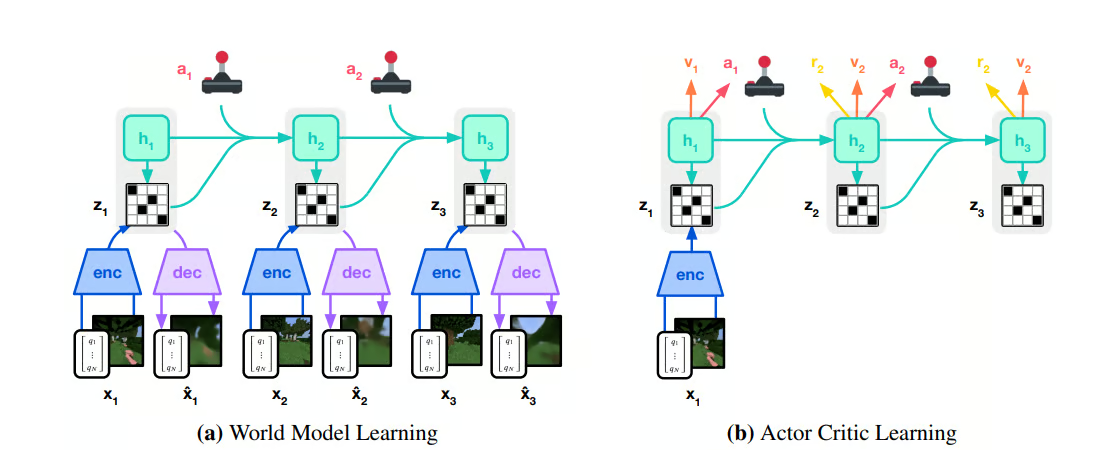
DreamerV3 entrena su política con simulaciones imaginadas desde su modelo de mundo. Imagen de la fuente: Hafner et al., 2023
La planificación, por su parte, cada vez más la gestionan los modelos de lenguaje.
Un buen ejemplo es Gemini Robotics-ER 1.5 de Google DeepMind, que actúa como planificador de alto nivel. Ante una tarea como clasificar residuos según normas locales de reciclaje, puede consultar las reglas con Google Search, descomponer el trabajo en pasos y delegar cada paso al modelo VLA Gemini Robotics 1.5 que ejecuta el trabajo físico.
Piensa en el modelo de lenguaje como el gestor y en el modelo VLA como quien hace el trabajo.
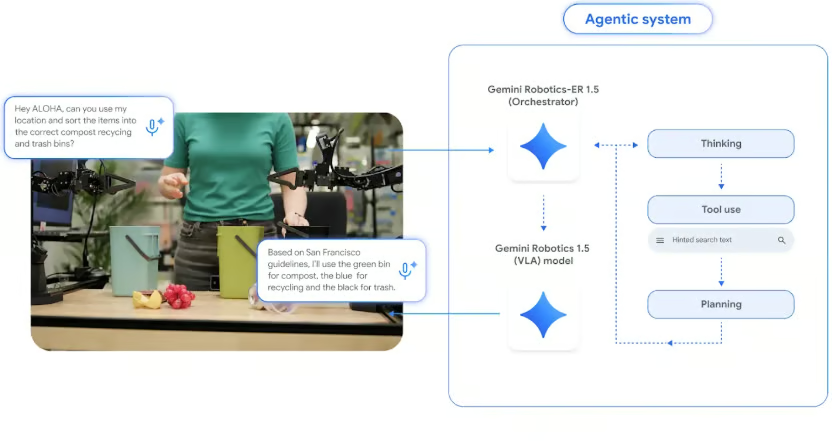
Gemini Robotics-ER 1.5 planifica la tarea y delega la ejecución física en Gemini Robotics 1.5 VLA. Imagen de la fuente: Google DeepMind, 2025
La acción convierte una decisión en órdenes precisas para cada articulación y motor, normalmente decenas o cientos de veces por segundo (medido en hercios, Hz). La parte de bajo nivel se llama control.
Por ejemplo, una orden como “Mueve el gripper 5 cm a la izquierda” suena simple, pero en un brazo de 7 articulaciones tiene que traducirse en un par concreto para cada motor, recalculado continuamente a medida que el brazo se mueve.
Lo difícil es que la realidad rara vez coincide con lo esperado. Los objetos resbalan, el suelo no es perfectamente plano, la luz cambia cuando alguien abre una persiana y un cable se dobla de forma distinta a la prevista.
Un buen controlador detecta la diferencia entre lo esperado y lo ocurrido y corrige de inmediato.
Creo que la acción es la etapa más difícil de clavar en entornos desordenados y no estructurados. Un error de percepción puede arreglarse mirando otra vez y uno de planificación, replanificando; un fallo de control ocurre en tiempo real.
La IA encarnada se entrena con una mezcla de simulación y datos del mundo real. La simulación son entornos virtuales con objetos 3D y física realista, donde un robot puede practicar millones de veces antes de tocar hardware real.
¿Recuerdas el problema de los datos? La simulación es uno de los principales atajos, especialmente para aprendizaje por refuerzo de locomoción y manipulación. Los modelos fundacionales como π₀ aún dependen mucho de demostraciones reales, así que la mayoría de equipos combinan ambos.
Recopilar datos en el mundo real tiene 3 grandes problemas:
Un simulador resuelve los 3 a la vez. Puedes ejecutar miles de robots virtuales en paralelo en una sola GPU y dejarles fallar y reiniciarse tantas veces como haga falta. Esto condensa años de experiencia en unas horas.
No todos los simuladores son igual de útiles para entrenar robots. Por mi experiencia con brazos robóticos en simulación, diría que uno bueno necesita 3 cosas:
Las dos plataformas más habituales son NVIDIA Isaac Sim (con Isaac Lab) y MuJoCo:
| Plataforma | Desarrollador | Puntos fuertes | Ideal para |
|---|---|---|---|
| NVIDIA Isaac Sim e Isaac Lab | NVIDIA | Render fotorrealista, simulación de sensores, miles de entornos en paralelo en GPU | Grandes runs de RL y datos sintéticos de cámara |
| MuJoCo | Google DeepMind (código abierto) | Física de contacto rápida y precisa, ligero, gran comunidad investigadora | Investigación, benchmarks de locomoción y manipulación |
La novedad es Newton, un motor de física de código abierto y acelerado por GPU, creado por NVIDIA, Google DeepMind y Disney Research y gestionado por la Linux Foundation.
Newton 1.0 se lanzó en NVIDIA GTC en marzo de 2026. Se integra en Isaac Lab como backend de física, con MuJoCo Warp como uno de sus solucionadores y solucionadores adicionales para deformables como cables y telas.
Los deformables importan más de lo que parece. Los simuladores antiguos llevaban mal cables y tejidos, y las fábricas necesitan robots capaces con ambos.
La brecha sim-to-real es la caída de rendimiento cuando una política entrenada en simulación se pasa a un robot real, y es uno de los mayores problemas en sistemas encarnados.
Por ejemplo, la fricción simulada nunca es exacta, las cámaras simuladas están demasiado limpias y los objetos simulados pueden ser demasiado perfectos, así que una política que acierta el 95% de las veces en simulación puede fallar en cuanto toca el hardware real.
Hay dos formas principales de cerrar esta brecha:
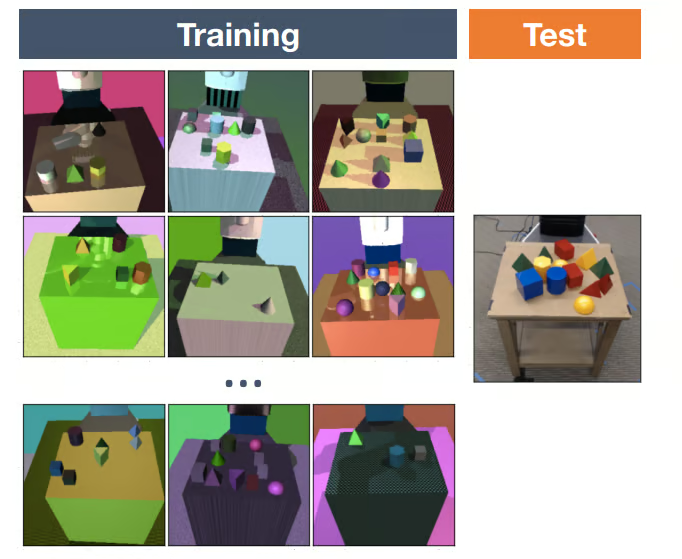
En lugar de intentar que el simulador sea perfecto, los equipos lo aleatorizan de muchas maneras.
Tobin et al. (2017) aleatorizaron texturas e iluminación tan fuerte que el mundo real parecía solo otra variación para el modelo. La mano robótica de Rubik de OpenAI fue más allá ampliando automáticamente la aleatorización a medida que mejoraba la política.
Una política preentrenada en simulación suele necesitar solo un pequeño conjunto de demostraciones reales para adaptarse, porque ya ha aprendido la estructura general de la tarea.
Ninguna técnica elimina del todo la brecha, así que los equipos siguen trabajando para reducir su impacto en el rendimiento real.
La IA encarnada ya funciona fuera del laboratorio en varias industrias, aunque de forma desigual.
El patrón que veo es que llega primero donde el entorno cambia demasiado como para guionizarlo a mano, pero donde un humano aún puede intervenir si algo falla.
Los coches autónomos son de los tipos de IA encarnada más hambrientos de datos.
Waymo Driver ha recorrido casi 200 millones de millas totalmente autónomas, y también entrena y prueba en miles de millones de millas en simulación, según su publicación de febrero de 2026 sobre su World Model. La simulación permite reproducir incidentes reales y generar escenarios raros (por ejemplo, un niño corriendo entre coches aparcados) que una flota de pruebas quizá nunca encuentre en carretera.
Los coches autónomos son también un buen ejemplo del bucle percepción-razonamiento-acción a toda velocidad. Un vehículo de Waymo percibe con cámaras, lidar y radar, razona qué hará cada peatón y vehículo a continuación y actúa controlando dirección y frenos muchas veces por segundo.
En mi opinión, los almacenes son hoy el uso comercial más natural de la IA encarnada.
El cambio va de robots de ruta fija que siguen líneas en el suelo a sistemas que gestionan inventario dinámico y desordenado, como recoger de una caja con 40 productos distintos mezclados.
El humanoide Digit de Agility Robotics ha estado moviendo cajas en GXO Logistics con un acuerdo plurianual firmado en 2024, y Stretch de Boston Dynamics descarga cajas de camiones.
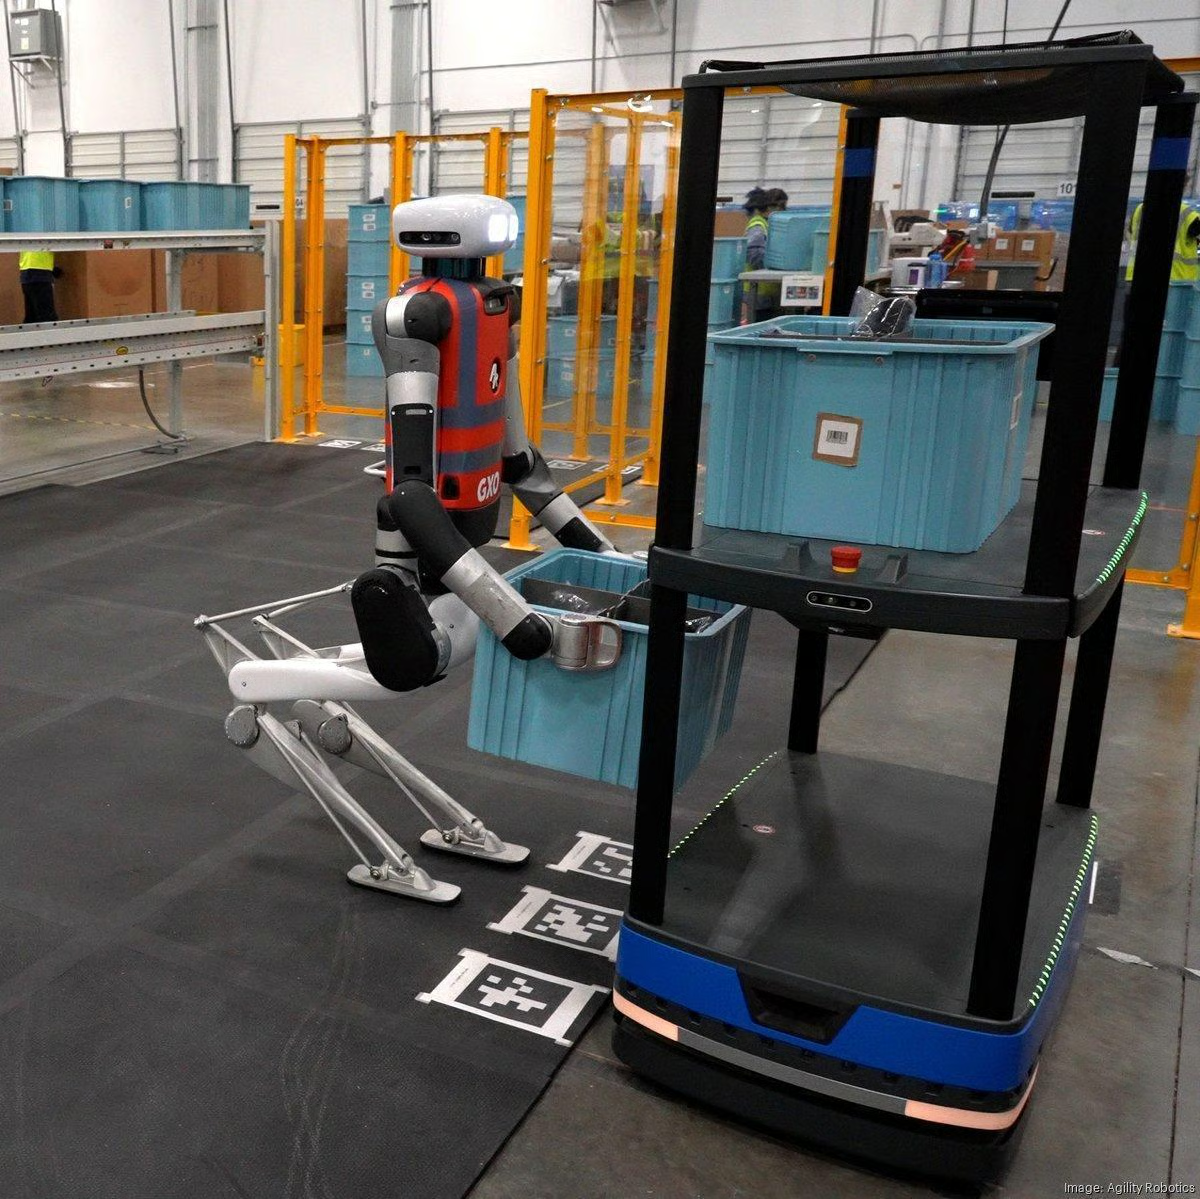
Digit, de Agility Robotics, moviendo contenedores entre robots móviles autónomos y una cinta en un almacén de GXO. Imagen de la fuente: Agility Robotics/The Robot Report
En sanidad, espero que la IA encarnada avance con mucha cautela.
Los sistemas quirúrgicos como da Vinci de Intuitive ya se usan en hospitales de todo el mundo, pero los controla un cirujano, y la mayoría de la I+D aquí se centra en asistencia, como seguimiento de instrumentos, control de cámara y apoyo al suturado.
En salud, la aprobación regulatoria suele ser un freno mayor que la capacidad del modelo, y con razón. Personalmente, esperaría que las aplicaciones de asistencia y formación lleguen mucho antes que algo cercano a la cirugía autónoma.
Los humanoides atraen más atención y están entre lo menos probado.
En el CES 2026, Boston Dynamics presentó la versión de producción de Atlas y dijo que todas las unidades que fabrique en 2026 ya están comprometidas con Hyundai y Google DeepMind. Figure, por su parte, realizó un despliegue de 11 meses de su humanoide Figure 02 en la planta de BMW en Spartanburg (Carolina del Sur), cargando chapa.
Quiero ser claro: la mayoría de despliegues de humanoides siguen siendo pilotos con un conjunto estrecho de tareas. Hyundai, por ejemplo, planea empezar a usar Atlas para secuenciación de piezas en 2028, señal de lo cuidadosos que son incluso los mayores impulsores.
Veamos quién está construyendo todo esto. Estas son las 5 organizaciones que, en mi opinión, cualquiera que llegue nuevo a la IA encarnada debería reconocer:
| Organización | Qué construyen | Por qué importa |
|---|---|---|
| NVIDIA | Isaac Sim, Isaac Lab, Newton, GR00T y Cosmos | La pila de simulación y cómputo con la que se entrena la mayoría |
| Physical Intelligence | Familia de modelos fundacionales de robots π₀ | Políticas de robot de propósito general con checkpoints abiertos |
| Agility Robotics | Humanoide Digit | Diseñado para logística en almacenes y ya con clientes |
| Boston Dynamics | Atlas, Stretch y Spot | Pasando Atlas de demos de investigación a unidades de producción en 2026 |
| AMI Labs (Yann LeCun) | Modelos de mundo estilo JEPA | Una apuesta contraria por modelos de mundo que no generan píxeles |
NVIDIA construye sobre todo las herramientas alrededor del robot, no el robot en sí.
Isaac Sim gestiona la simulación fotorrealista, Isaac Lab el aprendizaje por refuerzo sobre ella, y Newton ahora puede proporcionar la física. Muchos equipos de robótica entrenan con software de NVIDIA aunque NVIDIA no venda un robot de propósito general.
Physical Intelligence construyó π₀, un modelo visión-lenguaje-acción de 3.300 millones de parámetros que usa flow matching para producir bloques de acciones suaves en tareas como doblar ropa.
Es el mejor ejemplo que conozco de modelo de robot de propósito general que puedes descargar, a través del repositorio openpi.
Si el concepto de “modelo fundacional” te resulta nuevo, nuestra guía Introducción a los modelos fundacionales lo explica muy bien.
Agility Robotics eligió la vía estrecha con Digit.
Se diseñó desde el primer día para mover contenedores en almacenes, y ese foco es una gran razón por la que llegó antes a clientes de pago que la mayoría de humanoides.
Boston Dynamics tomó la vía opuesta con Atlas.
Pasó años llevando al límite la agilidad del robot (seguro que has visto los vídeos de parkour) antes de convertirlo en un producto totalmente eléctrico para fábrica que Google DeepMind planea potenciar con sus modelos Gemini Robotics.
AMI Labs es la startup parisina de Yann LeCun, que cerró una ronda semilla de 1.030 millones de dólares en marzo de 2026 con una valoración pre-money de 3.500 millones. La ronda fue co-liderada por Cathay Innovation, Greycroft, Hiro Capital, HV Capital y Bezos Expeditions, con NVIDIA y Samsung entre otros inversores.
LeCun lleva años defendiendo que predecir cada píxel del futuro es ineficiente, así que su Joint Embedding Predictive Architecture (JEPA) hace sus predicciones en un espacio de representaciones abstracto; una idea que Meta ya probó con V-JEPA 2.
Lo que hace a AMI interesante es que va a contracorriente de gran parte del campo. Aún no ha lanzado nada, así que, por ahora, yo lo trataría como una apuesta de investigación con mucho respaldo, más que como un enfoque ya probado.
La IA encarnada no es solo un problema de ingeniería robótica. Mucho trabajo, y diría que la mayor parte, es trabajo de aprendizaje automático.
Las habilidades que más se transfieren son:
No necesitas un robot para empezar. La biblioteca gymnasium incluye entornos MuJoCo, así que, tras ejecutar pip install "gymnasium[mujoco]", puedes ejecutar el bucle completo en un robot simulado:
import gymnasium as gym

# HalfCheetah is a 2D cheetah-like robot simulated with the MuJoCo physics engine
env = gym.make("HalfCheetah-v5")
observation, info = env.reset(seed=42)

for step in range(1000):
    # Perception: the observation holds joint angles and velocities
    # Reasoning: a trained policy would choose the action here, we pick randomly
    action = env.action_space.sample()

    # Action: apply torques to the joints and move the physics forward one step
    observation, reward, terminated, truncated, info = env.step(action)

    if terminated or truncated:
        observation, info = env.reset()

env.close()
Por ahora, el guepardo solo se agita porque el paso de “razonamiento” es env.action_space.sample(), que elige una acción aleatoria cada vez.
Reemplazar esa línea por una política entrenada es exactamente lo que hace el aprendizaje por refuerzo, y te recomiendo probarlo antes de pasar a algo más grande.
La IA encarnada avanza rápido, pero todavía se atasca en 4 frentes, y conviene conocerlos:
La IA encarnada da a las máquinas un cuerpo físico y la inteligencia para usarlo. Funciona mediante el bucle percepción-razonamiento-acción, está limitada sobre todo por la escasez de datos físicos y, en 2026, está saliendo de los laboratorios hacia los almacenes y los primeros pilotos en fábricas.
Lo que más me sorprende es cómo ha cambiado la pregunta. Hace unos años, la gente se preguntaba si los LLM harían irrelevante la investigación en robótica. En lugar de eso, los LLM se están convirtiendo en la capa de razonamiento dentro de los sistemas encarnados, y ambos campos están confluyendo.
¿Recuerdas la manzana del principio? Saber cómo cogerla y cogerla de verdad resultaron ser dos problemas muy distintos, y la IA encarnada trabaja en el segundo.
Si quieres construir las bases de ML para esto, empieza con nuestro itinerario de aprendizaje de Reinforcement Learning en Python. Para la parte de lenguaje de la pila, nuestro curso Large Language Models (LLMs) Concepts y nuestro itinerario Developing Large Language Models son buenos siguientes pasos.
Los mejores cursos de DataCamp
Curso
Curso
Programa
blog
Adel Nehme
15 min
blog
Javier Canales Luna
10 min
blog
DataCamp Team
4 min
blog
Austin Chia
10 min
blog
Tutorial
Zoumana Keita
12 min