Курс
Глубокое обучение с подкреплением на Python
4 ч
6K
Представьте, что вы просите друга подать вам яблоко из фруктовой вазы. Он смотрит на вазу, понимает, где именно яблоко, и берёт его достаточно аккуратно, чтобы не раздавить, а потом передаёт вам.
Теперь попросим о том же чат-бота. Он сможет подробно объяснить, как взять яблоко, какими пальцами и с какой силой сжать, но не сможет действительно его поднять. У него нет рук и нет представления о том, как яблоко ощущается на ощупь.
Воплощённый ИИ — это область, которая пытается закрыть этот разрыв. Проще говоря, это ИИ с физическим телом (например, робот, автомобиль или дрон), который учится, действуя в реальном мире, а не только «читая» о нём. Близкий по смыслу термин — «физический ИИ».
Сейчас эта область переживает большой подъём. На CES в январе 2026 года Дженсен Хуанг из NVIDIA назвал его «моментом ChatGPT для робототехники».
За этим пошли деньги. По данным Dealroom, на которые ссылается CNBC, к началу июня 2026 года робототехнические компании привлекли 55,8 млрд долларов, почти вдвое больше предыдущего годового рекорда.
В этой статье мы рассмотрим:
Не переживайте, если вы никогда не работали с роботами. Базовые знания машинного обучения помогут, но мы разберём каждую идею с нуля, чтобы вы могли следить за изложением в любом случае.
Воплощённый ИИ — это система искусственного интеллекта с физическим телом (например, робот, автономный автомобиль или дрон), которая воспринимает окружающую среду с помощью датчиков, рассуждает о том, что делать, и действует на мир через приводы, обучаясь на результатах собственных действий.
Ключевое слово здесь — воплощённый.
Большинство моделей ИИ учатся, наблюдая данные, собранные кем-то другим. Воплощённая система учится, взаимодействуя со средой — например, толкает чашку, наблюдает, как она скользит, и обновляет своё представление о том, как ведут себя чашки при толчке.
Вот пример. Модель зрения, обученная на миллионах фотографий дверей, знает, как выглядит дверь. Робот, который реально пытался открыть 500 дверей, знает, что одни двери толкаются, другие тянутся, некоторые тяжёлые, а у некоторых есть ручки, которые нужно сначала нажать вниз.
Такую глубину знаний из фото не получить.
Можно сказать так: большинство ИИ узнают о мире, читая о нём; воплощённый ИИ узнаёт о мире, прикасаясь к нему и испытывая его.
Эта единственная разница меняет требуемые данные, подходы к обучению и способы, которыми всё может пойти не так.
Пока что мы сравнивали воплощённый ИИ с чат-ботом. Теперь сравним его с двумя вещами, с которыми его чаще всего путают: большими языковыми моделями (LLM) и традиционной робототехникой на правилах.
| Воплощённый ИИ | Большие языковые модели (LLM) | Традиционная робототехника на правилах | |
|---|---|---|---|
| Обучается на среде | Да, через взаимодействие и обратную связь | Скорее нет, обучается на фиксированном корпусе текстов | Нет, поведение прописано вручную |
| Выполняет физические действия | Да | Нет | Да |
| Обучается на данных из интернета | Частично (визуально-языковые бэкенды) | Да, триллионы токенов | Нет |
| Обобщает на новые среды | Умеренно, и быстро улучшается | Хорошо, в рамках языковых задач | Плохо, ломается при изменении конфигурации |
| Коммерческая зрелость в 2026 | Ранний продакшен (склады, пилоты на фабриках) | Зрело и широко внедрено | Зрело, десятилетия использования на заводах |
Я бы выделил последние две строки.
Промышленные манипуляторы на правилах десятилетиями сваривают автомобили и предельно надёжны, но только потому, что в их рабочей зоне ничего не меняется. Воплощённый ИИ стремится сохранить эту надёжность, позволяя миру оставаться хаотичным — то, что исследователи называют обобщением.
LLM и воплощённый ИИ оба учатся на огромных массивах данных, но решают совсем разные задачи. LLM принимает текст и предсказывает следующий токен, тогда как воплощённая система принимает кадры с камер, углы сочленений и тактильные показания и предсказывает следующее движение.
Короче: LLM знают о физическом мире, а воплощённый ИИ действует в нём. Возвращаясь к яблоку: LLM может описать, как его поднять, а робот с воплощённым ИИ может действительно это сделать.
Цена ошибки тоже разная. Ошибка LLM даст чуть странное предложение. Ошибка воплощённой системы может привести к тому, что стакан окажется на полу — или к чему-то хуже.
И вот важный момент, который многие упускают: эти два подхода работают вместе.
В визуально-языково-действенных (VLA) моделях предобученная визуально-языковая модель — сердце системы. Она читает изображения с камер и вашу инструкцию («положи фрукты в вазу»), затем передаёт своё понимание декодеру действий, который вырабатывает реальные моторные команды.
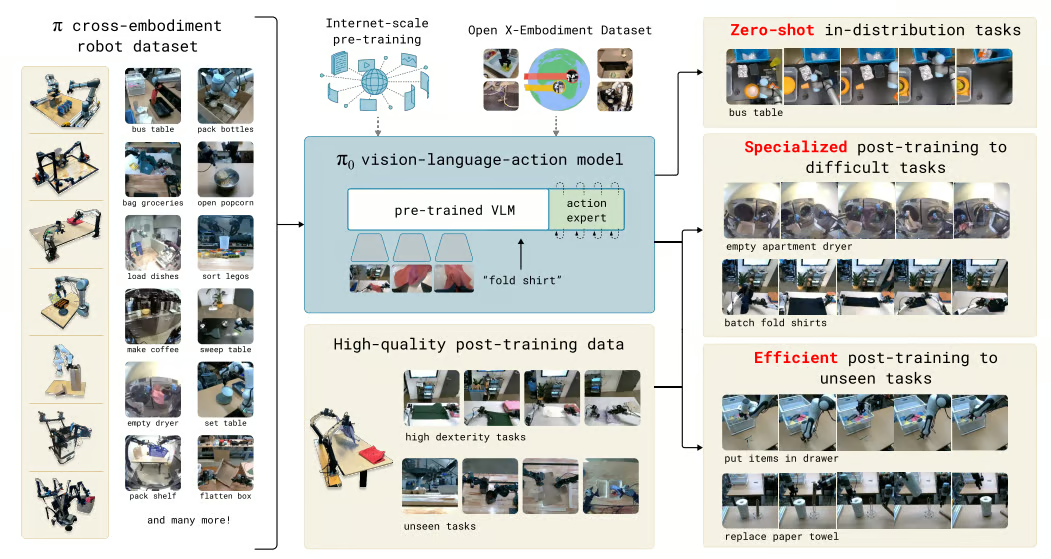
Как предобученная визуально-языковая модель связана с роботизированными действиями в π₀ (pi-zero). Источник изображения: Black et al., 2024
Главная причина, почему физический ИИ сложнее цифрового, — это данные.
Языковые модели быстро продвинулись благодаря десятилетиям открытого обмена текстами, кодом и изображениями в интернете, но сопоставимого источника реальных датчиковых данных не существует. Намного меньше потоков углов сочленений, силовых показаний и кадров с камер, снятых роботами при взаимодействии с бытовыми объектами.
Посмотрим детальнее на требования к данным. Воплощённой системе нужны три типа данных, которые трудно достать:
Теперь немного цифр.
Передовые LLM обучаются на триллионах токенов. Open X-Embodiment, один из крупнейших открытых наборов данных для робототехники, объединил данные от 22 типов роботов из 21 института и в итоге получил чуть более 1 млн реальных траекторий.
Роботы и задачи, объединённые в наборе данных Open X-Embodiment. Источник изображения: Open X-Embodiment Collaboration, 2023
Почему так мало? Каждая траектория требует реального робота, выполняющего настоящую задачу, обычно под управлением человека через телеприсутствие — это медленно и дорого.
Именно из-за этого физический ИИ обобщается медленнее, чем цифровой. Модель лучше справляется с вариативностью, когда раньше видела нечто похожее; миллион траекторий охватывает куда меньше кухонь, схем освещения и форм объектов, чем триллионы токенов — предложений.
Советую держать эту проблему данных в уме до конца статьи. Многие решения, которые вы увидите ниже — от симуляции и доменной рандомизации до заимствования предобученных визуально-языковых бэкендов, — это обходные пути именно из-за нехватки данных.
Воплощённый ИИ работает, непрерывно выполняя цикл из трёх стадий:
Цикл повторяется много раз в секунду, и каждое движение меняет последующие ощущения робота, так что выход одного цикла становится входом следующего.
Тот же цикл лежит в основе мировых моделей. В статье Ха и Шмидхубера World Models (2018) агент разделён на модуль зрения, модуль памяти и контроллер и протестирован на машине в гоночной игре. Воплощённый ИИ применяет ту же идею к полноценному роботу.
Понять цикл помогает пример с ловлей мяча:
Робот делает то же самое — только с камерами вместо глаз и моторами вместо мышц.
Рассмотрим каждую стадию по очереди.
Восприятие — это стадия, которая превращает «сырые» показания датчиков в форму, с которой может работать остальная система. Одной камеры редко хватает, поэтому большинство роботов комбинируют несколько датчиков:
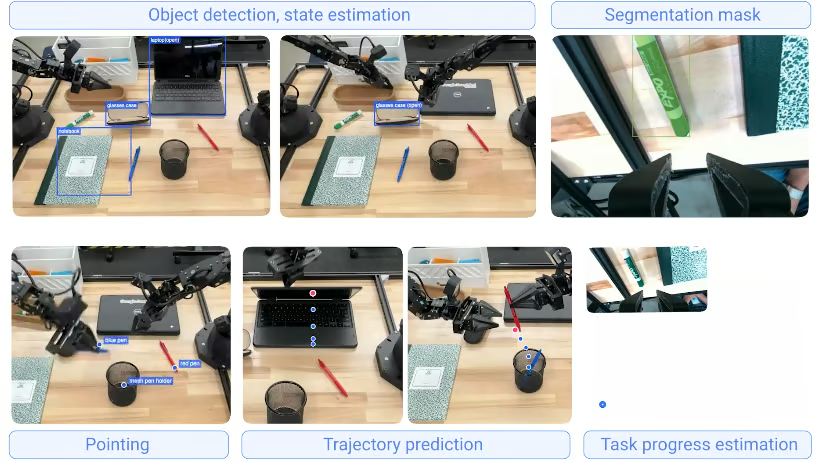
Примеры результатов восприятия в Gemini Robotics-ER 1.5. Источник изображения: Google DeepMind
Модели восприятия затем превращают эти показания в пространственные карты, идентичности объектов, позиции препятствий и общее понимание сцены.
Большая часть — это стандартное компьютерное зрение — детекция объектов, сегментация, оценка глубины — обычно на предобученных визуальных трансформерах вроде DINOv2 или SigLIP.
На мой взгляд, однако, осязание — самый недооценённый аспект восприятия сейчас. Камера сообщит, что на столе есть стакан, но осязание подскажет, что стакан начинает выскальзывать из захвата.
Для примера: XELA Robotics показала на Automate 2026 роботизированный «пальчик» с 30 трёхосевыми точками измерения силы, размещёнными на подушечке. Компания также заявляет, что её датчики uSkin могут обнаруживать силы от 0,1 грамм-силы.
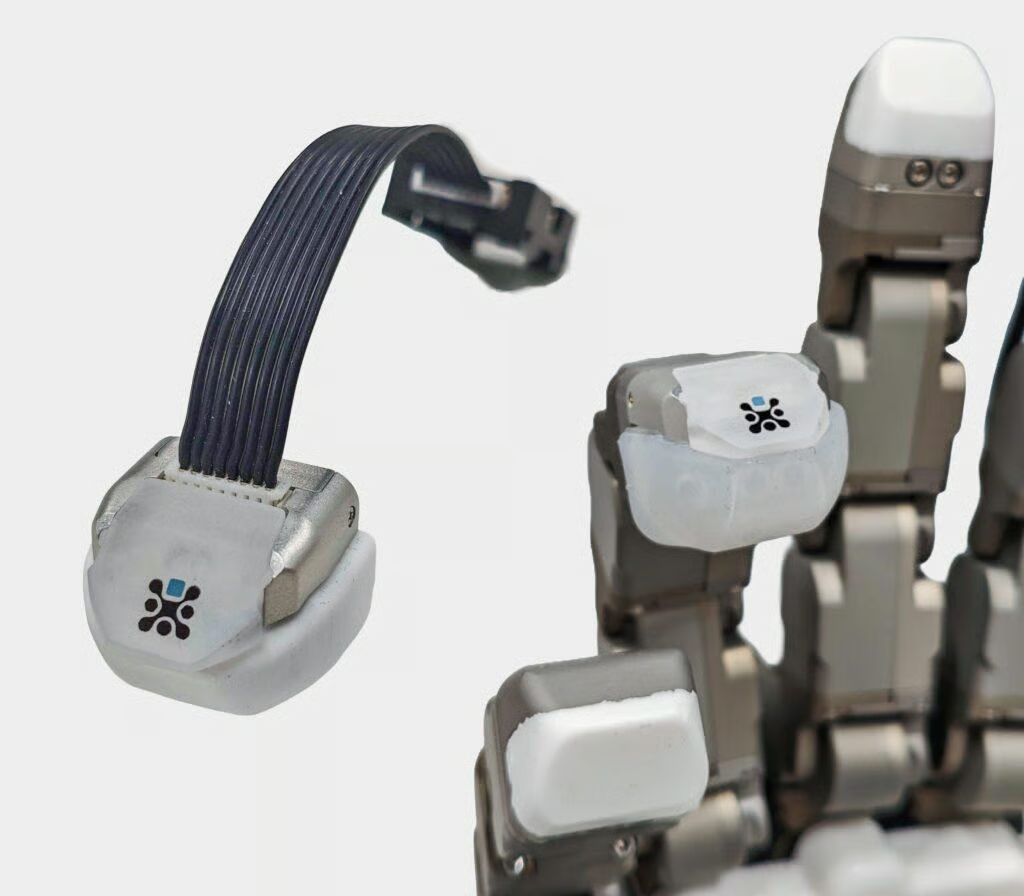
Роботизированный кончик пальца uSkin с массивом трёхосевых тактильных сенсоров. Источник изображения: XELA Robotics
Рассуждение — это стадия, где решается, что делать дальше. В новых системах она обычно двухуровневая:
Мировые модели позволяют роботу «представить» действие до его выполнения.
DreamerV3 — хороший пример. Она изучает компактную модель своей среды, а затем практически полностью обучает политику внутри этого воображаемого мира.
В собственной работе с DreamerV3 меня больше всего удивило, насколько больше времени агент проводит в «голове», чем в реальной среде. Это важно, потому что обучение становится быстрее и значительно дешевле.
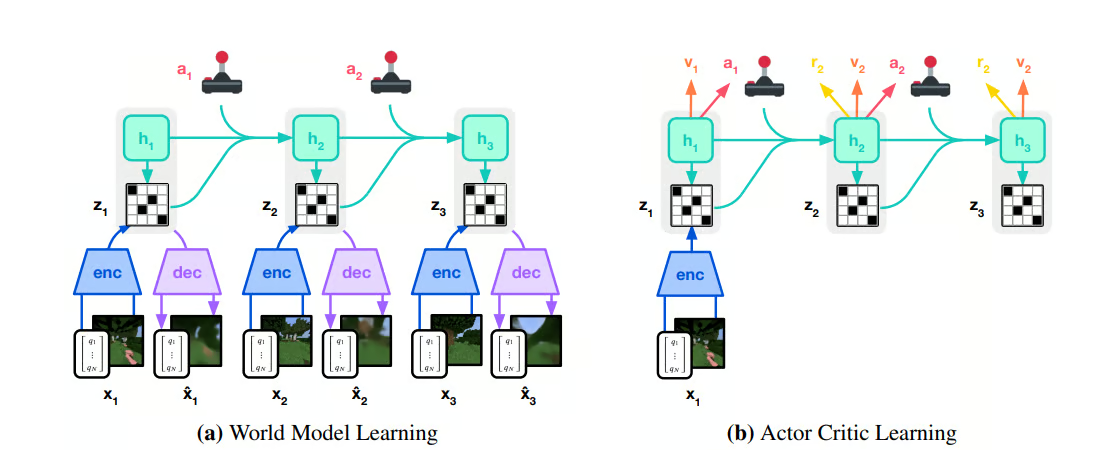
DreamerV3 обучает политику на воображаемых прогонах из своей мировой модели. Источник изображения: Hafner et al., 2023
Планирование, в свою очередь, всё чаще выполняют языковые модели.
Хороший пример — Gemini Robotics-ER 1.5 от Google DeepMind, выступающая как планировщик высокого уровня. Получив задачу, например, сортировать отходы по местным правилам переработки, она может найти правила через Google Поиск, разбить работу на шаги и передать каждый шаг модели VLA Gemini Robotics 1.5, которая выполняет физическую часть.
Можно думать о языковой модели как о руководителе, а о VLA — как о «исполнителе», который делает работу.
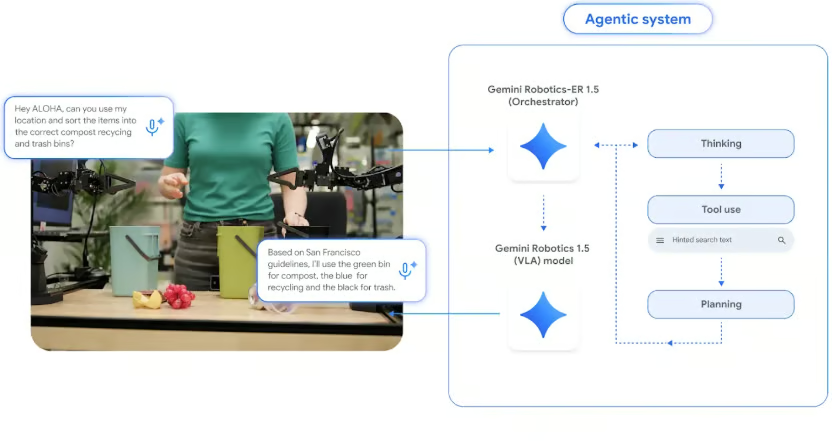
Gemini Robotics-ER 1.5 планирует задачу и делегирует физическое исполнение Gemini Robotics 1.5 VLA. Источник: Google DeepMind, 2025
Действие — это стадия, которая преобразует решение в точные команды для каждого сочленения и мотора, обычно десятки или сотни раз в секунду (в герцах, Гц). Низкоуровневая часть этой стадии называется управлением.
Например, команда «Сместить хват на 5 см влево» звучит просто, но на руке с семью сочленениями она должна превратиться в конкретные крутящие моменты для каждого привода, непрерывно пересчитываемые по мере движения руки.
Сложность в том, что реальность редко совпадает с ожиданиями робота. Объекты проскальзывают, пол редко идеально ровный, освещение меняется, когда кто-то открывает жалюзи, а кабель изгибается не так, как предсказано.
Хороший контроллер замечает разницу между ожиданием и реальностью и немедленно корректирует действия.
Считаю, что действие — самая сложная стадия в «шумных» и неструктурированных средах. Ошибку восприятия можно исправить, посмотрев ещё раз, ошибку планирования — перепланировав, а ошибка управления происходит в реальном времени.
Воплощённый ИИ обучают на смеси симуляции и реальных данных. Симуляция — это виртуальные среды с физически корректными 3D-объектами, где робот может «потренироваться» миллионы раз до первого прикосновения к реальному железу.
Помните проблему данных? Симуляция — один из главных обходных путей, особенно для обучения с подкреплением в локомоции и манипулировании. Фундаменты вроде π₀ всё ещё сильно опираются на реальные демонстрации, поэтому большинство команд совмещают оба подхода.
Сбор данных в реальном мире имеет три больших минуса:
Симулятор решает все три сразу. На одном GPU можно запустить тысячи виртуальных роботов параллельно и позволить им сколько угодно ошибаться и перезапускаться. Это сжимает годы «опыта» робота в несколько часов.
Не каждый симулятор одинаково полезен для обучения роботов. По опыту работы с симулированными робот-руками, хороший симулятор должен иметь три свойства:
Чаще всего вы встретите NVIDIA Isaac Sim (с Isaac Lab) и MuJoCo:
| Платформа | Разработчик | Сильные стороны | Лучше всего подходит для |
|---|---|---|---|
| NVIDIA Isaac Sim и Isaac Lab | NVIDIA | Фотореалистичный рендеринг, симуляция датчиков, тысячи параллельных сред на GPU | Крупные запуски RL и синтетические данные с камер |
| MuJoCo | Google DeepMind (open source) | Быстрая и точная контактная физика, лёгкость, большое сообщество исследователей | Исследования, бенчмарки по локомоции и манипулированию |
Новичок в экосистеме — Newton, открытый GPU-ускоренный физический движок, созданный NVIDIA, Google DeepMind и Disney Research и курируемый Linux Foundation.
Newton 1.0 вышел на NVIDIA GTC в марте 2026. Он подключается к Isaac Lab как физический бэкенд, с MuJoCo Warp в роли одного из солверов и дополнительными солверами для деформируемых объектов — кабелей и ткани.
Деформируемые объекты важнее, чем кажется. Старые симуляторы плохо справлялись с кабелями и тканями, а заводам нужны роботы, умеющие работать и с тем, и с другим.
Разрыв «симуляция — реальность» — это падение качества при переносе политики, обученной в симуляции, на реального робота, и это одна из главных проблем воплощённых систем.
Например, трение в симуляции никогда не совпадает полностью с реальным, камеры в симуляции «слишком чистые», объекты — слишком идеальные, поэтому политика, достигающая 95% успеха в симуляции, может «ломаться» при встрече с реальным железом.
Есть два основных способа сократить этот разрыв:
Вместо попыток сделать симулятор «идеальным» команды максимально его рандомизируют.
Tobin et al. (2017) настолько сильно рандомизировали текстуры и освещение, что реальный мир для модели выглядел как ещё одна вариация. Роботизированная рука OpenAI для кубика Рубика (Rubik’s Cube) зашла дальше, автоматически расширяя диапазон рандомизации по мере улучшения политики.
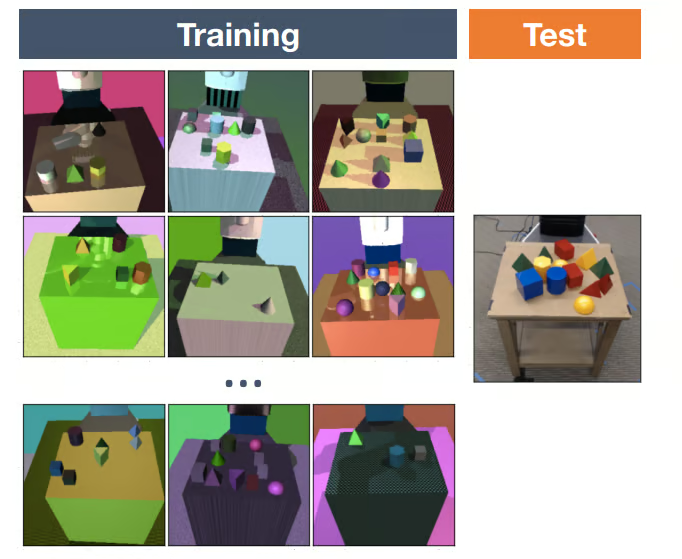
Политике, предобученной в симуляции, часто нужен лишь небольшой набор реальных демонстраций для адаптации, потому что общий «каркас» задачи уже выучен.
Ни одна из техник не убирает разрыв полностью, поэтому команды продолжают работать над снижением его влияния на реальную производительность.
Воплощённый ИИ уже работает вне лабораторий в ряде отраслей, хотя и неравномерно.
Шаблон, который я вижу: он появляется там, где среда слишком изменчива, чтобы прописать всё вручную, но где человек всё ещё может вмешаться, если что-то пойдёт не так.
Беспилотники — один из самых «прожорливых» к данным видов воплощённого ИИ.
Waymo Driver проехал почти 200 млн полностью автономных миль, а также обучается и тестируется на миллиардах миль в симуляции, согласно посту Waymo за февраль 2026 о её Мировой Модели. Симуляция позволяет проигрывать реальные инциденты и генерировать редкие сценарии (например, ребёнок выбегает между припаркованными машинами), с которыми тестовый парк может никогда не столкнуться на дорогах.
Беспилотники также хорошо иллюстрируют цикл восприятия, рассуждения и действия на полной скорости. Автомобиль Waymo воспринимает с помощью камер, лидара и радара, рассуждает о том, что вероятнее всего сделают пешеходы и машины дальше, и действует, управляя рулём и тормозами много раз в секунду.
На мой взгляд, склады — самое естественное коммерческое применение воплощённого ИИ сегодня.
Происходит переход от роботов по фиксированным маршрутам (по линиям на полу) к системам, способным работать с динамичным, «грязным» инвентарём, например, отбором из контейнера, куда свалены 40 разных товаров вместе.
Гуманоид Digit от Agility Robotics перемещает контейнеры у GXO Logistics по многолетнему соглашению 2024 года, а Stretch от Boston Dynamics разгружает коробки из грузовиков.
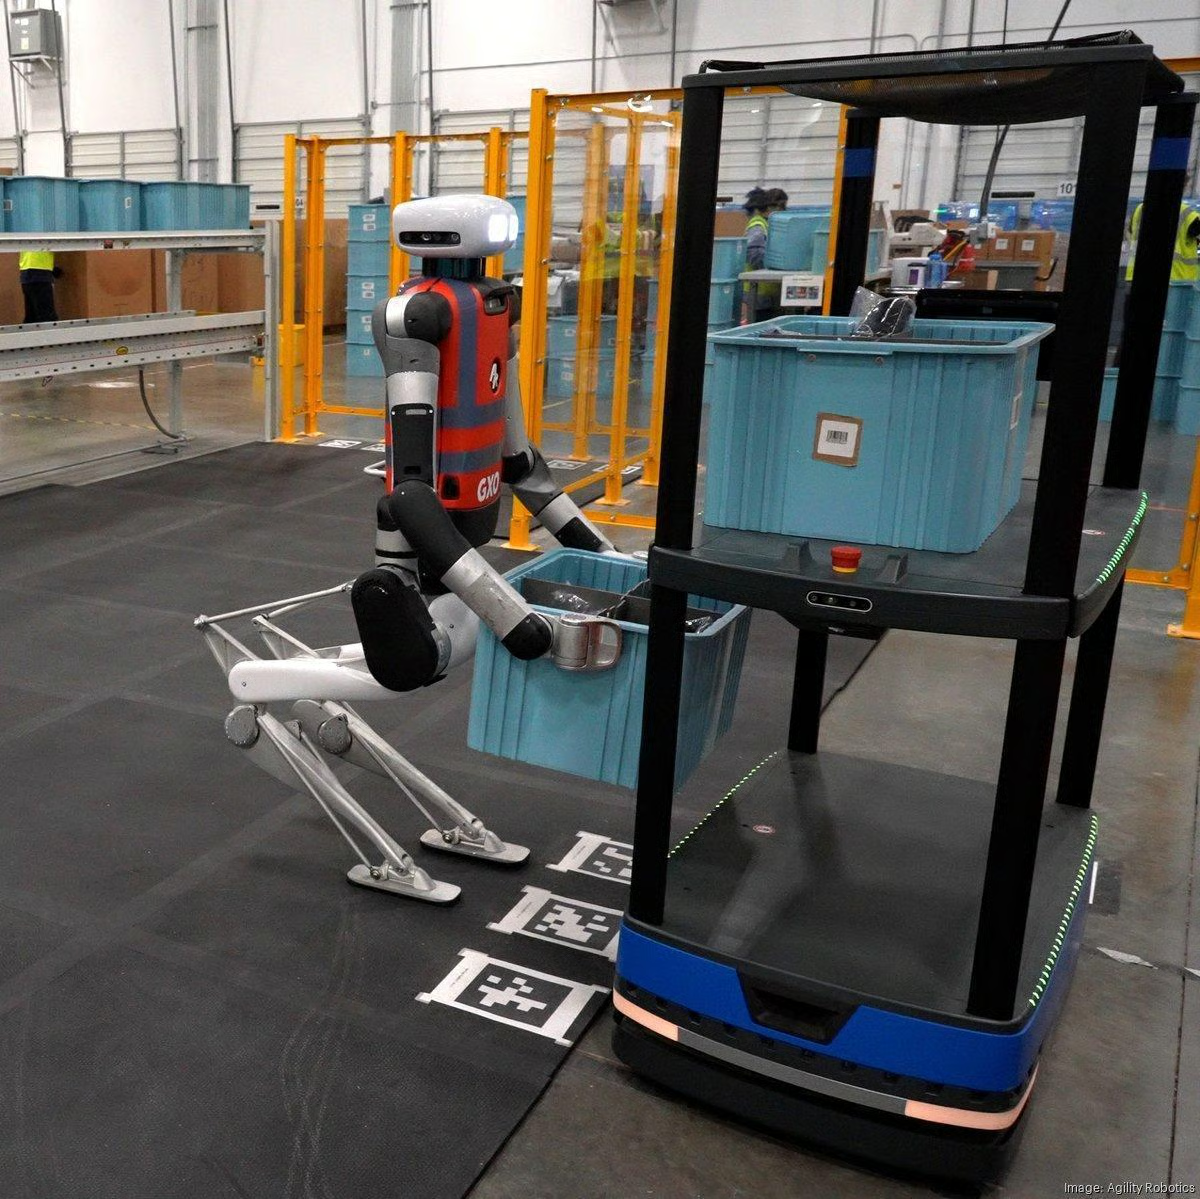
Digit от Agility Robotics переносит контейнеры между автономными мобильными роботами и конвейером на складе GXO. Источник изображения: Agility Robotics/The Robot Report
В здравоохранении, как ожидается, воплощённый ИИ будет двигаться особенно осторожно.
Хирургические системы, такие как da Vinci от Intuitive, уже используются по всему миру, но ими управляет хирург, и большая часть исследований ИИ здесь сосредоточена на ассистировании — отслеживание инструментов, управление камерой, помощь в прошивании швов.
В здравоохранении регуляторное одобрение часто сильнее ограничивает внедрение, чем возможности моделей — и это правильно. Лично я ожидаю, что помощники и тренажёры появятся гораздо раньше чего-то, близкого к автономной хирургии.
Гуманоды привлекают больше всего внимания и одновременно остаются наименее доказанными.
На CES 2026 Boston Dynamics представила серийную версию Atlas и заявила, что все выпущенные в 2026 году единицы уже закреплены за Hyundai и Google DeepMind. Figure, в свою очередь, провела 11-месячное развертывание своего Figure 02 на заводе BMW в Спартанбурге (Южная Каролина), загружая листовой металл.
Однако буду честен: большинство внедрений гуманойдов — это пока пилоты с узким набором задач. Например, Hyundai планирует начать использовать Atlas для комплектования деталей в 2028 году — показатель того, насколько осторожно движутся даже крупнейшие сторонники.
Теперь поговорим о тех, кто всё это строит. Вот 5 организаций, которые, на мой взгляд, должен знать каждый, кто знакомится с воплощённым ИИ:
| Организация | Что они создают | Почему это важно |
|---|---|---|
| NVIDIA | Isaac Sim, Isaac Lab, Newton, GR00T и Cosmos | Симуляционный и вычислительный стек, на котором обучается большинство команд |
| Physical Intelligence | Семейство фундаментальных робот-моделей π₀ | Универсальные политики для роботов с открытыми контрольными точками |
| Agility Robotics | Гуманоид Digit | Создан для складской логистики и уже работает с заказчиками |
| Boston Dynamics | Atlas, Stretch и Spot | Перевод Atlas из исследовательских демонстраций в серийные устройства в 2026 |
| AMI Labs (Ян Лекун) | Мировые модели в стиле JEPA | Идущая против мейнстрима ставка на мировые модели без генерации пикселей |
NVIDIA в основном создаёт инструменты вокруг робота, а не самих роботов.
Isaac Sim отвечает за фотореалистичную симуляцию, Isaac Lab — за обучение с подкреплением поверх неё, а Newton теперь обеспечивает физику. Многие команды в робототехнике обучаются на софте NVIDIA, хотя сама NVIDIA не продаёт универсального робота.
Physical Intelligence создала π₀ — 3,3-миллиардную визуально-языково-действенную модель, которая использует flow matching для генерации плавных фрагментов действий, например, при складывании белья.
Это лучший известный мне пример универсальной робот-модели, которую можно реально скачать — в репозитории openpi.
Если термин «фундаментальная модель» для вас нов, наш гид Introduction to Foundation Models хорошо объясняет идею.
Agility Robotics выбрала узкую специализацию для Digit.
С первого дня он был спроектирован для перемещения контейнеров на складах, и именно этот фокус помог ему раньше большинства гуманойдов выйти на платящих клиентов.
Boston Dynamics пошла противоположным путём с Atlas.
Годы компания расширяла атлетические возможности робота (вы наверняка видели ролики с паркуром), прежде чем превратить его в полностью электрический продукт для заводов, который Google DeepMind планирует «питать» своими моделями Gemini Robotics.
AMI Labs — стартап Яна Лекуна со штаб-квартирой в Париже, закрывший сид-раунд на 1,03 млрд долларов в марте 2026 при оценке 3,5 млрд до денег. Раунд возглавили Cathay Innovation, Greycroft, Hiro Capital, HV Capital и Bezos Expeditions; среди инвесторов также NVIDIA и Samsung.
Лекун много лет утверждает, что предсказывать каждый пиксель будущего — расточительно, поэтому его Joint Embedding Predictive Architecture (JEPA) делает предсказания в абстрактном пространстве представлений; Meta уже тестировала идею на V-JEPA 2.
За AMI стоит следить потому, что она идёт против основного тренда в области. Впрочем, пока она ничего не поставляет, так что это скорее исследовательская ставка с большим финансированием, чем доказанный на практике подход.
Воплощённый ИИ — это не только инженерия роботов. Большая часть работы, я бы сказал — большая её доля, — это задачи машинного обучения.
Навыки, которые переносятся наиболее прямо:
Чтобы начать, робот не нужен. Библиотека gymnasium поставляется со средами MuJoCo, так что после установки pip install "gymnasium[mujoco]" вы можете запустить весь цикл на симулированном роботе:
import gymnasium as gym

# HalfCheetah is a 2D cheetah-like robot simulated with the MuJoCo physics engine
env = gym.make("HalfCheetah-v5")
observation, info = env.reset(seed=42)

for step in range(1000):
    # Perception: the observation holds joint angles and velocities
    # Reasoning: a trained policy would choose the action here, we pick randomly
    action = env.action_space.sample()

    # Action: apply torques to the joints and move the physics forward one step
    observation, reward, terminated, truncated, info = env.step(action)

    if terminated or truncated:
        observation, info = env.reset()

env.close()
Сейчас «гепард» просто машет конечностями, потому что шаг «рассуждения» — это env.action_space.sample(), то есть каждый раз выбирается случайное действие.
Заменить эту одну строку на обученную политику — ровно то, для чего нужно обучение с подкреплением; стоит попробовать это до перехода к чему-то большему.
Воплощённый ИИ быстро развивается, но всё ещё испытывает трудности в четырёх местах — важно о них знать:
Воплощённый ИИ даёт машинам физическое тело и интеллект для его использования. Он работает через цикл восприятия, рассуждения и действия, упирается прежде всего в нехватку физических данных и в 2026 году выходит из лабораторий на склады и первые заводские пилоты.
Меня по-настоящему удивляет, как изменился вопрос. Ещё пару лет назад спрашивали, сделают ли LLM исследования в робототехнике неактуальными. Вместо этого LLM становятся слоем рассуждений внутри воплощённых систем, и эти две области «растут» навстречу друг другу.
Помните яблоко из начала статьи? Знать, как его поднять, и действительно поднять — оказались двумя разными задачами, и воплощённый ИИ работает над второй.
Если вы хотите заложить ML-основы для этого, начните с нашего трека Reinforcement Learning in Python. Для языковой части стека подойдут наш курс Large Language Models (LLMs) Concepts и трек Developing Large Language Models.
Лучшие курсы DataCamp
Курс
Курс
Трек