
Khóa học
Deep Reinforcement Learning bằng Python
4 giờ
6K
Hãy tưởng tượng bạn nhờ một người bạn đưa cho bạn một quả táo từ tô trái cây. Họ nhìn vào tô, xác định đâu là quả táo, rồi nhấc nó lên đủ nhẹ nhàng để không bị bóp nát trước khi đưa cho bạn.
Giờ hãy yêu cầu một chatbot làm điều tương tự. Nó có thể nói cho bạn chính xác cách nhấc một quả táo, dùng những ngón tay nào, và bóp mạnh khoảng bao nhiêu, nhưng nó không thể thực sự nhấc quả táo. Nó không có tay và cũng không biết cảm giác của một quả táo.
Embodied AI là lĩnh vực đang cố gắng thu hẹp khoảng cách này. Nói đơn giản, đó là AI có một cơ thể vật lý (như robot, ô tô hay drone) và học bằng cách làm việc trong thế giới thực thay vì chỉ đọc về chúng. Bạn cũng sẽ thấy thuật ngữ liên quan chặt chẽ là “physical AI” (AI vật lý) dùng cho cùng một ý tưởng.
Hiện tại, lĩnh vực này đang có bước bùng nổ. Tại CES tháng 1/2026, Jensen Huang của NVIDIA gọi đây là “khoảnh khắc ChatGPT của ngành robot”.
Tiền cũng đổ vào. Dữ liệu từ Dealroom do CNBC đưa tin cho thấy các công ty robot đã huy động 55,8 tỷ USD trong năm 2026 tính đến đầu tháng 6, gần gấp đôi kỷ lục thường niên trước đó.
Trong bài viết này, tôi sẽ đề cập:
Đừng lo nếu bạn chưa từng làm việc với robot. Có chút quen thuộc với machine learning sẽ hữu ích, nhưng tôi sẽ xây dựng mọi ý tưởng từ đầu để bạn có thể theo dõi dù thế nào.
Embodied AI là một hệ thống trí tuệ nhân tạo được tích hợp vào một cơ thể vật lý, như robot, phương tiện tự hành hay drone, có khả năng cảm nhận môi trường qua cảm biến, lý luận về việc cần làm, và hành động lên thế giới qua động cơ, học từ kết quả của chính hành động của nó.
Thuật ngữ then chốt ở đây là embodied (có thân thể).
Hầu hết mô hình AI học bằng cách quan sát dữ liệu do người khác thu thập. Một hệ thống embodied học bằng cách tương tác với môi trường, chẳng hạn đẩy một chiếc cốc, quan sát cốc trượt, và cập nhật hiểu biết về cách cốc ứng xử khi bị đẩy.
Ví dụ như sau. Một mô hình thị giác được huấn luyện trên hàng triệu ảnh cánh cửa biết một cánh cửa trông như thế nào. Một robot đã thực sự thử mở 500 cánh cửa biết rằng có cửa đẩy, cửa kéo, cửa nặng, và có cửa có tay nắm cần ấn xuống trước.
Bạn không thể có mức độ hiểu sâu này chỉ từ một bức ảnh.
Tôi thích diễn đạt thế này: đa số AI học về thế giới bằng cách đọc về nó; embodied AI học về thế giới bằng cách chạm và trải nghiệm nó.
Một khác biệt này thay đổi dữ liệu bạn cần, cách bạn huấn luyện, và cách mọi thứ có thể sai hỏng.
Đến giờ, tôi đã so sánh embodied AI với chatbot. Hãy so sánh nó với 2 thứ mà mọi người thường nhầm lẫn nhất: mô hình ngôn ngữ lớn (LLMs) và robot học dựa trên luật truyền thống.
| Embodied AI | Mô hình ngôn ngữ lớn (LLMs) | Robot học dựa trên luật truyền thống | |
|---|---|---|---|
| Học từ môi trường | Có, thông qua tương tác và phản hồi | Hầu như không, học từ một kho văn bản cố định | Không, hành vi được lập trình thủ công |
| Thực hiện hành động vật lý | Có | Không | Có |
| Huấn luyện trên dữ liệu internet | Một phần (các backbone thị giác và ngôn ngữ) | Có, hàng nghìn tỷ token | Không |
| Tổng quát hóa sang môi trường mới | Ở mức vừa, và đang cải thiện nhanh | Tốt, trong phạm vi các tác vụ ngôn ngữ | Kém, dễ hỏng khi thiết lập thay đổi |
| Độ trưởng thành thương mại năm 2026 | Đầu giai đoạn sản xuất (kho hàng, thí điểm nhà máy) | Trưởng thành và triển khai rộng rãi | Trưởng thành, đã dùng trong nhà máy hàng thập kỷ |
Hai hàng cuối là những điều tôi muốn nhấn mạnh.
Các cánh tay công nghiệp dựa trên luật đã hàn ô tô hàng thập kỷ và cực kỳ tin cậy, nhưng chỉ vì không có gì trong ô làm việc của chúng từng thay đổi. Embodied AI cố gắng giữ độ tin cậy đó trong khi chấp nhận thế giới lộn xộn, điều mà các nhà nghiên cứu gọi là năng lực tổng quát hóa.
LLM và embodied AI đều học từ lượng dữ liệu khổng lồ, nhưng chúng giải quyết những bài toán rất khác. Một LLM nhận văn bản đầu vào và dự đoán token tiếp theo, trong khi một hệ embodied nhận khung hình từ camera, góc khớp, và tín hiệu xúc giác rồi dự đoán chuyển động tiếp theo.
Tóm lại, LLM biết về thế giới vật lý, còn embodied AI hành động trong đó. Quay lại quả táo: một LLM có thể mô tả chính xác cách nhấc nó lên, còn robot embodied AI có thể thực sự làm việc đó.
Chi phí của sai sót cũng rất khác. Nếu LLM sai, bạn nhận một câu hơi kỳ. Nếu một hệ embodied sai, một chiếc ly có thể rơi xuống sàn, hoặc tệ hơn.
Và đây là phần tôi nghĩ nhiều người bỏ lỡ: hai thứ này phối hợp với nhau.
Trong các mô hình thị giác-ngôn ngữ-hành động (VLA), một mô hình thị giác-ngôn ngữ tiền huấn luyện nằm ở lõi hệ thống. Nó đọc ảnh từ camera và chỉ dẫn của bạn (“đặt trái cây vào tô”), rồi chuyển cách hiểu đó cho bộ giải mã hành động để tạo ra lệnh điều khiển động cơ thực tế.
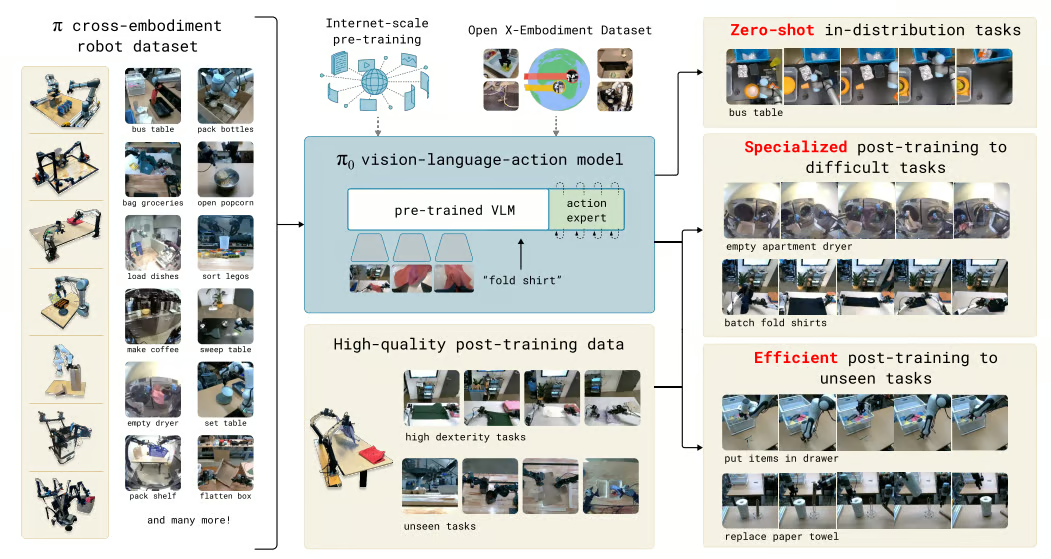
Cách một mô hình thị giác-ngôn ngữ tiền huấn luyện kết nối với hành động của robot trong π₀ (pi-zero). Ảnh nguồn: Black et al., 2024
AI vật lý khó hơn AI số chủ yếu vì dữ liệu.
Các mô hình ngôn ngữ tiến bộ nhanh nhờ hàng thập kỷ con người chia sẻ văn bản, mã và hình ảnh trực tuyến, nhưng không có nguồn dữ liệu cảm biến thế giới thực tương đương. Có rất ít luồng góc khớp, lực tác dụng, và khung hình camera từ robot tương tác với đồ vật hằng ngày.
Hãy xem kỹ hơn yêu cầu dữ liệu. Một hệ embodied cần 3 loại dữ liệu khó tìm:
Giờ hãy đặt vài con số lên bàn.
Các LLM tiên phong được huấn luyện trên hàng nghìn tỷ token. Open X-Embodiment, một trong những bộ dữ liệu robot mở lớn nhất, gộp dữ liệu từ 22 loại robot tại 21 tổ chức và chỉ thu được hơn 1 triệu quỹ đạo thực.
Các robot và tác vụ được gộp trong bộ dữ liệu Open X-Embodiment. Ảnh nguồn: Open X-Embodiment Collaboration, 2023
Tại sao lại ít như vậy? Mỗi quỹ đạo cần một robot thật làm một tác vụ thật, thường do con người điều khiển từ xa, chậm và tốn kém.
Khoảng trống này cũng là lý do AI vật lý tổng quát hóa chậm hơn AI số. Mô hình xử lý biến thiên tốt nhất khi nó đã thấy thứ tương tự trước đó, và một triệu quỹ đạo bao phủ ít căn bếp, thiết lập ánh sáng, và hình dạng vật thể hơn rất nhiều so với số câu văn được bao phủ bởi hàng nghìn tỷ token.
Tôi khuyên bạn giữ vấn đề dữ liệu này trong đầu cho phần còn lại của bài. Nhiều quyết định thiết kế bạn sẽ thấy bên dưới, từ mô phỏng đến ngẫu nhiên hóa miền đến tận dụng backbone thị giác-ngôn ngữ tiền huấn luyện, đều là cách lách vấn đề này.
Embodied AI vận hành bằng cách chạy liên tục vòng lặp 3 giai đoạn:
Vòng lặp này lặp lại nhiều lần mỗi giây, và mỗi chuyển động sẽ thay đổi những gì robot cảm nhận tiếp theo, nên đầu ra của một chu kỳ trở thành đầu vào cho chu kỳ kế tiếp.
Cùng vòng lặp này đứng sau các world model. Bài báo “World Models” năm 2018 của Ha và Schmidhuber tách một tác tử thành mô-đun thị giác, mô-đun bộ nhớ, và bộ điều khiển, và thử nghiệm trên một chiếc xe trong trò chơi đua xe. Embodied AI áp dụng cùng ý tưởng cho một robot hoàn chỉnh.
Một cách hay để hiểu vòng lặp là tưởng tượng bắt bóng:
Một robot làm điều tương tự, chỉ khác là dùng camera thay cho mắt và động cơ thay cho cơ bắp.
Hãy lần lượt xét từng giai đoạn.
Cảm nhận là giai đoạn biến các số đo cảm biến thô thành thứ mà phần còn lại của hệ thống có thể lý luận. Một camera đơn lẻ hiếm khi đủ, nên đa số robot kết hợp nhiều cảm biến:
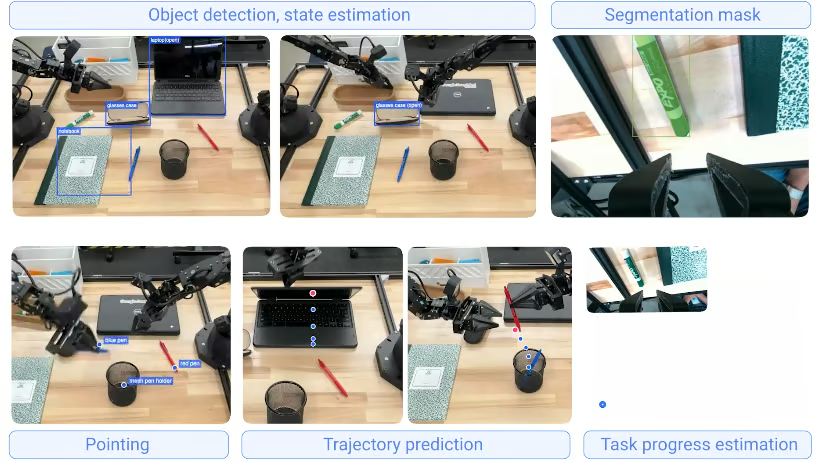
Ví dụ về đầu ra cảm nhận từ Gemini Robotics-ER 1.5. Ảnh nguồn: Google DeepMind
Các mô hình cảm nhận sau đó biến đổi các số đo này thành bản đồ không gian, danh tính đối tượng, vị trí chướng ngại vật, và hiểu biết tổng quát về cảnh.
Phần lớn là thị giác máy tính tiêu chuẩn, như phát hiện đối tượng, phân đoạn, và ước lượng độ sâu, thường xây trên vision transformer tiền huấn luyện như DINOv2 hay SigLIP.
Theo tôi, xúc giác đang bị đánh giá thấp nhất trong cảm nhận hiện nay. Camera có thể cho bạn biết có một chiếc ly trên bàn, nhưng xúc giác cho bạn biết chiếc ly bắt đầu trượt khỏi tay bạn.
Để minh họa hiện trạng, XELA Robotics đã trình diễn một đầu ngón tay robot tại Automate 2026 với 30 điểm đo lực ba trục được nhét vào phần đệm. Công ty cũng cho biết cảm biến uSkin của họ có thể phát hiện lực nhỏ tới 0,1 gram-force.
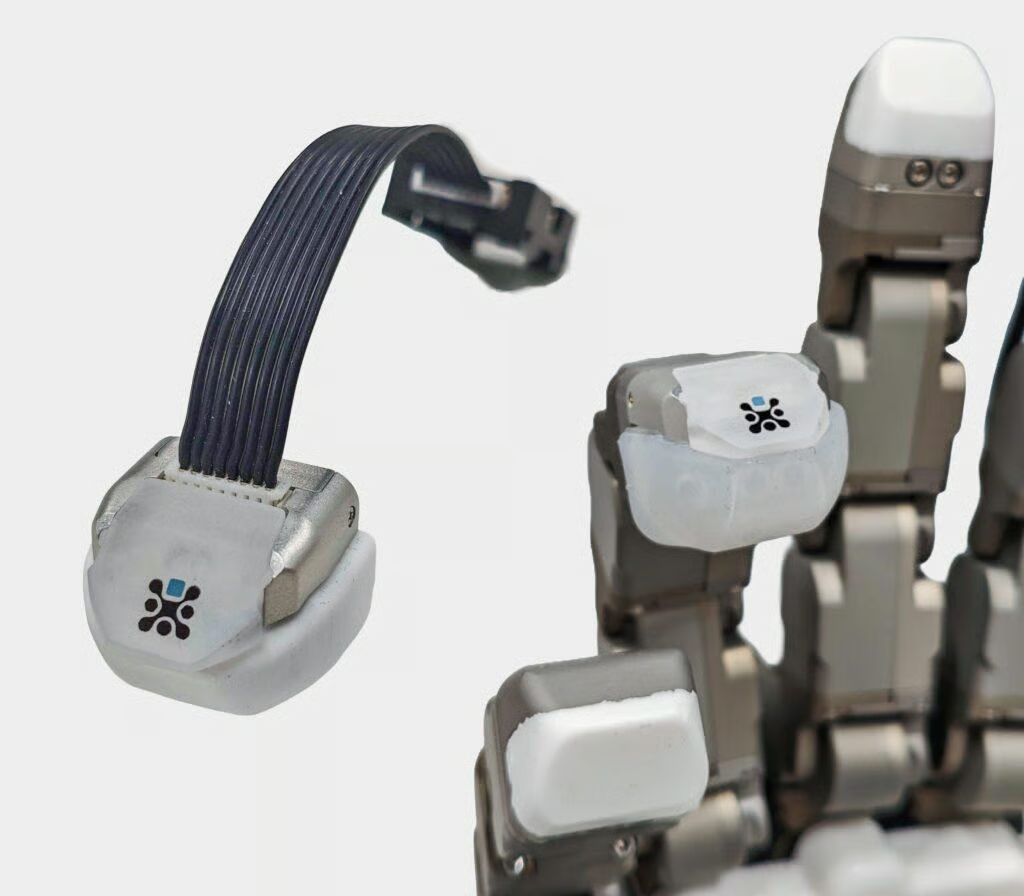
Một đầu ngón tay robot uSkin chứa mảng điểm cảm biến xúc giác ba trục. Ảnh nguồn: XELA Robotics
Lý luận là giai đoạn quyết định làm gì tiếp theo. Ở các hệ mới hơn, nó thường có 2 lớp:
World model cho phép robot tưởng tượng trước khi hành động.
DreamerV3 là ví dụ điển hình. Nó học một mô hình gọn của môi trường rồi huấn luyện chính sách gần như hoàn toàn bên trong thế giới tưởng tượng đó.
Tôi dùng DreamerV3 trong nghiên cứu của mình, và điều khiến tôi ngạc nhiên nhất là tác tử dành nhiều thời gian “luyện tập trong đầu” hơn trong môi trường thật đến mức nào. Điều đó quan trọng vì huấn luyện nhanh hơn và rẻ hơn nhiều.
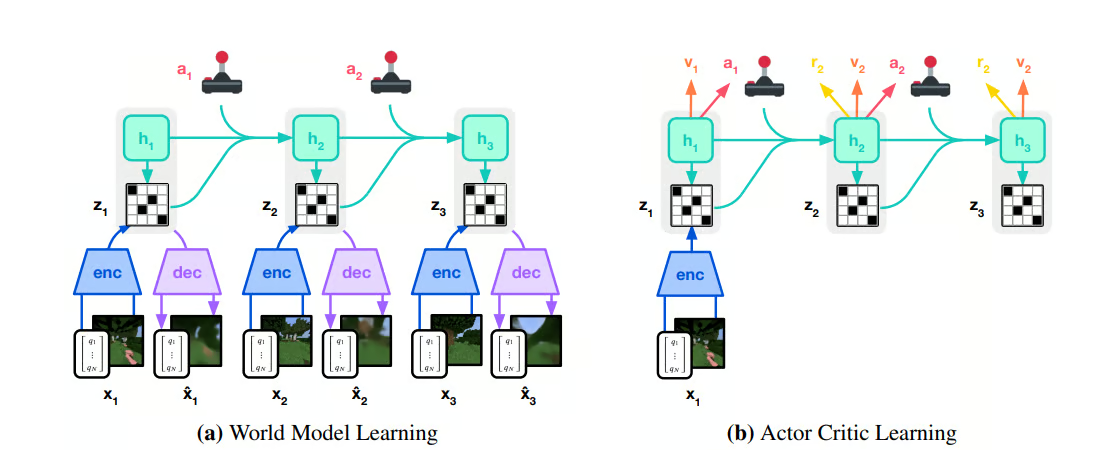
DreamerV3 huấn luyện chính sách trên các rollout tưởng tượng từ world model. Ảnh nguồn: Hafner et al., 2023
Mặt khác, lập kế hoạch ngày càng do các mô hình ngôn ngữ đảm nhiệm.
Ví dụ hay là Gemini Robotics-ER 1.5 của Google DeepMind, hoạt động như một bộ lập kế hoạch cấp cao. Với tác vụ như phân loại rác theo quy định tái chế địa phương, nó có thể tra cứu quy định bằng Google Search, chia công việc thành các bước, rồi giao từng bước cho mô hình VLA Gemini Robotics 1.5 thực hiện phần thể chất.
Bạn có thể xem mô hình ngôn ngữ là người quản lý và mô hình VLA là người công nhân thực sự làm việc.
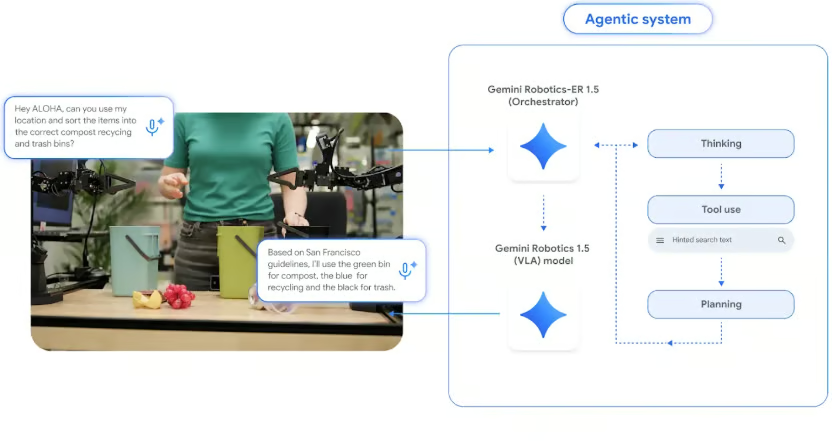
Gemini Robotics-ER 1.5 lập kế hoạch và giao việc thực thi thể chất cho Gemini Robotics 1.5 VLA. Ảnh nguồn: Google DeepMind, 2025
Hành động là giai đoạn chuyển một quyết định thành các lệnh chính xác cho mọi khớp và động cơ, thường hàng chục đến hàng trăm lần mỗi giây (đo bằng hertz, hay Hz). Phần cấp thấp của giai đoạn này gọi là điều khiển.
Ví dụ, một lệnh như “Di chuyển kẹp 5 cm sang trái” nghe có vẻ đơn giản, nhưng trên một cánh tay 7 khớp, nó phải trở thành mô-men xoắn cụ thể cho từng động cơ khớp, được tính lại liên tục khi cánh tay di chuyển.
Điểm khó là thực tế hiếm khi khớp với điều robot kỳ vọng. Vật thể trượt, sàn hơi không phẳng, ánh sáng đổi khi ai đó kéo rèm, và một sợi cáp uốn cong khác dự đoán.
Một bộ điều khiển tốt nhận ra chênh lệch giữa kỳ vọng và thực tế, rồi hiệu chỉnh ngay lập tức.
Theo tôi, hành động là giai đoạn khó nhất để làm đúng trong môi trường bừa bộn, không cấu trúc. Lỗi cảm nhận có thể sửa bằng cách nhìn lại và lỗi lập kế hoạch có thể sửa bằng tái lập kế hoạch, nhưng lỗi điều khiển xảy ra theo thời gian thực.
Embodied AI được huấn luyện bằng kết hợp giữa mô phỏng và dữ liệu thế giới thực. Mô phỏng nghĩa là các môi trường ảo chứa đối tượng 3D với vật lý chính xác, nơi robot có thể luyện hàng triệu lần trước khi chạm vào phần cứng thực.
Nhớ vấn đề dữ liệu ở trên chứ? Mô phỏng là một trong những cách lách chính, đặc biệt cho RL về di chuyển và thao tác. Các mô hình nền tảng như π₀ vẫn dựa nhiều vào các bản demo thực, nên đa số nhóm dùng cả hai.
Thu thập dữ liệu ngoài đời có 3 vấn đề lớn:
Một trình mô phỏng giải quyết cả 3 cùng lúc. Bạn có thể chạy hàng nghìn robot ảo song song trên một GPU và để chúng thất bại rồi khởi động lại tùy ý. Điều này nén kinh nghiệm nhiều năm của robot vào vài giờ.
Không phải trình mô phỏng nào cũng hữu ích như nhau để huấn luyện robot. Từ trải nghiệm làm việc với cánh tay robot trong mô phỏng, tôi cho rằng một trình tốt cần 3 yếu tố:
Hai nền tảng bạn sẽ thường gặp nhất là NVIDIA Isaac Sim (kèm Isaac Lab) và MuJoCo:
| Nền tảng | Đơn vị phát triển | Điểm mạnh | Phù hợp nhất cho |
|---|---|---|---|
| NVIDIA Isaac Sim và Isaac Lab | NVIDIA | Kết xuất như thật, mô phỏng cảm biến, hàng nghìn môi trường song song trên GPU | Chạy RL quy mô lớn và dữ liệu camera tổng hợp |
| MuJoCo | Google DeepMind (mã nguồn mở) | Vật lý tiếp xúc nhanh, chính xác, gọn nhẹ, cộng đồng nghiên cứu lớn | Nghiên cứu, benchmark di chuyển và thao tác |
Bổ sung mới nhất là Newton, một engine vật lý mã nguồn mở, tăng tốc bằng GPU do NVIDIA, Google DeepMind và Disney Research xây dựng và quản lý qua Linux Foundation.
Newton 1.0 được ra mắt tại NVIDIA GTC tháng 3/2026. Nó cắm vào Isaac Lab như backend vật lý, dùng MuJoCo Warp như một trong các bộ giải, và có thêm bộ giải cho vật thể biến dạng như cáp và vải.
Đối tượng biến dạng quan trọng hơn bạn tưởng. Trình mô phỏng cũ xử lý cáp và vải tệ, trong khi nhà máy cần robot có thể xử lý cả hai.
Sim-to-real gap là mức tụt hiệu năng xảy ra khi chuyển một chính sách được huấn luyện trong mô phỏng sang robot thật, và đây là một trong những vấn đề lớn nhất của hệ embodied.
Ví dụ, ma sát mô phỏng không bao giờ thật chuẩn, camera mô phỏng quá sạch, và vật thể mô phỏng quá hoàn hảo, nên một chính sách đạt 95% thành công trong mô phỏng có thể hỏng ngay khi gặp phần cứng thực.
Có 2 cách chính để thu hẹp khoảng cách này:
Thay vì cố làm trình mô phỏng hoàn hảo, các nhóm ngẫu nhiên hóa nó theo nhiều cách.
Tobin et al. (2017) ngẫu nhiên hóa mạnh kết cấu và ánh sáng đến mức thế giới thực trông như một biến thể nữa đối với mô hình. Tay robot giải Rubik của OpenAI Rubik’s Cube còn tiến xa hơn khi tự động mở rộng phạm vi ngẫu nhiên hóa khi chính sách tốt dần.
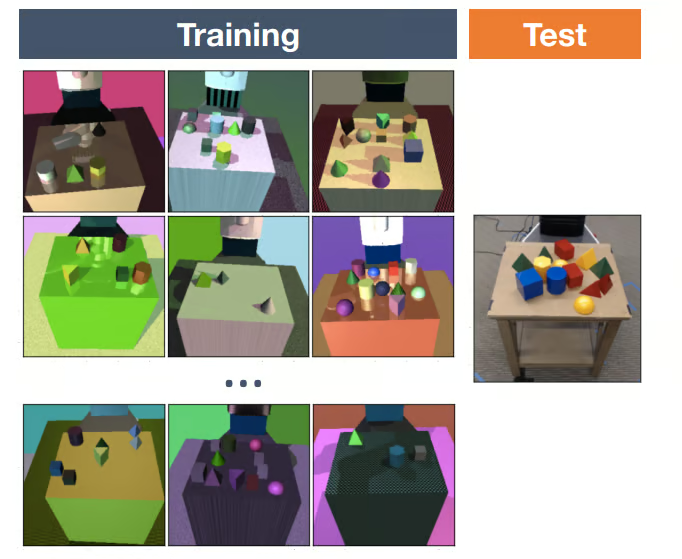
Một chính sách tiền huấn luyện trong mô phỏng thường chỉ cần một tập nhỏ bản demo thực để thích nghi, vì nó đã học được hình hài tổng quát của tác vụ.
Không kỹ thuật nào loại bỏ hoàn toàn khoảng cách, nên các nhóm tiếp tục giảm tác động của nó đến hiệu năng ngoài đời.
Embodied AI hiện hoạt động ngoài phòng thí nghiệm trong vài ngành, dù không đồng đều.
Mẫu hình tôi thấy là nó đáp xuống trước ở nơi môi trường thay đổi quá nhiều để viết kịch bản thủ công, nhưng con người vẫn có thể can thiệp nếu có sự cố.
Xe tự lái là một trong những dạng embodied AI ngốn dữ liệu nhất.
Waymo Driver đã chạy gần 200 triệu dặm hoàn toàn tự hành, và cũng huấn luyện và kiểm thử trên hàng tỷ dặm trong mô phỏng, theo bài đăng tháng 2/2026 của Waymo về World Model. Mô phỏng cho phép Waymo phát lại sự cố thực và tạo các tình huống hiếm (ví dụ, một đứa trẻ chạy ra giữa hai xe đậu) mà đội xe thử nghiệm có thể chẳng bao giờ gặp trên đường.
Xe tự lái cũng là ví dụ tốt cho vòng lặp cảm nhận–lý luận–hành động chạy hết tốc lực. Một xe Waymo cảm nhận bằng camera, lidar và radar, lý luận về khả năng hành động tiếp theo của mỗi người đi bộ và phương tiện, rồi hành động bằng điều khiển lái và phanh nhiều lần mỗi giây.
Theo tôi, kho hàng là ứng dụng thương mại tự nhiên nhất của embodied AI hiện nay.
Sự chuyển dịch là từ robot đi theo đường cố định trên sàn sang hệ thống có thể xử lý hàng hóa lộn xộn, động, như nhặt từ một thùng chứa 40 sản phẩm khác nhau trộn lẫn.
Humanoid Digit của Agility Robotics đã di chuyển thùng tại GXO Logistics theo một thỏa thuận nhiều năm ký năm 2024, và robot Stretch của Boston Dynamics dỡ hộp khỏi xe tải.
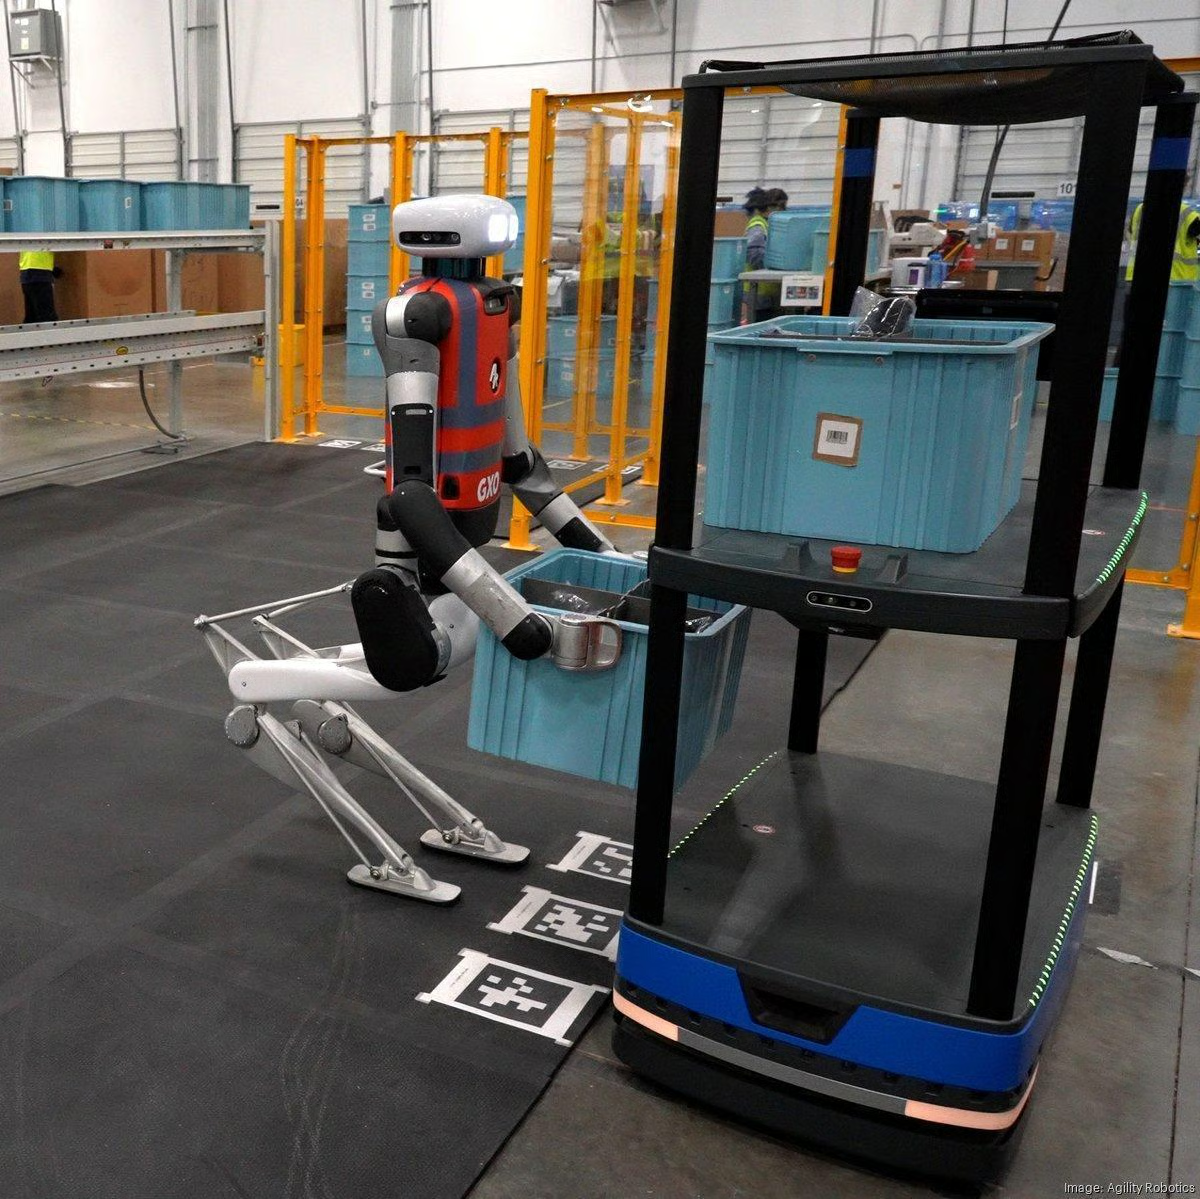
Digit của Agility Robotics di chuyển thùng giữa robot di động tự hành và băng tải tại kho GXO. Ảnh nguồn: Agility Robotics/The Robot Report
Y tế là nơi tôi kỳ vọng embodied AI tiến từng bước thận trọng nhất.
Hệ thống phẫu thuật như da Vinci của Intuitive đã dùng rộng rãi trong bệnh viện, nhưng bác sĩ phẫu thuật điều khiển chúng, và hầu hết nghiên cứu AI ở đây tập trung vào hỗ trợ, như theo dõi dụng cụ, điều khiển camera, và hỗ trợ khâu.
Trong y tế, phê duyệt quản lý thường là ràng buộc lớn hơn năng lực mô hình, và như vậy là đúng. Cá nhân tôi kỳ vọng ứng dụng hỗ trợ và đào tạo sẽ đến sớm hơn nhiều so với bất cứ điều gì gần với phẫu thuật tự động.
Humanoid được chú ý nhiều nhất và cũng là một trong những mảng ít được kiểm chứng nhất.
Tại CES 2026, Boston Dynamics ra mắt phiên bản sản xuất của Atlas và cho biết mọi đơn vị họ chế tạo trong 2026 đã được dành cho Hyundai và Google DeepMind. Trong khi đó, Figure chạy một triển khai 11 tháng với humanoid Figure 02 tại nhà máy BMW ở Spartanburg, Nam Carolina, bốc xếp tấm kim loại.
Tuy vậy, tôi muốn nói thẳng: đa số triển khai humanoid vẫn là thí điểm làm một bộ tác vụ hẹp. Ví dụ, Hyundai dự định bắt đầu dùng Atlas cho sắp xếp linh kiện vào năm 2028, cho thấy ngay cả các nhà hậu thuẫn lớn nhất cũng tiến rất thận trọng.
Giờ hãy nói về những ai thực sự xây dựng tất cả điều này. Dưới đây là 5 tổ chức mà tôi nghĩ bất kỳ người mới nào với embodied AI cũng nên nhận ra:
| Tổ chức | Họ xây dựng gì | Vì sao quan trọng |
|---|---|---|
| NVIDIA | Isaac Sim, Isaac Lab, Newton, GR00T và Cosmos | Ngăn xếp mô phỏng và tính toán mà đa số nhóm huấn luyện dựa vào |
| Physical Intelligence | Dòng mô hình nền tảng robot π₀ | Chính sách robot đa dụng với checkpoint mở |
| Agility Robotics | Humanoid Digit | Thiết kế cho logistics kho và đã làm việc với khách hàng |
| Boston Dynamics | Atlas, Stretch và Spot | Đưa Atlas từ bản demo nghiên cứu sang sản phẩm sản xuất trong 2026 |
| AMI Labs (Yann LeCun) | World model kiểu JEPA | Một cược đi ngược xu hướng vào world model không sinh ảnh pixel |
NVIDIA chủ yếu xây công cụ xung quanh robot chứ không phải bản thân robot.
Isaac Sim xử lý mô phỏng như thật, Isaac Lab xử lý RL phía trên, và Newton giờ có thể cung cấp vật lý. Nhiều nhóm robot huấn luyện trên phần mềm NVIDIA dù NVIDIA không bán robot đa dụng.
Physical Intelligence xây dựng π₀, một mô hình thị giác-ngôn ngữ-hành động 3,3 tỷ tham số dùng flow matching để tạo ra các đoạn hành động mượt cho các tác vụ như gấp quần áo.
Đây là ví dụ tốt nhất tôi biết về một mô hình robot đa dụng mà bạn có thể thực sự tải về, qua kho openpi.
Nếu khái niệm “mô hình nền tảng” còn mới với bạn, hướng dẫn Giới thiệu về Foundation Models của chúng tôi giải thích rất rõ.
Agility Robotics chọn lối hẹp với Digit.
Nó được thiết kế từ đầu để di chuyển thùng trong kho, và sự tập trung hẹp đó là lý do lớn giúp nó tiếp cận khách hàng trả tiền sớm hơn hầu hết humanoid khác.
Boston Dynamics chọn lối ngược lại với Atlas.
Họ dành nhiều năm đẩy giới hạn vận động của robot (có lẽ bạn đã xem các video parkour) trước khi biến nó thành sản phẩm điện hoàn toàn trong nhà máy mà Google DeepMind dự định vận hành bằng các mô hình Gemini Robotics.
AMI Labs là startup đặt tại Paris của Yann LeCun, huy động vòng seed 1,03 tỷ USD vào tháng 3/2026 với định giá pre-money 3,5 tỷ USD. Vòng này đồng dẫn bởi Cathay Innovation, Greycroft, Hiro Capital, HV Capital và Bezos Expeditions, với NVIDIA và Samsung trong số các nhà đầu tư khác.
LeCun lập luận nhiều năm rằng dự đoán mọi pixel của tương lai là lãng phí, nên Joint Embedding Predictive Architecture (JEPA) của ông đưa dự đoán vào không gian biểu diễn trừu tượng, một ý tưởng Meta đã thử với V-JEPA 2.
Điều khiến AMI đáng theo dõi là họ đi ngược hướng phần lớn lĩnh vực đang tiến. Tuy nhiên, họ chưa phát hành gì, nên tôi sẽ xem đây là một khoản cược nghiên cứu được hậu thuẫn tiền lớn hơn là một hướng tiếp cận đã được chứng minh vào lúc này.
Embodied AI không chỉ là bài toán kỹ thuật robot. Nhiều việc, và theo tôi là phần lớn, là công việc machine learning.
Các kỹ năng chuyển giao trực tiếp nhất gồm:
Bạn không cần robot để bắt đầu. Thư viện gymnasium đi kèm môi trường MuJoCo, nên sau khi chạy pip install "gymnasium[mujoco]" bạn có thể chạy cả vòng lặp trên một robot mô phỏng:
import gymnasium as gym

# HalfCheetah is a 2D cheetah-like robot simulated with the MuJoCo physics engine
env = gym.make("HalfCheetah-v5")
observation, info = env.reset(seed=42)

for step in range(1000):
    # Perception: the observation holds joint angles and velocities
    # Reasoning: a trained policy would choose the action here, we pick randomly
    action = env.action_space.sample()

    # Action: apply torques to the joints and move the physics forward one step
    observation, reward, terminated, truncated, info = env.step(action)

    if terminated or truncated:
        observation, info = env.reset()

env.close()
Hiện tại, con báo chỉ quẫy đạp vì bước “lý luận” là env.action_space.sample(), chọn ngẫu nhiên một hành động mỗi lần.
Thay một dòng đó bằng một chính sách đã huấn luyện chính là việc RL đảm nhiệm, và tôi khuyên bạn nên thử trước khi chuyển sang thứ lớn hơn.
Embodied AI tiến nhanh, nhưng vẫn gặp khó ở 4 điểm, và tôi nghĩ đáng để biết:
Embodied AI trao cho máy móc một cơ thể vật lý và trí thông minh để sử dụng nó. Nó vận hành qua vòng lặp cảm nhận–lý luận–hành động, bị kìm hãm chủ yếu bởi sự khan hiếm dữ liệu vật lý, và đến năm 2026 đang rời phòng thí nghiệm để bước vào kho hàng và những thí điểm nhà máy đầu tiên.
Điều làm tôi bất ngờ là câu hỏi đã đổi hướng. Vài năm trước, người ta hỏi liệu LLM có khiến nghiên cứu robot trở nên vô nghĩa không. Thay vào đó, LLM đang trở thành lớp lý luận bên trong hệ embodied, và hai lĩnh vực đang hòa nhập vào nhau.
Nhớ quả táo ở đầu bài chứ? Biết cách nhấc nó và thực sự nhấc nó hóa ra là hai vấn đề rất khác nhau, và embodied AI là lĩnh vực làm việc với vấn đề thứ hai.
Nếu bạn muốn xây nền tảng ML cho mảng này, hãy bắt đầu với lộ trình Reinforcement Learning bằng Python của chúng tôi. Với phần ngôn ngữ trong ngăn xếp, khóa Khái niệm về Mô hình Ngôn ngữ Lớn (LLMs) và lộ trình Phát triển Mô hình Ngôn ngữ Lớn là các bước tiếp theo phù hợp.
Các khóa học hàng đầu của DataCamp
Khóa học
Khóa học
Lộ trình
blog
Matt Crabtree
10 phút
