Kurs
Google Gemini ve NotebookLM ile Pratik AI
2 sa
9.8K
Gemma 4, Google DeepMind’in hem yerel kurulum hem de araştırma için tasarlanmış, açık ağırlıklı model ailesidir. Talimat izleme becerileri geliştirilmiş, daha uzun bağlam pencereleri ve yerleşik çok kipli girdi işleme ile Gemma soyağacını geliştirir ve Gemini 3 ile aynı araştırma altyapısından yararlanır.
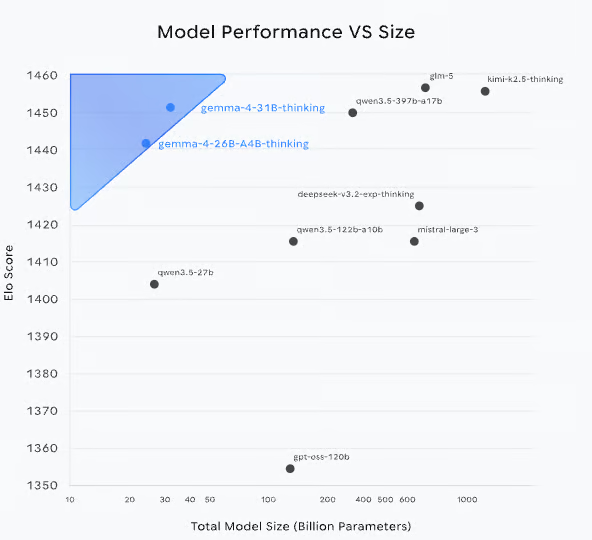
Şekil: Model performansı vs Boyut (kaynak: Gemma 4 blogu)
Gemma-4-26B(MOE) ve Gemma-4-31B gibi modeller, çok daha büyük modellere benzer Elo puanları elde ederek parametre başına güçlü performans sergiliyor. 31B modeli şu anda Arena AI metin sıralamasında dünyadaki 3. açık model, 26B modeli ise 6. sırada yer alıyor. Bu da Gemma 4’ü, yetenekten ödün vermeden yerel ve kaynak kısıtlı kurulumlar için özellikle uygun kılıyor.
Gemma 4, Etkili 2B (E2B), Etkili 4B (E4B), 26B Uzman Karışımı (MoE) ve 31B Yoğun modeller dahil olmak üzere dört esnek boyutta sunuluyor. Aile, dağıtım hedefine göre iki ayrı katmana ayrılıyor:
|
Model |
Mimari |
Toplam Parametre |
Aktif/Etkili Parametre |
Bağlam Uzunluğu |
Modaliteler |
|
Gemma-4-31B |
Yoğun Dönüştürücü |
31B |
31B |
256K belirteç |
Metin, Görüş, Video |
|
Gemma-4-26B-A4B |
MoE (128 Uzman) |
26B |
3.8B aktif |
256K belirteç |
Metin, Görüş, Video |
|
Gemma-4-E4B |
Yoğun Dönüştürücü |
7.9B (gömme katmanlarıyla) |
4.5B etkili |
128K belirteç |
Metin, Ses, Görüş, Video |
|
Gemma-4-E2B |
Yoğun Dönüştürücü |
5.1B (gömme katmanlarıyla) |
2.3B etkili |
128K belirteç |
Metin, Ses, Görüş, Video |
Her bir varyanta daha derin bakalım:
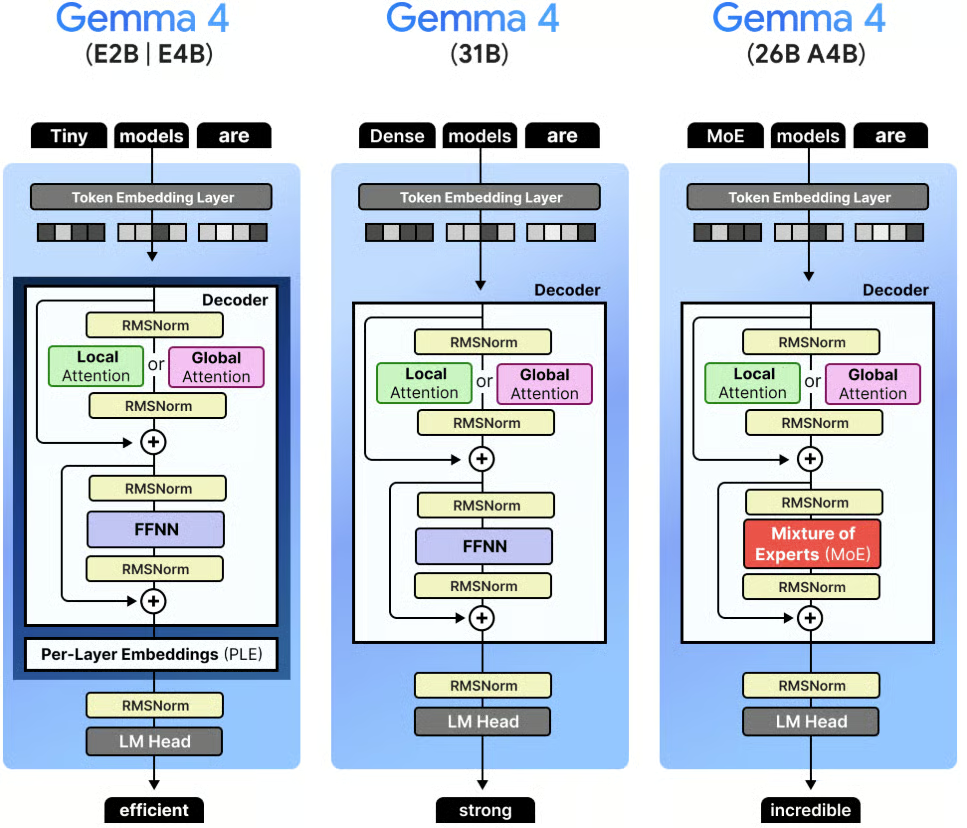
Şekil: Gemma 4’e Görsel Kılavuz (kaynak)
Dört modelin tümü Apache 2.0 lisansı altında kullanılabilir ve Ollama, vLLM, llama.cpp veya Unsloth üzerinden yerelde dağıtılabilir.
Kodlama görevleri için Gemma 4 şunlarda başarılıdır:
Bu eğitimde, tüketici donanımında yerel çıkarım için uygun, niceleme uygulanmış bir sürüm olan gemma4:e4b (9.6GB) varyantını Ollama üzerinden kullanıyoruz.
Ollama, model indirme, niceleme, sunum işlemlerini yönetir ve OpenAI ile uyumlu bir HTTP API sağlar. Bu eğitimde Ollama, çıkarım arka ucu olarak görev yapıyor ve uygulamamız onunla localhost:11434 üzerinden iletişim kuruyor.
Modeli çekmek ve çalıştırmak için:
curl -fsSL https://ollama.com/install.sh | sh
ollama pull gemma4:e4b
ollama serve
Yukarıdaki komutlar, Ollama’yı resmi kurulum betiğini kullanarak yerelde kurar. Ardından, cihaz üzerinde çıkarım için gemma 4:e4b model varyantını yerelde indiriyoruz. Son olarak ollama serve, Ollama sunucusunu başlatır ve uygulamamızın modele istek göndermesini sağlar.
Sunucu çalışmaya başladığında, Gradio uygulaması ona otomatik olarak bağlanır.
Bu bölümde, kod asistanını adım adım oluşturacağız. Yüksek düzeyde, uygulama şunları yapar:
Sohbet panelinde doğal dilli bir mesajı, isteğe bağlı görsel veya dosya ekleriyle kabul eder
Mevcut düzenleyici kodunu model için bağlam olarak enjekte eder
Ollama’nın /api/chat uç noktası üzerinden Gemma 4’e akışlı bir istek gönderir
İsteğe bağlı olarak aracısal döngüde araçları (kod çalıştırma, matematik değerlendirme) çağırır
Yanıttan çıkarılan kod bloklarını canlı düzenleyiciye aktarır
Hadi adım adım oluşturalım.
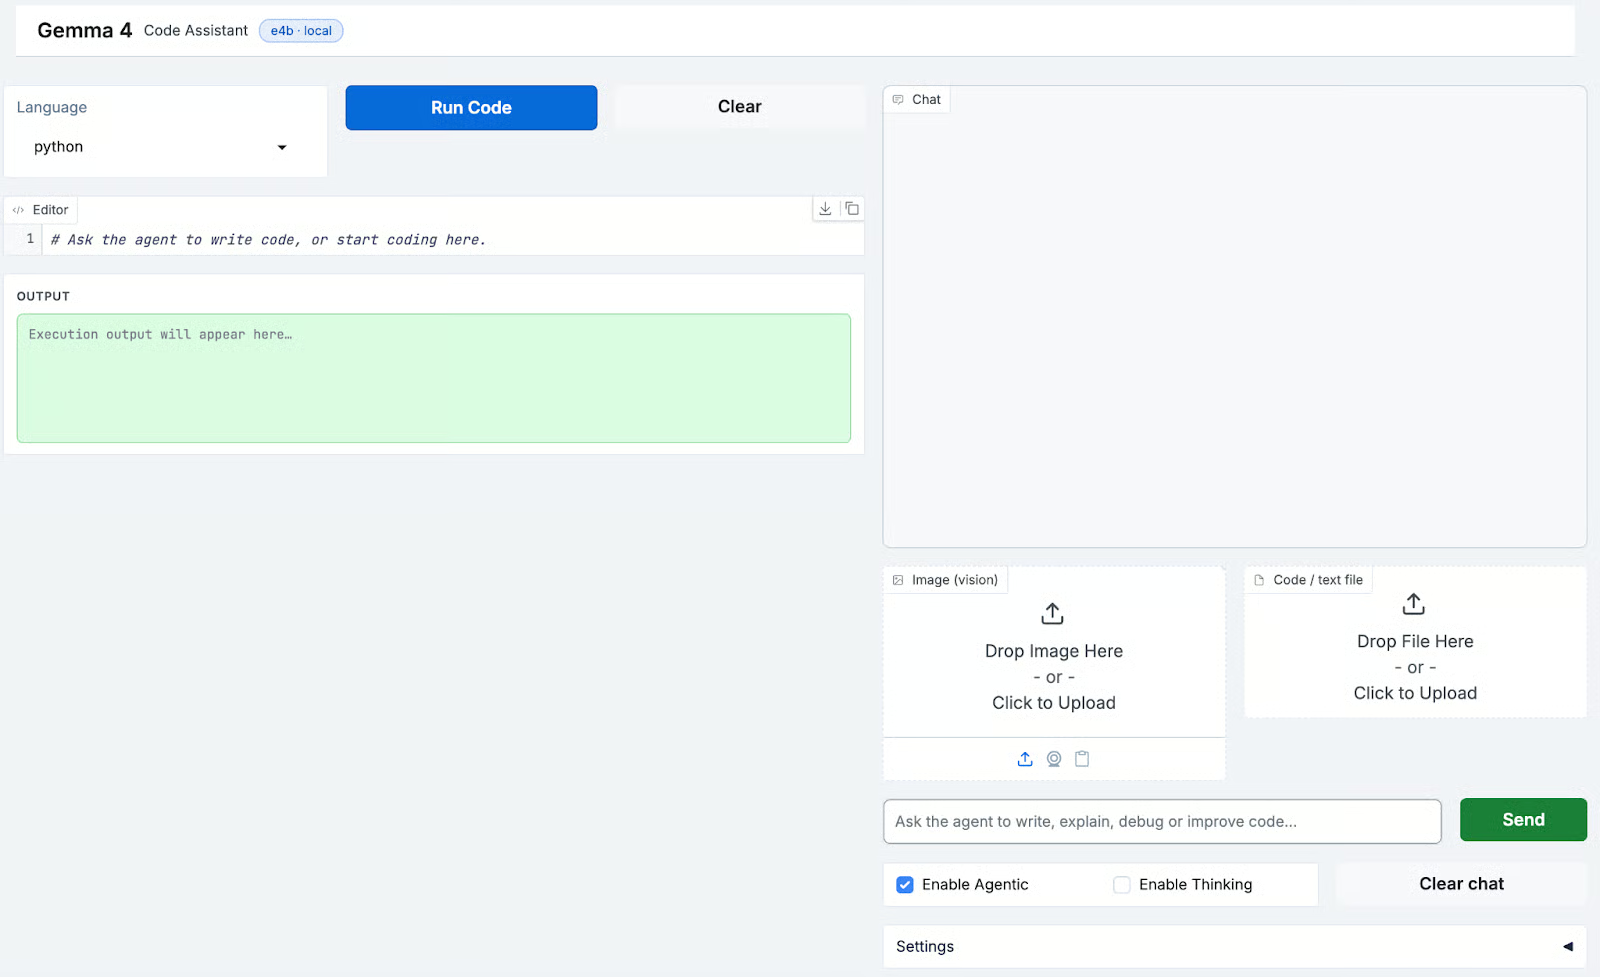
Uygulama, UI, görsel işleme ve HTTP iletişimi için küçük bir kitaplık seti gerektirir. Model Ollama üzerinden yerelde çalıştığından, bulut SDK bağımlılığı yoktur.
pip install gradio requests pillowBu projede şunları kullanacağız:
gradio: bölünmüş pencere düzenleyici ve sohbet arayüzü için
requests: Ollama HTTP API ile iletişim kurmak için
pillow: UI’da görsel işleme desteği için
Bu, ortamı hafif tutar ve Apple Silicon’lı macOS, Linux ve WSL üzerinden Windows dahil Ollama çalıştıran her makinede çalışır.
Herhangi bir mantık yazmadan önce, içe aktarımları, model adını, Ollama temel URL’sini, desteklenen dilleri ve varsayılan sistem istemini tanımlarız. Bu sabitler, uygulamanın tüm davranışını kontrol eder.
import base64
import json
import math
import os
import re
import subprocess
import tempfile
from pathlib import Path
import gradio as gr
import requests

OLLAMA_BASE = "http://localhost:11434"
MODEL       = "gemma4:e4b"
LANGUAGES = [
    "python", "javascript", "typescript", "bash", "sql",
    "rust", "go", "java", "c", "cpp", "html", "css",
    "json", "yaml", "markdown", "plaintext",
]
TEXT_EXTS = {
    ".py", ".js", ".ts", ".jsx", ".tsx", ".html", ".css",
    ".json", ".yaml", ".yml", ".toml", ".md", ".txt",
    ".csv", ".sql", ".sh", ".bash", ".rs", ".go",
    ".java", ".c", ".cpp", ".h", ".hpp", ".rb", ".php",
}
IMAGE_EXTS = {".jpg", ".jpeg", ".png", ".webp", ".gif", ".bmp"}
DEFAULT_SYSTEM = """\
You are an expert coding assistant. When you write code:
- Always wrap it in a markdown code block with the language tag
- Write complete, working code — not fragments
- Briefly explain what the code does
You have a code-runner tool. Use it to validate logic when helpful.\
"""
TEXT_EXTS ve IMAGE_EXTS kümeleri iki farklı ek davranışını yönlendirir. Metin/kod dosyaları okunur ve bağlama istemine enjekte edilirken, görsel dosyaları base64 ile kodlanır ve Gemma 4’ün görsel yetenekleri için images alanına gönderilir.
DEFAULT_SYSTEM istemi, modelin kod üretim stilini şekillendirir; uygulama bu kod bloklarını düzenleyiciye itmek için ayrıştırdığından özellikle dil etiketli, tam kod blokları talep eder.
Asistan, çıkarım sırasında araçları çağırdığı aracısal bir modda çalışabilir. Ollama’nın desteklediği standart fonksiyon çağırma şemasında iki araç tanımlıyoruz:
TOOLS = [
    {
        "type": "function",
        "function": {
            "name": "run_code",
            "description": (
                "Execute Python code in a sandboxed subprocess and return "
                "stdout + stderr. Use this to validate, test, or demonstrate code."
            ),
            "parameters": {
                "type": "object",
                "properties": {
                    "code": {
                        "type": "string",
                        "description": "Python code to run (max ~50 lines, 5 s timeout).",
                    }
                },
                "required": ["code"],
            },
        },
    },
    {
        "type": "function",
        "function": {
            "name": "calculate",
            "description": "Evaluate a mathematical expression precisely.",
            "parameters": {
                "type": "object",
                "properties": {
                    "expression": {
                        "type": "string",
                        "description": "Python-compatible math expression, e.g. 'math.sqrt(2) * 100'",
                    }
                },
                "required": ["expression"],
            },
        },
    },
]
Yukarıdaki kod parçası, Python’u 5 saniyelik zaman aşımıyla bir alt süreçte geçici bir dosyada çalıştıran ve hem stdout hem de stderr’i yakalayan run_code aracını tanımlar. Bu sayede model, yalnızca statik metin üretmek yerine mantığı doğrulayabilir, örnekler çalıştırabilir veya canlı çıktı üretebilir.
Buna karşılık calculate aracı, yalnızca math modülü ve güvenli yerleşikler kullanılarak kısıtlı bir ad alanında matematiksel ifadeleri değerlendirir. Modelin kesin sayısal sonuçlara ihtiyaç duyduğu durumları, tam bir Python süreci başlatmadan ele alır.
Yürütme katmanı, araç adlarını uygulamalarına eşler. Bu, model bir tool_calls bloğu döndürdüğünde aracısal döngü sırasında çağrılır.
def _run_python(code: str) -> str:
    with tempfile.NamedTemporaryFile(mode="w", suffix=".py", delete=False) as f:
        f.write(code)
        tmp = f.name
    try:
        r = subprocess.run(
            ["python3", tmp],
            capture_output=True, text=True, timeout=5,
        )
        out = (r.stdout + r.stderr).strip()
        return out[:3000] if out else "(no output)"
    except subprocess.TimeoutExpired:
        return "⏱ Timed out (>5 s)"
    except Exception as e:
        return f"Error: {e}"
    finally:
        os.unlink(tmp)

def _calculate(expr: str) -> str:
    ns = {k: getattr(math, k) for k in dir(math) if not k.startswith("_")}
    ns.update({"abs": abs, "round": round})
    try:
        return str(eval(expr, {"__builtins__": {}}, ns))  # noqa: S307
    except Exception as e:
        return f"Error: {e}"

def execute_tool(name: str, args: dict) -> str:
    if name == "run_code":
        return _run_python(args.get("code", ""))
    if name == "calculate":
        return _calculate(args.get("expression", ""))
    return f"Unknown tool: {name}"
Araç yürütme yığınının dikkat edilmeye değer birkaç güvenlik tasarım tercihi şunlardır:
_run_python() işlevi, geçici bir dosyaya yazar ve temizler; hata durumunda bile artık dosya kalmasını önler
Çıktı, bağlamın devasa çıktı yığınlarıyla taşmasını önlemek için 3.000 karakterle sınırlandırılır
_calculate() işlevi, __builtins__ boş bir sözlüğe ayarlanarak eval() kullanır; böylece açıkça izin verilen math işlevleri dışında Python yerleşiklerine erişim engellenir
Zaman aşımı, çoğu doğrulama görevi için yeterli, kaçak süreçleri önlemek için yeterince kısa olan katı bir 5 saniyelik penceredir
Çekirdek sohbet mantığını oluşturmadan önce, dosya yollarını, görsel kodlamayı ve kod çıkarımını yöneten birkaç yardımcı işlev gerekir. Bu yardımcılar, akış hattı boyunca çağrılır.
def encode_image(path: str) -> str | None:
    if not path:
        return None
    try:
        with open(path, "rb") as f:
            return base64.b64encode(f.read()).decode()
    except Exception:
        return None

def file_as_context(path: str) -> str | None:
    if not path:
        return None
    p = Path(path)
    if p.suffix.lower() not in TEXT_EXTS:
        return None
    try:
        content = p.read_text(encoding="utf-8", errors="replace")[:8000]
        lang = p.suffix.lstrip(".")
        return f"\n\n**Attached file — {p.name}:**\n```{lang}\n{content}\n```"
    except Exception:
        return None

def resolve_gradio_path(val) -> str | None:
    if val is None:
        return None
    if isinstance(val, Path):
        s = str(val)
        return s if s.strip() else None
    if isinstance(val, str):
        s = val.strip()
        return s if s else None
    if isinstance(val, dict):
        p = val.get("path")
        if isinstance(p, str) and p.strip():
            return p.strip()
        nested = val.get("file")
        if isinstance(nested, dict):
            np = nested.get("path")
            if isinstance(np, str) and np.strip():
                return np.strip()
        return None
    name = getattr(val, "name", None)
    if isinstance(name, str) and name.strip():
        return name.strip()
    return None

def is_image_path(path: str | None) -> bool:
    return bool(path) and Path(path).suffix.lower() in IMAGE_EXTS

def extract_last_code_block(text: str) -> tuple[str | None, str]:
    blocks = re.findall(r"```(\w*)\n(.*?)```", text, re.DOTALL)
    if blocks:
        lang, code = blocks[-1]
        return code.strip(), lang.strip() or "python"
    return None, "python"

def ollama_ok() -> bool:
    try:
        requests.get(f"{OLLAMA_BASE}/", timeout=2)
        return True
    except Exception:
        return False

def _gradio_content_to_text(content) -> str:
    if content is None:
        return ""
    if isinstance(content, str):
        return content
    if isinstance(content, list):
        parts: list[str] = []
        for block in content:
            if isinstance(block, dict):
                if block.get("type") == "text":
                    parts.append(str(block.get("text", "")))
                elif "text" in block:
                    parts.append(str(block["text"]))
            elif isinstance(block, str):
                parts.append(block)
        return "".join(parts)
    return str(content)

def _append_chat_turn(
    history: list | None, user_text: str, assistant_text: str
) -> list:
    base = list(history) if history else []
    return base + [
        {"role": "user", "content": user_text},
        {"role": "assistant", "content": assistant_text},
    ]

def run_code_btn(code: str) -> str:
    if not code.strip():
        return "Nothing to run."
    result = _run_python(code)
    return result
Bu yardımcılar, çok kipli girdilerin ve yapılandırılmış çıktının sorunsuz işlenmesini sağlar:
encode_image() işlevi: Bu işlev, bir görsel dosyasını base64 dizgesine dönüştürerek Ollama’nın images alanına aktarılmasını sağlar. Bu, Gemma’nın çok kipli akıl yürütme için görselleri metinle birlikte işlemesine olanak tanır.
file_as_context() işlevi: Bu işlev, metin/kod dosyalarını okur ve bunları biçimlendirilmiş bir markdown bloğu olarak doğrudan isteme enjekte eder. Böylece ayrı bir getirme sistemine gerek kalmadan her şey bağlam olarak satır içi iletilir.
resolve_gradio_path() işlevi: Bu işlev, Gradio’nun döndürdüğü farklı dosya biçimlerini kullanılabilir bir dosya yoluna dönüştürür. Bu, dosya işleme sırasında uç durum hatalarını önler.
is_image_path() işlevi: Belirli bir dosyanın görsel olup olmadığını hızlıca kontrol eder. Bu, görsel girdilerini doğru şekilde yönlendirmeye yardımcı olur.
extract_last_code_block() işlevi: Ardından, modelin yanıtındaki son kod bloğunu çıkarırız.
ollama_ok() işlevi: İstek yapmadan önce yerel Ollama sunucusunun çalıştığını doğrularız.
_gradio_content_to_text() ve _append_chat_turn() işlevleri: Gradio’nun yapılandırılmış ileti biçimini tutarlı işleme için düz metne dönüştürür ve sohbet geçmişini koruruz.
run_code_btn() işlevi: Son olarak, kullanıcı UI’daki Run code düğmesine bastığında oluşturulan kodu bu işleve kullanarak çalıştırırız.
Artık yardımcılarımız hazır olduğuna göre, çekirdek chat() işlevini uygulayabiliriz.
Bu işlev, girdileri hazırlamadan yanıtları akışla almaya ve araç yürütmeyi ele almaya kadar tüm etkileşim döngüsünü sürükler.
chat() işlevi yüksek düzeyde şunları yapar:
def chat(
    message, history, image_path, file_path,
    editor_code, language, system_prompt,
    agentic, thinking, temperature,
):
İşlev aşağıdaki adım adım diziyi izler:
Önce önceki sohbet turlarını Ollama’nın ileti biçimine dönüştürürüz. Sistem istemi, modelin davranışını yönlendirmek için öne eklenir; böylece model, yanıt üretmeden önce tam konuşma bağlamına sahip olur.
for h in history or []:
        if not isinstance(h, dict):
            continue
        role = h.get("role")
        if role not in ("user", "assistant"):
            continue
        messages.append(
            {"role": role, "content": _gradio_content_to_text(h.get("content"))}
        )
content = messageSonra, ek bağlam enjekte ederek geçerli kullanıcı iletisini inşa ederiz. Kullanıcı kod üzerinde çalışıyorsa, düzenleyici içeriğini ekleriz:
if editor_code.strip() and editor_code.strip() != STARTER_CODE.strip():
    content += (
        f"\n\n**Current code in editor ({language}):**\n"
        f"```{language}\n{editor_code}\n```"
    )
Benzer şekilde, yüklenen dosyalar satır içi bağlam olarak eklenir ve görseller base64 ile kodlanıp images alanı üzerinden aktarılır. Bu, modelin metin, kod ve görseller üzerinde birlikte akıl yürütmesini sağlar.
Yük, model adını, ileti geçmişini, akış bayrağını ve seçenekleri aşağıdaki gibi içerir:
payload = {
    "model": MODEL,
    "messages": messages,
    "stream": True,
    "options": options,
}

if agentic:
    payload["tools"] = TOOLS
Düşünme modu etkinse, desteklenen modellerde gelişmiş düşünce zinciri akıl yürütmesini etkinleştiren options["think"] = True ayarlanır.
Aracısal mod etkinse, model metin yerine araç çağrıları döndürebilir. Bu gerçekleştiğinde her araç yürütülür, sonuçlar konuşmaya eklenir ve üretime devam etmek için bir takip isteği gönderilir.
if agentic and msg.get("tool_calls"):
    for tc in msg["tool_calls"]:
        fn_name = tc["function"]["name"]
        fn_args = tc["function"]["arguments"]
        result = execute_tool(fn_name, fn_args)
        if fn_name == "run_code" and fn_args.get("code"):
            new_code = fn_args["code"]
        messages.append(msg)
        messages.append({"role": "tool", "content": result})
    resp2 = requests.post(f"{OLLAMA_BASE}/api/chat", ...)
Bu, modelin bir aracı çağırdığı, sonucu gördüğü ve ardından nihai yanıtı üretmeye devam ettiği tek turluk bir aracısal döngü oluşturur. Araç çağrısı günlükleri kullanıcı için sohbete öne eklenir.
Son olarak, akış tamamlandığında yanıttan son kod bloğunu çıkarırız:
extracted, _ = extract_last_code_block(full_response)

if extracted:
    new_code = extracted
Özetle, model kod üretir, düzenleyici otomatik olarak güncellenir ve manuel kopyala-yapıştır gerekmez.
Çekirdek mantık hazır olduğuna göre, şimdi Gradio kullanarak kullanıcı arayüzünü tasarlıyoruz. Amaç, hem kodlama iş akışlarını hem de yapay zekâ destekli etkileşimi yan yana destekleyen bir düzen oluşturmaktır.
gr.Blocks kullanarak iki sütunlu bir düzen tanımlıyoruz:
with gr.Blocks(title="Gemma 4 · Code Assistant") as demo:
    with gr.Row(equal_height=False):
        # LEFT: Code Editor
        with gr.Column(scale=11):
            with gr.Row():
                lang_sel = gr.Dropdown(choices=LANGUAGES, value="python", label="Language")
                run_btn  = gr.Button("Run Code", elem_classes=["run-btn"])
                clear_ed = gr.Button("Clear")
            code_editor = gr.Code(
                value=STARTER_CODE,
                language="python",
                label="Editor",
                lines=24,
                interactive=True,
            )
            run_output = gr.Textbox(
                label="Output",
                lines=6,
                interactive=False,
                elem_id="run-output",
            )
        # RIGHT: Chat
        with gr.Column(scale=9):
            chatbot = gr.Chatbot(value=[], elem_id="chatbot", height=430)
            with gr.Row():
                image_upload = gr.Image(label="Image (vision)", type="filepath")
                file_upload  = gr.File(label="Code / text file")
            with gr.Row():
                msg_input = gr.Textbox(placeholder="Ask the agent...", scale=6)
                send_btn  = gr.Button("Send", variant="primary")
            with gr.Row():
                agentic_cb  = gr.Checkbox(label="Enable Agentic", value=True)
                thinking_cb = gr.Checkbox(label="Enable Thinking", value=False)
                clear_chat  = gr.Button("Clear chat")
            with gr.Accordion("Settings", open=False):
                sys_prompt  = gr.Textbox(value=DEFAULT_SYSTEM, label="System prompt")
                temperature = gr.Slider(minimum=0.0, maximum=2.0, value=0.7)
UI’ın yukarıda anlattığımız bileşenlerle birlikte nasıl çalıştığını inceleyelim:
Gönder ve gönderim olayları aynı girdi ve çıktıları paylaşır; böylece düğmeye tıklama ve metin kutusunda Enter’a basma aynı davranışı tetikler:
_inputs = [
    msg_input, chatbot, image_upload, file_upload,
    code_editor, lang_sel,
    sys_prompt, agentic_cb, thinking_cb, temperature,
]
_outputs = [chatbot, code_editor, msg_input]
send_btn.click(fn=respond, inputs=_inputs, outputs=_outputs)
msg_input.submit(fn=respond, inputs=_inputs, outputs=_outputs)
respond() sarmalayıcı, burada Gradio dosya yolu nesnelerini akış üreticisine iletmeden önce düz dosya yolu dizgelerine dönüştürür. Ardından, ilk bölümde ileti girişini temizlemek için boş dizeyi döndürecek şekilde her parçada (history, code, "") üretir.
Kullanılabilirliği ve görsel tutarlılığı artırmak için, Gradio’nun varsayılan stilinin üzerine özel bir tema ve CSS katmanı ekliyoruz. Bu, hem açık hem koyu modu destekleyen, cilalı, GitHub esintili bir görünüm kazandırır. Bu tamamen isteğe bağlıdır.
Başlangıç olarak gr.themes.Base kullanarak bir temel tema tanımlarız:
THEME = gr.themes.Base(
    primary_hue   = "blue",
    secondary_hue = "slate",
    neutral_hue   = "slate",
    font      = [gr.themes.GoogleFont("Inter"), "system-ui", "sans-serif"],
    font_mono = [gr.themes.GoogleFont("JetBrains Mono"), "monospace"],
)
Bu, tutarlı bir renk paleti ve temiz UI tipografisi (Inter) ile geliştirici dostu bir tek aralıklı yazı tipi (JetBrains Mono) belirler. Sonraki adımda, uygulamanın görünümünü kontrol etmek için temel CSS değişkenlerini geçersiz kılıyoruz:
gradio-app {
    --body-background-fill:   #f0f3f7;
    --block-background-fill:  #ffffff;
    --body-text-color:        #1f2328;
    --button-primary-background-fill: #1a7f37;
}

body.dark gradio-app {
    --body-background-fill:   #0d1117;
    --block-background-fill:  #1c2128;
    --body-text-color:        #e6edf3;
    --button-primary-background-fill: #238636;
}
Burada ilk blok açık temayı tanımlar; ikinci blok ise koyu mod için değerleri geçersiz kılar. Bu adım isteğe bağlı olsa da, özel tema ve CSS eklemek genel kullanıcı deneyimini önemli ölçüde iyileştirir.
Artık UI tamamen yapılandırılıp stillendirildiğine göre son adıma, yani uygulamayı başlatmaya hazırız.
Son olarak, uygulama şu şekilde başlatılır:
if __name__ == "__main__":
    print(f"Model  : {MODEL}")
    print(f"Ollama : {OLLAMA_BASE}")
    if not ollama_ok():
        print("Ollama not detected — run ollama serve before chatting")
    demo.launch(
        server_name="0.0.0.0",
        server_port=7860,
        share=False,
        theme=THEME,
        css=CSS,
    )
Burada server_name="0.0.0.0", uygulamaya yerel ağınızdan erişilebilir kılar ve share=False her şeyi yerelde tutar. ollama_ok() denetimi, localhost:11434’e hızlı bir GET isteği gönderir ve Ollama çalışmıyorsa başlatmada uyarır; böylece hata, kullanıcının ilk mesajı gönderdiği ana kadar ertelenmez.
Son olarak uygulama çalıştığında http://localhost:7860 adresine gidin.
Kullanıcı perspektifinden tam yürütme akışı şöyledir:
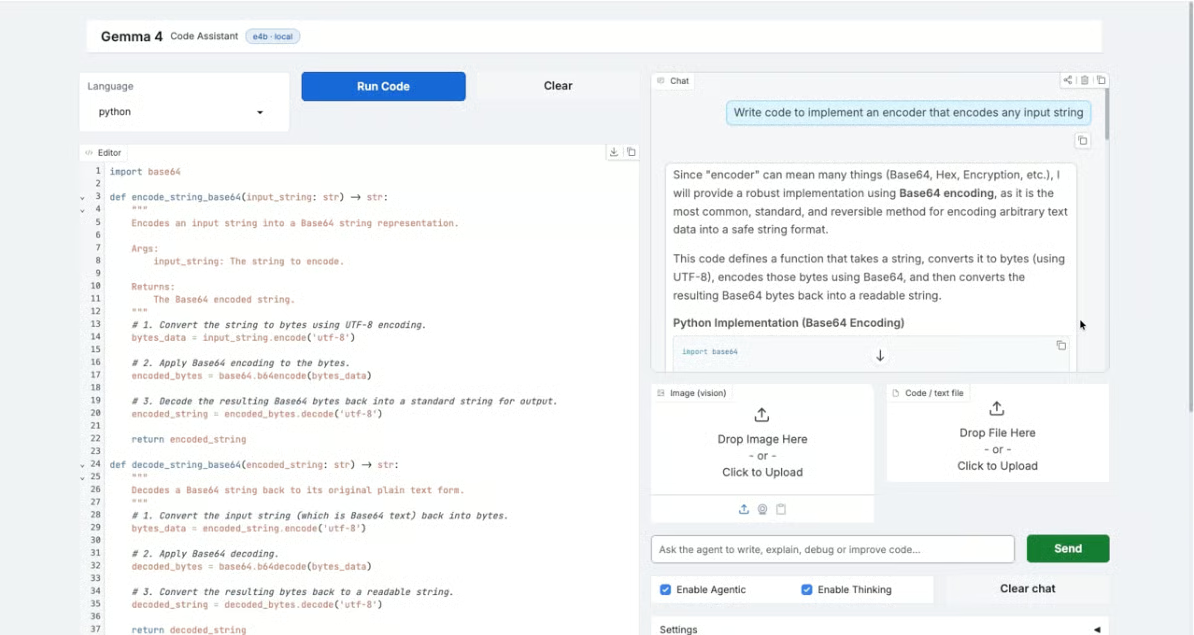
Kullanıcı sohbet paneline bir mesaj yazar; isteğe bağlı olarak bir görsel veya kod dosyası yükler ve aracısal/düşünme modunu açıp kapatır
Gönderimde, respond() işlevi, düzenleyicideki mevcut kod ve bağlam olarak ekler dahil tam Ollama isteğini oluşturur
İstek belirteç belirteç akış yapar ve kısmi yanıtlar canlı görüntüleme için Gradio sohbet botuna iletilir
Aracısal mod açıksa ve model bir araç çağırmaya karar verirse, araç yerelde çalışır; sonuçlar sohbete eklenir ve takip isteği nihai yanıtı akışla iletir
Akış tamamlandıktan sonra, yanıttaki son çitle çevrili kod bloğu çıkarılır ve düzenleyiciye otomatik olarak aktarılır
Bu eğitimde, Gemma 4, Ollama ve Gradio kullanarak tamamen yerel bir yapay zekâ kodlama asistanı oluşturduk. Uygulama, dış bir API olmadan kendi makinenizde çalışan çok kipli girdi, gerçek araç kullanımı, akışlı yanıtlar ve canlı bir kod düzenleyici destekler.
Düzenleyici kodunu her isteme doğrudan enjekte eden tüm-bağlam yaklaşımı, tek dosyalı bir iş akışı için RAG’den daha basittir ve üzerinde aktif olarak çalıştığınız kodu açıklama, yeniden düzenleme veya genişletme gibi görevlerde özellikle iyi çalışır.
Buradan projeyi birkaç yönde genişletebilirsiniz:
DataCamp ile Öğrenin
Kurs
Kurs
Kurs