

Langflow Nasıl Kurulur?
Langflow’u ücretsiz olarak ya resmi web sitelerindeki web arayüzü üzerinden ya da yerel olarak kurarak kullanabiliriz.
Bu eğitimde Docker ile yerel bir kurulum kullanacağız. Bu eğitimi takip etmek için Docker bilmeniz gerekmez. Ancak daha fazla bilgi edinmek isterseniz, bu yeni başlayanlar için Docker rehberine ve bu Docker kursuna göz atın.
Docker, uygulamaları konteyner adı verilen izole ortamlarda çalıştırmamıza olanak tanıyan bir araçtır; bu da yazılımı tutarlı şekilde geliştirme, test etme ve dağıtmayı kolaylaştırır. Bizim durumumuzda Docker kullanıyoruz çünkü Python ile özel bileşenler oluşturmak için daha fazla esneklik sunuyor; yerel bir veritabanı kullanabileceğiz ve harici bir hizmete bağlanmamız gerekmeyecek.
Langflow, hazır çalıştırılabilecek önceden oluşturulmuş bir örnek sağlar; bu nedenle kurulumu kendimiz yapmak zorunda kalmayacağız.
Docker ile Langflow’u yerelde çalıştırma
Langflow’u Docker ile yerelde çalıştırmak için şu adımları izleyin:
- Docker’ı buradaki adımları izleyerek kurun.
- resmî Langflow deposunu klonlayın veya indirin.
docker_exampleklasöründe bir terminal açın.docker compose upkomutunu çalıştırın.
Artık Langflow yerel makinemizde çalışıyor olmalı. Terminalde şu mesajı görmeliyiz:
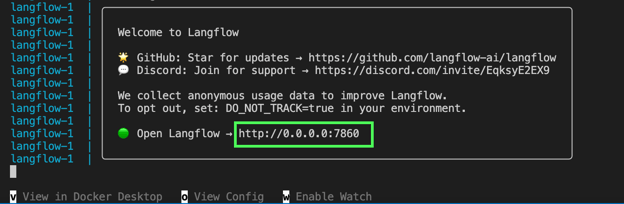
Uygulamayı terminalde gösterilen URL’yi ziyaret ederek açabiliriz; yukarıdaki örnekte http://0.0.0.0:7860.
Langflow ile Basit Ajana Göz Atma
Bu bölümde, Langflow’un nasıl çalıştığını Langflow’un basit yapay zeka ajan şablonunu inceleyerek keşfediyoruz. Bunu yapmak için ilk ekranda "Simple Agent"ı seçiyoruz.
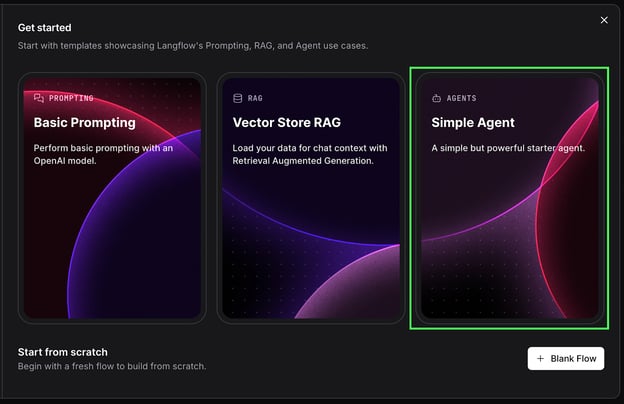
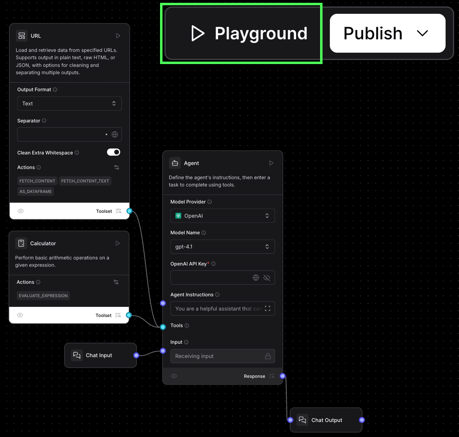
Bu, aşağıdakine benzer bir ajan iş akışı oluşturacaktır:
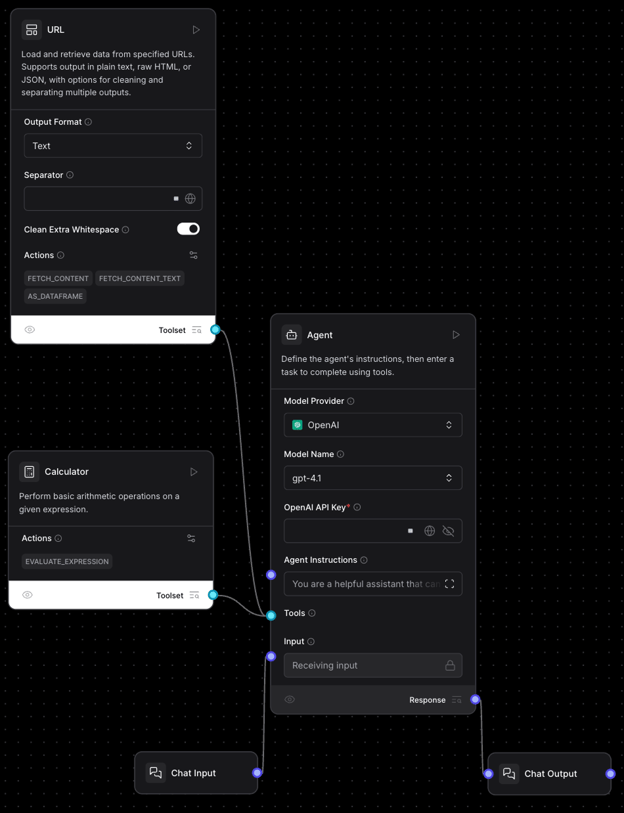
Bu iş akışının ana bileşeni ortadaki "Agent" bileşenidir:
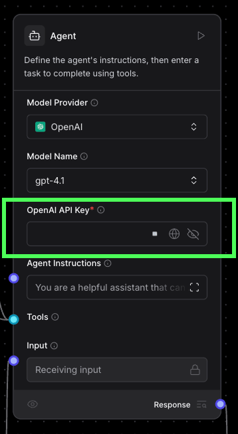
Bu ajan bileşeni OpenAI’nin gpt-4.1 modelini kullanıyor. Bunu kullanmak için bir OpenAI API anahtarı yapıştırmamız gerekir. Henüz yoksa, buradan oluşturabilirsiniz.
Ajan bileşeninin solunda, ona sunulan girdileri ve araçları görüyoruz (aşağıdaki görsele bakın). Bu örnekte iki araç ve bir girdi var:
- Sohbet arayüzünde kullanıcıdan gelen bir mesajı girdi olarak kullanan bir Chat Input.
- Hesaplamaları gerçekleştirmek için kullanılan bir Calculator aracı.
- Belirli bir URL’den bilgi çekmek için kullanılan bir URL aracı.
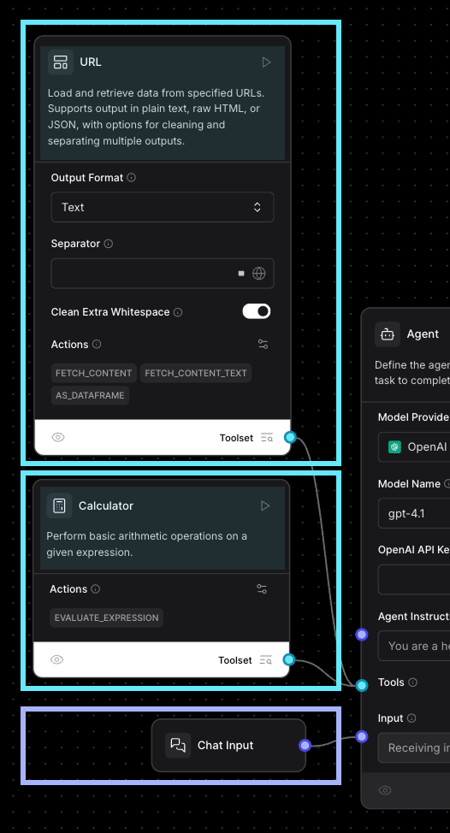
Sohbet girişi, iş akışını çalıştırdığımızda Langflow’un yerleşik sohbet arayüzünü kullanarak modele mesaj gönderebileceğimiz anlamına gelir. Her aracın üst kısmında bir açıklama görürüz. Model, her aracı çağırıp çağırmama kararını bu bilgiyi kullanarak verir.
Sağ tarafta ise çıktıları görüyoruz. Bu durumda tek bir çıktı bileşeni var; bu bir Chat Output bileşeni ve Ajan’ın yanıtının sohbete gönderilmesi gerektiğini belirtir.
Bileşenleri anlama
Basit Ajan’ı çalıştırmadan önce, genel olarak bileşenlerin nasıl çalıştığını anlamak için URL bileşenini kullanalım. Denemek üzere bir kopyasını oluşturalım.
- URL bileşenini seçin.
- Kopyalayıp yapıştırın.
- Hiçbir şeye bağlamayın.
Yeni bileşenin üst kısmında bir "Tool Mode" anahtarı var; kapatın.
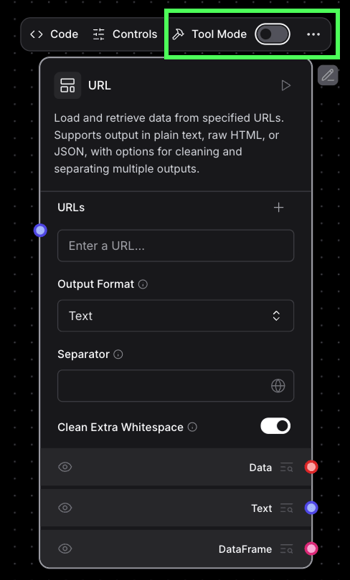
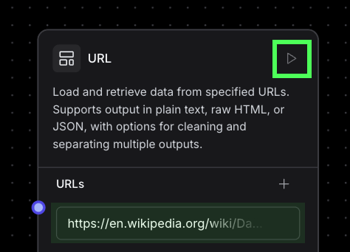
URLs alanına örneğin https://en.wikipedia.org/wiki/Data_science, yani Veri Bilimi’nin Wikipedia sayfasını girin. Sağ üst köşedeki çalıştırma okuna tıklayarak bileşeni yürütün.
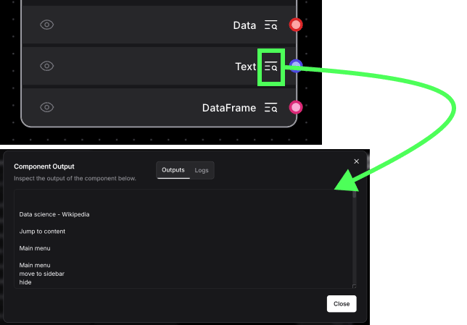
Bileşen çalışacak ve verdiğimiz URL’den içeriği yükleyecektir. Çıkış bağlantılarının yanındaki denetleyiciye tıklayarak görebiliriz. Her biri farklı bir çıktı biçimini temsil eder.
Arka planda, her düğüm bir Python betiğidir. Özel düğümler oluştururken buna daha ayrıntılı bakacağız. Koddaki "Code" düğmesine tıklayarak kodu inceleyebiliriz:
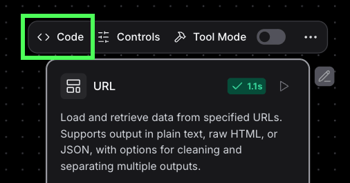
Orijinal Basit Ajan iş akışında, URL düğümü bir araç olacak şekilde yapılandırılmıştır. Bu, bir Ajan tarafından kullanılmak üzere tasarlandığı anlamına gelir. Bu durumda, URL’ler açıkça verilmez. Bunun yerine URL’leri ajan kendisi sağlayacaktır.
Basit Ajanı yürütme
Basit Ajan’a geri dönelim; sağ üst köşedeki "Playground" düğmesine tıklayarak çalıştırabiliriz. Bu, sohbet arayüzünü açar ve Ajan ile sohbet etmemizi sağlar.
Ondan Veri Bilimi Wikipedia sayfasını özetlemesini isteyelim:
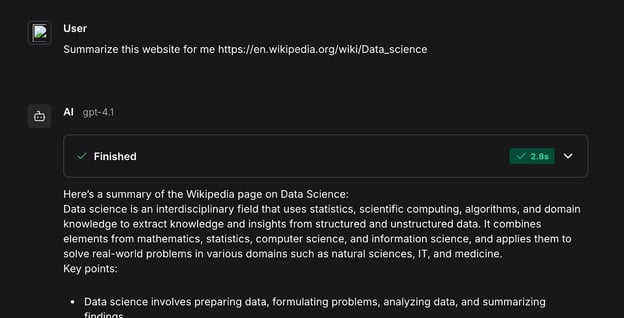
Yanıtın üst kısmındaki kutuyu genişletirsek, iş akışında yürütülen adımları görürüz.
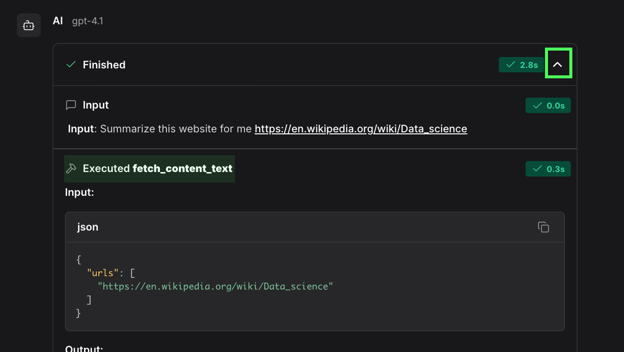
Burada örneğin, ajana sağladığımız URL aracında tanımlanan fetch_content_text() fonksiyonunu kullandığını görüyoruz.
Hesaplama aracının kullanımını, ondan bir hesaplama yapmasını isteyerek test edebiliriz. İfade ayrıştırılır ve değerlendirme için araca gönderilir. Bu, yalnızca LLM’ye güvenmeye kıyasla daha güvenilir bir yanıt sağlar.
Langflow’da Python ile Özel Bir Bileşen Oluşturma
Bu bölümde, özel bileşenlerin nasıl oluşturulacağını öğreneceğiz. Başlamak için sol alttaki "New Custom Component" düğmesine tıklayın:
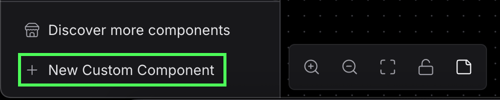
Varsayılan olarak bu, girdi olarak bir metin değeri alan ve aynı metni çıktılayan bir bileşen oluşturur. Varsayılan girdi "Hello, World!"dür ve bunu çalıştırıp çıktıyı incelersek, tam olarak bunu elde ettiğimizi görürüz.
Kodu incelediğimizde şunları görürüz:
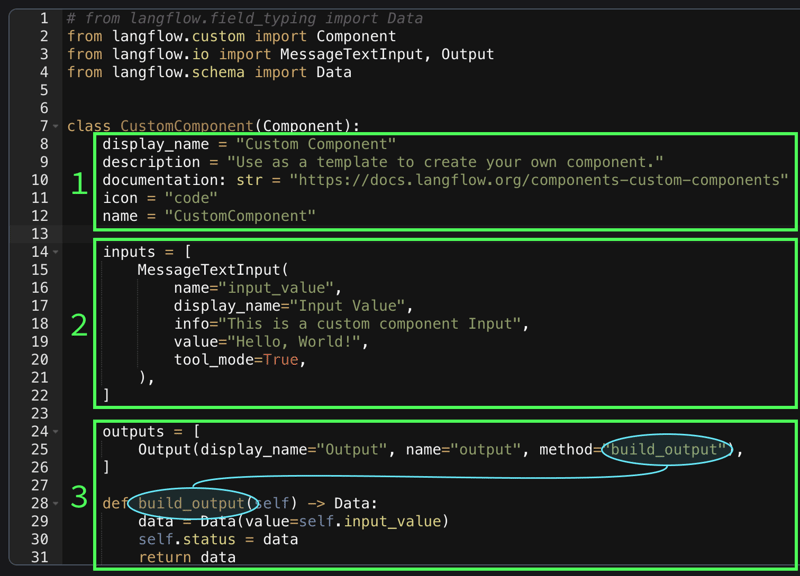
- Bu alanlar, bileşenin yapılandırma değerleridir. Açıklama önemlidir; çünkü bir araç olarak sunulduğunda yapay zeka ajanlarının bu bileşeni ne zaman kullanacağını belirlemesine yardımcı olur. Documentation alanı, bileşenin belgelerine isteğe bağlı bir URL’dir; burada bununla ilgilenmemize gerek yok.
inputslistesi, bileşen için mevcut girdi türlerini belirtir. Bu durumda, metin alanına karşılık geleninput_valueadlı tek birMessageTextInputsınıfı girdisi içerir. Ad, sınıfın bir niteliği haline geldiğinden geçerli bir Python değişken adı olmalıdır. Bir bileşen araç olarak ayarlandığında, bu girdiler yapay zeka ajanı tarafından otomatik olarak doldurulur. Girdinin ne olması gerektiğineinfoalanına bakarak karar verir. Langflow çeşitli girdi türlerini destekler. Desteklenen girdilerin tam listesi burada.- Bu bölüm çıktıları tanımlar.
methodalanı, çıktıyı oluşturmak için çalıştırılan fonksiyonu belirtir. Fonksiyon, girdiyeselfaracılığıyla erişir. Örneğin bu örnekte girdiinput_valueolarak adlandırılmıştır; dolayısıylaself.input_valuekullanarak erişebiliriz. Döndürülen değer, desteklenen çıktı sınıflarından biri olmalıdır.
Özel bir bileşen oluşturma hakkında daha fazla bilgi için Langflow’un resmi bileşen belgelerine bakın.
İki sayıyı toplayan bir bileşeni nasıl yapabileceğimize bir örnek:
from langflow.custom import Component
from langflow.io import MessageTextInput, Output
from langflow.schema import Data
class AddNumbers(Component):
display_name = "Add Numbers"
description = "This component adds two numbers together"
icon = "code"
name = "AddNumbers"
inputs = [
IntInput(
name="number1",
display_name="First Number",
info="The first number to add",
),
IntInput(
name="number2",
display_name="Second Number",
info="The second number to add",
),
]
outputs = [
Output(display_name="Output", name="output", method="add_numbers"),
]
def add_numbers(self) -> Data:
result = self.number1 + self.number2
data = Data(value=result)
return dataLangflow ile Bir Dil Eğitmeni Oluşturma
Yeni bir dil öğrenirken okuma becerilerimizi geliştirmede yardımcı olacak bir yapay zeka ajanı oluşturalım.
Deneyimlerime göre, yeni bir dil öğrenirken becerileri geliştirmenin yollarından biri okumaktır. Elbette başlangıçta sadece birkaç kelime bilirsiniz, bu yüzden bir kitap okumak imkansızdır. Bu nedenle, hâlihazırda bildiğimiz kelime dağarcığına odaklanan okuma materyallerine ihtiyaç duyarız.
Okumamız için kısa hikâyeler üretmek üzere bir LLM kullanacağız. Ancak kişiselleştirilmiş bir öğrenme deneyimi için, üreteceği hikâyelerin halihazırda bildiğimiz kelime dağarcığına odaklanmasını istiyoruz.
İhtiyaçlarımızın dökümü şöyle:
- Bilinen kelime dağarcığı veritabanı.
- Yapay zeka ajanının bilinen kelime dağarcığını almak ve bir hikâye üretmek için veritabanına erişmesi gerekir.
- Yapay zeka ajanının yeni kelimeler eklemek için veritabanına erişmesi gerekir.
Veritabanı kurulum bileşeni
Langflow’u Docker ile çalıştırdığımızda bir Postgres veritabanı başlatılır. Buna psycopg2 paketi ile erişebiliriz. Postgres hakkında daha fazla bilgi edinmek için şu PostgreSQL rehberine bakın.
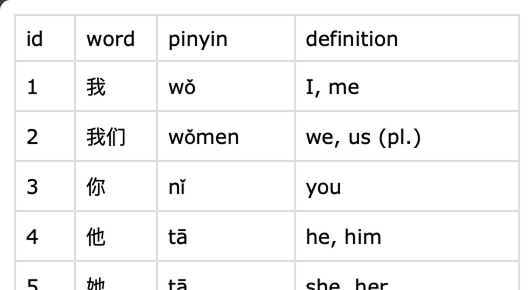
Veritabanını başlatmak için bilinen kelimeleri içeren bir CSV dosyasını yükleyebileceğimiz bir düğüm oluşturacağız. Benim CSV dosyam şöyle görünüyor:
İki girdili bir bileşen oluşturdum.
- Dahil etmek istediğimiz kelimeleri içeren sütunu belirtmek için bir sütun adı.
- Kelimeleri içeren CSV dosyasını sağlamak için bir dosya girdisi.
İşte bileşenin kodu:
from langflow.custom import Component
from langflow.io import MessageTextInput, Output
from langflow.schema import Message
import psycopg2
import csv
def connect_to_database():
# Connect to the Postgres database provided by the Docker setup
conn = psycopg2.connect(
dbname="langflow",
user="langflow",
password="langflow",
host="postgres",
port="5432"
)
conn.autocommit = True
return conn.cursor()
def add_word(cursor, word):
# Add a word to the database
cursor.execute(
"INSERT INTO words (word) VALUES (%s) ON CONFLICT (word) DO NOTHING;",
(word,)
)
def initialize_database(cursor):
# Initialize the database by creating the word table if it doesn't yet exist
create_table_query = """
CREATE TABLE IF NOT EXISTS words (
word TEXT PRIMARY KEY
);
"""
cursor.execute(create_table_query)
class UploadWordFile(Component):
display_name = "Upload Word File"
description = "Upload a CSV file of words to the database."
icon = "code"
name = "UploadWordFile"
inputs = [
StrInput(
name="column_name",
display_name="Column Name",
info="The name of the column containing the words",
),
FileInput(
name="csv_file",
display_name="CSV file",
info="CSV input file",
file_types=["csv"]
),
]
outputs = [
Output(display_name="Output", name="output", method="load_words_into_database"),
]
def load_words_into_database(self) -> Message:
try:
cursor = connect_to_database()
initialize_database(cursor)
with open(self.csv_file, "rt") as f:
rows = list(csv.reader(f))
headers = list(map(lambda header: header.lower(), rows[0]))
column_index = headers.index(self.column_name)
for row in rows[1:]:
add_word(cursor, row[column_index])
return "Success"
except Exception as e:
return f"Error: {str(e)}"Bileşen şu şekilde görünür:
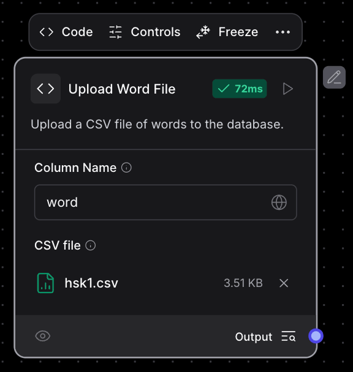
Tek başına kullanılmak ve başka bir bileşene bağlanmamak üzere tasarlanmıştır. Kelimeleri veritabanına manuel olarak yüklemek için kullanabiliriz.
Kelime ekleme aracı
Burada, yapay zeka ajanının veritabanına yeni kelimeler eklemek için kullanabileceği bir araç oluşturuyoruz. Böylece kullanıcı, ajana bir mesaj göndererek kolayca yeni kelime ekleyebilir.
Bu kod, önceki düğümden connect_to_database() ve add_word() fonksiyonlarını yeniden kullanır. Daha iyi bir Docker kurulumu ile kod tekrarından kaçınabiliriz; ancak bu eğitim için basit tutacağız.
Bu aracın kodu şöyle:
# from langflow.field_typing import Data
from langflow.custom import Component
from langflow.io import MessageTextInput, Output
from langflow.schema import Message
def connect_to_database():
# Connect to the Postgres database provided by the Docker setup
conn = psycopg2.connect(
dbname="langflow",
user="langflow",
password="langflow",
host="postgres",
port="5432"
)
conn.autocommit = True
return conn.cursor()
def add_word(cursor, word):
# Add a word to the database
cursor.execute(
"INSERT INTO words (word) VALUES (%s) ON CONFLICT (word) DO NOTHING;",
(word,)
)
class AddWordTool(Component):
display_name = "Add word tool"
description = "Use this tool to add a new word"
icon = "code"
name = "AddWordTool"
inputs = [
MessageTextInput(
name="word",
display_name="Word",
info="The word to add",
tool_mode=True,
),
]
outputs = [
Output(display_name="Output", name="output", method="add_new_word"),
]
def add_new_word(self) -> Message:
cursor = connect_to_database()
add_word(cursor, self.word)
return f"Added word: {self.word}"Bu aracın veritabanının önceden oluşturulmuş olduğunu varsaydığını unutmayın. Önceki bileşeni en az bir kez çalıştırmadan çalışmayacaktır.
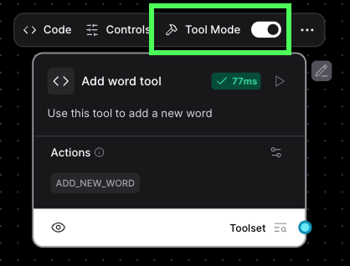
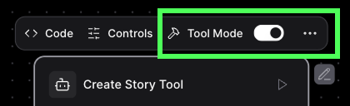
Araç moduna almayı unutmayın:
Hikâye oluşturucu aracı
Bir hikâye oluşturmak için bir yapay zeka ajan bileşeni kullanıyoruz. Yapı şöyle:
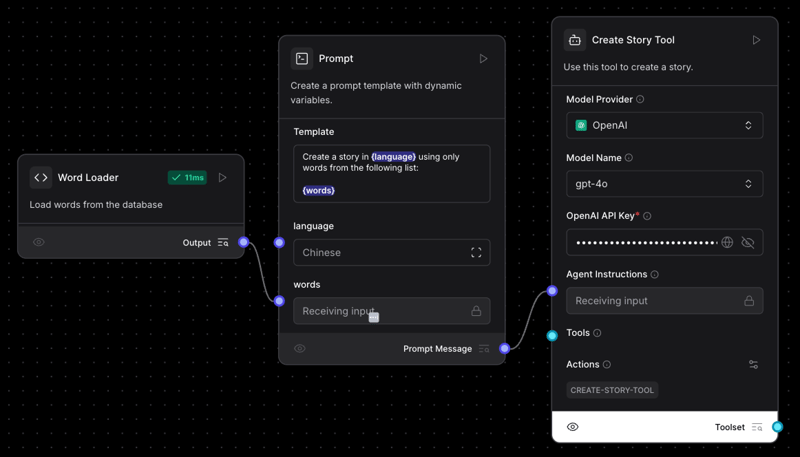
Ajan talimatlarında, istemi doğrudan bileşene eklemek yerine bir Prompt bileşeni kullandık; çünkü bu, isteme parametreler eklememize olanak tanır. Kullandığımız istem şu:
Create a story in {language} using only words from the following list:
{words}İstem iki parametreye sahiptir: {language} ve {words}. Bu şekilde parametreler eklendiğinde, bileşene her biri için bir alan eklenir.
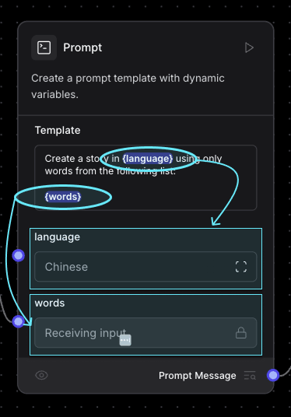
Dil değeri için metin kutusuna doğrudan girdik. Kelimelerin veritabanından yüklenmesi gerektiğinden, veritabanından tüm kelimeleri yükleyen özel bir bileşen oluşturduk ve o düğümün çıktısını words alanına bağladık.
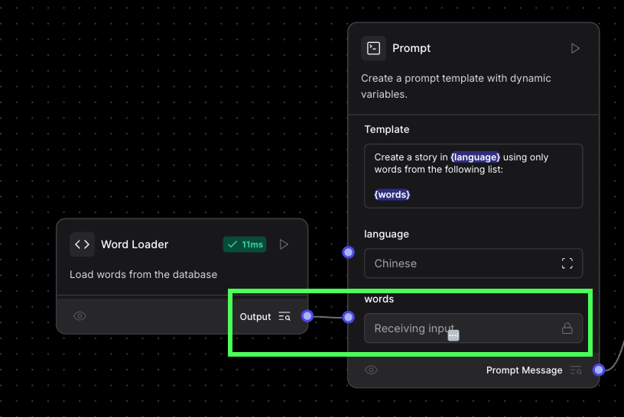
Kelime yükleyici bileşeninin kodu şöyle:
from langflow.custom import Component
from langflow.io import MessageTextInput, Output
from langflow.schema import Message
import psycopg2
def load_words():
conn = psycopg2.connect(
dbname="langflow",
user="langflow",
password="langflow",
host="postgres",
port="5432"
)
cursor = conn.cursor()
cursor.execute("""
SELECT * FROM words;
""")
rows = cursor.fetchall()
return map(lambda row: row[0], rows)
class WordLoader(Component):
display_name = "Word Loader"
description = "Load words from the database"
icon = "code"
name = "WordLoader"
outputs = [
Output(display_name="Output", name="output", method="build_output"),
]
def build_output(self) -> Message:
return str(", ".join(load_words()))Sonraki adımda ajanı bir araç olacak şekilde ayarladık. Bu sayede, (sonraki adımda oluşturduğumuz) ana ajan gerektiğinde bir hikâye oluşturmak için bunu kullanabilecek.
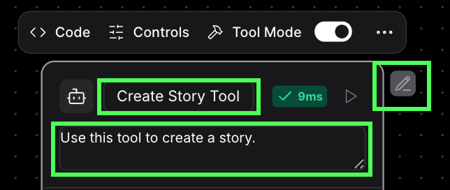
Son olarak, aracı yeniden adlandırıp araç açıklamasını, yapay zekânın bu aracı ne zaman kullanacağını anlayacağı şekilde değiştirdik:
Dil ajanı
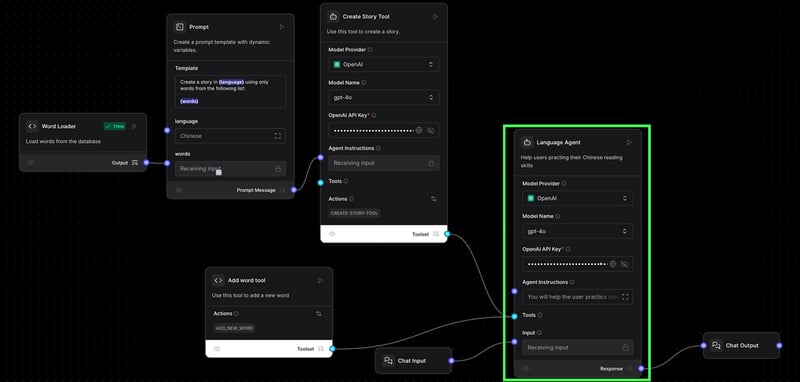
Ana ajan için, oluşturduğumuz iki araca bağlı sıradan bir yapay zeka ajan düğüm bileşeni kullanıyoruz. Bu ajan, sohbet arayüzüyle etkileşim kurabilmemiz için bir sohbet girişi ve sohbet çıkışı bileşeni kullanır.
İşte son mimari:
Kullandığımız istem:
You will help the user practice their language skills. You will either be asked to create a story or to add a new word to the vocabulary.
- If the user asks you to create a story, use the story generation tool.
- If the user asks you to add a word, use the word add tool.
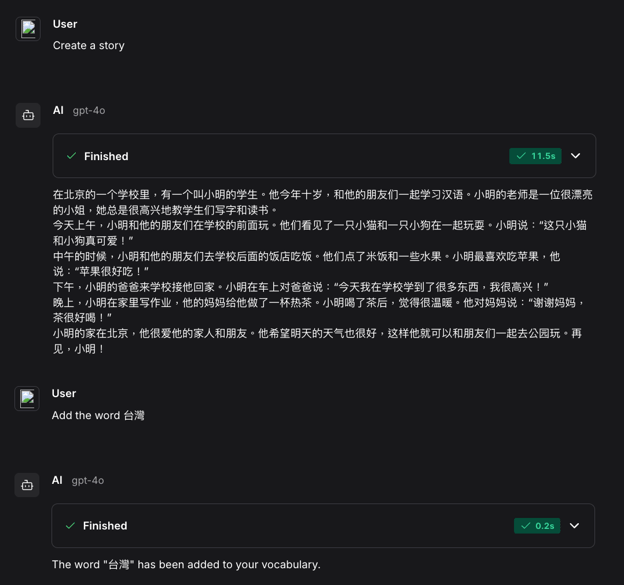
When using a tool, your answer should just be the result from the tool and nothing else.Tüm iş akışını “Playground” düğmesine tıklayarak çalıştırabiliriz. Örnek bir etkileşim şöyle:
Sonuç
Langflow’un temel yönlerini ve kullanıcıların okuma becerilerini geliştirmelerine yardımcı olan bir yapay zeka ajanı iş akışının nasıl oluşturulacağını inceledik. Python kullanarak özel bileşenler oluşturarak daha fazla olasılığın kilidini açıyoruz.
Bu hibrit yaklaşım, iki dünyanın en iyilerini bir araya getirir: Her türlü görevi yerine getirmeyi mümkün kılan Python betiklerinin esnekliği ve karmaşık koda dalmadan iş akışı oluşturmayı kolaylaştıran Langflow’un sezgisel grafik arayüzü.
Yapay zeka ajanları hakkında daha fazla bilgi edinmek için şu blogları okumanızı öneririm:





Langflow, çeşitli API’leri kullanarak yapay zeka ajan iş akışları oluşturmamıza ve görevleri otomatikleştirmemize olanak tanıyan düşük kodlu bir araçtır.
Bu yazıda, Python kullanarak özel Yapay Zeka Ajanı iş akışları oluşturmak için Langflow’u adım adım nasıl kullanacağınızı açıklayacağım. Yeni bir dil öğrenirken kullanıcıya okuma becerilerini geliştirmede yardımcı olan bir yapay zeka ajanını nasıl oluşturacağınızı göstereceğim.
Langflow Nedir?
Langflow, herhangi bir kod yazmadan çeşitli bileşenleri birbirine bağlayarak iş akışlarını otomatikleştirmemizi sağlar. Her bileşen, diğer bileşenlerden çıktılar alır, belirli bir işlem gerçekleştirir ve ardından yeni verileri çıktı olarak sunar.
Örneğin bir yapay zeka sohbet botu oluştururken, bir sohbet girişi bileşenini bir dil modeline (LLM) bağlayabiliriz. LLM bileşeninden gelen çıktı daha sonra başka bir sohbet çıkışı bileşenine bağlanabilir.
Geniş bir ön tanımlı bileşen koleksiyonunun üzerine, Python kullanarak özel bileşenler de oluşturabiliriz. Yüksek seviyede, özel bir bileşen, bazı girdiler alan ve bazı veriler çıktılayan bir Python fonksiyonudur.
Python kullanarak bir yapay zeka dil eğitmeni oluşturmak için özel bileşenleri nasıl kullanacağımızı öğreneceğiz. Bu tür iş akışlarını hiç kod yazmadan oluşturmakla ilgileniyorsanız, şu n8n rehberine göz atmanızı öneririm (n8n benzer bir araçtır ve o rehberde, e-posta gelen kutunuzdaki faturaları otomatik olarak işleyen bir yapay zeka ajanını kod yazmadan nasıl oluşturacağınızı açıklıyorum).