

Langflow कैसे इंस्टॉल करें?
हम Langflow का निःशुल्क उपयोग कर सकते हैं—या तो उनकी आधिकारिक वेबसाइट के वेब UI पर, या इसे लोकल रूप से इंस्टॉल करके।
इस ट्यूटोरियल में, हम Docker के साथ एक लोकल सेटअप का उपयोग करेंगे। इस ट्यूटोरियल को फॉलो करने के लिए आपको Docker जानने की आवश्यकता नहीं है। लेकिन यदि आप और सीखना चाहते हैं, तो यह Docker गाइड और यह Docker कोर्स देखें।
Docker एक टूल है जो हमें कंटेनर नामक आइसोलेटेड एनवायरनमेंट्स में एप्लिकेशन चलाने देता है, जिससे सॉफ्टवेयर को लगातार डेवलप, टेस्ट और डिप्लॉय करना आसान हो जाता है। हमारे मामले में, हम Docker का उपयोग करते हैं क्योंकि यह Python के साथ कस्टम कंपोनेंट्स बनाने के लिए अधिक लचीलापन देता है—हम लोकल डेटाबेस का उपयोग कर सकेंगे और किसी बाहरी सेवा से कनेक्ट करने की आवश्यकता नहीं होगी।
Langflow एक प्री-बिल्ट उदाहरण प्रदान करता है जो रन के लिए तैयार है, इसलिए हमें इसे खुद सेटअप नहीं करना होगा।
Docker के साथ लोकल रूप से Langflow चलाना
Docker के साथ लोकल रूप से Langflow चलाने के लिए ये कदम उठाएँ:
- यहाँ दिए गए चरणों का पालन करके Docker इंस्टॉल करें यहाँ।
- आधिकारिक Langflow रिपॉज़िटरी को क्लोन या डाउनलोड करें।
- टर्मिनल को
docker_exampleफ़ोल्डर में खोलें। - कमांड चलाएँ
docker compose up।
अब Langflow हमारी लोकल मशीन पर चलना चाहिए। हमें टर्मिनल में यह संदेश दिखना चाहिए:
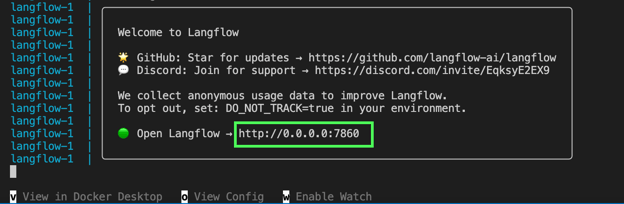
हम टर्मिनल में दिखाए गए URL पर जाकर एप्लिकेशन खोल सकते हैं, ऊपर वाले उदाहरण में http://0.0.0.0:7860।
Langflow के साथ सिंपल एजेंट की पड़ताल
इस खंड में, हम Langflow के सिंपल AI एजेंट टेम्पलेट की जाँच करके समझेंगे कि Langflow कैसे काम करता है। इसके लिए, पहली स्क्रीन पर "Simple Agent" चुनें।
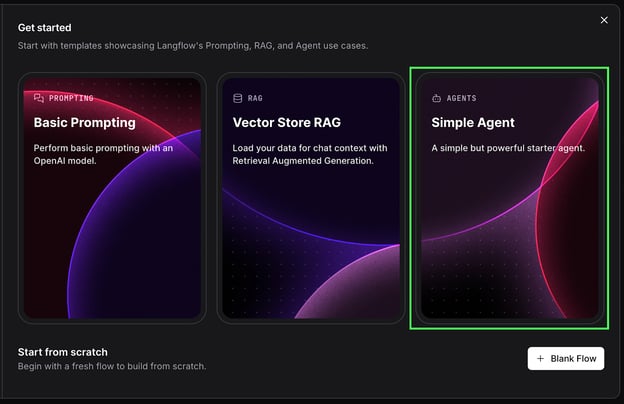
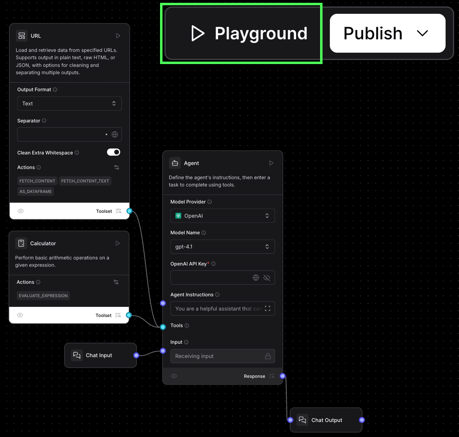
यह इस तरह का एजेंट वर्कफ़्लो बनाएगा:
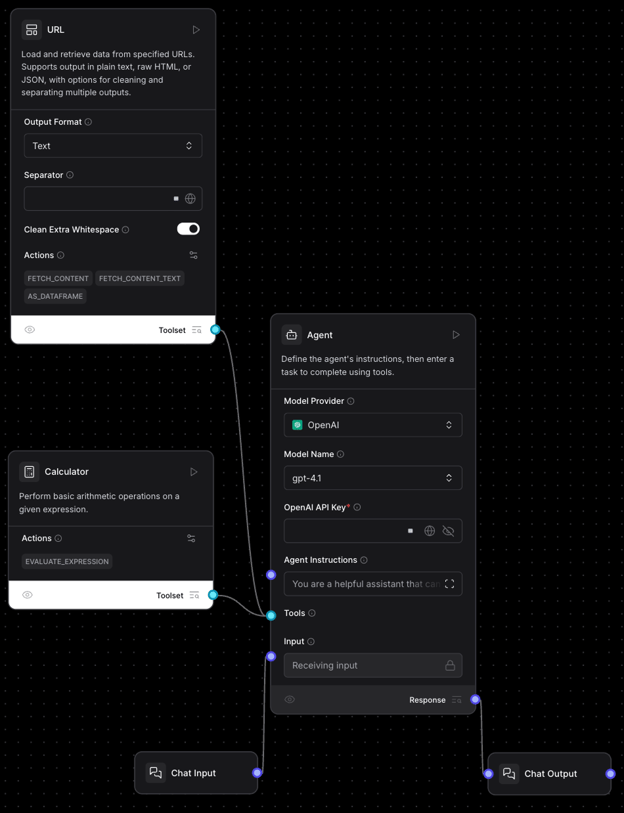
इस वर्कफ़्लो का मुख्य कंपोनेंट बीच में मौजूद "Agent" कंपोनेंट है:
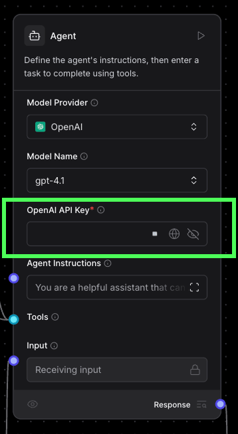
यह एजेंट कंपोनेंट OpenAI के gpt-4.1 मॉडल का उपयोग कर रहा है। इसका उपयोग करने के लिए, हमें OpenAI API कुंजी पेस्ट करनी होगी। यदि आपके पास अभी नहीं है, तो आप इसे यहाँ बना सकते हैं।
एजेंट कंपोनेंट के बाएँ तरफ, इसके इनपुट्स और उपलब्ध टूल्स दिखते हैं (नीचे दी गई छवि देखें)। इस मामले में, इसके पास दो टूल और एक इनपुट है:
- एक Chat Input जो चैट इंटरफ़ेस में उपयोगकर्ता के संदेश को इनपुट के रूप में उपयोग करता है।
- एक Calculator टूल जो गणनाएँ करने के लिए उपयोग होता है।
- एक URL टूल जो किसी विशेष URL से जानकारी लाने के लिए उपयोग होता है।
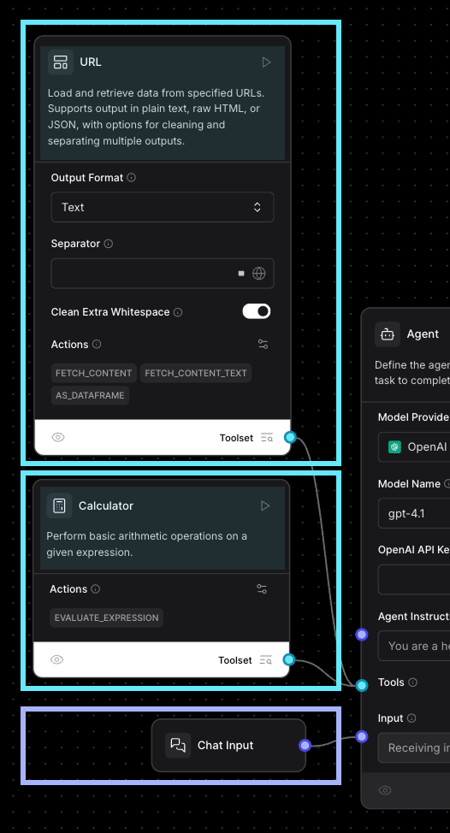
चैट इनपुट का अर्थ है कि जब हम वर्कफ़्लो चलाते हैं, तो हम Langflow के बिल्ट-इन चैट इंटरफ़ेस का उपयोग करके मॉडल को संदेश भेज सकते हैं। हर टूल के शीर्ष पर एक विवरण दिखाई देता है। मॉडल यह तय करने के लिए इस जानकारी का उपयोग करता है कि प्रत्येक टूल को कॉल करना है या नहीं।
दाईं ओर, हमें आउटपुट्स दिखते हैं। इस मामले में, एक ही आउटपुट कंपोनेंट है, जो एक Chat Output कंपोनेंट है, जो दर्शाता है कि एजेंट का उत्तर चैट में भेजा जाना चाहिए।
कंपोनेंट्स को समझना
सिंपल एजेंट चलाने से पहले, आइए URL कंपोनेंट का उपयोग करें ताकि सामान्य रूप से कंपोनेंट्स कैसे काम करते हैं, यह समझ सकें। प्रयोग के लिए इसका एक कॉपी बनाएँ।
- URL कंपोनेंट चुनें।
- कॉपी करें और पेस्ट करें।
- इसे किसी भी चीज़ से कनेक्ट न करें।
नए कंपोनेंट के शीर्ष पर "Tool Mode" स्विच है; इसे बंद करें।
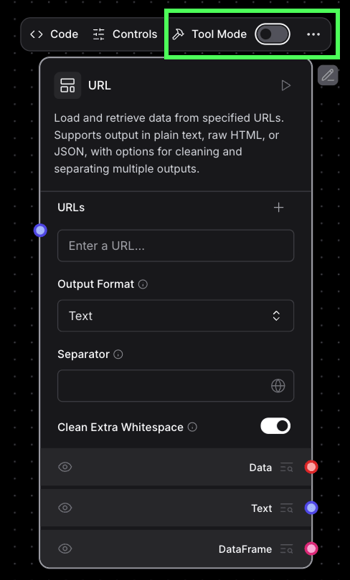
URLs फ़ील्ड में, उदाहरण के लिए https://en.wikipedia.org/wiki/Data_science डालें, जो Data Science का विकिपीडिया पेज है। ऊपर-दाईं तरफ रन एरो पर क्लिक करके कंपोनेंट को निष्पादित करें।
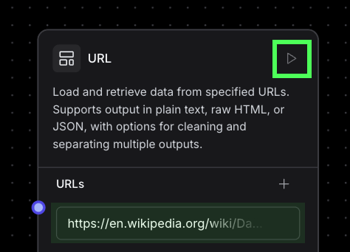
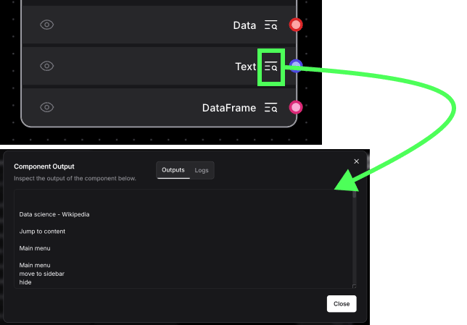
कंपोनेंट निष्पादित होगा और दिए गए URL से सामग्री लोड करेगा। हम आउटपुट लिंक्स के बगल में मौजूद इंस्पेक्टर पर क्लिक करके इसे देख सकते हैं। प्रत्येक एक अलग आउटपुट फ़ॉर्मेट का प्रतिनिधित्व करता है।
बैकग्राउंड में, हर नोड एक Python स्क्रिप्ट है। जब हम आगे कस्टम नोड्स बनाएँगे, तब इसके बारे में और सीखेंगे। हम शीर्ष पर "Code" बटन पर क्लिक करके कोड का निरीक्षण कर सकते हैं:
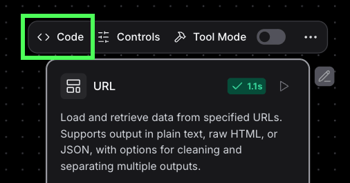
मूल सिंपल एजेंट वर्कफ़्लो में, URL नोड को एक टूल के रूप में कॉन्फ़िगर किया गया है। इसका मतलब है कि इसे किसी एजेंट द्वारा उपयोग के लिए बनाया गया है। इस स्थिति में, URLs स्पष्ट रूप से नहीं दिए जाते। इसके बजाय, एजेंट स्वयं URLs प्रदान करेगा।
सिंपल एजेंट निष्पादित करना
सिंपल एजेंट पर वापस आकर, हम ऊपर-दाईं ओर "Playground" बटन पर क्लिक करके इसे चला सकते हैं। यह चैट इंटरफ़ेस खोलता है, जिससे हम एजेंट से चैट कर सकते हैं।
आइए इससे Data Science के विकिपीडिया पेज का सारांश माँगते हैं:
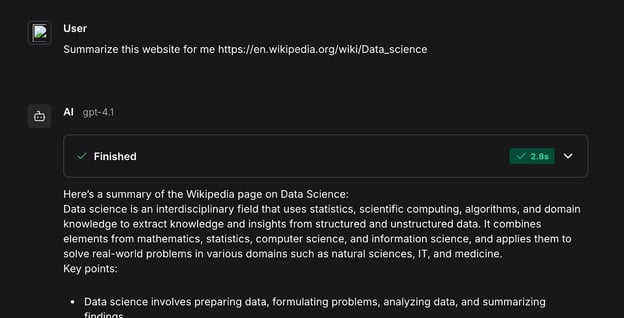
यदि हम उत्तर के शीर्ष पर बॉक्स को विस्तृत करें, तो हम देखेंगे कि वर्कफ़्लो में कौन-कौन से स्टेप्स निष्पादित हुए।
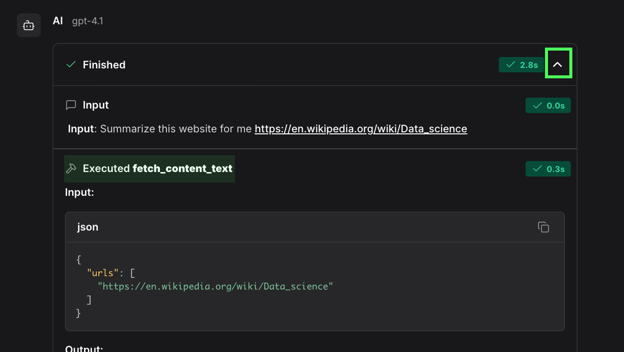
यहाँ, उदाहरण के लिए, हम देखते हैं कि यह fetch_content_text() फ़ंक्शन का उपयोग करता है, जो उस URL टूल में परिभाषित है जो हमने एजेंट को दिया था।
हम इससे Calculation टूल का उपयोग करवाकर परीक्षण कर सकते हैं—इसे कोई गणना करने के लिए कहें। एक्सप्रेशन को पार्स किया जाएगा और मूल्यांकन के लिए टूल को भेजा जाएगा। यह केवल LLM पर निर्भर रहने की तुलना में अधिक विश्वसनीय उत्तर प्रदान करता है।
Python के साथ Langflow में कस्टम कंपोनेंट बनाना
इस खंड में, हम कस्टम कंपोनेंट्स बनाना सीखेंगे। शुरू करने के लिए, नीचे बाईं ओर "New Custom Component" बटन पर क्लिक करें:
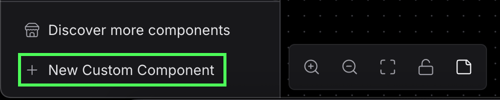
डिफ़ॉल्ट रूप से, यह ऐसा कंपोनेंट बनाता है जो इनपुट के रूप में एक टेक्स्ट वैल्यू लेता है और वही टेक्स्ट आउटपुट करता है। डिफ़ॉल्ट इनपुट "Hello, World!" है और यदि हम इसे चलाएँ और आउटपुट को देखें, तो बिल्कुल वही मिलता है।
कोड का निरीक्षण करने पर, हमें निम्न दिखाई देता है:
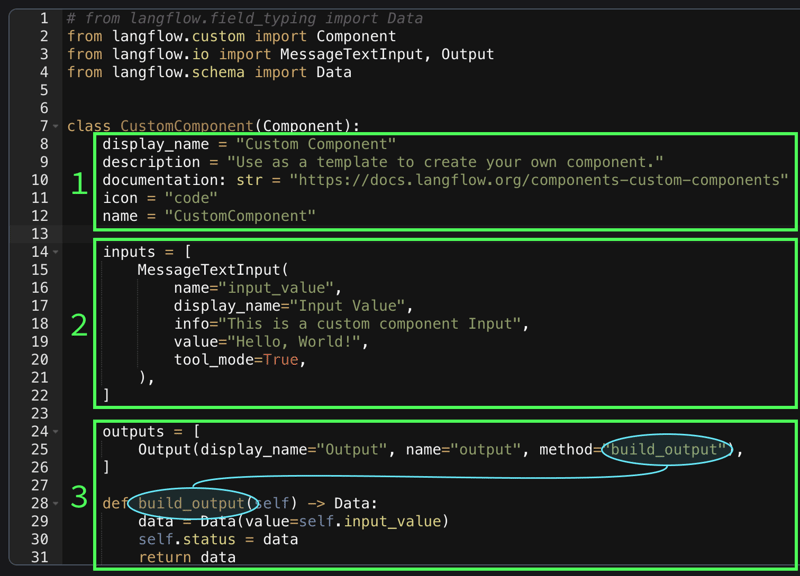
- ये फ़ील्ड्स कंपोनेंट के कॉन्फ़िगरेशन मान हैं। विवरण महत्वपूर्ण है क्योंकि इसे टूल के रूप में दिए जाने पर AI एजेंट यह जानने के लिए इसका उपयोग करते हैं कि इस कंपोनेंट का उपयोग कब करना है। डॉक्यूमेंटेशन फ़ील्ड कंपोनेंट के दस्तावेज़ की एक वैकल्पिक URL है, इसलिए यहाँ इसकी चिंता नहीं है।
inputsसूची कंपोनेंट के लिए उपलब्ध इनपुट प्रकारों को निर्दिष्ट करती है। इस मामले में, इसमेंMessageTextInputक्लास का एकल इनपुटinput_valueशामिल है, जो टेक्स्ट फ़ील्ड से मेल खाता है। नाम एक वैध Python वेरिएबल नाम होना चाहिए क्योंकि यह क्लास का एट्रिब्यूट बन जाता है। जब किसी कंपोनेंट को टूल के रूप में सेट किया जाता है, तो ये इनपुट AI एजेंट द्वारा स्वत: भरे जाते हैं। यह तय करने के लिएinfoफ़ील्ड का उपयोग करता है कि इनपुट क्या होना चाहिए। Langflow कई प्रकार के इनपुट को सपोर्ट करता है। यहाँ समर्थित इनपुट्स की पूरी सूची है।- यह भाग आउटपुट्स को परिभाषित करता है।
methodफ़ील्ड उस फ़ंक्शन को निर्दिष्ट करता है जो आउटपुट जनरेट करने के लिए निष्पादित होता है। फ़ंक्शन कोselfके माध्यम से इनपुट तक पहुंच होती है। उदाहरण के लिए, इस उदाहरण में इनपुट का नामinput_valueहै, इसलिए हम इसेself.input_valueका उपयोग करके एक्सेस कर सकते हैं। रिटर्न वैल्यू समर्थित आउटपुट क्लासेस में से किसी एक क्लास का होना चाहिए।
कस्टम कंपोनेंट बनाने के बारे में अधिक जानकारी के लिए Langflow के कंपोनेंट्स की आधिकारिक डॉक्स देखें।
यहाँ एक उदाहरण है कि हम दो संख्याएँ जोड़ने वाला कंपोनेंट कैसे बना सकते हैं:
from langflow.custom import Component
from langflow.io import MessageTextInput, Output
from langflow.schema import Data
class AddNumbers(Component):
display_name = "Add Numbers"
description = "This component adds two numbers together"
icon = "code"
name = "AddNumbers"
inputs = [
IntInput(
name="number1",
display_name="First Number",
info="The first number to add",
),
IntInput(
name="number2",
display_name="Second Number",
info="The second number to add",
),
]
outputs = [
Output(display_name="Output", name="output", method="add_numbers"),
]
def add_numbers(self) -> Data:
result = self.number1 + self.number2
data = Data(value=result)
return dataLangflow के साथ एक लैंग्वेज ट्यूटर बनाना
आइए एक AI एजेंट बनाते हैं जो नई भाषा सीखते समय हमारी रीडिंग स्किल्स का अभ्यास करने में मदद करे।
मेरे अनुभव में, नई भाषा सीखते समय कौशल सुधारने के तरीकों में से एक है पढ़ना। बेशक, शुरुआत में आप कुछ ही शब्द जानते हैं, इसलिए किताब पढ़ना असंभव होता है। इसलिए, हमें ऐसे रीडिंग मटेरियल चाहिए जो वर्तमान में हमारे ज्ञात शब्दावली पर केंद्रित हों।
हम अपने लिए छोटी कहानियाँ जनरेट करने के लिए एक LLM का उपयोग करेंगे। हालाँकि, व्यक्तिगत सीखने का अनुभव पाने के लिए, हम चाहते हैं कि यह उन कहानियों को हमारी पहले से ज्ञात शब्दावली पर केंद्रित रखे।
हमें जिन चीज़ों की आवश्यकता है, उनका सारांश:
- ज्ञात शब्दावली का एक डेटाबेस।
- AI एजेंट को डेटाबेस तक पहुँच चाहिए ताकि वह ज्ञात शब्दावली प्राप्त करके कहानी बना सके।
- AI एजेंट को नए शब्द जोड़ने के लिए भी डेटाबेस तक पहुँच चाहिए।
डेटाबेस सेटअप कंपोनेंट
जब हम Docker का उपयोग करके Langflow चलाते हैं, तो यह एक Postgres डेटाबेस शुरू करता है। हम इसे psycopg2 पैकेज का उपयोग करके एक्सेस कर सकते हैं। Postgres के बारे में अधिक जानने के लिए यह PostgreSQL ट्यूटोरियल देखें।
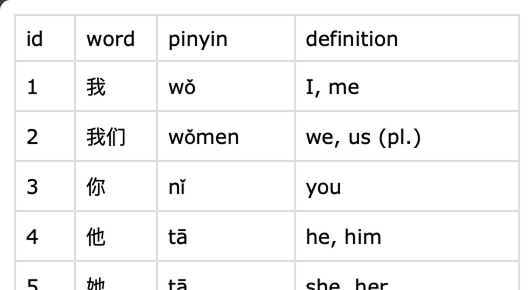
हम एक नोड बनाएँगे जहाँ हम ज्ञात शब्दों वाली CSV फ़ाइल अपलोड करके डेटाबेस को इनिशियलाइज़ कर सकें। मेरी CSV फ़ाइल कुछ इस तरह दिखती है:
मैंने दो इनपुट्स वाला एक कंपोनेंट बनाया।
- कॉलम का नाम, जिससे हम उस कॉलम को निर्दिष्ट कर सकें जिसमें शामिल करने के लिए शब्द हैं।
- फ़ाइल इनपुट, जिससे शब्दों वाली CSV फ़ाइल प्रदान की जा सके।
यहाँ कंपोनेंट का कोड है:
from langflow.custom import Component
from langflow.io import MessageTextInput, Output
from langflow.schema import Message
import psycopg2
import csv
def connect_to_database():
# Connect to the Postgres database provided by the Docker setup
conn = psycopg2.connect(
dbname="langflow",
user="langflow",
password="langflow",
host="postgres",
port="5432"
)
conn.autocommit = True
return conn.cursor()
def add_word(cursor, word):
# Add a word to the database
cursor.execute(
"INSERT INTO words (word) VALUES (%s) ON CONFLICT (word) DO NOTHING;",
(word,)
)
def initialize_database(cursor):
# Initialize the database by creating the word table if it doesn't yet exist
create_table_query = """
CREATE TABLE IF NOT EXISTS words (
word TEXT PRIMARY KEY
);
"""
cursor.execute(create_table_query)
class UploadWordFile(Component):
display_name = "Upload Word File"
description = "Upload a CSV file of words to the database."
icon = "code"
name = "UploadWordFile"
inputs = [
StrInput(
name="column_name",
display_name="Column Name",
info="The name of the column containing the words",
),
FileInput(
name="csv_file",
display_name="CSV file",
info="CSV input file",
file_types=["csv"]
),
]
outputs = [
Output(display_name="Output", name="output", method="load_words_into_database"),
]
def load_words_into_database(self) -> Message:
try:
cursor = connect_to_database()
initialize_database(cursor)
with open(self.csv_file, "rt") as f:
rows = list(csv.reader(f))
headers = list(map(lambda header: header.lower(), rows[0]))
column_index = headers.index(self.column_name)
for row in rows[1:]:
add_word(cursor, row[column_index])
return "Success"
except Exception as e:
return f"Error: {str(e)}"कंपोनेंट कुछ इस तरह दिखता है:
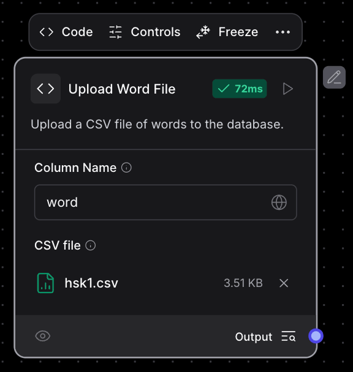
इसे अकेले उपयोग करने के लिए डिज़ाइन किया गया है और इसे किसी अन्य कंपोनेंट से जोड़ना नहीं है। हम इसका उपयोग मैन्युअल रूप से शब्दों को डेटाबेस में अपलोड करने के लिए कर सकते हैं।
शब्द जोड़ने का टूल
यहाँ हम एक ऐसा टूल बनाते हैं जिसे AI एजेंट डेटाबेस में नए शब्द जोड़ने के लिए उपयोग कर सके। इस तरह, उपयोगकर्ता एजेंट को संदेश भेजकर आसानी से नए शब्द जोड़ सकते हैं।
यह कोड पिछले नोड से connect_to_database() और add_word() फ़ंक्शंस को पुनः उपयोग करता है। बेहतर Docker सेटअप के साथ, हम कोड दोहराने से बच सकते हैं, लेकिन इस ट्यूटोरियल के लिए हम इसे सरल ही रखेंगे।
इस टूल का कोड यहाँ है:
# from langflow.field_typing import Data
from langflow.custom import Component
from langflow.io import MessageTextInput, Output
from langflow.schema import Message
def connect_to_database():
# Connect to the Postgres database provided by the Docker setup
conn = psycopg2.connect(
dbname="langflow",
user="langflow",
password="langflow",
host="postgres",
port="5432"
)
conn.autocommit = True
return conn.cursor()
def add_word(cursor, word):
# Add a word to the database
cursor.execute(
"INSERT INTO words (word) VALUES (%s) ON CONFLICT (word) DO NOTHING;",
(word,)
)
class AddWordTool(Component):
display_name = "Add word tool"
description = "Use this tool to add a new word"
icon = "code"
name = "AddWordTool"
inputs = [
MessageTextInput(
name="word",
display_name="Word",
info="The word to add",
tool_mode=True,
),
]
outputs = [
Output(display_name="Output", name="output", method="add_new_word"),
]
def add_new_word(self) -> Message:
cursor = connect_to_database()
add_word(cursor, self.word)
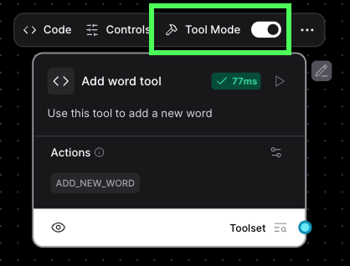
return f"Added word: {self.word}"ध्यान दें कि यह टूल मानकर चलता है कि डेटाबेस पहले से बनाया गया है। बिना पिछले कंपोनेंट को कम-से-कम एक बार चलाए यह काम नहीं करेगा।
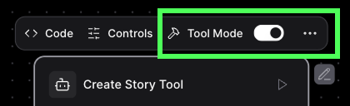
इसे टूल मोड में सेट करना न भूलें:
कहानी बनाने का टूल
कहानी बनाने के लिए, हम एक AI एजेंट कंपोनेंट का उपयोग करते हैं। संरचना इस प्रकार है:
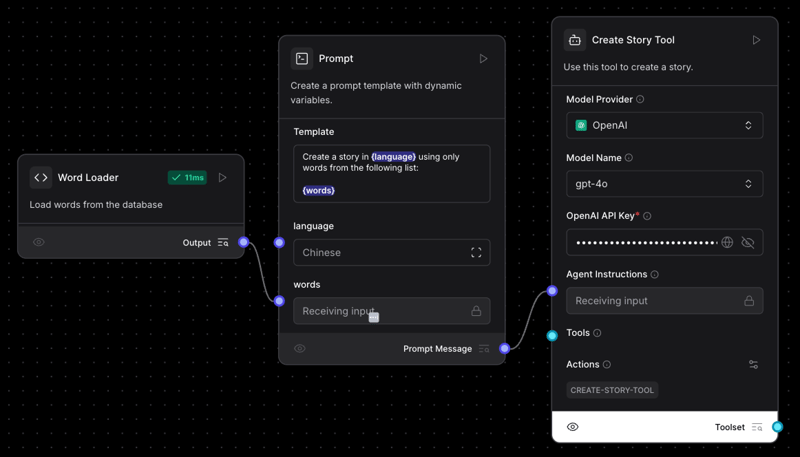
एजेंट निर्देशों में, प्रॉम्प्ट को सीधे कंपोनेंट में जोड़ने के बजाय, हमने Prompt कंपोनेंट का उपयोग किया क्योंकि इससे हम प्रॉम्प्ट में पैरामीटर जोड़ सकते हैं। हमने यह प्रॉम्प्ट उपयोग किया:
Create a story in {language} using only words from the following list:
{words}प्रॉम्प्ट में दो पैरामीटर हैं, {language} और {words}। ऐसे पैरामीटर जोड़ने पर, कंपोनेंट में प्रत्येक के लिए एक फ़ील्ड जुड़ जाता है।
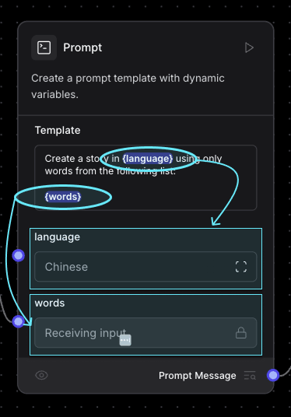
भाषा के मान के लिए, हमने इसे सीधे टेक्स्ट बॉक्स में सेट कर दिया। शब्दों को डेटाबेस से लोड करने की आवश्यकता है, इसलिए हमने एक कस्टम कंपोनेंट बनाया जो डेटाबेस से सभी शब्द लोड करता है, और उस नोड के आउटपुट को words फ़ील्ड से कनेक्ट कर दिया।
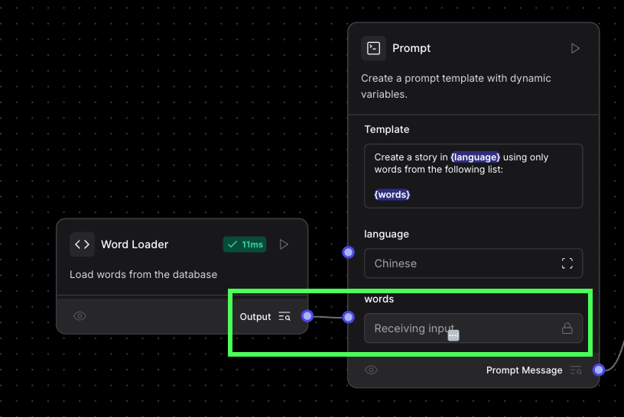
यहाँ वर्ड लोडर कंपोनेंट का कोड है:
from langflow.custom import Component
from langflow.io import MessageTextInput, Output
from langflow.schema import Message
import psycopg2
def load_words():
conn = psycopg2.connect(
dbname="langflow",
user="langflow",
password="langflow",
host="postgres",
port="5432"
)
cursor = conn.cursor()
cursor.execute("""
SELECT * FROM words;
""")
rows = cursor.fetchall()
return map(lambda row: row[0], rows)
class WordLoader(Component):
display_name = "Word Loader"
description = "Load words from the database"
icon = "code"
name = "WordLoader"
outputs = [
Output(display_name="Output", name="output", method="build_output"),
]
def build_output(self) -> Message:
return str(", ".join(load_words()))अगले चरण में, हमने एजेंट को एक टूल बना दिया। इस तरह, मुख्य एजेंट (जिसे हमने आगे बनाया) ज़रूरत पड़ने पर कहानी जनरेट करने के लिए इसका उपयोग कर सकेगा।
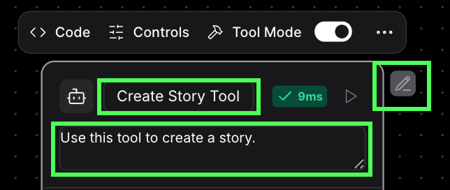
अंत में, हमने एजेंट का नाम बदला और टूल विवरण में यह बताया कि AI को यह टूल कब उपयोग करना चाहिए:
लैंग्वेज एजेंट
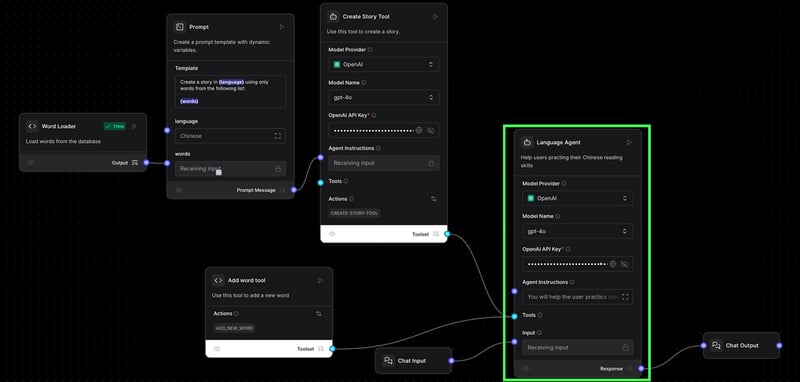
मुख्य एजेंट के लिए, हमने एक रेगुलर AI एजेंट नोड कंपोनेंट का उपयोग किया जिसे हमने बनाए गए दो टूल्स से जोड़ा। यह एजेंट चैट इनपुट और चैट आउटपुट कंपोनेंट्स का उपयोग करता है ताकि हम चैट इंटरफ़ेस के ज़रिए इसके साथ संवाद कर सकें।
अंतिम आर्किटेक्चर इस प्रकार है:
हमने जो प्रॉम्प्ट उपयोग किया वह था:
You will help the user practice their language skills. You will either be asked to create a story or to add a new word to the vocabulary.
- If the user asks you to create a story, use the story generation tool.
- If the user asks you to add a word, use the word add tool.
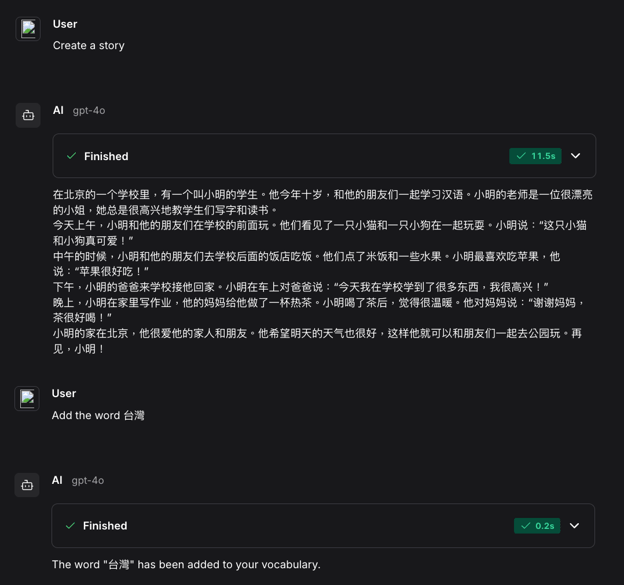
When using a tool, your answer should just be the result from the tool and nothing else.हम “Playground” बटन पर क्लिक करके पूरे वर्कफ़्लो को चला सकते हैं। यहाँ एक नमूना इंटरैक्शन है:
निष्कर्ष
हमने Langflow के मूलभूत पहलुओं की पड़ताल की और देखा कि कैसे इसका उपयोग ऐसे AI एजेंट वर्कफ़्लो बनाने में किया जा सकता है जो उपयोगकर्ताओं को उनकी रीडिंग स्किल्स का अभ्यास करने में मदद करता है। Python से कस्टम कंपोनेंट्स बनाकर, हम और अधिक संभावनाएँ खोलते हैं।
यह हाइब्रिड दृष्टिकोण दोनों दुनियाओं के सर्वश्रेष्ठ को जोड़ता है: Python स्क्रिप्ट्स की लचीलापन, जो किसी भी इच्छित कार्य को निष्पादित करने में सक्षम बनाती हैं, और Langflow का सहज ग्राफिकल इंटरफ़ेस, जो जटिल कोड में उतरे बिना वर्कफ़्लो निर्माण को सरल बनाता है।
AI एजेंट्स के बारे में अधिक जानने के लिए, मैं ये ब्लॉग पढ़ने की सलाह देता/देती हूँ:

Langflow एक लो-कोड टूल है जो हमें विभिन्न API का उपयोग करके AI एजेंट वर्कफ़्लो बनाने और कार्यों को स्वचालित करने की सुविधा देता है।
इस लेख में, मैं चरणबद्ध तरीके से समझाऊंगा कि Python का उपयोग करके कस्टम AI एजेंट वर्कफ़्लो बनाने के लिए Langflow का उपयोग कैसे करें। मैं आपको दिखाऊंगा कि एक ऐसा AI एजेंट कैसे बनाया जाए जो नई भाषा सीखते समय उपयोगकर्ता को उसकी रीडिंग स्किल्स का अभ्यास करने में मदद करे।
Langflow क्या है?
Langflow हमें अलग-अलग कंपोनेंट्स को जोड़कर बिना कोई कोड लिखे वर्कफ़्लो ऑटोमेट करने देता है। हर कंपोनेंट अन्य कंपोनेंट्स से आउटपुट प्राप्त करता है, कोई विशिष्ट एक्शन करता है, और फिर नया डेटा आउटपुट के रूप में देता है।
उदाहरण के लिए, जब हम AI चैटबॉट बनाते हैं, तो हम चैट इनपुट कंपोनेंट को किसी भाषा मॉडल (LLM) से कनेक्ट कर सकते हैं। LLM कंपोनेंट का आउटपुट फिर किसी अन्य चैट आउटपुट कंपोनेंट से जोड़ा जा सकता है।
प्रीडिफ़ाइंड कंपोनेंट्स के बड़े संग्रह के अलावा, हम Python का उपयोग करके कस्टम कंपोनेंट्स भी बना सकते हैं। उच्च स्तर पर, एक कस्टम कंपोनेंट एक Python फ़ंक्शन होता है जो कुछ इनपुट लेता है और कुछ डेटा आउटपुट करता है।
हम Python का उपयोग करके एक AI लैंग्वेज ट्यूटर बनाने के लिए कस्टम कंपोनेंट्स का उपयोग करना सीखेंगे। यदि आप बिना कोड के ऐसे वर्कफ़्लो बनाना चाहते हैं, तो मैं यह n8n ट्यूटोरियल देखने की सलाह देता/देती हूँ (n8n एक समान टूल है, और उस ट्यूटोरियल में मैं बताता/बताती हूँ कि बिना कोड के कैसे एक AI एजेंट बनाते हैं जो आपके ईमेल इनबॉक्स से बिल्स को ऑटोमैटिकली प्रोसेस करता है)।