

Supermemory Nedir?
Supermemory en iyi şekilde aracılar için bir yapay zekâ bellek API’si olarak tanımlanabilir. Kullanıcınızla ilgili metinler verdiğinizde, daha sonra o kullanıcının kim olduğuna ve yakın zamanda neler yaptığına dair derli toplu bir görünüm döndürür. Gömme, indeksleme ve getirme işlemlerinin tamamı Supermemory içinde çalışır, bu sayede aracı kodunuz küçük kalır.
LongMemEval kıyaslaması, bir bellek sisteminin uzun bir konuşma geçmişi üzerinden soruları ne kadar iyi yanıtladığını test eder. Supermemory doğru gerçeklerin %81,6’sını hatırlar. Bir sonraki en iyi sistem olan Zep %71,2 puan alır; bu 10 puanlık fark kabaca her 10 kullanıcı sorusunda 1 fazladan doğru yanıta denk gelir. Açık kaynak deposu 22 binden fazla GitHub yıldızına sahiptir; bu da gerçek kullanımın bir başka işaretidir.
Bellek vs RAG
Bir aracı bellek aracına yönelen çoğu okuyucu daha önce RAG kullanmıştır. Işleri netleştirmek için Supermemory’yi onun yanına koymak yardımcı olur. RAG ve bellek farklı sorunları çözer ve çoğunlukla aynı aracının içinde birlikte yaşarlar.
Bir RAG sistemi, geliştiricinin bir kez hazırladığı bir doküman külliyatına işaret eder. Ürün kılavuzları, destek makaleleri, dahili dokümanlar. Külliyat dağıtımda yüklenir, çalışırken sorgulanır ve nadiren değişir. Aracı, ürünün cevabını bildiği soruları yanıtlamak için bunu kullanır.
Bir bellek sistemi kullanıcıya işaret eder. Supermemory, aracı o kullanıcıyla konuşurken kullanıcıya özgü gerçekleri yazar ve mağaza her konuşmayla büyür. Aracı, tercihler, geçmiş ve son etkinlik gibi yalnızca kullanıcının cevaplayabileceği soruları yanıtlamak için bunu kullanır.
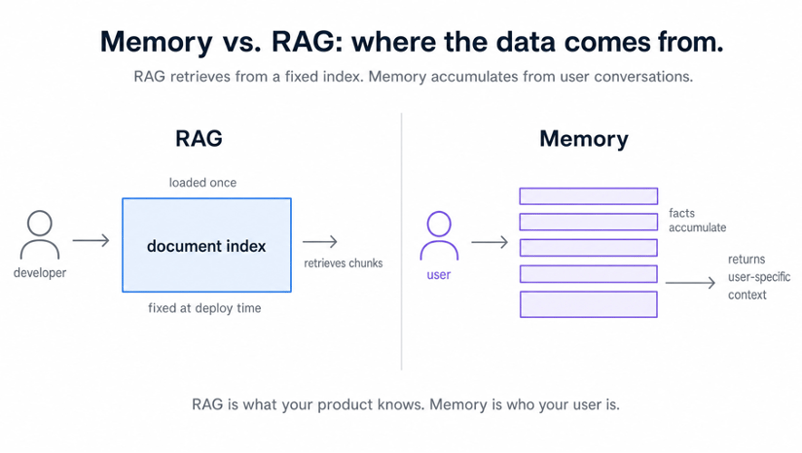
Gerçek bir üründe ikisi yan yana çalışır. Bir şirket bilgi tabanı üzerindeki RAG, "iade politikamız nedir?" sorusunu yanıtlar. Kullanıcının üzerinde ise Supermemory, "Geçen hafta bench press’im neydi?" sorusunu. Aynı aracı, iki veri deposu, iki iş.
Kullanıcı profilleri: statik ve dinamik gerçekler
Supermemory’nin ana fikri kullanıcı profilidir. Her kayıt iki kovaya ayrılır: nadiren değişen statik gerçekler ve güncel etkinliğe dair dinamik gerçekler. Tekrarlayan örüntüler statik tarafa terfi eder. Son etkinlik dinamikte kalır.
Aracı profili okuduğunda, tek bir çağrı iki kovayı da ve eşleşen bellek parçalarını döndürür.
Bölünme önemlidir çünkü statik ve dinamik gerçekler aynı kullanıcı hakkında farklı soruları yanıtlar:
|
Statik gerçekler |
Dinamik gerçekler |
|
Evde, dambıl ve barfiks barıyla antrenman yapar |
Güncel odak: üst vücut gücü |
|
Sol diz sakatlığı, derin çömelme yok |
Son bench: 185 lb ile 5 tekrarlı 4 set |
|
Yıl sonuna kadar bench’e 20 lb eklemek istiyor |
Bu hafta yağlama yöntemiyle barfikse odaklanıyor |
|
Sadece akşamları antrenman yapar, sabah asla |
Dün 5 km’yi 28 dakikada koştu |
Birinci satırı okuyun. Statik taraf, kullanıcının nasıl antrenman yaptığını söyler: evde, sahip olduğu ekipmanla. Bu haftadan haftaya değişmez. Dinamik taraf, şu anda neye odaklandığını söyler: bu döngüde üst vücut.
Bir antrenman önericisi her ikisine de ihtiyaç duyar. Statik taraf yalnızca spor salonunda yapılabilecek egzersizleri eler, dinamik taraf bugünkü seansı seçer.
Bu profilin arkasında Supermemory, normalde sizin inşa edeceğiniz dört işi yapar. Ham anıları saklar, her parçayı gömer, okuma anında benzerlik araması yapar ve kaydedilen içerikten profil gerçeklerini çıkarır. Dördünün de kodunuzda yeri yoktur.
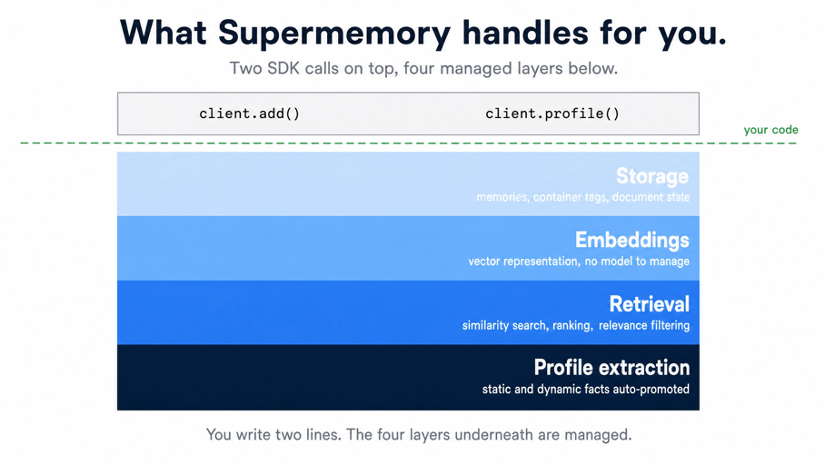
Her bellek, geliştiricinin seçtiği bir dizeyle etiketlenir. Her okuma, çıkanları sınırlamak için aynı dizeyi geri geçirir. Eğitmen, profilin ne yaptığını göstermek için bir kullanıcı yeterli olduğundan tek bir etiketi sabit kodlar. Gerçek uygulamalar etiketi kimliği doğrulanmış kullanıcıdan, örneğin JWT’lerinden, hesaplar.
Supermemory Ortamınızı Kurma
Eğitmenin iki API anahtarına (Supermemory ve OpenAI) ve üç bağımlılığı olan bir Python projesine ihtiyacı var. Hızlı bir gidiş-dönüş betiği, herhangi bir aracı kodu onlara dokunmadan önce iki anahtarın da çalıştığını kanıtlar.
API anahtarlarınızı alma
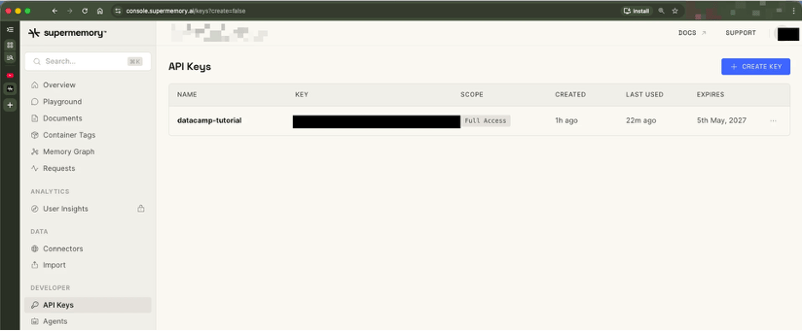
Supermemory API anahtarı şurada bulunur console.supermemory.ai, HAYIR app.supermemory.ai değil. app alt alan adı tüketici bellek ürünüdür (not kaydetme, alanınızı gezinme için). Bir API anahtarı sayfası yoktur. Bunu atlayın ve doğrudan konsola gidin.
Şurada console.supermemory.ai:
-
Oturum açın.
-
Kenar çubuğundan API Keys’e tıklayın.
-
Create API Key’e tıklayın.
-
Ad verin (eğitmen demosu
datacamp-tutorialkullanır). -
Oluşan anahtarı kopyalayın.
sm_ile başlar.
Aracının LLM çağrıları için bir OpenAI anahtarına da ihtiyacınız var. Henüz yoksa şuradan alın: platform.openai.com/api-keys.
Proje kök dizininizde her iki anahtarı içeren bir .env dosyası oluşturun. Bunu commit etmeyin.
SUPERMEMORY_API_KEY=sm_your_key_here
OPENAI_API_KEY=sk-your_key_hereSupermemory’nin ücretsiz katmanı, ödeme bilgisi girmeden bu eğitimi kapsar. Kesin limitler fiyatlandırma sayfasında yer alır.
Bağımlılıkların yüklenmesi
Eğitim, proje kurulumu ve yürütmesi için uv kullanır. uv yoksa, astral.sh/uv’deki tek satırlık komutla bir kez kurun.
Projeyi başlatın:
uv init supermemory-trainer
cd supermemory-trainerOtomatik oluşturulan README.md dosyasını silin; uv init ekler. Otomatik oluşturulan hello.py bir sonraki adımda üzerine yazılacağından şimdilik kalsın.
Üç bağımlılık ekleyin:
-
supermemory==3.37.0bellek istemcisidir; bu eğitim için doğrulanmış sürüme sabitlenmiştir. -
openai-agents, OpenAI Agents SDK’sıdır. Paket adı tirelidir, içe aktarma yolu
agents’tır. -
python-dotenv, az önce oluşturduğunuz.envdosyasını okur.
uv add supermemory==3.37.0 openai-agents python-dotenvOrtaya çıkan pyproject.toml:
[project]
name = "supermemory-trainer"
version = "0.1.0"
description = "Personal exercise trainer agent built with Supermemory and the OpenAI Agents SDK."
requires-python = ">=3.10"
dependencies = [
"openai-agents>=0.10.2",
"python-dotenv>=1.2.1",
"supermemory==3.37.0",
]Kurulumunuzu doğrulama
Herhangi bir aracı kodu yazmadan önce, Supermemory’nin tek bir cümlede işini bir kez yapmasını izleyin. Aşağıdaki betik bir gerçeği Supermemory’ye gönderir, hattı bekler ve ardından profili geri okur. Bu sorunsuz çalışırsa anahtarlar çalışıyor ve SDK erişilebilir demektir. Çıktı ayrıca Supermemory’nin ham metinle ne yaptığını ilk kez görmenizi sağlar.
Proje kök dizininde hello.py dosyasını açın ve otomatik oluşturulan gövdeyi içe aktarmalar ve bir yazma çağrısıyla değiştirin:
import time
from dotenv import load_dotenv
from supermemory import Supermemory
load_dotenv()
client = Supermemory()
USER_ID = "demo_warmup"
response = client.add(
content="The user is learning Supermemory by building a personal trainer agent.",
container_tag=USER_ID,
)
print(f"client.add() -> id={response.id} status={response.status}")load_dotenv() , .env dosyasından API anahtarını okur ve Supermemory() oluşturulmadan önce ortama yükler. İstemci SUPERMEMORY_API_KEY değerini otomatik olarak alır. container_tag="demo_warmup" değeri bu tek gerçeği geçici bir kullanıcıya sınırlar.
Şimdi aynı dosyanın altına bekleme ve okuma işlemini ekleyin:
print("Waiting 20 seconds for processing...")
time.sleep(20)
prof = client.profile(container_tag=USER_ID, q="learning")
print(f"profile.static ({len(prof.profile.static)}): {prof.profile.static}")
print(f"profile.dynamic ({len(prof.profile.dynamic)}): {prof.profile.dynamic}")
print(f"search_results.results ({len(prof.search_results.results)}):")
for r in prof.search_results.results[:3]:
print(f" - {r['memory']} (similarity={r['similarity']:.3f})")20 saniyelik bekleme, Supermemory’nin gömme ve çıkarma hattına yeni belleği işlemesi için zaman tanır. Olmadan okuma hiçbir şey döndürür ve betik bozukmuş gibi görünür, halbuki değildir.
Dosyayı çalıştırın:
uv run python hello.pyBeklenen çıktı:
client.add() -> id=zNLsJBrY1PZupAeZ3Qn6EL status=queued
Waiting 20 seconds for processing...
profile.static (0): []
profile.dynamic (1): ['Building a personal trainer agent to learn Supermemory.']
search_results.results (1):
- Building a personal trainer agent to learn Supermemory. (similarity=0.650)Bu çıktıda üç ayrıntı önemlidir. client.add() hemen status="queued" ile döner; çünkü Supermemory dokümanları eşzamansız işler. 20 saniyelik bekleme, gömme ve çıkarma hattını kapsar. Okuma çalıştığında ham cümle, aranabilir bir bellek parçası hâline gelmiştir.
İlginç satır profile.dynamic’tir. Girdi şu cümleydi: "The user is learning Supermemory by building a personal trainer agent." Çıktı ise dinamik gerçek 'Building a personal trainer agent to learn Supermemory.' oldu. Supermemory üçüncü tekil şahıs bir cümleyi kullanıcı hakkında birinci tekil şahıs bir gerçeğe dönüştürdü. Bu, profil çıkarıcının işini yaptığının göstergesidir.
profile.static boş bir listedir. Statik gerçekler yavaşça, bir dizi ilişkili kayıt biriktikten sonra konsolide olur; bu nedenle tek bir ısınma yazımı statik üretmez. Eğitmenin öneri aracı bunu öngörür ve static’i garanti değil, bonus olarak ele alır.
Bir Supermemory Aracısı Oluşturma: Python ile Kişisel Egzersiz Eğitmeni
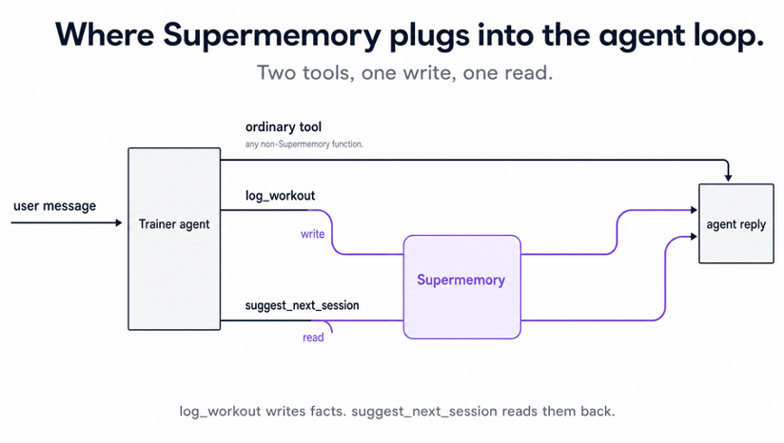
Eğitmen, client.add() ve client.profile() çağrılarını iki aracı aracına sarar; böylece kullanıcı sohbet ederken okumalar ve yazmalar otomatik gerçekleşir. Antrenman geçmişi belleğe iyi uyar. Ekipman, sakatlıklar ve son kaldırışlar LLM’in eğitim verilerinde yer almaz ve oturum oturum birikir.
Proje yapısı ve aracı
Eğitmen o kadar küçük ki tüm proje iki Python dosyasına ve zaten elinizde olan pyproject.toml dosyasına sığar:
supermemory-trainer/
├── .env # your real keys (gitignored)
├── .env.example # placeholders, committed
├── .gitignore
├── .python-version
├── main.py # agent definition, system prompt, REPL loop
├── pyproject.toml
└── tools.py # log_workout and suggest_next_sessiontools.py, az sonra yazacağınız iki bellek destekli aracı barındırır. log_workout, client.add() aracılığıyla bir antrenmanı Supermemory’ye yazar. suggest_next_session, client.profile() aracılığıyla kullanıcının profilini okur. main.py her ikisini içe aktarır ve aracıyı bağlar.
main.py’nin çoğu OpenAI Agents SDK şablonudur. Sistem yönergesindeki tek bir cümle Supermemory işini yapar: kullanıcıya dair her gerçek araç çağrılarıyla geri gelmelidir. Aracıya, kendi başına belleği olmadığı söylenir. Eğitmeni bellek destekli yapan tek kural budur.
main.py dosyasını açın ve içe aktarmalar ile sistem yönergesiyle başlayın:
import asyncio
from agents import Agent, Runner, SQLiteSession
from tools import log_workout, suggest_next_session
SYSTEM_PROMPT = """You are a personal exercise trainer who logs the user's
workouts and recommends what to do next.
You have no memory of the user's history on your own. Every fact about the
user lives in Supermemory and reaches you only through tool calls.
Two rules, no exceptions:
1. Whenever the user reports completing a workout, call log_workout immediately, before responding. Extract the exercise, sets, reps, weight, and any notes from what they said. If a value is missing, ask one short follow-up question instead of guessing. After logging, confirm in one short sentence and stop. Do NOT recommend the next session unless the user asks for one.
2. When the user explicitly asks what to do next (or asks for a recommendation, suggestion, or plan), call suggest_next_session first. Never recommend from your own training data. The tool returns the user's
recent activity, stable preferences, and matching past sessions. Reference those facts directly in your reply.
Keep replies concise (2-4 sentences). Be specific: name the exercise, sets, reps, and weight. Honor any injuries or equipment constraints the tool surfaces.
"""Sistem yönergesindeki her iki kural da modeli Supermemory üzerinden yönlendirir.
Kural 1, kullanıcı bir antrenmanı tamamladığını bildirdiğinde hemen log_workout çağrısını zorlar; böylece her antrenman bellek deposuna ulaşır. Kural 2, herhangi bir öneriden önce suggest_next_session okumayı zorlar; böylece her öneri Supermemory’nin bildiklerine dayanır.
Bu kuralları atlayın ve aracı yanıtlarını eğitim verilerinden verir; bu da bir bellek katmanının amacını boşa çıkarır.
Şimdi aynı dosyada aracı ve sohbet döngüsünü tanımlayın:
def build_agent() -> Agent:
return Agent(
name="Trainer",
instructions=SYSTEM_PROMPT,
tools=[log_workout, suggest_next_session],
model="gpt-5",
)
async def chat() -> None:
agent = build_agent()
session = SQLiteSession(session_id="trainer-cli")
print("Trainer ready. Type a message, or 'exit' to quit.\n")
while True:
try:
message = input("You: ").strip()
except (EOFError, KeyboardInterrupt):
print()
break
if not message:
continue
if message.lower() in {"exit", "quit"}:
break
result = await Runner.run(agent, message, session=session)
print(f"\nTrainer: {result.final_output}\n")
if __name__ == "__main__":
asyncio.run(chat())Bu blokta iki satır anılmaya değerdir. tools=[log_workout, suggest_next_session] iki bellek destekli aracı kaydeder. Her birinin üzerindeki @function_tool süsleyici (tools.py içinde) SDK’ya çağrılabilir olduklarını söyler. Süsleyici olmadan, kurulum çağrısı başarılı olsa bile aracı çalışma zamanında araca sahip olmaz.
SQLiteSession(session_id="trainer-cli"), kısa vadeli tur geçmişini çalışan Python süreci içinde tutar. Supermemory ise süreçler arasında uzun vadeli kullanıcı gerçeklerini saklar. Python sürecini sonlandırmak SQLite oturumunu düşürür; ancak Supermemory verileri kalır.
Önemli: main.py dosyasını bir betik olarak çalıştırın; bir Jupyter hücresinde değil; çünkü Jupyter’ın olay döngüsü asyncio.run() ile çakışır. Eşzamanlı Supermemory() istemcisi, Agents SDK araçları bir iş parçacığı havuzunda çalıştırdığından eşzamansız araç işlevleri içinde çalışır. SDK hakkında daha fazla bilgi için OpenAI Agents SDK eğitimi’ne bakın.
Antrenman kaydı aracını yazma
log_workout, aracının belleğinin yazma tarafıdır. İşlev aracıdan yapılandırılmış argümanlar alır: egzersiz adı, set, tekrar, ağırlık ve isteğe bağlı notlar. Bunları kısa bir İngilizce cümleye dönüştürür ve cümleyi client.add() üzerinden Supermemory’ye verir. Gömme ve çıkarma hattı bundan sonra Supermemory içinde çalışır ve eğitmenden hiçbir şey istemez.
tools.py dosyasını açın ve içe aktarmalar ile tek bir paylaşılan istemciyle başlayın:
from agents import function_tool
from dotenv import load_dotenv
from supermemory import Supermemory
load_dotenv()
USER_ID = "demo_user"
client = Supermemory()load_dotenv() içe aktarma anında çalışır; böylece SUPERMEMORY_API_KEY , Supermemory() oluşturulmadan önce ortamda bulunur. İstemciyi ortamı yüklemeden önce oluşturursanız kimlik doğrulamasız bir istemci elde edersiniz. İlk çağrı daha sonra kafa karıştırıcı bir 401 döndürür. Bu dosyadaki her iki araç işlevi de aynı istemciyi ve aynı USER_ID sabitini paylaşır.
İstemcinin altına kaydetme aracını ekleyin:
@function_tool
def log_workout(
exercise: str,
sets: int,
reps: int,
weight: float,
notes: str = "",
) -> str:
"""Log a completed workout to the user's memory.
Args:
exercise: Name of the exercise.
sets: Number of sets performed.
reps: Number of reps per set.
weight: Weight in pounds. Pass 0 for bodyweight or cardio.
notes: Optional notes about the session.
"""
print(f"[log_workout] {exercise=} {sets=} {reps=} {weight=} {notes=}")
content = f"Performed {exercise}: {sets} sets of {reps} reps at {weight} lbs."
if notes:
content += f" Notes: {notes}"
response = client.add(content=content, container_tag=USER_ID)
print(f"[log_workout] -> id={response.id} status={response.status}")
return f"Logged {exercise} ({sets}x{reps} @ {weight} lb)."@function_tool docstring’i, LLM’in aracıyı çağırıp çağırmamaya karar verirken gördüğüdür. Args: bloğu, parametre başına açıklamalara karşılık gelir. Her ikisi de aracının işleve olan sözleşmesinin parçasıdır.
Araç client.add()’e JSON değil, düz bir cümle gönderir. Supermemory’nin profil çıkarıcısı doğal dili okur ve bundan gerçekleri çıkarır. JSON teknik olarak çalışsa da, modelin özetleyeceği bir anlatı olmadığından çıkarım kalitesi düşer. "Performed bench press: 4 sets of 5 reps at 185.0 lbs" çıkarıcıya çalışacağı temiz bir cümle verir.
İki print() çağrısı her araç çağrısını terminale yazar: önce ayrıştırılmış argümanlar, sonra yanıt.
[log_workout] exercise='bench press' sets=4 reps=5 weight=185.0 notes=''
[log_workout] -> id=xY7AK3qLzBPx5Vd2HnRf1M status=queuedstatus="queued" değeri, ısınma betiğinin daha önce döndürdüğüyle eşleşir. Ham kayıt saklanır, ancak client.profile() hat bitene kadar arama sonucu olarak dönmez. Bunun yerleşmesini bekleyen bir doğrulama adımını daha sonra ekleyeceksiniz.
Antrenman önerisi aracını yazma
suggest_next_session okuma tarafıdır ve statik-dinamik ayrımının meyvesini verdiği yerdir. Tek bir client.profile(container_tag=USER_ID, q=focus) çağrısı, tek bir gidiş-dönüşte kullanıcıya dair üç görünüm döndürür.
Kalıcı tercihler profile.static olarak, güncel etkinlik profile.dynamic olarak ve en yakın eşleşen geçmiş anılar search_results.results olarak döner. Aracın işi, bu üç görünümü aracının alıntılayabileceği tek bir bağlam bloğuna düzleştirmektir.
Birkaç antrenmandan sonra araç şu çıktıyı üretir:
Recent activity:
- Trains at home instead of a gym
- Performed deadlift: 3 sets of 5 reps at 225.0 lbs
- Performed 5k run in 26 minutes
- Reports no knee pain during bench press
- Performed bench press: 4 sets of 5 reps at 185.0 lbs
Closest matching past entries:
- Trains at home instead of a gym
- Performed deadlift: 3 sets of 5 reps at 225.0 lbs
- Performed bench press: 4 sets of 5 reps at 185.0 lbs
- Performed 5k run in 26 minutes
- Reports no knee pain during bench pressAracı bu bloğu okur ve kullanıcının gerçek geçmişine dayalı bir öneri yazar. Supermemory’nin profili olmadan aynı bağlamı kendiniz oluştururdunuz. Bu da ayrı bir anlamsal arama, kendi profil deponuz ve sonuçların birleştirilmesi demektir. Tek bir client.profile() çağrısı bu üçünün yerini alır.
Bunu tools.py dosyasında log_workout’ın altına ekleyin:
@function_tool
def suggest_next_session(focus: str) -> str:
"""Fetch the user's training history and preferences for a given focus.
Returns a context string the agent can use to recommend the next session.
The agent is responsible for the actual recommendation. This tool only
surfaces what Supermemory knows about the user.
Args:
focus: What the user wants to train next (e.g. "upper body", "legs",
"cardio", "today"). Drives semantic search against past logs.
"""
print(f"[suggest_next_session] focus={focus!r}")
profile = client.profile(container_tag=USER_ID, q=focus)
static_facts = profile.profile.static
dynamic_facts = profile.profile.dynamic
matches = profile.search_results.results
print(
f"[suggest_next_session] static={len(static_facts)} "
f"dynamic={len(dynamic_facts)} matches={len(matches)}"
)
sections = []
if static_facts:
sections.append("Stable preferences and constraints:")
sections.extend(f"- {fact}" for fact in static_facts)
if dynamic_facts:
sections.append("Recent activity:")
sections.extend(f"- {fact}" for fact in dynamic_facts)
if matches:
sections.append("Closest matching past entries:")
for r in matches[:5]:
sections.append(f"- {r['memory']}")
if not sections:
return (
"No prior training history found for this user. "
"Ask the user about their goals, equipment, and recent training."
)
return "\n".join(sections)client.profile(container_tag=USER_ID, q=focus) bir ProfileResponse nesnesi döndürür. 5 kısa kayıttan sonra aracın okuduğu üç alan şöyle görünür:
profile.profile.static # [] (list[str])
profile.profile.dynamic # ["Performed bench press: 4 sets of 5 reps at 185.0 lbs", ...]
profile.search_results.results # [{"memory": "...", "similarity": 0.631, ...}, ...] (list[dict])Her arama sonucu bir Pydantic nesnesi değil, bir Python sözlüğüdür. Metin için r["memory"] ve puan için r["similarity"] kullanın. Tam sözlük şu anahtarlara sahiptir:
-
id -
memory -
rootMemoryId -
metadata -
updatedAt -
version -
similarity -
filepath -
documents
Supermemory’nin OpenAI Agents SDK entegrasyon sayfasındaki r.memory or r.chunk parçacığı, supermemory==3.37.0 ile AttributeError yükseltir. Köşeli parantez erişimini kullanın.
static burada boştur; bu nedenle araç if static_facts: üzerinde dallanır. İlk bir düzine kayıt için işi gerçekten dynamic ve search_results dalları yapar.
Supermemory ayrıca varsayılan bir benzerlik eşiği uygular. Bir kez bahsettiğiniz bir gerçek her sorgu için geri gelmeyebilir. Yukarıdaki 5 kayıt q="today" için geri döndü; ancak daha spesifik bir sorgu dizesi daha az sonuç döndürebilir. if matches: koruması, başarısız olmadan bunu ele alır.
1. oturumu çalıştırma: antrenmanları kaydetme
Oturum 1’i başlatın ve Supermemory’nin daha sonra geri okuyacağı bir şeylerle doldurmak için birkaç antrenman kaydedin. Betiği çalıştırın:
uv run python main.pyBench press, ardından 5 km koşu, ardından deadlift ve bir tercih ifadesi kaydedin: "Sadece evde antrenman yaparım, spor salonu yok." Aracı, her antrenman için bir kez log_workout tetikler ve aracın print() satırları her çağrıyı terminalde görünür kılar.
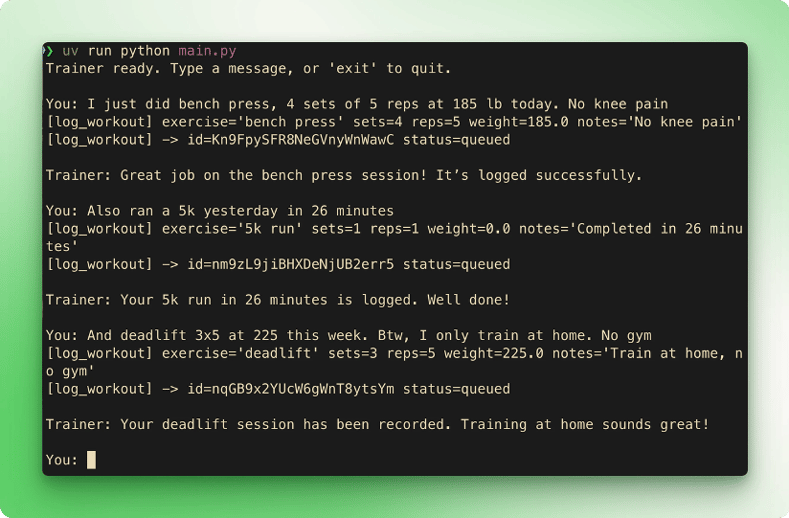
Örnek çıktı. Model belirleyici olmadığından aracınızın kesin ifadeleri farklı olacaktır.
Üç status=queued satırı, Supermemory’nin devraldığı andır. Her biri, Supermemory tarafında gömme ve çıkarma hattından geçen bir dokümana karşılık gelir. Bu tür kısa metin kayıtları için doküman, client.profile() üzerinden yaklaşık 12 saniye içinde aranabilir hâle gelir.
Eğitmenin kodunda bunu bekleyen hiçbir şey yoktur. Aracı devam eder ve Supermemory arka planda işi bitirir.
Her kayıt tam olarak bir log_workout çağrısı yapar ve aracı durur. Proaktif öneriler, ekstra araç çağrıları, takip önerileri yok. İlk sistem yönergesi kuralı bu işi yapar. Kural olmadan aracı, her kayıttan sonra bir sonraki seansı önerir ve araç çağrılarını ikiye katlardı.
exit yazarak oturum 1’i kapatın. Python süreci sona erer ve SQLiteSession onunla birlikte gider. Antrenman kayıtları ve tercih ifadesi artık komut dosyasından ayrı olarak container_tag="demo_user" altında Supermemory’de yaşıyor.
Geri çağırmayı doğrulama ve 2. oturumu çalıştırma
Oturum 2’den önce, oturum 1’den gelen gerçeklerin sorgulanabilir olduğunu doğrulayın. Yeni bir Python REPL açın veya bunu kısa bir betik olarak kaydedin:
from dotenv import load_dotenv
from supermemory import Supermemory
load_dotenv()
client = Supermemory()
prof = client.profile(container_tag="demo_user", q="training")
print(f"static ({len(prof.profile.static)}): {prof.profile.static}")
print(f"dynamic ({len(prof.profile.dynamic)}):")
for fact in prof.profile.dynamic:
print(f" - {fact}")
print(f"matches ({len(prof.search_results.results)}):")
for r in prof.search_results.results[:5]:
print(f" - {r['memory']} (similarity={r['similarity']:.3f})")İki oturum arasında yakalanan gerçek çıktı:
static (0): []
dynamic (5):
- Trains at home instead of a gym
- Performed deadlift: 3 sets of 5 reps at 225.0 lbs
- Performed 5k run in 26 minutes
- Reports no knee pain during bench press
- Performed bench press: 4 sets of 5 reps at 185.0 lbs
matches (5):
- Trains at home instead of a gym (similarity=0.682)
- Performed deadlift: 3 sets of 5 reps at 225.0 lbs (similarity=0.643)
- Performed bench press: 4 sets of 5 reps at 185.0 lbs (similarity=0.631)
- Performed 5k run in 26 minutes (similarity=0.585)
- Reports no knee pain during bench press (similarity=0.585)Supermemory’nin çıkarıcısının ürettiğine bakın. Kullanıcı bir kez "Sadece evde antrenman yaparım, spor salonu yok" dedi. Çıkarıcı bunu dinamik gerçek "Trains at home instead of a gym" hâline getirdi.
Bench press kaydı, dizde ağrı olmadığına dair bir not alanı içeriyordu. Çıkarıcı o tek kaydı iki dinamik gerçeğe böldü: biri antrenman için, biri ağrının yokluğu için.
Dört kayıt, 0,585 ile 0,682 arasında benzerlik puanlarına sahip beş normalleştirilmiş dinamik gerçeğe ve beş eşleşen bellek parçasına dönüştü. Bu bölme, normalleştirme veya eşleştirmenin hiçbiri eğitmenin kodunda çalışmadı. Sizde dynamic boşsa 10 saniye daha bekleyin ve parçacığı tekrar çalıştırın. İşleme kuyruğu ara sıra yükselir.
Şimdi tamamen yeni bir süreçte 2. oturumu başlatın:
uv run python main.pyBu yepyeni bir Python yorumlayıcısıdır. Oturum 1 ile paylaşılan bellek yok. Sıcak önbellek yok. Aracının hatırladığı her şey Supermemory’den gelir.
Tek bir mesaj gönderin: "Bugünkü antrenmanım için ne yapmalıyım?"
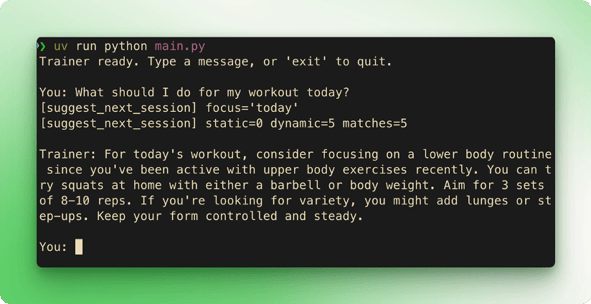
Örnek çıktı. Aynı bellek deposu, taze Python süreci.
Aracı suggest_next_session("today") çağırır. Araç static=0 dynamic=5 matches=5 yazdırır. Yakalanan çalıştırma, evde alt vücut seansı (squat, lunge, step-up) ile yanıt verdi.
Öneri, Supermemory’nin profili aracıya bunları söylediği için önceki kayıtlarla hizalandı. Bench, deadlift ve 5 km koşu üst vücut veya kardiyoydu ve kullanıcı sadece evde antrenman yapıyordu. Her iki gerçek de aynı client.profile() çağrısından geri geldi. Model belirleyici olmadığından sizin çalıştırmanız farklı ifade edebilir; ancak hatırlama yolu aynıdır.
Supermemory Aracınız İçin Sonraki Adımlar
Demo bir kullanıcı, iki araç ve bir CLI’dır. Eğitmenin gerçek bir sürümü, aracı döngüsüne dokunmadan önce üç Supermemory şekilli yönde genişler.
Belleği gerçek kullanıcıya göre kapsamlayın. USER_ID = "demo_user" sabiti bir kişi için çalışır. Üretim uygulamaları etiketi kimliği doğrulanmış kullanıcının kimliğinden üretir; ör. container_tag="user_sarah" veya container_tag=customer_id. Kullanıcılar arasındaki bellek ayrıdır; çünkü her okuma etiketi geri geçirir. tools.py içinde tek bir değişiklik; başka kod oynamaz.
Daha fazla bellek destekli araç ekleyin. Deload haftaları, PR takibi ve haftalık mobilite hatırlatıcıları. Her biri, yazmalar için @function_tool işlevi ve okumalar için aynı container_tag karşısında client.add() ve client.profile() çağrılarıdır. Aracın biçimi aynı kalır. Yalnızca aracının kaydettiği ve sorduğu şey değişir.
Supermemory hatalarını yönetin. client.add() ve client.profile() çağrılarını try/except supermemory.APIError içine sarın; böylece Supermemory’den gelen geçici hatalar aracıyı çökertmesin. Aracınız kısıtlı bir ortamda çalışıyorsa istek başına zaman aşımı belirleyin.
Aracı döngüsü tarafındaki çalışma, Supermemory’den bağımsızdır ve daha sonra değişebilir. CLI’nın önüne Telegram, Discord veya Slack koyun; böylece kullanıcı bir antrenmanı mesaj atar ve bot Runner.run() çağırır. Veya çerçeveyi değiştirin. Yığınınız zaten LangChain entegrasyonunda ise ve LangChain aracıları üzerindeyse Supermemory’nin bir entegrasyonu vardır ve bellek kodu değişmez.
Statik-dinamik ayrımı diğer alanlara da uyar.
- Müşteri destek aracısı: statik = bilinen sorunlar ve hesap tercihleri, dinamik = açık biletler ve son temaslar.
- Kodlama aracısı: statik = tercih edilen diller ve çerçeveler, dinamik = güncel görev ve son dokunulan dosyalar.
Kullanıcının hakikat kaynağı olduğu her yerde bu ayrım geçerlidir.
Sonuç
İki araçlı ve süreçler arasında kalıcı belleğe sahip bir Python eğitmeni oluşturdunuz. client.add() antrenmanları yazar. client.profile() kullanıcıyı tek çağrıda statik gerçekler, dinamik gerçekler ve anlamsal eşleşmeler olarak okur; hepsi container_tag ile kapsamlanır. Supermemory, demonun hiç yazmak zorunda kalmadığı parçalama, gömme, arama ve profil çıkarımı işlemlerini yapar.
Bunu RAG ile eşleştirin; aynı aracı hem kullanıcı hem de ürün hakkında soruları yanıtlasın. LLM Aracılar Açıklandı daha geniş aracı kalıplarını kapsar ve Geliştiriciler için Associate AI Engineer rotası bellek destekli aracılara daha derinlemesine iner.
Supermemory SSS
Supermemory nedir?
Supermemory, yapay zekâ aracıları için, kullanıcıları oturumlar arasında hatırlayabilmeleri amacıyla uzun vadeli bağlamı depolayan, indeksleyen ve getiren barındırılan bir bellek API’sidir.
Supermemory düz vektör veritabanlarından nasıl farklıdır?
Supermemory, depolamanın üzerine gömme, indeksleme, anlamsal arama ve profil tarzı gerçek çıkarımı ekler; böylece tek bir API çağrısıyla kullanılabilir anılar elde edersiniz.
Supermemory hem RAG’i hem de kullanıcı belleğini yönetebilir mi?
Evet, dosyalar ve URL’ler üzerinden doküman tarzı RAG’i ve kullanıcı odaklı anıları destekler; böylece aynı API, ürün bilgisini ve kişisel geçmişi güçlendirebilir.
Supermemory ile kendi gömme modellerimi yönetmem gerekir mi?
Hayır, Supermemory sizin için gömme ve getirme hattını çalıştırır; ham metin veya içerik gönderirsiniz ve daha sonra modelleri ya da indeksleri kendiniz yönetmeden sorgularsınız.
Supermemory’i denemek için ücretsiz bir katman var mı?
Evet, test ve küçük projeler için tasarlanmış, entegrasyon ve denemeyi yükseltmeden önce yapabilmeniz için aylık token ve sorgu limitlerine sahip ücretsiz bir plan vardır.

2 yılı aşkın deneyime sahip bir veri bilimi içerik üreticisiyim ve Medium’da en büyük takipçi kitlelerinden birine sahibim. Yapay zekâ ve makine öğrenimi üzerine, biraz da alaycı bir üslupla yazılmış, ayrıntılı makaleler kaleme almayı seviyorum; çünkü onları biraz daha az sıkıcı hale getirmek için bir şeyler yapmak gerekiyor. 130’un üzerinde makale ve bir de DataCamp kursu ürettim; bir diğeri de hazırlık aşamasında. İçeriklerim 5 milyondan fazla kişi tarafından görüldü; bunların 20 bini Medium ve LinkedIn’de takipçim oldu.
Çoğu LLM aracısı her çalıştırmada sıfırdan başlar. Kullanıcının adını, son konuşmasını ve üzerinde çalıştığı dosyayı unutur. Kullanıcıya özgü her şey her turda yeniden kurulmak zorundadır.
Bu eğitim, bir aracının bir sonraki çalıştırmasının kaldığı yerden başlamasını sağlamak için kalıcı bellek ekler. Bellek katmanı, kullanıcı başına gerçekleri saklayan ve tek çağrıda döndüren barındırılan bir Supermemory API’sidir. Python’da kişisel bir egzersiz eğitmeni oluşturacaksınız. Aracı antrenmanları kaydeder, bir sonraki seansı önerir ve komut dosyasının ayrı çalıştırmaları arasında tercihleri ve son kaldırışları hatırlar.
Yığın küçük. Belleği Supermemory tutar. OpenAI Agents SDK aracı döngüsünü çalıştırır. Eğitmen iki Python dosyası ve bir
pyproject.tomldosyasından oluşur.Python 3.10 veya üstü, bir OpenAI hesabı, bir Supermemory hesabı ve komut satırında temel rahatlık gerekir.