Lernpfad
Associate AI Engineer für Entwickler
26 Std.
Supermemory lässt sich am besten als KI-Gedächtnis-API für Agenten beschreiben. Übergibst du Supermemory Texte über deinen Nutzer, liefert es später eine kompakte Sicht darauf zurück, wer dieser Nutzer ist und was er zuletzt getan hat. Embedding, Indexierung und Retrieval laufen komplett in Supermemory, sodass dein Agent-Code schlank bleibt.
Der LongMemEval-Benchmark testet, wie gut ein Speichersystem Fragen über einen langen Gesprächsverlauf hinweg beantwortet. Supermemory ruft 81,6 % der richtigen Fakten ab. Zep, das nächstbeste System, erreicht 71,2 % – eine Lücke von 10 Punkten, die grob einem zusätzlichen korrekten Treffer pro 10 Nutzerfragen entspricht. Das Open-Source-Repository hat 22k+ GitHub-Sterne, ein weiteres Signal für echte Nutzung.
Die meisten, die nach einem Agenten-Gedächtnistool greifen, haben zuvor schon RAG verwendet. Es hilft, Supermemory daneben zu stellen. RAG und Memory lösen unterschiedliche Probleme und laufen oft im selben Agenten zusammen.
Ein RAG-System verweist auf einen Dokumentenkorpus, den die Entwickelnden einmalig vorbereiten. Produkt-Handbücher, Support-Artikel, interne Dokus. Der Korpus wird zur Bereitstellung geladen, zur Laufzeit abgefragt und ändert sich selten. Der Agent nutzt ihn, um Fragen zu beantworten, die das Produkt selbst beantworten kann.
Ein Memory-System richtet sich auf den Nutzer. Supermemory schreibt nutzerspezifische Fakten, während der Agent mit dieser Person spricht, und der Speicher wächst mit jedem Gespräch. Der Agent nutzt ihn für Antworten, die nur der Nutzer liefern kann – Vorlieben, Historie, aktuelle Aktivität.
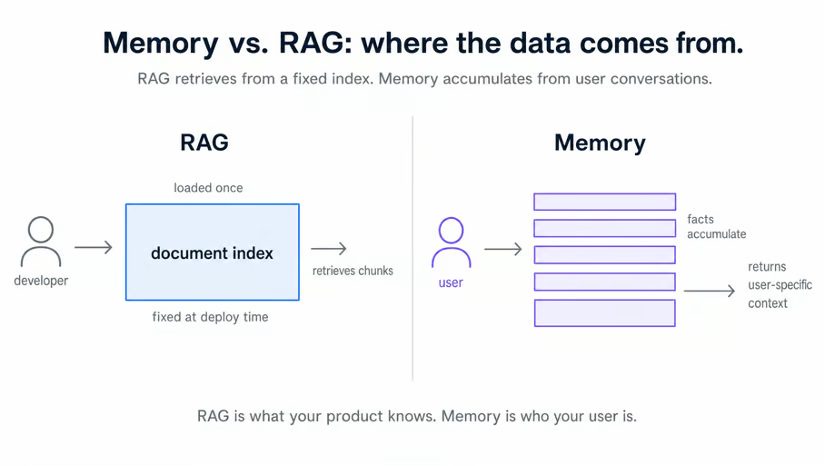
Im realen Produkt laufen beide nebeneinander. RAG über die Wissensbasis des Unternehmens beantwortet „Wie ist unsere Rückerstattungsrichtlinie?“. Supermemory über den Nutzer beantwortet „Was war mein Bankdrücken letzte Woche?“. Derselbe Agent, zwei Datenspeicher, zwei Aufgaben.
Die zentrale Idee von Supermemory ist das Nutzerprofil. Jeder Log wird in zwei Bereiche einsortiert: statische Fakten, die sich selten ändern, und dynamische Fakten zur aktuellen Aktivität. Wiederkehrende Muster wandern in die statische Seite. Aktuelle Aktivität bleibt in der dynamischen.
Beim Lesen des Profils liefert ein Aufruf beide Bereiche plus die passenden Memory-Chunks zurück.
Die Trennung ist wichtig, weil statische und dynamische Fakten unterschiedliche Fragen über denselben Nutzer beantworten:
|
Statische Fakten |
Dynamische Fakten |
|
Trainiert zu Hause mit Kurzhanteln und Klimmzugstange |
Aktueller Fokus: Oberkörperkraft |
|
Verletzung linkes Knie, keine tiefen Kniebeugen |
Letztes Bankdrücken: 4 Sätze à 5 Wiederholungen mit 185 lb |
|
Will bis Jahresende 20 lb beim Bankdrücken drauflegen |
Diese Woche „Grease-the-Groove“-Klimmzüge |
|
Trainiert nur abends, nie morgens |
Gestern 5 km in 28 Minuten gelaufen |
Lies Zeile eins. Die statische Seite beschreibt, wie der Nutzer trainiert: zu Hause, mit dem vorhandenen Equipment. Das ändert sich nicht von Woche zu Woche. Die dynamische Seite sagt, woran er gerade arbeitet: Oberkörper, in diesem Zyklus.
Ein Workout-Vorschlag braucht beides. Die statische Seite schließt reine Studio-Übungen aus, die dynamische wählt die heutige Einheit.
Hinter dem Profil erledigt Supermemory vier Aufgaben, die du sonst selbst bauen würdest: Rohspeicher, Embeddings für jeden Chunk, Similarity Search beim Lesen und das Extrahieren von Profilfakten aus geloggten Inhalten. Nichts davon taucht in deinem Code auf.
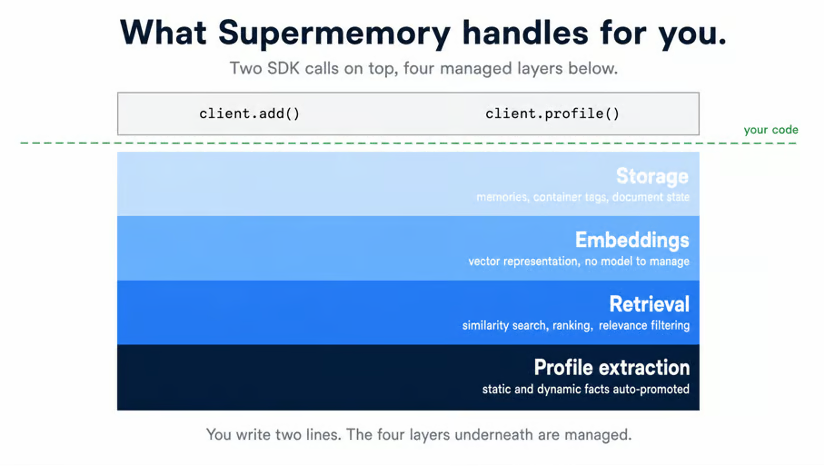
Jede Erinnerung ist mit einem String getaggt, den die Entwickler festlegen. Jeder Lesevorgang gibt denselben String zurück, um die Ausgabe zu begrenzen. Der Trainer hardcodiert ein Tag, weil eine Person reicht, um das Profil zu demonstrieren. Echte Apps berechnen das Tag aus dem authentifizierten Nutzer, zum Beispiel aus seinem JWT.
Der Trainer braucht zwei API-Schlüssel (Supermemory und OpenAI) und ein Python-Projekt mit drei Abhängigkeiten. Ein kurzer Roundtrip-Skriptlauf bestätigt, dass beide Schlüssel funktionieren, bevor Agent-Code sie nutzt.
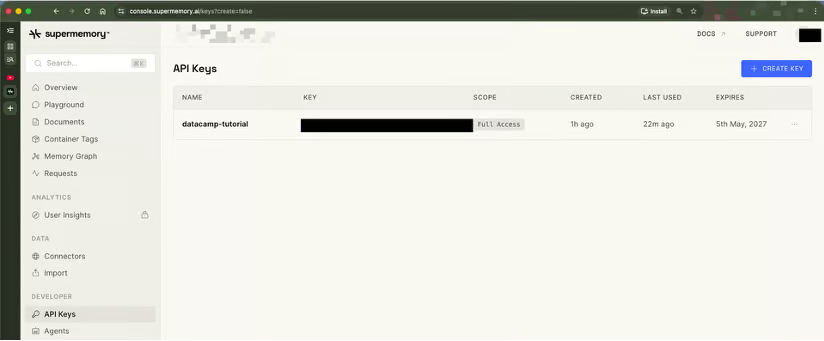
Der Supermemory-API-Schlüssel liegt unter console.supermemory.ai, NICHT unter app.supermemory.ai. Die Subdomain app ist das Consumer-Produkt (Notizen speichern, Space durchsuchen). Dort gibt es keine API-Key-Seite. Überspringe sie und gehe direkt in die Konsole.
Auf console.supermemory.ai:
Melde dich an.
Klicke in der Seitenleiste auf API Keys.
Klicke auf Create API Key.
Benenne ihn (die Trainer-Demo nutzt datacamp-tutorial).
Kopiere den Schlüssel. Er beginnt mit sm_.
Für die LLM-Aufrufe des Agenten brauchst du außerdem einen OpenAI-Schlüssel. Hol ihn dir unter platform.openai.com/api-keys, falls du noch keinen hast.
Lege im Projektroot eine .env-Datei mit beiden Schlüsseln an. Nicht committen.
SUPERMEMORY_API_KEY=sm_your_key_here
OPENAI_API_KEY=sk-your_key_here
Das Free-Tier von Supermemory reicht für dieses Tutorial aus, ohne Zahlungsdaten einzugeben. Exakte Limits findest du auf der Preisseite.
Das Tutorial nutzt uv für Projekt-Setup und Ausführung. Falls du uv noch nicht hast, installiere es einmalig mit dem Einzeiler von astral.sh/uv.
Initialisiere das Projekt:
uv init supermemory-trainer
cd supermemory-trainer
Lösche die automatisch erzeugte README.md, die uv init anlegt. Die generierte hello.py wird im nächsten Schritt überschrieben – lass sie vorerst liegen.
Füge drei Abhängigkeiten hinzu:
supermemory==3.37.0 ist der Memory-Client, auf die für dieses Tutorial verifizierte Version gepinnt.
openai-agents ist das OpenAI Agents SDK. Der Paketname ist mit Bindestrich, der Importpfad lautet agents.
python-dotenv liest die .env-Datei, die du eben erstellt hast.
uv add supermemory==3.37.0 openai-agents python-dotenvDie resultierende pyproject.toml:
[project]
name = "supermemory-trainer"
version = "0.1.0"
description = "Personal exercise trainer agent built with Supermemory and the OpenAI Agents SDK."
requires-python = ">=3.10"
dependencies = [
	"openai-agents>=0.10.2",
	"python-dotenv>=1.2.1",
	"supermemory==3.37.0",
]Bevor du Agent-Code schreibst, beobachte Supermemory einmal bei der Arbeit an einem einzelnen Satz. Das Skript unten sendet eine Tatsache an Supermemory, wartet auf die Pipeline und liest dann das Profil zurück. Läuft das sauber durch, sind die Schlüssel korrekt und das SDK erreichbar. Die Ausgabe gibt dir außerdem einen ersten Eindruck, was Supermemory mit Rohtext macht.
Öffne hello.py im Projektroot und ersetze den Autocode durch die Importe und einen Schreibaufruf:
import time

from dotenv import load_dotenv
from supermemory import Supermemory

load_dotenv()

client = Supermemory()
USER_ID = "demo_warmup"

response = client.add(
	content="The user is learning Supermemory by building a personal trainer agent.",
	container_tag=USER_ID,
)
print(f"client.add() -> id={response.id} status={response.status}")
load_dotenv() liest den API-Schlüssel aus der .env in die Umgebung, bevor Supermemory() konstruiert wird. Der Client nimmt SUPERMEMORY_API_KEY automatisch auf. Der Wert container_tag="demo_warmup" scoped diese einzelne Tatsache auf einen Wegwerf-Nutzer.
Füge nun unten in derselben Datei das Warten und den Lesevorgang hinzu:
print("Waiting 20 seconds for processing...")
time.sleep(20)

prof = client.profile(container_tag=USER_ID, q="learning")
print(f"profile.static  ({len(prof.profile.static)}): {prof.profile.static}")
print(f"profile.dynamic ({len(prof.profile.dynamic)}): {prof.profile.dynamic}")
print(f"search_results.results ({len(prof.search_results.results)}):")
for r in prof.search_results.results[:3]:
	print(f"  - {r['memory']} (similarity={r['similarity']:.3f})")
Der 20-Sekunden-Sleep gibt Supermemorys Embed-and-Extract-Pipeline Zeit, die neue Erinnerung zu verarbeiten. Ohne ihn kommt beim Lesen nichts zurück und das Skript wirkt kaputt, obwohl es das nicht ist.
Führe die Datei aus:
uv run python hello.pyErwartete Ausgabe:
client.add() -> id=zNLsJBrY1PZupAeZ3Qn6EL status=queued
Waiting 20 seconds for processing...
profile.static  (0): []
profile.dynamic (1): ['Building a personal trainer agent to learn Supermemory.']
search_results.results (1):
  - Building a personal trainer agent to learn Supermemory. (similarity=0.650)
Drei Details sind hier wichtig. client.add() gibt sofort mit status="queued" zurück, weil Supermemory Dokumente asynchron verarbeitet. Die 20 Sekunden decken die Embed-and-Extract-Pipeline ab. Bis zum Leseaufruf ist der Rohsatz ein durchsuchbarer Memory-Chunk.
Spannend ist die Zeile profile.dynamic. Der Input war der Satz „The user is learning Supermemory by building a personal trainer agent." Die Ausgabe ist die dynamische Tatsache 'Building a personal trainer agent to learn Supermemory.'. Supermemory hat den Satz aus dritter Person in eine Ich-bezogene Nutzerfaktum umgeschrieben. Das ist der Profil-Extractor bei der Arbeit.
profile.static ist leer. Statische Fakten konsolidieren sich langsamer, nachdem sich mehrere verwandte Logs sammeln. Ein einzelner Warm-up-Write liefert daher keinen. Das Vorschlagstool des Trainers plant das ein und behandelt static als Bonus statt als Garantie.
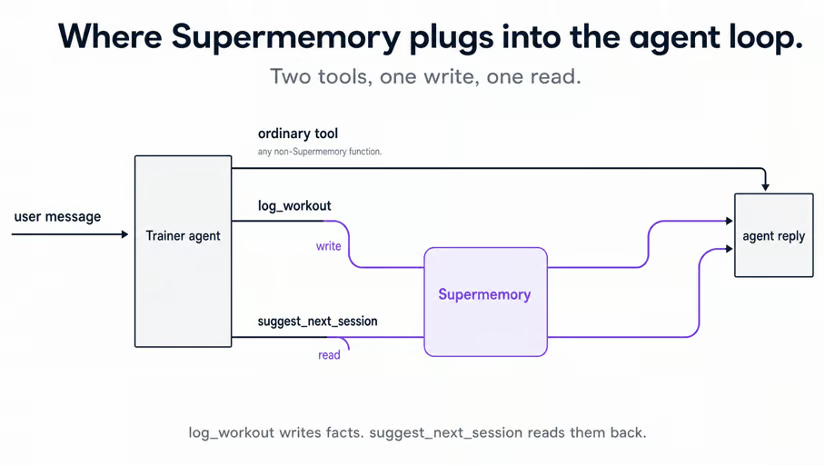
Der Trainer kapselt client.add() und client.profile() in zwei Agent-Tools, sodass Lesen und Schreiben während des Chats automatisch passieren. Trainingstagebücher passen perfekt zu Memory. Equipment, Verletzungen und letzte Leistungen stehen nicht im Trainingsdatensatz des LLM und sammeln sich Sitzung für Sitzung.
Der Trainer ist klein genug, dass das gesamte Projekt in zwei Python-Dateien plus der vorhandenen pyproject.toml Platz hat:
supermemory-trainer/
├── .env            	# your real keys (gitignored)
├── .env.example    	# placeholders, committed
├── .gitignore
├── .python-version
├── main.py         	# agent definition, system prompt, REPL loop
├── pyproject.toml
└── tools.py        	# log_workout and suggest_next_session
tools.py enthält die zwei speichergestützten Tools, die du gleich schreibst. log_workout schreibt ein Workout via client.add() in Supermemory. suggest_next_session liest das Nutzerprofil via client.profile(). main.py importiert beide und verdrahtet den Agenten.
Der Großteil von main.py ist OpenAI-Agents-SDK-Boilerplate. Ein Satz im System-Prompt erledigt die Supermemory-Arbeit: Jede Tatsache über den Nutzer muss über Tool-Aufrufe zurückkommen. Der Agent hat kein eigenes Gedächtnis. Diese eine Regel macht den Trainer speichergestützt.
Öffne main.py und beginne mit den Importen und dem System-Prompt:
import asyncio

from agents import Agent, Runner, SQLiteSession

from tools import log_workout, suggest_next_session

SYSTEM_PROMPT = """You are a personal exercise trainer who logs the user's
workouts and recommends what to do next.

You have no memory of the user's history on your own. Every fact about the
user lives in Supermemory and reaches you only through tool calls.

Two rules, no exceptions:

1. Whenever the user reports completing a workout, call log_workout immediately, before responding. Extract the exercise, sets, reps, weight, and any notes from what they said. If a value is missing, ask one short follow-up question instead of guessing. After logging, confirm in one short sentence and stop. Do NOT recommend the next session unless the user asks for one.

2. When the user explicitly asks what to do next (or asks for a recommendation, suggestion, or plan), call suggest_next_session first. Never recommend from your own training data. The tool returns the user's
 recent activity, stable preferences, and matching past sessions. Reference those facts directly in your reply.

Keep replies concise (2-4 sentences). Be specific: name the exercise, sets, reps, and weight. Honor any injuries or equipment constraints the tool surfaces.
"""
Beide Regeln im System-Prompt leiten das Modell durch Supermemory.
Regel 1 zwingt zu einem log_workout-Write, wenn der Nutzer ein Workout meldet, damit wirklich jedes Workout im Speicher landet. Regel 2 zwingt zu einem suggest_next_session-Read vor jeder Empfehlung, damit jede Empfehlung auf dem Wissen von Supermemory basiert.
Ohne diese Regeln antwortet der Agent aus seinen Trainingsdaten – und das konterkariert die Memory-Ebene.
Definiere nun den Agenten und die Chat-Loop in derselben Datei:
def build_agent() -> Agent:
	return Agent(
    	name="Trainer",
    	instructions=SYSTEM_PROMPT,
    	tools=[log_workout, suggest_next_session],
    	model="gpt-5",
	)


async def chat() -> None:
	agent = build_agent()
	session = SQLiteSession(session_id="trainer-cli")

	print("Trainer ready. Type a message, or 'exit' to quit.\n")
	while True:
    	try:
        	message = input("You: ").strip()
    	except (EOFError, KeyboardInterrupt):
        	print()
        	break
    	if not message:
        	continue
    	if message.lower() in {"exit", "quit"}:
        	break

    	result = await Runner.run(agent, message, session=session)
    	print(f"\nTrainer: {result.final_output}\n")


if __name__ == "__main__":
	asyncio.run(chat())
Zwei Zeilen sind hier nennenswert. tools=[log_workout, suggest_next_session] registriert die beiden speichergestützten Tools. Der @function_tool-Decorator auf jedem (in tools.py) teilt dem SDK mit, dass sie aufrufbar sind. Ohne Decorator hat der Agent zur Laufzeit keine Tools, auch wenn die Konstruktion gelingt.
SQLiteSession(session_id="trainer-cli") hält kurzfristige Turn-Historie im laufenden Python-Prozess. Supermemory hält langfristige Nutzerfakten prozessübergreifend. Beendest du den Python-Prozess, ist die SQLite-Session weg – die Supermemory-Daten bleiben.
Wichtig: Führe main.py als Skript aus, nicht in einer Jupyter-Zelle, da Jupyters Event-Loop mit asyncio.run() kollidiert. Der synchrone Supermemory()-Client funktioniert in asynchronen Tool-Funktionen, weil das Agents SDK Tools im Threadpool ausführt. Mehr zum SDK findest du im OpenAI Agents SDK Tutorial.
log_workout ist die Schreibseite des Agentengedächtnisses. Die Funktion nimmt strukturierte Argumente vom Agenten: Übungsname, Sätze, Wiederholungen, Gewicht und optionale Notizen. Daraus wird ein kurzer englischer Satz, der über client.add() an Supermemory übergeben wird. Die Embed-and-Extract-Pipeline läuft anschließend in Supermemory und braucht nichts vom Trainer.
Öffne tools.py und starte mit den Importen und einem geteilten Client:
from agents import function_tool
from dotenv import load_dotenv
from supermemory import Supermemory

load_dotenv()

USER_ID = "demo_user"

client = Supermemory()
load_dotenv() läuft beim Import, damit SUPERMEMORY_API_KEY in der Umgebung steht, bevor Supermemory() konstruiert wird. Konstruktion vor dem Env-Load ergibt einen nicht authentifizierten Client. Der erste Aufruf liefert dann verwirrend ein 401. Beide Tool-Funktionen in dieser Datei teilen sich diesen einen Client und die eine USER_ID-Konstante.
Füge unter dem Client das Logging-Tool hinzu:
@function_tool
def log_workout(
	exercise: str,
	sets: int,
	reps: int,
	weight: float,
	notes: str = "",
) -> str:
	"""Log a completed workout to the user's memory.

	Args:
    	exercise: Name of the exercise.
    	sets: Number of sets performed.
    	reps: Number of reps per set.
    	weight: Weight in pounds. Pass 0 for bodyweight or cardio.
    	notes: Optional notes about the session.
	"""
	print(f"[log_workout] {exercise=} {sets=} {reps=} {weight=} {notes=}")

	content = f"Performed {exercise}: {sets} sets of {reps} reps at {weight} lbs."
	if notes:
    	content += f" Notes: {notes}"

	response = client.add(content=content, container_tag=USER_ID)
	print(f"[log_workout] -> id={response.id} status={response.status}")
	return f"Logged {exercise} ({sets}x{reps} @ {weight} lb)."
Der @function_tool-Docstring ist das, was das LLM sieht, wenn es entscheidet, ob es das Tool aufruft. Der Args:-Block beschreibt die Parameter. Beides ist Teil des Vertrags zwischen Agent und Funktion.
Das Tool sendet einen einfachen Satz an client.add(), kein JSON. Der Profil-Extractor von Supermemory liest natürliche Sprache und leitet Fakten daraus ab. JSON funktioniert technisch, senkt aber die Extraktionsqualität, weil dem Modell die Erzählstruktur fehlt. „Performed bench press: 4 sets of 5 reps at 185.0 lbs“ liefert einen sauberen Satz für den Extractor.
Die zwei print()-Aufrufe schreiben jede Tool-Invocation ins Terminal: zuerst die geparsten Argumente, dann die Response.
[log_workout] exercise='bench press' sets=4 reps=5 weight=185.0 notes=''
[log_workout] -> id=xY7AK3qLzBPx5Vd2HnRf1M status=queued
Der Wert status="queued" entspricht dem aus dem Warm-up-Skript. Der Roh-Log ist gespeichert, aber client.profile() liefert ihn erst als Suchtreffer zurück, wenn die Pipeline fertig ist. Später fügst du eine Verifikation hinzu, die darauf wartet.
suggest_next_session ist die Leseseite – hier zahlt sich die Trennung in statisch und dynamisch aus. Ein client.profile(container_tag=USER_ID, q=focus)-Aufruf liefert drei Sichten auf den Nutzer in einem Roundtrip.
Stabile Vorlieben kommen als profile.static zurück, aktuelle Aktivität als profile.dynamic und die nächsten passenden Erinnerungen als search_results.results. Aufgabe des Tools ist es, diese drei Sichten zu einem Kontextblock zu verdichten, den der Agent zitieren kann.
Nach ein paar Workouts produziert das Tool etwa so eine Ausgabe:
Recent activity:
- Trains at home instead of a gym
- Performed deadlift: 3 sets of 5 reps at 225.0 lbs
- Performed 5k run in 26 minutes
- Reports no knee pain during bench press
- Performed bench press: 4 sets of 5 reps at 185.0 lbs
Closest matching past entries:
- Trains at home instead of a gym
- Performed deadlift: 3 sets of 5 reps at 225.0 lbs
- Performed bench press: 4 sets of 5 reps at 185.0 lbs
- Performed 5k run in 26 minutes
- Reports no knee pain during bench press
Der Agent liest diesen Block und schreibt eine Empfehlung, die in der tatsächlichen Historie des Nutzers verankert ist. Ohne Supermemorys Profil würdest du denselben Kontext selbst bauen: separate semantische Suche, eigener Profilstore und Zusammenführen der Ergebnisse. Der einzelne Aufruf client.profile() ersetzt alle drei.
Füge das unter log_workout in tools.py ein:
@function_tool
def suggest_next_session(focus: str) -> str:
	"""Fetch the user's training history and preferences for a given focus.

	Returns a context string the agent can use to recommend the next session.
	The agent is responsible for the actual recommendation. This tool only
	surfaces what Supermemory knows about the user.

	Args:
    	focus: What the user wants to train next (e.g. "upper body", "legs",
        	"cardio", "today"). Drives semantic search against past logs.
	"""
	print(f"[suggest_next_session] focus={focus!r}")
	profile = client.profile(container_tag=USER_ID, q=focus)

	static_facts = profile.profile.static
	dynamic_facts = profile.profile.dynamic
	matches = profile.search_results.results

	print(
    	f"[suggest_next_session] static={len(static_facts)} "
    	f"dynamic={len(dynamic_facts)} matches={len(matches)}"
	)

	sections = []
	if static_facts:
    	sections.append("Stable preferences and constraints:")
    	sections.extend(f"- {fact}" for fact in static_facts)
	if dynamic_facts:
    	sections.append("Recent activity:")
    	sections.extend(f"- {fact}" for fact in dynamic_facts)
	if matches:
    	sections.append("Closest matching past entries:")
    	for r in matches[:5]:
        	sections.append(f"- {r['memory']}")

	if not sections:
    	return (
        	"No prior training history found for this user. "
        	"Ask the user about their goals, equipment, and recent training."
    	)
	return "\n".join(sections)
client.profile(container_tag=USER_ID, q=focus) liefert ein ProfileResponse-Objekt. Nach 5 kurzen Logs sehen die drei vom Tool gelesenen Felder so aus:
profile.profile.static        	# [] (list[str])
profile.profile.dynamic       	# ["Performed bench press: 4 sets of 5 reps at 185.0 lbs", ...]
profile.search_results.results	# [{"memory": "...", "similarity": 0.631, ...}, ...] (list[dict])
Jeder Suchtreffer ist ein Python-Dict, kein Pydantic-Objekt. Nutze r["memory"] für den Text und r["similarity"] für den Score. Das vollständige Dict hat folgende Keys:
id
memory
rootMemoryId
metadata
updatedAt
version
similarity
filepath
documents
Das Snippet r.memory or r.chunk aus der Integrationsseite des Supermemory OpenAI Agents SDK wirft bei supermemory==3.37.0 ein AttributeError. Nutze Klammerzugriff.
static ist hier leer, daher die Verzweigung über if static_facts:. Die Zweige dynamic und search_results liefern in den ersten Dutzend Logs die Hauptarbeit.
Supermemory setzt außerdem einen standardmäßigen Similarity-Schwellenwert. Eine einmal erwähnte Tatsache taucht nicht in jeder Abfrage auf. Die 5 Logs oben kamen alle bei q="today" zurück, eine spezifischere Query kann weniger Treffer liefern. Die Abfrage if matches: fängt das robust ab.
Starte Session 1 und logge ein paar Workouts, um Supermemory mit Material zu füllen. Führe das Skript aus:
uv run python main.pyLogge Bankdrücken, dann einen 5-km-Lauf, dann Kreuzheben, plus eine Präferenz-Aussage: „Ich trainiere nur zu Hause, kein Gym.“ Der Agent feuert pro Workout einmal log_workout, und die print()-Zeilen machen jeden Aufruf im Terminal sichtbar.
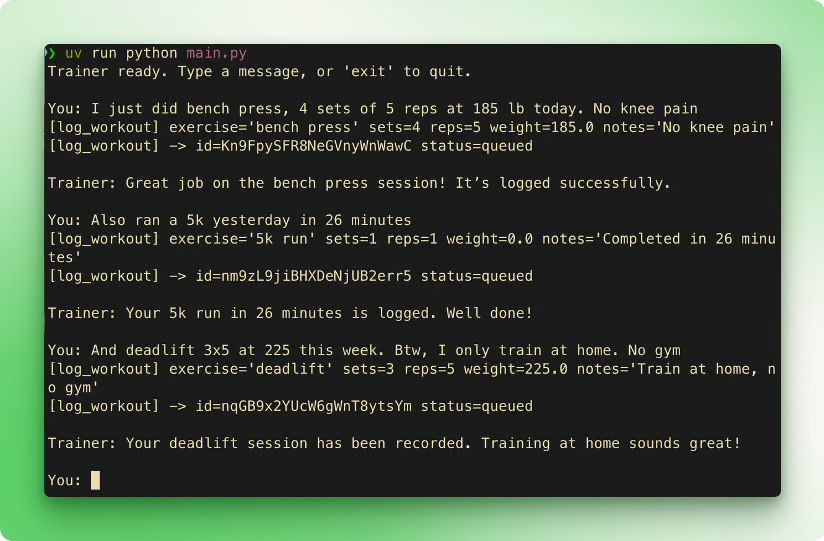
Beispielausgabe. Die genaue Formulierung deines Agenten kann abweichen, da das Modell nicht deterministisch ist.
Die drei status=queued-Zeilen markieren den Moment, in dem Supermemory übernimmt. Jede entspricht einem Dokument, das auf Supermemory-Seite durch die Embed-and-Extract-Pipeline läuft. Bei kurzen Logs wie diesen wird das Dokument innerhalb von ~12 Sekunden über client.profile() durchsuchbar.
Im Trainer-Code wartet darauf nichts. Der Agent macht weiter, während Supermemory im Hintergrund fertigrechnet.
Jeder Log löst genau einen log_workout-Aufruf aus, und der Agent stoppt. Keine proaktiven Empfehlungen, keine Extratools, keine Folgefragen. Die erste System-Prompt-Regel sorgt dafür. Ohne sie würde der Agent nach jedem Log direkt die nächste Einheit vorschlagen und die Tool-Aufrufe verdoppeln.
Tippe exit, um Session 1 zu schließen. Der Python-Prozess endet, und die SQLiteSession ist damit weg. Die Workout-Logs und die Präferenz-Aussage liegen nun in Supermemory unter container_tag="demo_user" – getrennt vom Skript, das sie geschrieben hat.
Bevor du Session 2 startest, prüfe, dass die Fakten aus Session 1 abfragbar sind. Öffne eine frische Python-REPL oder speichere dies als kurzes Skript:
from dotenv import load_dotenv
from supermemory import Supermemory

load_dotenv()
client = Supermemory()

prof = client.profile(container_tag="demo_user", q="training")
print(f"static  ({len(prof.profile.static)}): {prof.profile.static}")
print(f"dynamic ({len(prof.profile.dynamic)}):")
for fact in prof.profile.dynamic:
	print(f"  - {fact}")
print(f"matches ({len(prof.search_results.results)}):")
for r in prof.search_results.results[:5]:
	print(f"  - {r['memory']} (similarity={r['similarity']:.3f})")
Echte Ausgabe, zwischen den beiden Sessions aufgenommen:
static  (0): []
dynamic (5):
  - Trains at home instead of a gym
  - Performed deadlift: 3 sets of 5 reps at 225.0 lbs
  - Performed 5k run in 26 minutes
  - Reports no knee pain during bench press
  - Performed bench press: 4 sets of 5 reps at 185.0 lbs
matches (5):
  - Trains at home instead of a gym (similarity=0.682)
  - Performed deadlift: 3 sets of 5 reps at 225.0 lbs (similarity=0.643)
  - Performed bench press: 4 sets of 5 reps at 185.0 lbs (similarity=0.631)
  - Performed 5k run in 26 minutes (similarity=0.585)
  - Reports no knee pain during bench press (similarity=0.585)
Schau dir an, was der Extractor von Supermemory produziert hat. Der Nutzer sagte einmal: „Ich trainiere nur zu Hause, kein Gym.“ Der Extractor machte daraus die dynamische Tatsache "Trains at home instead of a gym".
Beim Bankdrück-Log stand im Notes-Feld, dass kein Knieschmerz auftrat. Der Extractor hat diesen einzelnen Log in zwei dynamische Fakten aufgeteilt: einmal das Workout, einmal die Abwesenheit von Schmerzen.
Vier Logs wurden zu fünf normalisierten dynamischen Fakten plus fünf passenden Memory-Chunks mit Similarity-Scores zwischen 0,585 und 0,682. Keine dieser Aufteilungen, Normalisierungen oder Matches lief im Trainer-Code. Falls dynamic bei dir leer ist, warte 10 Sekunden und führe das Snippet erneut aus. Die Verarbeitungswarteschlange schwankt gelegentlich.
Starte nun Session 2 in einem brandneuen Prozess:
uv run python main.pyDies ist ein frischer Python-Interpreter. Keine gemeinsame Erinnerung mit Session 1. Kein warmer Cache. Alles, was der Agent erinnert, kommt aus Supermemory.
Sende eine Nachricht: „Was soll ich heute für mein Workout machen?“
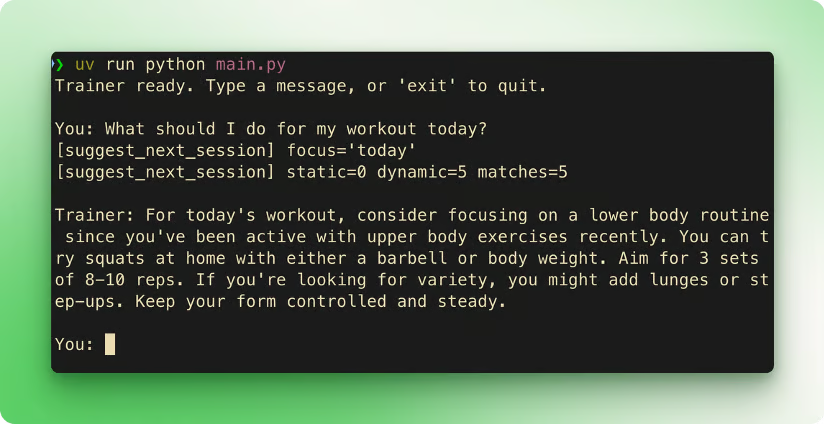
Beispielausgabe. Gleicher Speicher, neuer Python-Prozess.
Der Agent ruft suggest_next_session("today") auf. Das Tool druckt static=0 dynamic=5 matches=5. Der aufgezeichnete Lauf antwortete mit einer Unterkörper-Einheit zu Hause (Squats, Ausfallschritte, Step-ups).
Die Empfehlung passte zu den vorherigen Logs, weil Supermemorys Profil dem Agenten diese mitgegeben hat. Bankdrücken, Kreuzheben und ein 5-km-Lauf waren Oberkörper oder Cardio, und der Nutzer trainierte nur zu Hause. Beide Fakten kamen aus demselben client.profile()-Aufruf. Deine Ausgabe wird anders formulieren, da das Modell nicht deterministisch ist – der Recall-Pfad bleibt gleich.
Die Demo umfasst einen Nutzer, zwei Tools und eine CLI. Eine echte Version des Trainers wächst in drei Supermemory-typischen Richtungen, bevor die Agent-Schleife selbst angetastet wird.
Memory pro realem Nutzer scopen. Die Konstante USER_ID = "demo_user" reicht für eine Person. Produktions-Apps berechnen das Tag aus der authentifizierten Nutzer-ID, z. B. container_tag="user_sarah" oder container_tag=customer_id. Speicher zwischen Nutzern bleibt getrennt, weil jeder Read das Tag mitgibt. Eine Änderung in tools.py, sonst nichts.
Mehr speichergestützte Tools hinzufügen. Deload-Wochen, PR-Tracking und wöchentliche Mobility-Prompts. Jedes ist eine weitere @function_tool-Funktion, die für Writes client.add() und für Reads client.profile() gegen dasselbe container_tag aufruft. Die Tool-Form bleibt gleich. Nur was der Agent festhält und abfragt, ändert sich.
Mit Supermemory-Fehlern umgehen. Wickle client.add() und client.profile() in try/except supermemory.APIError, damit transiente Fehler den Agenten nicht crashen. Setze Timeouts pro Request, wenn dein Agent in einer engen Umgebung läuft.
Die Agent-Loop ist unabhängig von Supermemory und kann später wechseln. Setze vor die CLI Telegram, Discord oder Slack, damit der Nutzer ein Workout textet und der Bot Runner.run() aufruft. Oder tausche das Framework. Supermemory hat eine LangChain-Integration, falls dein Stack bereits auf LangChain-Agenten setzt – der Memory-Code bleibt gleich.
Die Trennung in statisch und dynamisch passt auch in andere Domänen.
Die Trennung hält immer dann, wenn der Nutzer die Quelle der Wahrheit ist.
Du hast gerade einen Python-Trainer mit zwei Tools und persistentem Speicher über Prozesse hinweg gebaut. client.add() schreibt Workouts. client.profile() liest den Nutzer in einem Aufruf als statische Fakten, dynamische Fakten und semantische Treffer – alles per container_tag gescoped. Supermemory übernimmt Chunking, Embedding, Suche und Profil-Extraktion, die die Demo nie schreiben musste.
Kombiniere es mit RAG, und derselbe Agent beantwortet Fragen zum Nutzer und zum Produkt. LLM Agents Explained deckt breitere Agenten-Muster ab, und der Associate AI Engineer for Developers-Lernpfad geht tiefer in speichergestützte Agenten.
Lerne AI Engineering mit DataCamp!
Lernpfad
Kurs
Lernpfad
Blog
Blog
Hesam Sheikh Hassani
15 Min.
Tutorial
Stephen Gruppetta
12 Min.
Tutorial
Sejal Jaiswal
24 Min.
Tutorial
Kurtis Pykes
15 Min.
Tutorial
DataCamp Team
2 Min.