
Kurs
Python ile LLM'lere Giriş
3 sa
36.6K
Birçok geliştirici, tekil soruları mükemmel yanıtlayan ama tutarlı sohbetler sürdürmekte zorlanan sohbet botları ve yapay zekâ asistanları oluşturuyor. Temel neden mi? Bellek eksikliği. Bir kullanıcı, önceki bağlama atıfta bulunan takip sorusu sorduğunda, durumsuz dil modelleri bunu tamamen yeni bir istek gibi ele alır ve bu da can sıkıcı, tekrarlayan etkileşimlere yol açar.
Doğal ve akıllı hissi veren yapay zekâ uygulamaları oluşturmak için büyük dil modellerinde belleği anlamak ve uygulamak kritik önemdedir. Bellek, LLM'lerin sohbetler boyunca bağlamı korumasını, geçmiş etkileşimlerden öğrenmesini ve kişiselleştirilmiş yanıtlar sunmasını sağlar. Bu eğitimde, temel bağlam pencerelerinden gelişmiş mimarilere kadar LLM belleğinin temellerini adım adım ele alacağım.
LLM'lere yeniyseniz, LangChain ile LLM Uygulamaları Geliştirme, Büyük Dil Modelleri Geliştirme veya LLMOps Kavramları gibi kurslarımızdan birini almanızı öneririm.
Büyük dil modelleri bilgiyi geleneksel yazılımdan farklı işler. Veritabanları veriyi açıkça depolayıp getirirken, LLM'ler bağlam pencereleri ve token sınırları gibi mimari kısıtlar içinde belleği yönetmek zorundadır. Zorluk, gereksiz ayrıntıları unuturken ilgili bilgiyi hatırlatmak ve hesaplama kaynaklarını aşırı zorlamadan tutarlılığı korumaktır.
Uygulama ayrıntılarına dalmadan önce, büyük dil modelleri bağlamında belleğin ne anlama geldiğini ve etkili yapay zekâ uygulamaları inşa etmek için neden önemli olduğunu netleştirelim.
LLM'lerde bellek, sistemin önceki etkileşimlerden veya eğitim verilerinden gelen bilgiyi tutma ve kullanma becerisini ifade eder. Bu, geleneksel bilişimdeki bellek gibi değildir. Modelin bağlamı koruma, geçmiş alışverişlere referans verme ve öğrenilmiş kalıpları yeni durumlara uygulama kapasitesidir.
Bellek, izole soru-cevap çiftlerini tutarlı sohbetlere dönüştürdüğü için kritiktir. Bellek olmadan bir LLM, "bundan biraz daha bahset" dediğinizde bunu anlayamaz. Modelin, gönderimleri yorumlamak ve önceki konuşmaların üzerine inşa etmek için bağlama ihtiyacı vardır.
LLM belleğini sıklıkla insan belleğine paralel düşünürüm. İnsanlarda duyusal bellek (anlık algı), kısa süreli bellek (aktif bilgi) ve uzun süreli bellek (depolanmış bilgi) vardır. LLM'ler de benzer sistemler uygular: bağlam pencereleri kısa süreli bellek gibi davranır, getirilen bilgiler hatırlanan uzun süreli bellek işlevi görür ve eğitilmiş parametreler kalıcı bilgiyi temsil eder.
Artık LLM'lerde belleğin temel kavramını ele aldığıma göre, belirli uygulamanız için doğru yaklaşımı seçmenize yardımcı olmak üzere bellek sistemlerinin nasıl sınıflandırıldığını inceleyelim.
Belleğin nasıl sınıflandırıldığını anlamak, uygulamanız için doğru yaklaşımı seçmeye yardımcı olur. LLM belleği üç temel boyut boyunca kategorize edilebilir: nesne, biçim ve zaman.
Nesne boyutu kişisel bellek ile sistem belleğini ayırt eder. Kişisel bellek, tercihler ve sohbet geçmişi gibi kullanıcıya özgü bilgileri depolar.
Sistem belleği ise tüm kullanıcılara açık genel bilgi ve yetenekleri içerir. Bir müşteri hizmetleri botu, ürün bilgileri için sistem belleğini, her müşterinin sipariş geçmişi için ise kişisel belleği kullanabilir.
İkinci boyuta geçtiğimizde, biçim boyutu parametrik ve parametrik olmayan belleği ayırır. Parametrik bellek, eğitim sırasında modelin ağırlıklarına kodlanır. Parametrik olmayan bellek modelin dışında, veritabanlarında veya vektör depolarında saklanır. Parametrik bellek eğitimden sonra sabittir; parametrik olmayan bellek ise dinamik olarak güncellenebilir.
Son olarak, zaman boyutu belleği süreye göre kategorize eder: kısa vadeli ve uzun vadeli. Kısa vadeli bellek, bağlam penceresinde tutulan mevcut sohbeti kapsar. Uzun vadeli bellek ise oturumlar arasında kalıcılık gösterir, haricî olarak saklanır ve gerektiğinde geri çağrılır.
Bu sınıflandırma çerçevesini kurduğumuza göre, LLM'lerin pratikte uyguladığı belirli bellek türlerini inceleyelim.
Farklı bellek türleri, LLM uygulamalarında farklı amaçlara hizmet eder. Bu türleri anlamak, özel kullanım senaryonuz için etkili bellek mimarileri tasarlamanıza yardımcı olur.
Anlamsal bellek, sistemin erişip referans verebileceği olgular ve genel bilgileri depolar. Modeller eğitimden gelen temel bilgiye sahip olsa da, pratikte anlamsal bellek sıklıkla olgusal bilgi içeren haricî bilgi tabanları, veritabanları veya doküman depolarını ifade eder.
Örneğin bir müşteri hizmetleri botu, ürün özellikleri, fiyat bilgileri ve şirket politikalarını bir vektör veritabanında saklayan bir anlamsal belleğe sahip olabilir. Bu sayede sistem, yalnızca güncelliğini yitirmiş olabilecek eğitim verilerine güvenmek yerine, doğru ve güncel bilgilere erişip bunlara referans verebilir. Anlamsal bellek genellikle haricî olarak saklanır ve gerektiğinde geri getirilir; bu da güncellemeyi ve bakımı kolaylaştırır.
Anlamsal bellek olgular ve bilgiyle ilgilenirken, episodik bellek belirli deneyimlere odaklanır. Episodik bellek geçmiş etkileşimleri, hangi soruların sorulduğunu, modelin nasıl yanıt verdiğini ve bu alışverişlerin bağlamını yakalar.
Episodik bellek, modelin sohbetin önceki bölümlerine doğal biçimde atıfta bulunmasını sağlar; "daha önce konuştuğumuz gibi" veya "projeniz hakkında bana söylediklerinize dayanarak" gibi ifadeler kullanabilir. Bu bellek türü genellikle parametrik olmayan, sohbet tamponlarında veya veritabanlarında saklanan bir yapıdır.
Prosedürel bellek, sistem talimatları ve öğrenilmiş yordamları kapsar. Buna, yapay zekânın davranışını tanımlayan sistem yönergesi, nasıl yanıt verileceğine dair kılavuzlar ve göreve özgü talimatlar dahildir.
Bir modeli "her zaman madde işaretleriyle yanıt ver" ya da "yaratıcılıktan ziyade doğruluğa öncelik ver" şeklinde yapılandırdığınızda, prosedürel belleği ayarlıyorsunuz demektir. Bu, modelin ne bildiğinden ziyade bilgiyi nasıl işlediğini ve yanıtladığını şekillendirir.
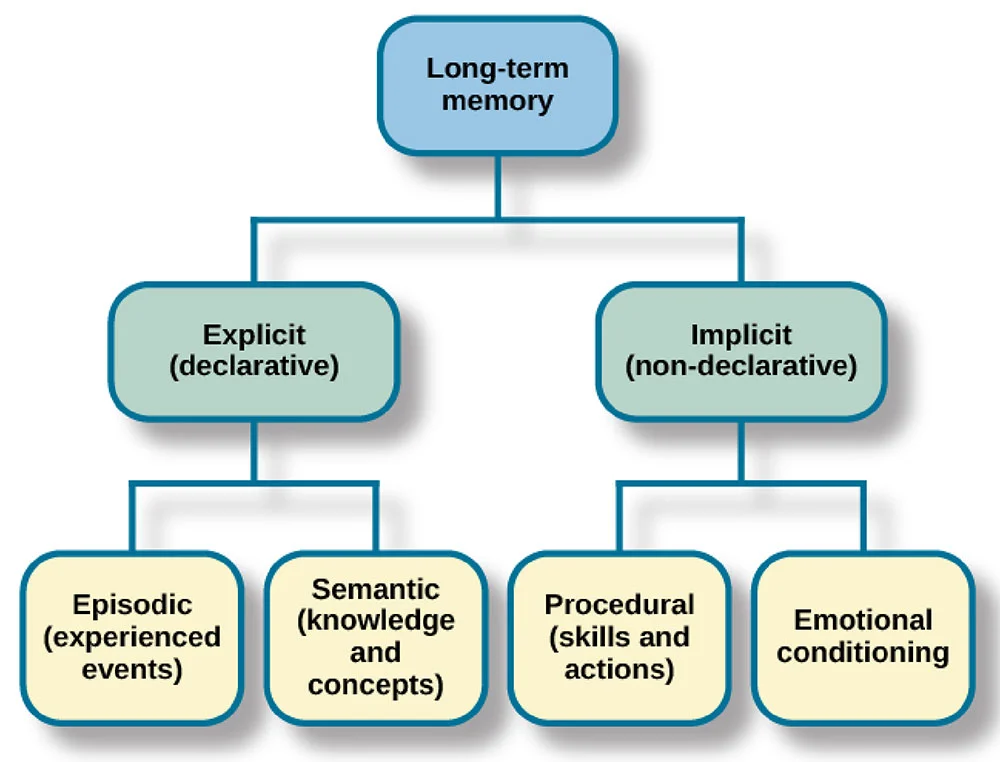
Bu temel bellek türlerinin ötesinde, özellikle LangChain gibi çerçevelerde pratik uygulamalar, çeşitli sohbet belleği biçimleri sunar.
ConversationBufferMemory, tüm iletileri bütünüyle saklayarak eksiksiz sohbet geçmişini korur; tam bağlamın gerekli olduğu kısa sohbetler için idealdir. ConversationSummaryMemory, geçmiş etkileşimleri özetlere sıkıştırır; uzun sohbetlerde ana bilgileri korurken token kullanımını azaltır. ConversationBufferWindowMemory, yalnızca en son N iletiyi tutar; yalnızca yakın geçmişin önemli olduğu durumlarda işe yarayan kayan bir bağlam penceresi oluşturur. ConversationSummaryBufferMemory, yaklaşımları birleştirir; son iletileri kelimesi kelimesine korurken daha eski alışverişleri özetler; ayrıntı ve verimlilik arasında denge sunar. Her biçim, eksiksizlik ve verimlilik arasında ödünleşim sunar; uygulamanızın özel gereksinimlerine göre seçim yapmanıza imkân tanır.Bu bellek türlerini anlamak önemlidir; ancak hepsi temel bir kısıt içinde çalışır: bağlam penceresi. Bu mimari sınırlamanın bellek uygulamasını nasıl şekillendirdiğini inceleyelim.
Sanırım LLM belleğini anlamanın kilit yönlerinden biri bağlam penceresi kavramıdır. Nasıl çalıştıklarına kısaca bakalım.
Bağlam penceresi, bir LLM'in tek bir istekte işleyebileceği en fazla metin miktarıdır ve token cinsinden ölçülür. Tokenlar, kabaca sözcüklere veya alt sözcüklere karşılık gelen metin parçalarıdır.
Bağlam penceresi, modelin anlık çalışma belleği gibi işlev görür. Modelin dikkate aldığı her şey bu pencereye sığmalıdır: sistem yönergesi, sohbet geçmişi, getirilen belgeler ve yanıt alanı. Sohbet büyüdükçe, yenilerine yer açmak için eski iletiler kaldırılmalıdır.
Bağlam penceresi boyutu ciddi ölçüde değişir. Örneğin GPT-5 400.000 token desteklerken, Claude 4.5 Sonnet 200.000 token işleyebilir ve Gemini 3 Pro 1,5 milyon tokena kadar uzanır. Daha büyük pencereler daha zengin bağlam sağlar fakat hesaplama maliyetlerini karesel olarak artırır.
Büyük bağlam pencerelerine sahip olmak ideal görünse de, gerçek dünyadaki kullanımı etkileyen önemli pratik zorluklar getirir.
Deneyimlerime göre bağlam pencereleriyle ilgili en büyük sorun "ortada kaybolma" problemidir. Araştırmalar, LLM'lerin bağlam penceresinin başındaki ve sonundaki bilgiye daha çok dikkat ettiğini, ortadaki içeriğin ise daha az ilgi gördüğünü gösteriyor. Bağlamı bilgiyle doldurmak tek başına etkin kullanım garantisi vermez.
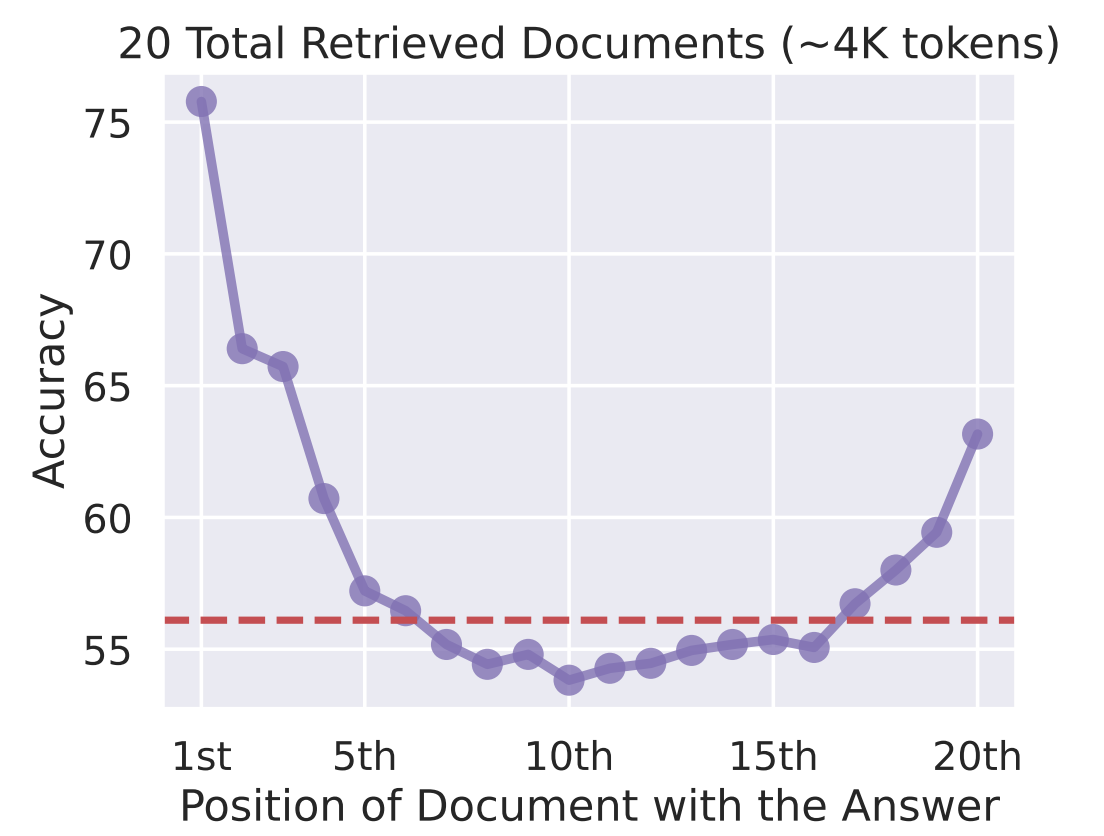
Doğruluk vs. Yanıtın Bulunduğu Belgenin Konumu
Hesaplamaya ilişkin kısıtlar, bağlam pencerelerini büyütmeyi pahalı kılar. 100.000 tokenlık bir bağlamı işlemek, 10.000 tokenlık bir bağlama kıyasla çok daha fazla GPU belleği ve zaman gerektirir.
Üretim uygulamalarında bu maliyetler hızla katlanır; yalnızca ilgili bilgileri seçici olarak dahil eden akıllı bellek sistemlerine duyulan ihtiyacı artırır.
Bu kısıtlar göz önüne alındığında, çözüm sadece bağlam pencerelerini büyütmek değil, onları verimli kullanan daha akıllı sistemler kurmaktır.
Etkili LLM uygulamaları, bağlam pencerelerini anlık bağlamın ötesine uzanan bellek sistemleriyle birleştirir. Kalıp, bağlam penceresini kısa vadeli, yüksek öncelikli bilgiler için kullanırken, uzun vadeli belleği haricî olarak saklayıp seçici biçimde geri çağırmayı içerir.
Tipik bir mimari, yakın tarihli sohbet dönüşlerini bağlam penceresinde tutar, daha eski sohbetleri bir veritabanında saklar ve gerektiğinde ilgili geçmiş bilgileri geri getirmek için getirme mekanizmaları kullanır. Bu, eksiksizlik ile verimlilik ve performans arasında denge sağlar.
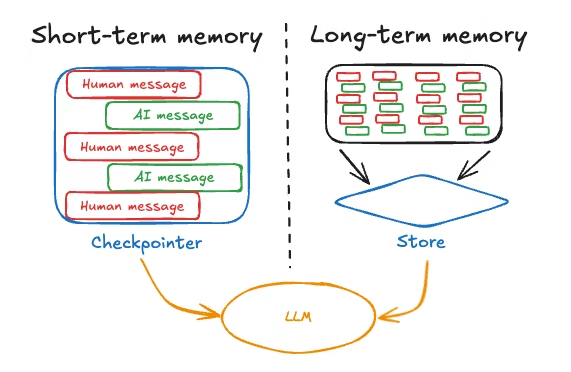
Bu mimari anlayış yerleştiğine göre, bu kısıtlar içinde çalışan etkili kısa vadeli bellek sistemlerinin nasıl uygulanacağını inceleyelim
Kısa vadeli bellek sistemleri, esas olarak bağlam penceresinden yararlanarak mevcut oturum içindeki bilgiyi yönetir. Ben bunu modelin çalışma belleği olarak düşünmeyi seviyorum; yani, mevcut sohbeti işlerken aktif olarak elinde tuttuğu bilgi.
Şimdi bu sınırlı ama kritik bellek alanını nasıl en üst düzeye çıkaracağımıza bakalım.
Bağlam içi öğrenme, modelin istemdeki örnekler veya talimatlara göre davranışını uyarlama yeteneğini ifade eder. Modeli, ince ayar yapmak yerine, bağlam penceresi içinde ne yapacağını göstererek eğitirsiniz.
Mekanizma basittir:
Bu yaklaşımın faydaları şunlardır:
Sınırlamalar arasında, çok sayıda örnekle etkinliğin "ortada kaybolma" nedeniyle düşmesi, artan token maliyetleri ve performansın nadiren ince ayarlı modellerle eşleşmesi yer alır.
Bağlam içi öğrenme kısa vadeli bellekle nelerin mümkün olduğunu gösterir; peki bilgi model tarafından kullanılmak üzere gerçekte nasıl depolanır? Bellek oluşumunun arkasındaki mekanizmaları inceleyelim.
LLM sistemlerinde bellek oluşumu bilinçli (açık) veya bilinçdışı (örtük) olabilir.
Birçok çerçeve, açık işlemler gerektirmeden örtük bellek oluşturan sohbet tamponlarını otomatik olarak sürdürür. Zorluk, bu birikimi yönetmekte; ilgili bilginin kalıcılığını sağlarken daha az önemli ayrıntıları budamaktadır.
Kısa vadeli bellek anlık sohbet ihtiyaçlarını karşılar; peki bilgi mevcut oturumun ötesinde kalıcılık gerektirdiğinde ne olur? İşte o zaman uzun vadeli bellek çözümleri devreye girer.
Uzun vadeli bellek, LLM'lerin oturumlar arasında bilgiyi muhafaza etmesini sağlar.
Kısa vadeli bellek geçicidir ve sohbet bittiğinde kaybolur; uzun vadeli bellek ise kalıcıdır, böylece yapay zekânız kullanıcı tercihlerini, geçmiş etkileşimleri ve zamanla biriken bilgileri hatırlayabilir.
İki temel yaklaşımı vurgulayacağım: bilgiyi haricî olarak depolayan metin tabanlı bellek sistemleri ve modelin daha önce hesaplanmış bilgilere erişimini optimize eden anahtar-değer önbellekleme.
Metin tabanlı bellek, sohbet geçmişini ve kullanıcı bilgilerini veritabanlarında veya vektör depolarında saklar. Edinim, tercihler, kararlar, olgular veya bağlamsal ayrıntılar gibi ilgili bilgileri yakalamayı içerir.
Bellek yönetimi, sıkıştırma ve organizasyon gerektirir. Özetleme teknikleri, sohbetleri kilit noktalara sıkıştırır. Hiyerarşik organizasyon, anıları konu, zaman dilimi veya alaka düzeyine göre yapılandırır.
Kullanım, getirime odaklanır. Vektör benzerliği araması, anlamsal anlama yoluyla ilgili anıları bulur. Zaman temelli getirim yakın tarihli bilgiyi önceliklendirir. Alaka puanlaması, anıları önemine göre sıralar.
Metin tabanlı sistemler neyin depolanacağını ele alır; ancak getirimi nasıl daha verimli kılacağımız sorusu da vardır. İşte anahtar-değer önbellekleme burada devreye girer.
Anahtar-değer (KV) önbellekleme, token üretim verimliliğini artırır. Metin üretimi sırasında model, önceki tüm tokenlar üzerinde dikkat hesaplar. KV önbellekleme bu ara hesaplamaları saklar; böylece sonraki tokenlar üretilirken yeniden hesaplamaya gerek kalmadan yeniden kullanılabilirler.
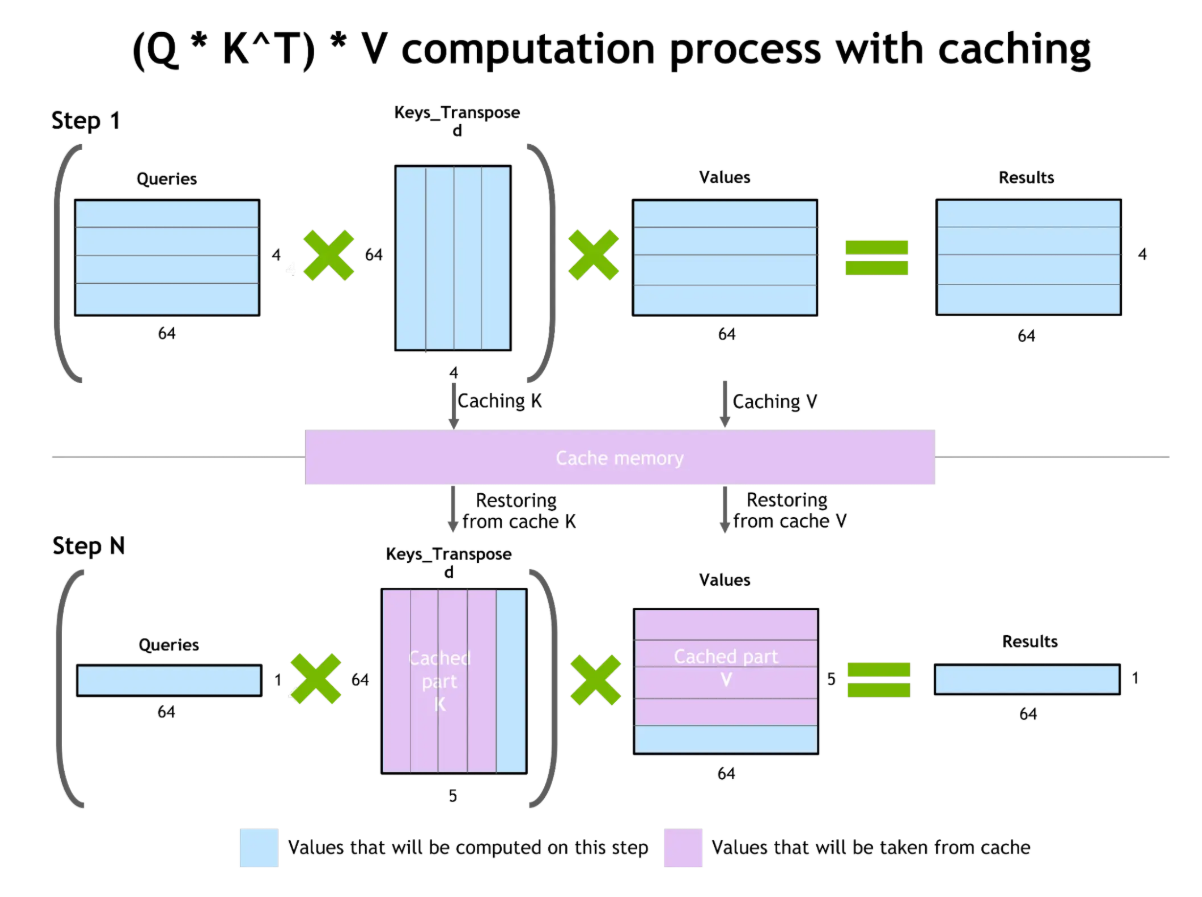
Anahtar-değer Önbellekleme ve Dikkat Optimizasyonu
Fayda kayda değerdir: azalan hesaplama maliyeti, daha hızlı yanıtlar ve daha düşük kaynak kullanımı. Ancak, önbelleğe alınmış anahtar-değer çiftleri GPU VRAM'i tüketir. Çok uzun bağlamlarda KV önbellek boyutu bir kısıt haline gelir.
KV önbellekleme, modellerin bağlam pencerelerini nasıl kullandığını optimize eder; ancak sınırlı bellek kapasitesi temel sorununu çözmez. İşte burada getirim destekli üretim tamamlayıcı bir yaklaşım sunar.
Son dönemde en ilginç bulduğum gelişmelerden biri Getirim Destekli Üretim ya da RAG. RAG, iç ve dış belleği köprüleyerek bir LLM'in belleğini bağlam penceresi kısıtlarının ötesine taşır.
Modelin yalnızca eğitimde öğrendiklerine veya mevcut bağlama sığana güvenmek yerine, RAG tam ihtiyaç anında haricî kaynaklardan ilgili bilgiyi dinamik olarak çeker. RAG'i daha ayrıntılı inceleyelim.
RAG mimarisi iki ana bileşenden oluşur: haricî bilgi tabanlarında ilgili bilgiyi arayan bir getirici ve hem sorguya hem de getirilen bağlama dayanarak yanıt üreten bir üretici (LLM).
Bir sorgu geldiğinde, getirici vektör veritabanlarından veya bilgi tabanlarından ilgili belgeleri bulur. Getirilen belgeler bağlam penceresine enjekte edilir; bu, yanıtı dayandırmak için spesifik bilgi sağlar.
RAG'in faydaları arasında, gerçek belgelere referans verilmesiyle halüsinasyonların azalması, eğitim verilerinin ötesinde güncel bilgiye erişerek artan doğruluk ve yeniden eğitim gerekmeksizin mülkiyetli bilginin dahil edilmesi yer alır.
Bununla birlikte, getirilen belgeler hata içerdiğinde potansiyel halüsinasyonlar, getirimin yararsız bilgi döndürmesi durumunda alaka sorunları ve vektör veritabanlarını yönetmenin karmaşıklığı gibi zorluklar da vardır.
RAG'in gerçek gücü, daha önce bahsettiğimiz en temel sınırlamalardan birini nasıl ele aldığına baktığımızda belirginleşir: bağlam penceresi kısıtları.
RAG, yalnızca ilgili bilgiyi seçerek getirip bağlam penceresi boyutunun ötesine uzanır. Tam sohbet geçmişini korumak yerine, bunu haricî olarak saklar ve ihtiyaç duyuldukça ilgili bölümleri geri getirirsiniz; böylece bağlam penceresi kısıtları içinde pratikte sınırsız sohbet uzunluğu desteklenir.
RAG ile bağlam pencerelerini iyileştirme stratejileri, anlamsal aramayı meta veri filtreleme ile birleştiren hibrit getirim, getirilen sonuçları yeniden sıralayarak ilgili belgeleri önceliklendirme ve modelin ilk yanıtının ek getirimi yönlendirdiği özyinelemeli getirimi içerir.
RAG, bellek genişletmeye yönelik pratik, üretime hazır bir yaklaşımı temsil eder; ancak araştırma topluluğu, modellerin belleği temel düzeyde nasıl ele aldığını yeniden tasarlayan yenilikçi mimarilerle sınırları zorlamaya devam ediyor.
Yenilikçi mimariler ve sinirbilim esinli sistemler, LLM bellek yeteneklerini ilerletiyor. Bu son teknoloji yaklaşımlar, uzun bağlam bilgisini modellerin nasıl ele aldığını yeniden tasarlayarak geleneksel dönüştürücü sınırlamalarının ötesine geçip daha verimli ve insana daha çok benzeyen bellek sistemleri oluşturuyor.
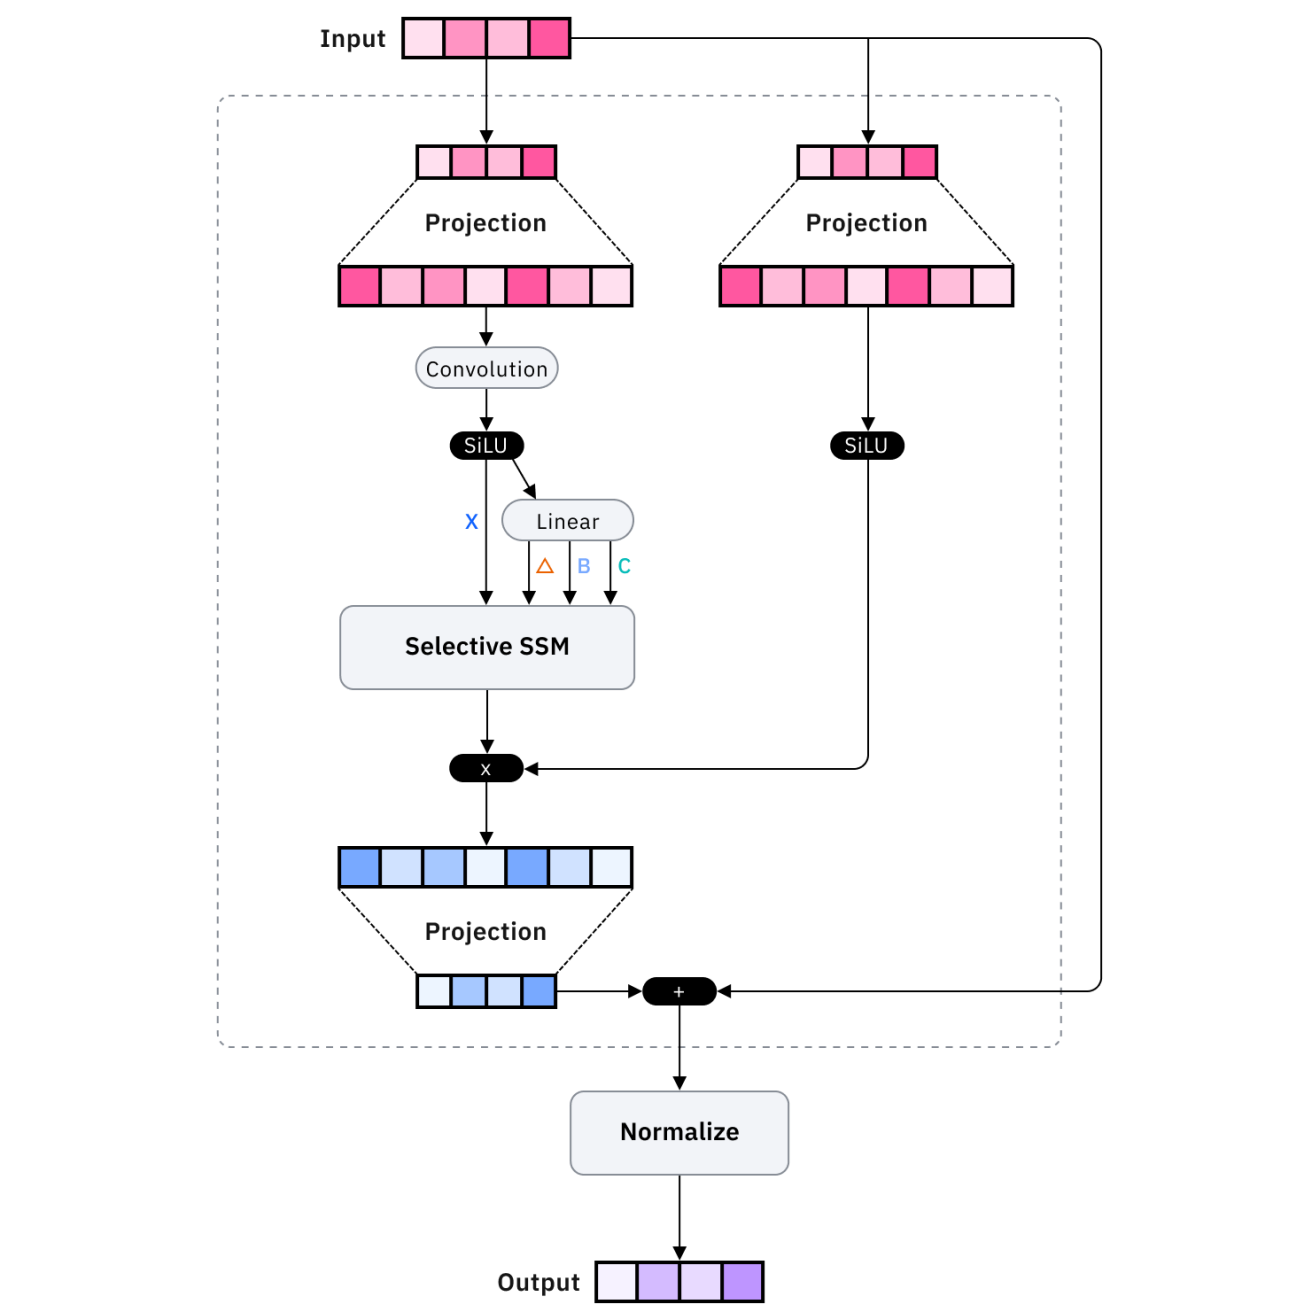
Mamba ve yinelemeli bellek dönüştürücüleri gibi mimariler, bellek verimliliğini optimize eder. Mamba, dikkat mekanizmaları yerine durum uzayı modelleri kullanır; dizi uzunluğuyla karesel yerine doğrusal ölçekleme başararak karşılaştırılabilir kaynaklarla çok daha uzun dizilerin işlenmesine imkân tanır.
Yinelemeli bellek dönüştürücüleri, standart dönüştürücüleri, uzun vadeli durumu koruyan yinelemeli bağlantılarla zenginleştirir; böylece öğrenilmiş bellek mekanizmaları aracılığıyla bilginin anlık bağlam penceresinin ötesinde kalıcılık göstermesini sağlar.
Bu mimari yenilikler araştırma açısından büyüleyici; peki üretime hazır çözümler ne durumda? İşte burada haricî bellek platformları devreye girer.
Mem0 ve Zep gibi platformlar üretime hazır haricî bellek çözümleri sunar. Mem0, ilgili bilgiyi otomatik olarak çıkaran, depolayan ve geri getiren yönetilen bir bellek katmanı sağlar. Zep, yerleşik özetleme, olgu çıkarımı ve vektör aramayla sohbet belleğine odaklanır.
Bu platformlar pratik çözümler sunsa da, bazı araştırmacılar beklenmedik bir kaynaktan ilham alıyor: insan beyninin anıları gerçekte nasıl oluşturup yönettiğinden.
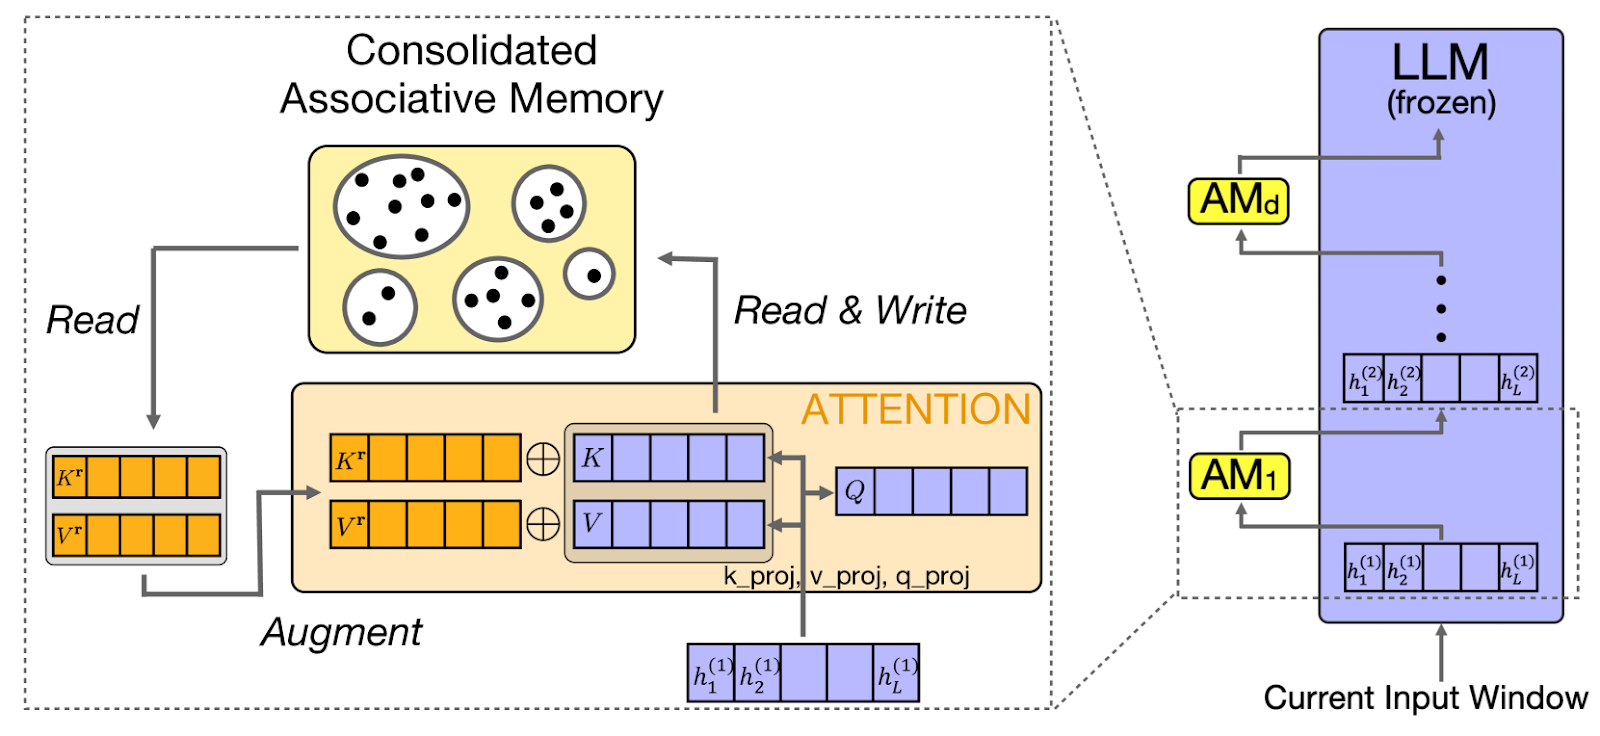
CAMELoT (Consolidated Associative Memory Enhanced Long Transformer), LLM belleğine sinirbilim ilkelerini uygular; pekiştirme, yenilik tespiti ve yakınlık ağırlığı gibi mekanizmaları hayata geçirir. Bu ilkeler, insan bellek sistemlerini yansıtarak daha doğal bellek davranışı oluşturur.
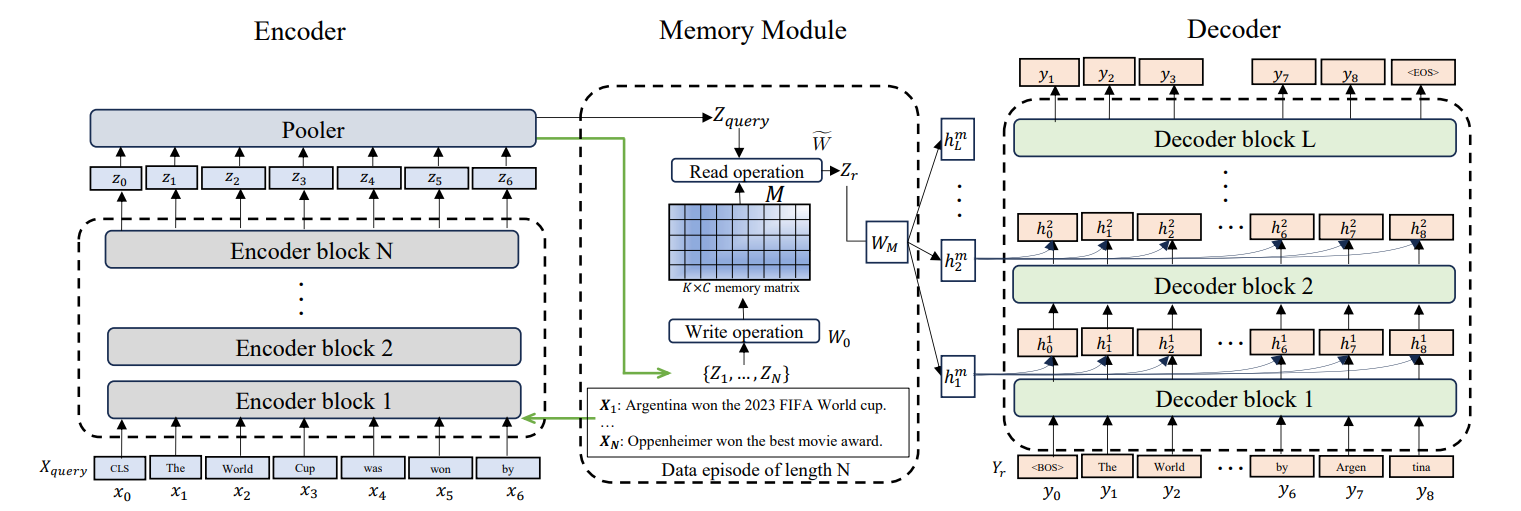
Bu sinirbilim ilkeleri üzerine inşa edilen bir başka yaklaşım, Laminar gibi, insanların farklı deneyimleri ve olayları nasıl hatırladığına özel olarak odaklanır.
Larimar, LLM'lerin farklı bellek epizodlarını sürdürmesini sağlar. Geçmişteki tüm bilgileri tekdüze ele almak yerine, episodik bellek bilgiyi ayrı olaylar halinde yapılandırır. Bu, bağlam uzunluğu genellemesini mümkün kılar. Model, tüm geçmişi yüklemeden belirli geçmiş epizodlara referans verir.
Bu gelişmiş mimariler büyük umut vaat ediyor ancak yeni karmaşıklıklar da getiriyor. Bellek sistemlerini uygularken ortaya çıkan pratik zorlukları ve bunları aşma stratejilerini inceleyelim.
Gelişmiş mimarilere rağmen, gördüm ki bellek sistemleri sıklıkla dikkatli önlemler gerektiren zorluklarla karşılaşır. Bu engelleri ve çözümlerini anlamak, kullanıcıların güvenebileceği sağlam üretim sistemleri kurmak için kritiktir.
Felaket unutma, modellerin önceden öğrenilmiş bilgiyi yitirmesiyle ortaya çıkar. Çözümler arasında bellek pekiştirme, önemli anıların güçlendirilmesi, bellek hiyerarşileriyle kritik bilginin korunması ve periyodik bellek tazeleme yer alır.
Unutmanın ötesinde bir diğer kritik zorluk, bellek sistemleri modelin yolunu aktif olarak saptırdığında ortaya çıkar. Halüsinasyon (inandırıcı ama yanlış bilgi üretme) hatalı bellekle daha da kötüleşir. Azaltma, kaynak atfı, getirilen anılar için güven puanlaması ve doğrulama adımlarını içerir.
Son olarak, kullanıcı sohbetlerini ve tercihlerini depolamak önemli mahremiyet soruları doğurur. Kullanıcı verisi saklarken gizlilik ve güvenlik hususları kritiktir. Veri şifreleme, eski veriyi otomatik olarak temizleyen saklama politikaları ve kullanıcıların yalnızca kendi anılarına erişmesini sağlayan erişim kontrollerini uygulayın.
Belleği entegre etmek özenli API tasarımı gerektirir. Temel kalıplar arasında, bellek sisteminin istekler arasında durumu koruduğu durumlu entegrasyon ve her isteğin gerekli tanımlayıcıları içerdiği durumsuz entegrasyon yer alır.
Verimli bellek yönetimi; budama (en eski veya en az ilgili iletileri kaldırma), silme (belirli ögeleri kaldırma) ve özetleme (iletileri sıkıştırma) uygular. Bu kalıplar, bütçe içinde kalarak temel bağlamı korur.
Bu teorik kalıpları ve zorlukları anlamak değerlidir; fakat asıl sınav uygulamadadır. Bu kavramları kendi projelerinize uygulayabileceğiniz pratik ilkelere dönüştürelim.
Geliştiricilerin LLM bellek sistemlerinden en iyi şekilde yararlandığını gördüğüm bazı yöntemler şunlar.
Etkili bağlam yönetimi, token bütçenizi anlamakla başlar. Sistem yönergenizin, belleğinizin ve yanıtınızın kaç token gerektirdiğini hesaplayın; toplamın sınırlar içinde kaldığından emin olun. Veriyi hiyerarşik olarak yapılandırın ve modelin en iyi dikkat ettiği yere—başına veya sonuna—önemli bilgileri yerleştirin.
Bellek sisteminize girmeden önce veriyi nasıl hazırladığınız da aynı derecede önemlidir. Veri hazırlığı ciddi biçimde fark yaratır. Büyük belgeleri, rastgele token sınırları yerine anlamsal parçalara bölün. Bağlam sürekliliği için parçaları hafifçe üst üste bindirin. Her parçaya, filtreli getirim sağlayacak meta veriler ekleyin.
Sisteminiz çalışmaya başladığında, gerçekten işe yarayıp yaramadığını ölçmenin yollarına ihtiyacınız olacak. Bellek değerlendirmesi; hatırlama doğruluğu, halüsinasyon oranı ve kullanıcı memnuniyeti gibi metriklerin takibini gerektirir. Bellek sistemi gecikmesini, token kullanımını ve getirimin alaka düzeyini izleyin.
Son olarak, getirim stratejiniz kullanıcıların sorduğu şeylerin karmaşıklığına uyum sağlamalıdır. Esnek getirimin stratejileri, sorgu karmaşıklığına göre uyumlanır. Basit sorgular anahtar sözcük aramasını, karmaşık sorular ise anlamsal benzerlik aramasını kullanmaktan fayda görür. Bilgiyi kullanıcı, konu veya zaman dilimine göre düzenlemek için bellek ad alanları uygulayın.
Büyük dil modeli belleği, bu modelleri durumsuz metin üreticilerinden bağlamı anlayan, tutarlı ve kişiselleştirilmiş etkileşimler sunabilen yapay zekâ asistanlarına dönüştürür. Bu eğitim boyunca, bağlam pencerelerinden gelişmiş mimarilere kadar LLM belleğinin temellerini inceledim.
Bence temel çıkarımlar; anlık ihtiyaçlar için iyi yönetilen bağlam pencereleri ve sohbet tamponlarıyla başlamak, parametrik belleğin ötesinde ölçeklenebilir bilgi erişimi için RAG uygulamak, üretim uygulamaları için haricî bellek platformlarından yararlanmak ve metrikler ile kullanıcı geri bildirimi üzerinden bellek etkinliğini sürekli değerlendirmektir.
LLM yetenekleri geliştikçe bellek sistemleri giderek daha sofistike hale gelecek. Uygulayıcılar için odak, kullanıcı ihtiyaçlarına hizmet eden bellek sistemleri kurmak olmalı: ilgili bağlamı korumak, uygun şekilde unutmak ve yapay zekâ uygulamalarını gerçekten faydalı kılan doğal etkileşimleri mümkün kılmak.
Öğrenmeye devam etmek için aşağıdaki kaynaklara göz atmanızı öneririm:
Öne Çıkan DataCamp Kursları
Kurs
Kurs
Kurs
blog
Abid Ali Awan
14 dk.
blog
Dario Radečić
15 dk.
Eğitim
Kurtis Pykes
8 dk.
Eğitim
Adel Nehme



