
Cursus
Associate AI Engineer pour développeurs
26 h
Supermemory est, en bref, une API de mémoire pour agents IA. Quand vous lui confiez des chaînes liées à votre utilisateur, elle renvoie ensuite une vue compacte de qui est cet utilisateur et de ce qu’il a fait récemment. L’embedding, l’indexation et la recherche sont gérés côté Supermemory, ce qui allège votre code d’agent.
Le benchmark LongMemEval mesure la capacité d’un système de mémoire à répondre sur une longue histoire de conversation. Supermemory retrouve 81,6 % des bons faits. Zep, le système suivant, atteint 71,2 %, soit 10 points d’écart — environ 1 réponse correcte en plus toutes les 10 questions utilisateur. Le référentiel open source compte plus de 22 k étoiles GitHub, un autre signe d’usage réel.
La plupart des lecteurs qui cherchent un outil de mémoire pour agents ont déjà utilisé le RAG. Il est utile de placer Supermemory à côté de lui. RAG et la mémoire résolvent des problèmes différents, et cohabitent souvent dans le même agent.
Un système RAG pointe vers un corpus documentaire préparé une fois par le développeur : manuels produit, articles d’aide, documentation interne. Le corpus est chargé au déploiement, interrogé à l’exécution, et change peu. L’agent s’en sert pour répondre aux questions dont le produit détient la réponse.
Un système de mémoire pointe vers l’utilisateur. Supermemory écrit des faits propres à l’utilisateur au fil de la conversation, et le store grandit à chaque échange. L’agent s’en sert pour répondre à des questions que seul l’utilisateur peut éclairer : préférences, historique, activité récente.
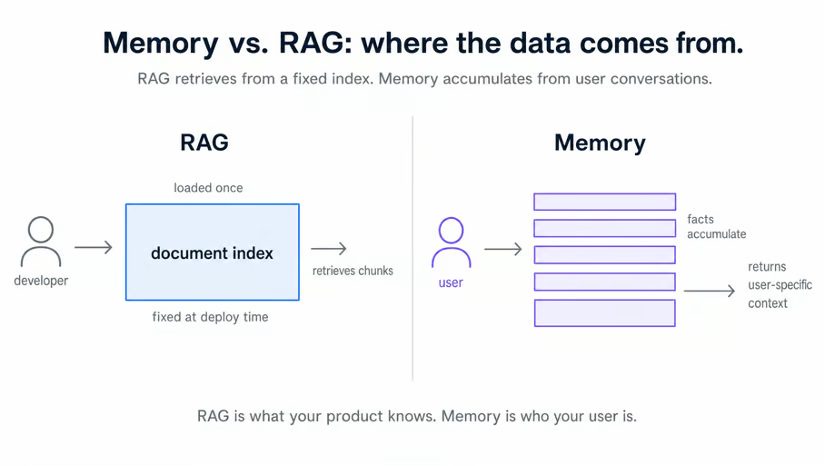
Dans un produit réel, les deux tournent côte à côte. Le RAG sur la base de connaissances de l’entreprise répond « quelle est notre politique de remboursement ? ». Supermemory répond à « Quel était mon développé couché la semaine dernière ? ». Même agent, deux stores de données, deux missions.
L’idée clé de Supermemory est le profil utilisateur. Chaque journal est classé en deux catégories : des faits statiques qui changent rarement, et des faits dynamiques sur l’activité en cours. Les habitudes récurrentes montent en statique. L’activité récente reste en dynamique.
Quand l’agent lit le profil, un seul appel renvoie les deux catégories, plus les fragments de mémoire correspondants.
La séparation est importante car les faits statiques et dynamiques répondent à des questions différentes sur le même utilisateur :
|
Faits statiques |
Faits dynamiques |
|
S’entraîne à domicile avec haltères et barre de traction |
Objectif actuel : renforcer le haut du corps |
|
Blessure au genou gauche, pas de squats profonds |
Dernier bench : 4 séries de 5 répétitions à 185 lb |
|
Veut ajouter 20 lb au bench d’ici fin d’année |
Travaille les tractions « grease‑the‑groove » cette semaine |
|
S’entraîne le soir uniquement, jamais le matin |
A couru 5 km en 28 minutes hier |
Lisez la première ligne. Le volet statique décrit comment la personne s’entraîne : chez elle, avec son matériel. Cela ne change pas d’une semaine à l’autre. Le volet dynamique indique ce sur quoi elle travaille maintenant : le haut du corps, sur ce cycle.
Un outil de suggestion d’entraînement a besoin des deux. Le statique écarte les exercices réservés à la salle, le dynamique choisit la séance du jour.
Derrière ce profil, Supermemory effectue quatre tâches que vous devriez autrement développer : stocker les souvenirs bruts, créer les embeddings de chaque fragment, exécuter la recherche de similarité à la lecture et extraire les faits du profil à partir du contenu journalisé. Aucune des quatre n’apparaît dans votre code.
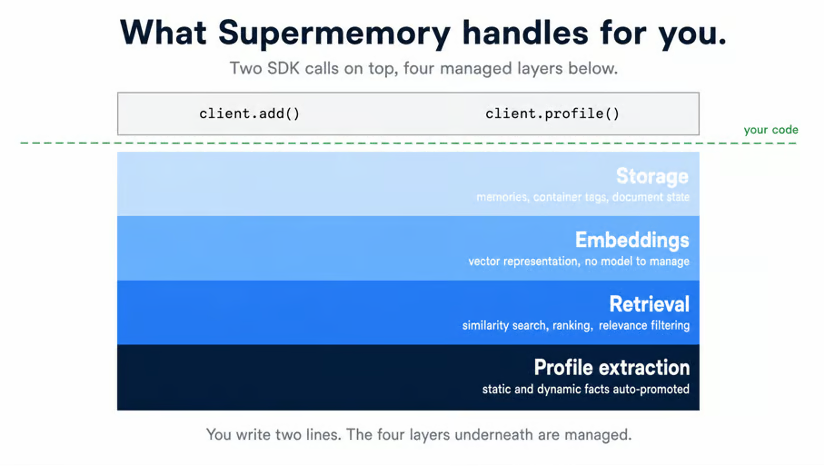
Chaque mémoire est étiquetée avec une chaîne choisie par le développeur. Chaque lecture renvoie la même étiquette pour borner ce qui ressort. Le coach force une seule étiquette, car un utilisateur suffit pour illustrer le fonctionnement du profil. En production, on calcule l’étiquette depuis l’utilisateur authentifié, par exemple son JWT.
Le coach requiert deux clés d’API (Supermemory et OpenAI) et un projet Python avec trois dépendances. Un aller‑retour rapide valide les deux clés avant d’écrire la moindre ligne d’agent.
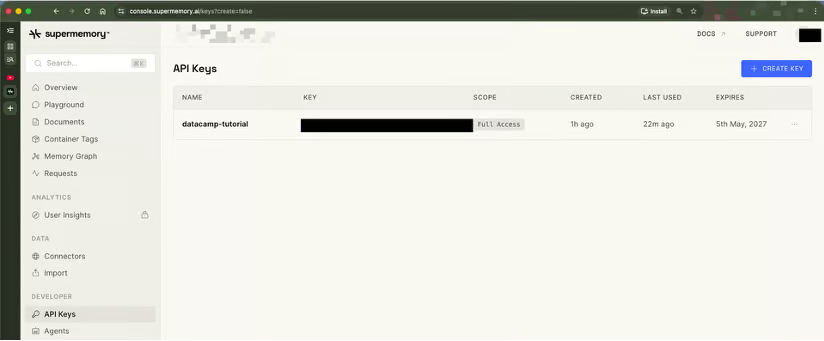
La clé API Supermemory se trouve sur console.supermemory.ai, PAS sur app.supermemory.ai. Le sous‑domaine app correspond au produit grand public (prise de notes, navigation dans votre espace). Il n’a pas de page de clé API. Ignorez‑le et allez directement sur la console.
Sur console.supermemory.ai :
Connectez‑vous.
Cliquez sur API Keys dans la barre latérale.
Cliquez sur Create API Key.
Donnez‑lui un nom (la démo utilise datacamp-tutorial).
Copiez la clé générée. Elle commence par sm_.
Vous aurez aussi besoin d’une clé OpenAI pour les appels LLM de l’agent. Récupérez‑en une sur platform.openai.com/api-keys si vous n’en avez pas déjà.
Créez un fichier .env à la racine du projet avec les deux clés. Ne le validez pas en dépôt.
SUPERMEMORY_API_KEY=sm_your_key_here
OPENAI_API_KEY=sk-your_key_here
L’offre gratuite de Supermemory suffit pour ce tutoriel sans saisir d’informations de paiement. Les limites exactes figurent sur la page tarifs.
Le tutoriel utilise uv pour l’initialisation et l’exécution du projet. Si vous n’avez pas uv, installez‑le en une ligne depuis astral.sh/uv.
Initialisez le projet :
uv init supermemory-trainer
cd supermemory-trainer
Supprimez le README.md auto‑généré par uv init. Le hello.py auto‑généré sera écrasé à l’étape suivante, laissez‑le pour l’instant.
Ajoutez trois dépendances :
supermemory==3.37.0 est le client mémoire, épinglé à la version validée pour ce tutoriel.
openai-agents est le SDK OpenAI Agents. Le nom du package est avec tiret, le chemin d’import est agents.
python-dotenv lit le fichier .env que vous venez de créer.
uv add supermemory==3.37.0 openai-agents python-dotenvLe pyproject.toml obtenu :
[project]
name = "supermemory-trainer"
version = "0.1.0"
description = "Personal exercise trainer agent built with Supermemory and the OpenAI Agents SDK."
requires-python = ">=3.10"
dependencies = [
	"openai-agents>=0.10.2",
	"python-dotenv>=1.2.1",
	"supermemory==3.37.0",
]Avant d’écrire du code d’agent, regardez Supermemory travailler une fois sur une seule phrase. Le script ci‑dessous envoie un fait à Supermemory, attend le pipeline, puis relit le profil. Si tout s’exécute correctement, les clés fonctionnent et le SDK est joignable. La sortie vous donne aussi un premier aperçu de ce que Supermemory fait du texte brut.
Ouvrez hello.py à la racine du projet et remplacez le corps auto‑généré par les imports et un appel d’écriture :
import time

from dotenv import load_dotenv
from supermemory import Supermemory

load_dotenv()

client = Supermemory()
USER_ID = "demo_warmup"

response = client.add(
	content="The user is learning Supermemory by building a personal trainer agent.",
	container_tag=USER_ID,
)
print(f"client.add() -> id={response.id} status={response.status}")
load_dotenv() lit la clé API depuis .env dans l’environnement avant la construction de Supermemory(). Le client récupère SUPERMEMORY_API_KEY automatiquement. La valeur container_tag="demo_warmup" borne ce fait à un utilisateur jetable.
Ajoutez maintenant l’attente et la lecture en bas du même fichier :
print("Waiting 20 seconds for processing...")
time.sleep(20)

prof = client.profile(container_tag=USER_ID, q="learning")
print(f"profile.static  ({len(prof.profile.static)}): {prof.profile.static}")
print(f"profile.dynamic ({len(prof.profile.dynamic)}): {prof.profile.dynamic}")
print(f"search_results.results ({len(prof.search_results.results)}):")
for r in prof.search_results.results[:3]:
	print(f"  - {r['memory']} (similarity={r['similarity']:.3f})")
Les 20 secondes de pause laissent le temps au pipeline d’embedding et d’extraction de traiter la nouvelle mémoire. Sans cela, la lecture ne renverra rien et le script semblera cassé alors qu’il ne l’est pas.
Exécutez le fichier :
uv run python hello.pySortie attendue :
client.add() -> id=zNLsJBrY1PZupAeZ3Qn6EL status=queued
Waiting 20 seconds for processing...
profile.static  (0): []
profile.dynamic (1): ['Building a personal trainer agent to learn Supermemory.']
search_results.results (1):
  - Building a personal trainer agent to learn Supermemory. (similarity=0.650)
Trois détails comptent dans cette sortie. client.add() renvoie immédiatement avec status="queued", car Supermemory traite les documents de façon asynchrone. L’attente de 20 secondes couvre le pipeline d’embedding et d’extraction. Au moment de la lecture, la phrase brute est devenue un fragment de mémoire interrogeable.
La ligne intéressante est profile.dynamic. L’entrée était : « The user is learning Supermemory by building a personal trainer agent. ». La sortie est le fait dynamique 'Building a personal trainer agent to learn Supermemory.'. Supermemory a reformulé une phrase à la troisième personne en un fait à la première personne sur l’utilisateur : c’est l’extracteur de profil à l’œuvre.
profile.static est vide. Les faits statiques se consolident plus lentement, après quelques journaux liés, donc un seul écrit d’échauffement n’en produit pas. L’outil de suggestion du coach l’anticipe et traite static comme un bonus, pas une garantie.
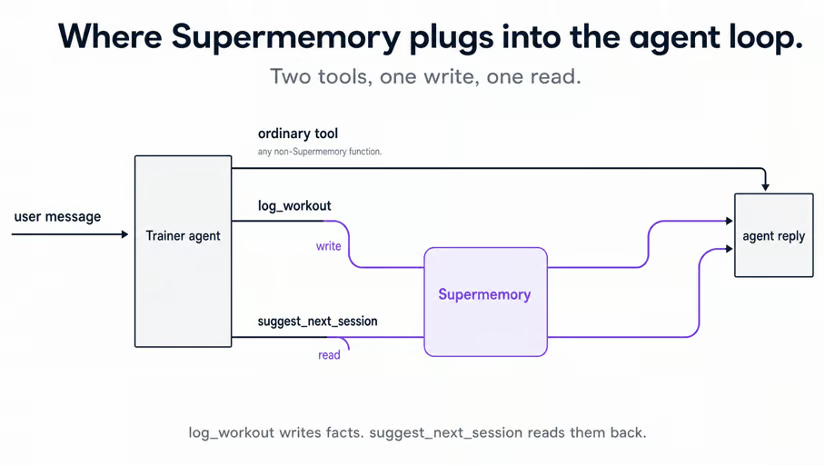
Le coach encapsule client.add() et client.profile() dans deux outils d’agent, pour que lectures et écritures se fassent automatiquement pendant l’échange. Un historique d’entraînement se prête bien à la mémoire. Matériel, blessures et charges récentes n’existent pas dans les données d’entraînement du LLM et s’accumulent séance après séance.
Le coach est assez compact pour tenir en deux fichiers Python plus le pyproject.toml déjà présent :
supermemory-trainer/
├── .env            	# your real keys (gitignored)
├── .env.example    	# placeholders, committed
├── .gitignore
├── .python-version
├── main.py         	# agent definition, system prompt, REPL loop
├── pyproject.toml
└── tools.py        	# log_workout and suggest_next_session
tools.py contient les deux outils adossés à la mémoire que vous allez écrire. log_workout écrit un entraînement dans Supermemory via client.add(). suggest_next_session lit le profil utilisateur via client.profile(). main.py importe les deux et connecte l’agent.
L’essentiel de main.py est du boilerplate du SDK OpenAI Agents. Une phrase dans le prompt système fait le travail Supermemory : tout fait sur l’utilisateur doit revenir via des appels d’outil. L’agent est informé qu’il n’a aucune mémoire propre. Cette seule règle rend le coach adossé à la mémoire.
Ouvrez main.py et commencez par les imports et le prompt système :
import asyncio

from agents import Agent, Runner, SQLiteSession

from tools import log_workout, suggest_next_session

SYSTEM_PROMPT = """You are a personal exercise trainer who logs the user's
workouts and recommends what to do next.

You have no memory of the user's history on your own. Every fact about the
user lives in Supermemory and reaches you only through tool calls.

Two rules, no exceptions:

1. Whenever the user reports completing a workout, call log_workout immediately, before responding. Extract the exercise, sets, reps, weight, and any notes from what they said. If a value is missing, ask one short follow-up question instead of guessing. After logging, confirm in one short sentence and stop. Do NOT recommend the next session unless the user asks for one.

2. When the user explicitly asks what to do next (or asks for a recommendation, suggestion, or plan), call suggest_next_session first. Never recommend from your own training data. The tool returns the user's
 recent activity, stable preferences, and matching past sessions. Reference those facts directly in your reply.

Keep replies concise (2-4 sentences). Be specific: name the exercise, sets, reps, and weight. Honor any injuries or equipment constraints the tool surfaces.
"""
Les deux règles du prompt système forcent le modèle à passer par Supermemory.
La règle 1 impose un appel à log_workout dès qu’un entraînement est déclaré, pour que chaque séance rejoigne le store mémoire. La règle 2 impose un appel à suggest_next_session avant toute recommandation, afin qu’elle s’appuie sur ce que Supermemory sait.
Sans ces règles, l’agent répondrait à partir de ses données d’entraînement, ce qui annule l’intérêt d’une couche mémoire.
Définissez maintenant l’agent et la boucle de chat dans le même fichier :
def build_agent() -> Agent:
	return Agent(
    	name="Trainer",
    	instructions=SYSTEM_PROMPT,
    	tools=[log_workout, suggest_next_session],
    	model="gpt-5",
	)


async def chat() -> None:
	agent = build_agent()
	session = SQLiteSession(session_id="trainer-cli")

	print("Trainer ready. Type a message, or 'exit' to quit.\n")
	while True:
    	try:
        	message = input("You: ").strip()
    	except (EOFError, KeyboardInterrupt):
        	print()
        	break
    	if not message:
        	continue
    	if message.lower() in {"exit", "quit"}:
        	break

    	result = await Runner.run(agent, message, session=session)
    	print(f"\nTrainer: {result.final_output}\n")


if __name__ == "__main__":
	asyncio.run(chat())
Deux lignes méritent d’être soulignées. tools=[log_workout, suggest_next_session] enregistre les deux outils adossés à la mémoire. Le décorateur @function_tool sur chacun (dans tools.py) indique au SDK qu’ils sont appelables. Sans ce décorateur, l’agent n’a pas d’outils à l’exécution, même si la construction réussit.
SQLiteSession(session_id="trainer-cli") conserve l’historique court terme des tours dans le processus Python en cours. Supermemory conserve les faits long terme à travers les processus. Tuer le processus Python supprime la session SQLite, mais les données Supermemory restent.
Important : exécutez main.py comme un script, pas dans une cellule Jupyter, car la boucle d’événements de Jupyter entre en conflit avec asyncio.run(). Le client synchrone Supermemory() fonctionne dans des fonctions d’outils async, car le SDK Agents exécute les outils dans un pool de threads. Pour en savoir plus sur le SDK, consultez le tutoriel OpenAI Agents SDK.
log_workout est la partie écriture de la mémoire de l’agent. La fonction reçoit des arguments structurés : exercice, séries, répétitions, charge et notes optionnelles. Elle les transforme en une courte phrase en anglais et envoie cette phrase à Supermemory via client.add(). Le pipeline d’embedding et d’extraction s’exécute ensuite côté Supermemory sans intervention du coach.
Ouvrez tools.py et commencez par les imports et un client partagé :
from agents import function_tool
from dotenv import load_dotenv
from supermemory import Supermemory

load_dotenv()

USER_ID = "demo_user"

client = Supermemory()
load_dotenv() s’exécute à l’import pour placer SUPERMEMORY_API_KEY dans l’environnement avant la construction de Supermemory(). Si vous construisez le client avant de charger l’env, vous obtiendrez un client non authentifié et un 401 déroutant au premier appel. Les deux fonctions d’outils partagent ce client unique et la constante USER_ID.
Ajoutez l’outil de journalisation sous le client :
@function_tool
def log_workout(
	exercise: str,
	sets: int,
	reps: int,
	weight: float,
	notes: str = "",
) -> str:
	"""Log a completed workout to the user's memory.

	Args:
    	exercise: Name of the exercise.
    	sets: Number of sets performed.
    	reps: Number of reps per set.
    	weight: Weight in pounds. Pass 0 for bodyweight or cardio.
    	notes: Optional notes about the session.
	"""
	print(f"[log_workout] {exercise=} {sets=} {reps=} {weight=} {notes=}")

	content = f"Performed {exercise}: {sets} sets of {reps} reps at {weight} lbs."
	if notes:
    	content += f" Notes: {notes}"

	response = client.add(content=content, container_tag=USER_ID)
	print(f"[log_workout] -> id={response.id} status={response.status}")
	return f"Logged {exercise} ({sets}x{reps} @ {weight} lb)."
La docstring du @function_tool est ce que le LLM voit pour décider d’appeler l’outil. Le bloc Args: décrit chaque paramètre. Les deux font partie du contrat entre l’agent et la fonction.
L’outil envoie une phrase en langage naturel à client.add(), pas du JSON. L’extracteur de profil de Supermemory lit le langage naturel et en infère des faits. Le JSON fonctionne techniquement, mais la qualité d’extraction baisse faute de narration à résumer. « Performed bench press: 4 sets of 5 reps at 185.0 lbs » offre une phrase nette à l’extracteur.
Les deux appels print() tracent chaque invocation : d’abord les arguments parsés, puis la réponse.
[log_workout] exercise='bench press' sets=4 reps=5 weight=185.0 notes=''
[log_workout] -> id=xY7AK3qLzBPx5Vd2HnRf1M status=queued
La valeur status="queued" correspond à celle du script d’échauffement. Le journal brut est stocké, mais client.profile() ne le renverra pas tant que le pipeline n’aura pas fini. Vous ajouterez plus tard une vérification qui attend la stabilisation.
suggest_next_session est la partie lecture, et c’est là que le découpage statique/dynamique porte ses fruits. Un seul appel client.profile(container_tag=USER_ID, q=focus) renvoie trois vues de l’utilisateur en un aller‑retour.
Les préférences stables arrivent dans profile.static, l’activité en cours dans profile.dynamic, et les souvenirs les plus proches dans search_results.results. Le rôle de l’outil est d’aplatir ces trois vues en un bloc de contexte que l’agent peut citer.
Après quelques séances, l’outil produit une sortie comme ceci :
Recent activity:
- Trains at home instead of a gym
- Performed deadlift: 3 sets of 5 reps at 225.0 lbs
- Performed 5k run in 26 minutes
- Reports no knee pain during bench press
- Performed bench press: 4 sets of 5 reps at 185.0 lbs
Closest matching past entries:
- Trains at home instead of a gym
- Performed deadlift: 3 sets of 5 reps at 225.0 lbs
- Performed bench press: 4 sets of 5 reps at 185.0 lbs
- Performed 5k run in 26 minutes
- Reports no knee pain during bench press
L’agent lit ce bloc et rédige une recommandation ancrée dans l’historique réel de l’utilisateur. Sans le profil Supermemory, vous devriez construire le même contexte : recherche sémantique séparée, store de profil maison et fusion des résultats. Le simple appel client.profile() remplace ces trois étapes.
Ajoutez ceci à tools.py sous log_workout :
@function_tool
def suggest_next_session(focus: str) -> str:
	"""Fetch the user's training history and preferences for a given focus.

	Returns a context string the agent can use to recommend the next session.
	The agent is responsible for the actual recommendation. This tool only
	surfaces what Supermemory knows about the user.

	Args:
    	focus: What the user wants to train next (e.g. "upper body", "legs",
        	"cardio", "today"). Drives semantic search against past logs.
	"""
	print(f"[suggest_next_session] focus={focus!r}")
	profile = client.profile(container_tag=USER_ID, q=focus)

	static_facts = profile.profile.static
	dynamic_facts = profile.profile.dynamic
	matches = profile.search_results.results

	print(
    	f"[suggest_next_session] static={len(static_facts)} "
    	f"dynamic={len(dynamic_facts)} matches={len(matches)}"
	)

	sections = []
	if static_facts:
    	sections.append("Stable preferences and constraints:")
    	sections.extend(f"- {fact}" for fact in static_facts)
	if dynamic_facts:
    	sections.append("Recent activity:")
    	sections.extend(f"- {fact}" for fact in dynamic_facts)
	if matches:
    	sections.append("Closest matching past entries:")
    	for r in matches[:5]:
        	sections.append(f"- {r['memory']}")

	if not sections:
    	return (
        	"No prior training history found for this user. "
        	"Ask the user about their goals, equipment, and recent training."
    	)
	return "\n".join(sections)
client.profile(container_tag=USER_ID, q=focus) renvoie un objet ProfileResponse. Après 5 courts journaux, les trois champs lus par l’outil ressemblent à ceci :
profile.profile.static        	# [] (list[str])
profile.profile.dynamic       	# ["Performed bench press: 4 sets of 5 reps at 185.0 lbs", ...]
profile.search_results.results	# [{"memory": "...", "similarity": 0.631, ...}, ...] (list[dict])
Chaque résultat de recherche est un dict Python, pas un objet Pydantic. Utilisez r["memory"] pour le texte et r["similarity"] pour le score. Le dict complet contient les clés suivantes :
id
memory
rootMemoryId
metadata
updatedAt
version
similarity
filepath
documents
L’extrait r.memory or r.chunk de la page d’intégration OpenAI Agents SDK de Supermemory lève AttributeError avec supermemory==3.37.0. Utilisez l’accès par crochets.
static est vide ici, d’où le branchement if static_facts:. Les branches dynamic et search_results font le gros du travail sur la première douzaine de journaux.
Supermemory applique aussi un seuil de similarité par défaut. Un fait mentionné une seule fois ne reviendra pas à chaque requête. Les 5 journaux ci‑dessus ressortent tous avec q="today", mais une requête plus spécifique peut en renvoyer moins. Le garde‑fou if matches: gère cela sans erreur.
Lancez la session 1 et journalisez quelques entraînements pour remplir Supermemory avant de relire. Exécutez le script :
uv run python main.pyJournalisez un développé couché, puis une course de 5 km, puis un soulevé de terre, plus une préférence : « Je m’entraîne uniquement à la maison, pas de salle. » L’agent déclenche log_workout une fois par séance, et les lignes print() de l’outil rendent chaque appel visible dans le terminal.
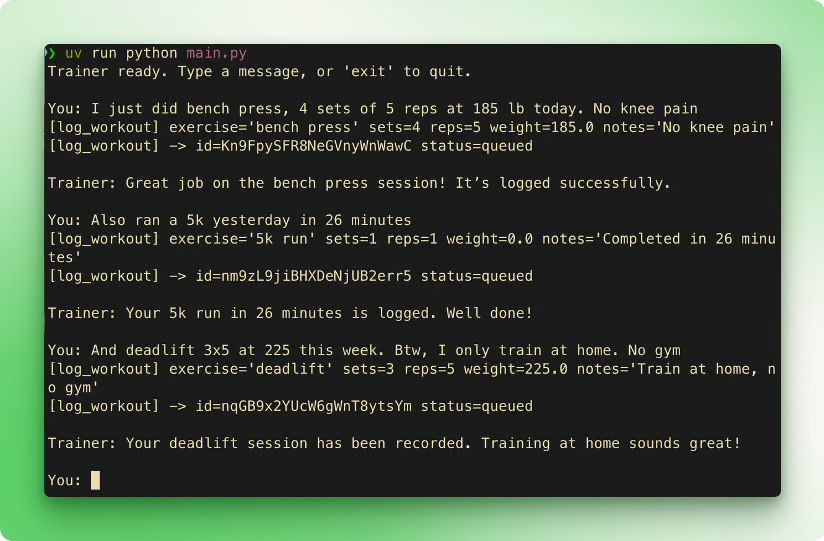
Exemple de sortie. La formulation exacte variera car le modèle est non déterministe.
Les trois lignes status=queued marquent le moment où Supermemory prend le relais. Chacune correspond à un document qui traverse le pipeline d’embedding et d’extraction côté Supermemory. Pour des journaux courts comme ceux‑ci, le document devient interrogeable via client.profile() en ~12 secondes.
Rien dans le code du coach n’attend cela. L’agent continue, et Supermemory termine en arrière‑plan.
Chaque journal déclenche exactement un appel à log_workout, puis l’agent s’arrête. Pas de recommandations proactives, pas d’appels supplémentaires, pas de relances. La première règle du prompt système impose ce comportement. Sans elle, l’agent proposerait une séance après chaque journal, doublant les appels d’outil.
Tapez exit pour fermer la session 1. Le processus Python se termine, et la SQLiteSession disparaît avec lui. Les journaux d’entraînement et la préférence vivent désormais dans Supermemory sous container_tag="demo_user", indépendamment du script qui les a écrits.
Avant la session 2, confirmez que les faits de la session 1 sont interrogeables. Ouvrez un REPL Python neuf ou enregistrez ce court script :
from dotenv import load_dotenv
from supermemory import Supermemory

load_dotenv()
client = Supermemory()

prof = client.profile(container_tag="demo_user", q="training")
print(f"static  ({len(prof.profile.static)}): {prof.profile.static}")
print(f"dynamic ({len(prof.profile.dynamic)}):")
for fact in prof.profile.dynamic:
	print(f"  - {fact}")
print(f"matches ({len(prof.search_results.results)}):")
for r in prof.search_results.results[:5]:
	print(f"  - {r['memory']} (similarity={r['similarity']:.3f})")
Sortie réelle capturée entre les deux sessions :
static  (0): []
dynamic (5):
  - Trains at home instead of a gym
  - Performed deadlift: 3 sets of 5 reps at 225.0 lbs
  - Performed 5k run in 26 minutes
  - Reports no knee pain during bench press
  - Performed bench press: 4 sets of 5 reps at 185.0 lbs
matches (5):
  - Trains at home instead of a gym (similarity=0.682)
  - Performed deadlift: 3 sets of 5 reps at 225.0 lbs (similarity=0.643)
  - Performed bench press: 4 sets of 5 reps at 185.0 lbs (similarity=0.631)
  - Performed 5k run in 26 minutes (similarity=0.585)
  - Reports no knee pain during bench press (similarity=0.585)
Observez le résultat de l’extracteur Supermemory. L’utilisateur a dit une fois « Je m’entraîne uniquement à la maison, pas de salle ». L’extracteur l’a transformé en fait dynamique "Trains at home instead of a gym".
Le journal du bench comprenait une note d’absence de douleur au genou. L’extracteur a scindé ce seul journal en deux faits dynamiques : un pour l’entraînement, un pour l’absence de douleur.
Quatre journaux sont devenus cinq faits dynamiques normalisés, plus cinq fragments de mémoire appariés avec des similarités de 0,585 à 0,682. Aucun de ces découpages, normalisations ou appariements n’a tourné dans le code du coach. Si dynamic est vide pour vous, attendez 10 secondes et relancez. La file de traitement peut ponctuellement gonfler.
Démarrez maintenant la session 2 dans un nouveau processus :
uv run python main.pyC’est un interpréteur Python frais. Pas de mémoire partagée avec la session 1. Pas de cache chaud. Tout rappel de l’agent provient de Supermemory.
Envoyez un message : « Que devrais‑je faire pour mon entraînement aujourd’hui ? »
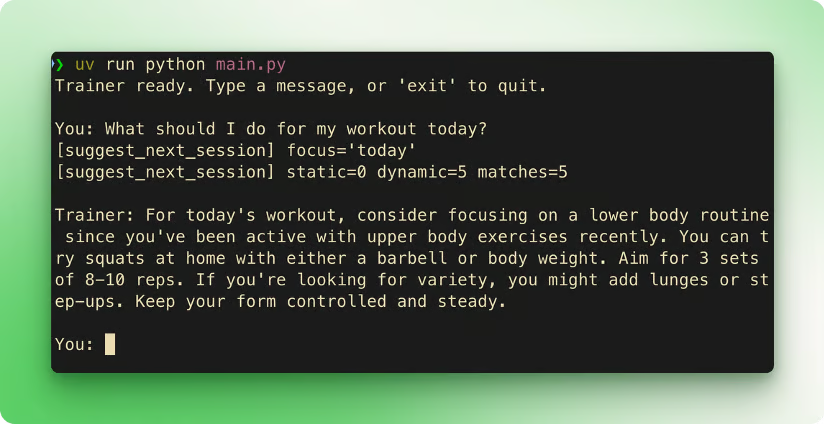
Exemple de sortie. Même store mémoire, nouveau processus Python.
L’agent appelle suggest_next_session("today"). L’outil affiche static=0 dynamic=5 matches=5. La session capturée a répondu avec une séance bas‑du‑corps à la maison (squats, fentes, step‑ups).
La recommandation s’aligne sur les journaux précédents car le profil Supermemory les a rappelés. Bench, soulevé de terre et 5 km étaient haut du corps ou cardio, et l’utilisateur ne s’entraîne qu’à la maison. Les deux faits sont revenus via le même appel client.profile(). Votre exécution formulera sans doute différemment, le modèle étant non déterministe, mais le chemin de rappel est identique.
La démo couvre un utilisateur, deux outils et une CLI. Une version réelle du coach s’étend dans trois directions liées à Supermemory avant de toucher à la boucle d’agent.
Isoler la mémoire par utilisateur réel. La constante USER_ID = "demo_user" convient pour une personne. En production, on calcule l’étiquette depuis l’ID authentifié, p. ex. container_tag="user_sarah" ou container_tag=customer_id. La mémoire reste séparée entre utilisateurs, car chaque lecture renvoie l’étiquette. Un changement dans tools.py, pas ailleurs.
Ajouter d’autres outils adossés à la mémoire. Semaines de deload, suivi des PR, rappels de mobilité hebdomadaires. Chaque outil est une fonction @function_tool qui appelle client.add() pour écrire et client.profile() pour lire avec le même container_tag. La forme de l’outil reste identique ; seuls les contenus changent.
Gérer les défaillances Supermemory. Encapsulez client.add() et client.profile() dans try/except supermemory.APIError pour éviter que des erreurs transitoires ne fassent tomber l’agent. Définissez des timeouts si votre agent tourne en environnement contraint.
Le côté boucle d’agent est indépendant de Supermemory et peut évoluer. Mettez une interface Telegram, Discord ou Slack devant la CLI pour que l’utilisateur texte une séance et que le bot appelle Runner.run(). Ou changez de cadre. Supermemory propose une intégration LangChain si votre pile utilise déjà des agents LangChain, sans changer le code mémoire.
La séparation statique/dynamique s’applique aussi à d’autres domaines.
La séparation tient dès lors que l’utilisateur est la source de vérité.
Vous venez de créer un coach Python avec deux outils et une mémoire persistante entre processus. client.add() écrit les séances. client.profile() relit l’utilisateur sous forme de faits statiques, faits dynamiques et correspondances sémantiques en un appel, tous bornés par container_tag. Supermemory gère le découpage, l’embedding, la recherche et l’extraction de profil que la démo n’a pas eu à coder.
Associez‑le au RAG, et le même agent répond aux questions sur l’utilisateur et le produit. LLM Agents Explained couvre des schémas d’agents plus larges, et le Associate AI Engineer for Developers track alle plus loin sur les agents adossés à la mémoire.
Formez‑vous à l’ingénierie de l’IA avec DataCamp !
Cursus
Cours
Cursus