
Kurs
Python ile Zaman Serisi Analizi
4 sa
70.9K
Alıştırma and program your progress.
Google Ile Devam Edin4 Ocak’taki Facebook Live kodlama oturumunda, 'diet', 'gym' ve 'finance' anahtar kelimelerinin Google Trends verilerine bakarak zaman içinde nasıl değiştiklerini inceledik. Hepimizin yeni bir sayfa açmaya çalıştığı Ocak ayında bu terimlere yönelik aramalar daha fazla olabilir mi diye merak ettik.
Bu eğitimde, oturum sırasında birlikte yazdığımız kodu adım adım gözden geçireceksiniz. Çok fazla matematik yapmayacaksınız. Bu eğitimin odağı, söz konusu veri kümesinin görsel olarak keşfedilmesi olacak.
pandas hakkında daha fazlası için DataCamp’in Python ile Veri Manipülasyonu yoluna göz atın. pandas ile zaman serileri hakkında daha fazlası için Python’da Zaman Serisi Verilerini Manipüle Etme kursuna bakın.
Şu soru hâlâ geçerli: Hepimizin yeni bir başlangıç yaptığı Ocak ayında bu terimlere yönelik aramalar daha fazla olabilir mi?
Bunu anlamak için buraya gidip verileri inceleyelim. Not: Bu eğitim, şu FiveThirtyEight yazısından esinlenmiştir.
Ayrıca verileri .csv olarak indirebilir, dosyaya kaydedip kendi Python ortamınıza aktararak kendi analizlerinizi gerçekleştirebilirsiniz. Bunu şimdi yapacaksınız. Haydi başlayalım!
Önce bazı paketleri içe aktaracaksınız: Bu örnekte numpy, pandas, matplotlib ve seaborn kullanacaksınız.
Ek olarak, görsellerin Jupyter Notebook içinde çizilmesini istiyorsanız, koda %matplotlib inline ekleyerek IPython sihrini kullanabilirsiniz. Alternatif olarak, sns.set() ile Seaborn varsayılanlarına da geçebilirsiniz:
# Import packages
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
import seaborn as sns
%matplotlib inline
sns.set()
İndirdiğiniz verileri .read_csv() ile içe aktarın ve ilk birkaç satırı .head() ile görüntüleyin.
Not: Dosyanın başındaki ilk satırı atlamak için skiprows argümanını ekliyorsunuz.
 df = pd.read_csv('data/multiTimeline.csv', skiprows=1)
df.head()| Month | diet: (Worldwide) | gym: (Worldwide) | finance: (Worldwide) | |
|---|---|---|---|---|
| 0 | 2004-01 | 100 | 31 | 48 |
| 1 | 2004-02 | 75 | 26 | 49 |
| 2 | 2004-03 | 67 | 24 | 47 |
| 3 | 2004-04 | 70 | 22 | 48 |
| 4 | 2004-05 | 72 | 22 | 43 |
Veri tiplerini, satır sayısını ve daha fazlasını kontrol etmek için .info() metodunu da kullanabilirsiniz:
df.info()
<class 'pandas.core.frame.DataFrame'>
RangeIndex: 168 entries, 0 to 167
Data columns (total 4 columns):
Month                   168 non-null object
diet: (Worldwide)       168 non-null int64
gym: (Worldwide)        168 non-null int64
finance: (Worldwide)    168 non-null int64
dtypes: int64(3), object(1)
memory usage: 5.3+ KB
Artık Google Trends verilerini içe aktardığınıza ve kısaca göz attığınıza göre, veri analizi için hazırlamak üzere verilerinizi düzenleme zamanı.
İlk olarak, DataFrame’iniz df içindeki sütun adlarını boşluk içermeyecek şekilde yeniden adlandırmak isteyeceksiniz. Bunu yapmanın birden fazla yolu var, ancak şimdilik, istediğiniz sütun adlarını içeren bir listeyi df.columns’a yeniden atayacaksınız.
Yeniden atamanın sonucunu df.head() çağırarak tekrar kontrol edin:
df.columns = ['month', 'diet', 'gym', 'finance']
df.head()
| month | diet | gym | finance | |
|---|---|---|---|---|
| 0 | 2004-01 | 100 | 31 | 48 |
| 1 | 2004-02 | 75 | 26 | 49 |
| 2 | 2004-03 | 67 | 24 | 47 |
| 3 | 2004-04 | 70 | 22 | 48 |
| 4 | 2004-05 | 72 | 22 | 43 |
Sonraki adımda, 'month' sütununu DateTime veri tipine dönüştürüp DataFrame’in indeksi yapacaksınız.
Not: Bunu yapmanızın sebebi, .info() sonucunda 'Month' sütununun aslında object veri tipinde olduğunu görmeniz. Bu genel veri tipi, dizelerden tamsayılara kadar her şeyi kapsar. Zaman serisi verilerine bakarken bu tam istediğiniz şey değildir. Bu yüzden, DataFrame’inizdeki 'month' sütununu DateTime’a dönüştürmek için .to_datetime() kullanacaksınız.
Dikkat! DataFrame df’in indeksini ayarlarken inplace argümanını dahil ettiğinizden emin olun ki orijinal indeksi gerçekten değiştirip 'month' sütununa ayarlayın.
df.month = pd.to_datetime(df.month)
df.set_index('month', inplace=True)
df.head()
| diet | gym | finance | |
|---|---|---|---|
| month | |||
| 2004-01-01 | 100 | 31 | 48 |
| 2004-02-01 | 75 | 26 | 49 |
| 2004-03-01 | 67 | 24 | 47 |
| 2004-04-01 | 70 | 22 | 48 |
| 2004-05-01 | 72 | 22 | 43 |
Şimdi DataFrame’inizi görsel olarak keşfetme zamanı.
Verilerinizi tek bir şekilde 3 çizgi grafik olarak çizmek için yerleşik pandas görselleştirme metodu .plot()’u kullanabilirsiniz (her sütun için bir tane: 'diet', 'gym' ve 'finance').
Not: Bu metoda figsize, linewidth ve fontsize gibi argümanlar da belirtebilirsiniz; sırasıyla şekil boyutunu, çizgi kalınlığını ve yazı tipi boyutunu ayarlar.
Ayrıca, x ekseninde varsayılan etiket aylarına işaret etse de aslında yılların göründüğünü göreceksiniz. Grafiğinizi biraz daha doğru hale getirmek için x ekseni etiketini 'Year' olarak belirtecek ve yazı tipi boyutunu 20 yapacaksınız.
İpucu: Matplotlib çıktısını bastırmak isterseniz, kodunuzun son satırına bir noktalı virgül ; ekleyin!
df.plot(figsize=(20,10), linewidth=5, fontsize=20)
plt.xlabel('Year', fontsize=20);
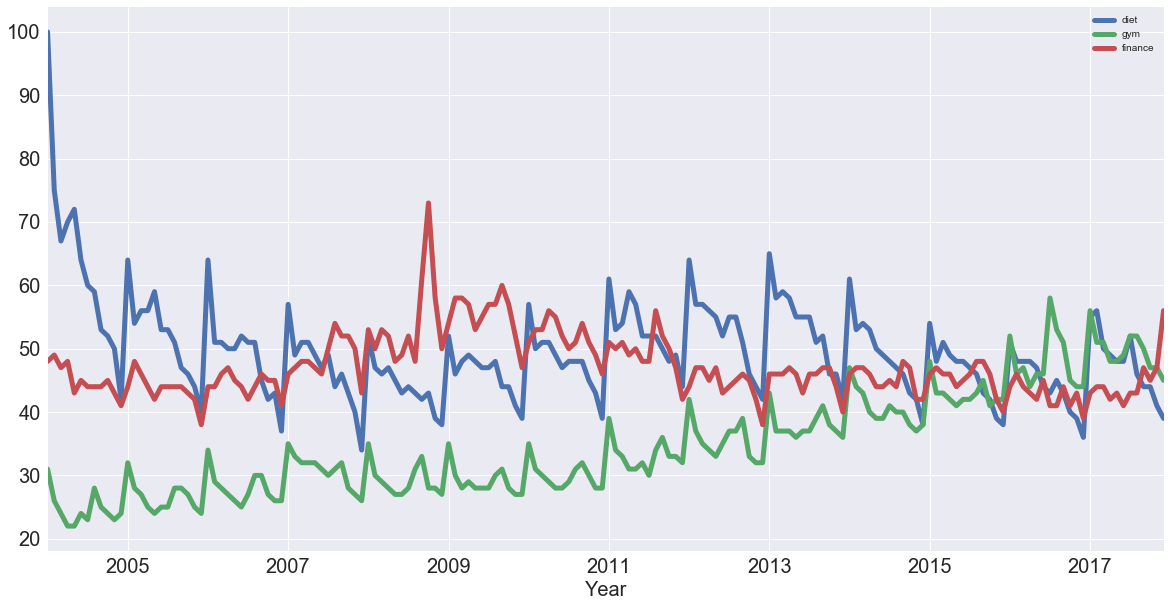
Not: Bu veriler görecektir. Google Trends’te yazdığı gibi:
Rakamlar, verilen bölge ve zaman için grafikteki en yüksek noktaya göre arama ilgisini temsil eder. 100 değeri, terimin popülerliğinin zirvesidir. 50 değeri, terimin yarı yarıya popüler olduğu anlamına gelir. Benzer şekilde 0 puan, terimin zirveye göre %1’den daha az popüler olduğu anlamına gelir.
İsterseniz, 'diet' sütununu tek başına bir zaman serisi olarak da çizebilirsiniz:
df[['diet']].plot(figsize=(20,10), linewidth=5, fontsize=20)
plt.xlabel('Year', fontsize=20);
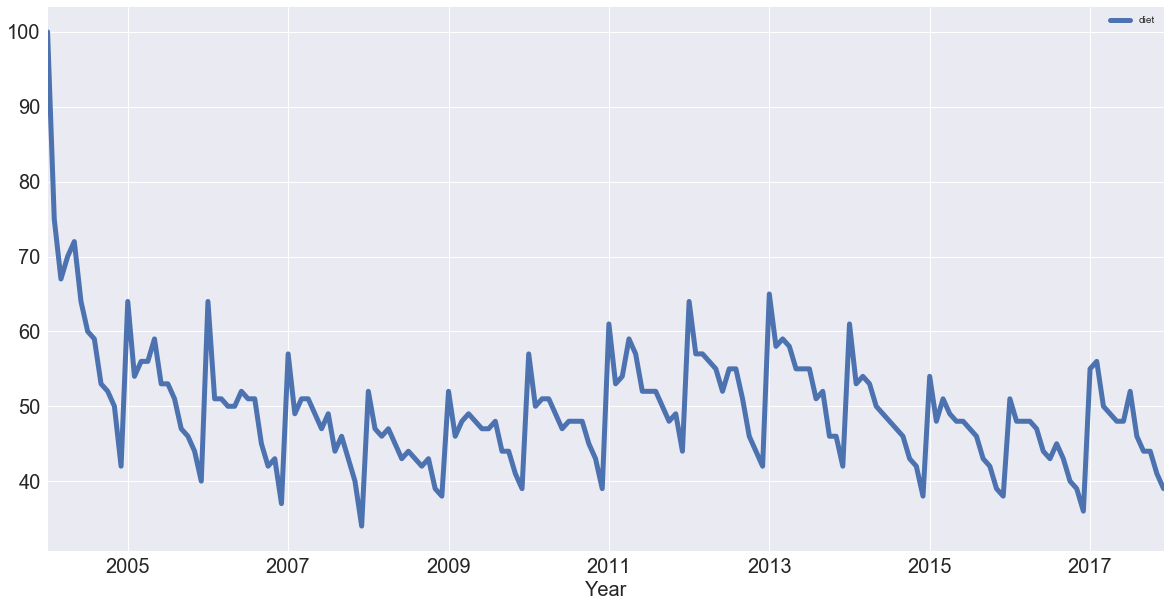
Not: İlk fark edilecek şey mevsimselliktir: Her Ocak ayında büyük bir sıçrama var. Ayrıca bir trend de var gibi görünüyor: hafifçe yukarı, sonra aşağı, tekrar yukarı ve tekrar aşağı gidiyor. Başka bir deyişle, bu zaman serilerinde hem trend hem de mevsimsel bileşenler var gibi duruyor.
Bunu aklınızda tutarak, zaman serinizde trendleri nasıl belirleyeceğinizi öğreneceksiniz!
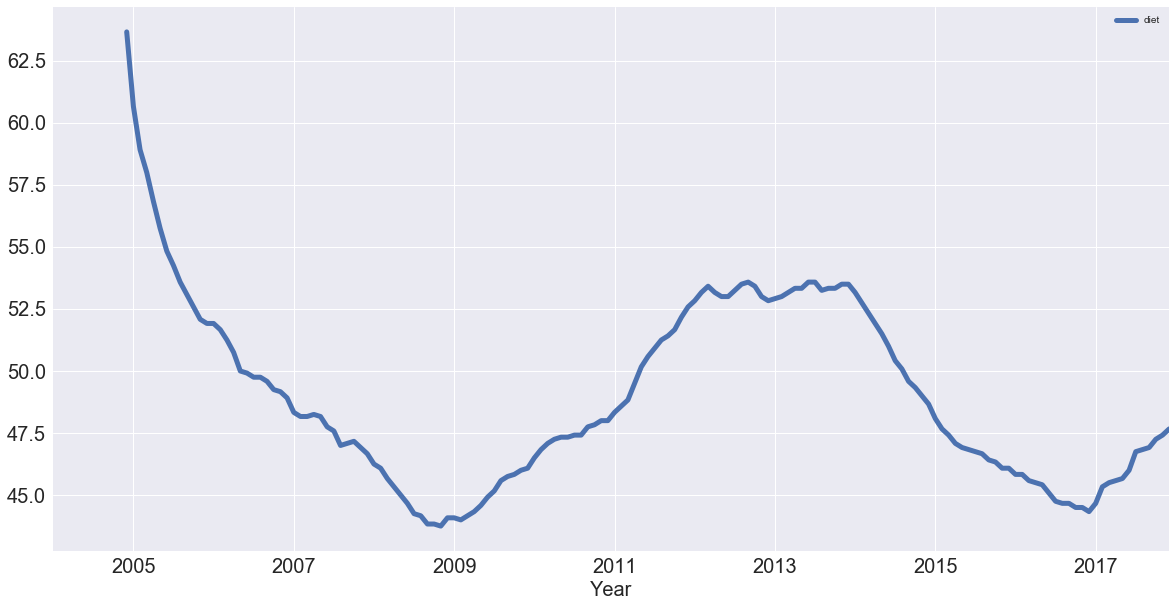
Zaman serilerinde trendleri belirlemeyi düşünmenin birkaç yolu vardır. Popüler bir yol, her zaman noktası için her iki yanındaki noktaların ortalamasını aldığınız hareketli ortalama almaktır. Nokta sayısının, seçmeniz gereken bir pencere boyutu ile belirlendiğine dikkat edin.
Ortalama aldığınız için, bu yöntem gürültüyü ve mevsimselliği düzleştirme eğilimindedir. Şimdi bunun bir örneğini göreceksiniz. Yerleşik pandas metodlarını kullanarak 'diet' için bu hareketli ortalamaya bakın.
Pencere boyutunu belirlerken, yıllık mevsimsellikten bahsettiğiniz için, önce on iki aylık bir pencereyi denemek mantıklıdır.
diet = df[['diet']]
diet.rolling(12).mean().plot(figsize=(20,10), linewidth=5, fontsize=20)
plt.xlabel('Year', fontsize=20);
Not: Yukarıdaki kod bloğunda 'diet' sütununu bir DataFrame olarak çıkarmak için iki köşeli parantez kullandınız; Tek parantez kullansaydınız, örneğin df['diet'] gibi, bir pandas Series oluşturmuş olurdunuz.
Ayrıca yukarıdaki kod bloğunda metod zincirleme kullandınız: bir nesne üzerinde ardı ardına metodlar çağırdınız. Metod zincirleme oldukça popülerdir ve pandas bu programlama stilini sonuna kadar kullanmanıza gerçekten imkân tanıyan paketlerden biridir!
Artık aradığınız trend elinizde! Önceki grafiğe kıyasla mevsimselliğin çoğunu kaldırdınız.
Aynı pencere boyutunu kullanarak yerleşik pandas metodlarıyla 'gym' için de hareketli ortalamayı çizebilirsiniz:
gym = df[['gym']]
gym.rolling(12).mean().plot(figsize=(20,10), linewidth=5, fontsize=20)
plt.xlabel('Year', fontsize=20);
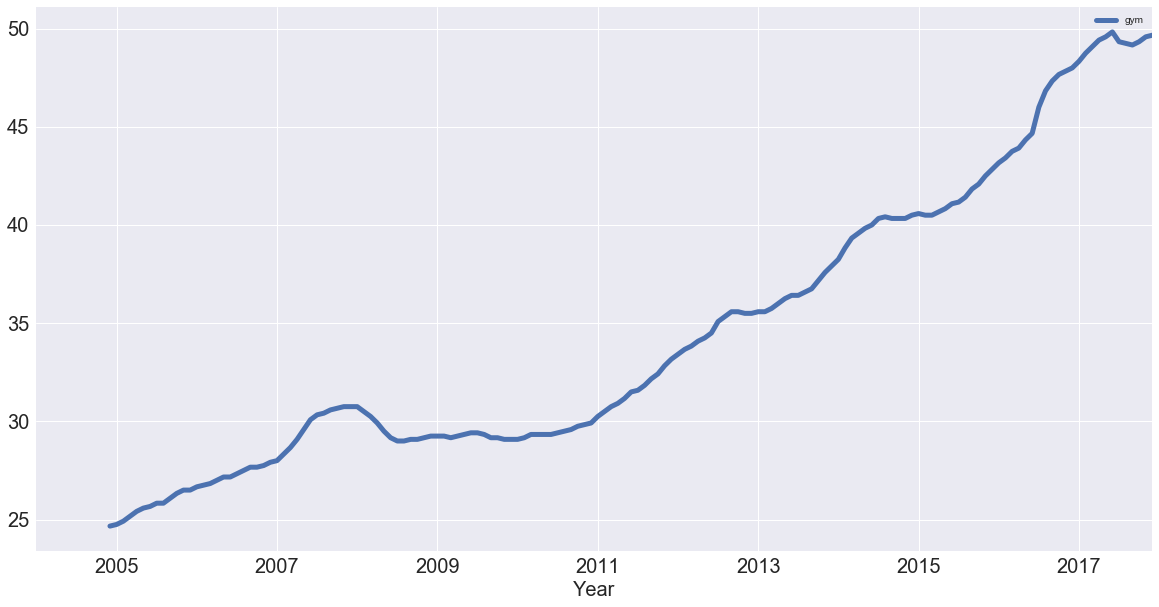
Mevsimselliği başarıyla kaldırdınız ve "gym" için yukarı yönlü bir trend görüyorsunuz! Peki bu iki arama terimi nasıl karşılaştırılır?
Bunu, 'gym' ve 'diet' trendlerini tek bir şekilde çizerek anlayabilirsiniz:
df_rm = pd.concat([diet.rolling(12).mean(), gym.rolling(12).mean()], axis=1)
df_rm.plot(figsize=(20,10), linewidth=5, fontsize=20)
plt.xlabel('Year', fontsize=20);
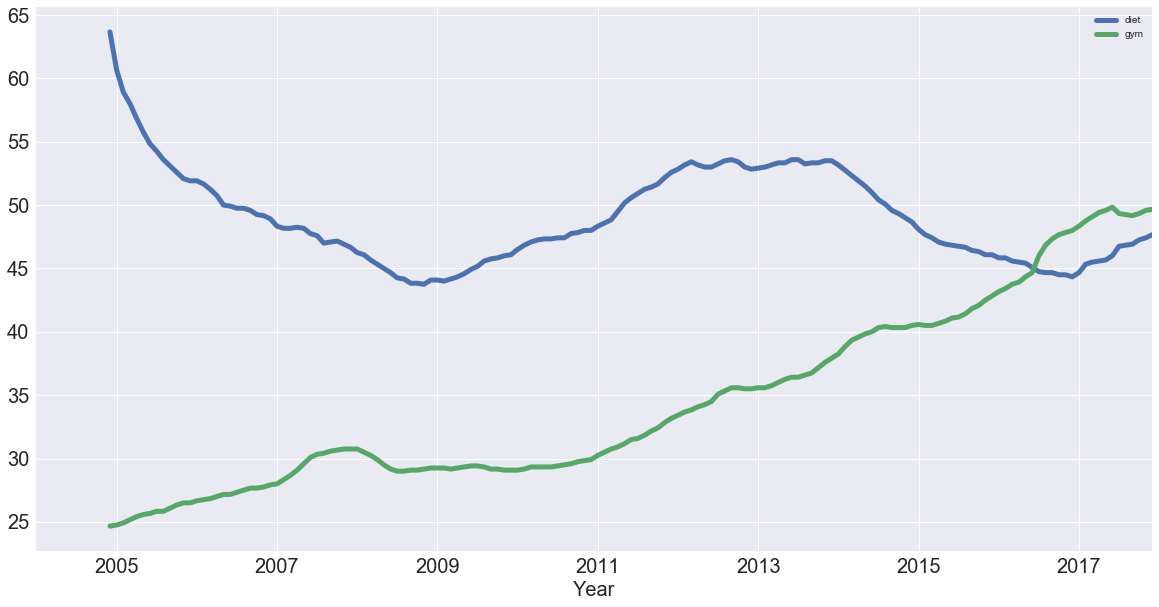
'diet' ve 'gym' hareketli ortalamalarını içeren iki sütunlu yeni bir DataFrame olan df_rm oluşturdunuz. İlk argüman olarak sütunların bir listesini alan pd.concat() fonksiyonunu kullandınız ve sütunlar olarak birleştirmek istediğiniz için axis argümanını 1 olarak ayarladınız.
Ardından, tıpkı daha önce yaptığınız gibi plot() metodu ile DataFrame’i çizdiniz! Artık mevsimselliği kaldırdığınızda, diet’in potansiyel olarak bir miktar mevsimsellik barındırdığını, gym’in ise aslında arttığını görüyorsunuz!
Verilerdeki trendleri belirledikten sonra, zaman serinizin tekrarlayıcı doğası olan mevsimsellik üzerine düşünme zamanı geldi. Bu eğitimin başında gördüğünüz gibi, verilerin zaman serilerinde trend ve mevsimsel bileşenler var gibi görünüyordu.
Verinizin zaman serisindeki mevsimsel bileşenleri düşünmenin bir yolu, mevsimselliği daha kolay inceleyebilmeniz için bir zaman serisinden trendi çıkarmaktır. Trendi kaldırmak için yukarıda hesapladığınız trendi (hareketli ortalama) orijinal sinyalden çıkarabilirsiniz. Ancak bu, kaç veri noktasını ortaladığınıza bağlı olacaktır.
Trendi kaldırmanın bir diğer yolu da ardışık veri noktaları arasındaki farklara bakmak olan "fark alma"dır ("birinci dereceden fark alma" olarak adlandırılır, çünkü yalnızca bir veri noktası ile ondan önceki arasındaki farka bakarsınız).
pandas’ı ve diff() ile plot() metodlarını kullanarak 'diet' Series’inin birinci dereceden farkını hesaplayıp çizebilirsiniz:
diet.diff().plot(figsize=(20,10), linewidth=5, fontsize=20)
plt.xlabel('Year', fontsize=20);
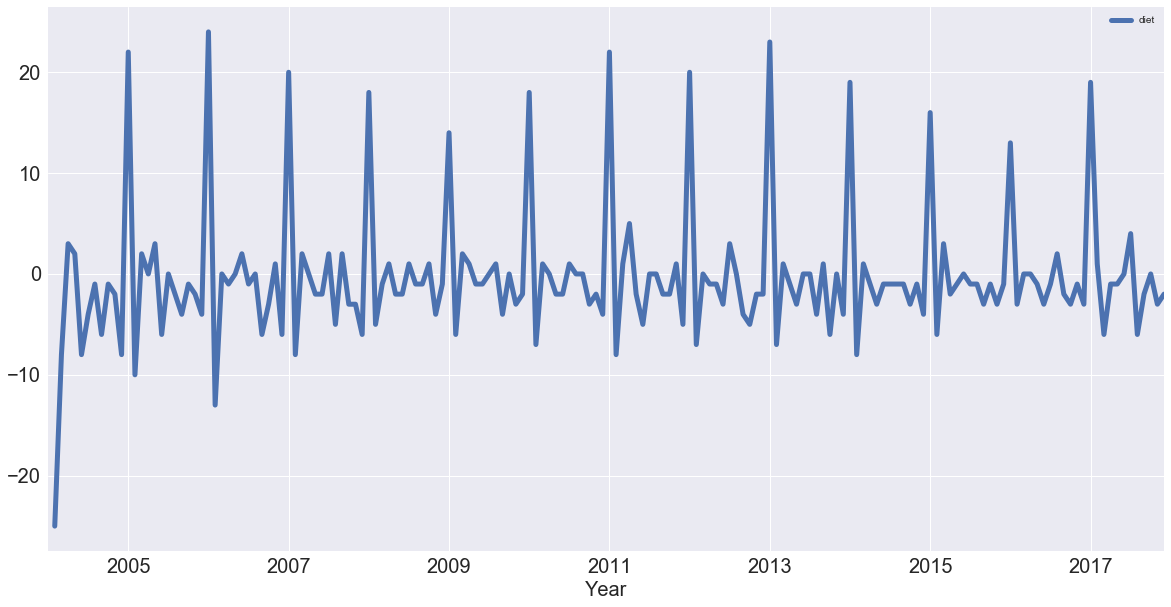
Trendin büyük kısmını kaldırdığınızı ve her yıl Ocak ayındaki zirveleri gerçekten görebildiğinizi fark edin. Her Ocak ayında, gördüğünüz en yüksek arama öğesinde %20 veya daha fazla büyük bir sıçrama var!
Not: Trend hâlâ tamamen kalkmadıysa, bir veri noktası ile ondan önceki iki nokta arasındaki farka baktığınız 2. dereceden fark alma da yapabilirsiniz. Fark alma hakkında daha fazlası için buraya bakın.
Fark alma, zaman serinizi durağan bir zaman serisine dönüştürmede son derece faydalıdır. Burada çok derine inmeyeceğiz ancak durağan zaman serisi, ortalama ve varyans gibi istatistiksel özellikleri zamanla değişmeyen seridir. Bu seriler, birçok zaman serisi tahmin yönteminin zaman serisinin yaklaşık olarak durağan olduğunu varsaymasına dayandığı için faydalıdır.
Tüm bunlarla birlikte, şimdi otokorelasyon fonksiyonuna bakarak zaman serinizdeki periyodiklik analizini yapacaksınız. Ancak ondan önce, kısa bir korelasyon turu yapalım.
Bir zaman serisi, belirli aralıklarla, örneğin her 12 ayda bir kendini tekrar ediyorsa periyodiktir.
Bunu şöyle de düşünebilirsiniz: Zaman serisinin bir yerde zirvesi varsa, bundan 12 ay sonra da bir zirvesi olacaktır; bir yerde dip varsa, 12 ay sonra da bir dip olacaktır.
Bunu düşünmenin bir başka yolu da zaman serisinin kendisinin 12 ay kaydırılmış hâliyle korelasyonlu olmasıdır. Yani zaman serisini 12 ay ileri ya da geri kaydırırsanız, bir şekilde kendisiyle çakışacaktır.
Bir zaman serisinin kendisinin böyle kaydırılmış bir sürümüyle olan korelasyonunu ele almak, otokorelasyon kavramıyla ifade edilir.
Bir dakika içinde buna geleceksiniz.
Önce, kendinize korelasyonu hatırlatalım ve bu kavrama sezgisel bir yaklaşım getirelim!
İki değişkenin korelasyon katsayısı, ne kadar doğrusal ilişkili olduklarını gösterir. Bunu anlamak için, çiçek ölçümlerini içeren iris veri setinin yardımıyla pratik bir örneğe bakacaksınız.
Bunu daha ayrıntılı incelemek için, scikit-learn’den iris veri setini içe aktaracak, bir DataFrame’e dönüştürecek ve .head() ile ilk satırlarına bakacaksınız:
from sklearn import datasets
iris = datasets.load_iris()
df_iris = pd.DataFrame(data= np.c_[iris['data'], iris['target']],
                     columns= iris['feature_names'] + ['target'])
df_iris.head()
| sepal length (cm) | sepal width (cm) | petal length (cm) | petal width (cm) | target | |
|---|---|---|---|---|---|
| 0 | 5.1 | 3.5 | 1.4 | 0.2 | 0.0 |
| 1 | 4.9 | 3.0 | 1.4 | 0.2 | 0.0 |
| 2 | 4.7 | 3.2 | 1.3 | 0.2 | 0.0 |
| 3 | 4.6 | 3.1 | 1.5 | 0.2 | 0.0 |
| 4 | 5.0 | 3.6 | 1.4 | 0.2 | 0.0 |
Bu veri setini anlamanız için kısa bir hatırlatma: Tüm çiçeklerin çanak yaprağı (sepal) ve taç yaprağı (petal) vardır. Çanak yaprak, taç yaprakları çevreler ve genellikle yeşil ve yaprak gibidir; taç yapraklar ise genellikle renklidir. Hedef değişken olan 'target' sütunu, iris çiçeklerinin türüdür ve Versicolor, Virginica veya Setosa olabilir. Yukarıdaki tabloda 0, 1 ve 2 olarak kodlanmıştır.
Şimdi korelasyonu düşünmek için, iris çiçeklerinin çanak yaprak uzunluğunun çanak yaprak genişliğiyle nasıl ilişkili olduğuna bakacaksınız. Bunu yapmak için pandas veya seaborn kullanarak 'sepal length' ile 'sepal width' dağılım grafiği oluşturacaksınız:
sns.lmplot(x='sepal length (cm)', y='sepal width (cm)', fit_reg=False, data=df_iris);
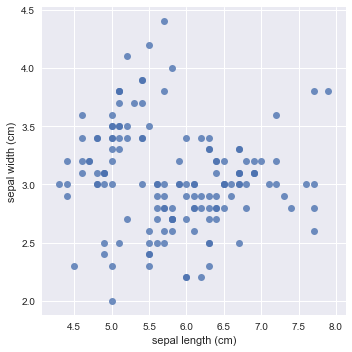
Not: fit_reg argümanını False yaparak doğrusal regresyonu kapattınız.
Çanak yaprak uzunluğu ve genişliği tüm çiçekler için pozitif mi negatif mi korelasyonludur? Peki her tür içinde pozitif mi negatif mi korelasyonludur? Bu önemli bir ayrımdır.
İlk durum, çanak yaprak uzunluğu arttıkça çanak yaprak genişliğinin de doğrusal olarak arttığı anlamına gelir. İkincisi ise çanak yaprak uzunluğu artarsa çanak yaprak genişliğinin doğrusal olarak azalacağı anlamına gelir.
İlk bakışta, yukarıdaki grafikte negatif bir korelasyon var gibi görünüyor: çanak yaprak uzunluğu arttıkça çanak yaprak genişliği hafifçe azalıyor.
Şimdi 'sepal length' ile 'sepal width' için, species (target) ile renklendirilmiş bir dağılım grafiği oluşturalım:
sns.lmplot(x='sepal length (cm)', y='sepal width (cm)', fit_reg=False, data=df_iris, hue='target');
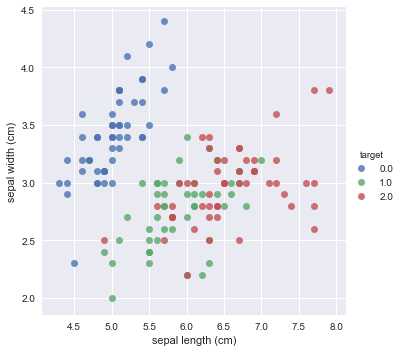
İlk bakışta, yukarıdaki grafikte pozitif bir korelasyon sergileniyor gibi: Her iris türü için, çanak yaprak uzunluğu arttığında çanak yaprak genişliği de artıyor.
Görselleştirmeler, korelasyon için sezgi kazanmanın harika bir yoludur, ancak bunu daha ayrıntılı düşünmenin bir yolu, gerçekten bir korelasyon katsayısı hesaplamaktır.
.corr() metodunun yardımıyla her ölçüm çiftinin korelasyon katsayılarını hesaplayabilirsiniz:
df_iris.corr()
| sepal length (cm) | sepal width (cm) | petal length (cm) | petal width (cm) | target | |
|---|---|---|---|---|---|
| sepal length (cm) | 1.000000 | -0.109369 | 0.871754 | 0.817954 | 0.782561 |
| sepal width (cm) | -0.109369 | 1.000000 | -0.420516 | -0.356544 | -0.419446 |
| petal length (cm) | 0.871754 | -0.420516 | 1.000000 | 0.962757 | 0.949043 |
| petal width (cm) | 0.817954 | -0.356544 | 0.962757 | 1.000000 | 0.956464 |
| target | 0.782561 | -0.419446 | 0.949043 | 0.956464 | 1.000000 |
Not: 'sepal length (cm)' ile 'sepal width (cm)' negatif korelasyonlu görünüyor! Ve ölçülen tüm çiçek popülasyonu üzerinde gerçekten öyleler. Korelasyon katsayısının -0.1 olduğunu görüyorsunuz. Ancak her tür içinde negatif korelasyonlu değiller; katsayı 0.78.
İlgilenenler için, bu durum Simpson paradoksu olarak bilinir ve nedensel çıkarımı düşünürken esastır. Daha fazlası için buraya bakabilirsiniz.
Bunu biraz daha inceleyelim. Her tür içinde her ölçüm çiftinin korelasyon katsayılarını hesaplayalım. Bunu yapmanın yolu, .groupby() ve .corr() metodlarını zincirleyerek hedefe göre gruplamak ve korelasyon katsayısını yazdırmaktır:
df_iris.groupby(['target']).corr()
| petal length (cm) | petal width (cm) | sepal length (cm) | sepal width (cm) | ||
|---|---|---|---|---|---|
| target | |||||
| 0.0 | petal length (cm) | 1.000000 | 0.306308 | 0.263874 | 0.176695 |
| petal width (cm) | 0.306308 | 1.000000 | 0.279092 | 0.279973 | |
| sepal length (cm) | 0.263874 | 0.279092 | 1.000000 | 0.746780 | |
| sepal width (cm) | 0.176695 | 0.279973 | 0.746780 | 1.000000 | |
| 1.0 | petal length (cm) | 1.000000 | 0.786668 | 0.754049 | 0.560522 |
| petal width (cm) | 0.786668 | 1.000000 | 0.546461 | 0.663999 | |
| sepal length (cm) | 0.754049 | 0.546461 | 1.000000 | 0.525911 | |
| sepal width (cm) | 0.560522 | 0.663999 | 0.525911 | 1.000000 | |
| 2.0 | petal length (cm) | 1.000000 | 0.322108 | 0.864225 | 0.401045 |
| petal width (cm) | 0.322108 | 1.000000 | 0.281108 | 0.537728 | |
| sepal length (cm) | 0.864225 | 0.281108 | 1.000000 | 0.457228 | |
| sepal width (cm) | 0.401045 | 0.537728 | 0.457228 | 1.000000 |
Bu korelasyon matrisinde şunları görebilirsiniz:
Bunların hepsi azalan miktarlarda pozitif korelasyonlardır, ancak orijinal negatif korelasyonunuzdan çok daha pozitifler.
Bu inanılmaz derecede öğretici ve verilerinizi kapsamlı bir şekilde analiz etmenin önemine açık bir hatırlatmadır.
Artık korelasyona daha yakından baktığınıza göre, zaman serinizin otokorelasyon fonksiyonuna bakarak periyodikliğinizi analiz etmeye hazırsınız!
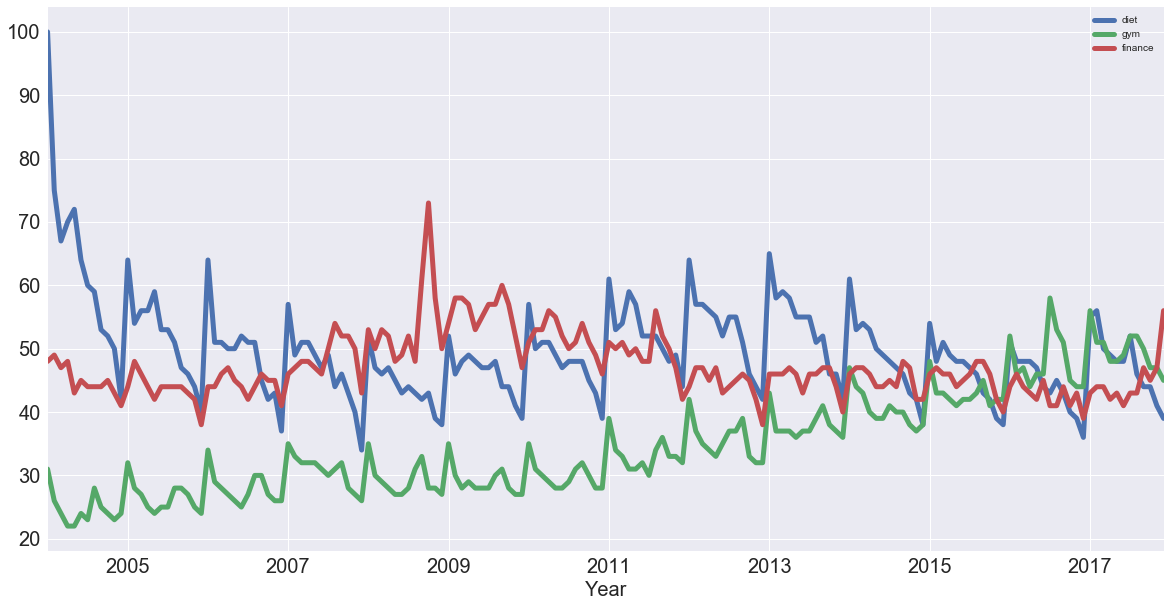
Başlangıç olarak, nasıl göründüklerini hatırlamak için zaman serilerinizin tümünü tekrar çizin:
df.plot(figsize=(20,10), linewidth=5, fontsize=20)
plt.xlabel('Year', fontsize=20);
Ardından, .corr() yardımıyla bu zaman serilerinin tümünün korelasyon katsayılarını hesaplayın:
df.corr()
| diet | gym | finance | |
|---|---|---|---|
| diet | 1.000000 | -0.100764 | -0.034639 |
| gym | -0.100764 | 1.000000 | -0.284279 |
| finance | -0.034639 | -0.284279 | 1.000000 |
Peki, yukarıdakiler size ne söylüyor?
'diet' ve 'gym' üzerine odaklanalım; Negatif korelasyonlular. Bu oldukça ilginç! Mevsimsel ve trend bileşeniniz olduğunu unutmayın. Korelasyon katsayısına göre 'diet' ve 'gym' negatif korelasyonlu. Ancak zaman serilerine baktığınızda, mevsimsel bileşenlerinin pozitif, trendlerinin ise negatif korelasyonlu göründüğünü fark ediyorsunuz.
Aslında korelasyon katsayısı her ikisini de yakalıyor.
Şimdi yapmak istediğiniz, bu zaman serilerinin birinci dereceden farklarını çizmek ve ardından bunların korelasyonunu hesaplamak; çünkü bu, yaklaşık olarak mevsimsel bileşenlerin korelasyonu olacaktır. Unutmayın, trendi kaldırmak, mevsimsellikteki korelasyonu ortaya çıkarabilir.
.diff() ve .plot() yardımıyla birinci dereceden farkları çizerek başlayın:
df.diff().plot(figsize=(20,10), linewidth=5, fontsize=20)
plt.xlabel('Year', fontsize=20);
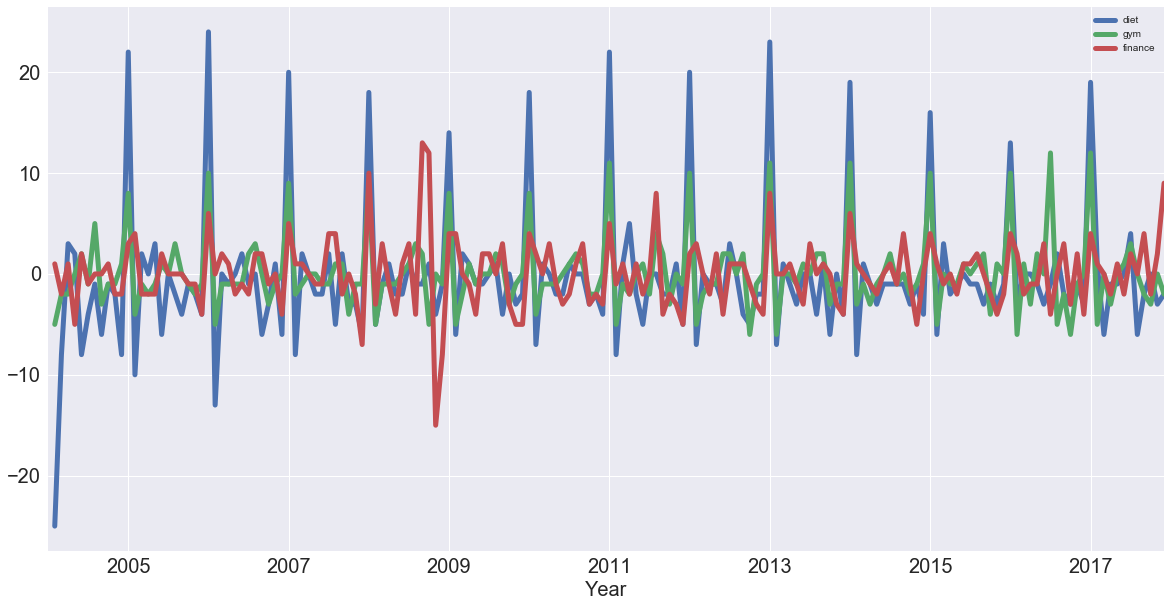
Trendi kaldırdığınızda 'diet' ve 'gym'’in inanılmaz derecede korelasyonlu olduğunu görüyorsunuz. Şimdi, bu zaman serilerinin birinci dereceden farklarının korelasyon katsayılarını hesaplayacaksınız:
df.diff().corr()
| diet | gym | finance | |
|---|---|---|---|
| diet | 1.000000 | 0.758707 | 0.373828 |
| gym | 0.758707 | 1.000000 | 0.301111 |
| finance | 0.373828 | 0.301111 | 1.000000 |
Not: Trend ve mevsimsel bileşeni birlikte düşündüğünüzde hafif bir negatif korelasyon vardı. Şimdi mevsimsel bileşenle birlikte, 'diet' ve 'gym'’in 0.76 katsayıyla yüksek korelasyona sahip olduğunu görebilirsiniz.
Artık değişkenlerin korelasyonuna ve zaman serilerinin korelasyonuna göz attığınıza göre, 'diet' serisinin otokorelasyonunu çizme zamanı: x ekseninde gecikme (lag), y ekseninde ise zaman serisinin o gecikmede kendisiyle ne kadar korelasyonlu olduğu var.
Yani, orijinal zaman serisi her iki günde bir kendini tekrar ediyorsa, otokorelasyon fonksiyonunda 2 günde bir tepe beklenir.
Burada, grafiğe bakacak ve 12 ayda bir otokorelasyon fonksiyonunda bir zirve görmeyi bekleyeceksiniz: zaman serisi, on iki ay kaydırılmış hâliyle korelasyonludur.
pandas’ın plotting arayüzünde bulunan autocorrelation_plot() fonksiyonunu kullanın. Bu fonksiyonla 'diet' zaman serisini çizebilirsiniz:
pd.plotting.autocorrelation_plot(diet);
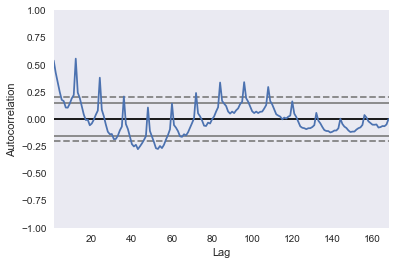
Eksenlerinize daha fazla gecikme ekleseydiniz, en büyük korelasyon tepesinin 12 ayda olduğunu görürdünüz. 24 aylık aralıkta bir başka tepe daha var, burada da kendiyle korelasyonlu. 36’da bir başka tepe daha var, ancak uzaklaştıkça korelasyon giderek azalıyor.
Elbette, 0 gecikmede serinin kendisiyle kendisi arasındaki korelasyon 1’dir.
Yukarıdaki grafikteki kesikli çizgiler, korelasyonun istatistiksel anlamlılığı hakkında bilgi verir. Bu durumda, 'diet' serisinin on iki aylık gecikmeyle gerçekten otokorelasyonlu olduğunu söyleyebilirsiniz.
Bu 12 aylık tekrarın mevsimselliğini belirlediniz!
Bu eğitimde oldukça geniş bir alanı kapsadınız! 'diet', 'gym' ve kısaca 'finance' anahtar kelimelerinin Google Trends verilerine bakarak zaman içinde nasıl değiştiklerini incelediniz. Mevsimsellik, trendler, korelasyon, otokorelasyon gibi kavramları ele aldınız...
Meraklı veri bilimciler için hemen yapabileceğiniz iki şey var:
Python hakkında daha fazla bilgi edinin
Kurs
Kurs
Alıştırma and program your progress.
Google Ile Devam Edinblog
Dario Radečić
15 dk.
blog
Abid Ali Awan
14 dk.
Eğitim
Adel Nehme
Eğitim
Kurtis Pykes
8 dk.




