
Khóa học
Bảo mật và Quản lý Rủi ro AI
2 giờ
11.8K
Luyện tập và Lộ trình tiến trình của bạn.
Tiếp Tục Với GoogleAI và ML thường được dùng thay thế cho nhau. Nhưng nếu phải định nghĩa nhanh và chỉ ra khác biệt, tôi sẽ nói: AI đề cập đến công nghệ xây dựng máy móc mô phỏng các chức năng nhận thức gắn với trí tuệ con người, còn ML là một tập con các thuật toán AI có khả năng học hỏi và cải thiện từ dữ liệu.
Trong bài viết này, tôi muốn cùng bạn khám phá khả năng ứng dụng của các kỹ thuật học máy trong an ninh mạng, giới thiệu nhiều trường hợp sử dụng cũng như những thách thức về khả năng giải thích, khả năng diễn giải và tính vững chắc cần được giải quyết để khai thác hết tiềm năng của chúng.
Phát hiện và ứng phó mối đe dọa đề cập đến việc phát hiện các mối đe dọa mạng đối với mạng lưới hoặc hệ thống, sau đó nhanh chóng triển khai các chiến lược giảm thiểu hiệu quả. Quy trình này bao gồm phát hiện hành vi bất thường trong mạng và hệ thống, xác định xâm nhập trái phép, và phân tích mẫu mã độc để bảo vệ hệ thống của chúng ta.
Phát hiện bất thường là việc nhận diện các mẫu trong dữ liệu không phù hợp với khái niệm hành vi bình thường được xác định rõ.
Khái niệm nền tảng này có tính ứng dụng rộng rãi trong nhiều lĩnh vực, và an ninh mạng cũng không ngoại lệ. Tôi sử dụng phát hiện bất thường để nhận diện nhiều hoạt động độc hại như phát hiện rò rỉ dữ liệu, tấn công Từ chối dịch vụ phân tán (DDoS), lây nhiễm mã độc, và các dạng khác.Nhiều thuật toán học máy như Local Outlier Factor (LOF), Isolation Forest, One-Class Support Vector Machine (OC-SVM) đã được sử dụng để phát hiện bất thường. Tuy nhiên, chọn kỹ thuật phù hợp để nhận diện ngoại lệ là một nhiệm vụ phức tạp, đòi hỏi cân nhắc kỹ nhiều yếu tố, bao gồm:
Chúng ta sẽ khám phá cách lựa chọn kỹ thuật học máy phù hợp và giải thích cách chúng phát hiện hoạt động độc hại trong an ninh mạng. Trọng tâm sẽ là hai ứng dụng then chốt: phát hiện xâm nhập và phân tích mã độc.
Hệ thống phát hiện xâm nhập (IDS) là “mắt tai” của mạng và hệ thống máy tính, giám sát và phân tích lưu lượng mạng (IDS dựa trên mạng) và các lệnh gọi hệ thống (IDS dựa trên máy chủ) để phát hiện hoạt động độc hại.
Qua các thử nghiệm, tôi đã chứng kiến sức mạnh của các phương pháp phát hiện bất thường đối với cả hai hệ thống trong việc phát hiện sự xuất hiện của các mối đe dọa mới hoặc chưa từng biết đến vốn có thể qua mặt các kỹ thuật dựa trên chữ ký, những kỹ thuật phụ thuộc vào các mẫu tấn công được định nghĩa sẵn để phát hiện.
Trước khi đi vào IDS dựa trên máy chủ, cần hiểu lệnh gọi hệ thống là gì. Chúng về bản chất là các yêu cầu do chương trình gửi tới hệ điều hành để thực hiện các tác vụ cụ thể. Giả sử bạn dùng trình soạn thảo văn bản để chỉnh sửa một tệp trên hệ điều hành Linux. Ở hậu trường, trình soạn thảo sẽ yêu cầu mở tệp bằng lệnh gọi hệ thống open(), ghi thay đổi bằng write(), rồi lưu bằng cách đóng tệp qua close().
Trong khi các lệnh gọi hệ thống của trình soạn thảo văn bản khá đơn giản và dễ dự đoán, chuỗi lệnh gọi của tác nhân độc hại thường đánh lừa. Một chương trình độc hại có thể dùng chuỗi như open(), write() để thả một tệp ẩn, rồi dùng execve() để thực thi với đặc quyền cao. Sau đó là các lệnh liên quan mạng như socket() để có thể thiết lập kênh chỉ huy–điều khiển.
Để xử lý vấn đề này, các chuỗi lệnh gọi hệ thống thường được biến đổi thành biểu diễn đặc trưng tĩnh phù hợp với các thuật toán học máy. Nhưng bạn có thể thắc mắc: kỹ thuật học nào phù hợp nhất để huấn luyện mô hình học máy trong trường hợp này?
Việc lựa chọn kỹ thuật học phụ thuộc nhiều vào tính sẵn có của nhãn. Nếu có một tập dữ liệu cân bằng gồm cả chuỗi lệnh gọi bình thường và bất thường, tôi chắc chắn sẽ chọn các mô hình phát hiện bất thường có giám sát như Support Vector Machines (SVM).
Ngược lại, khi thiếu dữ liệu gán nhãn, tôi có thể dùng các mô hình học không giám sát như Isolation Forest. Với các kịch bản mà dữ liệu huấn luyện chỉ đại diện cho hành vi bình thường, tôi tìm đến các kỹ thuật bán giám sát như One-Class SVM hoặc DBSCAN.
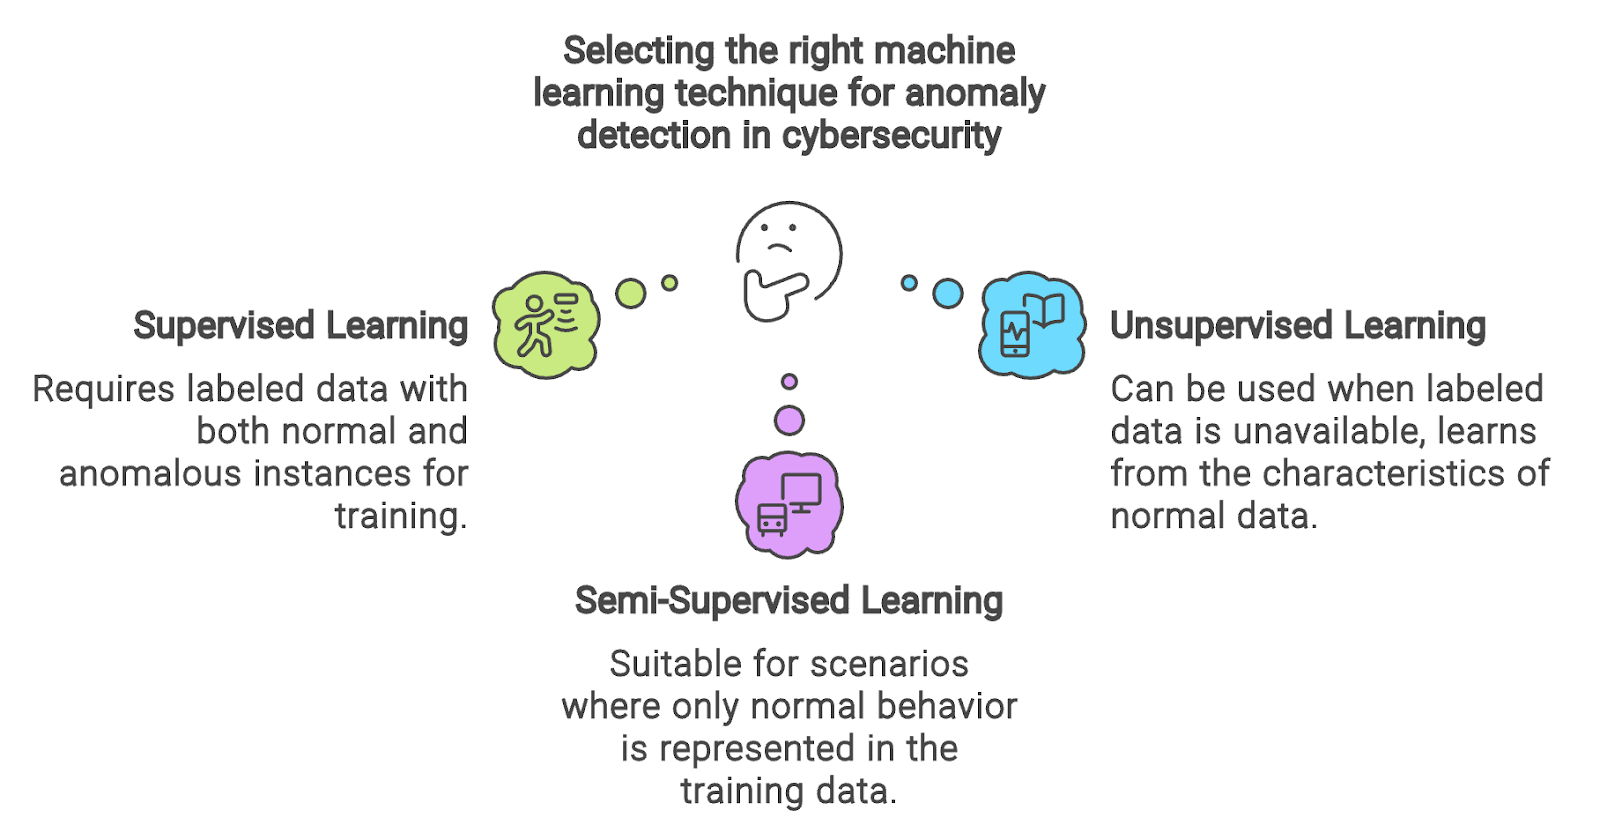
Sơ đồ được tạo bằng Napkin.ai
Giờ khi đã hiểu ML được áp dụng vào IDS dựa trên máy chủ như thế nào, hãy chuyển sang lĩnh vực IDS dựa trên mạng. Trong khi hệ thống dựa trên máy chủ tập trung vào từng máy riêng lẻ, IDS dựa trên mạng phát hiện xâm nhập trong dữ liệu mạng; tức là, thay vì phân tích lệnh gọi hệ thống, IDS mạng kiểm tra hoạt động đánh cắp thông tin và gây gián đoạn mạng bằng cách giám sát thống kê luồng mạng, dữ liệu tải, và tiêu đề gói tin.
Cái nhìn nhanh vào bảng sau sẽ giúp bạn hình dung một tập dữ liệu luồng mạng trông như thế nào.
|
Cổng đích |
Cổng nguồn |
Thời lượng luồng (ms) |
Tổng gói gửi đi |
Tổng gói nhận về |
Nhãn |
|
54865 |
9910 |
6 |
5000 |
600 |
0 |
|
54810 |
9010 |
2 |
2000 |
200 |
1 |
Thống kê luồng mạng tổng hợp cho trường hợp bình thường và bất thường.
Mỗi hàng trong tập dữ liệu đại diện cho một phiên liên lạc mạng độc lập giữa hai đầu mút, không có mối quan hệ vốn có với các luồng khác trong tập dữ liệu.
Mỗi luồng được xác định bởi các thuộc tính như số cổng nguồn và cổng đích, thời lượng luồng tính bằng mili giây, và tổng số gói trao đổi theo cả hai chiều. Một nhãn phân loại cho biết luồng mạng được xếp loại là bất thường hay tấn công, cung cấp dữ liệu chân lý cần thiết cho các mô hình phát hiện xâm nhập.
Đáng chú ý, mỗi hàng biểu diễn một luồng mạng độc lập mà không có phụ thuộc tuần tự hay quan hệ với các luồng khác trong tập dữ liệu.
Do tính độc lập của các luồng mạng, sau một số kỹ thuật trích xuất đặc trưng, tập dữ liệu có thể được đưa vào các thuật toán học máy để phát hiện bất thường. Như đã bàn ở bối cảnh IDS dựa trên máy chủ, việc lựa chọn kỹ thuật học máy phù hợp phụ thuộc vào tính sẵn có của dữ liệu gán nhãn.
Trước khi đi vào phân tích mã độc, ta cần giải thích mã độc là gì và cách nó hoạt động.
Malware (mã độc) là thuật ngữ chỉ phần mềm độc hại hoặc các tệp thực thi nhị phân được thiết kế để thực hiện ý đồ gây hại của kẻ tấn công. Đoạn mã này cố ý khai thác lỗ hổng trong hệ thống mục tiêu để làm suy giảm tính toàn vẹn, đánh cắp dữ liệu nhạy cảm, xóa dữ liệu, thậm chí mã hóa dữ liệu để đòi tiền chuộc. Nó có thể thuộc nhiều loại như virus, sâu máy tính, spyware, trojan, ransomware, v.v.
Để hiểu loại mã độc, chức năng và tác động tiềm ẩn của nó, nhiều đặc trưng được trích xuất từ phân tích tĩnh và động rồi đưa vào các thuật toán học máy phù hợp.
Xét phân tích mã độc cho tệp thực thi Windows, tức Portable Executables (PE). Ta có thể trích xuất đa dạng đặc trưng từ cả phân tích động và tĩnh của PE như chuỗi byte, API/lệnh gọi hệ thống, opcode, mạng, hệ thống tệp, thanh ghi CPU, đặc tính tệp PE và chuỗi ký tự, rồi đưa chúng vào các mô hình học máy có giám sát, không giám sát và bán giám sát phù hợp để phát hiện mã độc.
Để giảm thiểu rủi ro bị phơi bày trước các cuộc tấn công mạng, chúng ta phải nhanh chóng xác định, đánh giá và xử lý các điểm yếu bảo mật tiềm ẩn trong mạng, máy tính và ứng dụng. Hãy xem vai trò của các thuật toán AI và ML trong việc cải thiện quản lý lỗ hổng thông qua quét lỗ hổng, quản lý bản vá và đánh giá rủi ro.
Với tư cách là nhà nghiên cứu an ninh mạng, tôi thường phát triển công cụ tùy chỉnh để tự động hóa các tác vụ an ninh như bộ phân tích log lưu lượng mạng, fuzzer, và các công cụ khác.
Dù những công cụ này có thể nâng cao đáng kể hoạt động bảo mật, điều quan trọng là phải quét lỗ hổng nghiêm ngặt trước khi sử dụng và chia sẻ với đồng nghiệp.
Nếu không, kẻ tấn công có thể khai thác các lỗ hổng chưa được phát hiện và vá trong script tùy chỉnh của tôi để truy cập trái phép, làm lộ thông tin nhạy cảm, hoặc làm gián đoạn dịch vụ trong công ty.
Các mô hình học máy có khả năng “nhìn rừng thay vì chỉ cây”. Chúng xuất sắc trong việc trích xuất đặc trưng có ý nghĩa từ tập dữ liệu lớn bằng cách khám phá các mẫu và tương quan tinh vi. Với điều này trong đầu, tôi đã bắt đầu khám phá xem liệu chúng có thể tự động hóa phát hiện lỗ hổng, phân tích nhanh hơn và nhận diện các lỗ hổng chưa được công bố trước đó hay không.
Để xây dựng mô hình phát hiện lỗ hổng dựa trên ML, tôi bắt đầu bằng cách thu thập nhiều loại dữ liệu có và không có lỗ hổng để huấn luyện mô hình từ nhiều nguồn, bao gồm NVD (National Vulnerability Database), OWASP, v.v.
Bộ sưu tập này sau đó được tiền xử lý và nhúng để đưa vào mô hình đã chọn. Đầu vào có thể được biểu diễn dưới dạng Đồ thị hoặc Cây thể hiện mối quan hệ giữa các phần tử mã, chẳng hạn như Code Property Graph (CPG) hoặc Abstract Syntax Trees (AST).
Đầu vào cũng có thể ở dạng biểu diễn dựa trên token, trong đó mã nguồn được chuyển thành các vector token. Nhiều kỹ thuật nhúng có thể được áp dụng sau đó, gồm Word2Vec, nhúng đồ thị, one-hot embedding, đặc trưng n-gram, v.v.
Như đã giải thích ở các ứng dụng trước, việc chọn mô hình học máy và kỹ thuật học chủ yếu phụ thuộc vào tính sẵn có của nhãn. Ở giai đoạn huấn luyện, tập dữ liệu phát hiện lỗ hổng được tách thành tập huấn luyện và kiểm định, và mô hình học từ dữ liệu đã gán nhãn.
Các tham số của mô hình được cập nhật lặp lại dựa trên lỗi dự đoán bằng các kỹ thuật tối ưu hóa. Sau khi mô hình hoàn tất quá trình học, khả năng phát hiện lỗ hổng của mô hình được đo lường bằng dữ liệu chưa từng thấy. Các chỉ số hiệu năng chủ chốt như accuracy, precision, recall và F1 score được tính toán để đánh giá khả năng phát hiện lỗ hổng của mô hình.
Khi phát hiện lỗ hổng trong script tùy chỉnh của tôi, đánh giá rủi ro toàn diện là điều thiết yếu. Nếu các biện pháp kiểm soát bảo mật hiện có ngăn được việc khai thác lỗ hổng đã phát hiện hoặc hậu quả tiềm ẩn là tối thiểu, có thể chấp nhận rủi ro.
Ngoài ra, cũng có thể cân nhắc không sử dụng hoàn toàn đoạn mã đã phát triển để loại bỏ mọi rủi ro bị khai thác. Tuy nhiên, nếu loại bỏ hoàn toàn là không khả thi, việc triển khai các chiến lược giảm thiểu là rất quan trọng.
Tiếp theo, chúng ta sẽ tìm hiểu việc vá phần mềm có lỗ hổng như một biện pháp giảm thiểu chủ đạo.
Mặc dù lý tưởng là xử lý mọi lỗ hổng mở và nghiêm trọng, điều đó thường không khả thi. Cần một cách tiếp cận chiến lược hơn. Bằng cách sử dụng học máy, chúng ta có thể chủ động dự đoán những lỗ hổng nào có khả năng cao bị khai thác gây ra sự cố bảo mật. Điều này giúp ưu tiên nỗ lực vá lỗi.
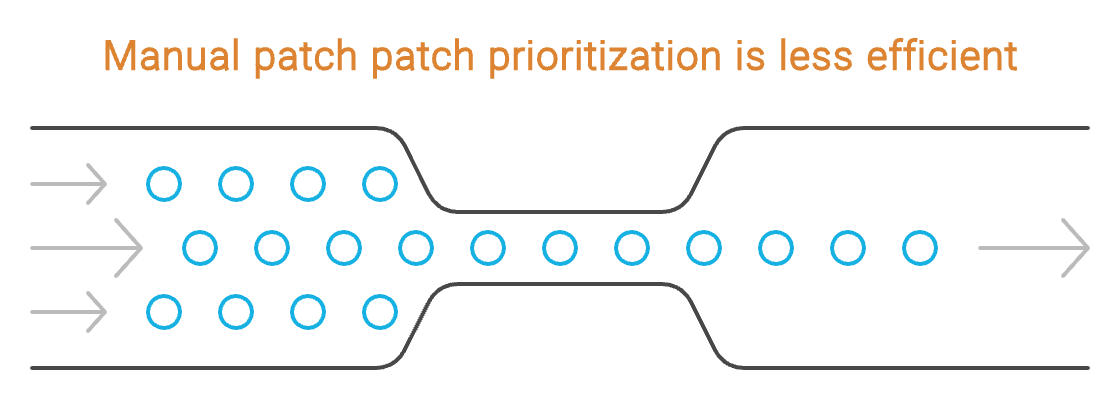
Tạo bằng Napkin.ai
Để hợp lý hóa quy trình ưu tiên vá lỗi, chúng tôi sử dụng mô hình dựa trên cây đã được huấn luyện sẵn của Exploit Prediction Scoring System (EPSS), kết hợp thông tin lỗ hổng với hoạt động khai thác ngoài thực tế để dự đoán khả năng kẻ tấn công sẽ cố gắng sử dụng một lỗ hổng cụ thể trong ba mươi ngày tới.
Mô hình học máy EPSS xác định các mẫu và mối quan hệ giữa thông tin lỗ hổng, như CVSS, và hoạt động khai thác để xác định bằng toán học xác suất kẻ tấn công sẽ sử dụng một lỗ hổng.
Sau khi ưu tiên lỗ hổng, các bản vá sẽ trải qua quy trình thu thập, xác thực và kiểm thử nghiêm ngặt để giảm rủi ro vận hành. Triển khai bản vá là một quy trình phức tạp phụ thuộc vào nhiều yếu tố, bao gồm:
Với quy mô và tính đa dạng của môi trường CNTT hiện đại, triển khai bản vá thủ công thường tốn nhiều công sức và thời gian. Tự động hóa dựa trên AI có thể tối ưu quy trình này bằng cách thông minh lựa chọn và triển khai bản vá phù hợp cho từng hệ thống dựa trên các yếu tố quan trọng nêu trên.
Các thuật toán phân cụm, chẳng hạn như K-means, có thể được tận dụng trong trường hợp này để gom nhóm các hệ thống tương đồng nhằm triển khai bản vá hiệu quả hơn.
Đánh giá rủi ro an ninh mạng rất quan trọng để xác định, đánh giá và giảm thiểu các mối đe dọa tiềm ẩn cùng các lỗ hổng đã phát hiện.
Do các cách tiếp cận truyền thống thường không tìm ra được chỉ dấu của những rủi ro mạng khó lường, các nhà nghiên cứu đã bắt đầu chuyển sang học máy.
Bằng cách sử dụng học có giám sát và phân loại đa lớp, các nhà nghiên cứu có thể cải thiện đánh giá rủi ro mạng thông qua phân tích toàn diện các yếu tố then chốt.
Như được nêu trong bảng dưới đây, các yếu tố này bao gồm đầu tư cho an ninh mạng, đặc điểm lực lượng lao động, lịch sử tấn công, lỗ hổng hạ tầng, tư vấn bên ngoài và mức rủi ro liên quan. Mô hình minh chứng SecRiskAI dựa trên ML cho thấy tiềm năng của ML trong việc dự đoán khả năng xảy ra tấn công DDoS hoặc lừa đảo (phishing).
|
Thông tin |
Ví dụ |
|
Doanh thu |
2,500,000 |
|
Đầu tư An ninh mạng |
500,000 |
|
Tấn công thành công |
5 |
|
Tấn công thất bại |
10 |
|
Số lượng nhân viên |
4,450 |
|
Đào tạo nhân viên |
Trung bình |
|
Lỗ hổng đã biết |
9 |
|
Cố vấn an ninh mạng bên ngoài |
Không |
|
Rủi ro |
Thấp |
Ví dụ về các thuộc tính then chốt cho đánh giá rủi ro an ninh mạng (Nguồn)
Giờ hãy khám phá cách AI và ML đang thay đổi ứng phó sự cố. Chúng ta sẽ xem cách chúng tự động hóa quy trình ứng phó sự cố, rút ngắn thời gian phản ứng, chủ động phát hiện mối đe dọa ẩn, và cải thiện phân tích pháp y để truy vết nguồn gốc và tác động của các cuộc tấn công mạng.
Tôi đã trực tiếp quan sát cách các hệ thống SOAR được thiết kế để tiếp nhận cảnh báo từ các hệ thống Quản lý Thông tin và Sự kiện Bảo mật (SIEM) và kích hoạt các playbook phù hợp nhằm tự động hóa và điều phối một chuỗi tác vụ bảo mật.
Các tác vụ này có thể bao gồm hành động điều tra, như kiểm tra uy tín URL hoặc truy xuất chi tiết người dùng và tài sản, cũng như hành động ứng phó, chẳng hạn như chặn địa chỉ IP trên tường lửa hoặc dừng một tiến trình độc hại trên thiết bị đầu cuối.
Tuy nhiên, hiện nay chúng ta đang đối mặt với những hạn chế đáng kể trong các hệ thống này. Các nhà phân tích bảo mật phải tự tay định nghĩa, tạo và thay đổi playbook, và việc lựa chọn giữa nhiều playbook được chi phối bởi các quy tắc do họ đặt ra.
Để vượt qua những hạn chế này, tôi đã thấy việc tích hợp AI và ML vào các nền tảng SOC có thể cách mạng hóa quy trình, cho phép tự động tạo playbook có khả năng
ứng phó với các cảnh báo chưa từng gặp.
Điều này không chỉ nâng cao hiệu quả phản ứng mà còn giúp các nhà phân tích tập trung vào nhiều tác vụ khác. Sử dụng các thuật toán ML, chúng ta cũng có thể huấn luyện để tính toán chi phí phạt của từng hành động ứng phó tùy theo cảnh báo nhận được và chọn phương án có chi phí thấp nhất.
Hãy tưởng tượng mức độ căng thẳng khi phải sàng lọc hàng triệu bản ghi nhật ký để cố gắng xác định các mối đe dọa tiềm ẩn.
Giờ hãy nhân thách thức đó lên ở quy mô doanh nghiệp, nơi từng bản ghi phải được kiểm tra từng cái một và phân loại là độc hại hay vô hại.
Bằng cách đưa học máy vào quy trình, chúng ta có thể đơn giản hóa nhiệm vụ này và tăng tốc phát hiện mối đe dọa. Các thuật toán AI và ML, như SVM, Random Forest, có thể được huấn luyện để phân tích và phân loại nhật ký hiệu quả, cho phép xác định mối đe dọa nhanh chóng và giảm gánh nặng cho đội ngũ bảo mật.
Khi dữ liệu số tiếp tục tăng về khối lượng và độ phức tạp, việc tích hợp AI và ML vào pháp y số — phân tích bằng chứng số để điều tra tội phạm mạng — đã trở nên thiết yếu.
Sự tích hợp này cho phép chúng ta nâng cao tốc độ, độ chính xác và hiệu quả trong việc xác định và ứng phó với các mối đe dọa mạng.
AI và ML có thể được sử dụng trong phân loại sơ bộ (triage) pháp y, chẳng hạn. Trong trường hợp này, chúng ta dùng các thuật toán ML để phân loại và nhóm một lượng lớn tệp số dựa trên mức độ liên quan đến cuộc điều tra.
Việc tích hợp AI trong an ninh mạng mang đến những cơ hội đáng kể. Tuy nhiên, cũng cần thừa nhận các thách thức và hạn chế vốn có của nó.
Nhiều hệ thống AI dễ bị tấn công đối kháng, ví dụ như nhiễm độc dữ liệu, né tránh, trích xuất mô hình, prompt injection và suy luận, lợi dụng các lỗ hổng của chúng.
Trong các cuộc tấn công này, kẻ tấn công cẩn thận thêm nhiễu vào đầu vào — nhiễu đó con người khó nhận thấy — nhưng có thể khiến mô hình đưa ra dự đoán sai. Điều này làm dấy lên lo ngại về an toàn khi triển khai các hệ thống này trong môi trường đòi hỏi an toàn cao, và an ninh mạng cũng không ngoại lệ.
Để đối phó hiệu quả các cuộc tấn công này, chúng tôi áp dụng nhiều cơ chế phòng thủ như huấn luyện đối kháng, chưng cất phòng thủ và che giấu gradient.
Mặc dù các thuật toán AI cho thấy hiệu quả trong việc đạt được kết quả và dự đoán, tôi gặp khó khăn khi hiểu cơ chế hoạt động nội tại của chúng.
Điều này rất quan trọng trong lĩnh vực của tôi, bởi giao phó các lựa chọn mang tính sống còn cho một hệ thống không thể giải thích được tiềm ẩn rủi ro rõ ràng.
Ở đây, Trí tuệ nhân tạo có khả năng giải thích (XAI) mở ra con đường phát triển các hệ thống an ninh mạng do AI dẫn dắt với mức độ giải thích cao hơn mà vẫn duy trì hiệu năng. Bằng cách mang lại sự minh bạch trong quyết định của AI, XAI giúp tôi phân tích có cơ sở và đưa ra hành động phù hợp nhất khi ứng phó sự cố bảo mật.
Những tiến bộ gần đây trong các kỹ thuật XAI, như phân tích tầm quan trọng của đặc trưng và trực quan hóa cây quyết định, đang khiến mức độ minh bạch này trở nên khả thi.
Mỗi khi tôi chọn một bộ dữ liệu để huấn luyện các giải pháp an ninh mạng dựa trên AI, tôi đảm bảo rằng nó không bị thiên lệch. Nếu không, các mô hình tôi phát triển có thể đưa ra kết quả thiếu công bằng hoặc mang tính phân biệt. Tôi áp dụng các kỹ thuật tiền xử lý dữ liệu để nhận diện và loại bỏ thiên lệch có trong dữ liệu huấn luyện, đồng thời triển khai các kỹ thuật đánh giá công bằng để kiểm tra đầu ra của mô hình nhằm phát hiện khả năng thiên lệch.
Nếu bạn đọc đến đây, bạn đã thấy AI và ML đang thay đổi cách chúng ta bảo vệ máy tính, thiết bị di động, mạng và ứng dụng như thế nào. Bạn đã chứng kiến cách chúng tiếp sức cho các đội ngũ bảo mật, phát hiện mối đe dọa nhanh hơn và củng cố nhiều công cụ an ninh mạng.
Và điều thú vị là: tôi nghĩ chúng ta mới chỉ bắt đầu.
Tương lai của an ninh mạng nằm ở sự phát triển liên tục của AI và ML, đặc biệt là các mô hình ngôn ngữ lớn (LLM). Nhờ giới hạn token mở rộng, khả năng diễn giải mã và phân tích chi tiết, các mô hình tiên tiến này sẽ nâng cao năng lực phân tích và ứng phó mối đe dọa của chúng ta bằng cách mở rộng phân tích phần mềm độc hại với tốc độ và độ chính xác cao hơn.
Hãy xét trường hợp mô hình Gemini 1.5 hiện đang được sử dụng để phát hiện phần mềm độc hại trong các tệp khổng lồ. Dù không được huấn luyện chuyên biệt về an ninh mạng, chúng vẫn có thể giải quyết các tác vụ liên quan thông qua kỹ thuật nhắc lệnh (prompt engineering), học trong ngữ cảnh và chuỗi suy luận.
Chúng ta cũng đang thấy những lát cắt của tương lai đó qua việc tinh chỉnh các LLM có trọng số mở, bao gồm Llama, cho các tác vụ liên quan đến an ninh mạng như Hackmentor.
Trong bài blog này, chúng ta đã xem xét cách các công cụ an ninh mạng dựa trên AI và ML hữu ích trong việc đối phó với bản chất năng động và phức tạp của các mối đe dọa mạng hiện đại. Những công cụ này hiệu quả trong việc phát hiện, ứng phó và giảm thiểu rủi ro thông qua các ứng dụng trọng điểm ở phát hiện mối đe dọa, quản lý lỗ hổng và ứng phó sự cố.
Tuy nhiên, chúng ta cũng phải cân nhắc những thách thức lớn và tác động đạo đức liên quan đến việc phát triển và triển khai các giải pháp an ninh mạng dựa trên AI.
Bất chấp những thách thức này, sự tiến bộ không ngừng của công nghệ AI và ML mang lại nhiều hứa hẹn trong việc củng cố phòng tuyến trước các mối đe dọa mạng đang biến đổi.
Tìm hiểu thêm về bảo mật dữ liệu!
Khóa học
Khóa học
Luyện tập và Lộ trình tiến trình của bạn.
Tiếp Tục Với Googleblog
Matt Crabtree
10 phút
