Khóa học
Thiết kế Hệ thống Agentic với LangChain
3 giờ
14.8K
Bạn có thể truy cập toàn bộ mã cho bản demo này tại đây.
Nemotron 3 Super là mô hình suy luận mở của NVIDIA dành cho các quy trình agentic và ngữ cảnh dài. Nó sử dụng kiến trúc Mamba lai với Transformer và Latent MoE với 120B tham số tổng và 12B tham số hoạt động, bao gồm dự đoán đa token (MTP), và được thiết kế cho các tác vụ nặng về suy luận như viết mã, sử dụng công cụ và phân tích ngữ cảnh dài.
NVIDIA định vị nó đặc biệt cho các ứng dụng đa tác tử phức tạp và suy luận toàn bộ codebase.
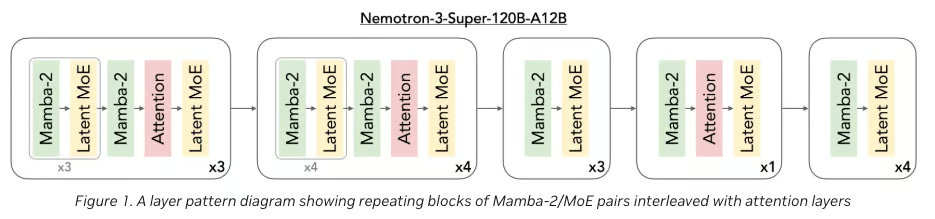
Hình 1: Kiến trúc Nemotron 3 Super (NVIDIA Blog)
Một vài ý tưởng cốt lõi đằng sau Nemotron 3 Super gồm:
Trong hướng dẫn này, chúng ta sẽ dùng endpoint miễn phí được lưu trữ của OpenRouter, vì cả biến thể đầy đủ lẫn biến thể lượng tử hóa của mô hình thường cần tối thiểu GPU H100 để suy luận thực tiễn. Endpoint lưu trữ hiện hỗ trợ cửa sổ ngữ cảnh 262K token (không phải toàn bộ 1M), vẫn đủ để phân tích các repo cỡ vừa trong bản demo này.
Dòng Nemotron 3 của NVIDIA được giới thiệu như một họ mô hình mở cho các hệ thống AI agentic, với các kích cỡ khác nhau nhắm tới nhu cầu triển khai và suy luận khác nhau, gồm các bậc Nano, Super và Ultra.
Ở mức thực tiễn, bạn có thể hình dung họ này như sau:
Vì vậy, Nemotron 3 Super là lựa chọn phù hợp ở đây vì chúng ta muốn một mô hình có thể suy luận trên toàn bộ repo cùng lúc, không chỉ giải quyết các tiểu tác vụ lập trình rời rạc.
Trong phần này, chúng ta sẽ xây dựng một trình phân tích repo dùng Nemotron 3 Super bọc trong giao diện Gradio. Ở mức cao, ứng dụng cuối sẽ làm những việc sau:
Hãy xây dựng từng bước.
Trước khi xây dựng trình phân tích repo, chúng ta cần một môi trường tối thiểu xử lý ba trách nhiệm cốt lõi gồm hiển thị UI, xử lý kho và tương tác mô hình. Vì không chạy Nemotron cục bộ, thiết lập sẽ gọn nhẹ và tập trung.
Cài đặt tất cả bằng cách chạy:
!pip -q install gradio openai tiktoken gitpython orjson pandasTrong dự án này, chúng ta dùng:
openai để tương tác với API của OpenRouter (endpoint Nemotron)gradio để xây dựng UI tương táctiktoken để ước tính lượng token trước khi gửi promptorjson để phân tích JSON nhanh từ đầu ra mô hìnhpandas để hiển thị kết quả có cấu trúc dưới dạng bảnggitpython để nhân bản và làm việc với các khoKhông giống các thiết lập LLM cục bộ (cần CUDA, vLLM hoặc lượng tử hóa), cách tiếp cận này loại bỏ hoàn toàn phụ thuộc GPU và thân thiện với Colab.
Ở bước này, ta thiết lập Nemotron 3 Super qua OpenRouter và định nghĩa một vài hằng số cốt lõi điều khiển cách xử lý kho. Vì không chạy mô hình cục bộ, client này trở thành giao diện trung tâm để gửi các prompt đóng gói lớn và nhận về đầu ra phân tích có cấu trúc.
OPENROUTER_API_KEY = os.environ.get("OPENROUTER_API_KEY", "")
MODEL = "nvidia/nemotron-3-super-120b-a12b:free"
WORKDIR = "/content/repo_ui"
if not OPENROUTER_API_KEY:
    raise ValueError("Set OPENROUTER_API_KEY in environment before running.")
client = OpenAI(
    base_url="https://openrouter.ai/api/v1",
    api_key=OPENROUTER_API_KEY,
)
enc = tiktoken.get_encoding("cl100k_base")
Tại đây, ứng dụng giao tiếp với Nemotron 3 Super qua OpenRouter bằng client Python openai được cấu hình với base_url tùy chỉnh và API key lưu trong OPENROUTER_API_KEY.
Mô hình được chọn trỏ tới endpoint lưu trữ của OpenRouter, cho phép chạy một mô hình rất lớn mà không cần hạ tầng GPU cục bộ.
Để quản lý kích thước ngữ cảnh, ta khởi tạo tokenizer (tiktoken với cl100k_base) để ước tính số token mà repo đóng gói sẽ tiêu thụ trước khi gửi tới mô hình. Bởi mô hình có cửa sổ ngữ cảnh hữu hạn.
Một vài lưu ý thực tế:
Giờ chúng ta cần hai lớp bảo vệ: lọc tệp và nền tảng hóa prompt.
Lớp đầu tiên ngăn lãng phí ngữ cảnh cho các tạo phẩm không liên quan như đầu ra build, notebook, hình ảnh hoặc tệp nhị phân.
Lớp thứ hai đảm bảo, khi repo đã được đóng gói, mô hình vẫn bám sát mã thực tế thay vì trôi sang lời khuyên phần mềm chung chung.
Kết hợp lại, các quy tắc này giúp phân tích repo hiệu quả hơn.
BASE_IGNORE_DIRS = {
    ".git", ".github", "__pycache__", "node_modules", ".venv", "venv",
    "dist", "build", ".mypy_cache", ".pytest_cache", ".idea", ".vscode"
}
IGNORE_SUFFIXES = {
    ".png", ".jpg", ".jpeg", ".gif", ".webp", ".pdf", ".zip", ".gz",
    ".tar", ".mp4", ".mov", ".onnx", ".pt", ".bin", ".parquet", ".feather",
    ".ico", ".svg", ".lock"
}
MAX_FILE_BYTES = 250_000
SYSTEM_PROMPT = """You are a codebase analysis model.
You are given the complete repository contents in one prompt.
Rules:
1. Use only the provided repository content.
2. Do not invent files, modules, libraries, or dependencies.
3. Every substantial claim must cite one or more file paths.
4. Clearly separate direct observations from engineering inferences or recommendations.
5. For modernization or improvement suggestions, explicitly distinguish:
   - repo-grounded findings
   - general engineering recommendations
6. Return valid JSON only.
7. If uncertain, say so explicitly.
8. For anything involving security, dead code, dependency replacement, or testing gaps,
   present findings as likely candidates unless directly proven by repository content.
"""
Ba biến lọc sau điều khiển tiền xử lý kho:
BASE_IGNORE_DIRS loại trừ các thư mục không liên quan đến phân tích mã hoặc quá nhiễu để hữu ích, như .git, node_modules, thư mục build và bộ đệm đặc thù IDE. IGNORE_SUFFIXES lọc các loại tệp thường không giúp ích cho suy luận repo, bao gồm hình ảnh, lưu trữ, video, checkpoint mô hình và các tạo phẩm khác. MAX_FILE_BYTES thêm một kiểm tra an toàn bằng cách bỏ qua các tệp quá lớn, giúp repo đóng gói nằm trong ngân sách ngữ cảnh thực tế.SYSTEM_PROMPT cũng quan trọng không kém các bộ lọc tệp.
Vì mô hình xem repo như một prompt dài, ta cần ràng buộc hành vi rõ ràng để tránh bịa module, hiểu sai trừu tượng hoặc đưa khuyến nghị quá chung chung.
Các chỉ dẫn này buộc mô hình bám sát repo được cung cấp, trích dẫn đường dẫn tệp cho các khẳng định quan trọng và tách bạch bằng chứng trực tiếp khỏi nhận định chung.
Khi đã có lọc tệp và system prompt, bước tiếp theo là định nghĩa một tập tác vụ trên toàn repo, mỗi tác vụ ghép với một lược đồ JSON có cấu trúc.
Điều này mang lại hai lợi ích lớn: mô hình biết chính xác cần xuất ra loại đầu ra nào, và ứng dụng có thể phân tích, hiển thị kết quả đáng tin cậy trong các bảng theo tác vụ.
TASK_DEFS: Dict[str, Dict[str, Any]] = {
    "Architecture Overview": {
        "description": "Explain the architecture, major modules, likely entrypoints, dependencies, and architectural issues.",
        "schema": {
            "repo_overview": {
                "summary": "",
                "primary_languages": [],
                "likely_entrypoints": []
            },
            "modules": [
                {
                    "name": "",
                    "responsibility": "",
                    "key_files": [],
                    "evidence_paths": []
                }
            ],
            "dependencies": [
                {
                    "from_module": "",
                    "to_module": "",
                    "relationship": "",
                    "evidence_paths": []
                }
            ],
            "issues": [
                {
                    "type": "",
                    "description": "",
                    "severity": "low|medium|high",
                    "evidence_paths": []
                }
            ],
            "unknowns_and_uncertainties": []
        },
    },
    ...
}
Từ điển TASK_DEFS đóng vai trò sổ đăng ký trung tâm cho mọi chế độ phân tích mà ứng dụng hỗ trợ.
Mỗi tác vụ bao gồm mô tả ngôn ngữ tự nhiên nêu rõ việc cần làm và một lược đồ nghiêm ngặt định nghĩa JSON đầu ra mong đợi.
Điều này cho phép cùng một repo đã đóng gói hỗ trợ nhiều hình thức suy luận rất khác nhau, như lập bản đồ kiến trúc, phân tích trùng lặp, hướng dẫn onboarding hoặc phát hiện khoảng trống kiểm thử.
Ví dụ, Architecture Overview yêu cầu mô hình xác định:
Các tác vụ khác trong mã đầy đủ gồm:
Code Duplication tập trung vào logic lặp lại và cơ hội refactor liên quan,Improvement Opportunities xác định các cải thiện về khả năng bảo trì và tính mô-đun,Testing Gaps làm nổi bật các khu vực thiếu kiểm thử,Onboarding Guide giải thích cách một kỹ sư mới nên tiếp cận codebase,Library Modernization nêu bật thư viện lỗi thời hoặc chồng chéo,Code Quality Hotspots chỉ ra các khu vực dễ vỡ hoặc dễ lỗi,Security hoặc Config Hygiene gắn cờ các thiết lập rủi ro hoặc vấn đề vận hành.FULL_REVIEW_TASKS = [
"Architecture Overview",
"Improvement Opportunities",
"Code Quality Hotspots",
"Testing Gaps",
"Refactor Roadmap",
]
TASK_CHOICES = [
"Architecture Overview",
"Code Duplication",
"Improvement Opportunities",
"Refactor Roadmap",
"Testing Gaps",
"Onboarding Guide",
"Library Modernization",
"Code Quality Hotspots",
"Security / Config Hygiene",
"Full Review",
]
def safe_str(value: Any) -> str:
if value is None:
return ""
if isinstance(value, str):
return value.strip()
return str(value).strip()Danh sách FULL_REVIEW_TASKS định nghĩa một gói đánh giá nhiều bước.
Thay vì chạy mọi tác vụ có thể, nó chạy một tập chọn lọc mang lại cái nhìn kỹ thuật rộng về repo. TASK_CHOICES sau đó được dùng trực tiếp trong dropdown của Gradio để người dùng chọn một tác vụ đơn lẻ hoặc đánh giá gói.
Phần cuối, safe_str(), giải quyết một vấn đề ổn định quan trọng đáng ngạc nhiên. Trong quá trình phát triển, một lỗi thường gặp là:
'NoneType' object has no attribute 'strip'Điều này có thể xảy ra khi:
None,Bằng cách chuẩn hóa các giá trị như vậy qua hàm safe_str(), ứng dụng ổn định hơn đáng kể.
Trước khi gửi bất cứ thứ gì tới mô hình, chúng ta cần biến một repo GitHub thành một prompt có cấu trúc duy nhất.
Bước này xử lý toàn bộ pipeline nạp vào gồm nhân bản repo, lọc các tệp không liên quan, chỉ trích xuất văn bản hữu dụng và đóng gói tất cả vào định dạng mà mô hình có thể tiêu thụ một lần.
Khác với các pipeline RAG truyền thống, chúng ta không chia đoạn hay nhúng. Thay vào đó, nén toàn bộ repo vào một đầu vào ngữ cảnh dài duy nhất, nên việc chọn lọc và có cấu trúc ở đây là tối quan trọng cho hiệu năng và chất lượng.
def clone_repo(repo_url: str, branch: str = "main") -> str:
    repo_url = safe_str(repo_url)
    branch = safe_str(branch)
    if not repo_url:
        raise ValueError("Repository URL is empty.")
    if os.path.exists(WORKDIR):
        shutil.rmtree(WORKDIR)
    cmd = ["git", "clone", "--depth", "1"]
    if branch:
        cmd += ["--branch", branch]
    cmd += [repo_url, WORKDIR]
    subprocess.run(cmd, check=True, capture_output=True, text=True)
    return WORKDIR
def is_probably_text(path: Path) -> bool:
    try:
        with open(path, "rb") as f:
            chunk = f.read(2048)
        if b"\x00" in chunk:
            return False
        chunk.decode("utf-8")
        return True
    except Exception:
        return False
def iter_repo_files(root: str, exclude_tests: bool, exclude_docs: bool, exclude_notebooks: bool):
    root = Path(root)
    for path in root.rglob("*"):
        if not path.is_file():
            continue
        rel = path.relative_to(root)
        parts = set(rel.parts)
        rel_str = str(rel).lower()
        if any(part in BASE_IGNORE_DIRS for part in rel.parts):
            continue
        if exclude_tests and ("test" in parts or "tests" in parts or "/tests/" in f"/{rel_str}/"):
            continue
        if exclude_docs and ("docs" in parts or rel_str.endswith(".md") or rel_str.endswith(".rst")):
            continue
        if exclude_notebooks and rel_str.endswith(".ipynb"):
            continue
        if path.suffix.lower() in IGNORE_SUFFIXES:
            continue
        try:
            if path.stat().st_size > MAX_FILE_BYTES:
                continue
        except Exception:
            continue
        if not is_probably_text(path):
            continue
        yield path
def repo_tree_string(root: str, exclude_tests: bool, exclude_docs: bool, exclude_notebooks: bool) -> str:
    root = Path(root)
    lines: List[str] = []
    for path in sorted(root.rglob("*")):
        rel = path.relative_to(root)
        rel_str = str(rel).lower()
        parts = set(rel.parts)
        if any(part in BASE_IGNORE_DIRS for part in rel.parts):
            continue
        if path.is_file() and path.suffix.lower() in IGNORE_SUFFIXES:
            continue
        if exclude_tests and ("test" in parts or "tests" in parts or "/tests/" in f"/{rel_str}/"):
            continue
        if exclude_docs and ("docs" in parts or rel_str.endswith(".md") or rel_str.endswith(".rst")):
            continue
        if exclude_notebooks and rel_str.endswith(".ipynb"):
            continue
        lines.append(f"{rel}/" if path.is_dir() else str(rel))
    return "\n".join(lines)
def pack_repo(root: str, exclude_tests: bool, exclude_docs: bool, exclude_notebooks: bool):
    root = Path(root)
    tree = repo_tree_string(root, exclude_tests, exclude_docs, exclude_notebooks)
    files: List[Tuple[str, int, str]] = []
    total_tokens = len(enc.encode(tree))
    for path in iter_repo_files(root, exclude_tests, exclude_docs, exclude_notebooks):
        rel = path.relative_to(root)
        try:
            content = path.read_text(encoding="utf-8", errors="ignore")
        except Exception:
            continue
        block = f"\n=== FILE START: {rel} ===\n{content}\n=== FILE END: {rel} ===\n"
        tok = len(enc.encode(block))
        files.append((str(rel), tok, block))
        total_tokens += tok
    return tree, files, total_tokens
def build_repo_context(tree: str, files: List[Tuple[str, int, str]]) -> str:
    joined_files = "".join(block for _, _, block in files)
    return f"""=== REPO TREE START ===
{tree}
=== REPO TREE END ===
=== REPOSITORY FILES START ===
{joined_files}
=== REPOSITORY FILES END ===
"""
Bước này định nghĩa toàn bộ pipeline nạp và đóng gói repo, nhưng mỗi hàm có trách nhiệm riêng:
hàm clone_repo(): Nhân bản repo GitHub vào thư mục làm việc tạm bằng clone nông (--depth 1) để tránh kéo toàn bộ lịch sử. Đầu vào như URL repo và nhánh được chuẩn hóa bằng safe_str() để tránh lỗi runtime. Đầu ra là đường dẫn cục bộ (WORKDIR) mà phần còn lại của pipeline sử dụng.hàm iter_repo_files(): Lớp lọc chính. Duyệt đệ quy repo và chỉ trả về các tệp tín hiệu cao. Loại trừ thư mục hệ thống, kiểu tệp không hỗ trợ, tệp quá kích thước và tùy chọn lọc tests, tài liệu và notebooks. hàm is_probably_text(): Kiểm tra an toàn nhẹ. Đọc một đoạn nhỏ của mỗi tệp và xác minh không có byte null (thường chỉ báo nội dung nhị phân) và giải mã UTF-8 thành công. Chỉ các tệp vượt qua kiểm tra này mới được coi là văn bản hợp lệ.hàm repo_tree_string(): Xây dựng chuỗi biểu diễn cấu trúc repo. Tạo cây thư mục (áp dụng cùng quy tắc lọc) và xuất danh sách thư mục, tệp để mô hình nắm bố cục codebase trước khi đọc nội dung tệp.hàm pack_repo(): Hàm đóng gói lõi. Duyệt các tệp đã lọc, đọc nội dung và bọc từng tệp trong các mốc đánh dấu rõ như === FILE START === và === FILE END ===. Cũng ước tính lượng token bằng tiktoken và cộng dồn tổng số token. hàm build_repo_context(): Kết hợp mọi thứ thành một prompt có cấu trúc duy nhất. Đặt cây repo trước, sau đó là nội dung tệp. Mô hình hiểu cấu trúc trước rồi đọc chi tiết triển khai.Hiệu ứng ròng là một repo GitHub thô được biến thành một đầu vào ngữ cảnh dài có cấu trúc duy nhất.
Khi repo đã được lọc và đóng gói thành một đầu vào ngữ cảnh dài, bước tiếp theo là chỉ cho mô hình biết dạng phân tích cần thực hiện và cách định dạng kết quả.
Thay vì gửi cùng một chỉ dẫn chung cho mọi trường hợp, chúng ta tạo một prompt theo tác vụ bao gồm tên tác vụ đã chọn, mô tả của nó và lược đồ JSON chính xác kỳ vọng trong phản hồi.
def build_task_prompt(task_name: str, repo_context: str) -> str:
    task_name = safe_str(task_name)
    if not task_name:
        raise ValueError("Task name is empty.")
    if task_name not in TASK_DEFS:
        raise ValueError(f"Unknown task: {task_name}")
    task_def = TASK_DEFS[task_name]
    return f"""Analyze this full repository.
Task Name:
{task_name}
Task Description:
{task_def["description"]}
Return JSON matching this schema exactly:
{json.dumps(task_def["schema"], indent=2)}
{repo_context}
"""
def try_parse_json(text: str) -> Dict[str, Any]:
    text = safe_str(text)
    if not text:
        raise ValueError("Model returned empty text.")
    try:
        return orjson.loads(text)
    except Exception:
        start = text.find("{")
        end = text.rfind("}")
        if start != -1 and end != -1 and end > start:
            return orjson.loads(text[start:end+1])
        raise ValueError("Could not parse model output as JSON.")
Đoạn mã trên định nghĩa hai hàm liên quan chặt chẽ tạo cầu nối giữa repo đóng gói và đầu ra phân tích theo tác vụ.
hàm build_task_prompt() : Tạo prompt cuối được gửi tới mô hình. Trước tiên chuẩn hóa tên tác vụ bằng safe_str() để đầu vào rỗng không làm vỡ pipeline. Sau đó xác thực tác vụ có tồn tại trong TASK_DEFS, ngăn app gửi tên tác vụ không hỗ trợ hoặc đánh sai. Khi đã hợp lệ, hàm lấy mô tả và lược đồ JSON của tác vụ đó, nhúng cả hai vào prompt cuối bên cạnh toàn bộ ngữ cảnh repo.hàm try_parse_json(): Xử lý đầu ra mô hình sau suy luận. Thực tế, các mô hình ngữ cảnh dài đôi khi bọc JSON bằng văn bản thừa, tạo phẩm định dạng hoặc nội dung giải thích. Để ứng dụng bền bỉ hơn, hàm try_parse_json() thử phân tích trực tiếp bằng orjson.loads() trước. Bằng cách kết hợp prompt nghiêm ngặt với phân tích khoan dung, ứng dụng ổn định hơn nhiều.Ở bước tiếp theo, chúng ta sẽ kết nối logic gợi ý này với lệnh gọi mô hình và bắt đầu tạo các kết quả phân tích repo có cấu trúc.
Tại giai đoạn này, chúng ta chạy phân tích bằng cách gửi prompt tới Nemotron 3 Super qua OpenRouter.
Thay vì chia đoạn hay truy xuất từng phần repo, ta gửi toàn bộ codebase đã lọc trong một yêu cầu duy nhất và để mô hình suy luận toàn cục trên các tệp, module và phụ thuộc.
def call_model(prompt: str, max_tokens: int = 5000) -> str:
    prompt = safe_str(prompt)
    if not prompt:
        raise ValueError("Prompt is empty.")
    resp = client.chat.completions.create(
        model=MODEL,
        messages=[
            {"role": "system", "content": SYSTEM_PROMPT},
            {"role": "user", "content": prompt},
        ],
        temperature=0.2,
        max_tokens=max_tokens,
        extra_headers={
            "HTTP-Referer": "https://colab.research.google.com",
            "X-Title": "Whole Repo Analysis Demo"
        }
    )
    if not getattr(resp, "choices", None):
        raise ValueError("Model response has no choices.")
    message = getattr(resp.choices[0], "message", None)
    if message is None:
        raise ValueError("Model response has no message.")
    content = getattr(message, "content", None)
    content = safe_str(content)
    if not content:
        raise ValueError("Model returned empty content.")
    return content
Hàm call_model() chịu trách nhiệm thực thi lệnh gọi mô hình và trích xuất phản hồi. Toàn bộ pipeline như sau:
temperature đặt ở 0.2 để đầu ra quyết đoán và max_tokens giới hạn kích thước phản hồi, đảm bảo mô hình tập trung vào đầu ra có cấu trúc.Cuối cùng, ta có thể chuyển sang phần suy luận mô hình tiếp theo và hiểu cách chạy phân tích qua mô hình lưu trữ trên OpenRouter.
Tiếp theo, ta cần một vài hàm nhỏ giúp UI và xử lý đầu ra trở nên dễ dàng.
def to_df(items, columns=None):
    if items is None:
        return pd.DataFrame(columns=columns or [])
    if isinstance(items, dict):
        return pd.DataFrame([items])
    if not items:
        return pd.DataFrame(columns=columns or [])
    return pd.DataFrame(items)
def get_tasks_to_run(task: str) -> List[str]:
    task = safe_str(task)
    if not task:
        raise ValueError("Task is empty.")
    return FULL_REVIEW_TASKS if task == "Full Review" else [task]
def visible_for_task(task: str) -> Dict[str, bool]:
    task = safe_str(task)
    if task == "Full Review":
        return {
            "modules": True,
            "deps": True,
            "issues": True,
            "dups": False,
            "refactor": False,
            "improvements": True,
            "roadmap": True,
            "testing": True,
            "onboarding": False,
            "libs": False,
            "hotspots": True,
            "security": False,
        }
    return {
        "modules": task == "Architecture Overview",
        "deps": task == "Architecture Overview",
        "issues": task == "Architecture Overview",
        "dups": task == "Code Duplication",
        "refactor": task == "Code Duplication",
        "improvements": task == "Improvement Opportunities",
        "roadmap": task == "Refactor Roadmap",
        "testing": task == "Testing Gaps",
        "onboarding": task == "Onboarding Guide",
        "libs": task == "Library Modernization",
        "hotspots": task == "Code Quality Hotspots",
        "security": task == "Security / Config Hygiene",
    }
def render_markdown_summary(repo_url: str, total_tokens: int, files, results: Dict[str, Dict[str, Any]]) -> str:
    repo_url = safe_str(repo_url)
    lines = [
        "# Whole-Repo Analysis Report",
        f"**Repository:** {repo_url}",
        f"**Files included:** {len(files)}",
        f"**Estimated input tokens:** {total_tokens}",
        "",
    ]
    if "Architecture Overview" in results:
        overview = results["Architecture Overview"].get("repo_overview", {})
        lines += [
            "## Architecture",
            overview.get("summary", "No summary returned."),
            "",
            f"**Primary languages:** {', '.join(overview.get('primary_languages', [])) or 'N/A'}",
            f"**Likely entrypoints:** {', '.join(overview.get('likely_entrypoints', [])) or 'N/A'}",
            "",
        ]
    if "Improvement Opportunities" in results:
        lines += [
            "## Improvement Opportunities",
            f"- Identified: {len(results['Improvement Opportunities'].get('improvement_opportunities', []))}",
            "",
        ]
    if "Code Quality Hotspots" in results:
        lines += [
            "## Code Quality Hotspots",
            f"- Identified: {len(results['Code Quality Hotspots'].get('quality_hotspots', []))}",
            "",
        ]
    if "Testing Gaps" in results:
        lines += [
            "## Testing Gaps",
            f"- Identified: {len(results['Testing Gaps'].get('testing_gaps', []))}",
            "",
        ]
    if "Code Duplication" in results:
        dup = results["Code Duplication"]
        lines += [
            "## Duplication & Refactor Summary",
            f"- Duplication candidates: {len(dup.get('duplication_candidates', []))}",
            f"- Design smells: {len(dup.get('design_smells', []))}",
            f"- High risk files: {len(dup.get('high_risk_files', []))}",
            f"- Refactor recommendations: {len(dup.get('refactor_recommendations', []))}",
            "",
        ]
    if "Library Modernization" in results:
        lines += [
            "## Library Modernization",
            f"- Recommendations: {len(results['Library Modernization'].get('library_recommendations', []))}",
            "",
        ]
    if "Security / Config Hygiene" in results:
        lines += [
            "## Security / Config Hygiene",
            f"- Findings: {len(results['Security / Config Hygiene'].get('security_and_config_findings', []))}",
            "",
        ]
    if "Refactor Roadmap" in results:
        lines += [
            "## Refactor Roadmap",
            f"- Planned items: {len(results['Refactor Roadmap'].get('refactor_roadmap', []))}",
            "",
        ]
    if "Onboarding Guide" in results:
        onboarding = results["Onboarding Guide"].get("onboarding_guide", {})
        lines += [
            "## Onboarding Guide",
            onboarding.get("summary", "No summary returned."),
            "",
            f"**Recommended reading order:** {', '.join(onboarding.get('recommended_reading_order', [])) or 'N/A'}",
            f"**Entrypoints:** {', '.join(onboarding.get('entrypoints', [])) or 'N/A'}",
            "",
        ]
    return "\n".join(lines)
def hidden_update():
    return gr.update(value=pd.DataFrame(), visible=False)
def visible_update(df):
    return gr.update(value=df, visible=True)
def empty_outputs(stats, status_message):
    return (
        status_message,
        "",
        *all_hidden(),
        "{}",
        json.dumps(stats, indent=2),
    )
Bước này định nghĩa một tập nhỏ các hàm tiện ích, nhưng cùng nhau chúng xử lý hầu hết logic trình bày của ứng dụng.
hàm to_df(): Chuyển đầu ra mô hình thành DataFrame pandas để hiển thị gọn trong các bảng Gradio. hàm get_tasks_to_run(): Quyết định ứng dụng nên chạy một tác vụ hay gói Full Review. Nếu tác vụ chọn là "Full Review", nó mở rộng thành danh sách tác vụ đánh giá được định sẵn. Ngược lại, trả về danh sách một phần tử với tác vụ đã chọn. hàm visible_for_task(): Điều khiển bảng báo cáo nào sẽ hiển thị trong UI. Ví dụ, nếu người dùng chọn Onboarding Guide, thì không cần hiển thị bảng trùng lặp hay bảo mật. hàm render_markdown_summary(): Thay vì đổ JSON thô trực tiếp, hàm này tạo bản tóm tắt dễ đọc với siêu dữ liệu repo, số token và các điểm nổi bật theo tác vụ.hàm hidden_update() và visible_update(): Trợ giúp nhỏ cho Gradio để điều khiển trạng thái thành phần. hidden_update() xóa và ẩn bảng, còn visible_update() đổ dữ liệu và hiện bảng. Mẫu này quan trọng vì Gradio kỳ vọng giá trị trả về cho mọi thành phần đầu ra, và nếu không đặt lại rõ ràng sẽ gây lỗi.hàm empty_outputs(): Xử lý thoát sớm và trạng thái lỗi. Nếu repo quá lớn, tác vụ không hợp lệ, hoặc lỗi khác, ứng dụng vẫn cần trả về đầu ra hợp lệ cho mọi thành phần UI. Cùng nhau, các hàm tiện ích này không thay đổi logic mô hình cốt lõi, nhưng tạo nên một ứng dụng sử dụng được.
Hàm này điều phối toàn bộ quy trình. Nó xác thực đầu vào, chuẩn bị repo, chạy một hoặc nhiều tác vụ phân tích và trả về các đầu ra có cấu trúc cho UI Gradio.
def analyze_repo(repo_url, branch, task, token_budget, exclude_tests, exclude_docs, exclude_notebooks):
    repo_url = safe_str(repo_url)
    branch = safe_str(branch)
    task = safe_str(task)
    try:
        if not repo_url:
            stats = {"repo_url": "", "branch": branch}
            return empty_outputs(stats, "Error: Repository URL is empty.")
        if not task:
            stats = {"repo_url": repo_url, "branch": branch}
            return empty_outputs(stats, "Error: Task is empty.")
        repo_path = clone_repo(repo_url, branch)
        tree, files, total_tokens = pack_repo(repo_path, exclude_tests, exclude_docs, exclude_notebooks)
        stats = {
            "repo_url": repo_url,
            "branch": branch,
            "files_included": len(files),
            "estimated_input_tokens": total_tokens,
            "token_budget": token_budget,
            "fits_budget": total_tokens <= token_budget,
            "sample_files": [f[0] for f in files[:30]],
            "tasks_requested": get_tasks_to_run(task),
        }
        if total_tokens > token_budget:
            msg = (
                f"Repo too large for current budget.\n\n"
                f"Estimated tokens: {total_tokens}\n"
                f"Budget: {token_budget}\n\n"
                f"Try excluding tests/docs/notebooks or use a smaller repo."
            )
            return empty_outputs(stats, msg)
        repo_context = build_repo_context(tree, files)
        tasks_to_run = get_tasks_to_run(task)
        results: Dict[str, Dict[str, Any]] = {}
        for task_name in tasks_to_run:
            prompt = build_task_prompt(task_name, repo_context)
            raw_text = call_model(prompt)
            results[task_name] = try_parse_json(raw_text)
        report_md = render_markdown_summary(repo_url, total_tokens, files, results)
        vis = visible_for_task(task)
        arch_json = results.get("Architecture Overview", {})
        dup_json = results.get("Code Duplication", {})
        imp_json = results.get("Improvement Opportunities", {})
        roadmap_json = results.get("Refactor Roadmap", {})
        testing_json = results.get("Testing Gaps", {})
        onboarding_json = results.get("Onboarding Guide", {})
        lib_json = results.get("Library Modernization", {})
        hotspot_json = results.get("Code Quality Hotspots", {})
        security_json = results.get("Security / Config Hygiene", {})
        modules_df = to_df(arch_json.get("modules", []), ["name", "responsibility", "key_files", "evidence_paths"])
        deps_df = to_df(arch_json.get("dependencies", []), ["from_module", "to_module", "relationship", "evidence_paths"])
        issues_df = to_df(arch_json.get("issues", []), ["type", "description", "severity", "evidence_paths"])
        dups_df = to_df(dup_json.get("duplication_candidates", []), ["summary", "files_involved", "why_it_looks_duplicate", "confidence"])
        refactor_df = to_df(dup_json.get("refactor_recommendations", []), ["title", "description", "target_files", "expected_benefit"])
        improvements_df = to_df(imp_json.get("improvement_opportunities", []), ["title", "description", "why_it_matters", "affected_files", "suggested_change", "expected_impact", "effort", "evidence_paths"])
        roadmap_df = to_df(roadmap_json.get("refactor_roadmap", []), ["priority", "title", "description", "target_files", "impact", "effort", "why_now"])
        testing_df = to_df(testing_json.get("testing_gaps", []), ["module_or_file", "why_it_needs_tests", "likely_missing_cases", "recommended_test_type", "evidence_paths"])
        onboarding_df = to_df(onboarding_json.get("onboarding_guide", {}), ["summary", "recommended_reading_order", "entrypoints", "important_directories", "debugging_start_points", "common_confusion_points"])
        libs_df = to_df(lib_json.get("library_recommendations", []), ["current_library_or_pattern", "where_used", "suggested_alternative", "why_better", "migration_difficulty", "confidence", "evidence_paths", "recommendation_type"])
        hotspots_df = to_df(hotspot_json.get("quality_hotspots", []), ["file_or_module", "risk_level", "why_it_is_a_hotspot", "evidence_paths", "recommended_cleanup"])
        security_df = to_df(security_json.get("security_and_config_findings", []), ["title", "severity", "description", "affected_files", "evidence_paths", "recommended_fix", "confidence"])
        status = (
            f"Done.\n\n"
            f"Files included: {len(files)}\n"
            f"Estimated input tokens: {total_tokens}\n"
            f"Tasks run: {', '.join(tasks_to_run)}"
        )
        return (
            status,
            report_md,
            visible_update(modules_df) if vis["modules"] else hidden_update(),
            visible_update(deps_df) if vis["deps"] else hidden_update(),
            visible_update(issues_df) if vis["issues"] else hidden_update(),
            visible_update(dups_df) if vis["dups"] else hidden_update(),
            visible_update(refactor_df) if vis["refactor"] else hidden_update(),
            visible_update(improvements_df) if vis["improvements"] else hidden_update(),
            visible_update(roadmap_df) if vis["roadmap"] else hidden_update(),
            visible_update(testing_df) if vis["testing"] else hidden_update(),
            visible_update(onboarding_df) if vis["onboarding"] else hidden_update(),
            visible_update(libs_df) if vis["libs"] else hidden_update(),
            visible_update(hotspots_df) if vis["hotspots"] else hidden_update(),
            visible_update(security_df) if vis["security"] else hidden_update(),
            json.dumps(results, indent=2),
            json.dumps(stats, indent=2),
        )
    except subprocess.CalledProcessError as e:
        stats = {"repo_url": repo_url, "branch": branch}
        stderr = safe_str(getattr(e, "stderr", "")) or safe_str(e)
        return empty_outputs(stats, f"Git clone failed:\n{stderr}")
    except Exception as e:
        stats = {"repo_url": repo_url, "branch": branch}
        return empty_outputs(stats, f"Error: {safe_str(e)}")
Hàm này điều phối toàn bộ pipeline, từ repo thô đến đầu ra có cấu trúc.
results.to_df() và ánh xạ tới các thành phần UI. Tính hiển thị được điều khiển qua visible_for_task(), đảm bảo chỉ các bảng liên quan được hiển thị cho tác vụ đã chọn.empty_outputs() để giữ UI ổn định.Cuối cùng, chúng ta bọc tất cả trong một giao diện Gradio đơn giản.
with gr.Blocks(title="Nemotron Repo Analyzer") as demo:
    gr.Markdown("# Nemotron Repo Analyzer")
    # gr.Markdown("Analyze a public GitHub repository without RAG using a single packed prompt.")
    with gr.Tab("Analyze"):
        with gr.Row():
            repo_url = gr.Textbox(
                label="GitHub Repo URL",
                value="https://github.com/AashiDutt/Nemotron-3-Nano.git"
            )
            branch = gr.Textbox(label="Branch", value="main")
        with gr.Row():
            task = gr.Dropdown(
                choices=TASK_CHOICES,
                value="Full Review",
                label="Task"
            )
            token_budget = gr.Slider(
                minimum=40000,
                maximum=180000,
                step=5000,
                value=120000,
                label="Token Budget"
            )
        with gr.Row():
            exclude_tests = gr.Checkbox(value=False, label="Exclude tests")
            exclude_docs = gr.Checkbox(value=False, label="Exclude docs / markdown")
            exclude_notebooks = gr.Checkbox(value=True, label="Exclude notebooks")
        analyze_btn = gr.Button("Analyze Repo", variant="primary")
        status = gr.Textbox(label="Status", lines=7)
    with gr.Tab("Report"):
        report_md = gr.Markdown()
        modules_df = gr.Dataframe(label="Modules", visible=False)
        deps_df = gr.Dataframe(label="Dependencies", visible=False)
        issues_df = gr.Dataframe(label="Architecture Issues", visible=False)
        dups_df = gr.Dataframe(label="Duplication Candidates", visible=False)
        refactor_df = gr.Dataframe(label="Refactor Recommendations", visible=False)
        improvements_df = gr.Dataframe(label="Improvement Opportunities", visible=False)
        roadmap_df = gr.Dataframe(label="Refactor Roadmap", visible=False)
        testing_df = gr.Dataframe(label="Testing Gaps", visible=False)
        onboarding_df = gr.Dataframe(label="Onboarding Guide", visible=False)
        libs_df = gr.Dataframe(label="Library Modernization", visible=False)
        hotspots_df = gr.Dataframe(label="Code Quality Hotspots", visible=False)
        security_df = gr.Dataframe(label="Security / Config Hygiene", visible=False)
    with gr.Tab("Raw JSON"):
        all_results_json_box = gr.Code(label="All Task Results JSON", language="json")
        stats_box = gr.Code(label="Run Stats", language="json")
    analyze_btn.click(
        analyze_repo,
        inputs=[repo_url, branch, task, token_budget, exclude_tests, exclude_docs, exclude_notebooks],
        outputs=[
            status,
            report_md,
            modules_df,
            deps_df,
            issues_df,
            dups_df,
            refactor_df,
            improvements_df,
            roadmap_df,
            testing_df,
            onboarding_df,
            libs_df,
            hotspots_df,
            security_df,
            all_results_json_box,
            stats_box,
        ]
    )
demo.launch(debug=True, share=True)
Container gr.Blocks() định nghĩa bố cục tổng thể của ứng dụng, trong khi Markdown cấp cao đặt tiêu đề và ngữ cảnh. Giao diện được chia thành ba tab để quy trình có cấu trúc.
Điều này kết nối trực tiếp đầu vào người dùng tới hàm analyze_repo() và ánh xạ đầu ra của nó trở lại các thành phần UI. Thứ tự đầu ra là tối quan trọng, vì mỗi giá trị trả về được định tuyến tới phần tử UI cụ thể.
Cuối cùng, ứng dụng được khởi chạy bằng:
demo.launch(debug=True, share=True)Cờ debug=True giúp hiển thị lỗi runtime trong quá trình phát triển, còn share=True tạo liên kết công khai, dễ dàng chia sẻ ứng dụng mà không cần triển khai.
Trong hướng dẫn này, tôi đã trình bày cách xây dựng trình phân tích codebase repo bằng NVIDIA Nemotron 3 Super, OpenRouter và Gradio.
Thay vì dựa vào chia đoạn, nhúng và truy xuất, ứng dụng nhân bản repo GitHub công khai, lọc và đóng gói codebase vào một prompt duy nhất, và yêu cầu mô hình suy luận trên toàn bộ repo cùng lúc.
Cách tiếp cận toàn ngữ cảnh này hữu ích cho các tác vụ cần góc nhìn toàn cục về codebase, như giải thích kiến trúc, hướng dẫn onboarding, phân tích khoảng trống kiểm thử, cơ hội cải tiến và lập kế hoạch refactor.
Từ đây, bạn có thể mở rộng dự án theo nhiều cách:
Các khóa học hàng đầu trên DataCamp
Khóa học
Khóa học
Khóa học
blog
Matt Crabtree
10 phút
