
Khóa học
Học có giám sát với scikit-learn
4 giờ
308.8K
Luyện tập và Lộ trình tiến trình của bạn.
Tiếp Tục Với GooglecuML của NVIDIA là một thư viện máy học tăng tốc bằng GPU thuộc hệ sinh thái RAPIDS AI. Và hiện nay, ở giai đoạn beta mở, cuML 25.02 cho phép tăng tốc GPU trong scikit-learn, UMAP và HDBSCAN mà không cần thay đổi mã Python của bạn. Đây sẽ là tin rất đáng chú ý đối với các kỹ sư máy học Python, nhà khoa học dữ liệu và nghiên cứu, nhà phát triển, và nhiều chuyên gia khác đang mong đợi hiệu năng mô hình được cải thiện.
Đừng lo nếu bạn chưa quen với cuML hay thậm chí là khái niệm tăng tốc GPU. Tôi sẽ hướng dẫn bạn khái quát và đến cuối bài viết này, bạn sẽ có thể dùng tăng tốc GPU cho các bài toán hồi quy, phân loại, giảm chiều hoặc phân cụm.
Hãy dành chút thời gian để xếp các mảnh ghép vào đúng chỗ.
NVIDIA phát triển các công nghệ tiên tiến phục vụ điện toán hiệu năng cao, AI và khoa học dữ liệu. Bạn có thể nhớ rằng họ từng xuất hiện dày đặc trên báo chí khi Deepseek ra mắt Deepseek-R1 và nhiều người tự hỏi liệu Deepseek có dùng chip NVIDIA không.
Giờ đây, NVIDIA lại lên báo, lần này là vì những đổi mới trong hệ sinh thái RAPIDS AI. Nếu bạn chưa biết, RAPIDS AI là một bộ thư viện mã nguồn mở tăng tốc bằng GPU, được thiết kế để tăng tốc quy trình khoa học dữ liệu và máy học. RAPIDS được xây dựng trên CUDA (Compute Unified Device Architecture) — một nền tảng tính toán song song và mô hình API, cũng do NVIDIA phát triển. Các thư viện tăng tốc GPU của RAPIDS gồm có:
Về cuML: cuML cung cấp các hiện thực hóa tối ưu cao cho những thuật toán máy học kinh điển. Vì NVIDIA có những con chip AI hàng đầu, các thuật toán này, khi chạy trên GPU NVIDIA, đạt được tốc độ tăng đáng kể. Khác với CPU, GPU vượt trội ở xử lý song song, tức là chúng có thể xử lý hàng nghìn phép tính cùng lúc, rất lý tưởng cho các tác vụ như (bạn đoán đúng rồi) học sâu và máy học.
Nếu bạn chưa quen với scikit-learn mà lại nghiêm túc với máy học và khoa học dữ liệu, bạn nên tham gia khóa Học có giám sát với scikit-learn của chúng tôi. Tôi nói vậy vì scikit-learn là thư viện số một cho dữ liệu dạng bảng trong ngôn ngữ lập trình phổ biến nhất dành cho máy học. Hơn nữa, scikit-learn khá dễ học, có API đơn giản và cũng hoạt động tốt với pandas và NumPy. Không ngạc nhiên khi đội RAPIDS AI tập trung vào các thuật toán scikit-learn như một lựa chọn chiến lược và tự nhiên.
NVIDIA và cuML giờ đây mang đến đổi mới lớn cho scikit-learn, cũng như UMAP và HDBSCAN: một cú hích lớn về tốc độ. Theo đội RAPIDS AI, điều này có nghĩa là tăng tốc tới 50 lần với scikit-learn, 60 lần với UMAP và 175 lần với HDBSCAN.
Tính nhẩm sơ bộ của tôi cho thấy một thuật toán mất năm phút chạy trên scikit-learn về lý thuyết có thể rút xuống còn sáu giây. Đó là khác biệt lớn. Tôi sẽ dành thêm thời gian bàn về điều này khi xem các benchmark bên dưới.
Nếu tất cả nghe có vẻ phức tạp, đừng lo. RAPIDS AI cam kết không cần thay đổi mã API cho scikit-learn. Thực sự, bạn chỉ cần nạp phần mở rộng như sau:
%load_ext cuml.accel
$ python -m cuml.accel script.pyĐiều này không làm thay đổi nhiều quy trình làm việc quen thuộc của bạn — đó chính là ý tưởng. Thỉnh thoảng, có thể bạn cần khởi động lại kernel và nạp lại phần mở rộng.
Theo tôi, khía cạnh “không cần đổi mã” này ngay từ cái nhìn đầu tiên là một tuyên bố rất thú vị. Ý tưởng là bạn không phải thay đổi các script scikit-learn đã viết — không chỉ lần đầu, mà về sau cũng vậy. cuML sẽ tự động tăng tốc các thành phần tương thích trên GPU NVIDIA; nếu có phần nào trong mã không tương thích với GPU của NVIDIA, script sẽ quay về chạy trên CPU “bình thường”. Bạn, với vai trò người viết mã, chỉ thấy kết quả mà không phải bận tâm xử lý lỗi hay điều gì khác.
Nói vậy nhưng tôi vẫn kỳ vọng sẽ có những trường hợp biên cần điều chỉnh. Trong lập trình, mọi thứ có thể trục trặc và hiếm khi đơn giản như tưởng. Tài liệu tham khảo có nêu một số điểm phần nào làm nhẹ đi tuyên bố “không đổi mã”, hoặc ít nhất tạo chút ma sát. Bạn phải chuyển list thành mảng NumPy hoặc Pandas DataFrame, và nhãn dạng chuỗi không được hỗ trợ nên người dùng phải mã hóa trước nhãn phân loại. Có thể bạn vốn dĩ vẫn làm thế, nhưng ý là ngoài việc nạp phần mở rộng, vẫn còn vài điều cần làm quen.
Nếu bạn đang ôn lại thống kê cơ bản bằng cách chạy hồi quy tuyến tính đơn giản trên bộ dữ liệu mtcars, thì dùng tăng tốc GPU để tìm hệ số góc và giao điểm nhanh hơn chút xíu cũng không quá hữu ích. Tiết kiệm vài phần của giây thậm chí không đáng để nạp phần mở rộng. Nhưng nếu bạn chạy thuật toán phức tạp hơn, thời gian tiết kiệm được lại quan trọng vì hai lý do chính.
Thứ nhất, thời gian tiết kiệm được là đáng kể với nhiều quy trình. Tôi đã đề cập tăng tốc đến 50 lần có thể, giả định, rút năm phút huấn luyện xuống còn sáu giây. Đó là tiết kiệm gần năm phút. Nhưng hãy xét quy trình làm việc của kỹ sư máy học, nơi mô hình có thể cần chạy vài lần để tinh chỉnh. Cộng dồn lại, nói về tiết kiệm thời gian mỗi lần chạy chính là nói về năng suất tổng thể của nhà khoa học dữ liệu.
Thứ hai, liên quan đến đó, nhà khoa học hay kỹ sư giờ có thể thử các mô hình phức tạp hơn. Ở ví dụ trước, ta giả định tốc độ của mô hình giữ nguyên độ chính xác. Nhưng nếu bạn nghĩ rằng dùng mô hình phức tạp hơn sẽ thật sự tăng độ chính xác thì sao? Hãy hình dung thực hiện grid search tham số và huấn luyện mô hình. (Tôi sẽ thử một ví dụ nhỏ bên dưới.) Số hoán vị tăng theo cấp số nhân, khiến chi phí tính toán trên CPU trở nên bất khả thi. Nhưng đó không còn là vấn đề lớn nếu bạn có mức tăng tốc 50 lần.
Những lợi ích này bổ trợ cho nhau. Nếu bạn thiết lập dự án tốt, bạn có thể có một mô hình chính xác hơn mà vẫn tạo ra nhanh hơn; hay như cách một kỹ sư máy học nghĩ, bạn có thể có kiến trúc mô hình tinh vi hơn mà không bị thời gian huấn luyện kéo dài quá mức.
NVIDIA nhấn mạnh rằng GPU sẽ cho ra kết quả tương đương về mặt số học. Điều đó đáng mừng vì nghĩa là lợi ích không đi kèm đánh đổi về độ chính xác của mô hình.
Nhưng điều này cũng khiến tôi nghĩ: Tại sao kết quả “tương đương về mặt số học” chứ không “giống hệt”? Có lẽ do xử lý song song dẫn đến vài khác biệt nhỏ ở đầu ra, hoặc có khác biệt về ổn định số của một phương pháp nào đó. Có thể với UMAP, phép chiếu UMAP hơi khác đi. Tôi nêu điều này phòng khi bạn thấy những sai khác tinh vi giữa lần chạy CPU và GPU. NVIDIA có vẻ cho rằng điều đó bình thường và nên kỳ vọng.
Nói thế, nếu bạn thật sự tự thử thách và chạy mô hình trên GPU vì mô hình đủ phức tạp khiến CPU không khả thi, thì việc so sánh đầu ra của mô hình đó với bản tương đương trên CPU sẽ trở nên khó khăn.
Tôi đã đề cập rằng bản phát hành cuML 25.02 nay hỗ trợ scikit-learn, UMAP và HDBSCAN. Nhưng nếu bạn quen scikit-learn, bạn biết có rất nhiều thuật toán trong đó. Hiện tại, RAPIDS AI hỗ trợ một số thư viện, nhưng không phải tất cả. Dưới đây là các điểm nhấn chính theo đội ngũ:
Trong danh sách này, tôi thấy phấn khích nhất với việc tăng tốc cho k-Nearest Neighbors, vốn nổi tiếng là rất tốn tài nguyên tính toán vì phải tính khoảng cách giữa mọi điểm dữ liệu.
Bảng sau cho thấy các estimator được chạy phần lớn hoặc hoàn toàn bằng cuML.
| Thuật toán | Thư viện / Tên hàm | Phân loại |
|---|---|---|
| UMAP | umap.UMAP |
Giảm chiều |
| PCA (Phân tích thành phần chính) | sklearn.decomposition.PCA |
Giảm chiều |
| SVD xén (Truncated SVD) | sklearn.decomposition.TruncatedSVD |
Giảm chiều |
| t-SNE | sklearn.manifold.TSNE |
Giảm chiều |
| HDBSCAN | hdbscan.HDBSCAN |
Phân cụm |
| K-Means | sklearn.cluster.KMeans |
Phân cụm |
| DBSCAN | sklearn.cluster.DBSCAN |
Phân cụm |
| Bộ phân loại Random Forest | sklearn.ensemble.RandomForestClassifier |
Phân loại |
| Hồi quy Logistic | sklearn.linear_model.LogisticRegression |
Phân loại |
| Bộ phân loại K-Nearest Neighbors | sklearn.neighbors.KNeighborsClassifier |
Phân loại |
| Bộ hồi quy Random Forest | sklearn.ensemble.RandomForestRegressor |
Hồi quy |
| Hồi quy tuyến tính | sklearn.linear_model.LinearRegression |
Hồi quy |
| Elastic Net | sklearn.linear_model.ElasticNet |
Hồi quy |
| Hồi quy Ridge | sklearn.linear_model.Ridge |
Hồi quy |
| Hồi quy Lasso | sklearn.linear_model.Lasso |
Hồi quy |
| Hồi quy Kernel Ridge | sklearn.kernel_ridge.KernelRidge |
Hồi quy |
| Bộ hồi quy K-Nearest Neighbors | sklearn.neighbors.KNeighborsRegressor |
Hồi quy |
| Tìm kiếm láng giềng gần nhất | sklearn.neighbors.NearestNeighbors |
Tìm kiếm láng giềng gần nhất |
Danh sách đầy đủ các phương pháp được hỗ trợ có trong tài liệu RAPIDS AI. Chúng tôi kỳ vọng sẽ sớm có thêm thuật toán mới. (Bạn cũng có thể phản hồi để giúp đội ngũ ưu tiên.) Một vài cái tôi nhận thấy còn thiếu: bộ hồi quy vector hỗ trợ (sklearn.svm.SVR), Theil-Sen Regressor (sklearn.linear_model.TheilSenRegressor), phân cụm mean shift (sklearn.cluster.MeanShift) và đa chiều hóa (multidimensional scaling) (sklearn.manifold.MDS).
Bạn có thể thắc mắc mọi thứ hoạt động thế nào. Nhìn từ góc độ tổng quát, ngày càng nhiều thư viện hiện đại được thiết kế để tự động phát hiện và dùng phần cứng tốt nhất sẵn có, dù là CPU hay GPU. Hiện nay, khi một hàm trong scikit-learn được gọi (khi cuml.accel được bật), phần mềm sẽ kiểm tra xem có GPU tương thích hay không và chuyển hướng thực thi sang phiên bản tăng tốc GPU nếu có.
RAPIDS AI mô tả cơ chế này giúp cuml.accel hoạt động như một lớp tương thích với sklearn. Ở đây, lớp tương thích của cuML cho phép mã scikit-learn chạy trên GPU NVIDIA mà không cần thay đổi. Nó được xây như một phần thay thế cắm-vào, đóng vai trò proxy, chặn các lời gọi hàm tới scikit-learn và chuyển tiếp chúng sang cuML.
Đội RAPIDS AI của NVIDIA chia sẻ một sơ đồ hữu ích mà tôi cũng đưa lại ở đây:
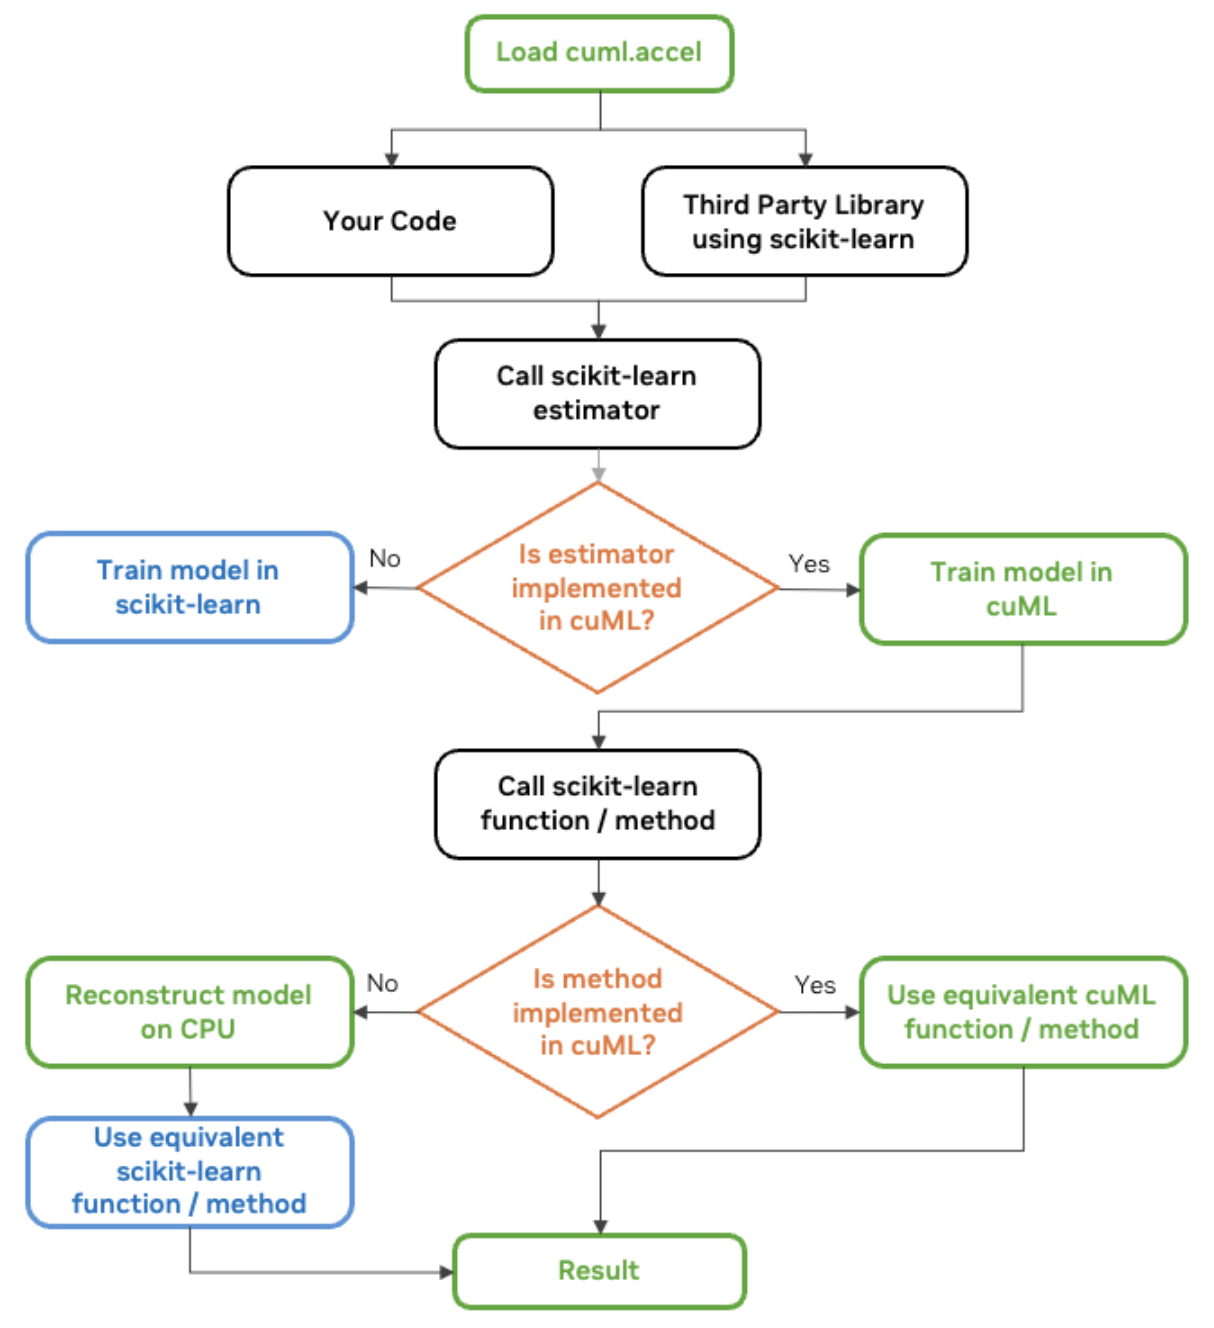
Sơ đồ quy trình cuML scikit-learn. Nguồn: NVIDIA
cuML đã được cài sẵn trên Google Colab, nhưng nếu bạn dùng Jupyter Notebook, hãy kích hoạt bằng lệnh này trước khi import scikit-learn:
%load_ext cuml.accel
import sklearn
Giờ đây, mã Python dùng sklearn của chúng ta sẽ trông quen thuộc — đó chính là mục tiêu. Đây là một ví dụ về hồi quy OLS.
# Import necessary libraries
from sklearn.datasets import make_regression
from sklearn.model_selection import train_test_split
from sklearn.linear_model import LinearRegression

# Generate synthetic regression data
X, y = make_regression(n_samples=500000, n_features=50, noise=0.1, random_state=0)

# Split into training and test sets
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=0)

# Create and train an OLS regression model
ols = LinearRegression()
ols.fit(X_train, y_train)
Nếu tôi muốn xem phần nào đã chạy trên GPU thay vì CPU, tôi có thể dùng logger.
%load_ext cuml.accel

from cuml.common import logger;
logger.set_level(logger.level_enum.debug)
cuML: Installed accelerator for sklearn.
cuML: Successfully initialized accelerator.
cuML: Performing fit in GPUBạn hiểu ý rồi. Giờ, hãy thử ví dụ thuyết phục hơn. Hồi quy tuyến tính vốn không đặc biệt song song hóa tốt vì giải phương trình chuẩn hoặc phân rã QR bao gồm một số bước tuần tự.
Một mở rộng phức tạp hơn của hồi quy OLS là hồi quy ridge. Khi dùng hồi quy ridge trong Python, gọi Ridge() sẽ áp dụng các siêu tham số mặc định, vốn có thể không tối ưu. Giá trị alpha kiểm soát mức độ regularization. Quá nhỏ thì mô hình overfit; quá lớn thì underfit.
%load_ext cuml.accel
import sklearn

from sklearn.linear_model import Ridge
from sklearn.datasets import make_regression
from sklearn.model_selection import train_test_split
from sklearn.metrics import mean_squared_error

# Generate synthetic data
X, y = make_regression(n_samples=100000, n_features=50, noise=0.1, random_state=0)

# Split into training and test sets
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=0)

# Train a Ridge Regression model with default settings
ridge_default = Ridge()
ridge_default.fit(X_train, y_train)

# Make predictions and evaluate
y_pred_default = ridge_default.predict(X_test)
mse_default = mean_squared_error(y_test, y_pred_default)
Đoạn mã trên huấn luyện một mô hình, dùng một giá trị alpha và solver duy nhất. (Theo tôi, mặc định là 'auto'.) Vậy nên, dù vẫn chạy được, nó không tối ưu hóa độ mạnh regularization hoặc lựa chọn solver.
Thay vì dựa vào mặc định, ta có thể thử cách khác. Ta có thể tạo một grid search kiểm thử nhiều tổ hợp siêu tham số và chọn tổ hợp tốt nhất.
from sklearn.model_selection import GridSearchCV

# Define Ridge Regression model
ridge = Ridge()

# Define a grid of hyperparameters to search
param_grid = {
    'alpha': [0.01, 0.1, 1.0, 10.0, 100.0],  # Different regularization strengths
    'solver': ['auto', 'svd', 'cholesky', 'lsqr', 'saga']  # Test multiple solvers
}

# Perform Grid Search with cross-validation
grid_search = GridSearchCV(ridge, param_grid, scoring='neg_mean_squared_error', cv=2, n_jobs=-1)
grid_search.fit(X_train, y_train)

# Get the best model from the search
best_ridge = grid_search.best_estimator_

# Make predictions and evaluate
y_pred_best = best_ridge.predict(X_test)
mse_best = mean_squared_error(y_test, y_pred_best)
Grid search ở đây kiểm thử mọi tổ hợp siêu tham số. Nếu ta định nghĩa 5 giá trị cho alpha ([0.01, 0.1, 1.0, 10.0, 100.0]), 5 tùy chọn solver (['auto', 'svd', 'cholesky', 'lsqr', 'saga']) và dùng cross-validation 2-fold, tổng số lần huấn luyện mô hình là 5x5x2, tức 50. Nghĩa là thay vì huấn luyện một mô hình, ta huấn luyện 50 mô hình. Điều này phức tạp hơn rất nhiều, đó là lý do GPU sẽ rất hữu dụng vì chúng nhanh hơn rất nhiều. Vì sklearn có mức tăng tốc (tối đa) 50 lần, huấn luyện 50 mô hình này có thể tốn thời gian tương đương huấn luyện chỉ một mô hình. (Tôi cố ý chọn các con số này để minh họa. Tôi hiểu rằng không phải mọi mô hình đều tăng tốc như nhau.)
NVIDIA so sánh hiệu năng các thuật toán scikit-learn chạy trên CPU Intel với GPU NVIDIA của chính họ. Họ khảo sát nhiều tác vụ máy học, bao gồm phân loại và hồi quy.
Kết luận là các mô hình đơn giản như random forest giảm thời gian huấn luyện từ phút trên CPU xuống còn giây trên GPU, và các mô hình phức tạp như phân cụm giảm từ giờ xuống phút. Quy trình làm việc nhanh hơn trong mọi trường hợp, nhưng với các mô hình nặng tính toán, dữ liệu nhiều chiều, lợi ích càng rõ rệt. Đây là nơi GPU tỏa sáng vì dùng xử lý song song, vốn được biết là tạo ra khác biệt lớn cho các mô hình cần nhiều phép toán ma trận, tính khoảng cách hoặc các tối ưu hóa thực hiện theo cách lặp.
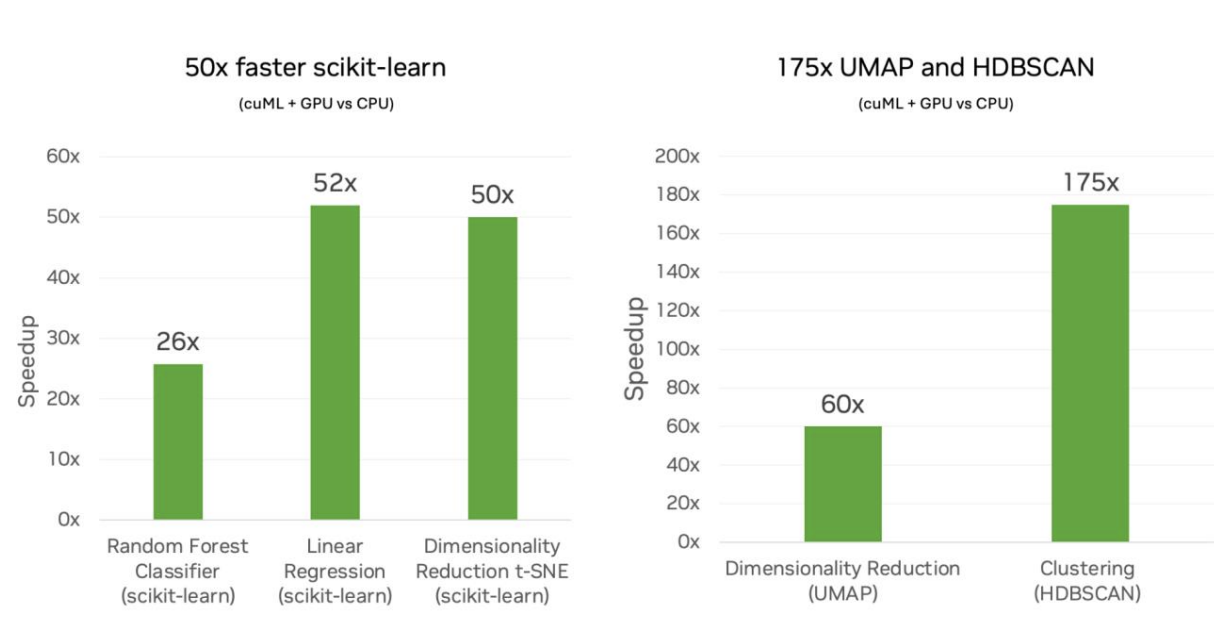
cuML scikit-learn trên GPU so với scikit-learn trên CPU. Nguồn: NVIDIA
Trước đó tôi đã tránh dùng hồi quy tuyến tính trong ví dụ mã vì muốn minh họa sức mạnh bằng thứ khác. Nhưng ở đây, tôi thấy tăng 52 lần cho hồi quy tuyến tính. Tôi thừa nhận khá bất ngờ vì hệ số đó lớn. Đây là lời nhắc rằng NVIDIA còn làm nhiều thứ tiên tiến khác, như đảm bảo các bước có thể xen kẽ để GPU không bị nhàn rỗi.
Nhờ cuML phiên bản 25.02, chạy thuật toán scitkit-learn với GPU giờ không quá khó. Bạn chỉ cần nạp phần mở rộng như tôi đã minh họa. Tuy nhiên, nếu bạn đi sâu hơn vào quy trình và muốn tận dụng tối đa tăng tốc GPU, bạn sẽ muốn cân nhắc những điều rất cụ thể.
NVIDIA khuyến nghị giảm thiểu việc truyền dữ liệu giữa CPU và GPU trong pipeline. Nói cách khác, hãy thực hiện các bước tiền xử lý, huấn luyện và suy luận trên GPU trước khi gửi kết quả về bộ nhớ máy chủ. Đừng “trộn” các bước bằng cách tiền xử lý trên CPU rồi suy luận trên GPU.
Ngoài ra, để tối đa hiệu quả, bạn nên cân nhắc CUDA-X, là bộ sưu tập các thư viện tăng tốc GPU do NVIDIA phát triển. Với random forest, bạn có thể dùng thư viện suy luận rừng của cuML chẳng hạn, thay vì của scikit-learn.
Những gì đội RAPIDS AI đang làm là phức tạp, nên sẽ có một số vấn đề. May mắn là tài liệu về các hạn chế đã biết được cập nhật tốt. Tôi không nhất thiết muốn liệt kê tất cả hay thậm chí một vài hạn chế ở đây vì nhiều vấn đề khá “kỹ thuật” theo từng thuật toán. Hơn nữa, các bản cập nhật, vá lỗi diễn ra nhanh. Thay vào đó, tôi sẽ đưa ra các nhóm vấn đề chung để cân nhắc.
Có một số ràng buộc áp dụng trên toàn bộ cuML, không chỉ cho thuật toán cụ thể. Ví dụ gồm hạn chế về định dạng dữ liệu đầu vào (một số vấn đề với list trong Python), tương thích phiên bản, và quản lý bộ nhớ.
Có những ràng buộc riêng cho từng thuật toán máy học. Khác biệt này có thể ảnh hưởng cách mô hình được huấn luyện, cách tham số hoạt động, hoặc cách kết quả được tính toán. Ví dụ, thuật toán random forest trong cuML dùng phương pháp khác để chọn ngưỡng chia, dẫn đến cấu trúc cây hơi khác.
Có khác biệt về tham số, solver và phương pháp khởi tạo được hỗ trợ. Ví dụ, PCA hỗ trợ solver SVD "full" và "auto", nhưng không hỗ trợ "randomized". Còn KNN hỗ trợ khoảng cách Minkowski, nhưng không hỗ trợ Mahalanobis.
Đôi khi kết quả có thể khác đôi chút do tính song song hoặc khác biệt về solver. Tôi đã đề cập điều này trước đó. Ví dụ, embedding UMAP có thể không đồng nhất, nhưng điểm trustworthiness vẫn cao. Trường hợp khác, dấu của các thành phần PCA có thể đảo, cần chuẩn hóa. Một lần nữa, đây là vấn đề cụ thể, và bạn nên tham khảo tài liệu mới nhất khi chạy thuật toán cụ thể.
Tôi rất hào hứng với viễn cảnh tăng tốc GPU cực dễ dùng cho các thuật toán nổi tiếng trong những thư viện máy học Python phổ biến. Điều này sẽ tạo khác biệt lớn về độ chính xác mô hình, đồng thời tiện lợi và không khó triển khai.
Cập nhật những điều mới nhất trong máy học. Hãy theo học lộ trình nghề nghiệp Nhà khoa học Máy học với Python để làm quen với các kỹ thuật cần thiết. Làm vậy để bạn tận dụng tối đa các tiến bộ mới nhất. Ngoài ra, hãy đăng ký podcast DataFramed của chúng tôi. Chúng tôi còn có một tập với Jean-Francois Puget, Distinguished Engineer tại NVIDIA & Chris Deotte, Senior Data Scientist tại NVIDIA, nơi họ bàn về, trong số những điều khác, tác động của tăng tốc GPU.
Học Python và scikit-Learn với DataCamp
Khóa học
Khóa học
Luyện tập và Lộ trình tiến trình của bạn.
Tiếp Tục Với Googleblog
Matt Crabtree
10 phút
