

Khóa học
Làm việc với Llama 3
2 giờ
15.8K
Luyện tập và Lộ trình tiến trình của bạn.
Tiếp Tục Với GoogleMeta vừa công bố bộ mô hình Llama 4, bao gồm hai mô hình đã phát hành—Llama 4 Scout và Llama 4 Maverick—và mô hình thứ ba vẫn đang được huấn luyện: Llama 4 Behemoth.
Hai biến thể Scout và Maverick hiện đã có sẵn, được phát hành công khai theo giấy phép open-weight điển hình của Meta—với một lưu ý đáng chú ý: nếu dịch vụ của bạn vượt quá 700 triệu người dùng hoạt động hàng tháng, bạn bắt buộc phải xin giấy phép riêng từ Meta, và họ có thể cấp hoặc không tùy theo quyết định của họ.
Llama Scout hỗ trợ cửa sổ ngữ cảnh 10 triệu token, lớn nhất trong số các mô hình công khai. Llama Maverick là mô hình tổng quát, nhắm đến GPT-4o, Gemini 2.0 Flash và DeepSeek-V3. Llama Behemoth, vẫn đang huấn luyện, đóng vai trò mô hình thầy có năng lực cao.
Trong bài blog giới thiệu này, tôi sẽ cung cấp cho bạn cái nhìn tổng quan về bộ Llama 4. Nhóm của chúng tôi đã thử nghiệm mô hình, và tôi khuyến nghị các hướng dẫn sau nếu bạn muốn tìm hiểu sâu hơn:
Cập nhật: Sau khoảng một năm yên ắng, Meta đã phát hành LLM mới nhất của mình. Để có cái nhìn tổng quan, hãy xem hướng dẫn về Muse Spark của chúng tôi.
Chúng tôi luôn cập nhật cho độc giả những tin mới nhất về AI bằng cách gửi The Median, bản tin Thứ Sáu miễn phí của chúng tôi tóm lược các câu chuyện chính trong tuần. Đăng ký và nắm bắt thông tin chỉ trong vài phút mỗi tuần:
Llama 4 là dòng mô hình ngôn ngữ lớn mới của Meta. Bản phát hành gồm hai mô hình đã sẵn có—Llama 4 Scout và Llama 4 Maverick—cùng mô hình thứ ba, Llama 4 Behemoth, vẫn đang huấn luyện.
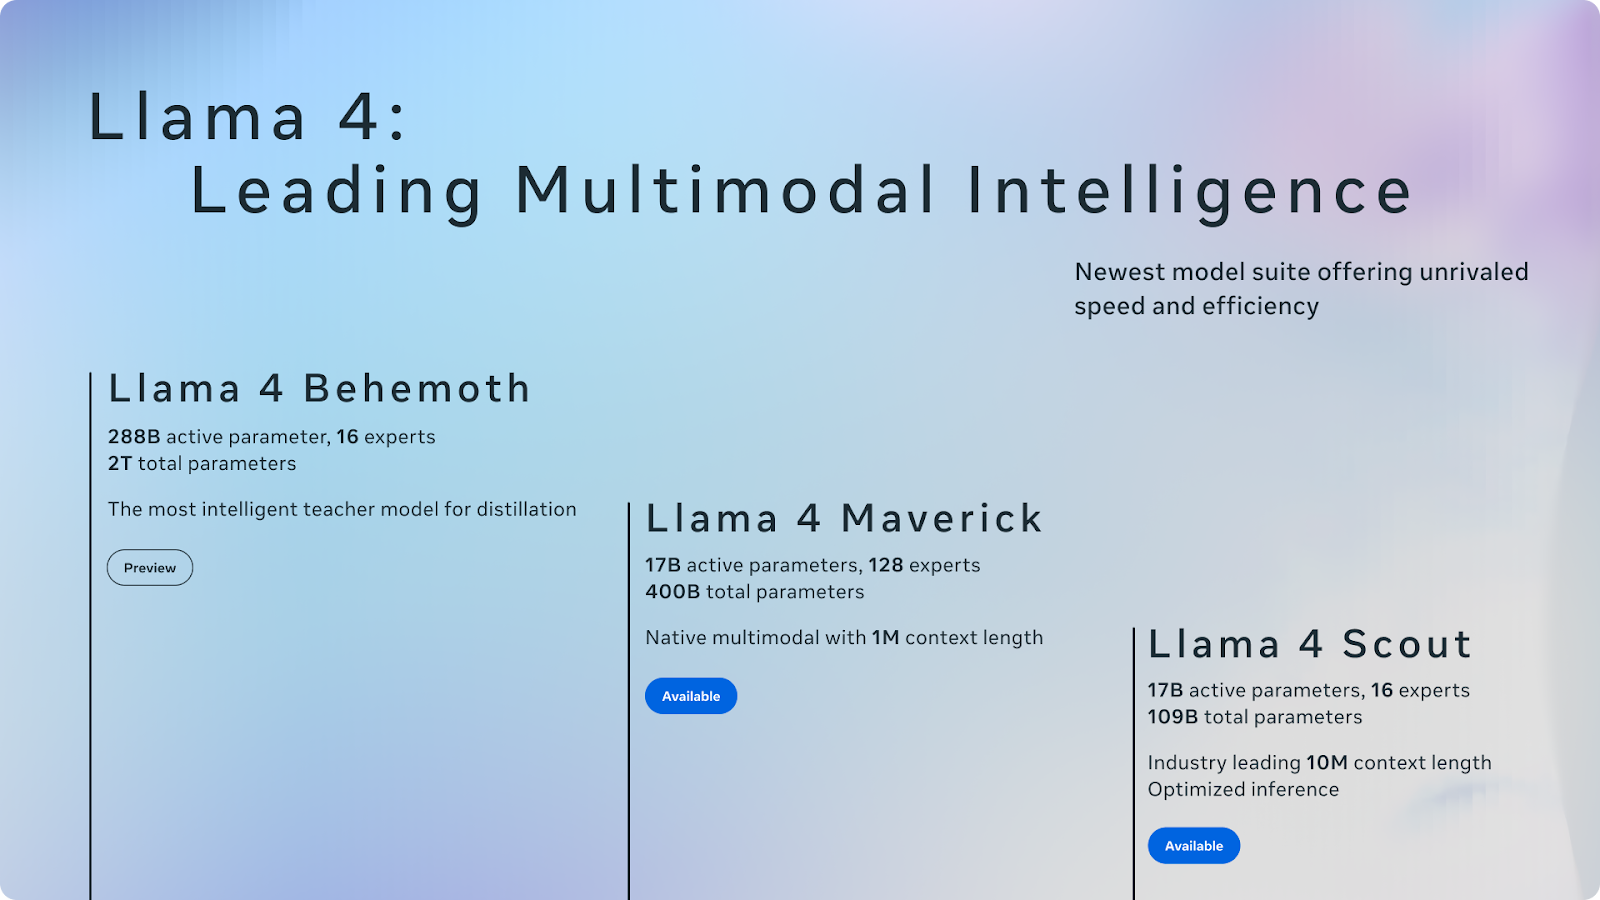
Nguồn: Meta AI
Llama 4 mang đến nhiều cải tiến đáng kể. Đáng chú ý, nó tích hợp kiến trúc mixture-of-experts (MoE) nhằm cải thiện hiệu quả và hiệu năng bằng cách chỉ kích hoạt các thành phần cần thiết cho từng tác vụ cụ thể (chút nữa sẽ nói kỹ hơn). Thiết kế này thể hiện bước chuyển hướng tới các mô hình AI có khả năng mở rộng và chuyên biệt hơn.
Llama 4 tiếp tục chiến lược phát hành mô hình open-weight của Meta—nhưng có điều kiện. Nếu công ty bạn vận hành dịch vụ có hơn 700 triệu người dùng hoạt động hàng tháng, bạn sẽ cần giấy phép riêng từ Meta, và có thể được cấp hoặc không. Bỏ qua giới hạn đó, bản phát hành vẫn là một sự kiện lớn trong lĩnh vực open-weight, dù chính lĩnh vực này đã thay đổi nhanh chóng vài tháng qua.
Nếu Llama 2 và 3 từng định hình phân khúc này, thì Llama 4 nay bước vào một sân chơi cạnh tranh hơn hẳn. DeepSeek đã xuất hiện với năng lực lập luận mạnh. Dòng Qwen của Alibaba thể hiện tốt trên các chuẩn đa ngôn ngữ và lập trình. Các mô hình Gemma của Google đang lấn sân với kiến trúc nhỏ gọn, hiệu quả. Và chỉ vài ngày trước, OpenAI công bố kế hoạch phát hành mô hình open-weight, một thay đổi có lẽ khó tưởng tượng cách đây một năm.
Hãy tìm hiểu chi tiết từng mô hình.
Llama 4 Scout là mô hình nhẹ hơn trong bộ mới, nhưng có lẽ lại thú vị nhất. Nó chạy trên một GPU H100 và hỗ trợ cửa sổ ngữ cảnh 10 triệu token. Điều này giúp Scout trở thành mô hình open-weight có khả năng “ăn” ngữ cảnh nhiều nhất đến nay và tiềm năng hữu ích cho các tác vụ như tóm tắt đa tài liệu, lập luận trên mã nguồn dài, và phân tích hoạt động.
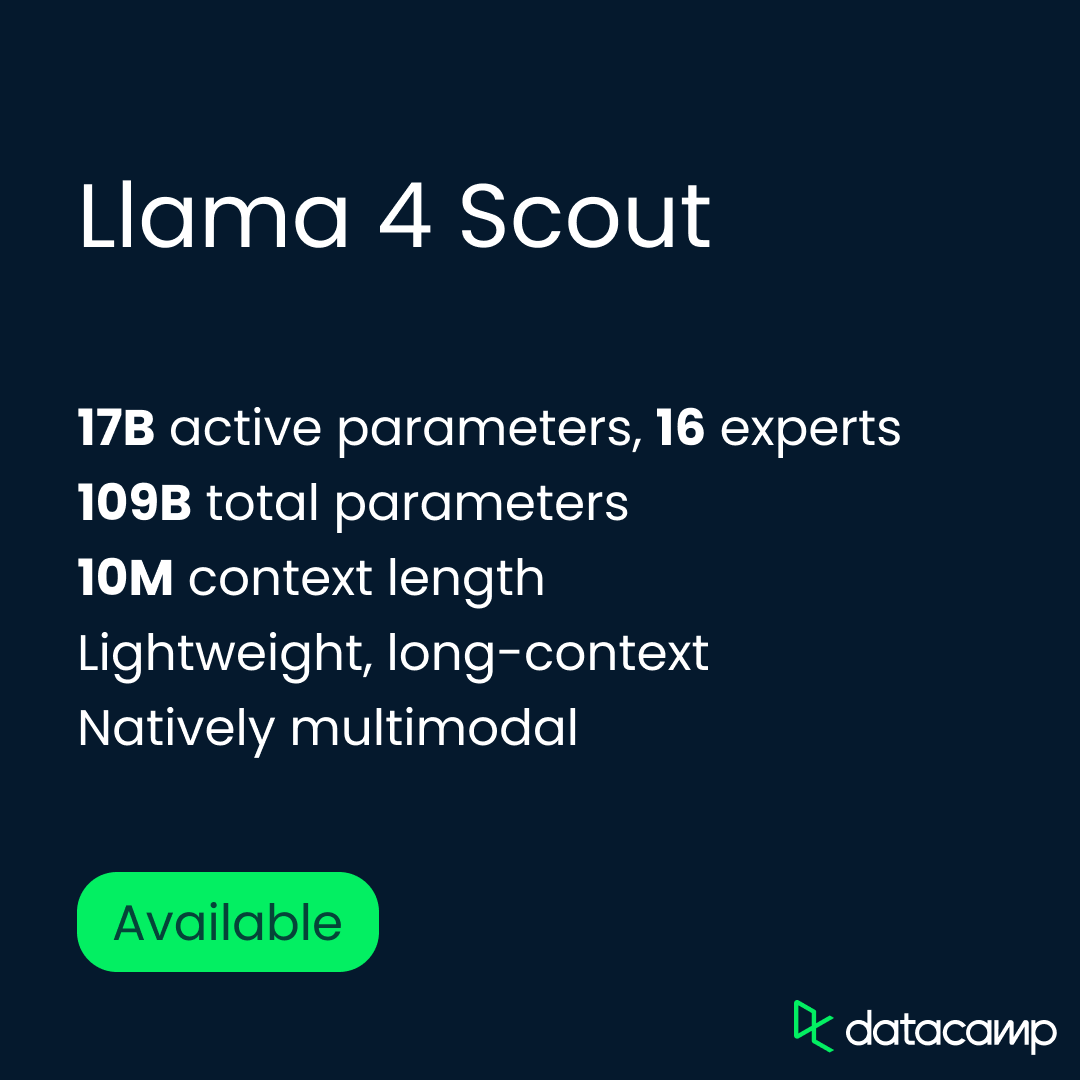
Scout có 17 tỷ tham số hoạt động, được tổ chức qua 16 chuyên gia, với tổng số tham số là 109 tỷ. Nó được tiền huấn luyện và hậu huấn luyện với cửa sổ ngữ cảnh 256K, nhưng Meta cho biết nó khái quát tốt vượt xa con số đó (tuyên bố này còn cần kiểm chứng). Trên thực tế, điều đó mở ra các quy trình xử lý trọn vẹn cả codebase, lịch sử phiên làm việc, hoặc tài liệu pháp lý—tất cả trong một lượt suy luận duy nhất.
Về kiến trúc, Scout được xây dựng dựa trên khung mixture-of-experts (MoE) của Meta, trong đó chỉ một phần tham số được kích hoạt cho mỗi token—khác với mô hình dày đặc như GPT-4o, nơi toàn bộ tham số đều được kích hoạt. Điều đó có nghĩa là vừa tiết kiệm tính toán, vừa khả năng mở rộng cao.
Ngoài kiến trúc lõi, Meta nhấn mạnh khả năng đa phương thức của Scout. Nó được tiền huấn luyện trên dữ liệu văn bản, hình ảnh và video với kỹ thuật hợp nhất sớm (early fusion), cho phép xử lý tự nhiên các kết hợp giữa văn bản và gợi ý trực quan. Ở các tác vụ nặng hình ảnh như định vị trực quan và VQA (trả lời câu hỏi dựa trên hình ảnh), Scout hoạt động tốt hơn mọi mô hình Llama trước đây—và đủ sức cạnh tranh với các hệ thống lớn hơn nhiều.
Tóm lại, Scout được xây để bao quát và mở rộng. Nó được thiết kế chạy hiệu quả, xử lý nhiều đầu vào hơn bất kỳ mô hình mở nào trước đó, và vận hành tốt trên cả tác vụ văn bản lẫn hình ảnh. Chúng tôi sẽ sớm kiểm thử giới hạn ngữ cảnh 10M đó—và sẽ báo lại.
Llama 4 Maverick là “tổng quát gia” trong danh mục—một mô hình đa phương thức, quy mô đầy đủ, được xây để đạt hiệu năng trên trò chuyện, lập luận, hiểu hình ảnh và mã. Trong khi Scout đẩy giới hạn độ dài ngữ cảnh, Maverick tập trung vào đầu ra cân bằng, chất lượng cao trên nhiều tác vụ. Đây là câu trả lời của Meta cho GPT-4o, DeepSeek-V3 và Gemini 2.0 Flash.
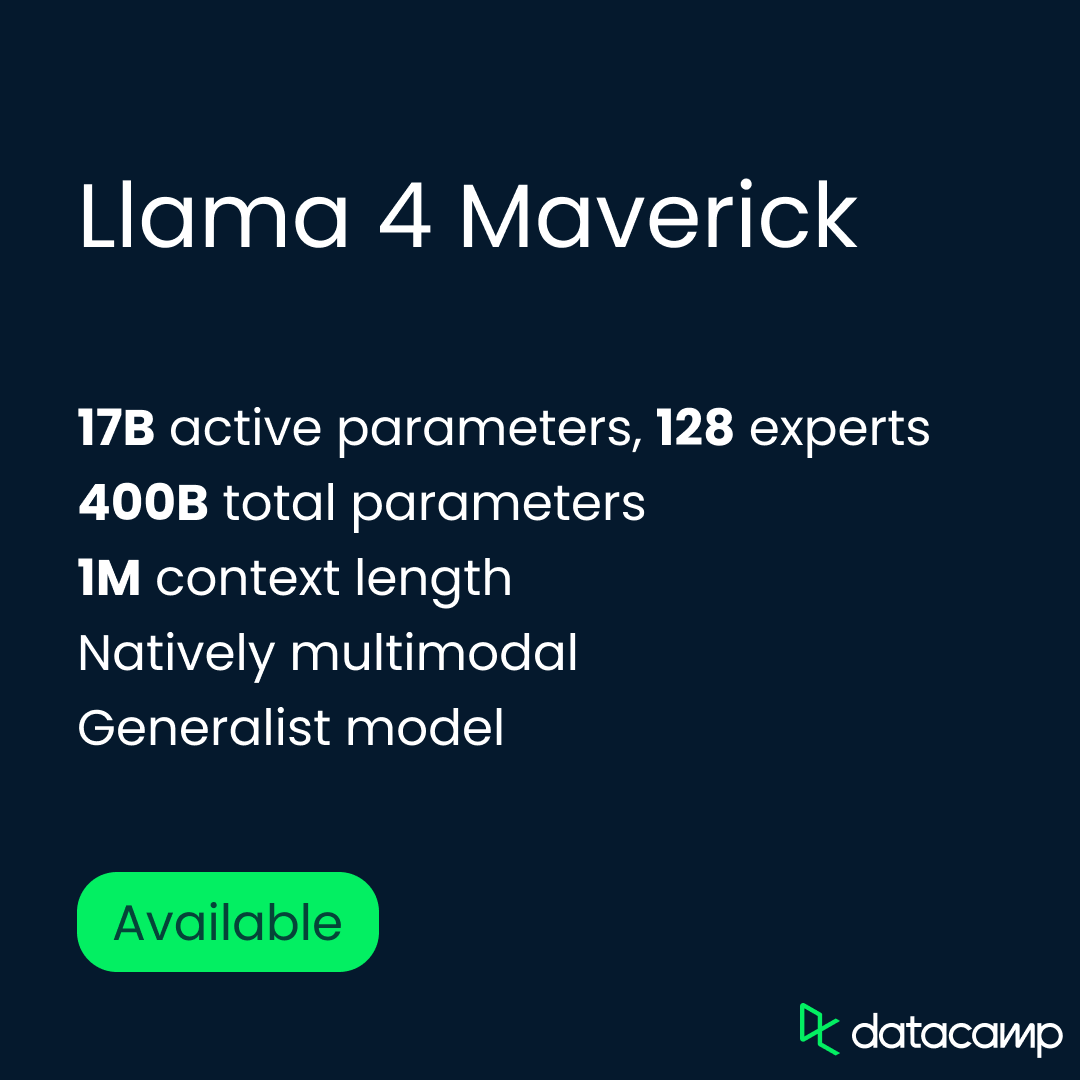
Maverick có cùng 17 tỷ tham số hoạt động như Scout, nhưng cấu hình MoE lớn hơn: 128 chuyên gia và tổng số tham số 400 tỷ. Giống Scout, nó dùng kiến trúc mixture-of-experts, chỉ kích hoạt một phần mô hình trên mỗi token—giảm chi phí suy luận đồng thời tăng khả năng mở rộng. Mô hình chạy trên một máy chủ H100 DGX, nhưng cũng có thể triển khai suy luận phân tán cho các ứng dụng quy mô lớn hơn.
Meta áp dụng cách tiếp cận hậu huấn luyện khác ở đây, kết hợp tinh chỉnh có giám sát nhẹ, học tăng cường trực tuyến và tối ưu hóa theo sở thích trực tiếp. Mục tiêu là mài sắc hiệu năng trên các prompt khó mà không ràng buộc mô hình quá mức. Theo đó, Meta loại bỏ hơn 50% ví dụ huấn luyện được các mô hình Llama trước đánh dấu là “dễ” và xây dựng chương trình học nhấn mạnh các tác vụ lập luận, lập trình và đa phương thức khó hơn.
Maverick cũng được đồng chưng cất (co-distilled) từ Llama 4 Behemoth, mô hình nội bộ lớn hơn nhiều của Meta, giúp tăng hiệu năng mà không tăng chi phí huấn luyện. Theo Meta, quy trình chưng cất này mang lại bước nhảy rõ rệt về chất lượng lập luận và trò chuyện.
Llama 4 Behemoth là mô hình mạnh mẽ và lớn nhất của Meta cho đến nay—nhưng chưa có sẵn. Vẫn đang huấn luyện, Behemoth không phải là mô hình lập luận theo cùng nghĩa với DeepSeek-R1 hay o3 của OpenAI, vốn được xây và tối ưu cho các tác vụ chuỗi tư duy nhiều bước.
Dựa trên những gì đã biết, nó cũng có vẻ không được thiết kế như một sản phẩm sử dụng trực tiếp. Thay vào đó, nó đóng vai trò mô hình thầy, dùng để chưng cất và định hình cả Scout lẫn Maverick. Khi được phát hành, nó cũng có thể cho phép người khác chưng cất các mô hình riêng của họ.
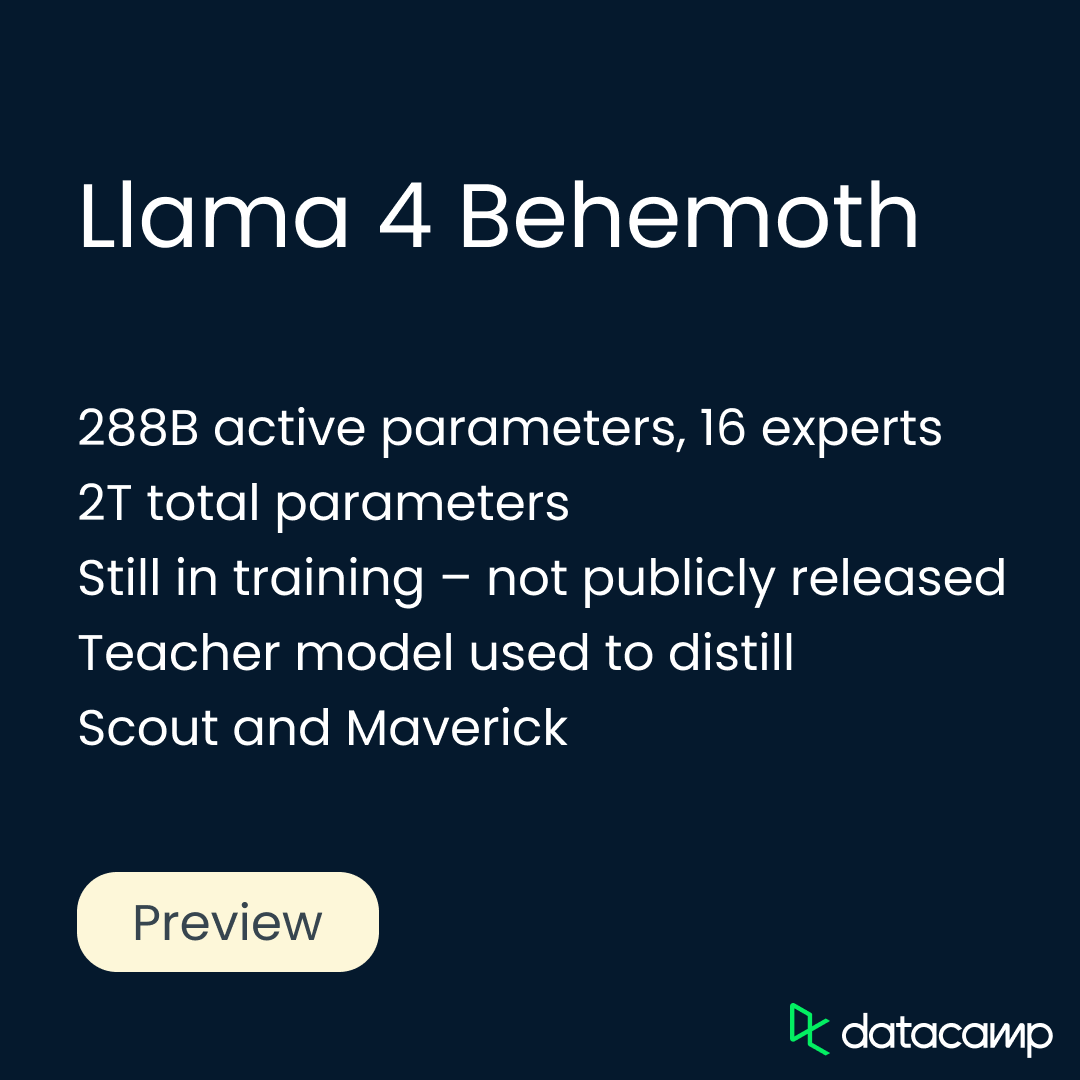
Behemoth có 288 tỷ tham số hoạt động, tổ chức qua 16 chuyên gia, với tổng số tham số gần 2 nghìn tỷ. Meta xây dựng hạ tầng huấn luyện hoàn toàn mới để hỗ trợ Behemoth ở quy mô này. Họ giới thiệu học tăng cường không đồng bộ, lấy mẫu theo chương trình dựa trên độ khó của prompt và hàm mất mát chưng cất mới cân bằng động mục tiêu mềm và cứng.
Hậu huấn luyện Behemoth cũng cần công thức khác. Meta loại bỏ hơn 95% ví dụ SFT để tập trung vào các prompt khó và dồn học tăng cường vào lập luận phức tạp, lập trình và kịch bản đa ngôn ngữ. Lấy mẫu từ nhiều chỉ dẫn hệ thống khác nhau giúp mô hình khái quát tốt, trong khi lọc động loại bỏ prompt giá trị thấp trong quá trình RL.
Meta công bố kết quả điểm chuẩn nội bộ cho từng mô hình Llama 4, so sánh với các biến thể Llama trước và một số mô hình open-weight cũng như mô hình tiên phong khác.
Trong phần này, tôi sẽ điểm qua các điểm nổi bật về điểm chuẩn cho Scout, Maverick và Behemoth, dựa trên số liệu của chính Meta. Như mọi khi, tôi khuyến nghị thận trọng với các điểm chuẩn tự báo cáo—nhưng các điểm số này vẫn cho cái nhìn ban đầu hữu ích về hiệu suất của mỗi mô hình trên các tác vụ khác nhau và vị thế của chúng trong bối cảnh hiện tại. Bắt đầu với Scout.
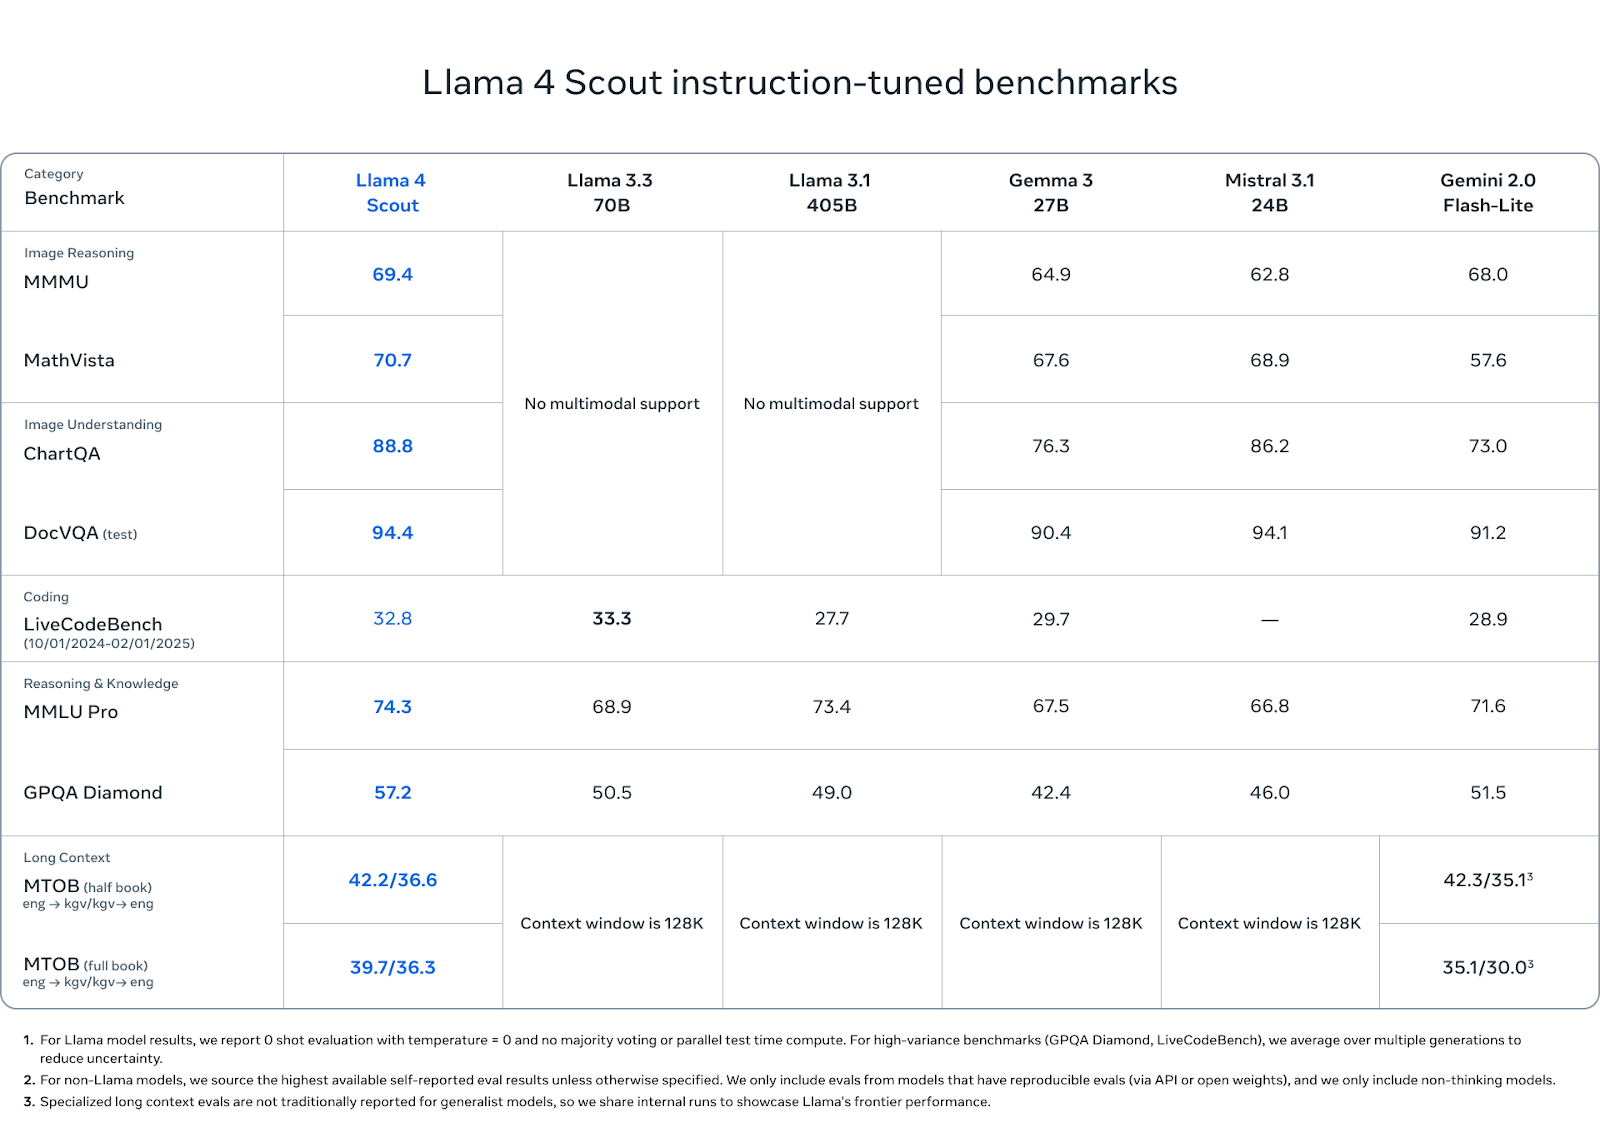
Llama 4 Scout thể hiện tốt trên tập hợp các điểm chuẩn về lập luận, lập trình và đa phương thức—đặc biệt nếu xét đến số tham số hoạt động nhỏ hơn và “dấu chân” một GPU của nó.
Nguồn: MetaAI
Về hiểu hình ảnh, Scout nhỉnh hơn đối thủ: đạt 88,8 trên ChartQA và 94,4 trên DocVQA (test), vượt Gemini 2.0 Flash-Lite (lần lượt 73,0 và 91,2) và ngang bằng hoặc nhỉnh hơn một chút so với Mistral 3.1 và Gemma 3 27B.
Ở các điểm chuẩn lập luận hình ảnh như MMMU (69,4) và MathVista (70,7), nó cũng dẫn đầu nhóm open-weight, vượt Gemma 3 (64,9; 67,6), Mistral 3.1 (62,8; 68,9) và Gemini Flash-Lite (68,0; 57,6).
Trong lập trình, Scout đạt 32,8 trên LiveCodeBench, vượt Gemini Flash-Lite (28,9) và Gemma 3 27B (29,7), dù hơi kém hơn mức 33,3 của Llama 3.3. Nó không phải mô hình thiên về mã, nhưng vẫn đủ sức cạnh tranh.
Về kiến thức và lập luận, Scout đạt 74,3 trên MMLU Pro và 57,2 trên GPQA Diamond, vượt mọi mô hình open-weight khác ở cả hai. Các điểm chuẩn này thiên về lập luận đa bước dạng dài, nên hiệu suất mạnh của Scout ở đây đáng chú ý, nhất là ở quy mô này.
Cuối cùng, khả năng ngữ cảnh dài của Scout thể hiện tiềm năng thực tế. Trên MTOB (Massive Textual Overlap Benchmark), kiểm tra khả năng dịch giữa tiếng Anh và KGV, một ngôn ngữ ít tài nguyên, nó đạt 42,2/36,6 ở bài kiểm tra nửa cuốn sách và 39,7/36,3 ở bài kiểm tra cả cuốn. Ở bài nửa cuốn, Gemini 2.0 Flash-Lite nhỉnh nhẹ với 42,3, nhưng Scout rút ngắn khoảng cách ở bài cả cuốn, vượt mức 35,1/30,0 của Gemini.
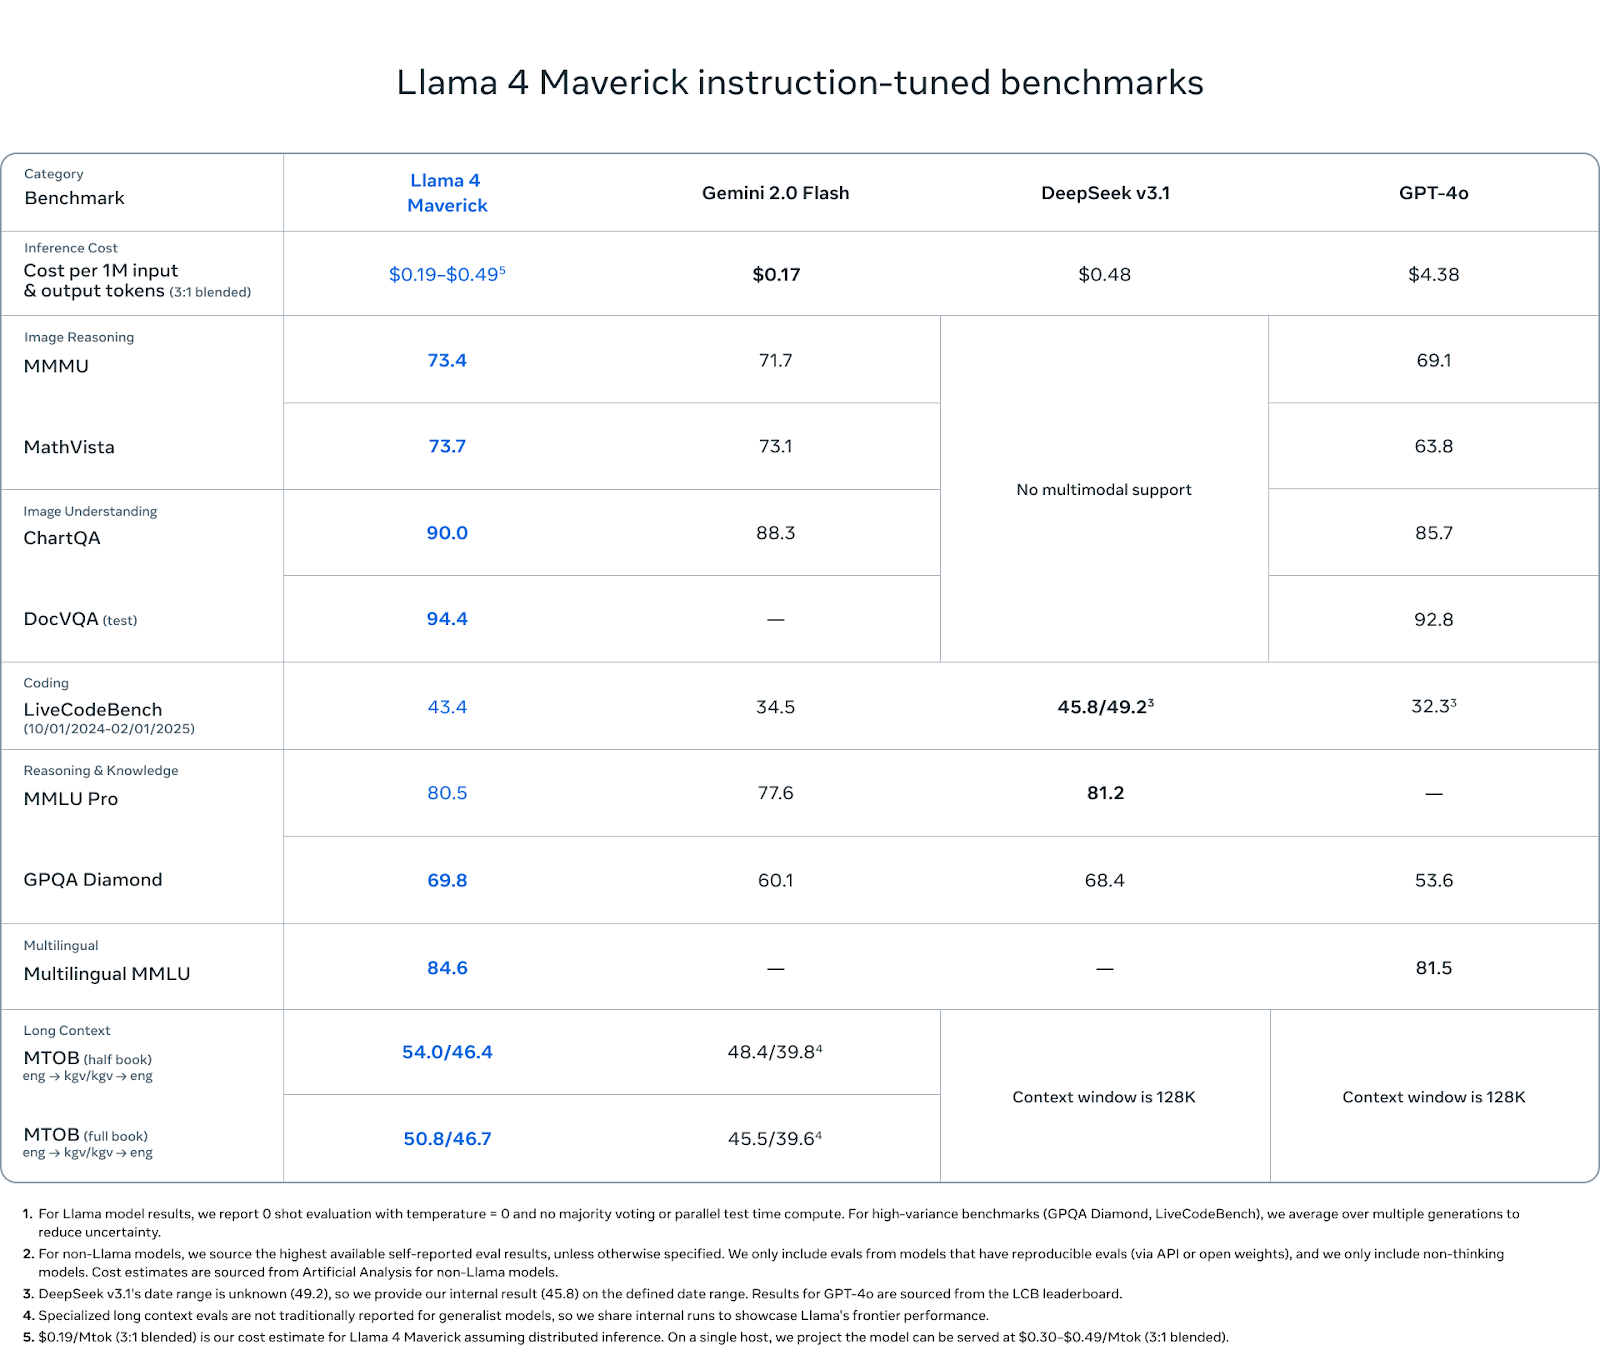
Maverick là mô hình toàn diện nhất trong dòng Llama 4—và kết quả điểm chuẩn phản ánh điều đó. Dù không nhắm tới độ dài ngữ cảnh cực đại như Scout hay quy mô thô như Behemoth, nó vẫn thể hiện ổn định ở mọi hạng mục quan trọng: lập luận đa phương thức, lập trình, hiểu ngôn ngữ và ghi nhớ ngữ cảnh dài.
Nguồn: MetaAI
Ở lập luận hình ảnh, Maverick đạt 73,4 trên MMMU và 73,7 trên MathVista, vượt Gemini 2.0 Flash (71,7 và 73,1) và GPT-4o (69,1 và 63,8). Trên ChartQA (hiểu hình ảnh), nó đạt 90,0, nhỉnh hơn chút so với 88,3 của Gemini và cao hơn hẳn mức 85,7 của GPT-4o. Ở DocVQA, Maverick đạt 94,4, ngang Scout và vượt 92,8 của GPT-4o.
Trong lập trình, Maverick đạt 43,4 trên LiveCodeBench, cao hơn GPT-4o (32,3), Gemini Flash (34,5) và tiệm cận mức 45,8 của DeepSeek v3.1.
Về lập luận và kiến thức, Maverick đạt 80,5 trên MMLU Pro và 69,8 trên GPQA Diamond, tiếp tục vượt Gemini Flash (77,6 và 60,1) và GPT-4o (không có MMLU Pro được báo cáo, 53,6 trên GPQA). DeepSeek v3.1 dẫn trước 0,7 điểm trên MMLU Pro.
Maverick cũng thể hiện tốt ở hiểu đa ngôn ngữ, đạt 84,6 trên Multilingual MMLU, nhỉnh hơn đôi chút so với 81,5 của Gemini. Điều này mang lại lợi thế cho nhà phát triển làm việc trên nhiều ngôn ngữ hoặc khu vực địa lý.
Trong các đánh giá ngữ cảnh dài (MTOB), Maverick đạt 54,0/46,4 ở bài nửa cuốn và 50,8/46,7 ở bài cả cuốn—vượt đáng kể so với 48,4/39,8 và 45,5/39,6 của Gemini. Những điểm số này cho thấy dù Maverick không “đánh tiếng” rầm rộ về độ dài ngữ cảnh như Scout, nó vẫn hưởng lợi rõ rệt từ cửa sổ mở rộng.
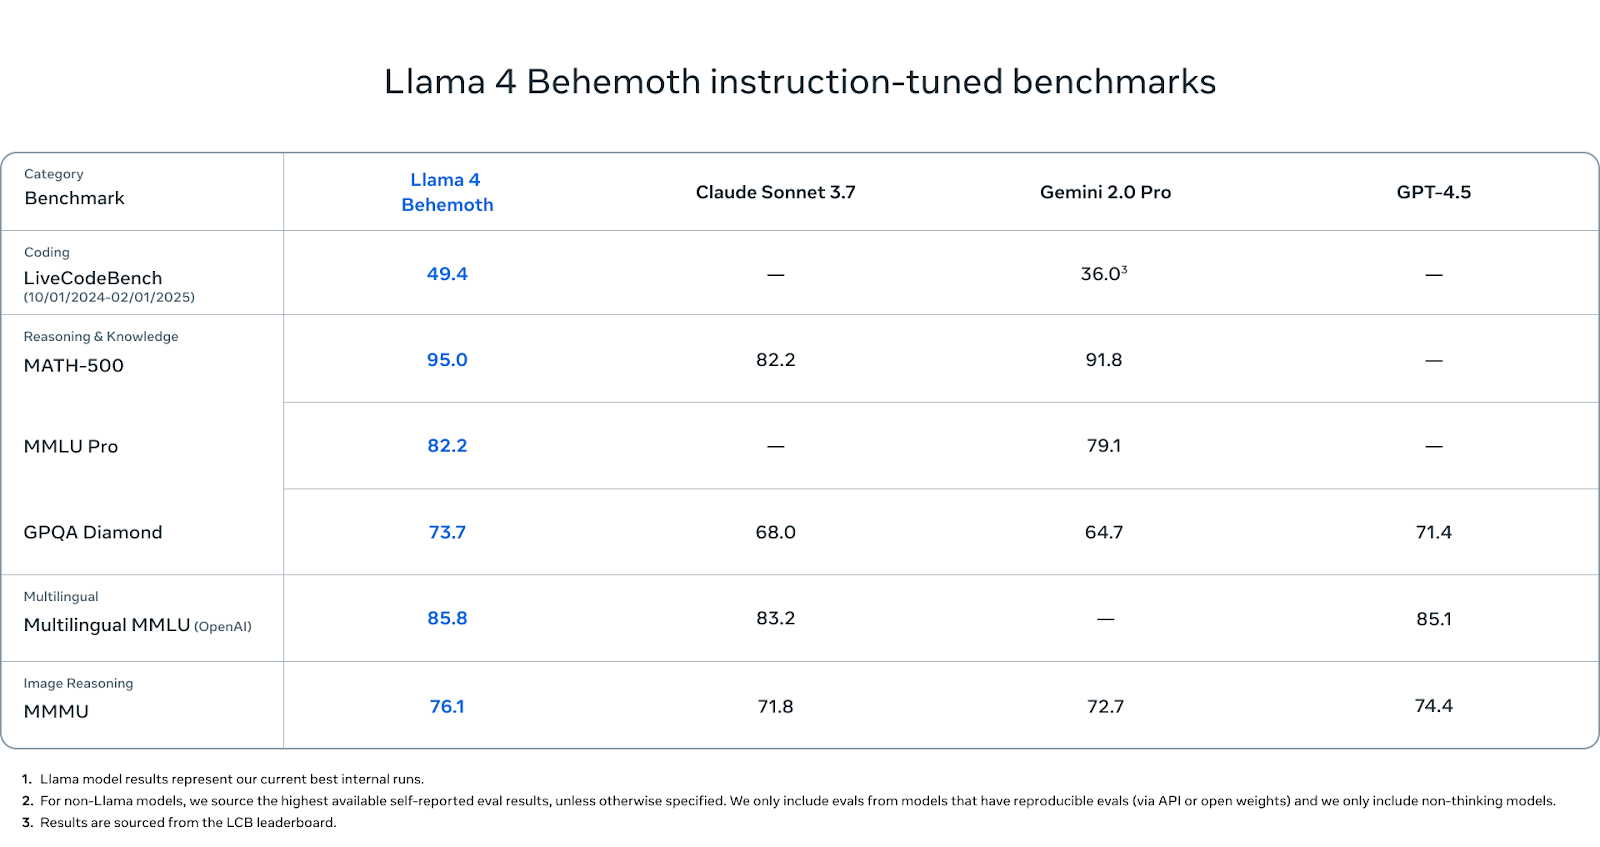
Behemoth chưa phát hành, nhưng các con số điểm chuẩn của nó rất đáng chú ý.
Nguồn: MetaAI
Trên các điểm chuẩn nặng STEM, Behemoth thể hiện xuất sắc. Nó đạt 95,0 trên MATH-500—cao hơn Gemini 2.0 Pro (91,8) và vượt xa Claude Sonnet 3.7 (82,2). Trên MMLU Pro, Behemoth đạt 82,2, trong khi Gemini Pro ở mức 79,1 (Claude không có điểm được báo cáo). Còn trên GPQA Diamond, một điểm chuẩn đánh giá độ sâu và độ chính xác tri thức, Behemoth đạt 73,7, vượt Claude (68,0), Gemini (64,7) và GPT-4.5 (71,4).
Trong hiểu đa ngôn ngữ, Behemoth đạt 85,8 trên Multilingual MMLU, nhỉnh hơn Claude Sonnet (83,2) và GPT-4.5 (85,1). Những điểm số này quan trọng với các nhà phát triển toàn cầu làm việc ngoài tiếng Anh, và hiện Behemoth đang dẫn đầu hạng mục này.
Về lập luận hình ảnh, Behemoth đạt 76,1 trên MMMU, vượt Gemini (71,8), Claude (72,7) và GPT-4.5 (74,4). Dù không phải trọng tâm chính, nó vẫn cạnh tranh với các mô hình đa phương thức hàng đầu.
Trong sinh mã, Behemoth đạt 49,4 trên LiveCodeBench. Con số này cao hơn nhiều so với Gemini 2.0 Pro (36,0).
Cả Llama 4 Scout và Llama 4 Maverick hiện đều có sẵn theo giấy phép open-weight của Meta. Bạn có thể tải trực tiếp từ trang Llama chính thức hoặc qua Hugging Face.
Để truy cập mô hình qua chính dịch vụ của Meta, bạn có thể tương tác với Meta AI trên nhiều nền tảng: WhatsApp, Messenger, Instagram và Facebook. Hiện việc truy cập yêu cầu đăng nhập bằng tài khoản Meta, và chưa có endpoint API độc lập cho Meta AI—ít nhất là chưa.
Nếu bạn dự định tích hợp mô hình vào ứng dụng hay hạ tầng của riêng mình, lưu ý điều khoản cấp phép: nếu sản phẩm hoặc dịch vụ của bạn có hơn 700 triệu người dùng hoạt động hàng tháng, bạn sẽ cần xin phép riêng từ Meta. Ngoài ra, các mô hình có thể sử dụng cho nghiên cứu, thử nghiệm và hầu hết các mục đích thương mại.
Scout giới thiệu độ dài ngữ cảnh chưa từng có trên một GPU. Maverick đủ sức đối đầu với các mô hình lớn hơn ở lập luận, mã và tác vụ đa phương thức. Và Behemoth, vẫn đang huấn luyện, cho thấy cách các mô hình thầy có thể định hình những biến thể hiệu quả và dễ triển khai hơn.
Không gian open-weight cạnh tranh hơn bao giờ hết. DeepSeek, Qwen, Gemma, và sắp tới là OpenAI đều đang thúc đẩy bằng các bản phát hành mạnh mẽ. Llama 4 xuất hiện như sự tiếp nối nỗ lực của Meta nhằm cung cấp các mô hình có khả năng mở rộng, sẵn có một cách cởi mở cho nhiều trường hợp sử dụng.
Học AI với những khóa học này!
Khóa học
Khóa học
Luyện tập và Lộ trình tiến trình của bạn.
Tiếp Tục Với Googleblog
Matt Crabtree
10 phút
