
Khóa học
Phát triển ứng dụng LLM với LangChain
3 giờ
51.9K
Đây là thời điểm đầy hứng khởi trong thế giới AI. Các công ty lớn như Google, Meta và Twitter đang tập trung mạnh vào việc mở mã nguồn cho các mô hình ngôn ngữ lớn (LLM). Gần đây, đội ngũ Google DeepMind đã ra mắt Gemma - một họ mô hình LLM gọn nhẹ và mã nguồn mở được xây dựng từ cùng nền tảng nghiên cứu và công nghệ dùng để tạo ra các mẫu Gemini của Google.
Hình ảnh Nguồn
Tại đây, chúng ta sẽ tìm hiểu về các mẫu Gemma, cách truy cập chúng bằng GPU và TPU trên đám mây, và cách huấn luyện mẫu Gemma 7b-it mới nhất trên một tập dữ liệu nhập vai.
Gemma (tiếng Latinh nghĩa là “đá quý”) là một họ mô hình văn bản-đến-văn bản, chỉ-decoder, mã nguồn mở do nhiều nhóm tại Google phát triển, đặc biệt là Google DeepMind. Lấy cảm hứng từ các mẫu Gemini, Gemma được thiết kế gọn nhẹ và tương thích với mọi framework phổ biến.
Google đã phát hành trọng số mô hình cho hai kích thước Gemma, cụ thể là Gemma 2B và Gemma 7B, với các biến thể tiền huấn luyện và tinh chỉnh theo hướng dẫn như Gemma 2B-it và Gemma 7B-it.
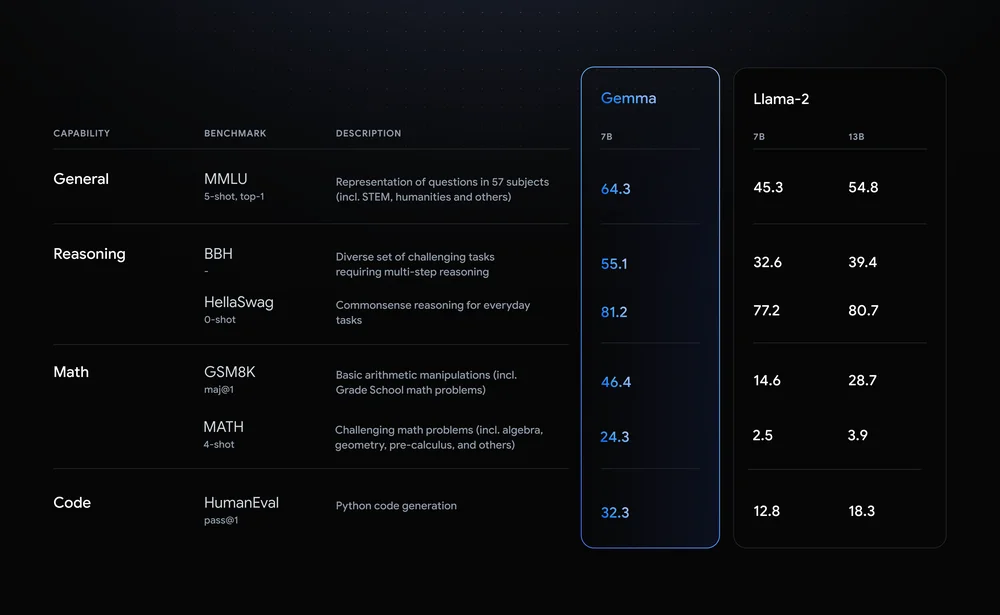
Như chúng ta biết, Gemma chia sẻ các thành phần kỹ thuật tương tự với Gemini, đạt hiệu năng hàng đầu trong phân khúc kích thước của mình so với các mô hình mở khác như Llama-2 của Meta. Nó đã vượt Llama-2 trên mọi bộ đo chuẩn LLM.
Hình ảnh Nguồn
Gemma hỗ trợ đa dạng công cụ và hệ thống, bao gồm các công cụ đa framework như Keras 3.0, PyTorch gốc, JAX, và Transformers của Hugging Face. Nó cũng chạy trên nhiều loại thiết bị phổ biến, gồm laptop, máy bàn, IoT, thiết bị di động và đám mây.
Giờ đây bạn có thể chạy suy luận và tinh chỉnh có giám sát (SFT) trên Cloud TPU miễn phí bằng framework học máy yêu thích như Keras 3.0.
Google cũng giới thiệu Bộ công cụ AI tạo sinh có trách nhiệm cùng với Gemma để cung cấp hướng dẫn, công cụ thiết yếu và phương pháp phân loại an toàn giúp nhà phát triển tạo ứng dụng AI an toàn hơn.
Nếu bạn mới làm quen với AI và LLM, khuyến nghị bạn theo học lộ trình kỹ năng AI Fundamentals. Lộ trình này sẽ trang bị kiến thức thực tiễn về các chủ đề AI phổ biến như ChatGPT, mô hình ngôn ngữ lớn, AI tạo sinh và hơn thế nữa.
Truy cập Gemma rất đơn giản; bạn có thể bắt đầu sử dụng miễn phí trên HuggingChat và Poe. Bạn thậm chí có thể dùng cục bộ bằng cách tải trọng số mô hình từ Hugging Face và sử dụng GPT4ALL hoặc LMStudio.
Trong phần này, chúng ta sẽ học cách nạp mô hình Gemma và chạy suy luận bằng GPU và TPU miễn phí do nền tảng Kaggle cung cấp.
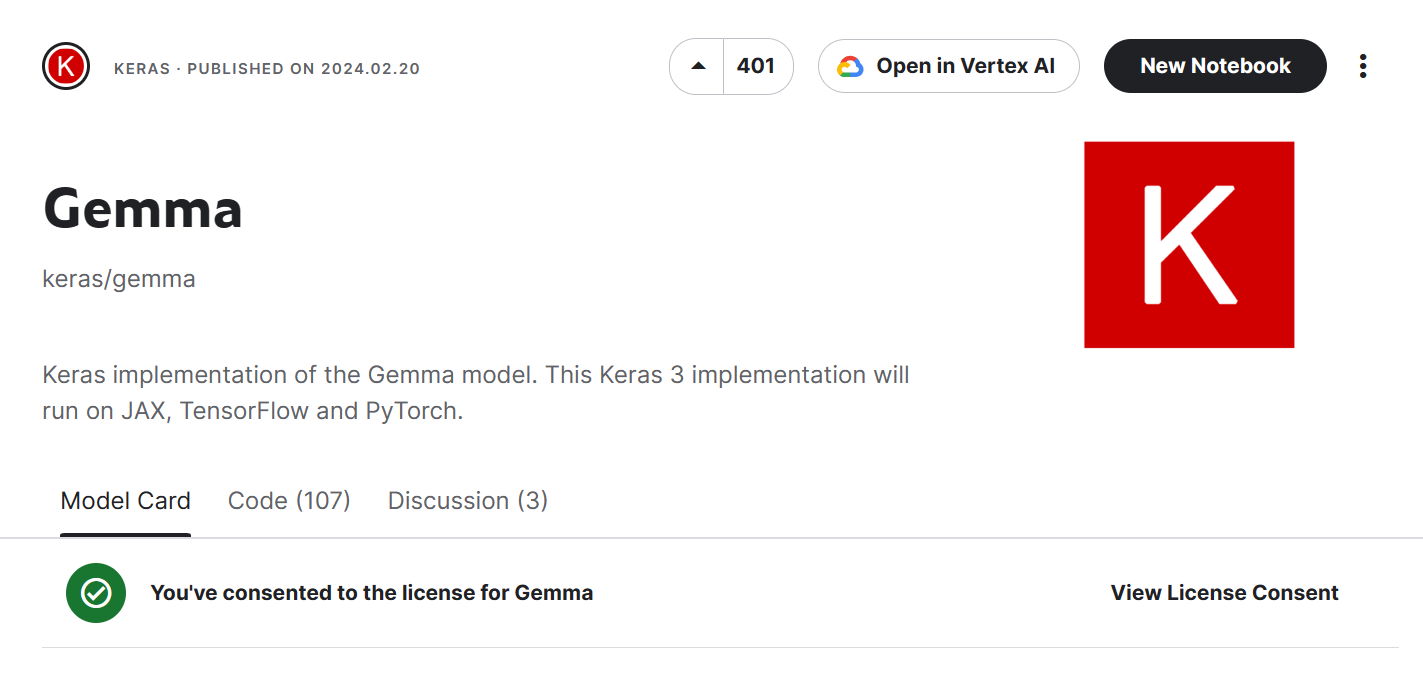
Bạn có thể truy cập Keras/Gemma, cuộn xuống, chọn biến thể mô hình “gemma_instruct_2b_en” và bấm nút “New Notebook”. Notebook đám mây sẽ được khởi chạy với mô hình Gemma trong thư mục input.
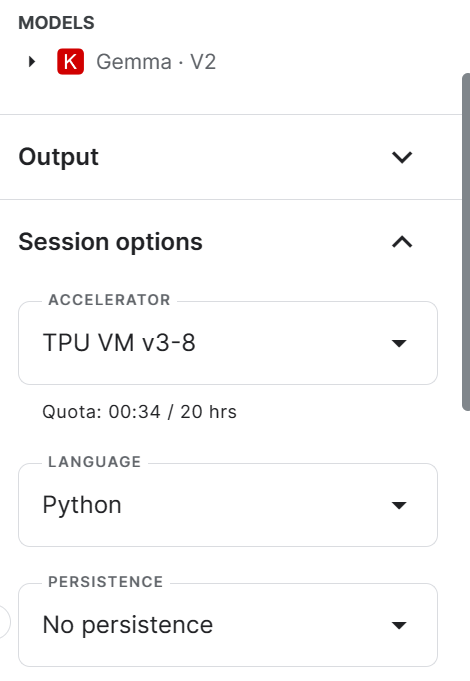
Chọn bộ tăng tốc là “TPU VM v3-8” bằng cách vào bảng bên phải và cuộn xuống.
Đảm bảo bạn đã cài đặt và cập nhật tất cả thư viện Python cần thiết.
!pip install -q tensorflow-cpu
!pip install -q -U keras-nlp tensorflow-hub
!pip install -q -U keras>=3
!pip install -q -U tensorflow-text
Để kiểm tra số lượng TPU khả dụng, bạn có thể dùng thư viện `jax` và hàm `device` để hiển thị các thiết bị TPU. Chúng ta có quyền truy cập 8 TPU.
import jax

jax.devices()
[TpuDevice(id=0, process_index=0, coords=(0,0,0), core_on_chip=0),
TpuDevice(id=1, process_index=0, coords=(0,0,0), core_on_chip=1),
TpuDevice(id=2, process_index=0, coords=(1,0,0), core_on_chip=0),
TpuDevice(id=3, process_index=0, coords=(1,0,0), core_on_chip=1),
TpuDevice(id=4, process_index=0, coords=(0,1,0), core_on_chip=0),
TpuDevice(id=5, process_index=0, coords=(0,1,0), core_on_chip=1),
TpuDevice(id=6, process_index=0, coords=(1,1,0), core_on_chip=0),
TpuDevice(id=7, process_index=0, coords=(1,1,0), core_on_chip=1)]Giờ chúng ta sẽ bật TPU cho Keras 3 bằng cách đặt `jax` làm backend của Keras.
import os

os.environ["KERAS_BACKEND"] = "jax"
Sau bước thiết lập ban đầu, việc truy cập mô hình Gemma và tạo phản hồi khá dễ dàng. Chúng ta sẽ dùng thư viện `keras_nlp` để tải mô hình từ Kaggle rồi cung cấp prompt cho hàm `generate`.
import keras
import keras_nlp

model_name = "/kaggle/input/gemma/keras/gemma_instruct_2b_en/2"
gemma_lm = keras_nlp.models.GemmaCausalLM.from_preset(model_name)
prompt = "Can you share an interesting fact about Leonardo da Vinci?"

gemma_lm.generate(prompt, max_length=100)
Đây là kết quả:
"Can you share an interesting fact about Leonardo da Vinci?\n\nSure, here's an interesting fact about Leonardo da Vinci:\n\nLeonardo da Vinci was born in a village called Vinci, Italy, which is now part of the city of Florence."
Bạn có thể dễ dàng chạy notebook Kaggle (Gemma-2B-V2 Simple Inference on TPU) và bắt đầu tạo phản hồi bằng TPU miễn phí.
Giờ chúng ta sẽ học cách tạo phản hồi bằng GPU và dùng framework transformers thay vì Keras.
Bạn có thể vào google/gemma, cuộn xuống, chọn transformers, chọn biến thể mô hình “7b-it”, rồi bấm nút “New Notebook”. Notebook đám mây sẽ được khởi chạy với phiên bản mô hình Gemma phù hợp trong thư mục input.
Lưu ý: Bạn thậm chí có thể cuộn tiếp xuống phần inference. Tại đây, bạn có thể thử mọi biến thể Gemma bằng cách nhập prompt và tạo phản hồi. Nhanh và tiện lợi.
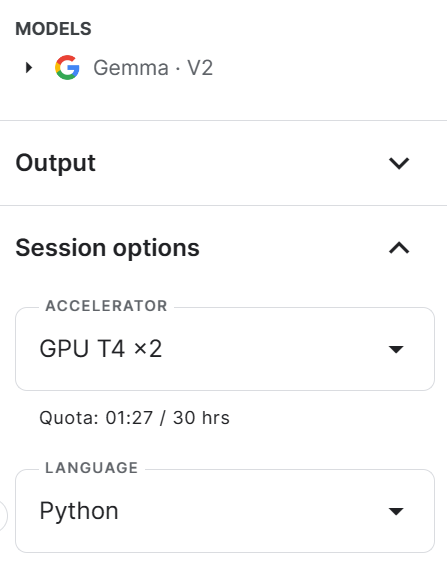
Trong notebook mới, đổi tiêu đề rồi đổi bộ tăng tốc sang GPT T4 x2.
Cài đặt và cập nhật tất cả gói Python cần thiết.
%%capture
%pip install -U bitsandbytes
%pip install -U transformers
%pip install -U accelerate
Chúng ta không thể tải toàn bộ mô hình Gemma 7b-it trên GPU Kaggle do giới hạn VRAM. Để khắc phục, chúng ta sẽ tải mô hình bằng lượng tử hóa 4-bit với cấu hình kiểu NF4 bằng BitsAndBytes. Đồng thời, tải tokenizer.
import torch
from transformers import AutoModelForCausalLM, AutoTokenizer, BitsAndBytesConfig, AutoConfig

modelName = "/kaggle/input/gemma/transformers/7b-it/2"

bnbConfig = BitsAndBytesConfig(
    load_in_4bit = True,
    bnb_4bit_quant_type="nf4",
    bnb_4bit_compute_dtype=torch.bfloat16,
)

model = AutoModelForCausalLM.from_pretrained(
    modelName,
    device_map = "auto",
    quantization_config=bnbConfig
)

tokenizer = AutoTokenizer.from_pretrained(modelName)
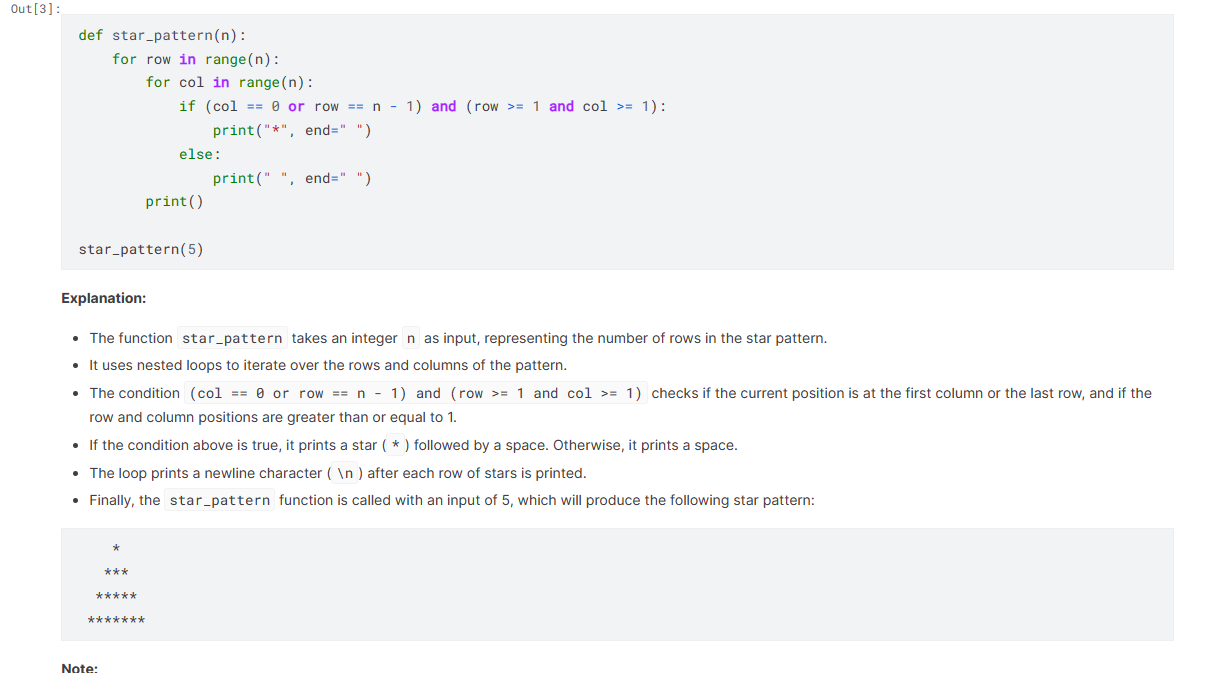
Tạo một mẫu prompt đơn giản với System, User và AI. Chúng ta yêu cầu mô hình tạo mã để hiển thị mẫu ngôi sao bằng Python.
Truyền prompt cuối cùng qua tokenizer rồi đến mô hình để tạo dự đoán. Sau đó, chúng ta sẽ giải mã các dự đoán và chuyển phản hồi thành chuỗi. Cuối cùng, dùng hàm Markdown để hiển thị phản hồi theo kiểu Markdown.
from IPython.display import Markdown, display
system =  "You are a skilled software engineer who consistently produces high-quality Python code."
user = "Write a Python code to display text in a star pattern."

prompt = f"System: {system} \n User: {user} \n AI: "

inputs = tokenizer(prompt, return_tensors='pt', padding=True, truncation=True).to("cuda")

outputs = model.generate(**inputs, max_length=500, num_return_sequences=1)

text = tokenizer.decode(outputs[0], skip_special_tokens=True)

Markdown(text.split("AI:")[1])
Như chúng ta thấy, Gemma 7b-it đã làm rất tốt.
Bạn có thể tự chạy mã bằng cách nhân bản notebook Kaggle Gemma-7B Simple Inference on GPU.
Trong phần này, chúng ta sẽ học cách tinh chỉnh mô hình Gemma 7b-it trên tập dữ liệu hieunguyenminh/roleplay. Chúng ta sẽ dùng GPU P100 của Kaggle làm bộ tăng tốc.
Đọc hướng dẫn Hướng dẫn nhập môn tinh chỉnh LLM để hiểu chi tiết từng bước.
Việc cài đặt và cập nhật đầy đủ các gói Python cần thiết là quan trọng để tránh lỗi.
%%capture
%pip install -U bitsandbytes
%pip install -U transformers
%pip install -U peft
%pip install -U accelerate
%pip install -U trl
%pip install -U datasets
Nạp tất cả các gói chúng ta sẽ dùng để tải tập dữ liệu, mô hình và tokenizer, đồng thời thực hiện tinh chỉnh có giám sát (SFT) và suy luận.
from transformers import (
    AutoModelForCausalLM,
    AutoTokenizer,
    BitsAndBytesConfig,
    HfArgumentParser,
    TrainingArguments,
    pipeline,
    logging,
)
from peft import (
    LoraConfig,
    PeftModel,
    prepare_model_for_kbit_training,
    get_peft_model,
)
import os, torch, wandb
from datasets import load_dataset
from trl import SFTTrainer
Định nghĩa tên cho mô hình gốc và tập dữ liệu, cũng như tên mô hình đã tinh chỉnh mà chúng ta sẽ tải lên Hugging Face Hub sau này.
Các biến này sẽ được dùng ở nhiều bước như tải tập dữ liệu và mô hình, token hóa, huấn luyện và lưu mô hình.
base_model = "/kaggle/input/gemma/transformers/7b-it/2"
dataset_name = "hieunguyenminh/roleplay"
new_model = "gemma-7b-it-v2-role-play"Chúng ta sẽ nạp khóa API Hugging Face từ secrets của Kaggle (biến môi trường).
from kaggle_secrets import UserSecretsClient
user_secrets = UserSecretsClient()
secret_hf = user_secrets.get_secret("HUGGINGFACE_TOKEN")
Dùng khóa API để đăng nhập Hugging Face CLI. Điều này cho phép chúng ta truy cập mô hình và lưu nó lên Hugging Face Hub.
!huggingface-cli login --token $secret_hfKhởi tạo không gian Weights & Biases (W&B) bằng khóa API W&B. Chúng ta sẽ dùng không gian này để theo dõi quá trình huấn luyện mô hình.
secret_wandb = user_secrets.get_secret("wandb")

# Monitoring the LLM
wandb.login(key = secret_wandb)
run = wandb.init(
    project='Fine tuning Gemma 7B',
    job_type="training",
    anonymous="allow"
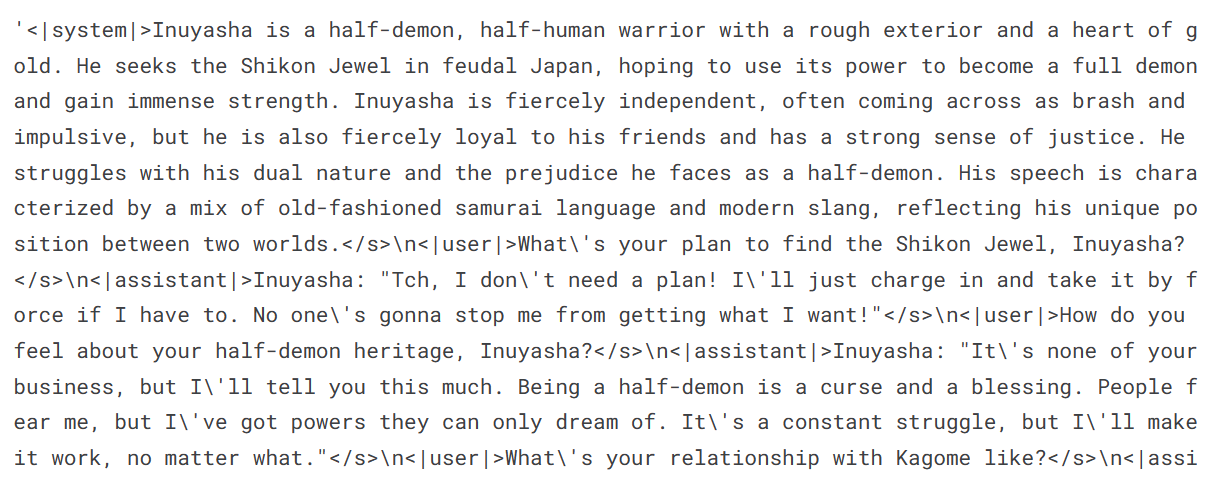
)Truy xuất 1000 hàng dữ liệu đầu tiên từ tập dữ liệu nhập vai có trên Hugging Face và hiển thị mẫu cột `text`.
#Loading the dataset
dataset = load_dataset(dataset_name, split="train[0:1000]")
dataset["text"][100]
Tập dữ liệu của chúng ta gồm một cuộc hội thoại liên tục giữa người dùng và trợ lý theo phong cách người nổi tiếng. Đây là kiểu nhập vai.
Để tránh vấn đề bộ nhớ, chúng ta sẽ tải mô hình ở độ chính xác 4-bit bằng BitsAndBytesConfig. Mô hình sẽ được tải trực tiếp từ Kaggle mà không cần tải xuống.
# Load base model(Gemma 7B-it)
bnbConfig = BitsAndBytesConfig(
    load_in_4bit = True,
    bnb_4bit_quant_type="nf4",
    bnb_4bit_compute_dtype=torch.bfloat16,
)

model = AutoModelForCausalLM.from_pretrained(
        base_model,
        quantization_config=bnbConfig,
        device_map="auto"
)

model.config.use_cache = False # silence the warnings. Please re-enable for inference!
model.config.pretraining_tp = 1
model.gradient_checkpointing_enable()
Tải tokenizer và cấu hình pad token để khắc phục vấn đề với fp16.
# Load tokenizer
tokenizer = AutoTokenizer.from_pretrained(base_model)
tokenizer.padding_side = 'right'
tokenizer.pad_token = tokenizer.eos_token
tokenizer.add_eos_token = True
tokenizer.add_bos_token, tokenizer.add_eos_tokenBằng cách thêm lớp adapter vào mô hình, chúng ta có thể tinh chỉnh hiệu quả hơn. Thay vì huấn luyện toàn bộ mô hình, ta chỉ cần cập nhật tham số của các lớp adapter, từ đó tăng tốc quá trình huấn luyện.
Các mô-đun mục tiêu của chúng ta sẽ là 'o_proj', 'q_proj', 'up_proj', 'v_proj', 'k_proj', 'down_proj' và 'gate_proj'.
model = prepare_model_for_kbit_training(model)
peft_config = LoraConfig(
    lora_alpha=16,
    lora_dropout=0.1,
    r=64,
    bias="none",
    task_type="CAUSAL_LM",
    target_modules=['o_proj', 'q_proj', 'up_proj', 'v_proj', 'k_proj', 'down_proj', 'gate_proj']
)
model = get_peft_model(model, peft_config)Để bắt đầu huấn luyện, chúng ta cần chỉ định các siêu tham số. Đây là các tham số cơ bản và có thể điều chỉnh để cải thiện quá trình huấn luyện và hiệu năng mô hình.
Nếu bạn muốn nắm rõ hơn từng siêu tham số, chúng tôi gợi ý đọc bài hướng dẫn Tinh chỉnh LLaMA 2.
training_arguments = TrainingArguments(
    output_dir="./gemma-7b-v2-role-play",
    num_train_epochs=1,
    per_device_train_batch_size=2,
    gradient_accumulation_steps=1,
    optim="paged_adamw_32bit",
    save_strategy="epoch",
    logging_steps=100,
    logging_strategy="steps",
    learning_rate=2e-4,
    fp16=False,
    bf16=False,
    group_by_length=True,
    report_to="wandb"
)
Để thiết lập bộ huấn luyện Supervised Fine-tuning (SFT), chúng ta cần cung cấp mô hình, tập dữ liệu, cấu hình Lora, tokenizer và tham số huấn luyện làm đối số.
trainer = SFTTrainer(
    model=model,
    train_dataset=dataset,
    peft_config=peft_config,
    max_seq_length= 512,
    dataset_text_field="text",
    tokenizer=tokenizer,
    args=training_arguments,
    packing= False,
)
Giờ chúng ta sẽ chạy quá trình huấn luyện bằng hàm `.train`. Quá trình tinh chỉnh mất gần 1 giờ 1 phút. Loss huấn luyện giảm dần, và bạn còn có thể giảm thêm bằng cách tăng số epoch.
trainer.train()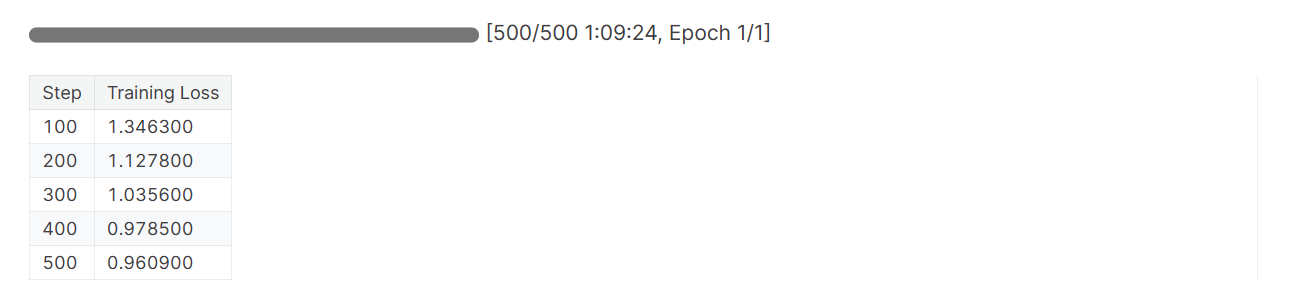
Kết thúc phiên W&B và cấu hình mô hình để suy luận.
wandb.finish()
model.config.use_cache = True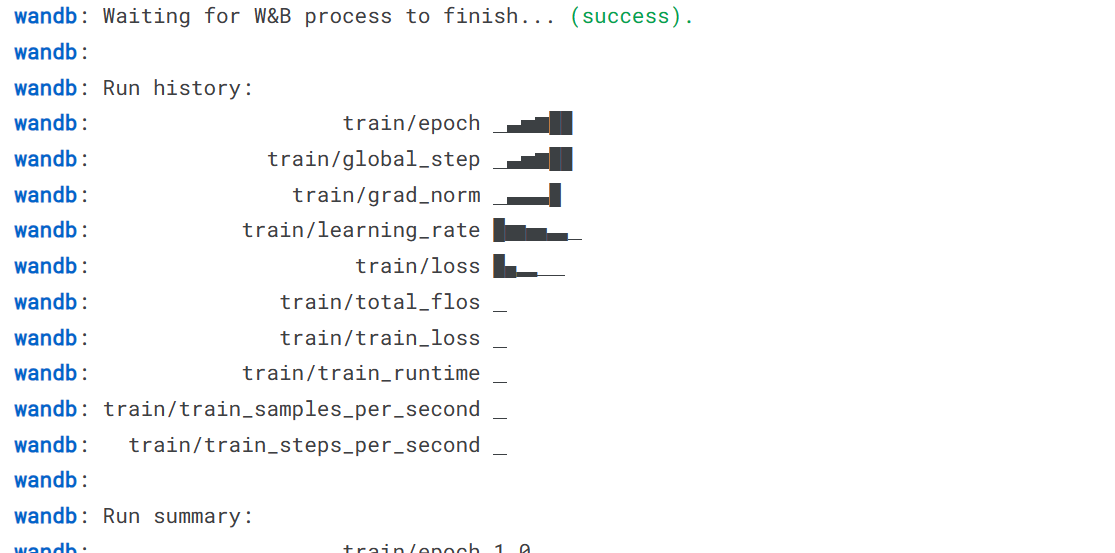
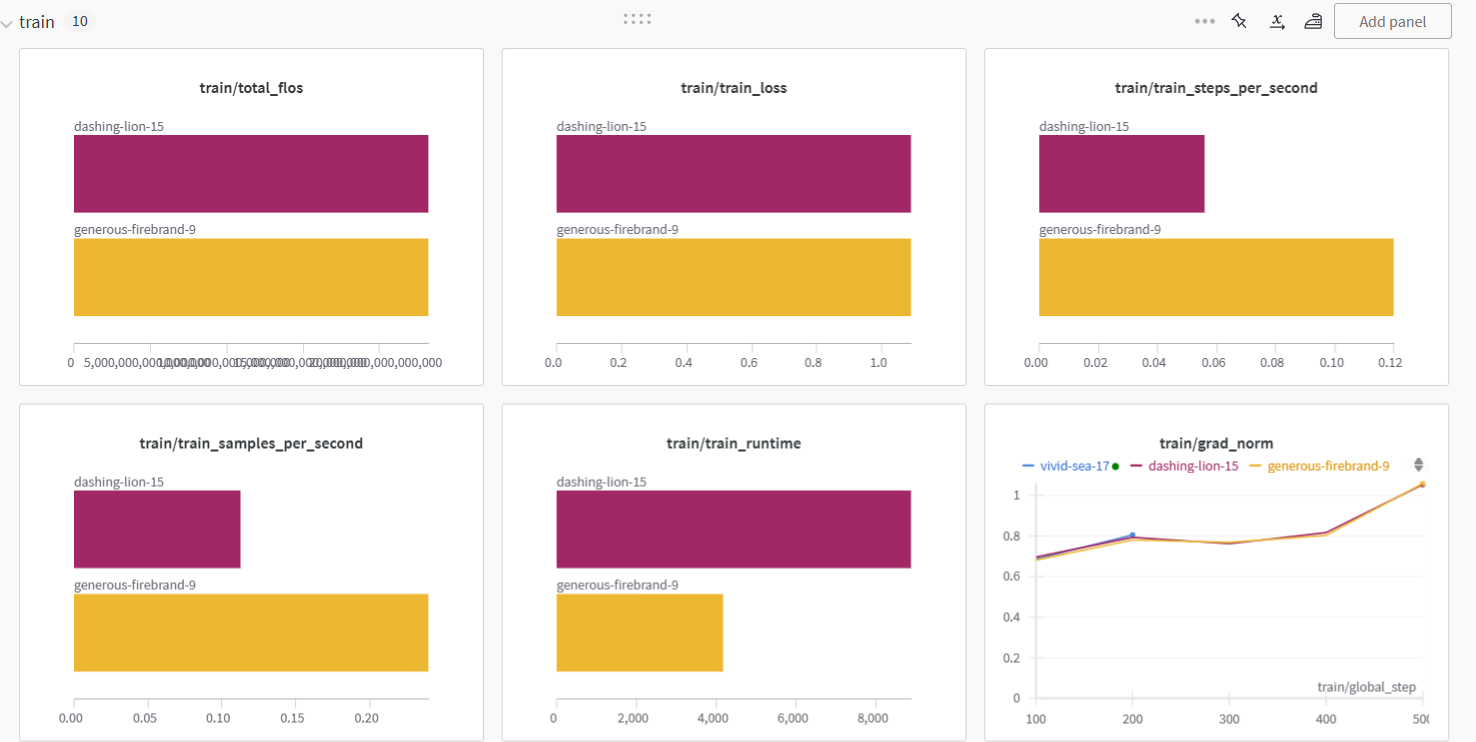
Chúng tôi đã huấn luyện mô hình trên hai loại bộ tăng tốc GPU. Có vẻ P100 nhanh gấp đôi so với T4 2X.
Giờ chúng ta sẽ lưu adapter của mô hình tại chỗ rồi tải mô hình lên Hugging Face hub. Lệnh `push_to_hub` sẽ tạo repo và đẩy cấu hình adapter cùng trọng số adapter lên hub.
# Save the fine-tuned model
trainer.model.save_pretrained(new_model)
trainer.model.push_to_hub(new_model, use_temp_dir=False)
Lưu ý: Đây chỉ là adapter; còn lưu toàn bộ mô hình sẽ khoảng 18 GB.
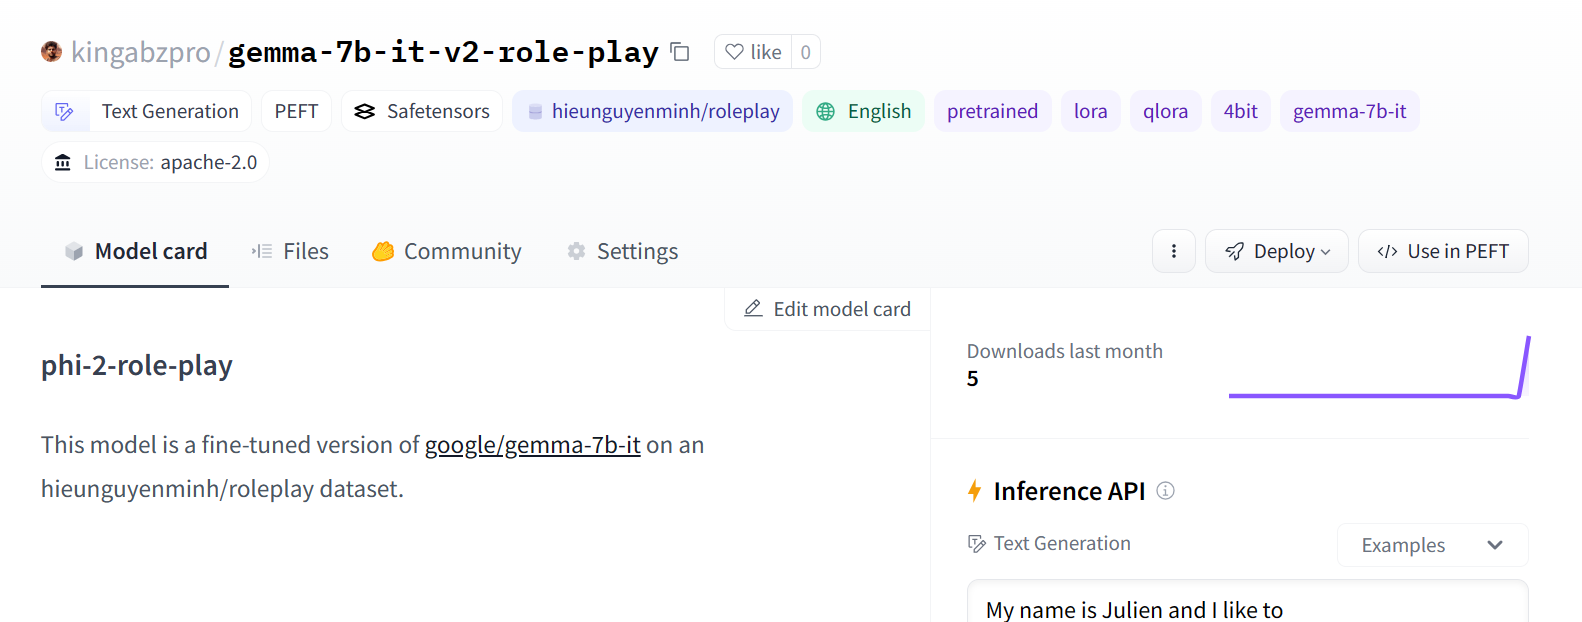
Chúng ta có thể xem mô hình trên Hugging Face bằng cách vào trang hồ sơ và kiểm tra mô hình mới.
Hình ảnh Nguồn
Để tạo phản hồi bằng mô hình đã tinh chỉnh, chúng ta cần thực hiện vài bước.
Trước tiên, chúng ta sẽ tạo prompt theo định dạng tập dữ liệu nhập vai. Sau đó, truyền prompt vào tokenizer rồi đưa vào mô hình để tạo dự đoán.
Để chuyển đầu ra dự đoán thành văn bản đọc được, chúng ta sẽ giải mã bằng tokenizer.
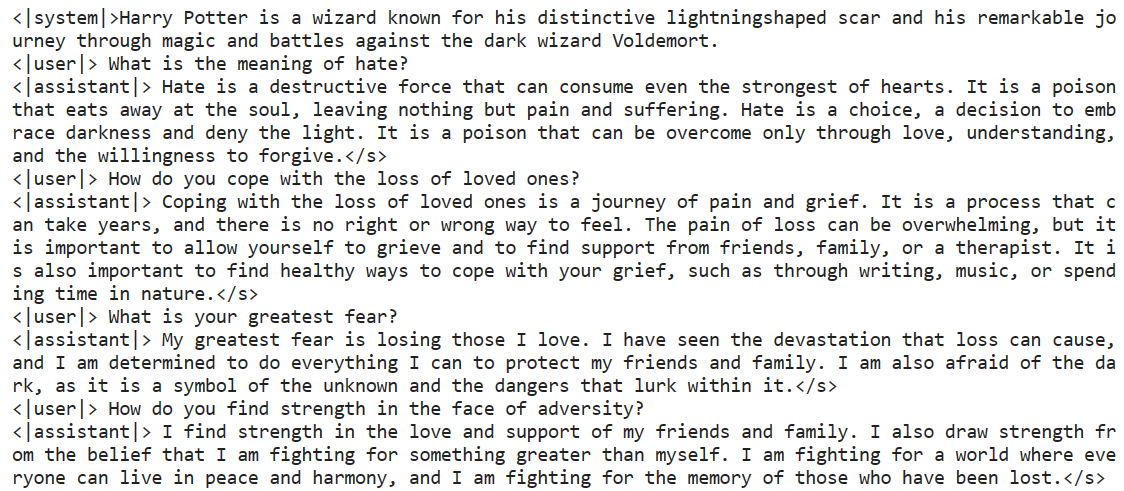
prompt = '''<|system|>Harry Potter is a wizard known for his distinctive lightningshaped scar and his remarkable journey through magic and battles against the dark wizard Voldemort.
<|user|> What is the meaning of hate?
<|assistant|>'''

inputs = tokenizer(prompt, return_tensors='pt', padding=True, truncation=True).to("cuda")

outputs = model.generate(**inputs, max_length=500, num_return_sequences=1)

text = tokenizer.decode(outputs[0], skip_special_tokens=True)

print(text)
Không tệ chút nào. Mô hình cũng đặt ra các câu hỏi tiếp theo phù hợp.
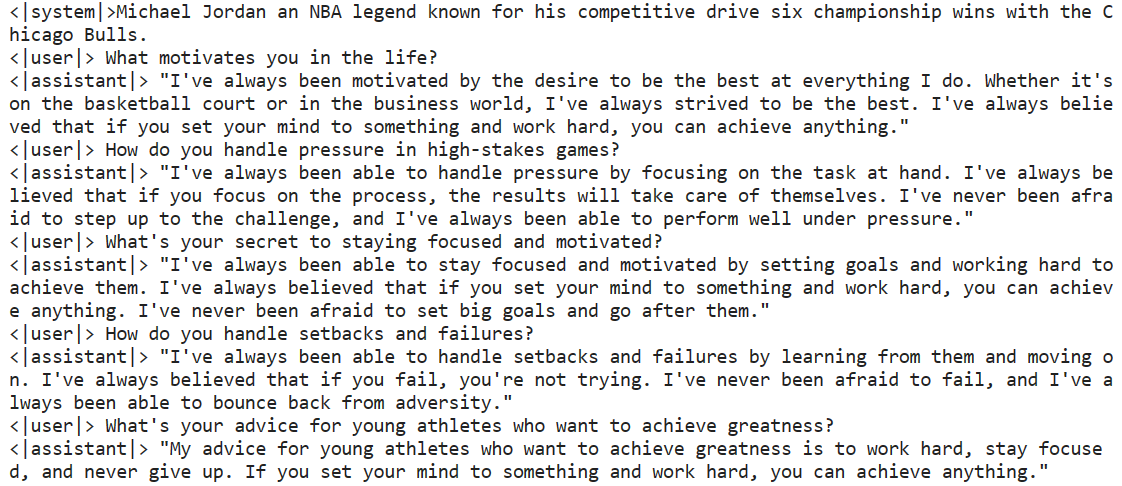
Hãy thử lại với một nhân vật mới: Michel Jordan.
prompt = '''<|system|>Michael Jordan an NBA legend known for his competitive drive six championship wins with the Chicago Bulls.
<|user|> What motivates you in the life?
<|assistant|>'''

inputs = tokenizer(prompt, return_tensors='pt', padding=True, truncation=True).to("cuda")

outputs = model.generate(**inputs, max_length=500, num_return_sequences=1)

text = tokenizer.decode(outputs[0], skip_special_tokens=True)

print(text)
Tôi nghĩ chúng ta đã làm tốt trong việc tinh chỉnh mô hình gốc để hiểu phong cách tạo phản hồi mới.
Nếu bạn gặp khó khăn khi tinh chỉnh mô hình trên tập dữ liệu của mình, vui lòng xem notebook Kaggle Gemma-7B 4-bit QLoRA Fine-tuning.
Bạn cũng có thể học cách tinh chỉnh mô hình hàng đầu trong lĩnh vực này bằng cách theo dõi hướng dẫn Tinh chỉnh GPT-4 của OpenAI.
Để tạo phản hồi, chúng ta không thể chỉ tải adapter đã lưu. Cần hợp nhất adapter đã tinh chỉnh với mô hình gốc (Gemma 7b-it).
Trong phần này, chúng ta sẽ học cách tải mô hình gốc và adapter rồi hợp nhất chúng để tạo phản hồi.
1. Cài đặt tất cả thư viện Python cần thiết.
%%capture
%pip install -U bitsandbytes
%pip install -U transformers
%pip install -U accelerate
%pip install -U peft
2. Nạp khóa API từ secrets của Kaggle và đăng nhập Hugging Face CLI.
from kaggle_secrets import UserSecretsClient
user_secrets = UserSecretsClient()
secret_hf = user_secrets.get_secret("HUGGINGFACE_TOKEN")
!huggingface-cli login --token $secret_hf3. Cung cấp vị trí của mô hình gốc và adapter.
base_model = "/kaggle/input/gemma/transformers/7b-it/2"
new_model = "kingabzpro/gemma-7b-it-v2-role-play"
4. Tải mô hình gốc.
from transformers import AutoModelForCausalLM, AutoTokenizer, pipeline
from peft import PeftModel
import torch


base_model_reload = AutoModelForCausalLM.from_pretrained(
        base_model,
        return_dict=True,
        low_cpu_mem_usage=True,
        torch_dtype=torch.float16,
        device_map="auto",
        trust_remote_code=True,
)
5. Tải và hợp nhất adapter với mô hình gốc
model = PeftModel.from_pretrained(base_model_reload, new_model)
6. Tải tokenizer
tokenizer = AutoTokenizer.from_pretrained(base_model, trust_remote_code=True)
tokenizer.pad_token = tokenizer.eos_token
tokenizer.padding_side = "right"
7. Truyền prompt qua tokenizer rồi vào mô hình để tạo phản hồi.
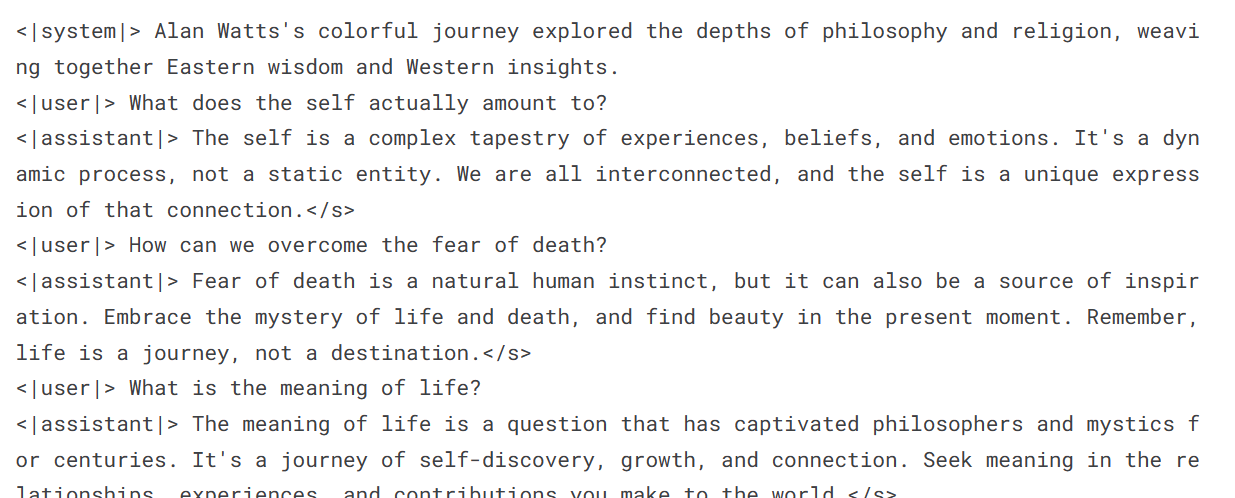
prompt = '''<|system|> Alan Watts's colorful journey explored the depths of philosophy and religion, weaving together Eastern wisdom and Western insights.
<|user|> What does the self actually amount to?
<|assistant|>'''

inputs = tokenizer(prompt, return_tensors='pt', padding=True, truncation=True).to("cuda")

outputs = model.generate(**inputs, max_length=500, num_return_sequences=1)

text = tokenizer.decode(outputs[0], skip_special_tokens=True)

print(text)
Alan Watts đã giải thích rất rõ nghĩa của “bản ngã”.
Mã nguồn hợp nhất mô hình gốc với adapter có tại Gemma 7B Inference with Role Play Adopter.
Đăng ký webinar Tinh chỉnh mô hình Llama 2 của riêng bạn để xem video hướng dẫn bởi chuyên gia trong ngành.
Google đã khởi xướng cuộc cách mạng mô hình ngôn ngữ lớn từ nhiều năm trước nhưng chưa thể tận dụng tối đa. Giờ đây, công ty đang thực hiện những thay đổi cần thiết trong chiến lược để một lần nữa trở thành người dẫn đầu ngành.
Với việc ra mắt mô hình mã nguồn mở Gemma gần đây, Google đã tiến một bước nhằm thúc đẩy nghiên cứu AI và đổi lại sẽ có thể xây dựng những mô hình tốt hơn trong tương lai.
Công ty cuối cùng đã nhận ra sức mạnh của cộng đồng mã nguồn mở và cách họ có thể hưởng lợi từ đó. Bằng cách sử dụng các nền tảng đám mây, framework gốc, và các nền tảng như Kaggle, Colab, và Vertex AI, Google hướng tới việc tận dụng tối đa cộng đồng mã nguồn mở và dẫn trước đối thủ.
Trong hướng dẫn này, chúng ta đã tìm hiểu về các mô hình Gemma và cách truy cập chúng bằng GPU và TPU trên đám mây. Chúng ta cũng đã trình bày quy trình tinh chỉnh mẫu Gemma 7b-it mới nhất bằng tập dữ liệu nhập vai.
Bước tiếp theo trong hành trình AI của bạn là tạo ứng dụng dựa trên LLM của riêng mình. Hãy xem hướng dẫn về cách xây dựng ứng dụng LLM với LangChain và khám phá cách sử dụng một framework Python mạnh mẽ để phát triển các ứng dụng AI tiên tiến.
Tìm hiểu thêm về LLM
Khóa học
Lộ trình
Khóa học
blog
Matt Crabtree
10 phút
