Khóa học
Làm việc với OpenAI API
3 giờ
184.5K
Mẫu AI tiên tiến nhất của OpenAI, Generative Pre-trained Transformer 4 (GPT-4), ra mắt vào tháng 3/2023, đánh dấu một bước tiến lớn trong trí tuệ nhân tạo, thiết lập chuẩn mực mới cho năng lực AI. Có mặt qua ChatGPT Plus, API của OpenAI và Microsoft Copilot, GPT-4 nổi bật với khả năng đa phương thức, đặc biệt qua GPT-4V, cho phép xử lý hình ảnh song song với văn bản, mở đường cho nhiều ứng dụng sáng tạo trong nhiều lĩnh vực.
Nền tảng của những tiến bộ trong GPT-4 là kiến trúc transformer, được tiền huấn luyện chuyên sâu trên lượng lớn dữ liệu từ internet và các nguồn được cấp phép, rồi tinh chỉnh bằng sự kết hợp giữa phản hồi của con người và học tăng cường do AI dẫn dắt. Cách tiếp cận độc đáo này nhằm tăng cường sự phù hợp của mô hình với các chuẩn mực đạo đức và tuân thủ chính sách của con người.
Dù GPT-4 cải thiện so với tiền nhiệm GPT-3, nó vẫn kế thừa một số hạn chế, nhấn mạnh những thách thức phức tạp trong các Mô hình Ngôn ngữ Lớn và AI sinh sinh. Một số thách thức đó có thể được giải quyết thông qua quy trình gọi là tinh chỉnh (Fine-tuning), cũng là chủ đề của hướng dẫn này. Mục tiêu của hướng dẫn gồm:
Tuy nhiên, cần lưu ý rằng tinh chỉnh GPT-4 hiện chỉ ở trạng thái truy cập thử nghiệm, và nhà phát triển đủ điều kiện có thể yêu cầu quyền qua giao diện tinh chỉnh. Dù vậy, các kỹ thuật tinh chỉnh được đề cập có thể áp dụng cho mọi mô hình GPT.
Tinh chỉnh là một quy trình tinh vi nhằm điều chỉnh các mô hình đã được tiền huấn luyện (như GPT-4) cho các tác vụ hay miền chuyên biệt, tận dụng nền tảng kiến thức rộng lớn mà mô hình tích lũy trong quá trình huấn luyện ban đầu trên các tập dữ liệu đa dạng. Điều này bao gồm việc điều chỉnh tham số của mô hình dựa trên dữ liệu đặc thù của tác vụ, nâng cao hiệu suất và cho phép mô hình xử lý các ứng dụng cụ thể với độ chính xác và hiệu quả cao hơn.
Một ví dụ minh họa tác động của tinh chỉnh là nâng cấp phản hồi của mô hình trước các câu hỏi chuyên sâu. Chẳng hạn, một mô hình tiền huấn luyện có thể đưa ra lời giải thích cơ bản khi được hỏi vì sao bầu trời có màu xanh. Thông qua tinh chỉnh, câu trả lời có thể được bổ sung bối cảnh khoa học chi tiết, phù hợp hơn cho các ứng dụng chuyên biệt như nền tảng giáo dục.
Các phương pháp tinh chỉnh trải rộng từ tinh chỉnh theo hướng dẫn (instruction fine-tuning), nơi mô hình được huấn luyện bằng các ví dụ thể hiện phản hồi mong muốn, đến tinh chỉnh hiệu quả tham số (PEFT), chỉ cập nhật một phần tham số mô hình để tiết kiệm tài nguyên tính toán và tránh quên thảm họa.
Ngược lại, Retrieval Augmented Generation (RAG) là một hướng tiếp cận khác. RAG kết hợp các yếu tố của truy xuất và mô hình sinh để nâng cao chất lượng nội dung sinh ra bằng cách đưa thông tin truy xuất từ nguồn bên ngoài vào trong quá trình tạo sinh.
Trong khi tinh chỉnh tập trung tối ưu hóa mô hình sẵn có cho tác vụ cụ thể, RAG tích hợp tri thức bên ngoài để làm giàu quá trình tạo nội dung.
Việc chọn giữa tinh chỉnh và RAG phụ thuộc vào yêu cầu cụ thể của ứng dụng, bao gồm nhu cầu thông tin cập nhật, tài nguyên tính toán sẵn có và mức độ chuyên biệt của tác vụ. Tinh chỉnh là cách trực tiếp để khai thác kho tri thức đồ sộ của mô hình tiền huấn luyện cho các tác vụ cụ thể, trong khi RAG mang lại cách tiếp cận linh hoạt nhằm đảm bảo tính liên quan và độ chính xác của thông tin mô hình sử dụng.
Tinh chỉnh các mô hình sinh văn bản của OpenAI là cách mạnh mẽ để điều chỉnh theo nhu cầu cụ thể, nhưng đòi hỏi nhiều thời gian và tài nguyên. Trước khi vội vàng tinh chỉnh, nên tối đa hóa hiệu suất mô hình qua kỹ thuật nhắc lệnh (prompt engineering), xâu chuỗi nhắc lệnh (chia tác vụ phức tạp thành các nhắc lệnh tuần tự đơn giản hơn) và sử dụng functions. Cách tiếp cận này được khuyến nghị vì:
Tinh chỉnh đặc biệt hữu ích trong các tình huống sau:
Do tính chất sở hữu của các mô hình OpenAI, bạn phải sử dụng API tinh chỉnh từ OpenAI nếu muốn tinh chỉnh bất kỳ mô hình nào của họ. Quy trình này bao gồm việc tải dữ liệu của bạn lên máy chủ OpenAI để huấn luyện mô hình.
Hiện tại, chỉ các mô hình sau được hỗ trợ tinh chỉnh qua API.
Tinh chỉnh GPT-4 đang trong giai đoạn truy cập thử nghiệm, và nhà phát triển đủ điều kiện có thể yêu cầu quyền qua giao diện tinh chỉnh. Bất kể dùng mô hình nào, quy trình tinh chỉnh và mã trong hướng dẫn này không thay đổi.
Đây là bước quan trọng nhất. Chất lượng của mô hình đã tinh chỉnh phụ thuộc trực tiếp vào dữ liệu bạn tạo ra để tinh chỉnh. Với OpenAI API, dữ liệu phải được lưu ở định dạng jsonl.
Định dạng JSONL là văn bản trong đó mỗi dòng là một đối tượng JSON riêng biệt, phù hợp để xử lý các tập dữ liệu lớn theo từng dòng. Định dạng này đặc biệt hữu ích khi dữ liệu có thể dễ dàng chia thành các bản ghi riêng lẻ mà không mất cấu trúc.
Ví dụ:
{"prompt": "<prompt text>", "completion": "<ideal generated text>"}
{"prompt": "<prompt text>", "completion": "<ideal generated text>"}
{"prompt": "<prompt text>", "completion": "<ideal generated text>"}
Trong hướng dẫn này, tôi tạo dữ liệu mẫu chỉ với năm ví dụ. Dữ liệu gồm các câu hỏi về nhiều chủ đề trong machine learning và câu trả lời theo phong cách Shakespeare.
Dữ liệu mẫu tôi tạo cho hướng dẫn này:
{"messages": [{"role": "system", "content": "You are teaching assistant for Machine Learning. You should help to user to answer on his question."}, {"role": "user", "content": "What is machine learning?"}, {"role": "assistant", "content": "'Tis but the art of teaching machines to think, to learn from data most fine, and decisions to link."}]}

{"messages": [{"role": "system", "content": "You are teaching assistant for Machine Learning. You should help to user to answer on his question."}, {"role": "user", "content": "How doth neural networks work?"}, {"role": "assistant", "content": "They're like the brains of yon digital beast, with layers many, and nodes that cease."}]}Bước đầu để tạo một job tinh chỉnh bằng OpenAI API là tải tệp lên. Để dùng API này, bạn cần cài đặt thư viện openai trong python.
!pip install openaiBây giờ hãy đăng nhập tài khoản platform.openai.com và tạo một mã thông báo API:
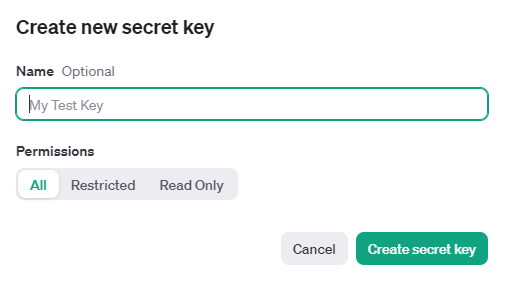
Sau đó bạn có thể đặt mã thông báo dưới dạng biến môi trường bằng thư viện os.
import os


# Set the OPENAI_API_KEY environment variable
os.environ['OPENAI_API_KEY'] = '...'Tệp huấn luyện của bạn phải ở định dạng jsonl. Sau khi tải lên, quá trình xử lý có thể mất một lúc. Kích thước tối đa cho tệp tải lên là 1 GB. Để tải tệp lên máy chủ OpenAI:
from openai import OpenAI
client = OpenAI()


client.files.create(
  file=open("train.jsonl", "rb"),
  purpose="fine-tune"
)
Đầu ra:
FileObject(id='file-rIua39sJX1O64gzxTYfpvJx7', bytes=11165, created_at=1709499930, filename='train.jsonl', object='file', purpose='fine-tune', status='processed', status_details=None)Sau khi đảm bảo tệp đã được tải lên thành công, bước tiếp theo là tạo job tinh chỉnh. training_file là ID tệp được trả về khi bạn tải tệp huấn luyện lên OpenAI API. Để bắt đầu một job tinh chỉnh:
from openai import OpenAI
client = OpenAI()


client.fine_tuning.jobs.create(
  training_file="file-rIua39sJX1O64gzxTYfpvJx7",
  model="gpt-3.5-turbo" #change to gpt-4-0613 if you have access
)
Để cấu hình các thiết lập tinh chỉnh bổ sung, như validation_file hoặc siêu tham số, hãy xem tài liệu API về tinh chỉnh.
Thời gian hoàn thành job tinh chỉnh khác nhau, từ vài phút đến vài giờ, tùy thuộc vào mô hình và kích thước dữ liệu. Ví dụ, chỉ với 50 ví dụ trong tập train.jsonl và sử dụng mô hình gpt-3.5-turbo, job hoàn tất chỉ trong 7 phút.
Khi job hoàn tất, bạn cũng sẽ nhận email xác nhận.
Ngoài việc thiết lập job tinh chỉnh, bạn có thể xem danh sách các job hiện có, kiểm tra trạng thái một job cụ thể hoặc hủy một job.
from openai import OpenAI
client = OpenAI()


# List 10 fine-tuning jobs
client.fine_tuning.jobs.list(limit=10)


# Retrieve the state of a fine-tune
client.fine_tuning.jobs.retrieve("...")


# Cancel a job
client.fine_tuning.jobs.cancel("...")


# List up to 10 events from a fine-tuning job
client.fine_tuning.jobs.list_events(fine_tuning_job_id="...", limit=10)


# Delete a fine-tuned model (must be an owner of the org the model was created in)
client.models.delete("ft:gpt-3.5-turbo:xxx:xxx")\OpenAI cung cấp các chỉ số huấn luyện then chốt như training loss, độ chính xác token trên tập huấn luyện, test loss và độ chính xác token trên tập kiểm thử. Những chỉ số này giúp đảm bảo quá trình huấn luyện diễn ra như kỳ vọng, với loss giảm dần và độ chính xác token được cải thiện. Bạn có thể xem các chỉ số hữu ích này trong đối tượng sự kiện trong thời gian job tinh chỉnh đang chạy.
{
    "object": "fine_tuning.job.event",
    "id": "ftjob-Na7BnF5y91wwGJ4EgxtzVyDD",
    "created_at": 1693582679,
    "level": "info",
    "message": "Step 100/100: training loss=0.00",
    "data": {
        "step": 100,
        "train_loss": 1.805623287509661e-5,
        "train_mean_token_accuracy": 1.0
    },
    "type": "metrics"
}
Bạn cũng có thể xem thông tin này trên giao diện UI.
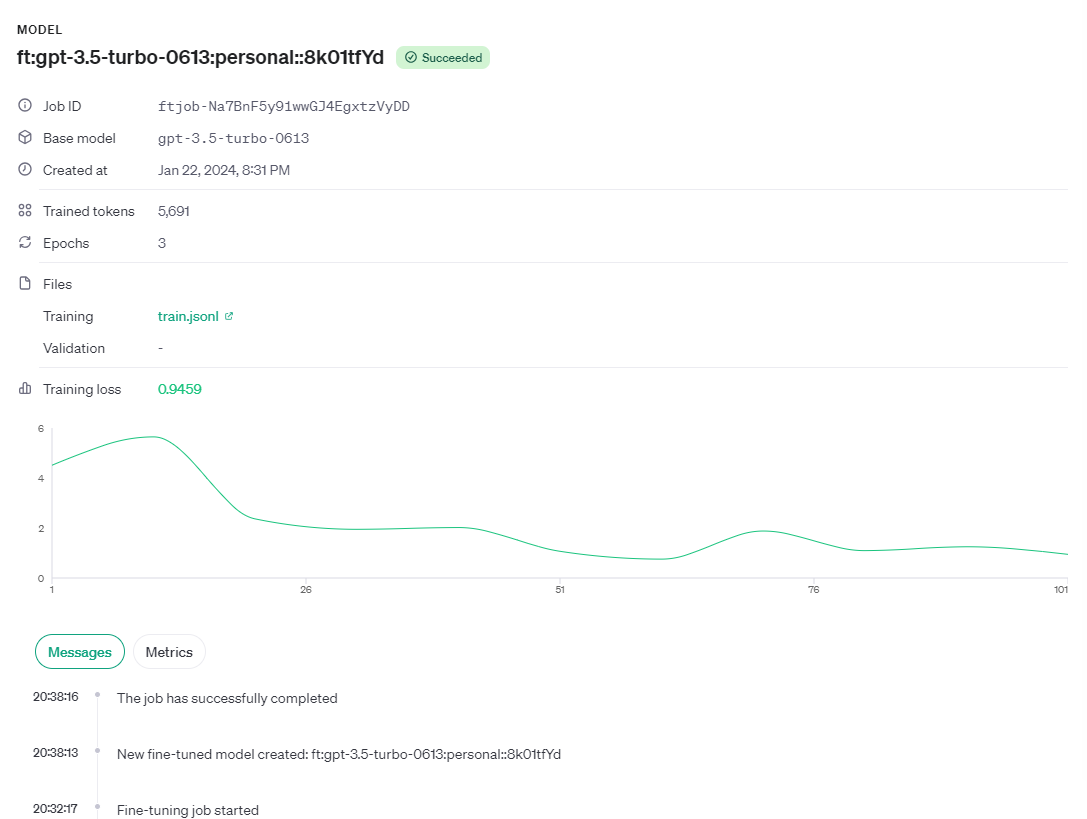
Khi job hoàn tất thành công, chi tiết job sẽ bao gồm trường fine_tuned_model, hiển thị tên mô hình. Bạn có thể gọi API tới mô hình này và nhận phản hồi từ mô hình vừa tinh chỉnh.
from openai import OpenAI
client = OpenAI()


completion = client.chat.completions.create(
  model="ft:gpt-3.5-turbo-0613:personal::8k01tfYd",
  messages=[
    {"role": "system", "content": "You are a teaching assistant for Machine Learning. You should help to user to answer on his question."},
    {"role": "user", "content": "What is a loss function?"}
  ]
)
print(completion.choices[0].message)
Đầu ra:
ChatCompletionMessage(content="To measure how far we falter, it guides our way, our hope's defaulter.", role='assistant', function_call=None, tool_calls=None)Hướng dẫn này đã đưa bạn qua quy trình tinh chỉnh mô hình GPT của OpenAI, một bước nâng cao để khai thác tối đa khả năng của LLM cho các ứng dụng miền chuyên biệt. Tinh chỉnh cho phép ta tinh gọn phản hồi của mô hình ngôn ngữ, giúp mô hình xử lý các tác vụ, phong cách hoặc lĩnh vực cụ thể với độ chính xác và hiệu quả cao hơn.
Hướng dẫn này sử dụng OpenAI Python API để tinh chỉnh mô hình. Nếu bạn muốn học cách thực hiện tương tự qua giao diện UI mà không cần viết bất kỳ dòng mã nào, hãy xem hướng dẫn Cách tinh chỉnh GPT 3.5 trên Datacamp.
Vì GPT không phải là mô hình mã nguồn mở nên quy trình tinh chỉnh khá đơn giản và chủ yếu là gọi API. Điều này rất khác khi tinh chỉnh các mô hình mã nguồn mở như llama-2, Mistral, Stable Diffusion, v.v. Nếu bạn quan tâm đến cách tinh chỉnh các mô hình mã nguồn mở, hãy xem các bài viết này trên DataCamp:
Để có thêm tài liệu nhập môn về tinh chỉnh LLM, hãy xem Hướng dẫn nhập môn về tinh chỉnh LLM trên Datacamp.
Bắt đầu hành trình AI của bạn ngay hôm nay!
Khóa học
Khóa học
Khóa học
blog
Matt Crabtree
10 phút
