
डेटा प्रीप्रोसेसिंग के चरण
डेटा प्रीप्रोसेसिंग में कई चरण शामिल होते हैं, जिनमें से हर एक डेटा की गुणवत्ता, संरचना और प्रासंगिकता से जुड़े विशिष्ट चुनौतियों को संबोधित करता है।
आइए इन प्रमुख चरणों पर नज़र डालें, जो सामान्यतः निम्न क्रम में चलते हैं:
चरण 1: डेटा क्लीनिंग
डेटा क्लीनिंग वह प्रक्रिया है जिसमें डेटा में त्रुटियों या असंगतियों की पहचान कर उन्हें ठीक किया जाता है ताकि वह सटीक और पूर्ण हो। उद्देश्य उन मुद्दों का समाधान करना है जो विश्लेषण या मॉडल के प्रदर्शन को विकृत कर सकते हैं।
उदाहरण के लिए:
- मिसिंग वैल्यू संभालना: औसत/मोड इम्प्यूटेशन, डिलीशन, या प्रिडिक्टिव मॉडल जैसी रणनीतियों का उपयोग करके गायब डेटा को भरना या हटाना।
- डुप्लिकेट हटाना: प्रत्येक एंट्री को अद्वितीय और प्रासंगिक बनाने के लिए डुप्लिकेट रिकॉर्ड्स को हटाना।
- असंगत प्रारूप ठीक करना: संगति बनाए रखने के लिए प्रारूपों (जैसे, तारीख के प्रारूप, स्ट्रिंग केस) को मानकीकृत करना।
यह पायथन में इस तरह दिखता है:
# Creating a manual dataset
data = pd.DataFrame({
'name': ['John', 'Jane', 'Jack', 'John', None],
'age': [28, 34, None, 28, 22],
'purchase_amount': [100.5, None, 85.3, 100.5, 50.0],
'date_of_purchase': ['2023/12/01', '2023/12/02', '2023/12/01', '2023/12/01', '2023/12/03']
})
# Handling missing values using mean imputation for 'age' and 'purchase_amount'
imputer = SimpleImputer(strategy='mean')
data[['age', 'purchase_amount']] = imputer.fit_transform(data[['age', 'purchase_amount']])
# Removing duplicate rows
data = data.drop_duplicates()
# Correcting inconsistent date formats
data['date_of_purchase'] = pd.to_datetime(data['date_of_purchase'], errors='coerce')
print(data)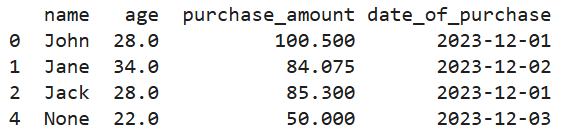
ऊपर दिए गए कोड का आउटपुट
चरण 2: डेटा इंटीग्रेशन
डेटा इंटीग्रेशन में कई स्रोतों से डेटा को मिलाकर एक एकीकृत डेटासेट बनाना शामिल है। जब डेटा अलग-अलग सोर्स सिस्टम्स से एकत्र होता है, तो यह अक्सर आवश्यक होता है।
डेटा इंटीग्रेशन में उपयोग की जाने वाली कुछ तकनीकें इस प्रकार हैं:
- स्कीमा मैचिंग: अलग-अलग स्रोतों के फ़ील्ड्स और डेटा संरचनाओं को एकसमान करने के लिए संरेखित करना।
- डेटा डिडुप्लीकेशन: कई डेटासेट्स में डुप्लिकेट एंट्रीज की पहचान करना और उन्हें हटाना।
उदाहरण के लिए, मान लीजिए हमारे पास कई डाटाबेस से ग्राहक डेटा है। हम इसे एकल दृश्य में इस प्रकार मर्ज करेंगे:
# Creating two manual datasets
data1 = pd.DataFrame({
'customer_id': [1, 2, 3],
'name': ['John', 'Jane', 'Jack'],
'age': [28, 34, 29]
})
data2 = pd.DataFrame({
'customer_id': [1, 3, 4],
'purchase_amount': [100.5, 85.3, 45.0],
'purchase_date': ['2023-12-01', '2023-12-02', '2023-12-03']
})
# Merging datasets on a common key 'customer_id'
merged_data = pd.merge(data1, data2, on='customer_id', how='inner')
print(merged_data)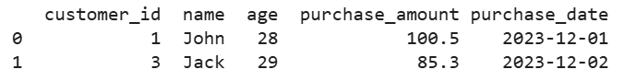
ऊपर दिए गए कोड का आउटपुट
चरण 3: डेटा ट्रांसफॉर्मेशन
डेटा ट्रांसफॉर्मेशन, डेटा को ऐसे प्रारूपों में बदलता है जो विश्लेषण, मशीन लर्निंग या माइनिंग के लिए उपयुक्त हों।
उदाहरण के लिए:
- स्केलिंग और नॉर्मलाइजेशन: संख्यात्मक मानों को एक सामान्य स्केल पर समायोजित करना, जो उन एल्गोरिद्म के लिए अक्सर आवश्यक होता है जो डिस्टेंस मैट्रिक्स पर निर्भर करते हैं।
- श्रेणीबद्ध वेरिएबल्स का एन्कोडिंग: श्रेणीबद्ध डेटा को वन-हॉट या लेबल एन्कोडिंग तकनीकों का उपयोग करके संख्यात्मक मानों में बदलना।
- फ़ीचर इंजीनियरिंग और एक्सट्रैक्शन: नए फ़ीचर्स बनाना या महत्वपूर्ण फ़ीचर्स का चयन करना ताकि मॉडल का प्रदर्शन बेहतर हो।
यह scikit-learn का उपयोग करते हुए पायथन में इस तरह दिखता है:
from sklearn.preprocessing import StandardScaler, OneHotEncoder
# Creating a manual dataset
data = pd.DataFrame({
'category': ['A', 'B', 'A', 'C', 'B'],
'numeric_column': [10, 15, 10, 20, 15]
})
# Scaling numeric data
scaler = StandardScaler()
data['scaled_numeric_column'] = scaler.fit_transform(data[['numeric_column']])
# Encoding categorical variables using one-hot encoding
encoder = OneHotEncoder(sparse_output=False)
encoded_data = pd.DataFrame(encoder.fit_transform(data[['category']]),
columns=encoder.get_feature_names_out(['category']))
# Concatenating the encoded data with the original dataset
data = pd.concat([data, encoded_data], axis=1)
print(data)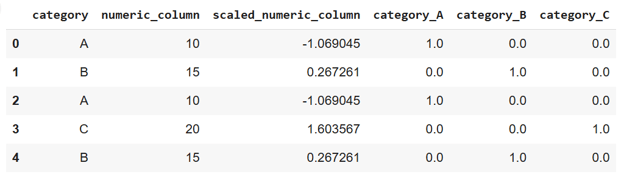
ऊपर दिए गए कोड का आउटपुट
चरण 4: डेटा रिडक्शन
डेटा रिडक्शन, फीचर्स या रिकॉर्ड्स की संख्या घटाकर डेटासेट को सरल बनाता है, जबकि आवश्यक जानकारी सुरक्षित रखता है। इससे विश्लेषण और मॉडल प्रशिक्षण तेज होता है, बिना सटीकता के साथ समझौता किए।
डेटा रिडक्शन की तकनीकें शामिल हैं:
- फ़ीचर सिलेक्शन: वे सबसे महत्वपूर्ण फ़ीचर्स चुनना जो विश्लेषण या मॉडल के प्रदर्शन में योगदान देते हैं।
- प्रिंसिपल कंपोनेंट एनालिसिस (PCA): एक डायमेंशनलिटी रिडक्शन टेकनीक जो डेटा को कम-आयामी स्पेस में ट्रांसफॉर्म करती है।
- सैंपलिंग विधियाँ: प्रतिनिधि सैंपल्स का चयन करके डेटासेट का आकार घटाना, जो बड़े डेटासेट संभालने में उपयोगी होता है।
और पायथन में डायमेंशनलिटी रिडक्शन इस तरह लागू करते हैं:
from sklearn.decomposition import PCA
from sklearn.feature_selection import SelectKBest, chi2
# Creating a manual dataset
data = pd.DataFrame({
'feature1': [10, 20, 30, 40, 50],
'feature2': [1, 2, 3, 4, 5],
'feature3': [100, 200, 300, 400, 500],
'target': [0, 1, 0, 1, 0]
})
# Feature selection using SelectKBest
selector = SelectKBest(chi2, k=2)
selected_features = selector.fit_transform(data[['feature1', 'feature2', 'feature3']], data['target'])
# Printing selected features
print("Selected features (SelectKBest):")
print(selected_features)
# Dimensionality reduction using PCA
pca = PCA(n_components=2)
pca_data = pca.fit_transform(data[['feature1', 'feature2', 'feature3']])
# Printing PCA results
print("PCA reduced data:")
print(pca_data)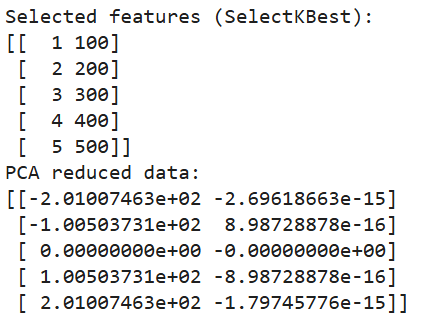
ऊपर दिए गए कोड का आउटपुट
उदाहरणों सहित डेटा प्रीप्रोसेसिंग की सामान्य तकनीकें
हमने स्थापित किया है कि कच्चे डेटा का प्रीप्रोसेसिंग करना आवश्यक है ताकि वह विश्लेषण या मशीन लर्निंग मॉडलों के लिए उपयुक्त हो। हमने इस प्रक्रिया से जुड़े चरण भी कवर किए हैं।
इस खंड में, हम प्रीप्रोसेसिंग चरण के दौरान आने वाली सामान्य समस्याओं से निपटने के लिए विभिन्न तकनीकों का अन्वेषण करेंगे। साथ ही, हम डेटा ऑग्मेंटेशन पर भी चर्चा करेंगे, जोकि छवि या पाठ डेटासेट जैसे विशिष्ट संदर्भों में सिंथेटिक डेटा बनाने की एक उपयोगी तकनीक है।
मिसिंग डेटा को संभालना
मिसिंग डेटा, मशीन लर्निंग मॉडल या विश्लेषण के प्रदर्शन पर नकारात्मक प्रभाव डाल सकता है। मिसिंग वैल्यूज़ को प्रभावी ढंग से संभालने के लिए कई रणनीतियाँ हैं:
- इम्प्यूटेशन: इस तकनीक में मिसिंग वैल्यूज़ को किसी गणना किए गए अनुमान, जैसे उपलब्ध डेटा के औसत, माध्यिका या मोड से भरना शामिल है। उन्नत विधियों में प्रिडिक्टिव मॉडलिंग शामिल है, जहाँ डेटा के भीतर संबंधों के आधार पर मिसिंग वैल्यूज़ की भविष्यवाणी की जाती है।
# Note: This is dummy code and not expected to run on its own
from sklearn.impute import SimpleImputer
imputer = SimpleImputer(strategy='mean') # Replace 'mean' with 'median' or 'most_frequent' if needed
data['column_with_missing'] = imputer.fit_transform(data[['column_with_missing']])- डिलीशन: मिसिंग वैल्यू वाली पंक्तियों या स्तंभों को हटाना एक सीधा समाधान है। हालांकि, इसे सावधानी से उपयोग करना चाहिए, क्योंकि यदि कई एंट्रीज़ गायब हों तो यह मूल्यवान डेटा के नुकसान का कारण बन सकता है।
data.dropna(inplace=True) # Removes rows with any missing values- मिसिंग वैल्यूज़ का मॉडलिंग: जहाँ मिसिंग डेटा का पैटर्न अधिक जटिल होता है, वहाँ मशीन लर्निंग मॉडल, डेटासेट के शेष हिस्से के आधार पर मिसिंग वैल्यूज़ की भविष्यवाणी कर सकते हैं। इससे विभिन्न वेरिएबल्स के बीच संबंधों को शामिल करके सटीकता में सुधार हो सकता है।
आउटलायर का पता लगाना और हटाना
आउटलायर वे चरम मान होते हैं जो बाकी डेटा से काफी भिन्न होते हैं, और मिसिंग वैल्यूज़ की तरह, विश्लेषण और मॉडल के प्रदर्शन को विकृत कर सकते हैं। आउटलायर का पता लगाने और संभालने के लिए विभिन्न तकनीकें इस्तेमाल की जा सकती हैं:
- Z-स्कोर विधि: यह तरीका मापता है कि कोई डेटा पॉइंट औसत से कितने मानक विचलन दूर है। एक निश्चित सीमा (जैसे, ±3 मानक विचलन) से परे के डेटा पॉइंट्स को आउटलायर माना जा सकता है।
# Note: this is dummy code.
# It won’t work unless a data with a column named “column” is imported
from scipy import stats
z_scores = stats.zscore(data['column']) outliers = abs(z_scores) > 3 # Identifying outliers- इंटरक्वार्टाइल रेंज (IQR): IQR, प्रथम क्वार्टाइल (Q1) और तृतीय क्वार्टाइल (Q3) के बीच की रेंज है। Q3 से 1.5 गुना IQR से ऊपर या Q1 से नीचे के मान आउटलायर माने जाते हैं।
Q1 = data['column'].quantile(0.25)
Q3 = data['column'].quantile(0.75)
IQR = Q3 - Q1
outliers = (data['column'] < (Q1 - 1.5 * IQR)) | (data['column'] > (Q3 + 1.5 * IQR))- दृश्य तकनीकें: बॉक्स प्लॉट, स्कैटर प्लॉट या हिस्टोग्राम जैसी विज़ुअलाइजेशन विधियाँ, डेटासेट में आउटलायर का पता लगाने में मदद कर सकती हैं। पहचान होने पर, उनके प्रभाव के अनुसार आउटलायर को हटाया या ट्रांसफॉर्म किया जा सकता है।
डेटा एन्कोडिंग
श्रेणीबद्ध डेटा के साथ काम करते समय, मशीन लर्निंग एल्गोरिद्म द्वारा प्रोसेस किए जा सकने वाले संख्यात्मक प्रतिनिधित्वों में श्रेणियों को बदलने के लिए एन्कोडिंग आवश्यक है। सामान्य एन्कोडिंग तकनीकें शामिल हैं:
- वन-हॉट एन्कोडिंग: जैसा पहले उल्लेख किया, यह विधि प्रत्येक श्रेणी के लिए बाइनरी कॉलम बनाती है।
from sklearn.preprocessing import OneHotEncoder
encoder = OneHotEncoder(sparse_output=False)
encoded_data = encoder.fit_transform(data[['categorical_column']])- लेबल एन्कोडिंग: लेबल एन्कोडिंग प्रत्येक श्रेणी को एक अद्वितीय संख्यात्मक मान सौंपता है। हालांकि, यदि श्रेणियों का स्वाभाविक क्रम नहीं है, तो यह विधि अनजाने में क्रम संबंध ला सकती है।
from sklearn.preprocessing import LabelEncoder
le = LabelEncoder()
data['encoded_column'] = le.fit_transform(data['categorical_column'])- ऑर्डिनल एन्कोडिंग: जब श्रेणीबद्ध वेरिएबल्स में अंतर्निहित क्रम होता है, जैसे लो, मीडियम और हाई, तब ऑर्डिनल एन्कोडिंग का उपयोग होता है। प्रत्येक श्रेणी को उसके रैंकिंग को दर्शाने वाले संबंधित पूर्णांक मान से मैप किया जाता है।
from sklearn.preprocessing import OrdinalEncoder
oe = OrdinalEncoder(categories=[['low', 'medium', 'high']])
data['ordinal_column'] = oe.fit_transform(data[['ordinal_column']])डेटा स्केलिंग और नॉर्मलाइजेशन
स्केलिंग और नॉर्मलाइजेशन सुनिश्चित करते हैं कि संख्यात्मक फ़ीचर्स समान स्केल पर हों, जो विशेष रूप से उन एल्गोरिद्म के लिए महत्वपूर्ण है जो डिस्टेंस मैट्रिक्स पर निर्भर करते हैं (जैसे, k-nearest neighbors, SVMs)।
- मिन-मैक्स स्केलिंग: यह तकनीक डेटा को निर्दिष्ट रेंज, आमतौर पर 0 से 1 तक, में स्केल करती है। जब सभी फ़ीचर्स को समान स्केल पर लाना हो, तो यह उपयोगी है।
from sklearn.preprocessing import MinMaxScaler
scaler = MinMaxScaler()
data[['scaled_column']] = scaler.fit_transform(data[['numeric_column']])- स्टैंडर्डाइजेशन (Z-स्कोर नॉर्मलाइजेशन): यह विधि डेटा को इस प्रकार स्केल करती है कि औसत 0 और मानक विचलन 1 हो जाए, जिससे सामान्य रूप से वितरित फ़ीचर्स के साथ मॉडल बेहतर प्रदर्शन करते हैं।
from sklearn.preprocessing import StandardScaler
scaler = StandardScaler()
data[['standardized_column']] = scaler.fit_transform(data[['numeric_column']])डेटा ऑग्मेंटेशन
डेटा ऑग्मेंटेशन, नए सिंथेटिक उदाहरण बनाकर कृत्रिम रूप से डेटासेट का आकार बढ़ाने की तकनीक है। यह विशेष रूप से डीप लर्निंग मॉडलों में छवि या पाठ डेटासेट के लिए उपयोगी है, जहाँ मजबूत मॉडल प्रदर्शन के लिए बड़े पैमाने पर डेटा की आवश्यकता होती है।
- इमेज ऑग्मेंटेशन: छवियों को घुमाना, पलटना, स्केल करना या उनमें नॉइज़ जोड़ना जैसी तकनीकें ऐसी विविधताएँ बनाती हैं जो मॉडल की सामान्यीकरण क्षमता में सुधार करती हैं।
from tensorflow.keras.preprocessing.image import ImageDataGenerator
datagen = ImageDataGenerator(
rotation_range=40,
width_shift_range=0.2,
height_shift_range=0.2,
shear_range=0.2,
zoom_range=0.2,
horizontal_flip=True,
fill_mode='nearest')
augmented_images = datagen.flow_from_directory('image_directory', target_size=(150, 150))- टेक्स्ट ऑग्मेंटेशन: पाठ डेटा के लिए, तरीकों में समानार्थी शब्दों का प्रतिस्थापन, रैंडम इंसर्शन, और बैक-ट्रांसलेशन शामिल हैं, जिसमें एक वाक्य को किसी अन्य भाषा में अनुवादित कर फिर मूल भाषा में वापस अनुवादित किया जाता है, जिससे विविधताएँ आती हैं।
import nlpaug.augmenter.word as naw
# install nlpaug here: https://github.com/makcedward/nlpaug
aug = naw.SynonymAug(aug_src='wordnet')
augmented_text = aug.augment("This is a sample text for augmentation.")डेटा प्रीप्रोसेसिंग के टूल
हालाँकि आप शुद्ध पायथन कोड से डेटा प्रोसेसिंग लागू कर सकते हैं, विभिन्न कार्यों को संभालने और संपूर्ण प्रक्रिया को अधिक कुशल बनाने के लिए शक्तिशाली टूल विकसित किए गए हैं। यहाँ कुछ उदाहरण हैं:
पायथन लाइब्रेरीज़
पायथन में डेटा प्रीप्रोसेसिंग के लिए कई विशेषीकृत लाइब्रेरीज़ हैं। यहाँ 3 सबसे लोकप्रिय हैं:
- Pandas: पायथन की सबसे आम तौर पर उपयोग की जाने वाली लाइब्रेरी डेटा मैनिपुलेशन और क्लीनिंग के लिए। यह लचीली डेटा संरचनाएँ प्रदान करती है, मुख्यतः DataFrame और Series, जो आपको संरचित डेटा को कुशलता से संभालने और मैनिपुलेट करने में सक्षम बनाती हैं। Pandas, मिसिंग डेटा संभालना, डेटासेट्स मर्ज करना, डेटा फ़िल्टर करना और रिसेपिंग जैसे ऑपरेशन्स सपोर्ट करता है।
import pandas as pd
# Load a sample dataset
data = pd.DataFrame({
'name': ['John', 'Jane', 'Jack'],
'age': [28, 31, 34]
})
print(data)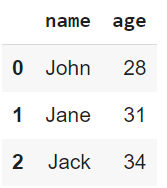
ऊपर दिए गए कोड का आउटपुट
- NumPy: संख्यात्मक कंप्यूटेशन्स के लिए एक बुनियादी लाइब्रेरी। यह बड़े, बहु-आयामी एरेज़ और मैट्रिसेज़ तथा उन पर ऑपरेट करने के लिए गणितीय फ़ंक्शन्स सपोर्ट करता है। NumPy अक्सर कई उच्च-स्तरीय डेटा प्रोसेसिंग लाइब्रेरीज़, जैसे Pandas, की नींव होता है।
import numpy as np
# Create an array and perform element-wise operations
array = np.array([1, 2, 3, 4])
squared_array = np.square(array)
print(squared_array)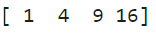
ऊपर दिए गए कोड का आउटपुट
- Scikit-learn: मशीन लर्निंग कार्यों के लिए व्यापक रूप से उपयोग की जाती है और साथ ही स्केलिंग, एन्कोडिंग और डेटा ट्रांसफॉर्मेशन जैसी कई प्रीप्रोसेसिंग यूटिलिटीज़ भी प्रदान करती है। इसका प्रीप्रोसेसिंग मॉड्यूल श्रेणीबद्ध डेटा संभालने, संख्यात्मक डेटा स्केल करने, फ़ीचर एक्सट्रैक्शन आदि के लिए टूल्स प्रदान करता है।
from sklearn.preprocessing import StandardScaler
# Standardize data
data = [[10, 2], [15, 5], [20, 3]]
scaler = StandardScaler()
scaled_data = scaler.fit_transform(data)
print(scaled_data)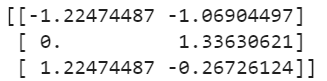
ऊपर दिए गए कोड का आउटपुट
क्लाउड प्लेटफ़ॉर्म
ऑन-प्रिमाइज़ सिस्टम बड़े डेटासेट्स को प्रभावी ढंग से संभाल नहीं पाते। ऐसी स्थितियों में, क्लाउड प्लेटफ़ॉर्म स्केलेबल और कुशल समाधान प्रदान करते हैं, जो वितरित सिस्टम्स में विशाल मात्रा में डेटा प्रोसेस करने में सक्षम बनाते हैं।
विचार करने के लिए कुछ क्लाउड प्लेटफ़ॉर्म टूल्स में शामिल हैं:
- AWS Glue: Amazon Web Services द्वारा उपलब्ध एक पूर्ण-प्रबंधित ETL सेवा। यह स्वतः डेटा की खोज और संगठन करता है तथा उसे एनालिटिक्स के लिए तैयार करता है। Glue डेटा कैटलॉगिंग सपोर्ट करता है और S3 तथा Redshift जैसे AWS सेवाओं से कनेक्ट हो सकता है।
- Azure Data Factory: माइक्रोसॉफ्ट की क्लाउड-आधारित डेटा इंटीग्रेशन सेवा। यह बड़े पैमाने के डेटा के लिए ETL और ELT पाइपलाइंस बनाने का समर्थन करती है। Azure Data Factory उपयोगकर्ताओं को विभिन्न सेवाओं के बीच डेटा स्थानांतरित करने, ट्रांसफॉर्मेशन्स का उपयोग करके उसे प्रीप्रोसेस करने और एक विज़ुअल इंटरफ़ेस के माध्यम से वर्कफ़्लोज़ को ऑर्केस्ट्रेट करने की अनुमति देती है।
ऑटोमेशन टूल्स
प्रीप्रोसेसिंग के दोहराए जाने वाले चरणों को स्वचालित करना समय बचा सकता है और त्रुटियाँ घटा सकता है – खासकर जब मशीन लर्निंग मॉडलों और बड़े डेटासेट्स से निपटना हो। यहाँ कुछ टूल्स हैं जो बिल्ट-इन प्रीप्रोसेसिंग पाइपलाइंस प्रदान करते हैं:
- AutoML प्लेटफ़ॉर्म: AutoML का अर्थ Automated Machine Learning है (और नाम ही इसका अर्थ बताता है)। दूसरे शब्दों में, ये प्लेटफ़ॉर्म मशीन लर्निंग वर्कफ़्लो के कई चरणों को स्वचालित करते हैं। प्लेटफ़ॉर्म्स जैसे Google का AutoML, Microsoft का Azure AutoML, और H2O.ai का AutoML न्यूनतम उपयोगकर्ता हस्तक्षेप के साथ फ़ीचर चयन, डेटा ट्रांसफॉर्मेशन और मॉडल चयन जैसे कार्यों को संभालने वाली स्वचालित पाइपलाइंस प्रदान करते हैं।
- scikit-learn में प्रीप्रोसेसिंग पाइपलाइंस: Scikit-learn का Pipeline क्लास प्रीप्रोसेसिंग चरणों को सुव्यवस्थित और स्वचालित करने में मदद करता है। यह आपको कई प्रीप्रोसेसिंग ऑपरेशन्स को एकल, निष्पादन योग्य वर्कफ़्लो में जोड़ने देता है, जिससे यह सुनिश्चित होता है कि प्रीप्रोसेसिंग कार्य लगातार लागू हों:
from sklearn.pipeline import Pipeline
from sklearn.preprocessing import StandardScaler, OneHotEncoder
from sklearn.impute import SimpleImputer
from sklearn.compose import ColumnTransformer
# Example Pipeline combining different preprocessing tasks
numeric_transformer = Pipeline(steps=[
('imputer', SimpleImputer(strategy='mean')),
('scaler', StandardScaler())
])
categorical_transformer = Pipeline(steps=[
('imputer', SimpleImputer(strategy='most_frequent')),
('encoder', OneHotEncoder())
])
preprocessor = ColumnTransformer(transformers=[
('num', numeric_transformer, ['age']),
('cat', categorical_transformer, ['category'])
])
preprocessed_data = preprocessor.fit_transform(data)डेटा प्रीप्रोसेसिंग के लिए सर्वोत्तम प्रथाएँ
अपने प्रीप्रोसेसिंग प्रयासों की प्रभावशीलता को अधिकतम करने के लिए सर्वोत्तम प्रथाओं का पालन करना आवश्यक है। यही कहते हुए, नीचे कुछ प्रथाएँ दी गई हैं जिन्हें मैं अपनाने के लिए प्रोत्साहित करूंगा:
डेटा को समझें
प्रीप्रोसेसिंग शुरू करने से पहले, डेटासेट को अच्छी तरह से समझना महत्वपूर्ण है। एक्सप्लोरेटरी डेटा एनालिसिस करें ताकि वर्तमान डेटा की संरचना की पहचान हो सके। विशेष रूप से, आपको जो समझना है, वह है:
- मुख्य फ़ीचर्स
- संभावित विसंगतियाँ
- संबंध
यदि आप पहले डेटासेट की विशेषताओं को नहीं समझते, तो संभव है कि आप गलत प्रीप्रोसेसिंग विधियाँ लागू कर दें, जिससे डेटा विकृत हो सकता है।
दोहराए जाने वाले चरणों को स्वचालित करें
प्रीप्रोसेसिंग में अक्सर दोहराए जाने वाले कार्य शामिल होते हैं। पाइपलाइंस बनाकर इन कार्यों को स्वचालित करने से सुसंगति और दक्षता सुनिश्चित होती है तथा मैन्युअल त्रुटियों की आशंका घटती है। वर्कफ़्लोज़ को सुव्यवस्थित करने के लिए scikit-learn या क्लाउड-आधारित प्लेटफ़ॉर्म्स में पाइपलाइंस का लाभ उठाएँ।
प्रीप्रोसेसिंग चरणों का दस्तावेज़ीकरण करें
स्पष्ट दस्तावेज़ीकरण से दो उद्देश्यों की पूर्ति होती है:
- पुनरुत्पादनक्षम बनाना
- समझ बनाना (खुद के लिए बाद में या अपनी टीम के अन्य सदस्यों के लिए)।
हर निर्णय, ट्रांसफॉर्मेशन या फ़िल्टरिंग चरण, और उसके पीछे का कारण दर्ज होना चाहिए। इससे टीम सदस्यों के बीच सहयोग में काफी सुधार होगा और आपको प्रोजेक्ट्स को वहीं से दोबारा उठाने में मदद मिलेगी जहाँ आप छोड़कर गए थे।
पुनरावृत्त सुधार
डेटा प्रीप्रोसेसिंग एक बार का कार्य नहीं है – यह एक पुनरावृत्त प्रक्रिया है। जैसे-जैसे मॉडल विकसित होते हैं और अपने प्रदर्शन पर फीडबैक देते हैं, इस जानकारी का उपयोग प्रीप्रोसेसिंग चरणों की समीक्षा और परिष्करण के लिए करें, क्योंकि इससे बेहतर परिणाम मिल सकते हैं। उदाहरण के लिए, फ़ीचर इंजीनियरिंग नए उपयोगी फ़ीचर्स प्रकट कर सकती है, या आउटलायर हैंडलिंग को ट्यून करने से मॉडल की सटीकता में सुधार हो सकता है – इस फीडबैक का उपयोग अपने प्रीप्रोसेसिंग चरणों को अपडेट करने के लिए करें।
निष्कर्ष
डेटा प्रीप्रोसेसिंग, किसी भी डेटा प्रोजेक्ट की सफलता में एक महत्वपूर्ण भूमिका निभाता है। उचित प्रीप्रोसेसिंग सुनिश्चित करता है कि कच्चा डेटा साफ-सुथरे, संरचित प्रारूप में परिवर्तित हो, जिससे मॉडल और विश्लेषण अधिक सटीक और अर्थपूर्ण अंतर्दृष्टि प्रदान करें।
इस लेख में, मैंने डेटा प्रीप्रोसेसिंग लागू करने में मदद करने वाली विभिन्न तकनीकें साझा की हैं। फिर भी, सबसे महत्वपूर्ण बात यह है कि यह प्रक्रिया एक बार का प्रयास नहीं, बल्कि एक पुनरावृत्त प्रक्रिया है! सतत परिष्करण से मॉडल प्रदर्शन में सुधार होता है और बेहतर निर्णय लेने में मदद मिलती है। अच्छी तरह तैयार किया गया डेटासेट किसी भी सफल डेटा AI पहल की नींव रखता है।
अपनी सीख जारी रखने के लिए, मैं निम्न उत्कृष्ट संसाधनों पर नज़र डालने की सलाह देता/देती हूँ:

आपके डेटा की गुणवत्ता सीधे आपके विश्लेषण की सटीकता और मॉडल के प्रदर्शन को प्रभावित करती है। क्यों? क्योंकि कच्चे डेटा में अक्सर असंगतियाँ, त्रुटियाँ और अप्रासंगिक जानकारी होती है, जो परिणामों को बिगाड़ सकती है और गलत निष्कर्षों तक ले जा सकती है। डेटा प्रीप्रोसेसिंग इस समस्या को कम करने का एक तरीका है। यानी, यह कच्चे डेटा को साफ-सुथरे, संरचित प्रारूप में बदलने की प्रक्रिया है।
इस ब्लॉग पोस्ट में, मैं कवर करूंगा:
चलिए शुरू करते हैं!
डेटा प्रीप्रोसेसिंग क्या है?
डेटा प्रीप्रोसेसिंग, डेटा तैयारी का एक मुख्य पहलू है। इसका अर्थ है कच्चे डेटा पर ऐसा कोई भी प्रोसेसिंग लागू करना जो उसे आगे के विश्लेषण या प्रोसेसिंग कार्यों के लिए तैयार कर दे।
पारंपरिक रूप से, डेटा प्रीप्रोसेसिंग डेटा विश्लेषण में एक आवश्यक प्रारंभिक चरण रहा है। हालांकि, हाल ही में, इन तकनीकों को मशीन लर्निंग और AI मॉडलों को प्रशिक्षित करने और उनसे निष्कर्ष निकालने के लिए भी अपनाया गया है।
इस प्रकार, डेटा प्रीप्रोसेसिंग को इस प्रक्रिया के रूप में परिभाषित किया जा सकता है जिसमें कच्चे डेटा को ऐसे प्रारूप में बदला जाता है जिसे निम्नलिखित कार्यों में अधिक कुशलता और सटीकता से प्रोसेस किया जा सके: