

Llama 3.3 क्या है?
Llama 3.3 Meta AI का नवीनतम बड़े भाषा मॉडल है, और हम इसे विविध प्रोजेक्ट्स के लिए उन्नत AI को अधिक सुलभ बनाने की दिशा में एक कदम के रूप में देखते हैं। 70 बिलियन पैरामीटर्स के साथ, यह कहीं बड़े Llama 3.1 405B के समकक्ष प्रदर्शन देता है, लेकिन हार्डवेयर आवश्यकताएँ काफी कम हैं। इसका मतलब है कि हम महंगे, विशेष सेटअप के बिना भी उन्नत AI एप्लिकेशंस का अन्वेषण कर सकते हैं।
मॉडल खास तौर पर टेक्स्ट इनपुट और आउटपुट के लिए बनाया गया है, इसलिए यह इमेज, ऑडियो या अन्य मीडिया को नहीं संभालता। हमने पाया है कि यह बहुभाषी चैट, कोडिंग सहायता और सिंथेटिक डेटा जेनरेशन जैसे कार्यों में विशेष रूप से प्रभावी है। अंग्रेजी, स्पेनिश, हिंदी और जर्मन सहित आठ भाषाओं के समर्थन के साथ, यह बहुभाषी क्षमताओं की आवश्यकता वाले प्रोजेक्ट्स के लिए एक मजबूत विकल्प है।
जो बात हमें खास लगती है, वह है इसकी दक्षता पर फोकस। Llama 3.3 आम GPUs पर चलाने के लिए ऑप्टिमाइज़्ड है, जिससे लोकल डिप्लॉयमेंट व्यावहारिक हो जाता है और प्रयोग करना आसान। इसमें ऐसे एलाइनमेंट तकनीकें भी शामिल हैं जो प्रतिक्रियाओं को उपयोगी और सुरक्षित बनाए रखती हैं, जो संवेदनशील एप्लिकेशंस के लिए अनिवार्य है।
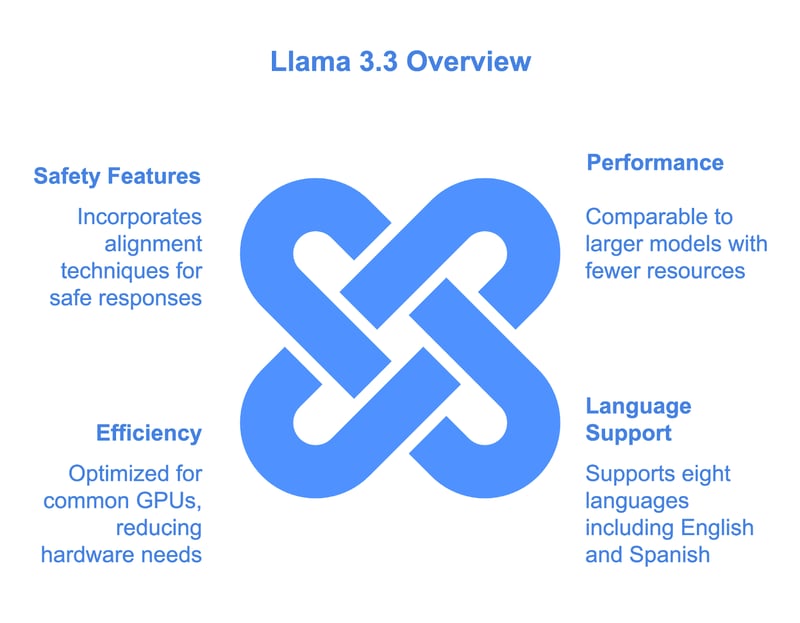
इस खंड में, हमने बताया कि Llama 3.3 क्या है, लेकिन अगले हिस्सों में हम और गहराई में जाएंगे। हम कवर करेंगे कि यह कैसे काम करता है, इसे कैसे इस्तेमाल शुरू करें, और बेंचमार्क्स में इसका प्रदर्शन कैसा है, ताकि आप तय कर सकें कि यह आपके काम के लिए सही है या नहीं।
Llama 3.3 कैसे काम करता है?
यहाँ बताया गया है कि Llama 3.3 कैसे काम करता है—चाहे आप बड़े भाषा मॉडलों से परिचित हों या अभी शुरुआत कर रहे हों, हम उम्मीद करते हैं यह व्याख्या सहज लगेगी।
आर्किटेक्चर: कुशल और स्केलेबल
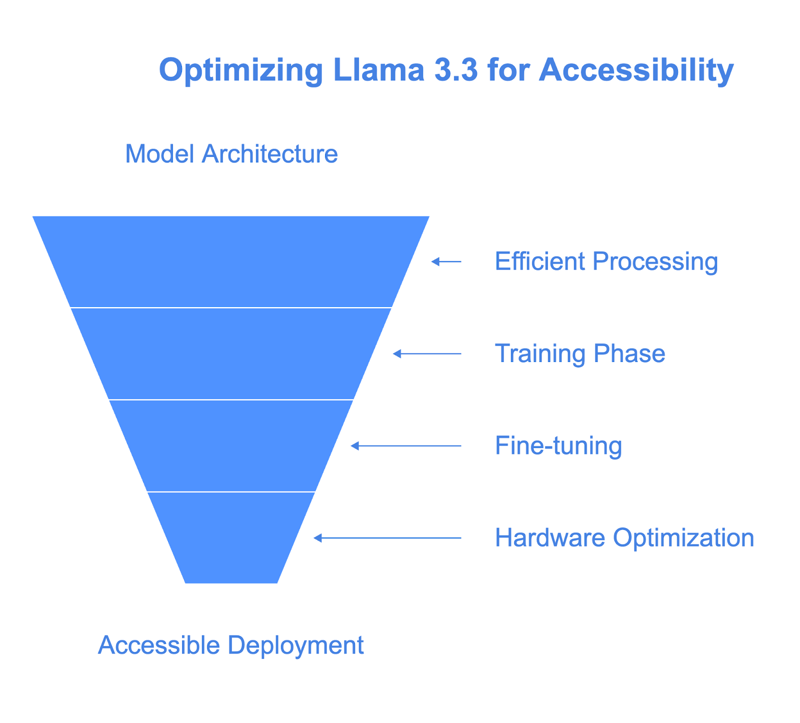
Llama 3.3 के केंद्र में ट्रांसफॉर्मर-आधारित आर्किटेक्चर है, जिसमें 70 बिलियन पैरामीटर्स हैं। यदि आप परिचित नहीं हैं, तो पैरामीटर्स मूलतः वे “नॉब्स” हैं जिन्हें मॉडल प्रशिक्षण के दौरान समायोजित करता है ताकि टेक्स्ट में पैटर्न और संबंध सीख सके। यही Llama 3.3 को सुसंगत और प्रसंगानुकूल जवाब जनरेट करने में सक्षम बनाता है।
Llama 3.3 की खास बात इसका Grouped-Query Attention (GQA) का उपयोग है। इससे मॉडल टेक्स्ट को तेज़ी से और कम कंप्यूटेशनल संसाधनों के साथ प्रोसेस कर पाता है। इसलिए यह कहीं बड़े Llama 3.1 405B जैसा प्रदर्शन दे पाता है, जबकि हार्डवेयर पर मांग बहुत कम रखता है।
ट्रेनिंग और फाइन-ट्यूनिंग
Llama 3.3 जैसे मॉडल को ट्रेन करना एक विशाल डेटासेट—सार्वजनिक रूप से उपलब्ध स्रोतों से 15 ट्रिलियन टोकन्स—से शुरू होता है। इससे मॉडल को भाषा और ज्ञान की व्यापक समझ मिलती है।
लेकिन हम जानते हैं कि कच्ची ट्रेनिंग वास्तविक दुनिया के उपयोग में पर्याप्त नहीं होती। यहीं फाइन-ट्यूनिंग काम आती है:
- सुपरवाइज्ड फाइन-ट्यूनिंग (SFT): यहाँ, मॉडल अच्छे उत्तरों के सावधानी से चुने गए उदाहरणों से सीखता है। इसे ऐसे समझें मानो इसके लिए “गोल्ड स्टैंडर्ड” तय किया जा रहा हो।
- मानव फीडबैक के साथ रिइनफोर्समेंट लर्निंग (RLHF): इसमें मॉडल के प्रदर्शन पर मनुष्यों से फीडबैक एकत्र कर उसके व्यवहार को और परिष्कृत किया जाता है।
यह द्वि-पद्धति Llama 3.3 को उपयोगिता और सुरक्षा—दोनों के लिहाज से मानव अपेक्षाओं के अनुरूप बनाती है।
सुलभ हार्डवेयर के लिए डिज़ाइन
Llama 3.3 को आम डेवलपर वर्कस्टेशंस पर लोकल रूप से चलने के लिए डिज़ाइन किया गया है, जिससे एंटरप्राइज़-स्तरीय इन्फ्रास्ट्रक्चर के बिना भी डेवलपर्स इसे एक्सेस कर सकें। Llama 3.1 405B जैसे बड़े मॉडलों के विपरीत, यह काफी कम कंप्यूटेशनल शक्ति मांगते हुए भी मजबूत प्रदर्शन बनाए रखता है।
यह दक्षता मुख्य रूप से Grouped-Query Attention (GQA) के कारण है, जो मेमोरी उपयोग घटाकर और इन्फेरेंस तेज करके टेक्स्ट प्रोसेसिंग को ऑप्टिमाइज़ करता है।
मॉडल क्वांटाइज़ेशन तकनीकों का भी समर्थन करता है, जैसे 8-बिट और 4-बिट प्रिसीजन, bitsandbytes जैसे टूल्स के माध्यम से। ये तकनीकें मेमोरी की जरूरतों को काफी घटाती हैं, वह भी प्रदर्शन में बहुत कम समझौते के साथ।
साथ ही, यह एकल GPU से लेकर डिस्ट्रीब्यूटेड सिस्टम तक, विभिन्न हार्डवेयर सेटअप्स पर अच्छी तरह स्केल करता है, जिससे लोकल प्रयोगों से लेकर बड़े डिप्लॉयमेंट तक लचीलापन मिलता है।
व्यवहार में, इसका मतलब है कि हम अधिक किफायती हार्डवेयर सेटअप्स पर Llama 3.3 के साथ प्रयोग कर सकते हैं या इसे डिप्लॉय कर सकते हैं, और आमतौर पर उन्नत AI मॉडलों से जुड़ी ऊंची लागतों से बच सकते हैं। यह उन डेवलपर्स और टीमों के लिए व्यावहारिक विकल्प है जो प्रदर्शन और सुलभता के बीच संतुलन चाहते हैं।
Llama 3.3 बेंचमार्क्स
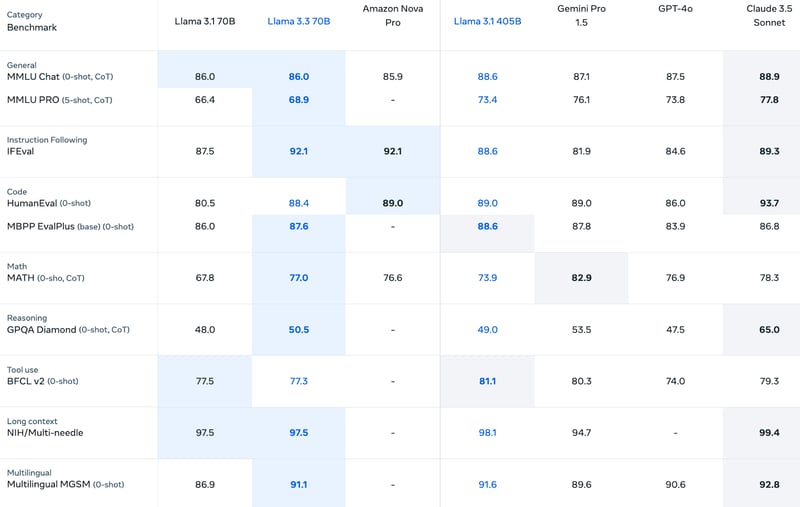
Llama 3.3 विभिन्न बेंचमार्क्स पर अच्छा प्रदर्शन करता है, खासकर इंस्ट्रक्शन फॉलोइंग, कोडिंग और बहुभाषी रीज़निंग में। यद्यपि यह Llama 3.1 405B या Claude 3.5 Sonnet जैसे बड़े मॉडलों को लगातार मात नहीं देता, फिर भी यह अधिकांश श्रेणियों में भरोसेमंद और प्रतिस्पर्धी परिणाम देता है। विविध कार्यों को प्रभावी ढंग से संभालने वाले एक संतुलित मॉडल की तलाश कर रहे डेवलपर्स के लिए Llama 3.3 एक मजबूत विकल्प है।
सामान्य ज्ञान और रीज़निंग
सामान्य ज्ञान वाले कार्यों में, Llama 3.3 ठोस परिणाम देता है। यह MMLU Chat (0-shot, CoT) पर 86.0 स्कोर हासिल करता है, जो इसके पूर्ववर्ती Llama 3.1 70B के बराबर है और Amazon Nova Pro (85.9) के साथ प्रतिस्पर्धी बना रहता है। हालांकि, यह बड़े Llama 3.1 405B (88.6) और Claude 3.5 Sonnet (88.9) से थोड़ा पीछे है।
और अधिक चुनौतीपूर्ण MMLU PRO (5-shot, CoT) बेंचमार्क पर, Llama 3.3 68.9 का स्कोर लेकर Llama 3.1 70B से बेहतर करता है, लेकिन Llama 3.1 405B (73.4) और Claude 3.5 Sonnet (77.8) दोनों से पीछे रहता है।
रीज़निंग कार्यों के लिए, Llama 3.3 GPQA Diamond (0-shot, CoT) पर 50.5 स्कोर करता है, जो Llama 3.1 70B (48.0) से थोड़ा बेहतर है। यद्यपि यह Claude 3.5 Sonnet (65.0) जैसे कुछ प्रतिद्वंद्वियों से पीछे है, फिर भी यह संरचित रीज़निंग में कुछ प्रगति दर्शाता है।
इंस्ट्रक्शन का पालन
Llama 3.3 इंस्ट्रक्शन-फॉलोइंग कार्यों में उत्कृष्ट है, IFEval पर 92.1 स्कोर करता है, जो यह मापता है कि मॉडल उपयोगकर्ता के निर्देशों का कितना अच्छी तरह पालन करता है। यह परिणाम Llama 3.1 405B (88.6) और GPT-4o (84.6) से इसे आगे रखता है, और Claude 3.5 Sonnet (89.3) के करीब लाता है। इस श्रेणी में इसका प्रदर्शन इसकी एलाइनमेंट क्षमताओं को उजागर करता है, जो चैटबोट्स और टास्क-विशिष्ट असिस्टेंट्स जैसे एप्लिकेशंस के लिए महत्वपूर्ण हैं।
कोडिंग क्षमताएँ
कोडिंग बेंचमार्क्स Llama 3.3 की विशेष ताकत हैं। HumanEval (0-shot) पर यह 88.4 स्कोर करता है, जो Llama 3.1 405B (89.0) से थोड़ा पीछे और Gemini Pro 1.5 के बराबर है। इसी तरह, MBPP EvalPlus (base) में यह 87.6 हासिल करता है, जो Llama 3.1 70B (86.0) से थोड़ा बेहतर है। ये परिणाम कोड जनरेट करने और प्रोग्रामिंग-संबंधी कार्यों को हल करने में इसकी प्रभावशीलता की पुष्टि करते हैं।
गणित और प्रतीकात्मक रीज़निंग
प्रतीकात्मक रीज़निंग में, Llama 3.3 ने उल्लेखनीय प्रगति दिखाई है। यह MATH (0-shot, CoT) पर 77.0 स्कोर करता है, जो Llama 3.1 70B (67.8) और Amazon Nova Pro (76.6) से बेहतर है। हालांकि, यह Gemini Pro 1.5 (82.9) से पीछे रहता है। इस श्रेणी में शीर्ष पर न होते हुए भी, यह कई संरचित रीज़निंग कार्यों के लिए पर्याप्त अच्छा प्रदर्शन करता है।
बहुभाषी क्षमताएँ
बहुभाषी रीज़निंग में Llama 3.3 ने उल्लेखनीय मजबूती दिखाई है, MGSM (0-shot) पर 91.1 स्कोर के साथ। यह Llama 3.1 70B (86.9) से काफी सुधार है और इसे Claude 3.5 Sonnet (92.8) के करीब लाता है। इस श्रेणी में इसका प्रदर्शन अनुवाद और वैश्विक ग्राहक सहायता जैसे बहुभाषी एप्लिकेशंस के लिए इसे एक बेहतरीन विकल्प बनाता है।
टूल उपयोग और लंबा संदर्भ प्रदर्शन
टूल उपयोग के लिए, Llama 3.3 BFCL v2 (0-shot) पर 77.3 हासिल करता है, जो Llama 3.1 70B (77.5) के तुलनीय है लेकिन Llama 3.1 405B (81.1) से कम है। लंबे संदर्भ इनपुट को संभालने में, यह NIH/Multi-Needle पर 97.5 स्कोर करता है, जो Llama 3.1 70B के बराबर है और Llama 3.1 405B (98.1) से थोड़ा पीछे है। ये परिणाम टूल-असिस्टेड वर्कफ़्लोज़ और विस्तारित इनपुट परिदृश्यों के लिए मजबूत क्षमताओं को दर्शाते हैं।
Llama 3.3 के उपयोग के मामले
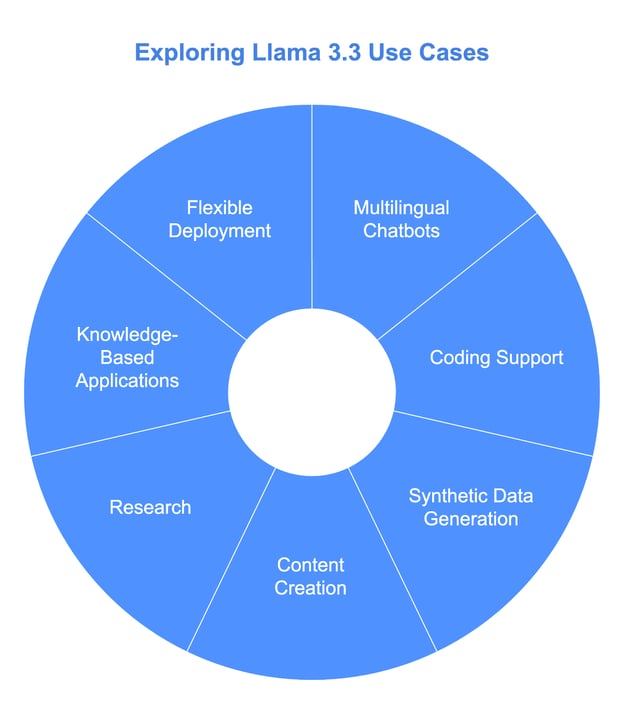
मजबूत प्रदर्शन और हार्डवेयर दक्षता के संतुलन के चलते Llama 3.3 डेवलपर्स और शोधकर्ताओं के लिए व्यापक संभावनाएँ खोलता है। हमें पसंद है कि यह मानक डेवलपर वर्कस्टेशंस पर प्रभावी ढंग से चलता है, जिससे एंटरप्राइज़-स्तरीय इन्फ्रास्ट्रक्चर के बिना भी यह एक सहज विकल्प बनता है। ये कुछ क्षेत्र हैं जहाँ यह उपयोगी हो सकता है।
1. बहुभाषी चैटबोट्स और असिस्टेंट्स
Llama 3.3 की ताकतों में से एक है इसकी कई भाषाएँ संभालने की क्षमता। अंग्रेजी, स्पेनिश, फ्रेंच और हिंदी सहित आठ कोर भाषाओं के समर्थन के साथ—यह बहुभाषी चैटबोट्स या वर्चुअल असिस्टेंट्स बनाने के लिए आदर्श है।
जो हमें खास लगता है वह यह कि शुरुआत करने के लिए आपको डेटा सेंटर की जरूरत नहीं। डेवलपर्स ग्राहक सहायता, शैक्षिक टूल्स या अन्य संवादात्मक एप्लिकेशंस के लिए अपने ही हार्डवेयर पर इन सिस्टम्स के प्रोटोटाइप और डिप्लॉयमेंट कर सकते हैं।
उदाहरण के लिए, हम Llama 3.3 का उपयोग ऐसे कस्टमर सर्विस चैटबोट बनाने में कर सकते हैं जो कई भाषाओं में प्रश्नों के उत्तर दे, वह भी एक सिंगल GPU पर कुशलतापूर्वक चलते हुए।
2. कोडिंग सपोर्ट और सॉफ्टवेयर डेवलपमेंट
HumanEval और MBPP EvalPlus जैसे कोडिंग बेंचमार्क्स पर मजबूत स्कोर के साथ, Llama 3.3 कोड जनरेट करने, डीबग करने, या आंशिक रूप से लिखी स्क्रिप्ट्स को पूरा करने के लिए एक भरोसेमंद सहायक है।
जो हमें विशेष रूप से उपयोगी लगता है, वह है इसका व्यक्तिगत हार्डवेयर पर अच्छा काम करना। महंगे क्लाउड सिस्टम्स पर निर्भर रहने के बजाय, आप Llama 3.3 को लोकल रूप से चलाकर दोहराए जाने वाले कार्यों को स्वचालित कर सकते हैं, बॉयलरप्लेट कोड बना सकते हैं, या यूनिट टेस्ट बना सकते हैं। टीमों या एकल डेवलपर्स के लिए, यह उन्नत AI कोडिंग सपोर्ट को व्यावहारिक और किफायती बनाता है।
3. सिंथेटिक डेटा जेनरेशन
एक और क्षेत्र जहाँ Llama 3.3 चमकता है, वह है सिंथेटिक डेटासेट्स बनाना। चाहे आप चैटबोट बना रहे हों, क्लासिफायर ट्रेन कर रहे हों, या किसी NLP प्रोजेक्ट पर काम कर रहे हों, उच्च-गुणवत्ता, लेबल्ड डेटा जनरेट करने की क्षमता समय और प्रयास दोनों बचा सकती है।
यह उपयोग-मामला हमें खासकर छोटी टीमों के लिए मूल्यवान लगता है जिन्हें डोमेन-विशिष्ट डेटा चाहिए, लेकिन उसे मैन्युअली एकत्र करने के संसाधन नहीं हैं। चूंकि Llama 3.3 डेवलपर-ग्रेड हार्डवेयर पर चलता है, आप लोकल रूप से डेटा जनरेट कर सकते हैं, लागत घटा सकते हैं और वर्कफ़्लो सरल बना सकते हैं।
4. बहुभाषी कंटेंट निर्माण और लोकलाइज़ेशन
Llama 3.3 की बहुभाषी क्षमताएँ इसे कंटेंट निर्माण के लिए भी मजबूत उम्मीदवार बनाती हैं। हमें इसमें लोकलाइज़्ड मार्केटिंग सामग्री तैयार करने, तकनीकी दस्तावेजों का अनुवाद करने, या बहुभाषी ब्लॉग बनाने की अच्छी संभावना दिखती है। डेवलपर्स मॉडल को फाइन-ट्यून कर इसके टोन या स्टाइल को अनुकूलित कर सकते हैं ताकि आउटपुट लक्षित दर्शकों से मेल खाए।
उदाहरण के लिए, आप Llama 3.3 का उपयोग कई भाषाओं में प्रोडक्ट विवरण का मसौदा तैयार करने के लिए कर सकते हैं, जिससे बिना समर्पित अनुवादक टीम के लोकलाइज़ेशन प्रक्रिया सुधरती है।
5. शोध और प्रयोग
शोधकर्ताओं के लिए, Llama 3.3 भाषा मॉडलिंग, एलाइनमेंट या फाइन-ट्यूनिंग तकनीकों की पड़ताल के लिए एक ठोस प्लेटफ़ॉर्म देता है। इसकी दक्षता इसे खास आकर्षक बनाती है—उन्नत AI के साथ प्रयोग करने के लिए आपको विशाल क्लाउड इन्फ्रास्ट्रक्चर की आवश्यकता नहीं।
यह शैक्षणिक प्रोजेक्ट्स या उद्योग शोध के लिए बेहतरीन टूल है, विशेषकर सेफ्टी एलाइनमेंट या डिस्टिलेशन के माध्यम से छोटे, विशिष्ट मॉडलों को ट्रेन करने जैसे क्षेत्रों में।
6. नॉलेज-आधारित एप्लिकेशंस
Llama 3.3 की मजबूत टेक्स्ट-प्रोसेसिंग क्षमताएँ प्रश्नोत्तर, सार-संक्षेपण और रिपोर्ट निर्माण जैसे एप्लिकेशंस के लिए भी उपयुक्त हैं। इन कार्यों में अक्सर बड़े पैमाने के टेक्स्ट को कुशलतापूर्वक संभालना पड़ता है—कुछ ऐसा जो Llama 3.3 व्यक्तिगत हार्डवेयर पर भी अच्छी तरह कर सकता है।
उदाहरण के लिए, हम इसका उपयोग ग्राहक फीडबैक का स्वत: सार निकालने या आंतरिक डॉक्यूमेंटेशन जनरेट करने में कर सकते हैं, जिससे समय की बचत होती है और सटीकता बनी रहती है।
7. छोटी टीमों के लिए लचीला डिप्लॉयमेंट
अंततः, हमें लगता है कि Llama 3.3 स्टार्टअप्स, एकल डेवलपर्स या छोटी टीमों के लिए बढ़िया विकल्प है, जो एंटरप्राइज़-ग्रेड इन्फ्रास्ट्रक्चर की लागत के बिना उन्नत AI क्षमताएँ चाहते हैं। इसका लोकल सर्वर्स या यहाँ तक कि एक सिंगल वर्कस्टेशन पर चलने की क्षमता इसे हल्के प्रोडक्शन सिस्टम्स के लिए व्यावहारिक समाधान बनाती है।
Llama 3.3 तक कैसे पहुंचें
Meta अपनी समर्पित वेबसाइट के माध्यम से Llama 3.3 तक पहुंच प्रदान करता है: Llama Downloads। यहाँ आपको आधिकारिक मॉडल कार्ड, लाइसेंसिंग विवरण और शुरुआत करने में मददगार अन्य डॉक्यूमेंटेशन के लिंक मिलेंगे।
विस्तृत मार्गदर्शन के लिए, हम आधिकारिक संसाधनों की जाँच करने की सलाह देते हैं:
- GitHub पर मॉडल कार्ड और उपयोग निर्देश: Meta GitHub Repository.
- Hugging Face मॉडल पेज: Hugging Face पर Llama 3.3-70B.
ये प्लेटफ़ॉर्म विस्तृत डॉक्यूमेंटेशन और कम्युनिटी फोरम्स प्रदान करते हैं जहाँ आप प्रश्न पूछ सकते हैं या समस्याओं का समाधान कर सकते हैं।
Llama 3.3 की कीमत
हमारे नज़रिये से, यह प्राइसिंग Llama 3.3 को बजट पर काम करने वाले या उच्च टोकन मांग वाले प्रोजेक्ट्स को स्केल कर रहे डेवलपर्स के लिए विशेष रूप से आकर्षक बनाती है। चाहे आप इसे लोकल चलाएँ या किसी प्लेटफ़ॉर्म के जरिए, ये प्रतिस्पर्धी दरें सुनिश्चित करती हैं कि उच्च-गुणवत्ता वाला AI जेब पर भारी पड़े बिना सुलभ रहे।
इनपुट टोकन लागत
10 लाख इनपुट टोकन प्रोसेस करने के लिए, Llama 3.3 की कीमत $0.1 है, जो इसके पूर्ववर्ती Llama 3.1 70B के बराबर है। अन्य मॉडलों की तुलना में, यह सबसे कम दरों में से एक है:
- Amazon Nova Pro $0.80 चार्ज करता है, जो समान मात्रा के लिए आठ गुना महँगा है।
- GPT-4o और Claude 3.5 Sonnet की कीमत क्रमशः $2.5 और $3.0 है, जो Llama 3.3 से काफी अधिक है।
यह कम इनपुट लागत Llama 3.3 को उन एप्लिकेशंस के लिए खासतौर पर उपयुक्त बनाती है जिन्हें बड़े पैमाने पर टेक्स्ट प्रोसेस करना होता है, जैसे चैटबोट्स या टेक्स्ट एनालिसिस टूल्स।
आउटपुट टोकन लागत
10 लाख आउटपुट टोकन के लिए, Llama 3.3 की कीमत $0.4 है, जो फिर से Llama 3.1 70B की लागत के बराबर है। तुलना इस प्रकार है:
- Amazon Nova Pro की कीमत $1.8 है, जो Llama 3.3 से चार गुना से अधिक है।
- GPT-4o $10.0 और Claude 3.5 Sonnet $15.0 चार्ज करते हैं, जिससे Llama 3.3 बहुत बड़े अंतर से किफायती विकल्प बनता है।
ऐप्लिकेशंस जो बड़ी मात्रा में टेक्स्ट जनरेट करते हैं, जैसे सिंथेटिक डेटा निर्माण या कंटेंट जेनरेशन, उनके लिए Llama 3.3 उल्लेखनीय लागत बचत देता है।
निष्कर्ष
हम Llama 3.3 को इस बात के प्रभावशाली उदाहरण के रूप में देखते हैं कि बड़े भाषा मॉडल क्षमता और सुलभता के बीच कैसे संतुलन बना सकते हैं।
एक 70-बिलियन पैरामीटर मॉडल के रूप में, यह कहीं बड़े Llama 3.1 405B के तुलनीय प्रदर्शन देता है, वह भी बहुत कम संगणनात्मक आवश्यकताओं के साथ।
एंटरप्राइज़-स्तरीय हार्डवेयर तक पहुंच न रखने वाले डेवलपर्स के लिए, यह मॉडल अपने वर्कफ़्लो में उच्च-गुणवत्ता वाले AI को शामिल करने का व्यावहारिक तरीका प्रस्तुत करता है।
FAQs
Llama 3.3, Llama 3.2 से कैसे अलग है?
Llama 3.3, Llama 3.2 पर बेहतर फाइन-ट्यूनिंग (SFT और RLHF), विस्तारित सेफ्टी फीचर्स, बहुभाषी समर्थन (8 भाषाएँ), लंबी कॉन्टेक्स्ट विंडो (128k टोकन्स), और मजबूत बेंचमार्क प्रदर्शन के साथ सुधार लाता है। इसमें टूल-यूज़ क्षमताएँ, बेहतर ऊर्जा दक्षता, और एक मजबूत जिम्मेदार AI ढांचा भी शामिल है, जिससे यह और अधिक शक्तिशाली और बहुमुखी बनता है।
Llama 3.3, Llama 405B से कैसे अलग है?
Llama 3.3, Llama 3.1 405B के तुलनीय प्रदर्शन देता है, लेकिन यह काफी अधिक दक्ष है और चलाने के लिए बहुत कम कंप्यूटेशनल शक्ति की आवश्यकता होती है।
Llama 3.3 किन भाषाओं का समर्थन करता है?
Llama 3.3 में मूल रूप से अंग्रेजी, फ्रेंच, जर्मन, हिंदी, इतालवी, पुर्तगाली, स्पेनिश और थाई का समर्थन है। डेवलपर्स इसे अन्य भाषाओं के लिए फाइन-ट्यून कर सकते हैं, लेकिन अतिरिक्त सुरक्षा उपाय आवश्यक होंगे।
Llama 3.3 किन बेंचमार्क्स में उत्कृष्ट है?
Llama 3.3, MMLU, HumanEval, और MGSM जैसे बेंचमार्क्स में उच्च स्कोर हासिल करता है, और रीज़निंग, कोडिंग, तथा बहुभाषी क्षमताओं जैसी श्रेणियों में कई अन्य मॉडलों से बेहतर प्रदर्शन करता है।
क्या Llama 3.3 मानक डेवलपर हार्डवेयर पर चल सकता है?
हाँ, Llama 3.3 को आम GPUs और डेवलपर-ग्रेड वर्कस्टेशंस पर चलाने के लिए डिज़ाइन किया गया है, जिससे एंटरप्राइज़-स्तरीय इन्फ्रास्ट्रक्चर के बिना भी यह डेवलपर्स के लिए सुलभ है।

मैं एक संपादक और लेखक हूँ जो AI ब्लॉग, ट्यूटोरियल, और समाचार कवर करता/करती हूँ, यह सुनिश्चित करते हुए कि सब कुछ ठोस कंटेंट रणनीति और SEO के सर्वोत्तम तरीकों के अनुरूप हो। मैंने Python, सांख्यिकी, प्रायिकता, और डेटा विज़ुअलाइज़ेशन पर डेटा साइंस पाठ्यक्रम लिखे हैं। मेरा एक पुरस्कृत उपन्यास भी प्रकाशित हो चुका है, और खाली समय में मैं पटकथा लेखन और फ़िल्म निर्देशन में समय बिताता/बिताती हूँ।

लेखक
Josef Waples
मैं एक डेटा साइंस संपादक हूँ और वैज्ञानिक पत्रिकाओं में प्रकाशित शोध लेखों में योगदान दे चुका/चुकी हूँ। मुझे विशेष रूप से रैखिक बीजगणित, सांख्यिकी, R, और इसी तरह के विषयों में रुचि है।
Meta AI ने अभी Llama 3.3 पेश किया है, एक 70-बिलियन पैरामीटर मॉडल जो कहीं बड़े Llama 3.1 405B के तुलनीय प्रदर्शन देता है, लेकिन बहुत कम संगणनात्मक जरूरतों के साथ।
हमें यह खास तौर पर दिलचस्प लगता है क्योंकि इससे उच्च-गुणवत्ता वाला AI उन डेवलपर्स के लिए भी सुगम हो जाता है जिनके पास महंगे हार्डवेयर तक पहुंच नहीं है।
बहुभाषी चैट, कोडिंग सहायता, और सिंथेटिक डेटा जेनरेशन जैसी टेक्स्ट-आधारित जिम्मेदारियों के लिए डिज़ाइन किया गया, Llama 3.3 केवल टेक्स्ट इनपुट और आउटपुट पर केंद्रित है—इसे इमेज या ऑडियो संभालने के लिए नहीं बनाया गया है।
इस ब्लॉग में, हम आपको बताएंगे कि यह मॉडल किस तरह अलग है और यह तय करने में आपकी मदद करेंगे कि क्या यह आपके प्रोजेक्ट्स के लिए उपयुक्त है।