
Ana içeriğe atla
Yapay Zeka
Büyük Dil Modelleri

Meta'nın Llama 3.3 70B'si Nedir? Nasıl Çalışır, Kullanım Alanları ve Daha Fazlası

Meta, Llama 3.3’ü tanıttı: Llama 3.1 405B’ye benzer performans sunan, ancak hesaplama gereksinimleri çok daha düşük olan 70 milyar parametreli bir model.
Alex Olteanu's photo
Josef Waples's photo
Alex Olteanu, Josef Waples
Güncel · 8 dk. oku

Yapay Zeka ile Keşfedin

ChatGPTClaudePerplexity

Ücretsiz Hesabınızı Oluşturun

Alıştırma and program your progress.

Google Ile Devam Edin
Devam ederek Kullanım Şartlarımızı, Gizlilik Politikamızı ve verilerinizin ABD’de saklandığını kabul etmiş olursunuz.

Meta AI, çok daha büyük olan Llama 3.1 405B ile kıyaslanabilir performans sunan, ancak çok daha düşük hesaplama gerektiren 70 milyar parametreli Llama 3.3’ü yeni tanıttı.

Bunu özellikle ilginç buluyoruz çünkü pahalı donanımlara erişimi olmayan geliştiriciler için yüksek kaliteli yapay zekâyı daha erişilebilir kılıyor.

Çok dilli sohbet, kodlama desteği ve sentetik veri üretimi gibi metin tabanlı görevler için tasarlanan Llama 3.3, yalnızca metin giriş ve çıkışlarına odaklanıyor—görsel veya ses işlemek için tasarlanmadı.

Bu blogda, modeli öne çıkaran unsurları adım adım ele alacak ve projeleriniz için uygun olup olmadığına karar vermenize yardımcı olacağız.

Yapay Zeka Uygulamaları Geliştirin

OpenAI API'sını kullanarak AI uygulamaları oluşturmayı öğrenin.
Ücretsiz Olarak Beceri Geliştirmeye Başlayın

Llama 3.3 Nedir?

Llama 3.3, Meta AI’nin en yeni büyük dil modeli ve bunu, çeşitli projeler için gelişmiş yapay zekâyı daha erişilebilir kılma yönünde bir adım olarak görüyoruz. 70 milyar parametreyle, çok daha büyük Llama 3.1 405B’ye denk bir performans sunarken donanım gereksinimlerini önemli ölçüde azaltıyor. Bu da pahalı ve özelleşmiş kurulumlara ihtiyaç duymadan gelişmiş yapay zekâ uygulamalarını keşfedebileceğimiz anlamına geliyor.

Model özellikle metin giriş ve çıkışları için tasarlandığından görselleri, sesi veya diğer medyaları işleme yeteneği yok. Çok dilli sohbet, kodlama desteği ve sentetik veri üretimi gibi görevlerde özellikle etkili bulduk. İngilizce, İspanyolca, Hintçe ve Almanca dâhil sekiz dili desteklemesi, çok dilli yeteneklere ihtiyaç duyan projeler için güçlü bir seçenek yapıyor.

Bize göre öne çıkan nokta verimlilik odaklı olması. Llama 3.3, yaygın GPU’larda çalışacak şekilde optimize edildi; bu da yerel dağıtımlar için pratik ve denemeyi kolay kılıyor. Ayrıca yanıtlarının faydalı ve güvenli olmasını sağlamak üzere hizalama teknikleri içeriyor; bunun hassas uygulamalar için kritik olduğunu biliyoruz.
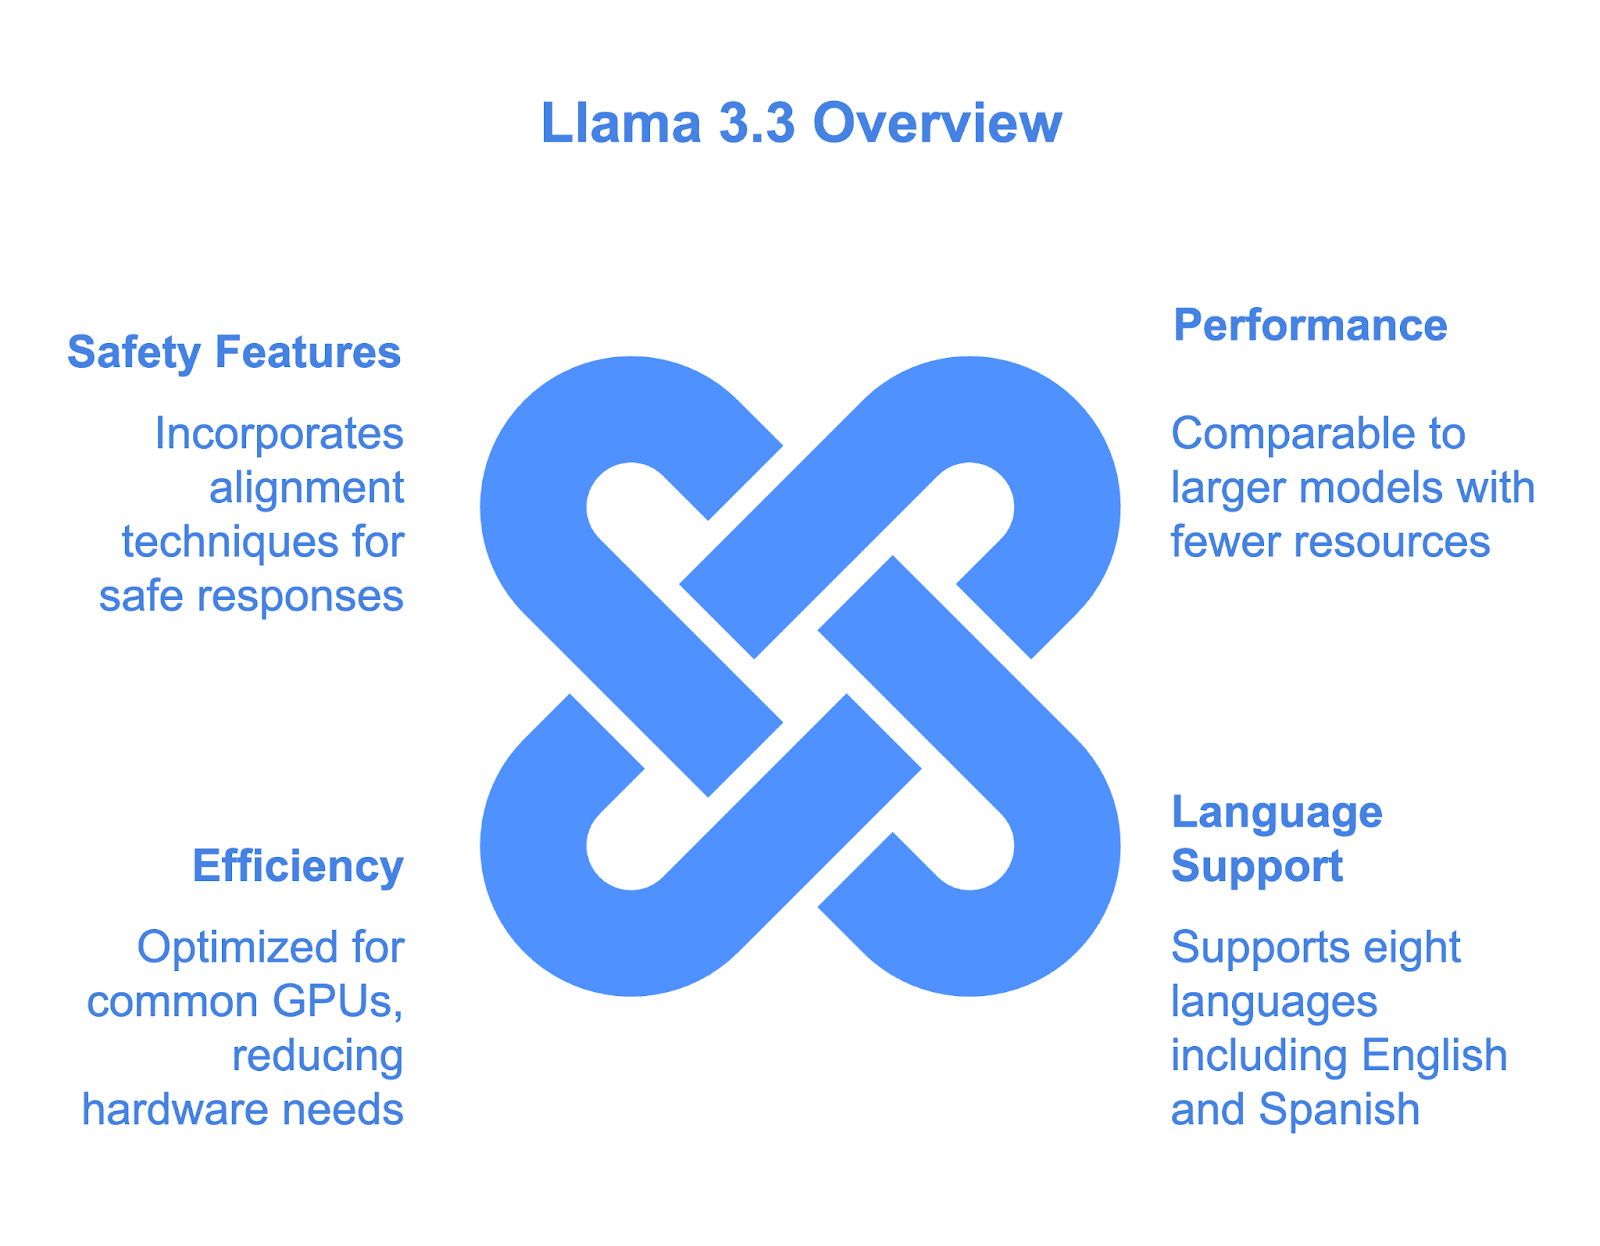
Llama 3.3 70b özellikler ve destek

Bu bölümde Llama 3.3’ün temellerini özetledik; sonraki bölümlerde daha derine ineceğiz. Nasıl çalıştığını, nasıl kullanmaya başlayacağınızı ve kıyaslamalardaki performansını ele alacağız ki işleriniz için doğru seçenek olup olmadığına karar verebilesiniz.

Llama 3.3 Nasıl Çalışır?

İster büyük dil modellerine aşina olun ister yeni yeni keşfediyor olun, Llama 3.3’ün nasıl çalıştığını anlaşılır şekilde şöyle özetliyoruz.

Mimari: Verimli ve ölçeklenebilir

Llama 3.3’ün kalbinde 70 milyar parametreli transformer tabanlı bir mimari bulunuyor. Aşina değilseniz, parametreler kabaca modelin eğitim sırasında metindeki örüntüleri ve ilişkileri öğrenmek için ayarladığı “düğmelerdir”. Bu sayede Llama 3.3 tutarlı, bağlama uygun yanıtlar üretebilir.

Llama 3.3’ü farklı kılan, Grouped-Query Attention (GQA) kullanmasıdır. Bu, metni daha hızlı ve daha az hesaplama kaynağıyla işlemesini sağlayarak modeli daha verimli kılar. Bu yüzden, donanım açısından çok daha talepkâr olmayan bir yapıda, çok daha büyük Llama 3.1 405B’ye benzer performansa ulaşabilir.

Eğitim ve ince ayar

Llama 3.3 gibi bir modelin eğitimi, modele herkese açık kaynaklardan 15 trilyon tokenlık devasa bir veri kümesi sunmakla başlar. Bu, modele dil ve bilgi konusunda geniş bir anlayış kazandırır.

Ancak ham eğitim, bir modeli gerçek dünya senaryolarında faydalı kılmak için yeterli değildir. İşte ince ayar burada devreye girer:

  • Denetimli ince ayar (SFT): Burada model, özenle seçilmiş iyi yanıt örneklerinden öğrenir. Bunun, nasıl davranması gerektiğine dair bir “altın standart” sunmak gibi olduğunu düşünebilirsiniz.
  • İnsan geri bildirimiyle pekiştirmeli öğrenme (RLHF): Modelin performansına dair insanlardan geri bildirim toplanır ve bu geri bildirim davranışını iyileştirmek için kullanılır.

Bu ikili yaklaşım, Llama 3.3’ün hem fayda hem de güvenlik açısından insan beklentileriyle uyumlu olmasını sağlar.

Erişilebilir donanım için tasarlandı

Llama 3.3, kurumsal düzeyde altyapıya sahip olmayan geliştiriciler için erişilebilir kılarak, yaygın geliştirici iş istasyonlarında yerel olarak çalışacak şekilde tasarlandı. Llama 3.1 405B gibi daha büyük modellerin aksine, güçlü performansı korurken çok daha az hesaplama gücü gerektirir.

Bu verimlilik büyük ölçüde, belleği azaltıp kestirimi hızlandırarak modelin metni nasıl işlediğini optimize eden Grouped-Query Attention (GQA) sayesindedir.

Model ayrıca kuantizasyon tekniklerini, sözgün olarak 8-bit ve 4-bit hassasiyeti, bitsandbytes gibi araçlar üzerinden destekler. Bu teknikler, performanstan çok az ödün vererek bellek gereksinimlerini ciddi biçimde düşürür.

Ayrıca tek GPU’dan dağıtık sistemlere kadar donanım kurulumlarında iyi ölçeklenir ve hem yerel deneyler hem de daha büyük dağıtımlar için esneklik sunar.

Pratikte bu, Llama 3.3’ü daha uygun maliyetli donanım kurulumlarında deneyebileceğimiz veya dağıtabileceğimiz, gelişmiş yapay zekâ modelleriyle ilişkilendirilen yüksek maliyetlerden kaçınabileceğimiz anlamına gelir. Bu da performans ile erişilebilirlik dengesini arayan geliştiriciler ve ekipler için modeli pratik bir tercih yapar.
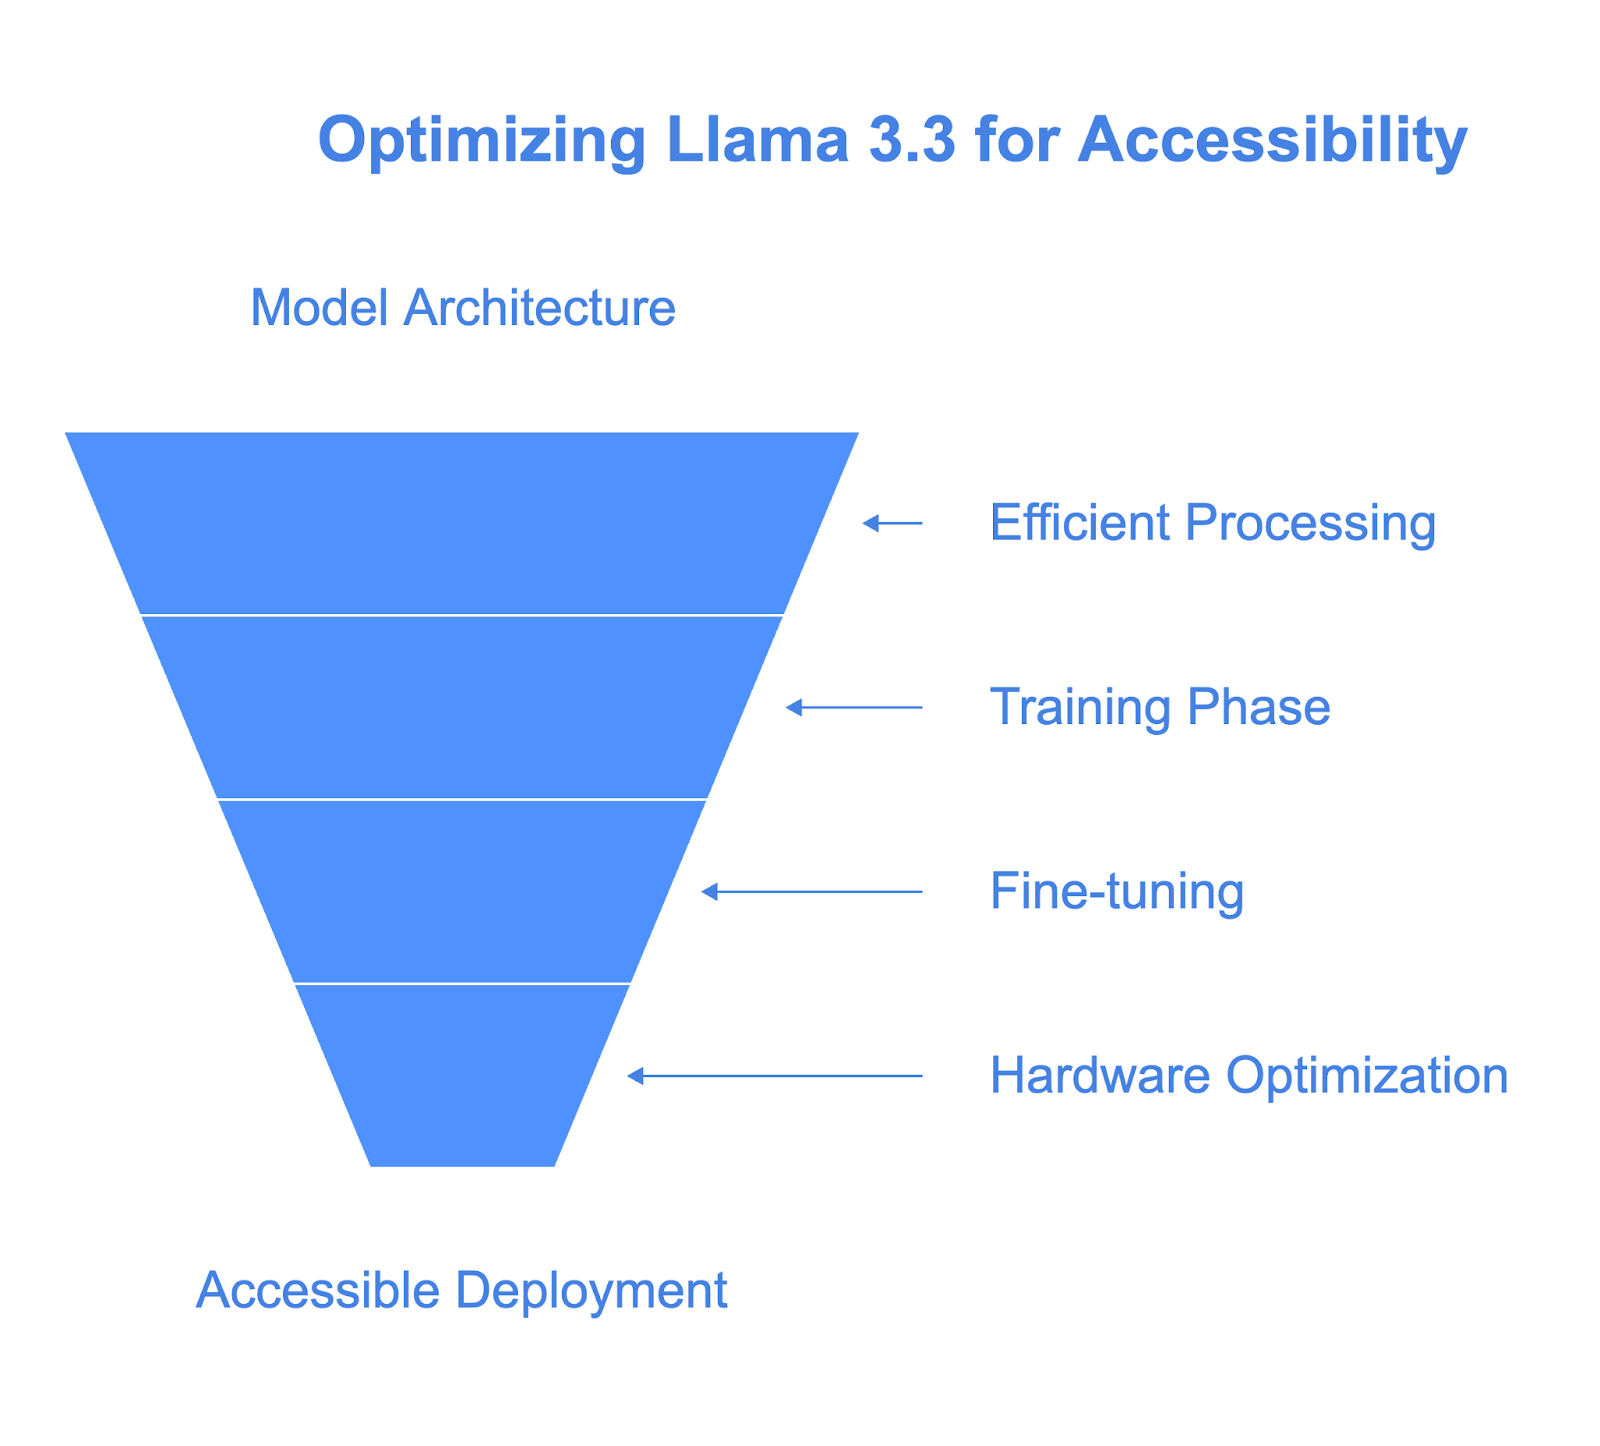
Llama 3.3 model mimarisini optimize etme

Llama 3.3 Kıyaslamaları

Llama 3.3, yönerge takibi, kodlama ve çok dilli akıl yürütme alanlarında öne çıkan sonuçlarla çeşitli kıyaslamalarda iyi performans sergiliyor. Llama 3.1 405B veya Claude 3.5 Sonnet gibi daha büyük modelleri tutarlı biçimde geride bırakmasa da çoğu kategoride güvenilir ve rekabetçi sonuçlar veriyor. Çeşitli görevleri etkili şekilde yerine getiren dengeli bir model arayan geliştiriciler için Llama 3.3 güçlü bir seçenek.
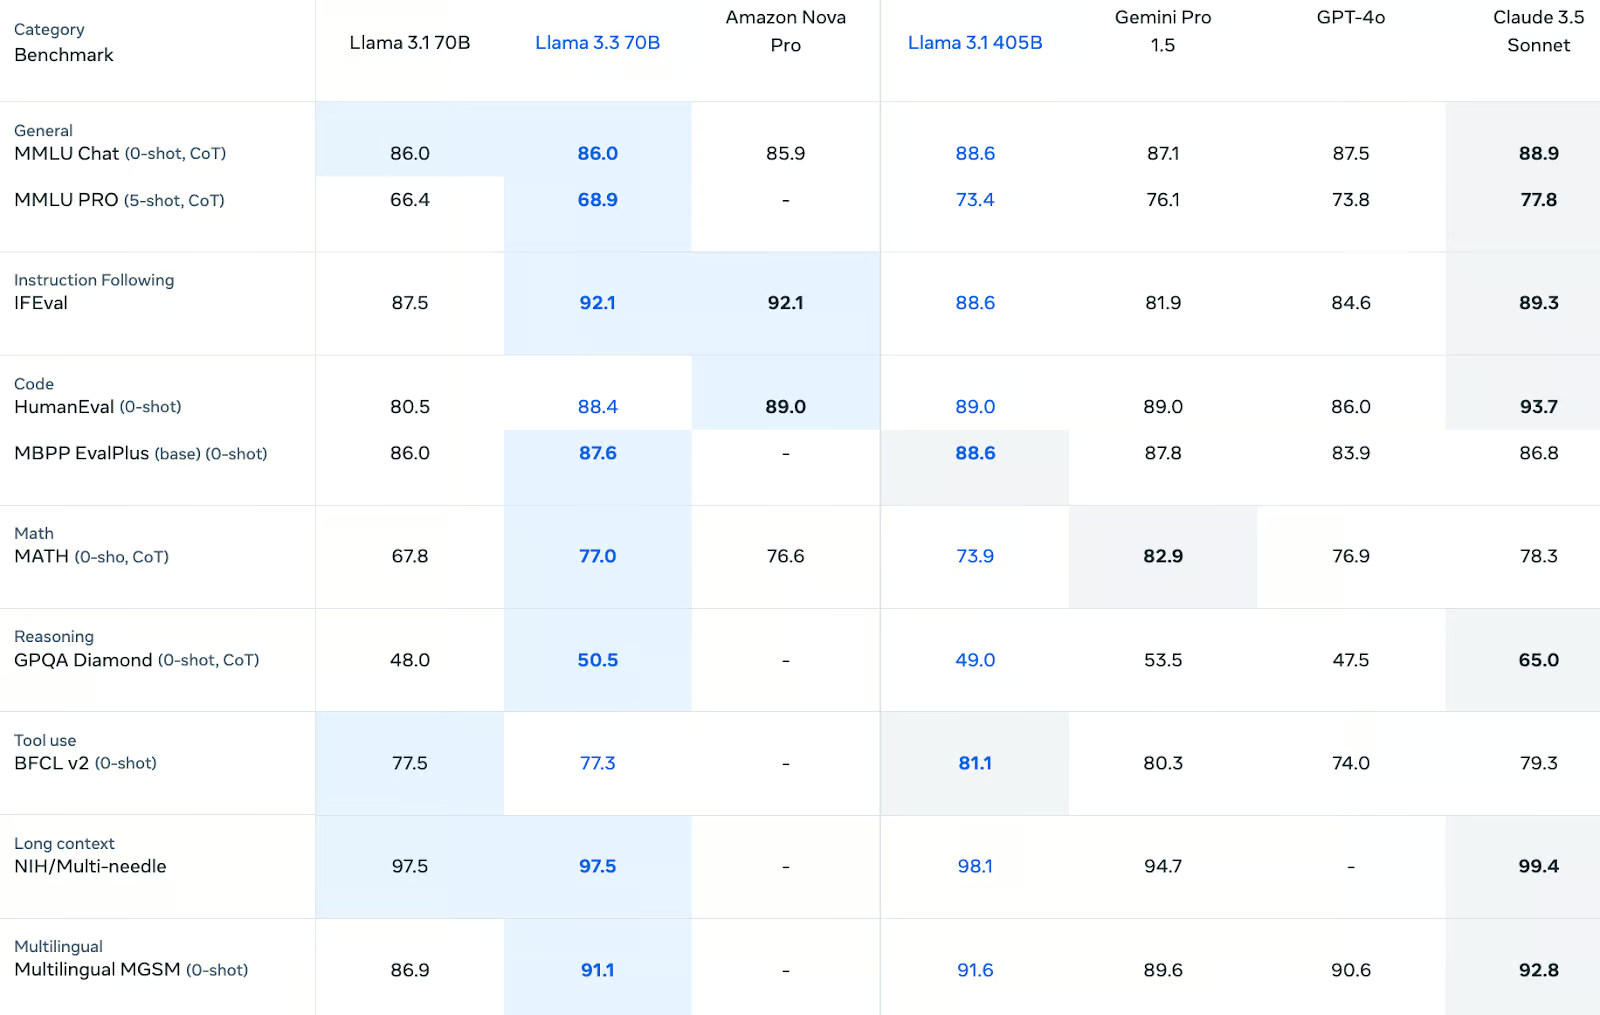
Llama 3.3 70b MMLU, IfEval, GPQA ve Çok Dilli MGSM Kıyaslamaları

Genel bilgi ve akıl yürütme

Genel bilgi görevlerinde Llama 3.3 sağlam sonuçlar veriyor. MMLU Chat’te (0-shot, CoT) 86,0 puan alarak selefi Llama 3.1 70B ile aynı seviyeye geliyor ve Amazon Nova Pro (85,9) ile rekabetçi kalıyor. Ancak daha büyük Llama 3.1 405B (88,6) ve Claude 3.5 Sonnet’in (88,9) biraz gerisinde kalıyor.

Daha zorlu MMLU PRO (5-shot, CoT) kıyaslamasında Llama 3.3, 68,9 puanla Llama 3.1 70B’ye göre ilerleme kaydediyor, ancak Llama 3.1 405B (73,4) ve Claude 3.5 Sonnet’in (77,8) gerisinde kalıyor.

Akıl yürütme görevlerinde Llama 3.3, GPQA Diamond’da (0-shot, CoT) 50,5 puan alıyor; bu, Llama 3.1 70B’ye (48,0) göre hafif bir iyileşme. Bazı rakiplerin (ör. Claude 3.5 Sonnet 65,0) gerisinde kalsa da yapısal akıl yürütmede ilerleme gösteriyor.

Yönerge takibi

Llama 3.3, yönerge takibi görevlerinde IFEval’de 92,1 puan alarak öne çıkıyor; bu metrik, bir modelin kullanıcı talimatlarına ne kadar iyi uyduğunu ölçer. Bu sonuç, Llama 3.1 405B’yi (88,6) ve GPT-4o’yu (84,6) geride bırakıyor ve Claude 3.5 Sonnet’e (89,3) yakın seyrediyor. Bu kategorideki performansı, sohbet botları ve görev odaklı asistanlar gibi uygulamalar için kritik olan hizalama yeteneklerini öne çıkarıyor.

Kodlama yetenekleri

Kodlama kıyaslamaları Llama 3.3’ün güçlü yanlarından. HumanEval’de (0-shot) 88,4 puanla Llama 3.1 405B’nin (89,0) biraz gerisinde ve Gemini Pro 1.5 ile aynı seviyede. Benzer şekilde MBPP EvalPlus’ta (temel) 87,6 puana ulaşıyor; bu da Llama 3.1 70B’ye (86,0) göre hafif bir iyileşme. Bu sonuçlar, kod üretimi ve programlama ile ilgili görevleri çözmedeki etkinliğini doğruluyor.

Matematik ve sembolik akıl yürütme

Sembolik akıl yürütmede Llama 3.3 önemli ilerleme gösteriyor. MATH’ta (0-shot, CoT) 77,0 puan alarak Llama 3.1 70B’yi (67,8) ve Amazon Nova Pro’yu (76,6) geride bırakıyor. Ancak Gemini Pro 1.5’in (82,9) arkasında kalıyor. Bu kategoride lider olmasa da birçok yapısal akıl yürütme görevi için yeterince iyi performans sergiliyor.

Çok dilli yetenekler

Llama 3.3, çok dilli akıl yürütmede kayda değer bir güç sergiliyor ve MGSM’de (0-shot) 91,1 puan alıyor. Bu, Llama 3.1 70B’ye (86,9) göre kayda değer bir iyileşme ve onu Claude 3.5 Sonnet’e (92,8) yaklaştırıyor. Bu kategorideki performansı, çeviri ve küresel müşteri desteği gibi çok dilli uygulamalar için harika bir tercih yapıyor.

Araç kullanımı ve uzun bağlam performansı

Araç kullanımında Llama 3.3, BFCL v2’de (0-shot) 77,3 puana ulaşıyor; bu, Llama 3.1 70B (77,5) ile kıyaslanabilir ancak Llama 3.1 405B’nin (81,1) gerisinde. Uzun bağlamlı girdileri ele almada ise NIH/Multi-Needle’da 97,5 puan alarak Llama 3.1 70B ile aynı düzeyi yakalıyor ve Llama 3.1 405B’nin (98,1) biraz gerisinde kalıyor. Bu sonuçlar, araç destekli iş akışları ve uzun giriş senaryoları için güçlü yetenekleri gösteriyor.

Llama 3.3 Kullanım Alanları

Llama 3.3, güçlü performans ile donanım verimliliği arasındaki dengesi sayesinde geliştiriciler ve araştırmacılar için geniş olanaklar sunuyor. Standart geliştirici iş istasyonlarında etkili şekilde çalışmasını, kurumsal düzeyde altyapıya erişimi olmayanlar için ulaşılabilir bir seçenek hâline getirmesini takdir ediyoruz. İşte faydalı olabileceği bazı alanlar.
Llama 3.3 70b kullanım alanları: içerik üretimi, sohbet botları, kodlama desteği ve araştırma

1. Çok dilli sohbet botları ve asistanlar

Llama 3.3’ün güçlü yanlarından biri, birden fazla dili işleyebilmesidir. İngilizce, İspanyolca, Fransızca ve Hintçe dâhil sekiz çekirdek dili desteklemesiyle çok dilli sohbet botları veya sanal asistanlar geliştirmek için idealdir.

Öne çıkan bir diğer nokta, başlamak için bir veri merkezine ihtiyacınız olmaması. Geliştiriciler, müşteri desteği, eğitim araçları veya diğer sohbet tabanlı uygulamalar için bu sistemleri kendi donanımlarında prototipleyip dağıtabilir.

Örneğin, tek bir GPU üzerinde verimli şekilde çalışırken birden fazla dilde soruları yanıtlayan bir müşteri hizmetleri sohbet botunu Llama 3.3 ile oluşturabiliriz.

2. Kodlama desteği ve yazılım geliştirme

HumanEval ve MBPP EvalPlus gibi kodlama kıyaslamalarındaki güçlü puanlarıyla Llama 3.3; kod üretimi, hata ayıklama veya kısmen yazılmış betikleri tamamlama için güvenilir bir yardımcıdır.

Özellikle değerli bulduğumuz nokta, kişisel donanımda ne kadar iyi çalıştığı. Pahalı bulut sistemlerine bel bağlamak yerine Llama 3.3’ü yerelde çalıştırarak tekrarlayan görevleri otomatikleştirebilir, şablon kod üretebilir veya birim testleri oluşturabilirsiniz. Ekipler veya bireysel geliştiriciler için bu, gelişmiş yapay zekâ kodlama desteğini hem pratik hem de uygun maliyetli hâle getirir.

3. Sentetik veri üretimi

Llama 3.3’ün parladığı bir diğer alan da sentetik veri kümeleri üretmektir. Bir sohbet botu geliştiriyor, bir sınıflandırıcı eğitiyor veya bir NLP projesi üzerinde çalışıyor olun; yüksek kaliteli, etiketli veri üretme yeteneği önemli ölçüde zaman ve emek tasarrufu sağlar.

Bu kullanım alanının, alanına özgü veriye ihtiyaç duyup bunu manuel olarak toplamak için kaynağı olmayan küçük ekipler için özellikle değerli olduğunu düşünüyoruz. Llama 3.3 geliştirici sınıfı donanımda çalıştığından veriyi yerelde üretebilir, maliyetleri düşürüp iş akışını basitleştirebilirsiniz.

4. Çok dilli içerik üretimi ve yerelleştirme

Llama 3.3’ün çok dilli yetenekleri, içerik üretimi için de güçlü bir aday yapıyor. Yerelleştirilmiş pazarlama materyalleri üretmek, teknik belgeleri çevirmek veya çok dilli bloglar oluşturmak için potansiyelini görüyoruz. Geliştiriciler, çıktının hedef kitleye uyacak şekilde tonunu veya tarzını uyarlaması için modeli ince ayarlarla şekillendirebilir.

Örneğin, Llama 3.3’ü bir ürün açıklamasını birden fazla dilde taslak hâline getirmek için kullanabilir, yerelleştirme sürecini özel bir çeviri ekibine ihtiyaç duymadan iyileştirebilirsiniz.

5. Araştırma ve deney

Araştırmacılar için Llama 3.3; dil modelleme, hizalama veya ince ayar tekniklerini keşfetmek adına sağlam bir platform sunar. Onu özellikle cazip kılan, verimliliğidir—ileri düzey yapay zekâ ile denemeler yapmak için devasa bulut altyapısına erişmeniz gerekmez.

Bu, özellikle güvenlik hizalaması veya damıtma yoluyla daha küçük, uzmanlaşmış modelleri eğitmek gibi alanları keşfederken akademik projeler veya endüstri araştırmaları için harika bir araçtır.

6. Bilgi tabanlı uygulamalar

Llama 3.3’ün güçlü metin işleme yetenekleri; soru yanıtlama, özetleme ve rapor oluşturma gibi uygulamalara da uygundur. Bu görevler genellikle büyük metin hacimlerini verimli biçimde işlemeyi gerektirir ve Llama 3.3 bunu kişisel donanımda bile iyi şekilde yönetebilir.

Örneğin, müşteri geri bildirimlerini otomatik olarak özetlemek veya dahili dokümantasyon üretmek için kullanabilir, doğruluğu korurken zamandan tasarruf edebiliriz.

7. Küçük ekipler için esnek dağıtım

Son olarak, kurumsal düzeyde altyapının maliyetlerine katlanmadan gelişmiş yapay zekâ yetenekleri isteyen girişimler, bağımsız geliştiriciler veya küçük ekipler için Llama 3.3’ün harika bir seçenek olduğunu düşünüyoruz. Yerel sunucularda veya tek bir iş istasyonunda çalışabilmesi, onu hafif üretim sistemleri için pratik bir çözüm yapar.

Llama 3.3’e Nasıl Erişilir

Meta, Llama 3.3’e özel web sitesi üzerinden erişim sağlıyor: Llama Downloads. Burada resmi model kartına, lisans detaylarına ve başlamanıza yardımcı olacak ek dokümantasyona bağlantılar bulacaksınız.

Ayrıntılı rehberlik için resmi kaynakları incelemenizi öneririz:

Bu platformlar ayrıntılı dokümantasyon ve soru sorabileceğiniz veya sorun giderebileceğiniz topluluk forumları sağlar.

Llama 3.3 Fiyatlandırması

Bizim açımızdan bu fiyatlandırma, bütçeyle çalışan veya token talebi yüksek projeleri ölçeklendiren geliştiriciler için Llama 3.3’ü özellikle cazip kılıyor. İster yerelde ister bir platform üzerinden çalıştırın, bu rekabetçi oranlar, bütçeyi zorlamadan yüksek kaliteli yapay zekâya erişimi sağlıyor.

Girdi token maliyetleri

1 milyon girdi tokenının işlenmesi için Llama 3.3’ün fiyatı 0,1 ABD dolarıdır ve bu, selefi Llama 3.1 70B ile aynıdır. Diğer modellere kıyasla bu, en düşük oranlardan biridir:

  • Amazon Nova Pro 0,80 ABD doları talep eder; bu da aynı hacim için sekiz kat daha pahalıdır.
  • GPT-4o ve Claude 3.5 Sonnet sırasıyla 2,5 ve 3,0 ABD dolarıdır; bu da onları Llama 3.3’ten belirgin şekilde daha pahalı kılar.

Düşük girdi maliyeti, sohbet botları veya metin analizi araçları gibi büyük miktarda metin işleyen uygulamalar için Llama 3.3’ü özellikle uygun kılar.

Çıktı token maliyetleri

1 milyon çıktı tokenı için Llama 3.3’ün fiyatı 0,4 ABD dolarıdır ve yine Llama 3.1 70B ile aynıdır. Karşılaştırma şöyle:

  • Amazon Nova Pro 1,8 ABD dolarıdır; Llama 3.3’ten dört katın üzerinde daha pahalı.
  • GPT-4o 10,0 ABD doları, Claude 3.5 Sonnet ise 15,0 ABD dolarıdır; bu da Llama 3.3’ü açık ara ekonomik bir seçenek yapar.

Sentetik veri üretimi veya içerik üretimi gibi yüksek hacimde metin üreten uygulamalar için Llama 3.3 önemli maliyet tasarrufları sunar.

Sonuç

Llama 3.3’ü, büyük dil modellerinin yetenek ile erişilebilirlik arasında nasıl denge kurabileceğine dair etkileyici bir örnek olarak görüyoruz.

70 milyar parametreli bir model olarak, çok daha büyük Llama 3.1 405B’ye benzer performans sunarken hesaplama gereksinimleri çok daha düşüktür.

Kurumsal düzeyde donanıma erişimi olmayan geliştiriciler için bu model, yüksek kaliteli yapay zekâyı iş akışlarına entegre etmenin pratik bir yolunu temsil ediyor.

SSS

Llama 3.3, Llama 3.2’den nasıl farklı?

Llama 3.3, daha iyi ince ayar (SFT ve RLHF), genişletilmiş güvenlik özellikleri, çok dilli destek (8 dil), daha uzun bağlam penceresi (128k token) ve daha güçlü kıyaslama performansıyla Llama 3.2’yi geliştiriyor. Ayrıca araç kullanımı yetenekleri, iyileştirilmiş enerji verimliliği ve sağlam bir sorumlu yapay zekâ çerçevesi ekleyerek onu daha güçlü ve çok yönlü kılıyor.

Llama 3.3, Llama 405B’den nasıl farklı?

Llama 3.3, Llama 3.1 405B’ye kıyaslanabilir performans sunar ancak çok daha verimlidir; çalıştırmak için çok daha az hesaplama gücü gerektirir.

Llama 3.3 hangi dilleri destekliyor?

Llama 3.3, yerel olarak İngilizce, Fransızca, Almanca, Hintçe, İtalyanca, Portekizce, İspanyolca ve Taycayı destekler. Geliştiriciler başka diller için ince ayar yapabilir, ancak ek korumalar gereklidir.

Llama 3.3 hangi kıyaslamalarda öne çıkıyor?

Llama 3.3, MMLU, HumanEval ve MGSM gibi kıyaslamalarda yüksek puanlar alır; akıl yürütme, kodlama ve çok dilli yetenekler gibi kategorilerde birçok modeli geride bırakır.

Llama 3.3 standart geliştirici donanımında çalışabilir mi?

Evet, Llama 3.3, yaygın GPU’lar ve geliştirici sınıfı iş istasyonlarında çalışacak şekilde tasarlanmıştır; bu da kurumsal düzeyde altyapısı olmayan geliştiriciler için erişilebilir olmasını sağlar.


Alex Olteanu's photo
Author
Alex Olteanu
LinkedIn

Yapay zeka ile ilgili bloglar, eğitimler ve haberleri kapsayan bir editör ve yazarım; tüm içeriklerin güçlü bir içerik stratejisine ve SEO en iyi uygulamalarına uygun olmasını sağlıyorum. Python, istatistik, olasılık ve veri görselleştirme üzerine veri bilimi kursları yazdım. Ödüllü bir roman yayımladım ve boş zamanlarımı senaryo yazımı ile film yönetmenliğine ayırıyorum.


Josef Waples's photo
Author
Josef Waples

Bilimsel dergilerde yayımlanan araştırma makalelerine katkıları olan bir veri bilimi yazarı ve editörüyüm. Özellikle lineer cebir, istatistik, R ve benzeri konularla ilgileniyorum. Aynı zamanda epey satranç da oynarım! 

Konular
Yapay Zeka
Büyük Dil Modelleri

DataCamp ile Yapay Zekâ Öğrenin

Kurs

Llama 3 ile Çalışmak

2 sa
15.7K
Llama LLM'yi yerel olarak çalıştırmak ve yığınınıza entegre etmek için en son teknikleri keşfedin.
Ayrıntıları GörüntüleKursa Başla

Ücretsiz Hesabınızı Oluşturun

Alıştırma and program your progress.

Google Ile Devam Edin
Devam ederek Kullanım Şartlarımızı, Gizlilik Politikamızı ve verilerinizin ABD’de saklandığını kabul etmiş olursunuz.
Devamını Gör
İlgili

blog

Hızlı Sevkiyat İçin Pratik Vibe Kodlama Teknoloji Yığını

Ön uç, arka uç, veritabanları, kimlik doğrulama, depolama, e-posta, test, dağıtım ve izleme için en iyi araçları keşfedin.
Abid Ali Awan's photo

Abid Ali Awan

14 dk.

blog

2026’da En Popüler 40 Yazılım Mühendisi Mülakat Sorusu

Algoritmalar, sistem tasarımı ve davranışsal senaryoları kapsayan bu temel sorularla teknik mülakat sürecine hakim olun. Uzman cevapları, kod örnekleri ve kanıtlanmış hazırlık stratejileri edinin.
Dario Radečić's photo

Dario Radečić

15 dk.

Eğitim

.gitignore Nasıl Kullanılır: Örneklerle Pratik Bir Giriş

Git deponuzu temiz tutmak için .gitignore’u nasıl kullanacağınızı öğrenin. Bu eğitim; temelleri, yaygın kullanım durumlarını ve başlamanıza yardımcı olacak pratik örnekleri kapsar!
Kurtis Pykes 's photo

Kurtis Pykes

8 dk.

Eğitim

Python'da Listeyi String'e Nasıl Dönüştürürsünüz

Bu hızlı eğitimde, Python'da bir listeyi string'e nasıl dönüştüreceğinizi öğrenin.
Adel Nehme's photo

Adel Nehme

Devamını Gör

