
Chuyển đến nội dung chính
Trí tuệ Nhân tạo
Mô hình Ngôn ngữ Lớn

Llama 3.3 70B của Meta là gì? Cách hoạt động, trường hợp sử dụng & hơn thế nữa

Meta giới thiệu Llama 3.3, một mô hình 70B tham số mang lại hiệu năng tương đương Llama 3.1 405B nhưng với nhu cầu tính toán thấp hơn đáng kể.
Alex Olteanu's photo
Josef Waples's photo
Alex Olteanu, Josef Waples
Đã cập nhật · 8 phút đọc

Khám phá cùng AI

ChatGPTClaudePerplexity

Tạo tài khoản miễn phí của bạn

Luyện tập và Lộ trình tiến trình của bạn.

Tiếp Tục Với Google
Bằng cách tiếp tục, bạn chấp nhận Điều khoản sử dụng, Chính sách bảo mật và việc dữ liệu của bạn được lưu trữ tại Hoa Kỳ.

Meta AI vừa giới thiệu Llama 3.3, một mô hình 70 tỷ tham số mang lại hiệu năng tương đương với Llama 3.1 405B lớn hơn nhiều, nhưng đòi hỏi tài nguyên tính toán thấp hơn rất nhiều.

Điều này đặc biệt đáng chú ý vì nó giúp đưa AI chất lượng cao đến gần hơn với các nhà phát triển không có sẵn phần cứng đắt tiền.

Được thiết kế cho các tác vụ dựa trên văn bản như trò chuyện đa ngôn ngữ, hỗ trợ viết mã và tạo dữ liệu tổng hợp, Llama 3.3 chỉ tập trung vào đầu vào và đầu ra văn bản—không được xây dựng để xử lý hình ảnh hoặc âm thanh.

Trong bài viết này, chúng tôi sẽ giới thiệu những điểm nổi bật của mô hình và giúp bạn quyết định liệu nó có phù hợp với các dự án của bạn không.

Llama 3.3 là gì?

Llama 3.3 là mô hình ngôn ngữ lớn mới nhất của Meta AI, và chúng tôi xem đây là bước tiến giúp AI tiên tiến trở nên dễ tiếp cận hơn cho nhiều dự án. Với 70 tỷ tham số, nó mang lại hiệu năng ngang ngửa với Llama 3.1 405B lớn hơn rất nhiều nhưng yêu cầu phần cứng thấp hơn đáng kể. Điều này có nghĩa chúng ta có thể khám phá các ứng dụng AI tinh vi mà không cần thiết bị chuyên dụng đắt đỏ.

Mô hình được thiết kế riêng cho đầu vào và đầu ra văn bản, vì vậy không xử lý hình ảnh, âm thanh hay phương tiện khác. Chúng tôi nhận thấy nó đặc biệt hiệu quả cho các tác vụ như trò chuyện đa ngôn ngữ, hỗ trợ viết mã và tạo dữ liệu tổng hợp. Với hỗ trợ cho tám ngôn ngữ, bao gồm tiếng Anh, Tây Ban Nha, Hindi và Đức, đây là lựa chọn mạnh cho các dự án cần khả năng đa ngôn ngữ.

Điểm nổi bật đối với chúng tôi là trọng tâm vào hiệu suất. Llama 3.3 được tối ưu để chạy trên các GPU phổ thông, giúp triển khai cục bộ trở nên thực tế và dễ thử nghiệm hơn. Nó cũng áp dụng các kỹ thuật căn chỉnh để đảm bảo phản hồi hữu ích và an toàn, điều tối quan trọng cho các ứng dụng nhạy cảm.
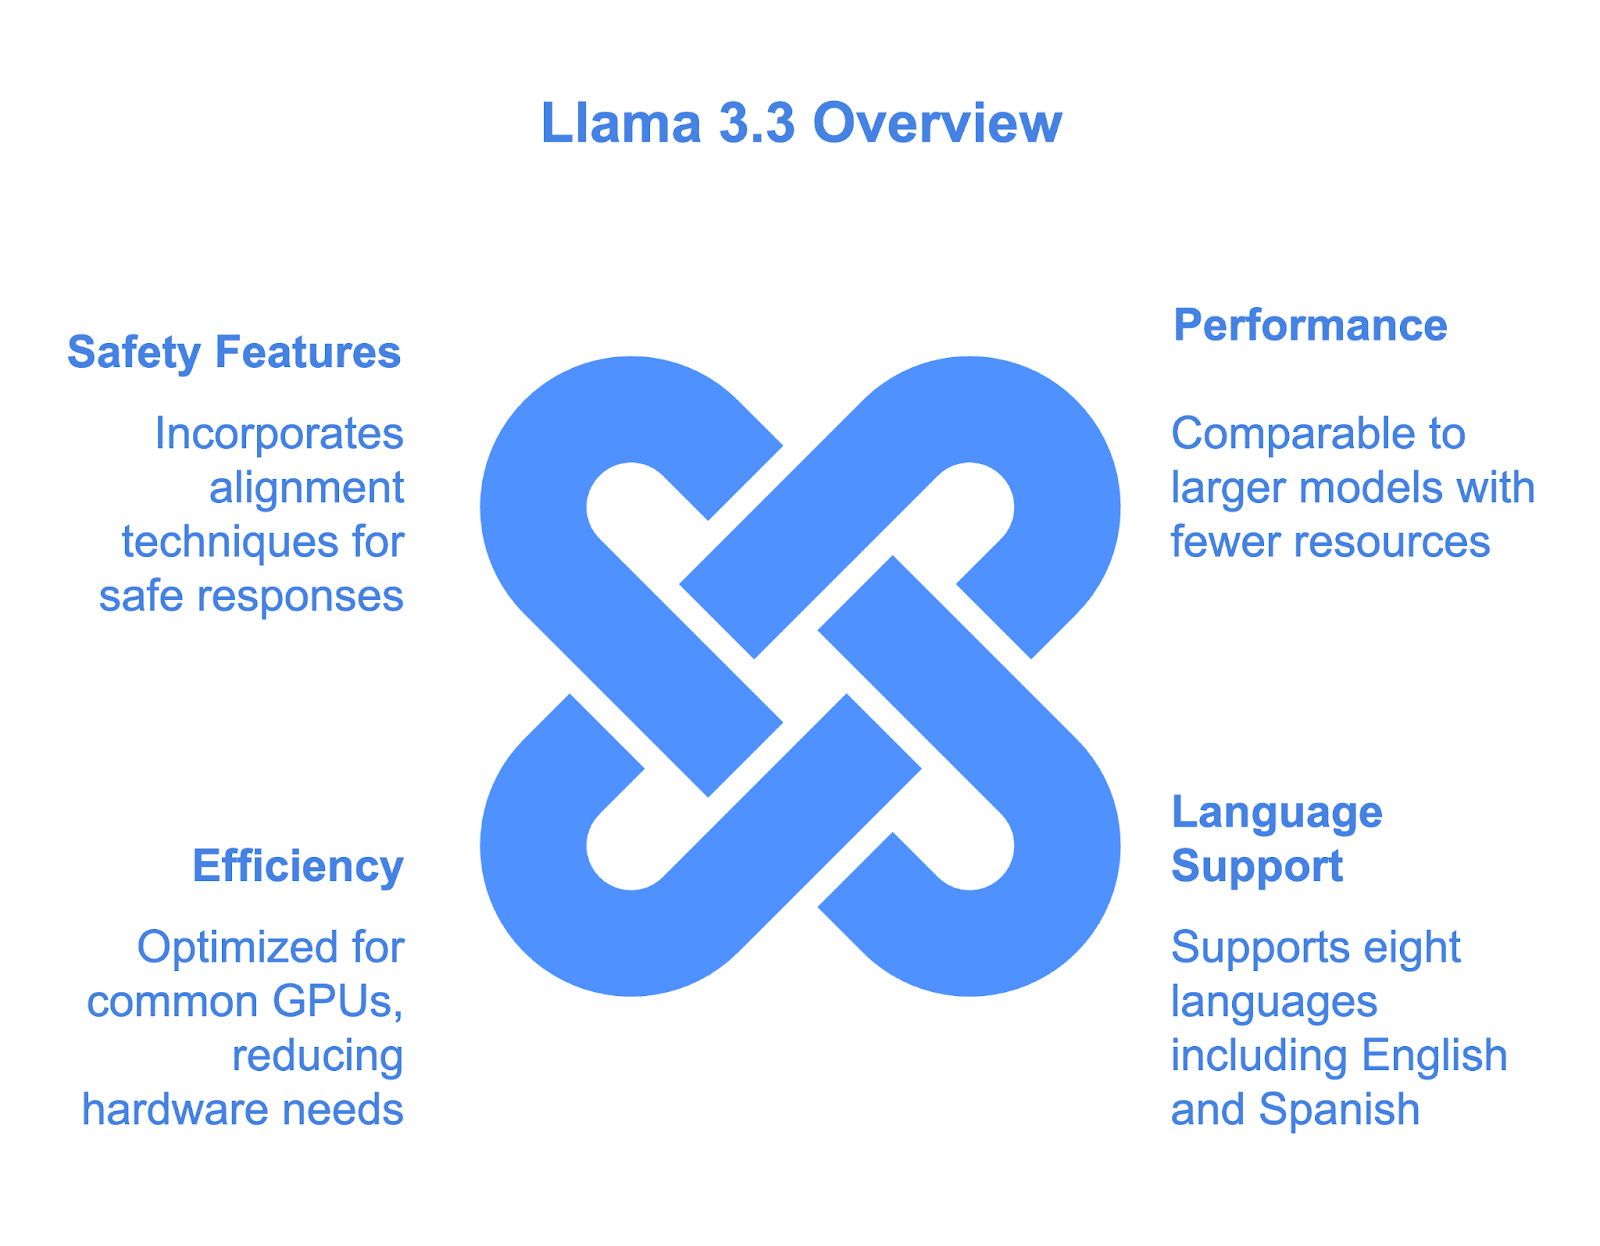
Tính năng và hỗ trợ của Llama 3.3 70b

Trong phần này, chúng tôi đã điểm qua những điều cơ bản về Llama 3.3, nhưng sẽ đi sâu hơn ở các phần tiếp theo. Chúng tôi sẽ nói về cách nó hoạt động, cách bắt đầu sử dụng và hiệu năng trên các bài kiểm định, để bạn có thể xác định liệu nó phù hợp với công việc của mình hay không.

Llama 3.3 hoạt động như thế nào?

Dưới đây là cách Llama 3.3 vận hành, được diễn giải theo cách mà chúng tôi hy vọng sẽ dễ hiểu dù bạn đã quen với các mô hình ngôn ngữ lớn hay chỉ mới bắt đầu khám phá.

Kiến trúc: Hiệu quả và có thể mở rộng

Trọng tâm của Llama 3.3 là kiến trúc dựa trên transformer với 70 tỷ tham số. Nếu bạn chưa quen, tham số về cơ bản là các “nút điều chỉnh” mà mô hình tinh chỉnh trong quá trình huấn luyện để học các mẫu và mối quan hệ trong văn bản. Đây là điều cho phép Llama 3.3 tạo ra phản hồi mạch lạc và phù hợp ngữ cảnh.

Điểm khác biệt của Llama 3.3 là sử dụng Grouped-Query Attention (GQA). Cách này giúp mô hình hiệu quả hơn bằng cách xử lý văn bản nhanh hơn và tốn ít tài nguyên tính toán hơn. Đó là lý do nó có thể đạt hiệu năng tương tự Llama 3.1 405B lớn hơn nhiều trong khi ít đòi hỏi phần cứng hơn.

Huấn luyện và tinh chỉnh

Huấn luyện một mô hình như Llama 3.3 bắt đầu bằng việc cho nó tiếp xúc với một tập dữ liệu khổng lồ—15 nghìn tỷ token văn bản từ các nguồn công khai. Điều này mang lại cho mô hình hiểu biết rộng về ngôn ngữ và tri thức.

Nhưng chúng tôi biết huấn luyện thô là chưa đủ để mô hình hữu dụng trong bối cảnh thực tế. Đó là lúc tinh chỉnh phát huy tác dụng:

  • Tinh chỉnh có giám sát (SFT): Ở đây, mô hình học từ các ví dụ được tuyển chọn cẩn thận về phản hồi tốt. Hãy coi đây như việc cung cấp “chuẩn mực vàng” cho cách nó nên hành xử.
  • Học tăng cường với phản hồi của con người (RLHF): Bao gồm thu thập phản hồi của con người về cách mô hình hoạt động và dùng phản hồi đó để tinh chỉnh hành vi.

Cách tiếp cận kép này giúp Llama 3.3 phù hợp với kỳ vọng của con người cả về tính hữu ích lẫn an toàn.

Thiết kế cho phần cứng dễ tiếp cận

Llama 3.3 được thiết kế để chạy cục bộ trên các máy trạm của nhà phát triển, giúp các lập trình viên không có hạ tầng cấp doanh nghiệp vẫn có thể tiếp cận. Không giống các mô hình lớn hơn như Llama 3.1 405B, nó yêu cầu sức mạnh tính toán ít hơn đáng kể trong khi vẫn duy trì hiệu năng mạnh mẽ.

Hiệu quả này phần lớn đến từ Grouped-Query Attention (GQA), tối ưu cách mô hình xử lý văn bản bằng cách giảm sử dụng bộ nhớ và tăng tốc suy luận.

Mô hình cũng hỗ trợ các kỹ thuật lượng tử hóa, chẳng hạn như độ chính xác 8-bit và 4-bit, thông qua các công cụ như bitsandbytes. Các kỹ thuật này giảm đáng kể yêu cầu bộ nhớ mà không làm mất nhiều hiệu năng.

Ngoài ra, nó mở rộng tốt trên nhiều cấu hình phần cứng, từ GPU đơn đến hệ thống phân tán, mang lại sự linh hoạt cho cả thử nghiệm cục bộ lẫn triển khai quy mô lớn.

Trong thực tế, điều này có nghĩa chúng ta có thể thử nghiệm hoặc triển khai Llama 3.3 trên các cấu hình phần cứng phải chăng hơn, tránh chi phí cao thường gắn với các mô hình AI tiên tiến. Đây là lựa chọn thực tế cho các nhà phát triển và nhóm muốn cân bằng giữa hiệu năng và khả năng tiếp cận.
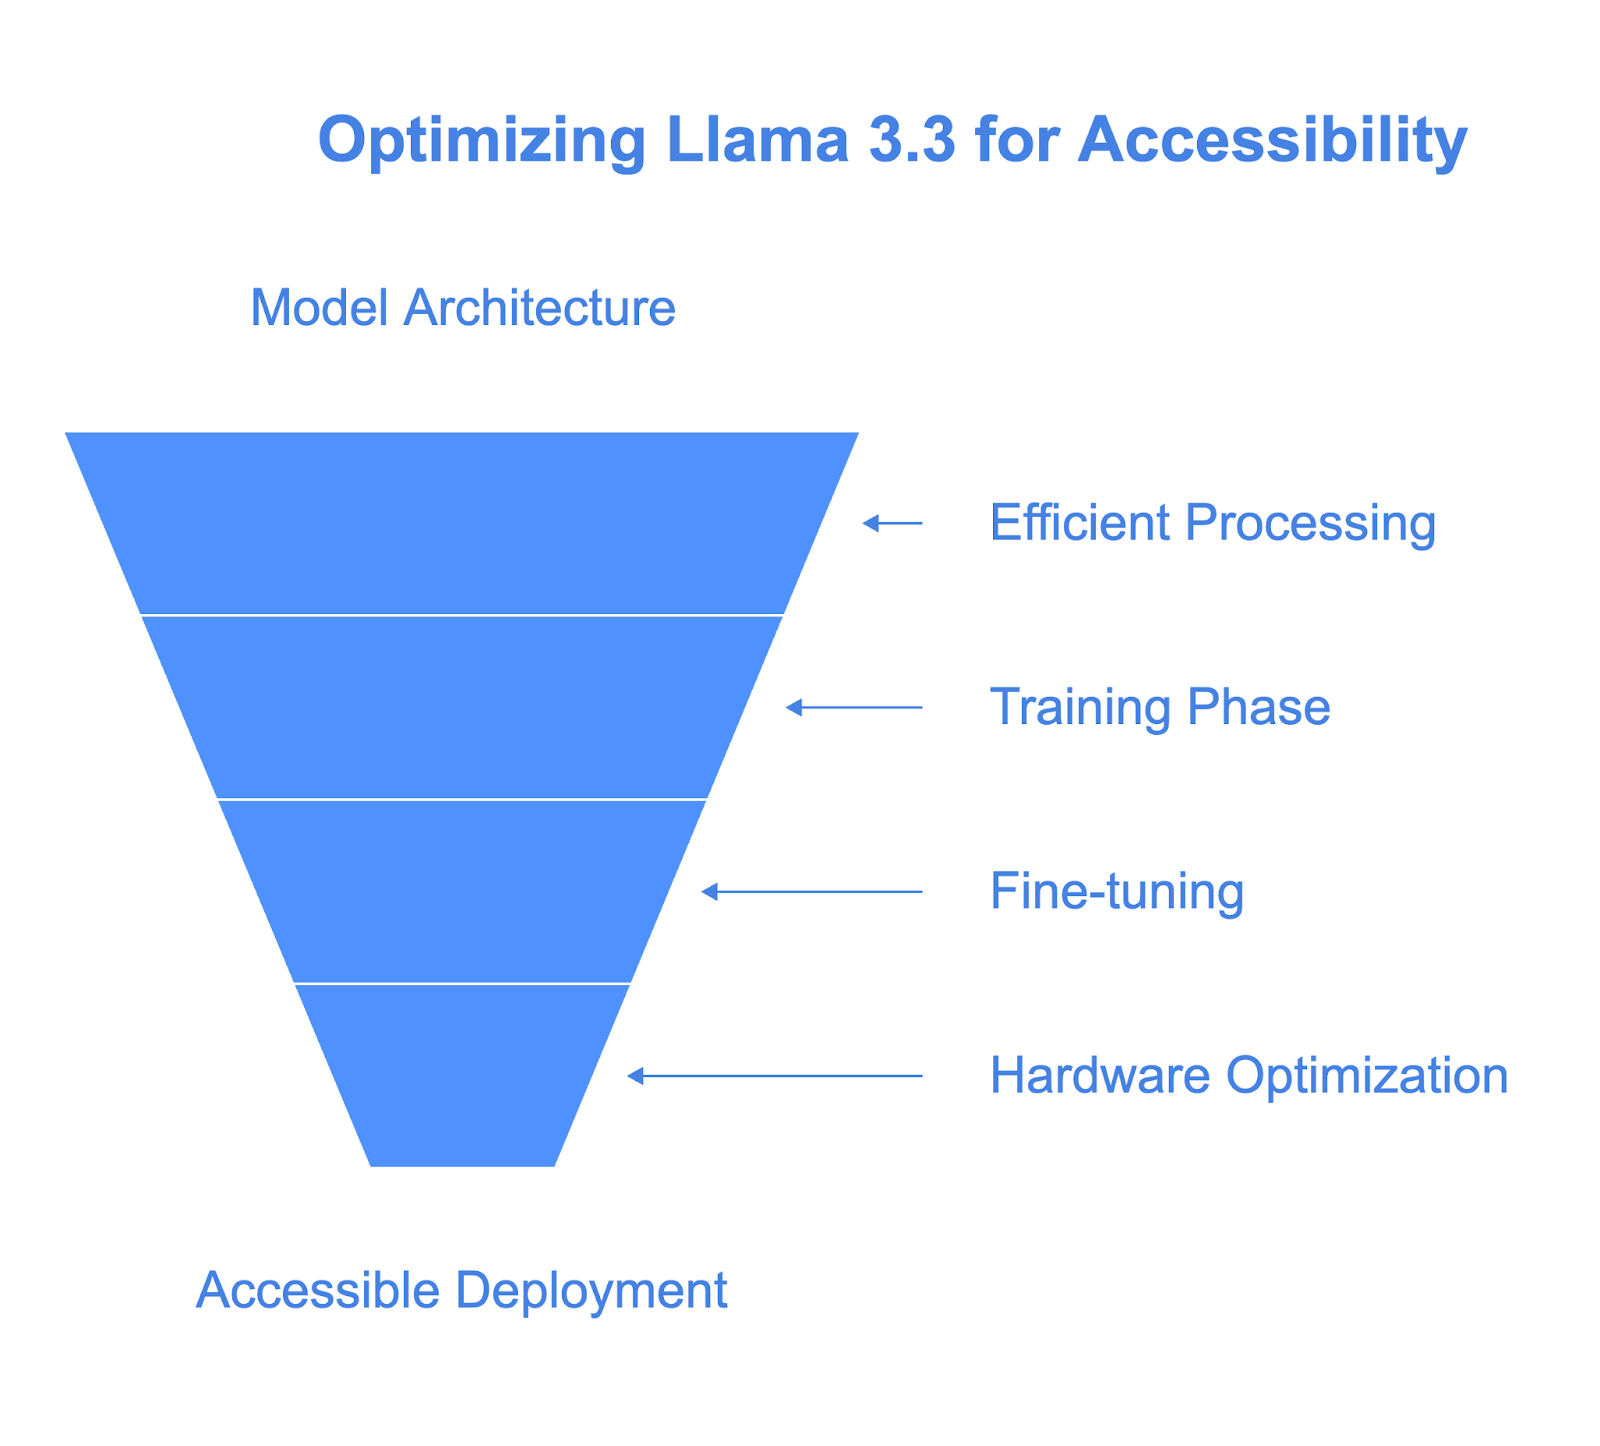
tối ưu hóa kiến trúc mô hình Llama 3.3

Các bài kiểm định Llama 3.3

Llama 3.3 thể hiện tốt trên nhiều bài kiểm định, nổi bật ở khả năng tuân thủ hướng dẫn, viết mã và lập luận đa ngôn ngữ. Dù không ổn định vượt trội các mô hình lớn hơn như Llama 3.1 405B hay Claude 3.5 Sonnet, nó mang lại kết quả đáng tin cậy và cạnh tranh ở hầu hết hạng mục. Với các nhà phát triển cần một mô hình cân bằng, xử lý hiệu quả nhiều tác vụ, Llama 3.3 là lựa chọn mạnh.
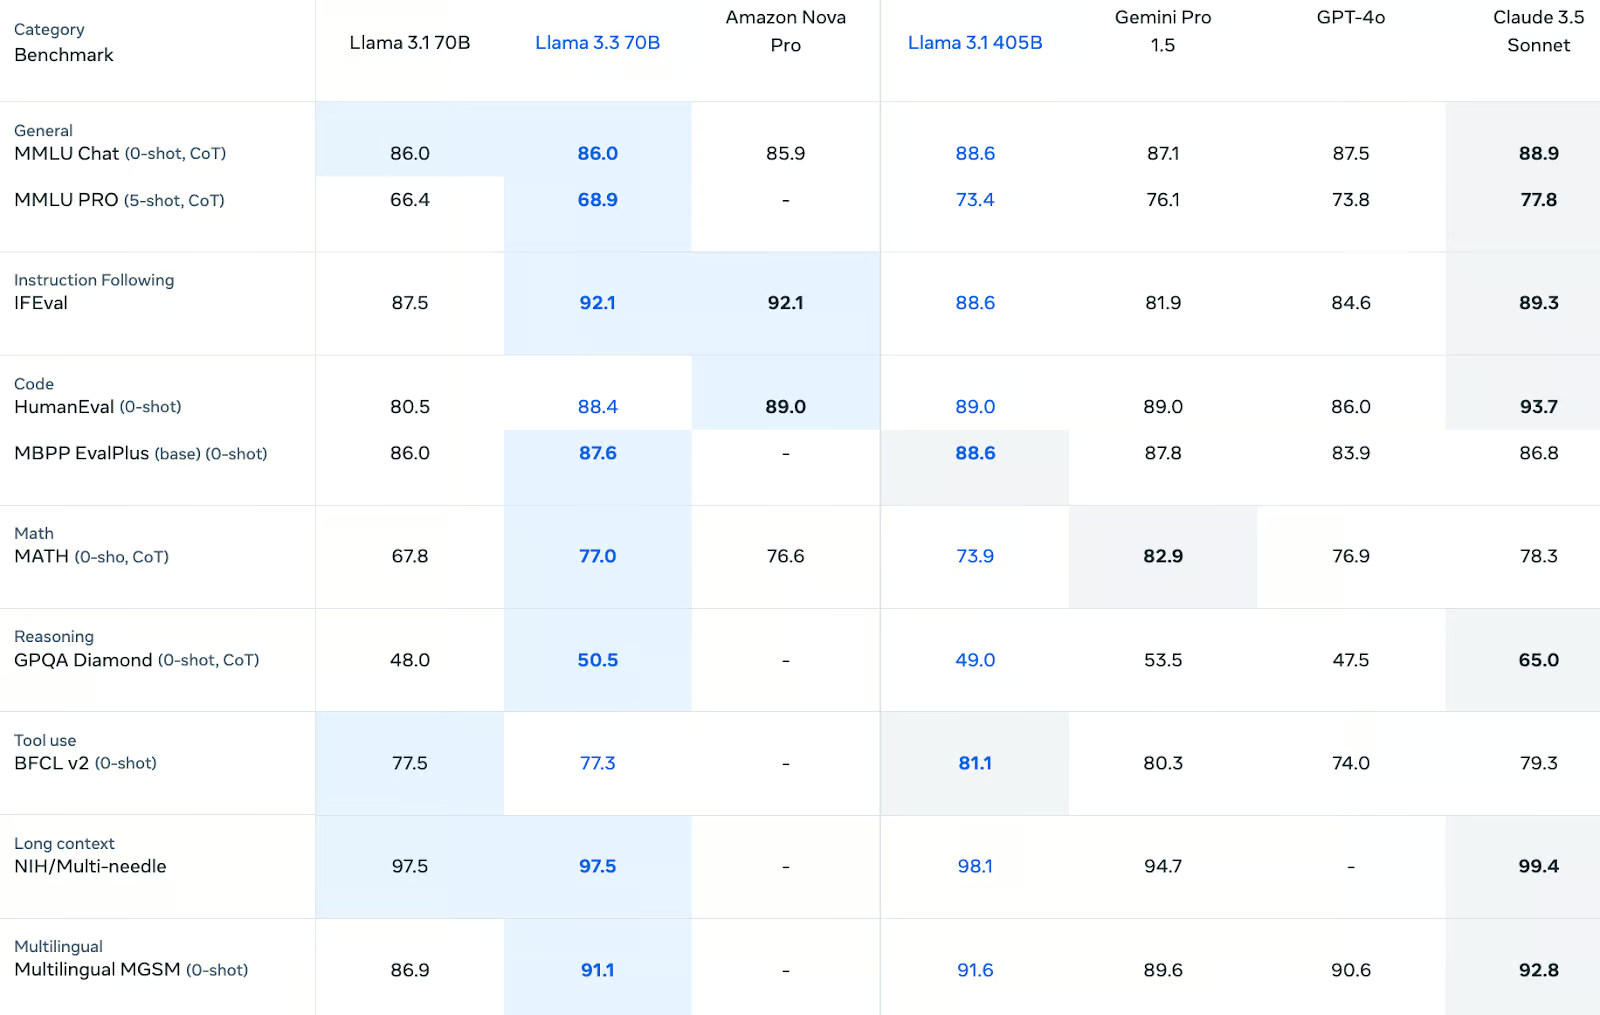
Bài kiểm định Llama 3.3 70b trên MMLU, IfEval, GPQA và MGSM đa ngôn ngữ

Kiến thức tổng quát và lập luận

Trong các tác vụ kiến thức tổng quát, Llama 3.3 đạt kết quả vững vàng. Nó đạt 86,0 điểm trên MMLU Chat (0-shot, CoT), ngang với tiền nhiệm Llama 3.1 70B và cạnh tranh với Amazon Nova Pro (85,9). Tuy nhiên, nó kém đôi chút so với Llama 3.1 405B (88,6) và Claude 3.5 Sonnet (88,9) lớn hơn.

Trên bài kiểm định khó hơn MMLU PRO (5-shot, CoT), Llama 3.3 cải thiện so với Llama 3.1 70B với điểm số 68,9, nhưng vẫn đứng sau Llama 3.1 405B (73,4) và Claude 3.5 Sonnet (77,8).

Với các tác vụ lập luận, Llama 3.3 đạt 50,5 trên GPQA Diamond (0-shot, CoT), nhỉnh hơn Llama 3.1 70B (48,0). Dù đứng sau một số đối thủ như Claude 3.5 Sonnet (65,0), nó cho thấy tiến bộ trong lập luận có cấu trúc.

Tuân thủ hướng dẫn

Llama 3.3 nổi trội ở các tác vụ tuân thủ hướng dẫn, đạt 92,1 trên IFEval, đo lường mức độ mô hình tuân theo chỉ dẫn người dùng. Kết quả này đưa nó vượt Llama 3.1 405B (88,6) và GPT-4o (84,6), và tiệm cận Claude 3.5 Sonnet (89,3). Hiệu năng này làm nổi bật khả năng căn chỉnh, rất quan trọng cho các ứng dụng như chatbot và trợ lý theo nhiệm vụ.

Khả năng viết mã

Các bài kiểm định viết mã là điểm mạnh của Llama 3.3. Trên HumanEval (0-shot), nó đạt 88,4, kém chút so với Llama 3.1 405B (89,0) và ngang với Gemini Pro 1.5. Tương tự, ở MBPP EvalPlus (base), nó đạt 87,6, nhỉnh hơn Llama 3.1 70B (86,0). Những kết quả này khẳng định hiệu quả của mô hình trong việc sinh mã và giải quyết các tác vụ lập trình.

Toán học và lập luận ký hiệu

Trong lập luận ký hiệu, Llama 3.3 ghi nhận tiến bộ đáng kể. Nó đạt 77,0 trên MATH (0-shot, CoT), vượt Llama 3.1 70B (67,8) và Amazon Nova Pro (76,6). Tuy nhiên, vẫn sau Gemini Pro 1.5 (82,9). Dù không dẫn đầu, nó vẫn đủ tốt cho nhiều tác vụ lập luận có cấu trúc.

Khả năng đa ngôn ngữ

Llama 3.3 thể hiện sức mạnh đáng kể trong lập luận đa ngôn ngữ, đạt 91,1 trên MGSM (0-shot). Đây là bước cải thiện lớn so với Llama 3.1 70B (86,9) và tiệm cận Claude 3.5 Sonnet (92,8). Hiệu năng này khiến nó trở thành lựa chọn tốt cho ứng dụng đa ngôn ngữ như dịch thuật và hỗ trợ khách hàng toàn cầu.

Sử dụng công cụ và hiệu năng ngữ cảnh dài

Về sử dụng công cụ, Llama 3.3 đạt 77,3 trên BFCL v2 (0-shot), tương đương Llama 3.1 70B (77,5) nhưng thấp hơn Llama 3.1 405B (81,1). Khi xử lý đầu vào ngữ cảnh dài, nó đạt 97,5 trên NIH/Multi-Needle, ngang Llama 3.1 70B và thấp hơn đôi chút so với Llama 3.1 405B (98,1). Các kết quả này cho thấy năng lực mạnh mẽ cho quy trình có hỗ trợ công cụ và kịch bản đầu vào mở rộng.

Trường hợp sử dụng Llama 3.3

Llama 3.3 mở ra nhiều khả năng cho nhà phát triển và nhà nghiên cứu nhờ sự cân bằng giữa hiệu năng mạnh và hiệu quả phần cứng. Chúng tôi đánh giá cao việc nó chạy hiệu quả trên các máy trạm tiêu chuẩn, giúp những người không có hạ tầng cấp doanh nghiệp vẫn dễ tiếp cận. Dưới đây là một số lĩnh vực hữu ích.
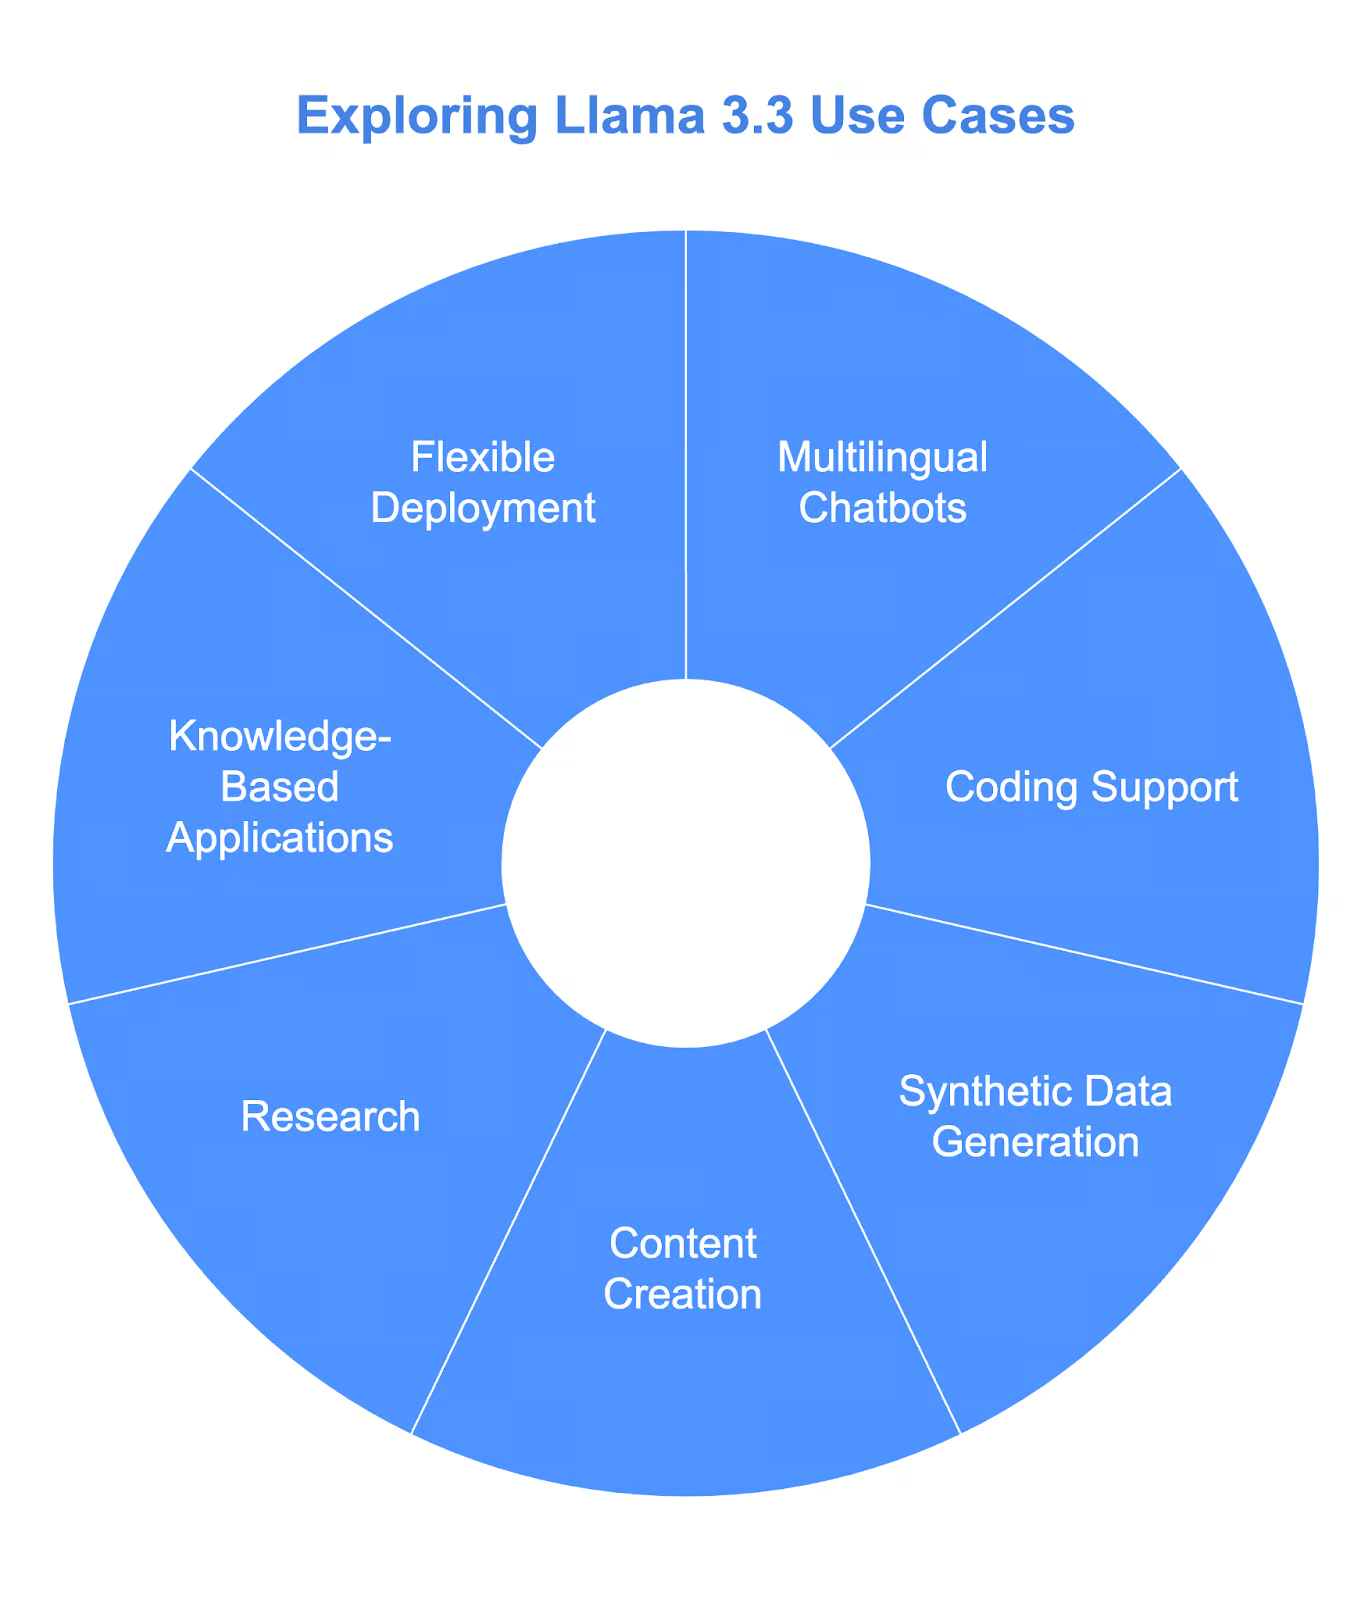
Các ứng dụng Llama 3.3 70b gồm sáng tạo nội dung, chatbot, hỗ trợ viết mã và nghiên cứu

1. Chatbot và trợ lý đa ngôn ngữ

Một trong những thế mạnh của Llama 3.3 là khả năng xử lý nhiều ngôn ngữ. Với hỗ trợ tám ngôn ngữ cốt lõi—bao gồm tiếng Anh, Tây Ban Nha, Pháp và Hindi—nó lý tưởng để xây dựng chatbot hoặc trợ lý ảo đa ngôn ngữ.

Điểm chúng tôi đánh giá cao là bạn không cần trung tâm dữ liệu để bắt đầu. Nhà phát triển có thể tạo mẫu và triển khai các hệ thống này trên phần cứng của chính mình, cho dù là hỗ trợ khách hàng, công cụ giáo dục hay ứng dụng hội thoại khác.

Ví dụ, chúng ta có thể dùng Llama 3.3 để tạo chatbot chăm sóc khách hàng trả lời bằng nhiều ngôn ngữ, đồng thời chạy hiệu quả trên một GPU duy nhất.

2. Hỗ trợ viết mã và phát triển phần mềm

Với điểm số mạnh trên các bài kiểm định viết mã như HumanEval và MBPP EvalPlus, Llama 3.3 là trợ lý đáng tin cậy để sinh mã, gỡ lỗi hoặc hoàn thiện các kịch bản viết dở.

Điều chúng tôi đánh giá cao là khả năng hoạt động tốt trên phần cứng cá nhân. Thay vì phụ thuộc vào hệ thống đám mây đắt đỏ, bạn có thể chạy Llama 3.3 cục bộ để tự động hóa tác vụ lặp lại, sinh mã khung, hoặc tạo kiểm thử đơn vị. Với đội ngũ nhỏ hoặc lập trình viên độc lập, điều này khiến hỗ trợ viết mã bằng AI tiên tiến trở nên thực tế và tiết kiệm.

3. Tạo dữ liệu tổng hợp

Một lĩnh vực khác nơi Llama 3.3 tỏa sáng là tạo bộ dữ liệu tổng hợp. Dù bạn đang xây dựng chatbot, huấn luyện bộ phân loại hay làm dự án NLP, khả năng tạo dữ liệu gán nhãn chất lượng cao có thể tiết kiệm đáng kể thời gian và công sức.

Chúng tôi cho rằng trường hợp sử dụng này đặc biệt hữu ích cho các nhóm nhỏ cần dữ liệu theo miền nhưng không có nguồn lực thu thập thủ công. Vì Llama 3.3 chạy trên phần cứng cấp nhà phát triển, bạn có thể tạo dữ liệu cục bộ, giảm chi phí và đơn giản hóa quy trình.

4. Sáng tạo nội dung và bản địa hóa đa ngôn ngữ

Khả năng đa ngôn ngữ của Llama 3.3 cũng khiến nó là ứng viên sáng giá cho sáng tạo nội dung. Chúng tôi thấy tiềm năng trong việc tạo tài liệu marketing bản địa hóa, dịch tài liệu kỹ thuật, hoặc viết blog đa ngôn ngữ. Nhà phát triển có thể tinh chỉnh mô hình để điều chỉnh giọng điệu hay phong cách, đảm bảo đầu ra phù hợp đối tượng.

Chẳng hạn, bạn có thể dùng Llama 3.3 để phác thảo mô tả sản phẩm bằng nhiều ngôn ngữ, cải thiện quy trình bản địa hóa mà không cần đội ngũ dịch thuật chuyên trách.

5. Nghiên cứu và thử nghiệm

Với các nhà nghiên cứu, Llama 3.3 là nền tảng vững chắc để khám phá mô hình ngôn ngữ, căn chỉnh hoặc kỹ thuật tinh chỉnh. Điểm hấp dẫn đặc biệt là hiệu quả—bạn không cần truy cập hạ tầng đám mây khổng lồ để thử nghiệm AI tiên tiến.

Điều này khiến nó trở thành công cụ tốt cho các dự án học thuật hoặc nghiên cứu công nghiệp, nhất là khi khám phá các lĩnh vực như căn chỉnh an toàn hoặc huấn luyện các mô hình nhỏ, chuyên biệt thông qua chưng cất.

6. Ứng dụng dựa trên tri thức

Khả năng xử lý văn bản mạnh của Llama 3.3 cũng phù hợp với các ứng dụng như hỏi đáp, tóm tắt và tạo báo cáo. Những tác vụ này thường yêu cầu xử lý khối lượng văn bản lớn hiệu quả, điều mà Llama 3.3 có thể đáp ứng tốt ngay cả trên phần cứng cá nhân.

Ví dụ, chúng ta có thể dùng nó để tự động tóm tắt phản hồi khách hàng hoặc tạo tài liệu nội bộ, tiết kiệm thời gian mà vẫn đảm bảo độ chính xác.

7. Triển khai linh hoạt cho nhóm nhỏ

Cuối cùng, chúng tôi cho rằng Llama 3.3 là lựa chọn tuyệt vời cho startup, lập trình viên độc lập hoặc nhóm nhỏ muốn có khả năng AI tiên tiến mà không cần chi phí hạ tầng cấp doanh nghiệp. Khả năng chạy trên máy chủ cục bộ hoặc thậm chí một máy trạm đơn lẻ khiến nó là giải pháp thực tế cho hệ thống sản xuất gọn nhẹ.

Cách truy cập Llama 3.3

Meta cung cấp quyền truy cập Llama 3.3 qua trang web chuyên dụng: Llama Downloads. Tại đây, bạn sẽ tìm thấy liên kết đến thẻ mô hình chính thức, chi tiết cấp phép và tài liệu bổ sung để bắt đầu.

Để có hướng dẫn chuyên sâu, chúng tôi khuyến nghị khám phá các tài nguyên chính thức:

Những nền tảng này cung cấp tài liệu chi tiết và diễn đàn cộng đồng nơi bạn có thể đặt câu hỏi hoặc khắc phục sự cố.

Giá của Llama 3.3

Theo quan điểm của chúng tôi, mức giá này khiến Llama 3.3 đặc biệt hấp dẫn với các nhà phát triển có ngân sách hạn chế hoặc đang mở rộng dự án có nhu cầu token cao. Dù bạn chạy cục bộ hay qua nền tảng, mức phí cạnh tranh này đảm bảo AI chất lượng cao vẫn dễ tiếp cận mà không vượt ngân sách.

Chi phí token đầu vào

Để xử lý 1 triệu token đầu vào, Llama 3.3 có giá 0,1 USD, ngang với tiền nhiệm Llama 3.1 70B. So với các mô hình khác, đây là một trong những mức thấp nhất:

  • Amazon Nova Pro tính 0,80 USD, đắt gấp tám lần cho cùng khối lượng.
  • GPT-4o và Claude 3.5 Sonnet lần lượt là 2,5 USD và 3,0 USD, cao hơn đáng kể so với Llama 3.3.

Chi phí đầu vào thấp này khiến Llama 3.3 đặc biệt phù hợp cho các ứng dụng cần xử lý lượng văn bản lớn, như chatbot hoặc công cụ phân tích văn bản.

Chi phí token đầu ra

Với 1 triệu token đầu ra, Llama 3.3 có giá 0,4 USD, tiếp tục ngang với Llama 3.1 70B. So sánh như sau:

  • Amazon Nova Pro có giá 1,8 USD, cao hơn hơn bốn lần so với Llama 3.3.
  • GPT-4o tính 10,0 USD và Claude 3.5 Sonnet tính 15,0 USD, khiến Llama 3.3 là lựa chọn tiết kiệm hơn rất nhiều.

Với các ứng dụng tạo ra lượng văn bản lớn, như tạo dữ liệu tổng hợp hoặc sáng tạo nội dung, Llama 3.3 mang lại tiết kiệm chi phí đáng kể.

Kết luận

Chúng tôi xem Llama 3.3 là ví dụ thuyết phục về cách mô hình ngôn ngữ lớn cân bằng giữa năng lực và khả năng tiếp cận.

Với 70 tỷ tham số, nó mang lại hiệu năng tương đương Llama 3.1 405B lớn hơn nhiều nhưng yêu cầu tính toán thấp hơn nhiều.

Đối với các nhà phát triển không có phần cứng cấp doanh nghiệp, mô hình này là cách thực tế để tích hợp AI chất lượng cao vào quy trình làm việc.

Câu hỏi thường gặp

Llama 3.3 khác gì so với Llama 3.2?

Llama 3.3 cải thiện so với Llama 3.2 nhờ tinh chỉnh tốt hơn (SFT và RLHF), tính năng an toàn mở rộng, hỗ trợ đa ngôn ngữ (8 ngôn ngữ), cửa sổ ngữ cảnh dài hơn (128k token) và hiệu năng kiểm định mạnh hơn. Nó cũng bổ sung khả năng dùng công cụ, cải thiện hiệu suất năng lượng và khung AI có trách nhiệm vững chắc, khiến mô hình mạnh mẽ và đa dụng hơn.

Llama 3.3 khác gì so với Llama 405B?

Llama 3.3 mang lại hiệu năng tương đương Llama 3.1 405B nhưng hiệu quả hơn nhiều, cần ít sức mạnh tính toán để chạy.

Llama 3.3 hỗ trợ những ngôn ngữ nào?

Llama 3.3 hỗ trợ nguyên bản tiếng Anh, Pháp, Đức, Hindi, Ý, Bồ Đào Nha, Tây Ban Nha và Thái. Nhà phát triển có thể tinh chỉnh cho các ngôn ngữ khác, nhưng cần có biện pháp bảo vệ bổ sung.

Llama 3.3 nổi trội ở những bài kiểm định nào?

Llama 3.3 đạt điểm cao ở các bài kiểm định như MMLU, HumanEval và MGSM, vượt nhiều mô hình khác ở các hạng mục như lập luận, viết mã và khả năng đa ngôn ngữ.

Llama 3.3 có thể chạy trên phần cứng tiêu chuẩn của nhà phát triển không?

Có. Llama 3.3 được thiết kế để chạy trên các GPU phổ thông và máy trạm cấp nhà phát triển, giúp các nhà phát triển không có hạ tầng cấp doanh nghiệp vẫn có thể tiếp cận.


Alex Olteanu's photo
Author
Alex Olteanu
LinkedIn

Tôi là biên tập viên và tác giả phụ trách blog, hướng dẫn và tin tức về AI, bảo đảm mọi nội dung phù hợp với chiến lược nội dung vững chắc và các thực tiễn SEO tốt nhất. Tôi đã viết các khóa học khoa học dữ liệu về Python, thống kê, xác suất và trực quan hóa dữ liệu. Tôi cũng đã xuất bản một tiểu thuyết đoạt giải và dành thời gian rảnh cho việc viết kịch bản và đạo diễn phim.


Josef Waples's photo
Author
Josef Waples

Tôi là một cây bút và biên tập viên về khoa học dữ liệu, đã có bài đóng góp cho các nghiên cứu đăng trên tạp chí khoa học. Tôi đặc biệt quan tâm đến đại số tuyến tính, thống kê, R và các chủ đề tương tự. Tôi cũng chơi cờ vua khá thường xuyên! 

Chủ đề
Trí tuệ Nhân tạo
Mô hình Ngôn ngữ Lớn

Học AI cùng DataCamp

Khóa học

Làm việc với Llama 3

2 giờ
15.7K
Khám phá các kỹ thuật mới nhất để chạy Llama LLM tại chỗ và tích hợp nó vào hệ thống của bạn.
Xem chi tiếtBắt Đầu Khóa Học

Tạo tài khoản miễn phí của bạn

Luyện tập và Lộ trình tiến trình của bạn.

Tiếp Tục Với Google
Bằng cách tiếp tục, bạn chấp nhận Điều khoản sử dụng, Chính sách bảo mật và việc dữ liệu của bạn được lưu trữ tại Hoa Kỳ.
Xem thêm
Liên quan

blog

Claude Opus 4.6: Tính năng, Điểm chuẩn, Bài kiểm tra thực hành và hơn thế nữa

Mô hình mới nhất của Anthropic dẫn đầu ở mã hóa tác tử và lập luận phức tạp. Thêm vào đó, nó có cửa sổ ngữ cảnh 1M.
Matt Crabtree's photo

Matt Crabtree

10 phút

Xem thêm