
Lernpfad
Grundlagen der KI
10 Std.
Stell dir vor, du willst einem Computer den Unterschied zwischen einem Apfel und einer Orange beibringen. Für uns ist das klar, aber für eine Maschine, die nur Zahlen versteht, ist das eine komplexe Aufgabe.
Genau hier kommen Vektoreinbettungen ins Spiel. Diese mathematischen „Zaubertricks“ verwandeln Wörter, Bilder und andere Daten in numerische Darstellungen, die Computer leicht verstehen und verarbeiten können.
Vektoreinbettungen eröffnen ein Universum an Möglichkeiten, indem sie die Welt der Informationen in einen numerischen Raum abbilden.
Vektoreinbettungen sind digitale Fingerabdrücke für Wörter oder andere Dateneinheiten. Statt Buchstaben oder Bilder zu verwenden, arbeiten sie mit Zahlen, angeordnet in einer speziellen Struktur, dem Vektor – im Grunde eine geordnete Liste von Werten.
Du kannst dir jeden Vektor als Punkt in einem mehrdimensionalen Raum vorstellen, dessen Position wichtige Informationen über das dargestellte Wort oder die Daten trägt.
Aus dem Matheunterricht kennst du Vektoren vielleicht als Pfeile mit Richtung und Länge. Vektoreinbettungen basieren zwar auf diesem Prinzip, arbeiten aber in Räumen mit sehr vielen Dimensionen.
Diese hohe Dimensionalität ist entscheidend, um die feinen Nuancen menschlicher Sprache abzubilden – etwa Ton, Kontext und Grammatik. Stell dir einen Vektor vor, der nicht nur zwischen „happy“ und „sad“ unterscheidet, sondern auch Abstufungen wie „ecstatic“, „content“ oder „melancholic“ erfasst.
Vektoreinbettungen sind eine wertvolle Methode, um komplexe Daten in ein Format zu überführen, das sich für Machine-Learning-Algorithmen eignet. Indem sie hochdimensionale und kategoriale Daten in niedrigdimensionale, kontinuierliche Repräsentationen überführen, steigern Einbettungen die Modellleistung und Recheneffizienz – bei gleichzeitiger Bewahrung zugrunde liegender Muster.
Um dir vereinfacht zu zeigen, wie ein mehrdimensionaler Vektorraum definiert sein könnte, findest du hier eine Tabelle mit acht beispielhaften Dimensionen und ihren Wertebereichen:
|
Merkmal |
Beschreibung |
Bereich |
|
Konkretheit |
Ein Maß dafür, wie greifbar oder abstrakt ein Wort ist |
0 bis 1 |
|
Emotionale Valenz |
Die mit dem Wort verbundene Positivität oder Negativität |
-1 bis 1 |
|
Häufigkeit |
Wie oft das Wort in einem großen Textkorpus vorkommt |
0 bis 1 |
|
Länge |
Die Anzahl der Zeichen im Wort |
0 bis 1 |
|
Wortart |
Eine Menge One-Hot-codierter Werte für Nomen, Verb, Adjektiv, Sonstiges |
4x [0,1] |
|
Formellheitsgrad |
Das mit dem Wort verbundene Maß an Formalität |
0 bis 1 |
|
Spezifität |
Wie spezifisch oder allgemein das Wort ist |
0 bis 1 |
|
Sensorische Assoziation |
Das Ausmaß, in dem das Wort mit Sinneserfahrungen verknüpft ist |
0 bis 1 |
So könnte z. B. das Wort "cat" einen Vektor wie diesen haben: [0.9, 0.2, 0.7, 0.3, 1, 0, 0, 0, 0.4, 0.8, 0.9], während "freedom" so aussehen könnte: [0.1, 0.8, 0.6, 0.7, 1, 0, 0, 0, 0.7, 0.3, 0.2].
Jeder Vektor funktioniert wie ein eindeutiger Identifikator, der nicht nur die Bedeutung eines Wortes erfasst, sondern auch widerspiegelt, wie dieses Wort zu anderen steht. Wörter mit ähnlicher Bedeutung liegen in diesem numerischen Raum oft nah beieinander – wie benachbarte Punkte auf einer Karte. Diese Nähe macht semantische Verbindungen sichtbar.
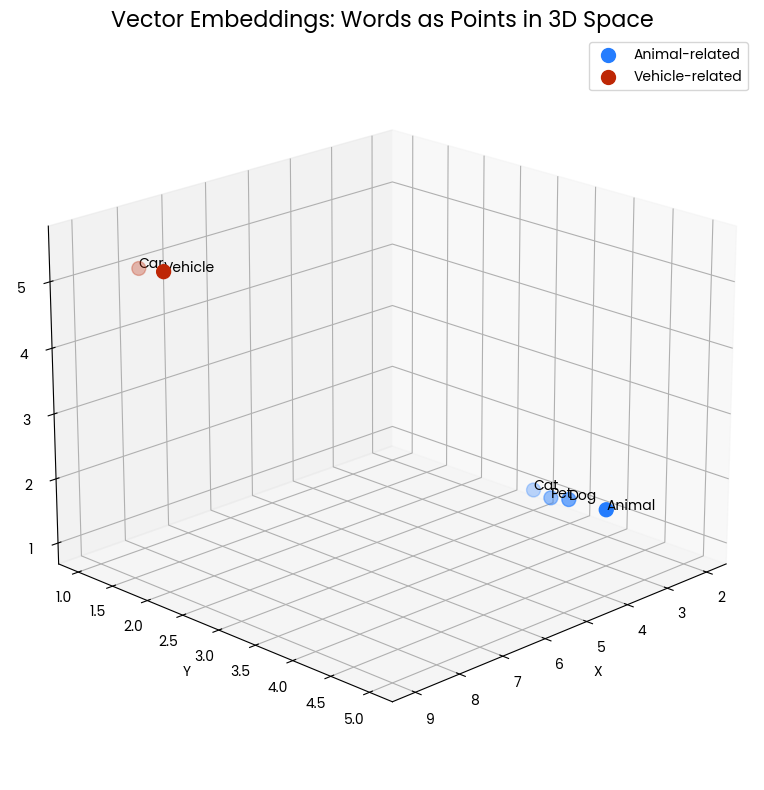
Das folgende 3D-Streudiagramm veranschaulicht das Konzept von Vektoreinbettungen für Wörter. Jeder Punkt repräsentiert ein Wort; seine Position wird durch die zugehörige Einbettung bestimmt. Die zusammenliegenden blauen Punkte stehen für tierbezogene Wörter („Cat“, „Dog“, „Pet“, „Animal“), die roten Punkte für fahrzeugbezogene Wörter („Car“, „Vehicle“). Die Nähe der Punkte zeigt semantische Ähnlichkeit an – Wörter mit verwandter Bedeutung liegen in diesem Raum näher beieinander.
Abbildung 1: Zwei Wort-Cluster in einem dreidimensionalen Raum. Nähe bedeutet semantische Ähnlichkeit.
So liegen „Cat“ und „Dog“ nahe beieinander – sie teilen Eigenschaften als typische Haustiere. Ebenso stehen „Car“ und „Vehicle“ dicht zusammen, was ihre Verwandtschaft zeigt. Der Tier-Cluster ist jedoch weit vom Fahrzeug-Cluster entfernt, was die semantische Trennung dieser Konzepte verdeutlicht.
Diese räumliche Darstellung hilft uns zu verstehen, wie Vektoreinbettungen Beziehungen zwischen Wörtern erfassen und abbilden. Sprachliche Bedeutung wird in geometrische Relationen übersetzt, die sich messen und mathematisch analysieren lassen.
Vektoreinbettungen sind besonders im Natural Language Processing (NLP) verbreitet und repräsentieren dort einzelne Wörter. Diese numerischen Darstellungen sind nicht zufällig – sie werden aus großen Textmengen gelernt. So funktioniert es.
Eine NLP-Technik zur Zuordnung von Vektoren zu Wörtern ist Word2Vec. Dabei handelt es sich um ein Machine-Learning-Modell, das auf Basis des Kontextes in einem großen Textkorpus lernt, Wörter miteinander zu verknüpfen. Du kannst es dir wie ein Sprachmodell vorstellen, das ein Wort aus seinen umgebenden Wörtern heraus vorhersagen will.
Dadurch lernt es implizit die Beziehungen zwischen Wörtern und erfasst semantische wie auch syntaktische Informationen. Diese gelernten Beziehungen werden als numerische Vektoren codiert und für verschiedene NLP-Aufgaben genutzt. Wörter, die häufig zusammen oder in ähnlichen Kontexten auftauchen, erhalten Vektoren, die im Einbettungsraum näher beieinander liegen.
Word2Vec nutzt zwei Hauptarchitekturen, um Wortbeziehungen zu erfassen: Continuous Bag-of-Words (CBOW) und Skip-gram.
|
Architektur |
Vorgehen |
Recheneffizienz |
Erfasste Beziehungen |
Empfindlichkeit gegenüber häufigen Wörtern |
|
CBOW |
Sagt das Zielwort anhand der umgebenden Kontextwörter voraus |
Schnelleres Training |
Besser für syntaktische Beziehungen (grammatikalische Regeln) |
Empfindlicher gegenüber häufigen Wörtern |
|
Skip-gram |
Sagt Kontextwörter anhand des Zielworts voraus |
Langsameres Training |
Besser für semantische Beziehungen (Textbedeutung) |
Weniger empfindlich gegenüber häufigen Wörtern |
Skip-gram ist zwar langsamer zu trainieren als CBOW, liefert mit seinem generativen Ansatz aber oft präzisere Einbettungen – insbesondere für seltene Wörter.
Schauen wir uns ein Beispiel an: Stell dir einen riesigen Textkorpus vor. Word2Vec analysiert, wie Wörter innerhalb eines Fensters gemeinsam vorkommen. Im Satz "The king and queen ruled the kingdom." stehen „king“ und „queen“ in unmittelbarer Nachbarschaft. Word2Vec erfasst diese Kookkurrenzen.
Über unzählige Sätze hinweg baut der Algorithmus ein statistisches Modell auf. Er lernt, dass Wörter wie „king“ und „queen“ oft in ähnlichen Kontexten auftreten, und codiert diese Information in numerische Vektoren. Entsprechend liegen die Vektoren für „king“ und „queen“ im Einbettungsraum näher beieinander als etwa der Vektor für „apple“, das selten in denselben Kontexten vorkommt.
Diese Nähe im Vektorraum spiegelt die semantische Ähnlichkeit zwischen „king“ und „queen“ wider und zeigt die Stärke von Word2Vec beim Erfassen sprachlicher Beziehungen.
Jetzt, da klar ist, was Vektoreinbettungen sind und wie sie Bedeutung erfassen, schauen wir uns an, welche Aufgaben sie ermöglichen.
Wie bereits erwähnt, glänzen Vektoreinbettungen bei der Quantifizierung semantischer Ähnlichkeit. Über den Abstand zwischen Wortvektoren lässt sich bestimmen, wie nah sich Bedeutungen stehen.
Damit lassen sich etwa Synonyme und Antonyme finden. Wörter mit ähnlicher Definition clustern zusammen, während Antonyme zwar viele Dimensionen teilen, sich aber in den Schlüsseldimensionen ihrer Unterschiede deutlich entfernen.
Die „Magie“ geht weiter: Mit Vektoreinbettungen lassen sich arithmetische Operationen auf Wortvektoren durchführen, um verborgene Beziehungen aufzudecken. So kann man die Analogie „king verhält sich zu queen wie man zu woman“ lösen, indem man vom Vektor „king“ den Vektor „man“ abzieht und „woman“ hinzufügt. Der resultierende Vektor sollte dem von „queen“ sehr nahe kommen – ein Beispiel dafür, wie Einbettungen Sprachmuster abbilden.
Die Einsatzmöglichkeiten gehen über einzelne Wörter hinaus. Satz-Einbettungen erfassen die Gesamtbedeutung ganzer Sätze. Indem Sätze als dichte Vektoren dargestellt werden, lässt sich semantische Ähnlichkeit zwischen Texten messen.
Wie Wort-Einbettungen sind auch Satz-Einbettungen Vektoren, typischerweise mit höherer Dimensionalität, um die Komplexität satzbezogener Informationen abzubilden. Auf den resultierenden Vektoren lassen sich mathematische Operationen ausführen, um semantische Ähnlichkeit zu messen – das ermöglicht anspruchsvollere Aufgaben wie Information Retrieval, Textklassifikation und Sentiment-Analyse.
Ein naheliegender Ansatz ist, die Wort-Einbettungen aller Wörter eines Satzes zu mitteln. Das ist simpel, liefert aber oft eine brauchbare Basis. Um komplexere semantische und syntaktische Informationen zu erfassen, kommen fortgeschrittene Techniken wie rekurrente neuronale Netze (RNNs) und Transformer-Modelle zum Einsatz:
|
Architektur |
Verarbeitung |
Kontextverständnis |
Recheneffizienz |
|
RNNs |
Sequenziell |
Fokus auf lokalen Kontext |
Weniger effizient bei langen Sequenzen |
|
Transformer-Modelle |
Parallel |
Erfassen Langzeitabhängigkeiten |
Sehr effizient, auch bei langen Sequenzen |
Während RNNs lange Zeit die dominierende Architektur waren, haben Transformer sie in vielen NLP-Aufgaben – auch bei Satz-Einbettungen – in Leistung und Effizienz überholt.
Dennoch haben RNNs ihren Platz in Anwendungen, in denen die sequentielle Verarbeitung zentral ist. Außerdem gibt es zahlreiche vortrainierte Modelle für Satz-Einbettungen, die sofort einsatzfähige Lösungen für Aufgaben wie Textzusammenfassung, wissensbasierte Fragebeantwortung oder Named Entity Recognition (NER) bieten.
Vektoreinbettungen sind nicht auf Text beschränkt. Die folgenden Anwendungen zeigen ihre breite Wirkung in verschiedenen Domänen:
Nachdem klar ist, wie Vektoreinbettungen funktionieren und welche Datentypen sie abdecken, schauen wir uns konkrete Anwendungsfälle an. Beginnen wir mit einem der bekanntesten Beispiele: Large Language Models (LLMs).
LLMs wie ChatGPT, Claud oder Google Gemini basieren stark auf Vektoreinbettungen. Sie lernen, Wörter, Phrasen und sogar ganze Sätze als dichte Vektoren in einem hochdimensionalen Raum darzustellen. Kurz gesagt: Vektoreinbettungen geben Sprachmodellen ein semantisches Verständnis von Wörtern und ihren Beziehungen – das Rückgrat ihrer beeindruckenden Fähigkeiten.
Die numerische Darstellung von Text ermöglicht es LLMs, menschenähnliche Texte zu verstehen und zu erzeugen – für Aufgaben wie Übersetzung, Zusammenfassung und Fragebeantwortung. Das eröffnet vielfältige Einsatzfelder, von Content-Erstellung und Kundenservice bis Bildung und Forschung.
Vektoreinbettungen bieten auch einen alternativen Ansatz zu klassischen Suchmaschinen, die oft auf Keyword-Matching beruhen. Deren Grenzen lassen sich überwinden, indem sowohl Suchanfragen als auch Webseiten als Einbettungen dargestellt werden. So verstehen Suchmaschinen die semantische Bedeutung hinter Anfragen und Zielseiten besser, finden relevante Ergebnisse jenseits exakter Schlüsselwortübereinstimmungen und liefern treffendere Resultate.
Eine weitere Stärke von Einbettungen liegt in der Erkennung ungewöhnlicher Datenpunkte oder Muster. Algorithmen können Abstände zwischen als Vektoren dargestellten Datenpunkten berechnen und solche markieren, die deutlich vom Normalfall abweichen. Das wird u. a. in der Betrugserkennung, in der Netzwerksicherheit und im industriellen Monitoring eingesetzt.
Vektoreinbettungen helfen auch, Sprachbarrieren zu überbrücken. Ähnlich wie in unserem Beispiel mit „king“ und „queen“ lassen sich semantische und syntaktische Beziehungen zwischen Wörtern über Sprachen hinweg erfassen. Entsprechend können in der Zielsprache Begriffe mit ähnlichen Vektoren gefunden werden – das hilft maschinellen Übersetzungssystemen wie DeepL, genauere und flüssigere Übersetzungen zu erzeugen.
Schließlich sind Einbettungen zentral für leistungsfähige Empfehlungssysteme. Indem Nutzende und Items als Einbettungen dargestellt werden, können Systeme ähnliche Nutzende oder Items über Vektornähe identifizieren. So entstehen personalisierte Empfehlungen für Produkte, Filme, Musik und mehr. Wer etwa Filme mit ähnlichen Einbettungen mag, wird mit hoher Wahrscheinlichkeit auch andere ähnliche Filme mögen.
Wie du siehst, haben sich Vektoreinbettungen als äußerst mächtiges Werkzeug etabliert. Indem sie komplexe Daten in ein von ML-Algorithmen leicht nutzbares Format überführen, erschließen sie vielfältige Möglichkeiten in zahlreichen Bereichen.
Die wichtigsten Punkte aus diesem Artikel:
Wenn du tiefer einsteigen möchtest, helfen dir diese Ressourcen weiter:
Lerne KI von Grund auf!
Lernpfad
Lernpfad
Lernpfad