
Cursus
Principes fondamentaux de l'IA
10 h
Imaginez que vous deviez apprendre à un ordinateur la différence entre une pomme et une orange. Pour nous, c’est évident, mais pour une machine qui ne comprend que des nombres, le défi est de taille.
C’est là qu’interviennent les embeddings vectoriels. Ces « tours de magie » mathématiques transforment des mots, des images et d’autres données en représentations numériques que les ordinateurs peuvent facilement comprendre et manipuler.
Les embeddings vectoriels ouvrent un monde de possibilités en cartographiant l’information dans un espace numérique.
Les embeddings vectoriels sont comme des empreintes digitales numériques pour des mots ou d’autres éléments de données. Au lieu de lettres ou d’images, ils utilisent des nombres organisés dans une structure appelée vecteur, comparable à une liste ordonnée de valeurs.
Imaginez chaque vecteur comme un point dans un espace multidimensionnel, où sa position porte des informations essentielles sur le mot ou la donnée qu’il représente.
Vous vous souvenez peut-être des vecteurs en maths comme des flèches avec une direction et une norme. Les embeddings vectoriels partagent ce principe, mais évoluent dans des espaces à d’innombrables dimensions.
Cette très grande dimensionnalité est cruciale pour capturer les subtiles nuances du langage humain : ton, contexte, caractéristiques grammaticales. Imaginez un vecteur qui distingue non seulement « heureux » et « triste », mais aussi des variations comme « extatique », « satisfait » ou « mélancolique ».
Les embeddings vectoriels sont une technique précieuse pour transformer des données complexes en un format adapté aux algorithmes de machine learning. En convertissant des données catégorielles et de haute dimension en représentations continues de plus faible dimension, ils améliorent les performances des modèles et l’efficacité de calcul tout en préservant les motifs sous-jacents.
Pour illustrer simplement comment on peut définir un espace vectoriel multidimensionnel, voici un tableau avec huit dimensions exemplaires et leur plage de valeurs :
|
Caractéristique |
Description |
Plage |
|
Concrétude |
Mesure du caractère tangible ou abstrait d’un mot |
0 à 1 |
|
Valence émotionnelle |
Positivité ou négativité associée au mot |
-1 à 1 |
|
Fréquence |
Fréquence d’apparition du mot dans un large corpus |
0 à 1 |
|
Longueur |
Nombre de caractères du mot |
0 à 1 |
|
Catégorie grammaticale |
Ensemble de valeurs one-hot représentant nom, verbe, adjectif, autre |
4x [0,1] |
|
Niveau de formalité |
Degré de formalité associé au mot |
0 à 1 |
|
Spécificité |
Degré de spécificité ou de généralité du mot |
0 à 1 |
|
Association sensorielle |
Degré d’association du mot à des expériences sensorielles |
0 à 1 |
Par exemple, le mot « cat » pourrait avoir un vecteur comme : [0.9, 0.2, 0.7, 0.3, 1, 0, 0, 0, 0.4, 0.8, 0.9] et « freedom » : [0.1, 0.8, 0.6, 0.7, 1, 0, 0, 0, 0.7, 0.3, 0.2].
Chaque vecteur agit comme un identifiant unique qui encapsule le sens d’un mot et reflète la façon dont il se relie aux autres. Les mots de sens proches ont souvent des vecteurs situés à proximité dans cet espace numérique, comme des points voisins sur une carte. Cette proximité révèle les connexions sémantiques entre les mots.
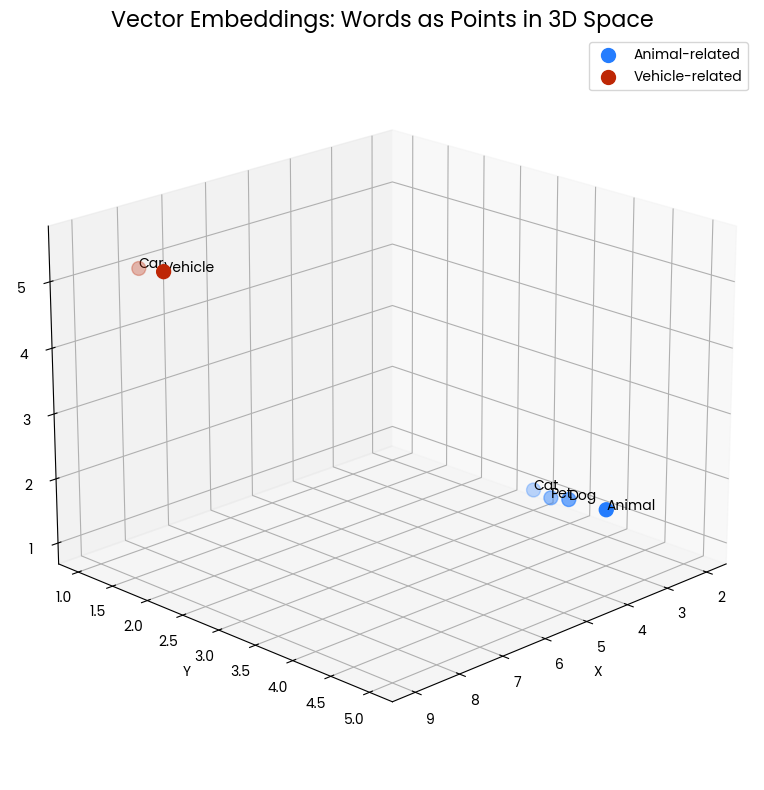
Le nuage de points 3D ci-dessous illustre le concept d’embeddings vectoriels pour des mots. Chaque point représente un mot, et sa position est déterminée par son embedding. Les points bleus regroupés correspondent à des mots liés aux animaux (« Cat », « Dog », « Pet », « Animal »), tandis que les points rouges représentent des mots liés aux véhicules (« Car », « Vehicle »). La proximité des points indique une similarité sémantique : des mots aux sens proches sont placés plus près les uns des autres dans cet espace.
Figure 1 : deux grappes de mots dans un espace en 3D. La proximité indique une similarité sémantique.
Par exemple, « Cat » et « Dog » sont proches, reflétant leurs caractéristiques communes d’animaux de compagnie. De même, « Car » et « Vehicle » sont voisins, ce qui traduit la parenté de leur sens. En revanche, le groupe des animaux est éloigné du groupe des véhicules, illustrant la distinction sémantique entre ces ensembles de concepts.
Cette représentation spatiale nous permet d’appréhender visuellement comment les embeddings vectoriels capturent et modélisent les relations entre les mots. Elle convertit le sens linguistique en relations géométriques mesurables et analysables mathématiquement.
Les embeddings vectoriels sont particulièrement répandus en traitement du langage naturel (NLP), où ils servent à représenter des mots individuels. Ces représentations numériques ne sont pas attribuées au hasard : elles sont apprises à partir de vastes quantités de texte. Voyons comment.
Parmi les techniques NLP pour associer des vecteurs aux mots, Word2Vec fait référence. C’est un modèle de machine learning qui apprend à associer les mots selon leur contexte au sein d’un grand corpus. On peut le voir comme un modèle de langue qui tente de prédire un mot à partir des mots qui l’entourent.
Ce faisant, il apprend implicitement les relations entre les mots, en capturant des informations sémantiques et syntaxiques. Ces relations apprises sont ensuite encodées en vecteurs numériques, exploitables dans diverses tâches NLP. In fine, des mots qui apparaissent souvent ensemble ou dans des contextes similaires auront des vecteurs plus proches dans l’espace d’embedding.
Word2Vec s’appuie sur deux architectures principales pour capturer les relations entre mots : Continuous Bag-of-Words (CBOW) et Skip-gram.
|
Architecture |
Procédure |
Efficacité de calcul |
Relations capturées |
Sensibilité aux mots fréquents |
|
CBOW |
Prédit le mot cible à partir des mots du contexte |
Apprentissage plus rapide |
Meilleur pour les relations syntaxiques (règles grammaticales) |
Plus sensible aux mots fréquents |
|
Skip-gram |
Prédit les mots du contexte à partir du mot cible |
Apprentissage plus lent |
Meilleur pour les relations sémantiques (sens du texte) |
Moins sensible aux mots fréquents |
Skip-gram peut être plus lent à entraîner que CBOW, mais son approche générative est généralement jugée plus précise, notamment pour les mots rares.
Prenons un exemple : imaginez un vaste corpus de textes. Word2Vec commence par analyser la cooccurrence des mots dans une fenêtre de texte donnée. Par exemple, dans la phrase « The king and queen ruled the kingdom. », « king » et « queen » apparaissent ensemble dans une petite fenêtre. Word2Vec capture cette information de cooccurrence.
Au fil de millions de phrases, l’algorithme construit un modèle statistique. Il apprend que des mots comme « king » et « queen » apparaissent fréquemment dans des contextes similaires et encode cette information dans des vecteurs numériques. Ainsi, les vecteurs de « king » et « queen » seront plus proches l’un de l’autre que celui de « apple », qui coapparaît rarement dans les mêmes contextes.
Cette proximité dans l’espace vectoriel reflète la similarité sémantique entre « king » et « queen », démontrant la puissance de Word2Vec pour capter les relations linguistiques.
Maintenant que nous savons ce que sont les embeddings vectoriels et comment ils capturent le sens, passons à l’usage et aux tâches qu’ils permettent.
Comme nous l’avons vu, les embeddings vectoriels excellent à quantifier la similarité sémantique. En mesurant la distance entre des vecteurs de mots, on peut évaluer la proximité de leur sens.
Cette capacité permet, entre autres, de trouver synonymes et antonymes. Les mots de sens proche sont regroupés, tandis que les antonymes partagent souvent de nombreuses dimensions mais s’opposent sur celles qui portent leur différence.
La magie va plus loin avec des analogies complexes. Les embeddings permettent d’effectuer des opérations arithmétiques sur les vecteurs de mots pour découvrir des relations cachées. Par exemple, l’analogie « king est à queen ce que man est à woman » se résout en soustrayant le vecteur de « man » à celui de « king » puis en l’ajoutant à « woman ». Le vecteur obtenu se rapproche alors de « queen », illustrant la puissance des embeddings pour modéliser des motifs linguistiques.
La polyvalence des embeddings dépasse le cadre du mot isolé. Les embeddings de phrases capturent le sens global d’un énoncé. En représentant les phrases par des vecteurs denses, on peut mesurer la similarité sémantique entre différents textes.
Comme les embeddings de mots, les embeddings de phrases sont des vecteurs dans un espace de haute dimension, souvent encore plus élevée pour refléter la complexité des informations au niveau de la phrase. On peut réaliser des opérations mathématiques sur ces vecteurs pour mesurer la similarité sémantique, ce qui permet des tâches plus avancées comme la recherche d’information, la classification de textes ou l’analyse de sentiment.
Une méthode simple consiste à moyenner les embeddings des mots d’une phrase. Si elle est basique, elle offre souvent un bon point de départ. Pour capturer des informations sémantiques et syntaxiques plus riches, on recourt à des techniques avancées comme les réseaux de neurones récurrents (RNN) et les modèles à base de transformers :
|
Architecture |
Traitement |
Compréhension contextuelle |
Efficacité de calcul |
|
RNN |
Séquentiel |
Focalisé sur le contexte local |
Moins efficace pour les longues séquences |
|
Transformers |
Parallèle |
Captent les dépendances à longue portée |
Très efficaces, y compris pour les longues séquences |
Si les RNN ont longtemps dominé, les transformers les ont surpassés en performance et efficacité pour de nombreuses tâches NLP, y compris la génération d’embeddings de phrases.
Cela dit, les RNN gardent leur intérêt dans des cas spécifiques où le traitement séquentiel est crucial. Par ailleurs, de nombreux modèles préentraidés d’embeddings de phrases sont disponibles, offrant des solutions clé en main pour la synthèse de texte, le question-réponse sur base de connaissances ou la reconnaissance d’entités nommées (NER).
Les embeddings vectoriels ne se limitent pas au texte. Les applications suivantes illustrent leur impact dans divers domaines :
Désormais que nous avons vu le fonctionnement des embeddings vectoriels et les types de données qu’ils traitent, passons à des cas d’usage concrets. Commençons par l’exemple le plus célèbre : les modèles de langue de grande taille (LLM).
Les LLM comme ChatGPT, Claude ou Google Gemini reposent largement sur les embeddings vectoriels comme composant fondamental. Ces modèles apprennent à représenter des mots, des expressions, voire des phrases entières, par des vecteurs denses dans un espace de haute dimension. En substance, les embeddings fournissent aux modèles une compréhension sémantique des mots et de leurs relations, constituant l’ossature de leurs capacités impressionnantes.
Cette représentation numérique du texte permet aux LLM de comprendre et de générer un texte proche du langage humain, pour des tâches comme la traduction, le résumé et le question-réponse. Les applications potentielles couvrent de nombreux domaines : création de contenu, service client, éducation, recherche, etc.
Les embeddings vectoriels offrent aussi une alternative aux moteurs de recherche traditionnels, souvent limités à la correspondance de mots-clés. En représentant à la fois les requêtes et les pages par des embeddings, ils aident à comprendre le sens derrière les requêtes et les documents cibles. Les moteurs peuvent ainsi identifier des pages pertinentes au-delà des correspondances exactes et fournir des résultats plus précis et informatifs.
Autre atout : la détection d’anomalies. Les algorithmes mesurent les distances entre points de données représentés en vecteurs et signalent ceux qui s’écartent fortement de la norme. Cette approche s’applique à la détection de fraude, à la sécurité réseau ou à la surveillance de procédés industriels.
Les embeddings contribuent également à combler la barrière des langues. Comme pour « king » et « queen », des relations sémantiques et syntaxiques peuvent être capturées entre langues. On peut ainsi trouver des mots ou expressions correspondants dans la langue cible selon leur similarité vectorielle, ce qui aide des systèmes de traduction comme DeepL à produire des traductions plus justes et fluides.
Enfin, les embeddings sont essentiels pour construire des systèmes de recommandation efficaces. En représentant utilisateurs et objets sous forme d’embeddings, on identifie des utilisateurs ou des éléments similaires par proximité vectorielle, pour proposer des recommandations personnalisées (produits, films, musique, etc.). Par exemple, une personne qui apprécie des films proches d’un film donné a de fortes chances d’aimer d’autres titres aux embeddings voisins.
Vous l’aurez compris, les embeddings vectoriels se sont imposés comme un outil très puissant. En transformant des données complexes en un format aisément exploitable par les algorithmes de machine learning, ils ouvrent un large champ d’applications.
Points clés à retenir :
Pour aller plus loin sur les embeddings vectoriels :
Apprenez l’IA depuis zéro !
Cursus
Cursus
Cursus