
{count, plural, one {कोर्स} other {कोर्स}}
Python में ETL और ELT
{hours} घंटा
40.1K
डेटा आर्किटेक्चर का परिदृश्य विकसित हो रहा है, जिसका प्रमुख कारण क्लाउड तकनीकों का बढ़ता उपयोग और आधुनिक डेटा स्टैक को अपनाना है। इसके परिणामस्वरूप, ELT प्रक्रियाएँ अधिक व्यापक रूप से उपयोग में आ रही हैं। लेकिन इस प्रक्रिया में वास्तव में क्या शामिल होता है?
इस लेख में, हम ELT और उन्नत डेटा आर्किटेक्चर में इसकी भूमिका का अन्वेषण करेंगे।
ELT का अर्थ है Extract, Load, Transform। यह एक डेटा इंटीग्रेशन प्रक्रिया है जिसमें विभिन्न स्रोतों से डेटा निकालना, उसे किसी डेटा स्टोरेज सिस्टम में लोड करना, और उसे ऐसे प्रारूप में रूपांतरित करना शामिल है जिसे आसानी से विश्लेषित किया जा सके।
ELT प्रक्रिया का उपयोग बड़े पैमाने पर आधुनिक डेटा स्टैक आर्किटेक्चर में होता है, जहाँ डेटा को डेटा लेक या वेयरहाउस में संग्रहीत, रूपांतरित और विश्लेषित किया जाता है।
इसके नाम से ही स्पष्ट है कि ELT में तीन मुख्य चरण होते हैं: Extract, Load, और Transform। आइए प्रत्येक चरण को विस्तार से समझते हैं।
ELT प्रक्रिया का पहला चरण विभिन्न स्रोतों जैसे डेटाबेस, फाइलें, API, या वेब सेवाओं से डेटा निकालना है। यह कार्य ELT सॉफ्टवेयर जैसे टूल्स या डेवलपर्स द्वारा लिखी गई कस्टम स्क्रिप्ट्स के माध्यम से किया जा सकता है।
डेटा एक्सट्रैक्शन प्लेटफ़ॉर्म के कुछ उदाहरण Airbyte और Fivetran हैं। कस्टम स्क्रिप्ट लिखने के लिए Apache Spark और Python व्यापक रूप से उपयोग किए जाते हैं.
निकाला गया डेटा स्ट्रक्चर्ड, सेमी-स्ट्रक्चर्ड या अनस्ट्रक्चर्ड हो सकता है और यह विभिन्न प्रकार की प्रणालियों से आ सकता है, जैसे रिलेशनल डेटाबेस, NoSQL डेटाबेस, या क्लाउड स्टोरेज।
डेटा निकाल लेने के बाद, उसे किसी केंद्रीकृत डेटा स्टोरेज सिस्टम, जैसे डेटा लेक या डेटा वेयरहाउस में लोड किया जाता है। इस चरण में निकाले गए डेटा को बिना किसी रूपांतरण के, उसके कच्चे रूप में व्यवस्थित कर संग्रहीत किया जाता है।
आम तौर पर इस चरण में डेटा इंजीनियर शामिल होते हैं, जहाँ वे डेटा को निम्न प्लेटफ़ॉर्म्स पर लोड करते हैं:
ये डेटा प्लेटफ़ॉर्म बड़ी मात्रा में डेटा को तेज़ी से लोड करने की सुविधा देते हैं और विभिन्न स्रोतों से एकत्र किए गए सभी प्रकार के डेटा के लिए एकल सोर्स ऑफ़ ट्रुथ प्रदान करते हैं।
ELT प्रक्रिया का अंतिम चरण कच्चे डेटा को विश्लेषण और रिपोर्टिंग के लिए अनुकूलित प्रारूप में रूपांतरित करना है। इसमें डेटा की सफाई, फ़िल्टरिंग, एग्रीगेशन, और ऐसी संरचना बनाना शामिल है, जिससे बिज़नेस इंटेलिजेंस और एनालिटिक्स टूल्स उसके साथ काम कर सकें।
आमतौर पर इस चरण की ज़िम्मेदारी डेटा इंजीनियर या डेटा वैज्ञानिकों की होती है, और वे निम्नलिखित टूल्स का उपयोग कर सकते हैं:
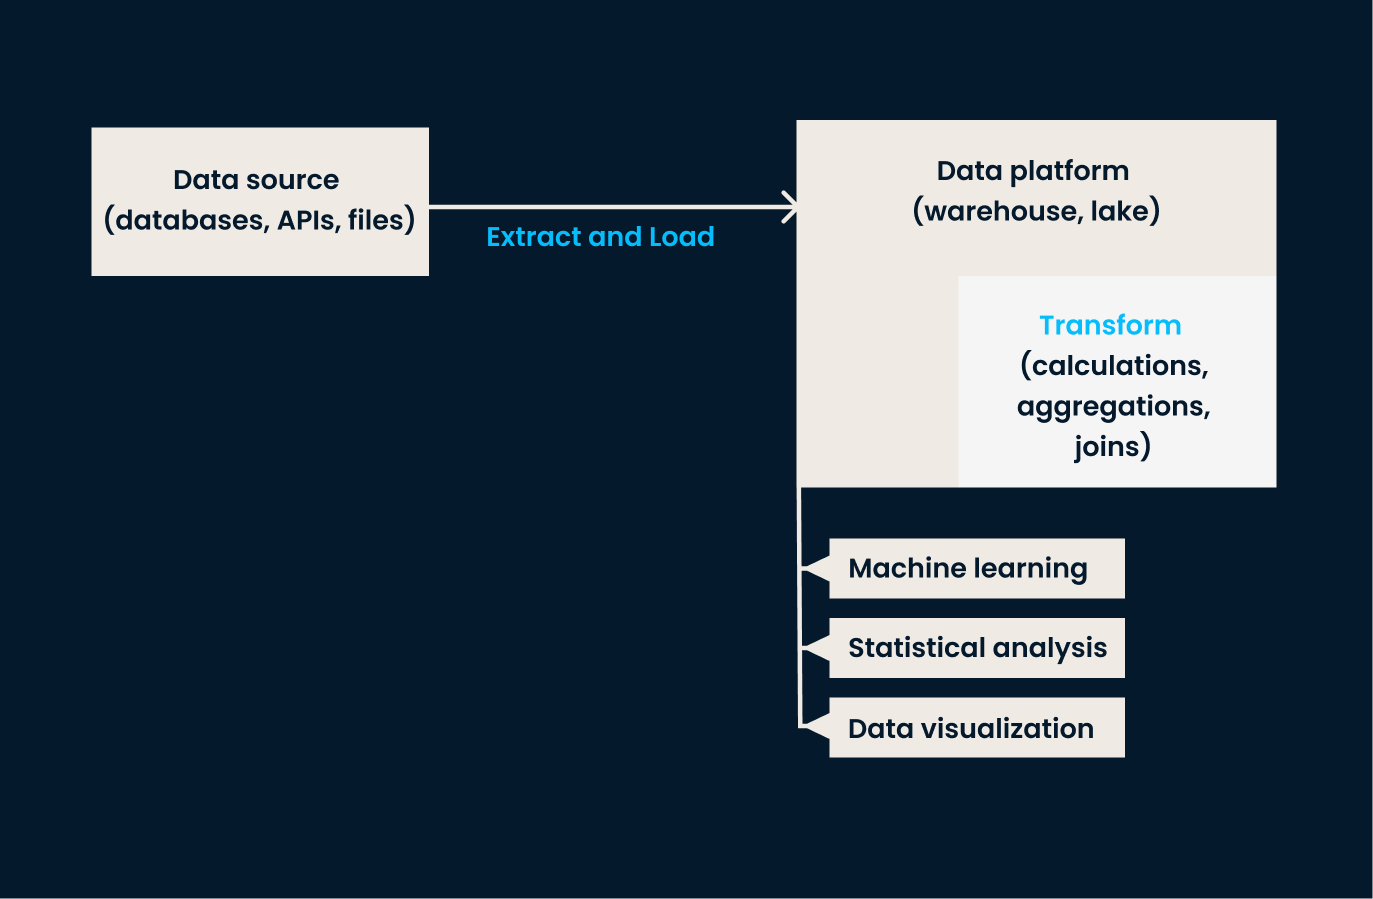
ELT डेटा पाइपलाइन: डेटा पर किसी भी रूपांतरण के लागू होने से पहले एक्सट्रैक्ट और लोड चरण होते हैं। रूपांतरण चरण डेटा प्लेटफ़ॉर्म के भीतर किया जाता है।
डेटा रूपांतरण डेटा वेयरहाउस या डेटा लेक के भीतर किया जाता है, जो बड़े पैमाने के डेटा को संभालना आसान बनाता है। आधुनिक क्लाउड तकनीकों के साथ, यह प्रक्रिया लगभग रीयल-टाइम में की जा सकती है, जिससे संगठनों को विश्लेषण के लिए ताज़ा और सटीक डेटा तक पहुंच मिलती है।
ELT के लिए Python का उपयोग करने के बारे में और सीखना चाहते हैं? ETL and ELT in Python कोर्स आपके लिए बिल्कुल उपयुक्त हो सकता है।
ELT के कई फायदे हैं, जिनमें से कुछ प्रमुख निम्नलिखित हैं:
अब ELT और ETL के बीच के अंतर की तुलना करते हैं।
जैसा कि पहले उल्लेख किया गया, ELT डेटा प्रोसेसिंग का एक नया दृष्टिकोण है जिसमें डेटा पहले एक केंद्रीय रिपॉजिटरी में लोड किया जाता है, जिससे रूपांतरण लोडिंग के बाद किए जा सकते हैं।
इसके विपरीत, ETL (Extract, Transform, Load) पारंपरिक पद्धति है जिसमें डेटा को गंतव्य सिस्टम में लोड करने से पहले रूपांतरित किया जाता है। ये मौलिक अंतर न केवल प्रक्रिया को बल्कि गति, लागत और सुरक्षा को भी प्रभावित करते हैं।
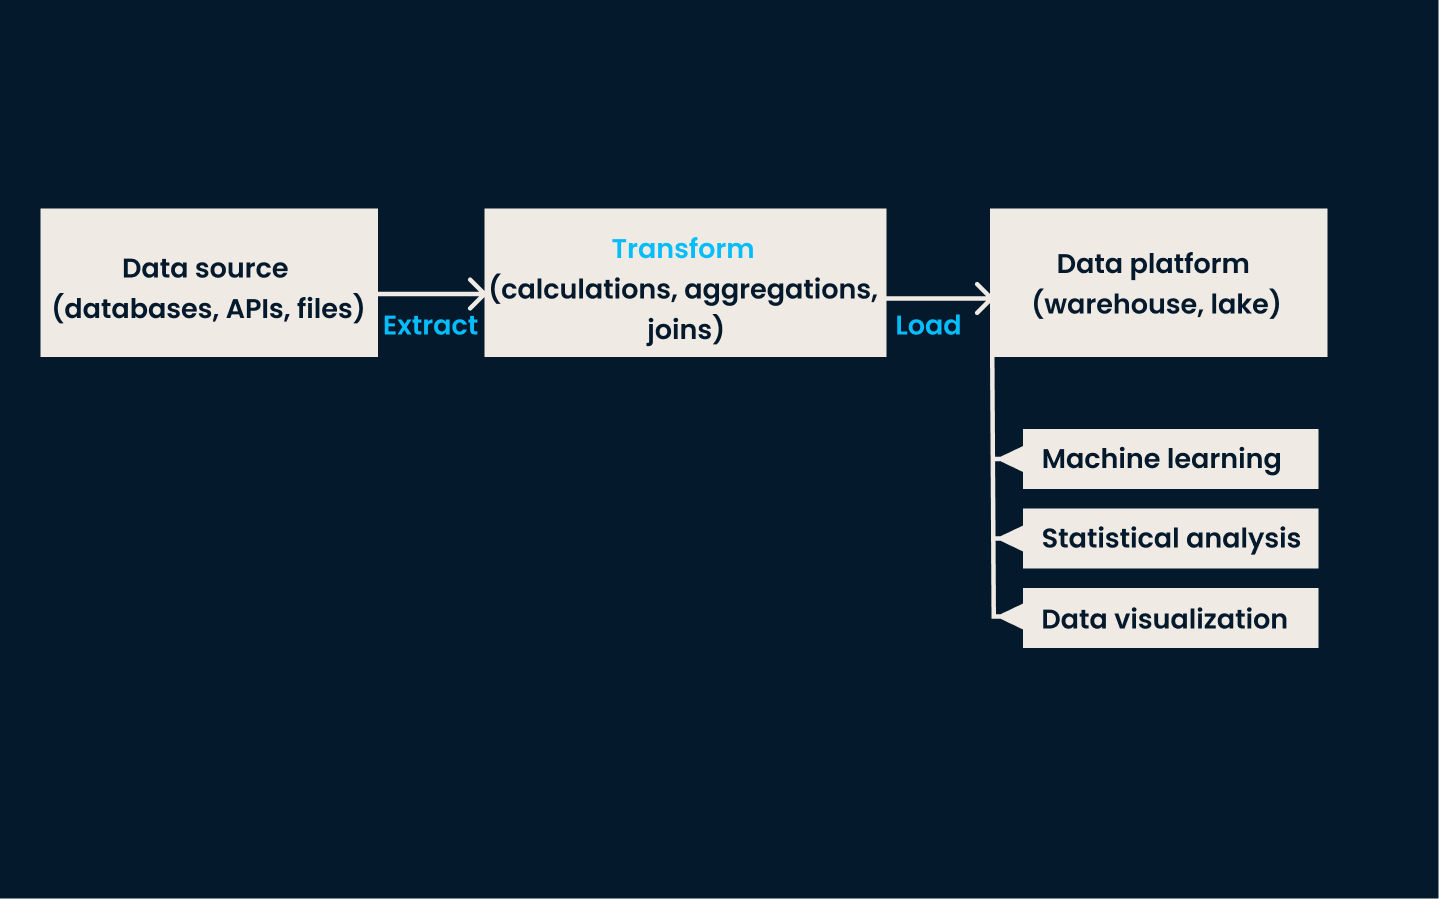
ETL पाइपलाइन: डेटा को गंतव्य प्लेटफ़ॉर्म पर लोड करने से पहले रूपांतरण चरण होता है। आम तौर पर, रूपांतरण डेटा प्लेटफ़ॉर्म के बजाय एक अलग सर्वर पर होता है।
ELT 'पहले लोड, बाद में रूपांतरण' दृष्टिकोण का पालन करता है, जहाँ डेटा को उसके कच्चे रूप में स्टोरेज सिस्टम में लोड किया जाता है और फिर विश्लेषण के लिए रूपांतरित किया जाता है.
दूसरी ओर, ETL 'एक्सट्रैक्ट-ट्रांसफॉर्म-लोड' दृष्टिकोण का पालन करता है, जहाँ डेटा विभिन्न स्रोतों से निकाला जाता है, फिर रूपांतरित किया जाता है, और अंततः डेटा वेयरहाउस में लोड किया जाता है।
ELT दृष्टिकोण अपनी तेज़ डेटा प्रोसेसिंग गति के लिए जाना जाता है, क्योंकि यह मध्यवर्ती स्टेजिंग क्षेत्र की आवश्यकता को समाप्त करता है। यह रीयल-टाइम या नियर-रीयल-टाइम डेटा विश्लेषण की अनुमति देता है.
इसके विपरीत, ETL में अक्सर डेटा को रूपांतरित और लोड करने के कई चरणों के कारण अधिक समय लग सकता है।
इसके अलावा, ELT में महंगे ETL सॉफ्टवेयर की आवश्यकता समाप्त हो जाती है, क्योंकि रूपांतरण SQL क्वेरीज़ या अन्य ओपन-सोर्स टूल्स का उपयोग करके किए जा सकते हैं।
इसके विपरीत, पारंपरिक ETL प्रक्रियाएँ अक्सर ऑन-प्रिमाइसेस इन्फ्रास्ट्रक्चर में बेहतर फिट बैठती हैं, जहाँ डेटा स्रोत सीमित होते हैं और हार्डवेयर संसाधन क्लाउड-आधारित वातावरण की तुलना में कम स्केलेबल होते हैं। ऑन-प्रिमाइसेस इन्फ्रास्ट्रक्चर की लागत अक्सर क्लाउड इन्फ्रास्ट्रक्चर से अधिक होती है।
अंततः, ELT लोड प्रोसेस के दौरान व्यक्तिगत पहचान योग्य जानकारी (PII) के डेटा एन्क्रिप्शन और डेटा मास्किंग की अनुमति देता है, क्योंकि यह एक सुरक्षित केंद्रीय रिपॉजिटरी में किया जाता है.
ETL प्रक्रियाओं में एक्सट्रैक्शन और ट्रांसफ़ॉर्मेशन के पूरे दौरान डेटा सुरक्षा सुनिश्चित करनी होती है। हालाँकि, यह कठिन साबित होता है, क्योंकि डेटा को अतिरिक्त स्टेजिंग स्टोरेज में ले जाना पड़ता है और अक्सर अलग सर्वरों पर प्रोसेस किया जाता है।
तेज़ डेटा प्रोसेसिंग गति और क्लाउड कंप्यूटिंग एनालिटिक्स के साथ, ELT प्रक्रिया ने कुछ ऐसे उपयोग मामलों में बेहतर प्रदर्शन दिखाया है जहाँ यह ETL की तुलना में चमकता है।
ELT प्रक्रिया के कुछ सामान्य उपयोग इस प्रकार हैं:
संगठनों के पास ELT प्रक्रियाओं को लागू करने के लिए विभिन्न टूल्स और तकनीकें उपलब्ध हैं। इनमें शामिल हैं:
ELT प्रक्रिया के लोडिंग चरण में, डेटा लेक और डेटा वेयरहाउस किसी कंपनी के भीतर केंद्रीकृत डेटा स्टोरेज स्पेस प्रदान करने के लिए आवश्यक होते हैं।
यहाँ सबसे लोकप्रिय क्लाउड डेटा प्लेटफ़ॉर्म दिए गए हैं:
कई संगठन अपनी किफायती प्रकृति के कारण ELT प्रक्रियाओं के लिए ओपन-सोर्स टूल्स का भी लाभ उठाते हैं।
ये टूल्स ELT प्रक्रिया के विभिन्न चरणों में मदद कर सकते हैं:
ओपन-सोर्स टूल्स ELT प्रक्रियाओं के लिए उत्कृष्ट मेल हैं क्योंकि वे लचीलापन, डेवलपर समर्थन और कई इंटीग्रेशन विकल्प प्रदान करते हैं।
डेवलपर्स अतिरिक्त कस्टमाइज़ेबिलिटी के लिए प्रोग्रामिंग भाषाओं का उपयोग करके बनाई गई स्क्रिप्ट्स का भी चयन कर सकते हैं। इनमें आमतौर पर डेटा को प्रोसेस और रूपांतरित करने के लिए पैकेजेस और लाइब्रेरियों का उपयोग शामिल होता है।
इन स्क्रिप्ट्स के लिए उपयोग की जाने वाली कुछ सामान्य प्रोग्रामिंग भाषाएँ इस प्रकार हैं:
निष्कर्षतः, ELT डेटा प्रोसेसिंग में एक नया और उभरता रुझान है जो पारंपरिक ETL तरीकों पर कई लाभ प्रदान करता है। यह तेज़ और अधिक कुशल डेटा रूपांतरण की अनुमति देता है और अधिक लचीलापन तथा स्केलेबिलिटी प्रदान करता है.
यदि आप ELT या अन्य डेटा इंजीनियरिंग अवधारणाओं के बारे में और जानने के बारे में सोच रहे हैं, तो आपको हमारा Data Engineer Certification या हमारा Data Engineer in Python Career Track पसंद आ सकता है।
इन कोर्सेज के साथ डेटा इंजीनियरिंग और डेटा प्रोसेसिंग के बारे में और जानें!
{count, plural, one {कोर्स} other {कोर्स}}
{count, plural, one {लर्निंग पाथ} other {लर्निंग पाथ}}
{count, plural, one {कोर्स} other {कोर्स}}