Le paysage de l’architecture data évolue, porté par l’essor des technologies cloud et l’adoption de la modern data stack. Résultat : les processus ELT se généralisent. Mais en quoi consistent-ils exactement ?
Dans cet article, nous passons en revue l’ELT et son rôle dans une architecture data avancée.
Qu’est-ce que l’ELT ?
ELT signifie Extract, Load, Transform (extraire, charger, transformer). Il s’agit d’un processus d’intégration de données qui consiste à extraire des données de différentes sources, à les charger dans un système de stockage, puis à les transformer dans un format facile à analyser.
Le processus ELT est largement utilisé dans l’architecture modern data stack, où les données sont stockées, transformées et analysées dans un data lake ou un data warehouse.
Comme son nom l’indique, l’ELT se déroule en trois étapes : Extract, Load et Transform. Examinons-les de plus près.
La première étape consiste à extraire les données de diverses sources, comme des bases de données, des fichiers, des API ou des services web. Cette extraction peut s’effectuer à l’aide d’outils ELT dédiés ou de scripts personnalisés développés en interne.
Parmi les plateformes d’extraction, on peut citer Airbyte et Fivetran. Pour écrire des scripts sur mesure, Apache Spark et Python sont largement utilisés.
Les données extraites peuvent être structurées, semi-structurées ou non structurées et provenir de différents systèmes : bases relationnelles, bases NoSQL ou stockage cloud.
2. Load
Une fois extraites, les données sont chargées dans un système de stockage centralisé, tel qu’un data lake ou un data warehouse. Cette étape consiste à organiser et stocker les données brutes, sans transformation préalable.
Les data engineers interviennent généralement pour charger les données vers des plateformes comme :
Ces plateformes permettent de charger rapidement de gros volumes de données et offrent une source de vérité unique pour l’ensemble des données collectées.
Dernière étape, la transformation des données brutes dans un format optimisé pour l’analyse et le reporting. Elle inclut le nettoyage, le filtrage, l’agrégation et la structuration des données afin de les rendre exploitables par les outils de business intelligence et d’analytique.
Les data engineers ou data scientists réalisent généralement cette étape, avec des outils tels que :
- Requêtes SQL
- Apache Spark
- Bibliothèques Python comme Pandas ou NumPy
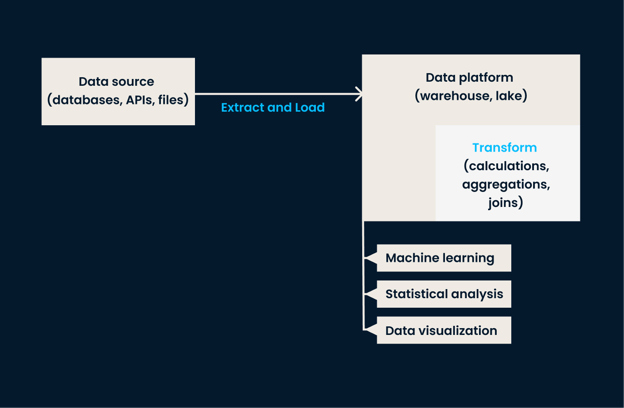
Pipeline ELT : les phases d’extraction et de chargement précèdent toute transformation des données. La transformation est effectuée au sein de la plateforme data.
La transformation est réalisée dans le data warehouse ou le data lake, ce qui facilite la gestion de grands volumes. Avec les technologies cloud modernes, ce processus peut s’opérer en quasi temps réel, offrant aux organisations des données fraîches et fiables pour l’analyse.
Vous souhaitez apprendre à utiliser Python pour l’ELT ? Le cours ETL and ELT in Python est fait pour vous.
Les avantages de l’ELT
L’ELT présente de nombreux atouts, parmi lesquels :
- Scalabilité : grâce à la puissance du cloud, l’ELT permet d’extraire, de charger et de transformer de grands volumes de données plus rapidement que les processus ETL traditionnels.
- Flexibilité : l’ELT facilite l’intégration de sources variées, qu’elles soient structurées, semi-structurées ou non structurées.
- Vitesse d’accès aux insights : les données brutes stockées dans un data lake ou un data warehouse peuvent être transformées à la demande, rapidement, pour fournir des insights en temps réel et accélérer la prise de décision.
ELT vs ETL
Comparons maintenant les différences entre ELT et ETL.
Comme indiqué précédemment, l’ELT est une approche plus récente : les données sont d’abord chargées dans un référentiel central, puis transformées a posteriori.
À l’inverse, l’ETL (Extract, Transform, Load) est une méthodologie traditionnelle dans laquelle les données sont transformées avant d’être chargées dans le système cible. Ces différences fondamentales impactent non seulement le processus, mais aussi la vitesse, les coûts et la sécurité.
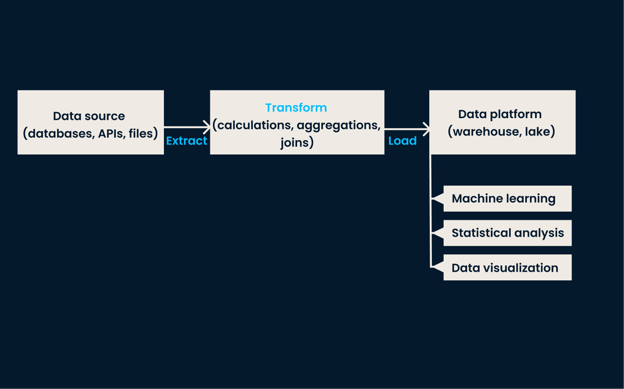
Pipeline ETL : la transformation a lieu avant le chargement vers la plateforme cible. Elle s’effectue généralement sur un serveur distinct, et non dans la plateforme data elle-même.
Processus
L’ELT suit une logique « charger d’abord, transformer ensuite », où les données sont chargées à l’état brut dans un système de stockage, puis transformées pour l’analyse.
L’ETL, de son côté, suit l’enchaînement « extract-transform-load » : les données sont extraites, transformées, puis chargées dans un data warehouse.
Vitesse
L’approche ELT est réputée plus rapide, car elle évite le passage par une zone de transit intermédiaire. Elle autorise ainsi des analyses en temps réel ou quasi temps réel.
À l’inverse, l’ETL peut être plus long en raison des étapes multiples de transformation et de chargement.
Coûts
L’ELT réduit aussi le recours à des logiciels ETL coûteux, les transformations pouvant être réalisées avec des requêtes SQL ou d’autres outils open source.
À l’inverse, les processus ETL traditionnels s’adaptent mieux aux environnements on-premise, où les sources de données sont limitées et les ressources matérielles moins extensibles que dans le cloud. Les infrastructures on-premise entraînent souvent des coûts supérieurs à ceux du cloud.
Sécurité
Enfin, l’ELT permet de chiffrer les données et de masquer les informations personnelles (PII) pendant le chargement, puisque tout s’effectue dans un référentiel central sécurisé.
Les processus ETL doivent garantir la sécurité tout au long de l’extraction et de la transformation, ce qui s’avère plus complexe, les données transitant par des stockages intermédiaires et étant souvent traitées sur des serveurs séparés.
Cas d’usage de l’ELT
Grâce à sa vitesse de traitement et aux capacités analytiques du cloud, l’ELT excelle dans plusieurs scénarios par rapport à l’ETL.
Quelques usages courants :
- Reporting applicatif en temps réel : l’ELT offre une visibilité immédiate sur les comportements des utilisateurs.
- Data warehousing : de nombreuses organisations utilisent l’ELT pour charger et transformer les données dans un data warehouse centralisé à des fins de reporting et d’analytique.
- Intégration de données dans le cloud : avec la généralisation du cloud, l’ELT s’impose pour intégrer des sources issues d’applications on-premise et cloud.
Outils et technologies ELT
De nombreux outils et technologies permettent de mettre en œuvre des processus ELT. Citons notamment :
Data warehouses et data lakes
Lors de l’étape de chargement, les data lakes et data warehouses sont essentiels pour fournir un espace de stockage centralisé au sein de l’entreprise.
Voici les plateformes cloud les plus populaires :
- Amazon Redshift : un service de data warehouse dans le cloud, rapide et efficace sur de très gros volumes.
- Google BigQuery : data warehouse cloud serverless et scalable, permettant d’interroger rapidement de vastes jeux de données.
- Snowflake : data warehouse cloud compatible ELT, offrant des performances et une sécurité avancées.
- Amazon S3 : service de stockage cloud utilisable comme data lake pour conserver des données brutes, transformables ensuite via SQL ou d’autres outils.
Outils ELT open source
Beaucoup d’organisations privilégient des outils open source pour l’ELT en raison de leur rapport coût/valeur.
Ces outils peuvent intervenir à différentes étapes du processus :
- Apache Airflow : orchestration et planification des workflows ETL/ELT.
- dbt : logiciel open source pour transformer les données dans un data warehouse via SQL.
- Airbyte : plateforme d’intégration de données open source prenant en charge l’ELT et l’ETL.
- Singer : outil open source utilisé en ELT comme en ETL grâce à une approche modulaire.
- Apache NiFi : outil open source d’intégration de données prenant en charge le routage, la transformation et la médiation entre systèmes.
Les outils open source s’accordent particulièrement bien avec l’ELT, offrant flexibilité, soutien des développeurs et de nombreuses options d’intégration.
Scripts personnalisés
Les développeurs peuvent aussi s’appuyer sur des scripts rédigés dans des langages de programmation pour plus de personnalisation. Ils mobilisent alors des packages et bibliothèques pour traiter et transformer les données.
Parmi les langages courants utilisés :
- Python : avec des bibliothèques comme Pandas, NumPy et SQLAlchemy pour l’extraction, le chargement et la transformation.
- Apache Spark : pour le traitement et l’analyse de données massives, avec Python (PySpark), Java ou Scala.
- R : le framework tidyverse et des bibliothèques comme dplyr et data.table pour l’extraction et la transformation.
- SQL : les requêtes SQL pour les tâches de transformation, et SQL Server Integration Services (SSIS), un outil ETL populaire, compatible également avec l’ELT.
- Scala : souvent utilisée avec Apache Spark pour le big data et les tâches ELT.
- Java : couramment utilisé avec Apache Hadoop et Apache Spark pour des processus ELT.
Pour conclure
En résumé, l’ELT est une tendance émergente du traitement des données qui offre de nombreux avantages par rapport aux méthodes ETL traditionnelles. Il permet des transformations plus rapides et plus efficaces, avec davantage de flexibilité et d’évolutivité.
Si vous souhaitez en savoir plus sur l’ELT ou d’autres concepts de data engineering, découvrez notre Data Engineer Certification ou notre Data Engineer in Python Career Track.





Le paysage de l’architecture data évolue, porté par l’essor des technologies cloud et l’adoption de la modern data stack. Résultat : les processus ELT se généralisent. Mais en quoi consistent-ils exactement ?
Dans cet article, nous passons en revue l’ELT et son rôle dans une architecture data avancée.
Qu’est-ce que l’ELT ?
ELT signifie Extract, Load, Transform (extraire, charger, transformer). Il s’agit d’un processus d’intégration de données qui consiste à extraire des données de différentes sources, à les charger dans un système de stockage, puis à les transformer dans un format facile à analyser.
Le processus ELT est largement utilisé dans l’architecture modern data stack, où les données sont stockées, transformées et analysées dans un data lake ou un data warehouse.
Comment fonctionne l’ELT ?
Comme son nom l’indique, l’ELT se déroule en trois étapes : Extract, Load et Transform. Examinons-les de plus près.
1. Extract
La première étape consiste à extraire les données de diverses sources, comme des bases de données, des fichiers, des API ou des services web. Cette extraction peut s’effectuer à l’aide d’outils ELT dédiés ou de scripts personnalisés développés en interne.
Parmi les plateformes d’extraction, on peut citer Airbyte et Fivetran. Pour écrire des scripts sur mesure, Apache Spark et Python sont largement utilisés.
Les données extraites peuvent être structurées, semi-structurées ou non structurées et provenir de différents systèmes : bases relationnelles, bases NoSQL ou stockage cloud.
2. Load
Une fois extraites, les données sont chargées dans un système de stockage centralisé, tel qu’un data lake ou un data warehouse. Cette étape consiste à organiser et stocker les données brutes, sans transformation préalable.
Les data engineers interviennent généralement pour charger les données vers des plateformes comme :
Ces plateformes permettent de charger rapidement de gros volumes de données et offrent une source de vérité unique pour l’ensemble des données collectées.
3. Transform
Dernière étape, la transformation des données brutes dans un format optimisé pour l’analyse et le reporting. Elle inclut le nettoyage, le filtrage, l’agrégation et la structuration des données afin de les rendre exploitables par les outils de business intelligence et d’analytique.
Les data engineers ou data scientists réalisent généralement cette étape, avec des outils tels que :
Pipeline ELT : les phases d’extraction et de chargement précèdent toute transformation des données. La transformation est effectuée au sein de la plateforme data.
La transformation est réalisée dans le data warehouse ou le data lake, ce qui facilite la gestion de grands volumes. Avec les technologies cloud modernes, ce processus peut s’opérer en quasi temps réel, offrant aux organisations des données fraîches et fiables pour l’analyse.
Vous souhaitez apprendre à utiliser Python pour l’ELT ? Le cours ETL and ELT in Python est fait pour vous.
Les avantages de l’ELT
L’ELT présente de nombreux atouts, parmi lesquels :
ELT vs ETL
Comparons maintenant les différences entre ELT et ETL.
Comme indiqué précédemment, l’ELT est une approche plus récente : les données sont d’abord chargées dans un référentiel central, puis transformées a posteriori.
À l’inverse, l’ETL (Extract, Transform, Load) est une méthodologie traditionnelle dans laquelle les données sont transformées avant d’être chargées dans le système cible. Ces différences fondamentales impactent non seulement le processus, mais aussi la vitesse, les coûts et la sécurité.
Pipeline ETL : la transformation a lieu avant le chargement vers la plateforme cible. Elle s’effectue généralement sur un serveur distinct, et non dans la plateforme data elle-même.
Processus
L’ELT suit une logique « charger d’abord, transformer ensuite », où les données sont chargées à l’état brut dans un système de stockage, puis transformées pour l’analyse.
L’ETL, de son côté, suit l’enchaînement « extract-transform-load » : les données sont extraites, transformées, puis chargées dans un data warehouse.
Vitesse
L’approche ELT est réputée plus rapide, car elle évite le passage par une zone de transit intermédiaire. Elle autorise ainsi des analyses en temps réel ou quasi temps réel.
À l’inverse, l’ETL peut être plus long en raison des étapes multiples de transformation et de chargement.
Coûts
L’ELT réduit aussi le recours à des logiciels ETL coûteux, les transformations pouvant être réalisées avec des requêtes SQL ou d’autres outils open source.
À l’inverse, les processus ETL traditionnels s’adaptent mieux aux environnements on-premise, où les sources de données sont limitées et les ressources matérielles moins extensibles que dans le cloud. Les infrastructures on-premise entraînent souvent des coûts supérieurs à ceux du cloud.
Sécurité
Enfin, l’ELT permet de chiffrer les données et de masquer les informations personnelles (PII) pendant le chargement, puisque tout s’effectue dans un référentiel central sécurisé.
Les processus ETL doivent garantir la sécurité tout au long de l’extraction et de la transformation, ce qui s’avère plus complexe, les données transitant par des stockages intermédiaires et étant souvent traitées sur des serveurs séparés.
Cas d’usage de l’ELT
Grâce à sa vitesse de traitement et aux capacités analytiques du cloud, l’ELT excelle dans plusieurs scénarios par rapport à l’ETL.
Quelques usages courants :
Outils et technologies ELT
De nombreux outils et technologies permettent de mettre en œuvre des processus ELT. Citons notamment :
Data warehouses et data lakes
Lors de l’étape de chargement, les data lakes et data warehouses sont essentiels pour fournir un espace de stockage centralisé au sein de l’entreprise.
Voici les plateformes cloud les plus populaires :
Outils ELT open source
Beaucoup d’organisations privilégient des outils open source pour l’ELT en raison de leur rapport coût/valeur.
Ces outils peuvent intervenir à différentes étapes du processus :
Les outils open source s’accordent particulièrement bien avec l’ELT, offrant flexibilité, soutien des développeurs et de nombreuses options d’intégration.
Scripts personnalisés
Les développeurs peuvent aussi s’appuyer sur des scripts rédigés dans des langages de programmation pour plus de personnalisation. Ils mobilisent alors des packages et bibliothèques pour traiter et transformer les données.
Parmi les langages courants utilisés :
Pour conclure
En résumé, l’ELT est une tendance émergente du traitement des données qui offre de nombreux avantages par rapport aux méthodes ETL traditionnelles. Il permet des transformations plus rapides et plus efficaces, avec davantage de flexibilité et d’évolutivité.
Si vous souhaitez en savoir plus sur l’ELT ou d’autres concepts de data engineering, découvrez notre Data Engineer Certification ou notre Data Engineer in Python Career Track.