Lewati ke konten utama

Penjelasan ELT: Integrasi Data untuk Era Cloud

Pelajari proses ELT (Extract, Load, Transform) dan perannya dalam arsitektur data modern. Ketahui bagaimana ELT meningkatkan integrasi dan pemrosesan data.
Diperbarui 28 Sep 2026  · 7 mnt Baca

Jelajahi bersama AI

ChatGPTClaudePerplexity

Lanskap arsitektur data terus berkembang, didorong oleh meningkatnya penggunaan teknologi cloud dan adopsi modern data stack. Akibatnya, proses ELT semakin banyak digunakan. Namun, apa saja yang sebenarnya terlibat dalam proses ini?

Dalam artikel ini, kita akan membahas ELT dan perannya dalam arsitektur data tingkat lanjut.

Apa Itu ELT?

ELT adalah singkatan dari Extract, Load, Transform. Ini adalah proses integrasi data yang melibatkan pengambilan data dari berbagai sumber, memuatnya ke dalam sistem penyimpanan data, dan mentransformasikannya ke format yang mudah dianalisis.

Proses ELT banyak digunakan dalam arsitektur modern data stack, di mana data disimpan, ditransformasikan, dan dianalisis di data lake atau gudang data.

Bagaimana ELT Bekerja?

Sesuai namanya, ELT melibatkan tiga langkah utama: Extract, Load, dan Transform. Mari kita bahas masing-masing langkah secara lebih rinci.

1. Extract

Langkah pertama dalam proses ELT adalah mengekstrak data dari berbagai sumber seperti basis data, file, API, atau layanan web. Ini dapat dilakukan menggunakan alat seperti perangkat lunak ELT atau skrip kustom yang ditulis oleh pengembang.

Beberapa contoh platform ekstraksi data termasuk Airbyte dan Fivetran. Untuk menulis skrip kustom, Apache Spark dan Python banyak digunakan. 

Data yang diekstraksi bisa terstruktur, semi-terstruktur, atau tidak terstruktur dan dapat berasal dari berbagai jenis sistem, seperti basis data relasional, basis data NoSQL, atau penyimpanan cloud.

2. Load

Setelah data diekstraksi, data dimuat ke sistem penyimpanan data terpusat seperti data lake atau gudang data. Langkah ini melibatkan pengorganisasian dan penyimpanan data yang diekstraksi dalam format mentah tanpa transformasi apa pun.

Data engineer biasanya terlibat dalam langkah ini, di mana mereka memuat data ke platform seperti:

Platform data ini memungkinkan pemuatan cepat dalam jumlah data yang besar dan menyediakan single source of truth untuk semua jenis data yang dikumpulkan dari berbagai sumber.

3. Transform

Langkah terakhir dalam proses ELT adalah mentransformasikan data mentah menjadi format yang dioptimalkan untuk analisis dan pelaporan. Ini mencakup pembersihan, penyaringan, pengagregasian, dan penataan data dengan cara yang sesuai untuk alat business intelligence dan analitik.

Data engineer atau data scientist biasanya bertanggung jawab atas langkah ini, dan mereka dapat menggunakan alat seperti:
  • Kueri SQL
  • Apache Spark
  • Pustaka Python seperti Pandas atau NumPy

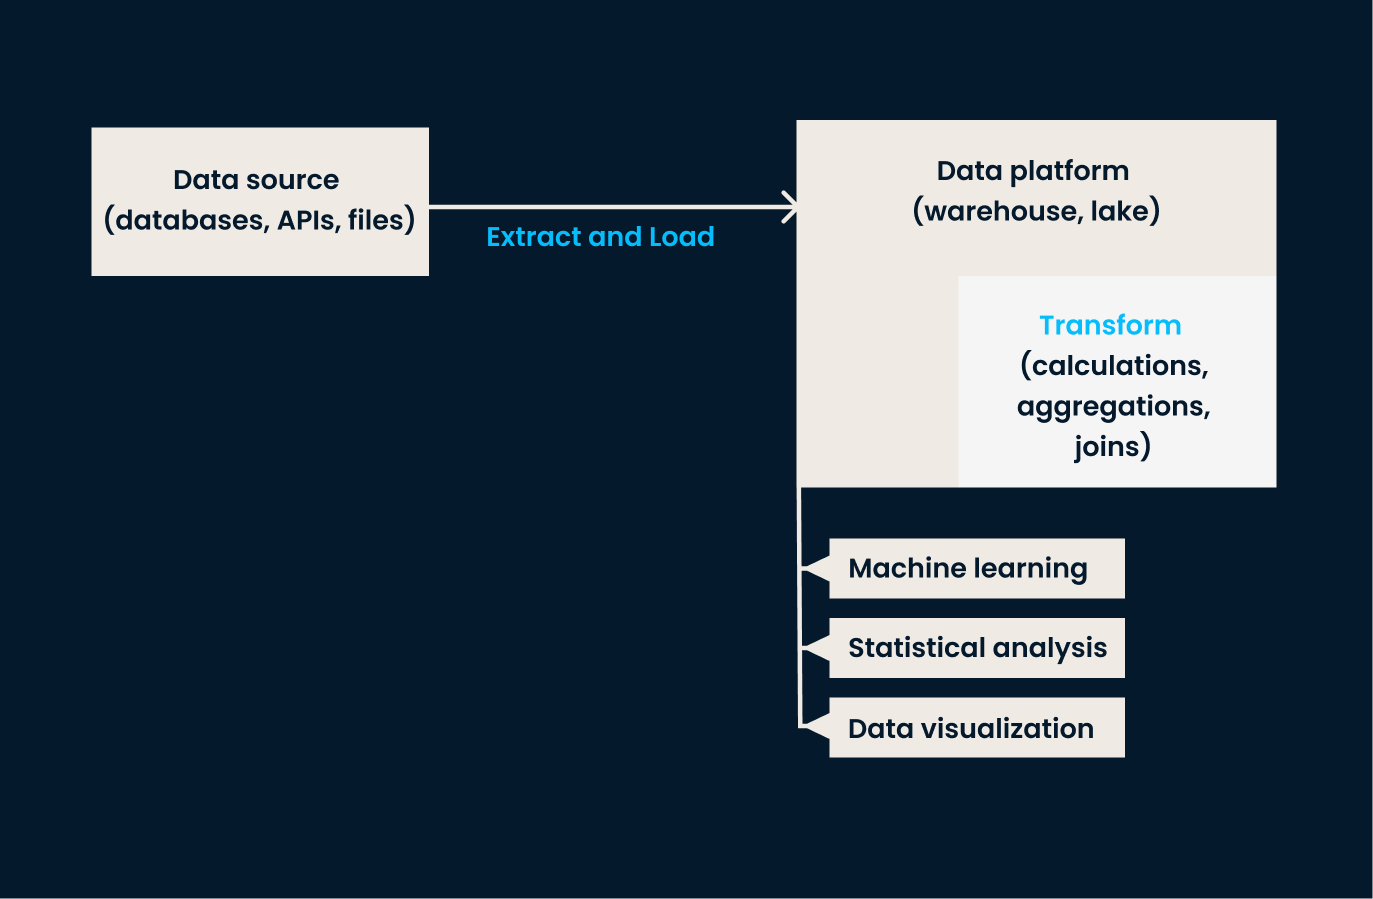
Pipa data ELT

Pipa data ELT: Tahap ekstraksi dan pemuatan terjadi sebelum transformasi apa pun diterapkan pada data. Langkah transformasi dilakukan di dalam platform data.

Transformasi data dilakukan di dalam gudang data atau data lake, yang memungkinkan penanganan volume data besar dengan lebih mudah. Dengan teknologi cloud modern, proses ini dapat dilakukan hampir secara real-time, sehingga organisasi mendapatkan akses ke data yang segar dan akurat untuk dianalisis.

Ingin mempelajari lebih lanjut tentang penggunaan Python untuk ELT? Kursus ETL and ELT in Python mungkin tepat untuk Anda.

Keunggulan ELT

ELT memiliki banyak manfaat, berikut beberapa yang menonjol:

  • Skalabilitas: ELT memungkinkan ekstraksi, pemuatan, dan transformasi data dalam jumlah besar lebih cepat dibandingkan proses ETL tradisional, berkat kekuatan komputasi cloud.
  • Fleksibilitas: ELT memungkinkan integrasi data dari berbagai sumber, termasuk data terstruktur, semi-terstruktur, dan tidak terstruktur.
  • Kecepatan wawasan real-time: Data mentah yang disimpan di data lake atau gudang data dapat ditransformasikan sesuai permintaan dengan cepat, memberikan wawasan real-time untuk pengambilan keputusan yang lebih cepat.

ELT vs ETL

Sekarang mari bandingkan perbedaan antara ELT dan ETL.

Seperti disebutkan sebelumnya, ELT adalah pendekatan pemrosesan data yang lebih baru di mana data terlebih dahulu dimuat ke repositori pusat, memungkinkan transformasi dilakukan setelah pemuatan.

Sebaliknya, ETL (Extract, Transform, Load) adalah metodologi tradisional di mana data ditransformasikan sebelum dimuat ke sistem tujuan. Perbedaan mendasar ini memengaruhi tidak hanya prosesnya, tetapi juga kecepatan, biaya, dan keamanan.
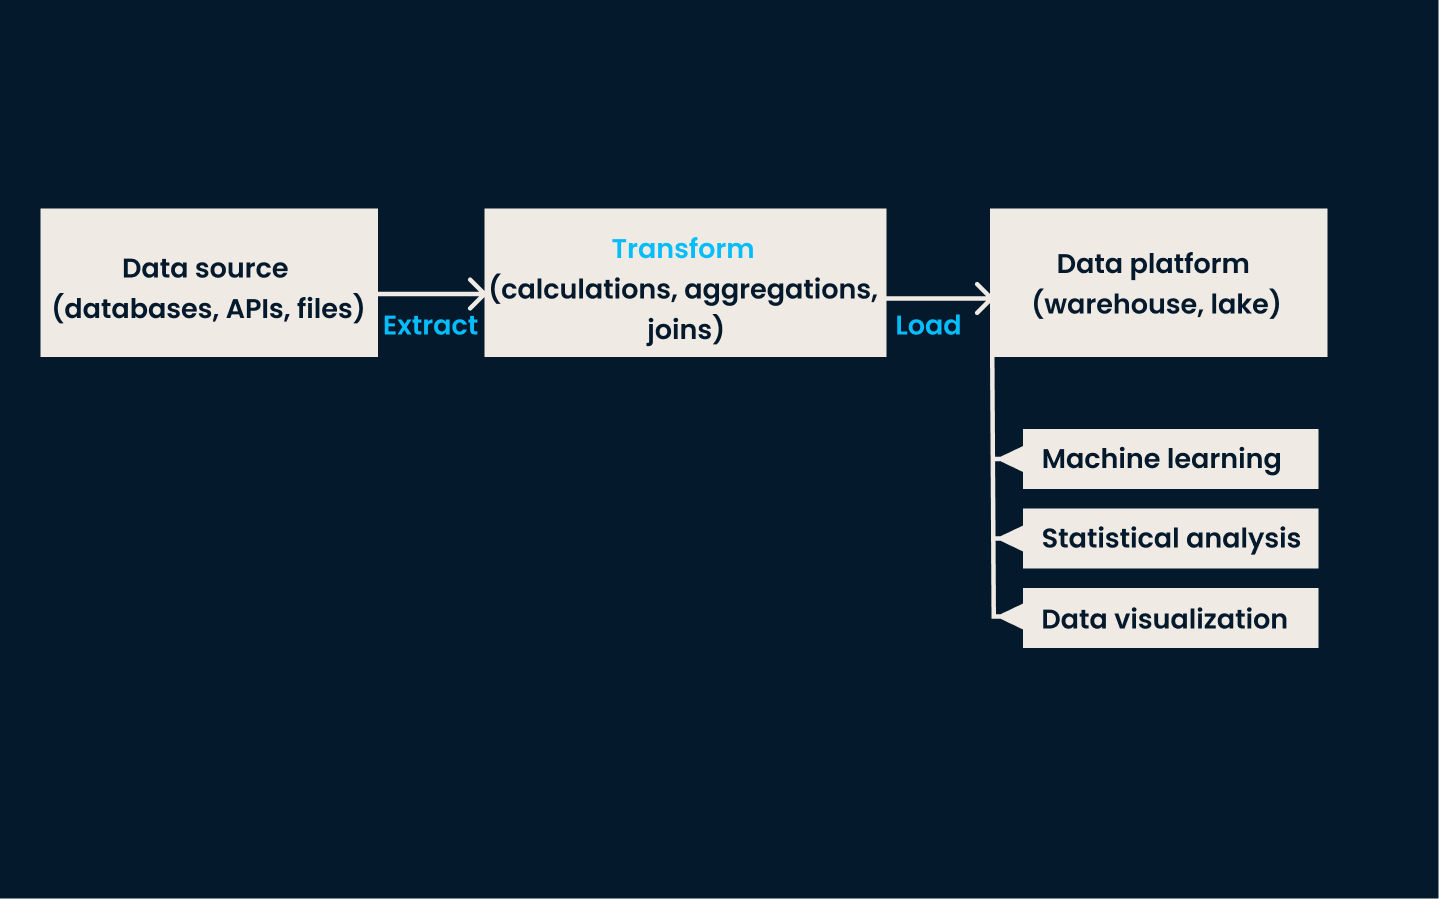
Pipa data ETL

Pipa ETL: Langkah transformasi terjadi sebelum memuat data ke platform tujuan. Biasanya, transformasi terjadi pada server terpisah, bukan di platform data itu sendiri.

Proses

ELT mengikuti pendekatan 'muat terlebih dahulu, transformasi kemudian' di mana data dimuat ke sistem penyimpanan dalam bentuk mentah lalu ditransformasikan untuk analisis. 

Di sisi lain, ETL mengikuti pendekatan 'ekstrak-transformasi-muat' di mana data diekstraksi dari berbagai sumber, kemudian ditransformasikan, dan akhirnya dimuat ke gudang data.

Kecepatan

Pendekatan ELT dikenal memiliki kecepatan pemrosesan data yang lebih tinggi karena menghilangkan kebutuhan akan area staging perantara. Ini memungkinkan analisis data secara real-time atau hampir real-time. 

Sebaliknya, ETL sering kali memerlukan waktu lebih lama karena banyaknya langkah yang terlibat dalam transformasi dan pemuatan data.

Biaya

Selain itu, ELT menghilangkan kebutuhan akan perangkat lunak ETL yang mahal, karena transformasi dapat dilakukan menggunakan kueri SQL atau alat open-source lainnya.

Sebaliknya, proses ETL tradisional cenderung lebih cocok untuk infrastruktur on-premises, di mana sumber data terbatas, dan sumber daya perangkat keras kurang skalabel dibandingkan lingkungan berbasis cloud. Infrastruktur on-premises sering kali memiliki biaya lebih tinggi daripada infrastruktur cloud.

Keamanan

Terakhir, ELT memungkinkan enkripsi data dan masking data untuk informasi yang dapat diidentifikasi secara pribadi (PII) selama proses pemuatan karena dilakukan di repositori pusat yang aman. 

Proses ETL harus memastikan keamanan data sepanjang proses ekstraksi dan transformasi. Namun, itu menjadi sulit mengingat data harus dipindahkan ke penyimpanan staging tambahan dan sering diproses di server terpisah.

Use Case ELT

Dengan kecepatan pemrosesan data yang lebih tinggi dan analitik komputasi cloud, proses ELT memiliki beberapa use case di mana ia unggul dibandingkan ETL.

Berikut beberapa penggunaan umum proses ELT:

  • Pelaporan aplikasi real-time: ELT memungkinkan bisnis mendapatkan wawasan real-time tentang perilaku pengguna aplikasi.
  • Data warehousing: Banyak organisasi menggunakan ELT untuk memuat dan mentransformasikan data ke gudang data terpusat untuk tujuan pelaporan dan analitik.
  • Integrasi data berbasis cloud: Seiring berkembangnya teknologi cloud, ELT menjadi pilihan populer untuk mengintegrasikan sumber data dari berbagai aplikasi on-premises dan cloud.

Alat dan Teknologi ELT

Ada berbagai alat dan teknologi yang tersedia bagi organisasi untuk menerapkan proses ELT. Ini termasuk:

Gudang data dan data lake

Dalam langkah pemuatan proses ELT, data lake dan gudang data penting untuk menyediakan ruang penyimpanan data terpusat di dalam perusahaan.

Berikut platform data cloud yang paling populer:

  • Amazon Redshift: Layanan gudang data cloud yang dapat menangani data dalam jumlah sangat besar dengan cepat dan efisien.
  • Google BigQuery: Gudang data cloud tanpa server yang skalabel dan memungkinkan kueri cepat pada dataset besar.
  • Snowflake: Gudang data berbasis cloud yang mendukung proses ELT serta menyediakan keamanan dan kinerja tingkat lanjut.
  • Amazon S3: Layanan penyimpanan cloud yang dapat digunakan sebagai data lake untuk menyimpan data mentah, yang kemudian dapat ditransformasikan menggunakan kueri SQL atau alat lainnya.

Alat ELT open-source

Banyak organisasi juga memanfaatkan alat open-source untuk proses ELT karena efektivitas biayanya.

Alat-alat ini dapat membantu pada berbagai tahap proses ELT:

  • Apache Airflow: Digunakan untuk otomatisasi alur kerja dan penjadwalan proses ETL/ELT.
  • dbt: Perangkat lunak open-source untuk mentransformasikan data di gudang data menggunakan SQL.
  • Airbyte: Platform integrasi data open-source yang mendukung proses ELT dan ETL.
  • Singer: Alat open-source yang digunakan dalam proses ELT dan ETL melalui pendekatan modular.
  • Apache NiFi: Alat integrasi data open-source yang mendukung perutean data, transformasi, dan logika mediasi sistem.

Alat open-source sangat cocok untuk proses ELT karena memberikan fleksibilitas, dukungan pengembang, dan banyak opsi integrasi.

Skrip yang dibangun khusus

Pengembang juga dapat memilih menggunakan skrip yang dibuat dengan bahasa pemrograman untuk menambah kemampuan kustomisasi. Ini biasanya melibatkan penggunaan paket dan pustaka untuk memproses dan mentransformasikan data.

Beberapa bahasa pemrograman umum yang digunakan untuk skrip ini meliputi:

  • Python: Menggunakan pustaka seperti Pandas, NumPy, dan SQLAlchemy dapat membantu ekstraksi, pemuatan, dan transformasi data.
  • Apache Spark: Digunakan untuk pemrosesan dan analitik big data, sering memanfaatkan bahasa seperti Python (PySpark), Java, dan Scala.
  • R: Kerangka tidyverse, bersama pustaka R lainnya seperti dplyr dan data.table, dapat digunakan untuk ekstraksi dan transformasi data.
  • SQL: Kueri SQL dapat digunakan untuk tugas transformasi, dan SQL Server Integration Services (SSIS) adalah alat ETL populer yang juga mendukung proses ELT.
  • Scala: Sering digunakan dengan Apache Spark untuk pemrosesan big data dan tugas ELT.
  • Java: Umumnya digunakan dengan kerangka kerja big data seperti Apache Hadoop dan Apache Spark untuk proses ELT.

Penutup

Kesimpulannya, ELT adalah tren baru dan berkembang dalam pemrosesan data yang menawarkan banyak keunggulan dibandingkan metode ETL tradisional. ELT memungkinkan transformasi data yang lebih cepat dan efisien serta memberikan fleksibilitas dan skalabilitas yang lebih besar. 

Jika Anda berpikir untuk mempelajari lebih lanjut tentang ELT atau konsep rekayasa data lainnya, Anda mungkin tertarik dengan Sertifikasi Data Engineer kami atau Data Engineer in Python Career Track kami.

FAQs

Bagaimana ELT menangani masalah kualitas dan konsistensi data?

ELT menangani kualitas dan konsistensi data dengan memanfaatkan kapabilitas gudang data atau data lake tempat data disimpan. Pemeriksaan kualitas data, pembersihan, dan proses validasi diterapkan selama fase transformasi untuk memastikan konsistensi dan akurasi. Alat seperti dbt (data build tool) dapat digunakan untuk membuat pipeline transformasi yang mencakup pemeriksaan kualitas ini, sehingga membantu menjaga standar integritas data yang tinggi.

Dapatkah ELT digunakan untuk streaming data real-time, dan bagaimana caranya?

Ya, ELT dapat digunakan untuk streaming data real-time. Ini dicapai dengan mengintegrasikan alat ingest data real-time seperti Apache Kafka atau AWS Kinesis dengan pipeline ELT. Alat-alat ini dapat secara kontinu melakukan streaming data ke data lake atau gudang data, di mana transformasi dapat diterapkan hampir secara real-time menggunakan alat seperti Apache Spark atau transformasi berbasis SQL, sehingga memungkinkan analisis dan pengambilan keputusan yang tepat waktu.

Bagaimana ELT terintegrasi dengan alur kerja machine learning?

ELT terintegrasi dengan alur kerja machine learning dengan menyediakan pipeline data yang andal untuk memasok data yang bersih dan telah ditransformasikan ke dalam model machine learning. Setelah data dimuat ke gudang data, data dapat ditransformasikan dan dipersiapkan untuk machine learning menggunakan alat seperti Apache Spark MLlib atau pustaka Python seperti scikit-learn. Integrasi ini memungkinkan prapemrosesan data, pelatihan model, dan evaluasi dilakukan dalam lingkungan yang sama, sehingga meningkatkan efisiensi dan skalabilitas.

Apa saja pertimbangan keamanan saat menerapkan ELT di lingkungan cloud?

Saat menerapkan ELT di lingkungan cloud, pertimbangan keamanan mencakup enkripsi data, kontrol akses, dan masking data. Data harus dienkripsi saat transit dan saat disimpan untuk melindungi informasi sensitif. Mekanisme kontrol akses, seperti role-based access control (RBAC), harus diterapkan untuk memastikan hanya pengguna berwenang yang dapat mengakses dan memanipulasi data. Teknik masking data dapat diterapkan untuk melindungi informasi pribadi yang dapat diidentifikasi (PII) selama proses pemuatan dan transformasi.

Bagaimana data engineer menangani tantangan evolusi skema dalam proses ELT?

Profesional data menangani evolusi skema dalam proses ELT dengan menggunakan alat dan praktik manajemen skema yang mengakomodasi perubahan dari waktu ke waktu. Ini mencakup penggunaan alat seperti Apache Avro atau skema JSON untuk serialisasi data yang fleksibel dan evolusi skema. Selain itu, strategi versioning dan skrip migrasi skema otomatis dapat diterapkan untuk mengelola perubahan tanpa mengganggu pipeline data. Katalog data dan alat manajemen metadata juga berperan penting dalam melacak dan mendokumentasikan perubahan skema guna memastikan konsistensi dan keandalan data.


Austin Chia's photo
Author
Austin Chia
LinkedIn

Saya Austin, seorang blogger dan penulis teknologi dengan pengalaman bertahun-tahun sebagai data scientist dan analis data di bidang kesehatan. Memulai perjalanan teknologi dengan latar belakang biologi, kini saya membantu orang lain melakukan transisi yang sama melalui blog teknologi saya. Ketertarikan saya pada teknologi mendorong kontribusi tulisan saya untuk puluhan perusahaan SaaS, menginspirasi orang lain dan membagikan pengalaman saya.

Topik
Rekayasa Data

Pelajari lebih lanjut tentang data engineering dan pemrosesan data dengan kursus-kursus ini!

Kursus

ETL dan ELT di Python

4 jam
40.2K
Pelajari cara membangun data pipeline yang efektif, memiliki performa tinggi, dan andal menggunakan prinsip Extract, Transform, dan Load.
Lihat DetailRight Arrow
Mulai Kursus
Lihat SelengkapnyaRight Arrow
Terkait

blogs

40 Pertanyaan Wawancara DBMS Teratas di 2026

Kuasai pertanyaan wawancara basis data, dari konsep SQL dasar hingga skenario desain sistem tingkat lanjut. Panduan mendalam ini mencakup semua yang Anda perlukan untuk sukses di wawancara DBMS dan meraih peran berikutnya.
Dario Radečić's photo

Dario Radečić

15 mnt

blogs

Tutorial Korelasi di R

Dapatkan pengenalan dasar-dasar korelasi di R: pelajari lebih lanjut tentang koefisien korelasi, matriks korelasi, plotting korelasi, dan sebagainya.
David Woods's photo

David Woods

13 mnt

blogs

Spaghetti Plot dan Jalur Badai

Temukan alasan mengapa Anda sebaiknya (tidak) menggunakan spaghetti plot untuk menyampaikan ketidakpastian jalur prediksi badai serta dampaknya terhadap interpretasi.
Hugo Bowne-Anderson's photo

Hugo Bowne-Anderson

13 mnt

blogs

12 Alternatif ChatGPT Terbaik yang Bisa Anda Coba pada 2026

Artikel ini menyajikan daftar alternatif ChatGPT yang akan meningkatkan produktivitas Anda.
Javier Canales Luna's photo

Javier Canales Luna

14 mnt

Lihat SelengkapnyaLihat Selengkapnya
